에이전트 하네스란 무엇이고, 하네스 엔지니어링은 무엇을 하나
에이전트는 모델에 하네스를 더한 것입니다. 하네스는 모델을 둘러싼 프롬프트, 규칙, 메모리, 도구, 스크립트입니다. 하네스 엔지니어링이라는 말이 어디서 나왔는지, 구글 Harness² 논문이 고치는 여덟 부분이 무엇인지, 이미 가진 저장소에서 그 일이 어떤 모습인지 정리했습니다.
에이전트 하네스란 무엇이고, 하네스 엔지니어링은 무엇을 하나
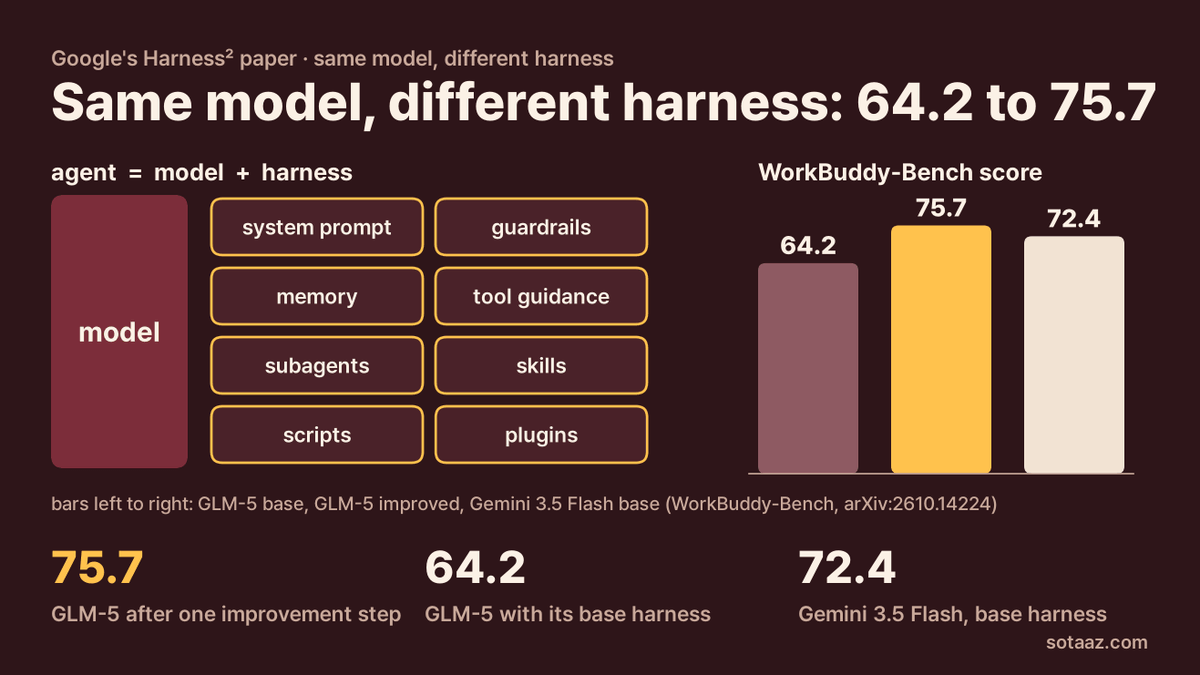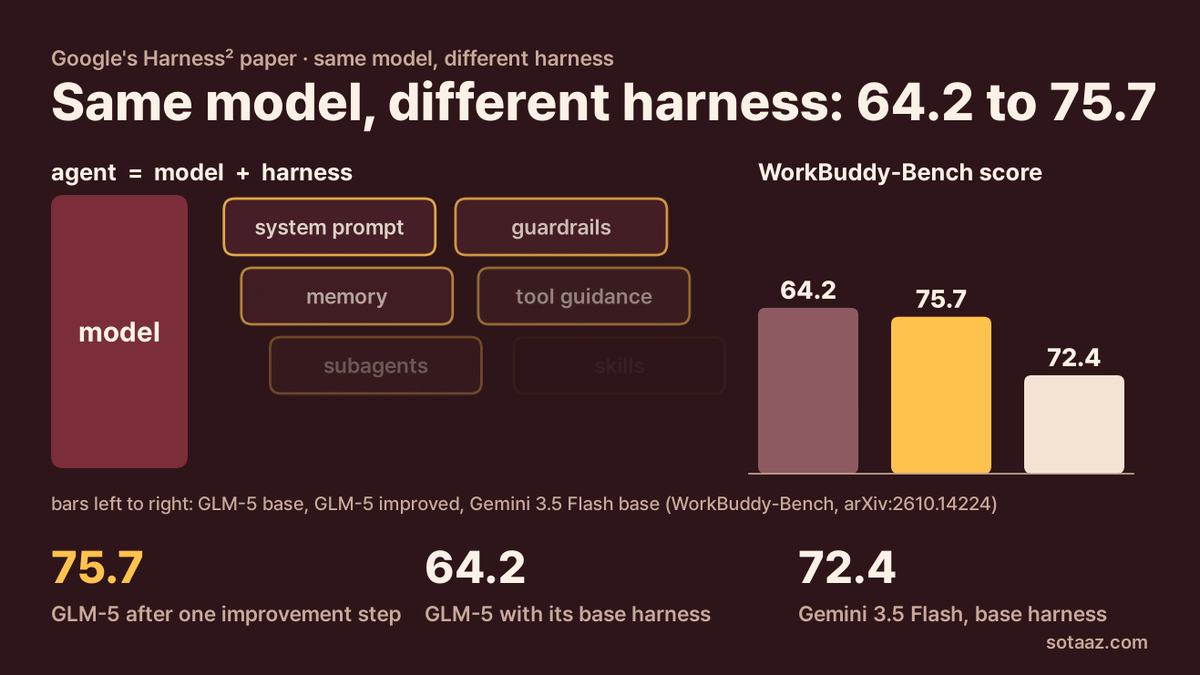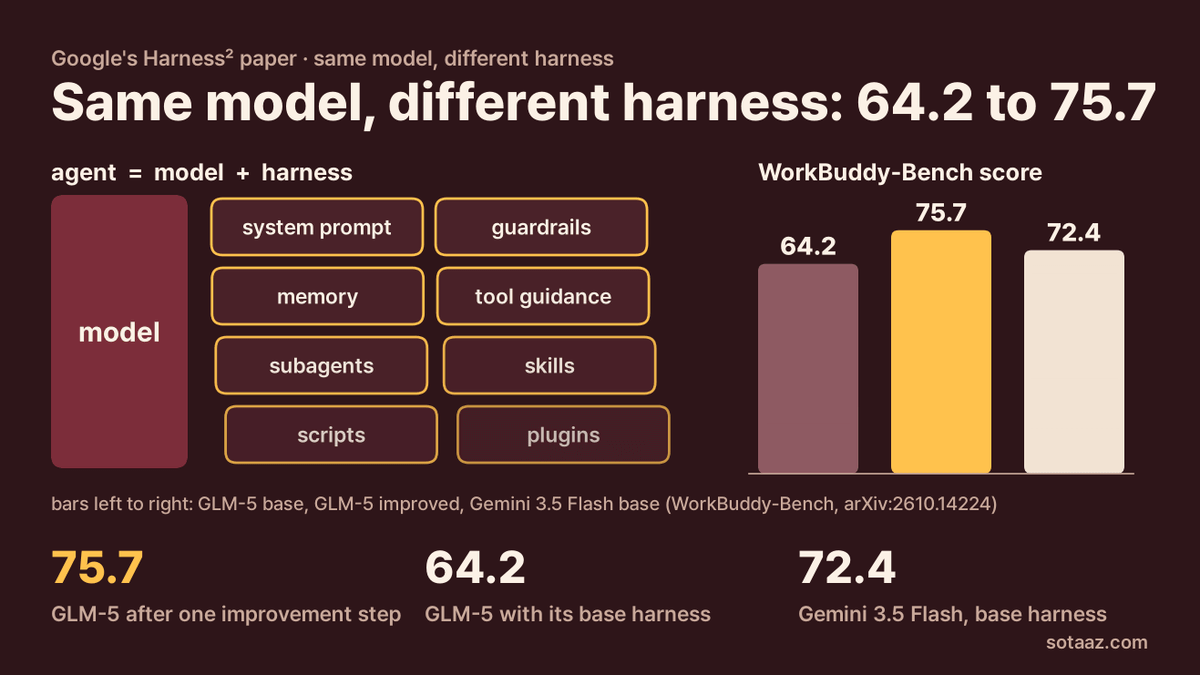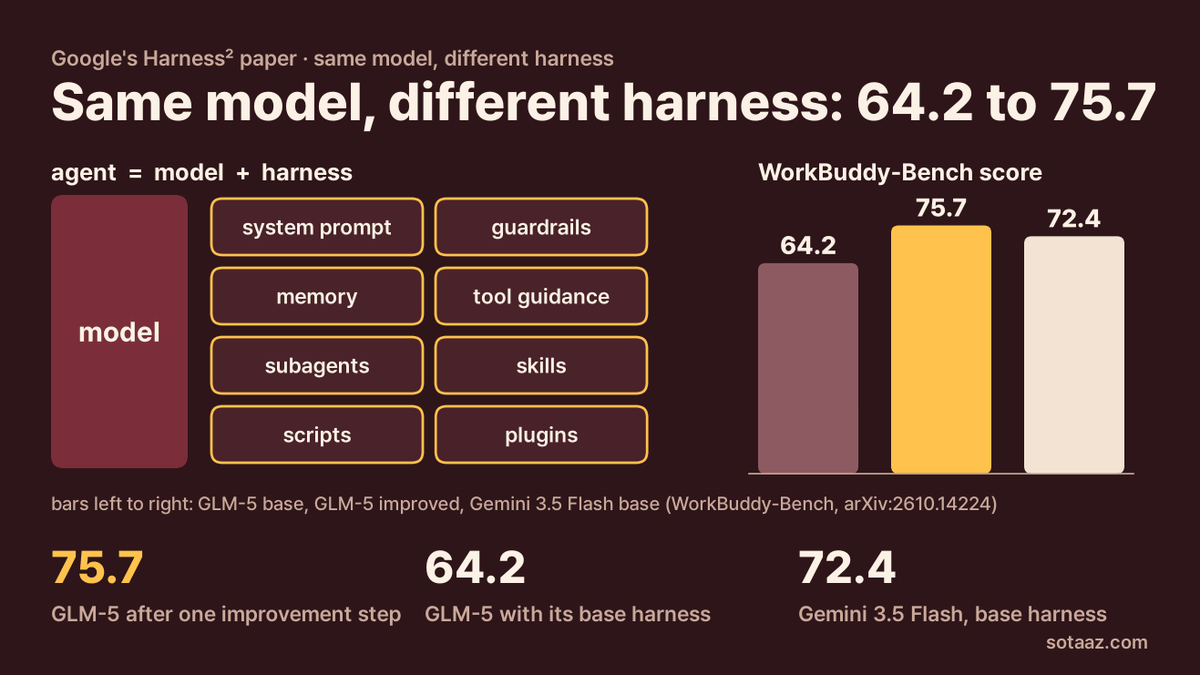
모델을 둘러싼 부분을 고치는 일이 모델을 바꾸는 것만큼 결과를 바꾸기도 합니다. 이번 달 나온 구글의 Harness² 논문(arXiv:2610.14224)의 WorkBuddy-Bench 표에서, GLM-5는 기본 하네스로 64.2점이었지만 하네스를 한 단계 고친 뒤 75.7점이 되어 기본 하네스의 Gemini 3.5 Flash(72.4점)를 넘었습니다. 이 논문은 최적화 대상을 모델이 아니라 하네스로 잡습니다. 이 글은 그 논문을 다루는 여섯 편 연재의 첫 글입니다. 용어를 정하고, 하네스가 무엇으로 이루어졌는지 나열하고, "하네스 엔지니어링"이라는 말의 출처를 확인합니다.
하네스는 모델을 뺀 전부입니다
세 정의를 나란히 놓아 볼 만합니다. Harness² 저장소의 README는 이렇게 씁니다. "A harness is the system around a model that enables it to act as an agent: prompts, tools, memory, skills, orchestration, and more." 논문 본문은 "the system surrounding a base model that enables it to act as an autonomous agent"라고 쓰고, "Agent = Model + Harness" 공식에는 Weng(2026)을 인용합니다. Addy Osmani의 글(2026년 5월 15일 O'Reilly에 재게재)은 "every piece of code, configuration, and execution logic that isn't the model itself"라고 적고, "Agent = Model + Harness"라는 한 줄 공식은 Viv Trivedy의 것으로 소개합니다.
세 정의는 같은 말입니다. 모델 혼자서는 글자를 받아 글자를 내놓을 뿐입니다. 무언가가 상태를 쥐여 주고, 도구 호출을 실행해 주고, 결과를 되먹이고, 한계를 강제할 때 비로소 에이전트가 됩니다. 그 무언가가 하네스입니다.
여덟 부분
Harness² 논문은 하네스를 뭉뚱그려 두지 않습니다. OpenCode 기반으로 편집 가능한 여덟 부분을 꼽습니다. 시스템 프롬프트, 가드레일, 메모리, 도구 안내, 서브에이전트, 스킬, 스크립트, 플러그인입니다. 각각은 에이전트 작업 공간의 파일이나 디렉터리입니다. 항상 켜져 있는 글(시스템 프롬프트, 가드레일, 메모리, 도구 안내)은 코드에서 24,000자로 제한됩니다. 상한은 글자 수로 재고, 이유는 소스에 "여기 있는 토큰 하나하나가 에이전트 자신의 출력 예산과 경쟁한다"고 적혀 있습니다.
관련해서 저희가 쓴 글을 아래에 모았습니다.
| 부분 | 무엇을 다스리는가 | 저희가 다룬 글 |
|---|---|---|
| system prompt | 항상 컨텍스트에 들어가는 지시 | CLAUDE.md 정리 |
| guardrails | 에이전트가 넘으면 안 되는 규칙 | AI 코딩 규칙 가이드 |
| memory | 과제 사이를 넘어가는 것 | 컨텍스트 예산 |
| tool guidance | 도구를 어떻게 설명하느냐 | Claude Code MCP |
| skills | 필요할 때 불러 쓰는 재사용 절차 | Claude Code 스킬 |
| scripts | 에이전트가 실행하는 결정적 도우미 | 훅과 스크립트 |
| plugins | 도구 루프 안에서 동작하는 코드 | 훅과 스크립트 |
| subagents | 자기 컨텍스트에서 일하는 위임 워커 | 모델 믹스 |
이 목록은 논문 한 편의 구현에서 나온 것이지 표준 구현 방법은 아닙니다. 다른 도구는 이 중 일부만 파일로 열어 둘 수도 있고, 다른 옵션이나 파일을 더 둘 수도 있습니다. 2부에서는 도구별로 여덟 부분 중 몇 개가 파일이나 설정으로 열려 있다고 공식 문서에 적혀 있는지 세어 봅니다.
"하네스 엔지니어링"은 어디서 나온 말인가
논문의 표현을 그대로 옮기지 않고 하네스 엔지니어링이 어디서 나왔는지 확인해 봤습니다. Mitchell Hashimoto의 글 "My AI Adoption Journey"(2026년 2월 5일)에는 "Engineer the Harness"라는 절이 있고, 거기서 이것을 "harness engineering"이라고 부르게 됐다고 직접 씁니다. 지금까지 저희가 직접 확인한 가장 오래된 사용입니다. 반면 Osmani 글의 O'Reilly 재게재본에는 "Viv Trivedy coined the term harness engineering"이라고 적혀 있습니다. 이 주장은 그 기사에서만 확인했고, Trivedy의 원글은 열어 보지 못했습니다. 한편 Harness² 논문은 "Agent = Model + Harness" 공식에 Weng(2026)을 인용합니다. 기록이 서로 맞지 않아서, 저희는 누가 이 말을 처음 만들었는지 단정하지 않습니다.
그 일은 무엇을 하는 일인가
Hashimoto는 이 말을 구체적인 습관에 씁니다. 에이전트가 실수하면 다음 실행이 잘되기를 바라는 대신, 같은 실수가 다시 나오지 않도록 환경을 고칩니다. Osmani의 글도 같은 순환을 설명합니다. 뼈대를 "진짜 산출물"로 다루고, 에이전트가 실수할 때마다 뼈대를 더 단단히 고쳐 나간다는 것입니다. 각 구성 요소가 "모델이 아직 혼자 못 하는 것"에 대한 가정을 담고 있으니, 모델이 더는 필요로 하지 않으면 그 요소를 걷어 내야 한다고도 덧붙입니다.
저장소에서는 평범하고 화려하지 않은 편집으로 나타납니다. 에이전트가 같은 실수를 반복한 뒤 CLAUDE.md에 규칙을 한 줄 더하고, 부작용이 있는 코드가 등록된 한 경로만 거치는지 검사해 실패하면 push를 막는 git pre-push 훅을 달고, 손으로 계속 설명하던 절차를 스킬로 만듭니다. 이 사이트에서도 모두 하고 있습니다. 다만 이 편집들에는 어떤 증거가 그 편집을 정당화했는지에 대한 기록도, 편집이 도움이 됐는지 가려 볼 방법도 없습니다.
다음 글
위에서 설명한 하네스 엔지니어링은 손으로 합니다. 사람이 실수를 알아채고 파일을 고칩니다. Harness²는 이 순환이 정답 없이도 스스로 돌 수 있는지를 묻습니다. 2부에서는 어떤 하네스들이 있고 각각 얼마나 고칠 수 있는지 훑고, 3부에서는 Harness² 논문을 읽고 공개 저장소의 데모를 돌립니다.
확인한 범위
- 하네스 정의는 저장소 README, 여덟 부분은 논문: Harness²: Recursive Agent Harnessing for an Open World, arXiv:2610.14224. 24,000자(문자 수) 상한은 공개 코드(
substrate/opencode.py, 커밋1cfe254)에서 확인했습니다. - Osmani 정의와 Trivedy 귀속: O'Reilly Radar "agent harness engineering"(2026년 5월 15일), 직접 읽었습니다.
- Weng(2026) 귀속: Harness² 논문이 "Agent = Model + Harness" 공식에 붙인 인용을 읽었고, Weng의 원문은 열어 보지 못했습니다.
- Hashimoto: mitchellh.com/writing/my-ai-adoption-journey(2026년 2월 5일). 절 제목과 인용한 문장은 직접 읽었고, 그 절 외의 본문은 이번 글을 위해 읽지 않았습니다.
- 확인하지 못한 것: Trivedy의 원글, Weng(2026)의 원문, 2026년 2월 5일 이전의 용례.