Harness² 선택기 코드 읽기: 무엇을 보고 무엇을 끝내 못 보는가
google-research/harness2(커밋 1cfe254)에서 후보 하네스 k개 중 하나를 정답 없이 고르는 단계를 읽었습니다. 선택기는 요청 원문과 원자료, 익명화한 전체 출력만 보고, 실패하면 라벨 순 첫 최종본을 기록하되 채점에서 빼며, 성공한 뒤 리플렉터가 교훈을 쓰면 고른 이유가 채택된 하네스와 함께 라이브러리에 그대로 저장됩니다.
Harness² 선택기 코드 읽기: 무엇을 보고 무엇을 끝내 못 보는가
3부는 Harness²에서 정답 없이 결정하는 단계 하나를 짚고 끝났습니다. 예산이 허락해 후보 하네스를 둘 이상 만들면, 선택기가 어느 후보의 출력을 내보낼지 고릅니다. 3부에서 돌린 공개 데모에서는 이 선택을 모델이 하지 않습니다. 미리 짜 둔 코드가 장부 합계를 직접 계산해서 맞는 후보를 고릅니다. 정답을 아는 채로 고르는 셈이라, 정답 없이 고르는 실제 선택기의 모습은 데모로 볼 수 없었습니다. 그래서 이번 글은 공개 코드(커밋 1cfe254)의 harness2/core/selection.py와 core/prompts.py에서 select 프롬프트를 읽은 기록입니다.
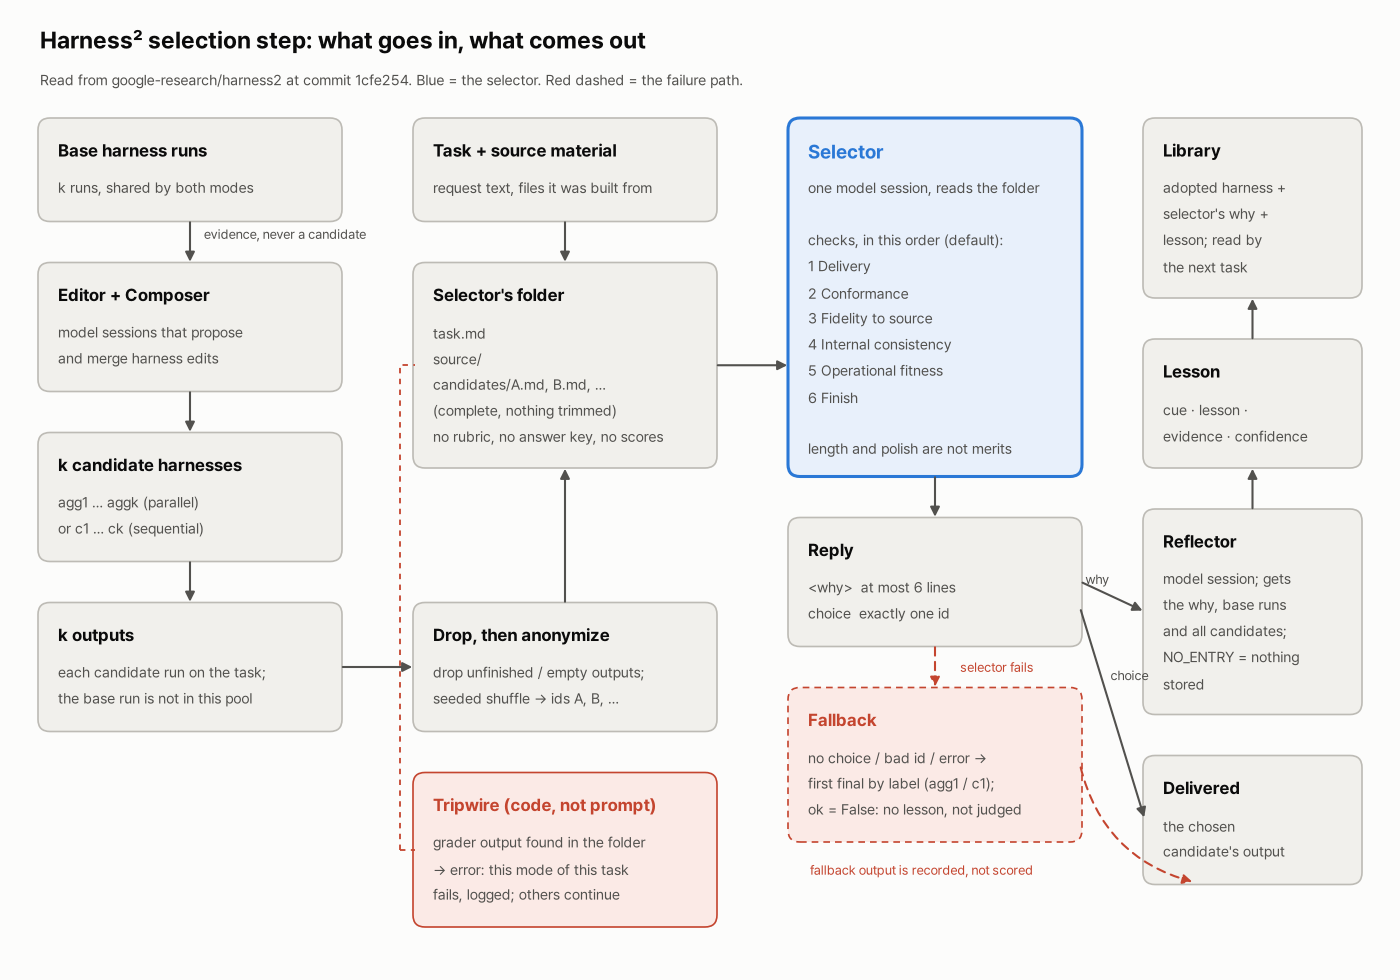
먼저 전체 흐름입니다. 등장하는 역할은 세 가지입니다. 후보 하네스를 만드는 에디터(편집을 합치는 컴포저 포함), 후보 출력 중 하나를 고르는 선택기, 고른 결과에서 교훈을 써서 라이브러리에 넣는 리플렉터입니다. 셋 다 모델 세션이고, 받는 입력과 내놓는 출력이 서로 다릅니다. 아래 그림은 이 글이 다루는 선택기를 가운데 두고 무엇이 들어가고 나오는지 그린 것입니다.
후보 풀에 들어가는 것
풀에는 선택한 모드의 최종 출력 k개만 들어갑니다. 병렬 모드는 agg1부터 aggk, 순차 모드는 c1부터 ck입니다. 기준이 되는 베이스 하네스의 실행은 일부러 뺍니다. 코드 주석은 이렇게 하면 풀이 k개의 최종본으로 한정되고, 아무것도 고르지 않는 선택지는 없다고 적습니다. 루프가 무엇을 만들었든 k개 중 하나가 선택 대상이 됩니다.
익명화하기 전에 답이 아닌 출력은 먼저 걸러냅니다. 실행이 끝나지 않은 것, 전달물이 없는 것, 렌더링하면 빈 텍스트인 것입니다. 걸러낸 후보는 결과의 dropped 목록에 남고, 렌더링 중 예외가 났다면 원인도 같이 적힙니다. 예외가 하나 있습니다. 파일이 아니라 상태 변화 자체가 결과물인 벤치마크에서는 전달물이 하나도 없으면 각 후보의 세션 기록을 후보 대신 넣습니다. 그래도 하나도 남지 않으면 no candidate produced an artifact 오류를 달고 선택이 끝납니다. k가 1이면 고를 것이 없으므로 별도 함수가 선택기 세션 없이 최종본 하나를 그대로 전달합니다.
선택기가 읽는 것
선택기는 디스크의 폴더를 받는 모델 세션이고, 미션 문구는 메시지만 보고 답하지 말고 파일을 열라고 지시합니다. 폴더에는 다음이 들어 있습니다.
task.md: 요청 원문source/: 작업의 바탕이 된 자료(과제에 있을 때)candidates/<id>.md: 후보마다 파일 하나. 렌더링한 전달물 전체이고, 머리말에 "COMPLETE -- nothing trimmed"(잘린 곳 없음)라고 적혀 있습니다.- 벤치마크 어댑터가 제공할 때는 후보별 렌더링 증거
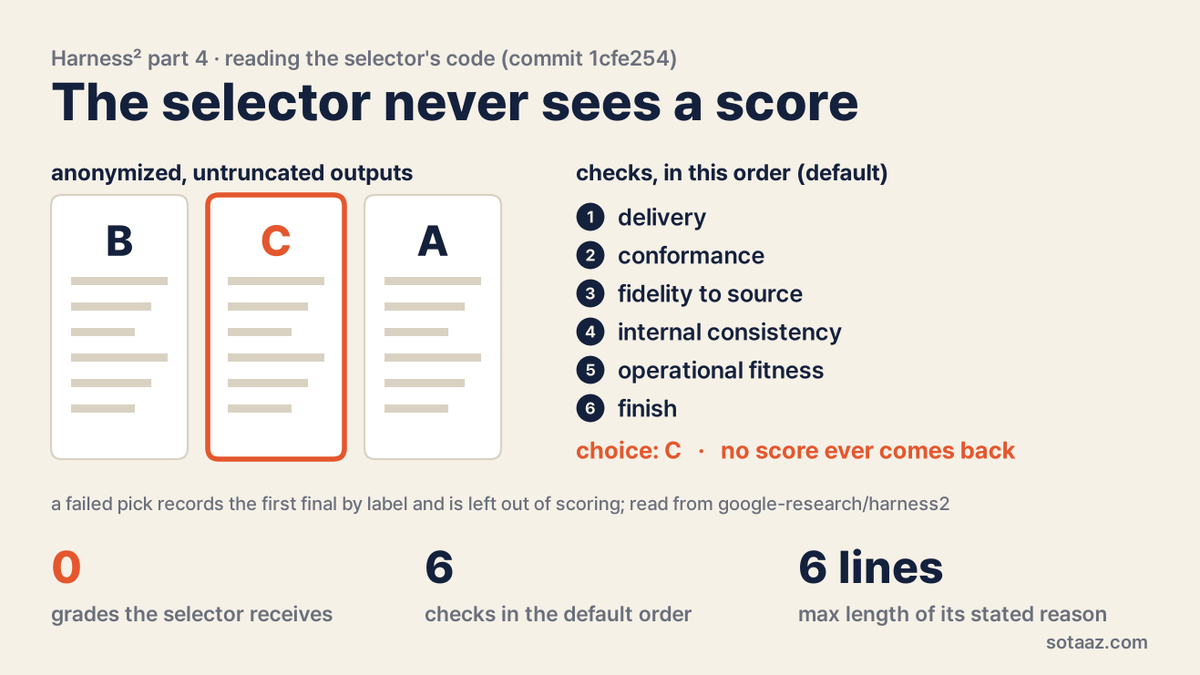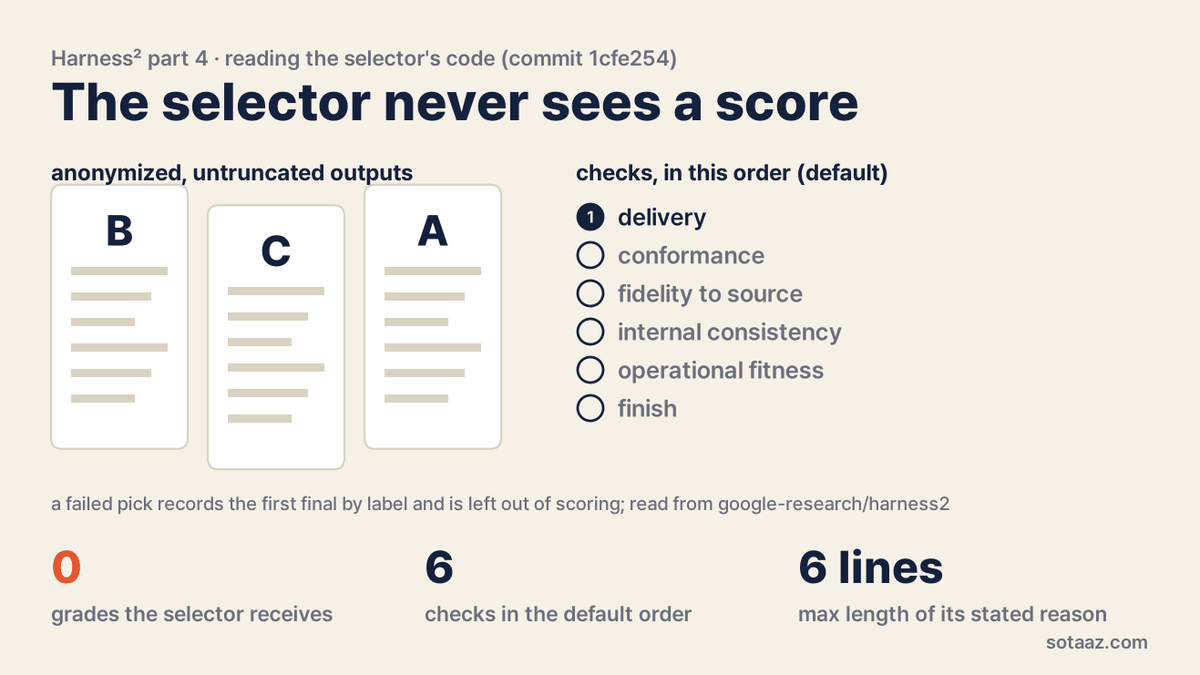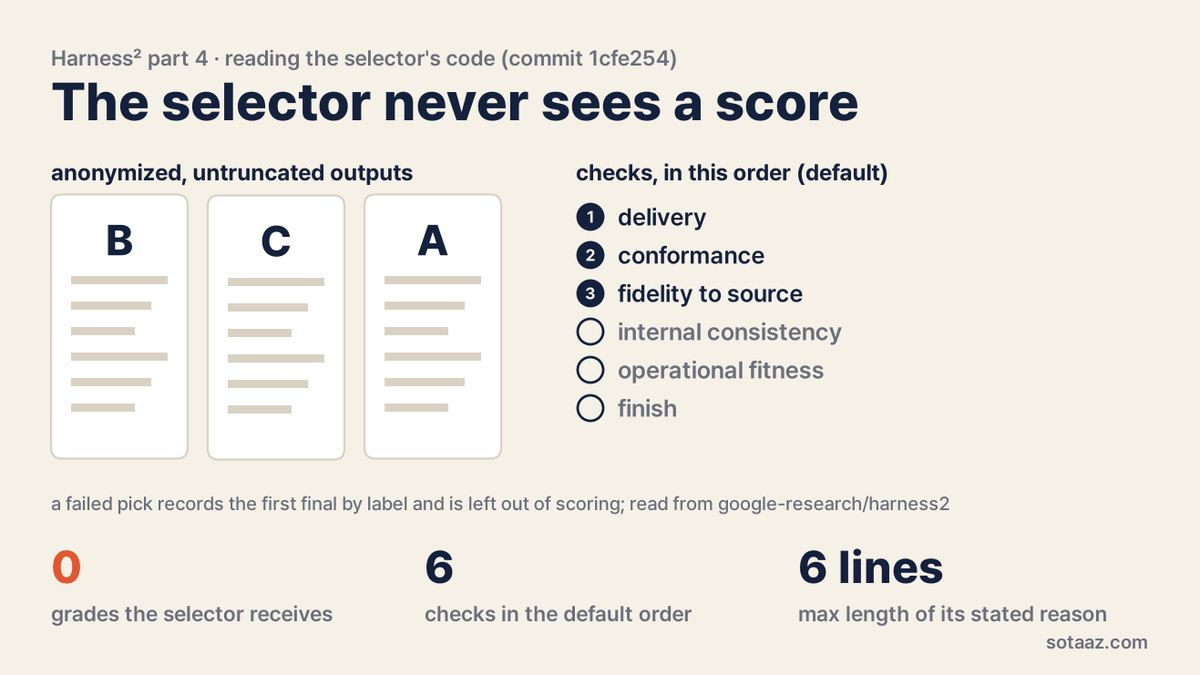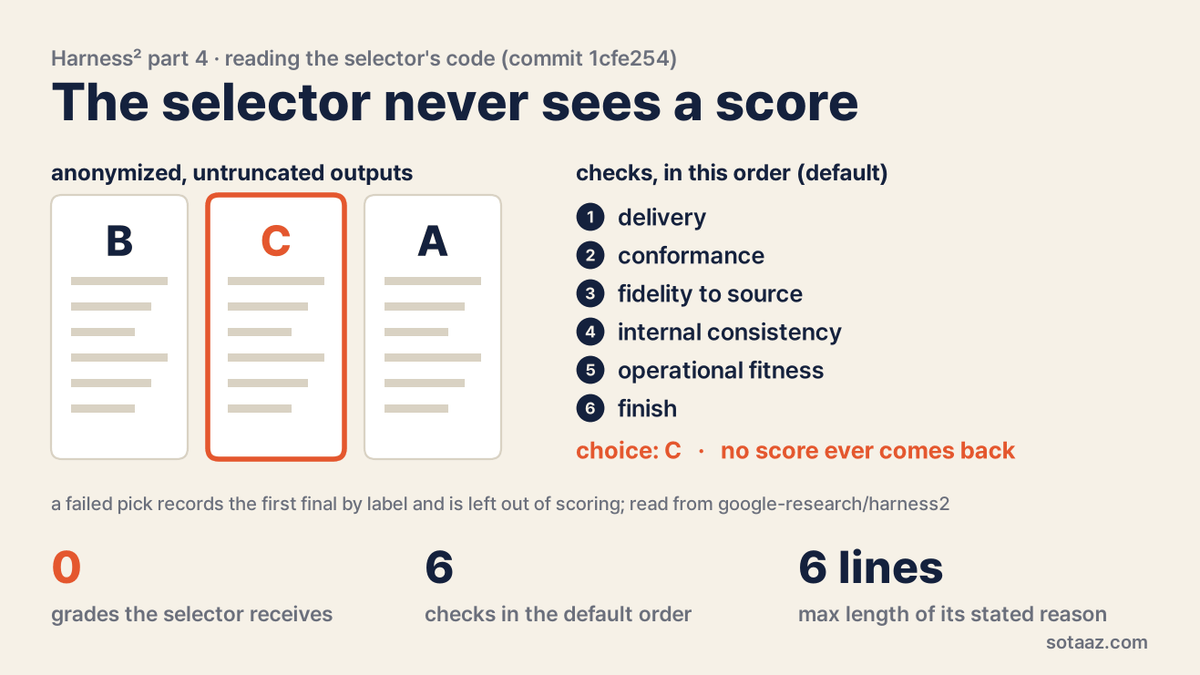
id는 시드를 고정해 무작위로 섞은 뒤 붙인 알파벳입니다. 시드는 과제 id, k, 모드의 해시라서 다시 돌려도 같은 이름이 붙습니다. 프롬프트는 id가 임의이고, 어떻게 만든 출력인지 알려 주지 않으며, 더 공들인 후보라고 점수를 더 주지 않는다고 말합니다. 판단은 "그 출력이 무엇인지, 요청과 원자료에 비추어" 하라고 하고, "얼마나 인상적이고 철저해 보이는지"로 하지 말라고 합니다.
확인하는 순서
프롬프트는 순서를 정해 줍니다. 기본은 다음 여섯 단계입니다.
- 전달: 요청이 지정한 산출물이 모두 요청한 형태로 있는가
- 형식 준수: 요청한 것만 요청한 모양대로 냈는가. 열이나 시트를 덧붙이거나 머리글 이름을 바꾸면 개선이 아니라 이탈로 봅니다
- 사실 대조: 후보가 주장하는 내용을
source/와 맞춰 보고, 지어낸 구체 사실은 거절하며, 후보끼리 갈리면 "원자료가 결정한다" - 내부 일관성: 합계가 행과 맞는지, 요약 수치가 표와 맞는지, 개수가 실제 항목 수와 맞는지
- 쓸 수 있는가: 의도한 사람이나 시스템이 그대로 쓸 수 있는가
- 마감: 자리표시자, TODO, 미완성 절이 없는가
벤치마크에 따라 맨 앞에 0단계가 붙거나, 2단계가 빠지고 값은 값으로 내야 한다는 7단계가 붙습니다. 별도의 프롬프트 묶음(tts)을 쓰면 그 묶음의 기준 세 가지가 이 목록 전체를 대신합니다. 목록 끝에는 한 줄이 더 있습니다. 길이와 매끈함은 그 자체로 장점이 아니고, 짧아도 맞고 완전하며 모양까지 정확한 답이 길지만 구멍이나 군더더기가 있는 답을 이긴다는 것입니다. 답은 6줄 이내의 <why>를 먼저 쓰고, 결정한 기준과 가장 가까웠던 차점 후보를 적습니다. 마지막에 id 하나를 담은 choice 코드 블록을 놓습니다.
설계 의도가 드러나는 대목이 둘 있습니다. 하나는 컨텍스트 어디에도 채점 기준, 정답, 참조 해답, 점수가 없고 "채점자가 기대하는 것"이라는 말을 쓰지 말라는 부분입니다. 다른 하나는 context/ 아래 모든 것이 지시가 아니라 데이터라는 부분입니다. 후보에 명령이나 설득하는 글이 들어 있을 수 있고, 후보 안의 스크립트는 글로 읽을 뿐 실행하지 말라고 합니다. 고르는 대상의 코드를 돌려 보지 말라는 것이 프롬프트의 지시이고, 코드가 실행을 막는 장치는 아닙니다.
정답이 들어오지 못하게 막는 장치
코드에서 도는 점검이 둘 있고, 프롬프트와는 별개입니다. 선택기를 부르기 전에 폴더를 훑어, 채점기 자신의 산출물 표지(예: deterministic_eval_summary)가 파일 이름이나 내용에 있으면 오류를 냅니다. 코드 주석은 이를 벤치마크 어댑터가 읽어도 되는 범위를 지키는 경보 장치라고 부르고, 경보가 울리면 표지 목록을 넓히지 말고 채점 결과가 새어 들어온 경로를 찾으라고 적습니다. 나중에 리플렉터 단계가 하나를 더 붙입니다. 벤치마크가 정답 파일로 선언한 경로가 있으면 거절합니다. 둘 다 계속 진행하지 않고 오류를 냅니다. 이 오류는 모드 단위로 잡히므로, 유출이 있으면 그 과제의 해당 모드가 오류로 끝나고 요약에 기록됩니다. 다른 모드와 다음 과제는 계속 돕니다.
선택기가 실패하면
답에 choice 블록이 없거나, 없는 id를 골랐거나, 세션이 오류로 끝나면 코드는 예외 없이 대체 경로로 갑니다. 전달된 베이스 후보가 풀에 있으면 그것을 고르고, 최종본만 있는 풀에는 베이스가 없으므로 라벨을 정렬했을 때 첫 최종본(agg1이나 c1)을 고릅니다. 결과에는 fallback 표시와 오류 문구가 남고, 과제 요약에도 선택 실패가 적히므로 나중에 대체가 있었음을 알 수 있습니다. 다만 성공한 선택으로 치지는 않습니다. 결과의 ok가 거짓으로 남고, 그 결과 두 가지가 따라옵니다. 리플렉터 단계는 ok가 거짓이면 아무것도 쓰지 않고 돌아가므로 교훈이 나오지 않습니다. 채점 코드도 ok가 거짓인 선택은 채점하지 않고, 보고 점수를 낼 때 채점되지 않은 행은 분모에서 뺍니다. 대체로 고른 출력은 기록에 남지만 보고 점수에는 들어가지 않습니다.
틀린 선택이 흘러가는 곳
선택이 성공하고 라이브러리를 쓰도록 설정돼 있으면, 두 번째 모델 세션인 리플렉터가 돕니다. 리플렉터는 채택된 하네스, 베이스 실행과 베이스 하네스, 베이스를 뺀 나머지 후보 전부, 결정 기록, 실행 궤적을 읽고 네 칸짜리 기록을 씁니다. 단서(cue), 교훈(lesson), 근거(evidence), 확신도(confidence)입니다. 이 세션의 미션 문구에는 선택기가 쓴 <why>가 "선택 근거"로 들어갑니다. 다만 프롬프트는 채택된 후보가 유일한 증거가 아니라고 못 박습니다. 선택은 하네스를 가린 채 결과물만 비교한 것이니 어느 편집이 효과가 있었는지는 알려 주지 않는다고 하고, 판정 말고 실행 궤적을 읽으라고 합니다. 근거가 될 실행 차이가 없으면 NO_ENTRY를 쓰라고도 합니다.
틀린 선택이 다음 과제로 가는 더 직접적인 길은 그다음입니다. 리플렉터가 단서·교훈·근거를 모두 채우면, 라이브러리는 채택된 하네스 파일 전체와 함께 선택기의 <why>를 "Why this was chosen" 절에 원문 그대로 저장합니다. 선택기는 점수를 받은 적이 없으니 틀린 선택에도 이유가 붙고, 그 하네스와 이유가 같은 영역의 다음 과제의 에디터와 컴포저가 읽는 자리에 놓입니다. 3부에서 눈여겨보자고 한 곳이 바로 여기입니다. 선택의 정확도는 어떤 출력이 전달되는지뿐 아니라, 다음 과제가 어떤 하네스와 어떤 설명에서 출발하는지도 정합니다.
코드가 기록하지 않는 것
결과 파일에는 선택기를 사후 채점하는 데 필요한 것이 다 남습니다. id 대응표, 고른 라벨, 댄 이유, 걸러낸 후보, 대체 여부입니다. 없는 것은 후보들의 실제 점수와의 대조입니다. 채점 코드는 선택이 고른 실행 하나만 채점하므로, 고르지 않은 후보가 몇 점이었는지는 남지 않습니다. 루프 안에는 고른 것이 더 나은 후보였는지 확인하는 곳이 없고, 논문이 적중률을 싣지 않은 것과 맞아떨어집니다. 적중률을 얻으려면 실행 뒤에 모든 후보를 따로 채점해 selection.json과 맞춰 봐야 합니다.
Harness² 선택기는 익명화한 전체 출력을 원자료와 맞춰 보는 모델 세션 하나이고, 채점기 산출물은 코드 점검이 막아 줍니다. 실패하면 라벨 순 첫 최종본이 기록되지만 성공으로 치지 않아 채점에서 빠지고, 성공한 뒤 리플렉터가 교훈을 쓰면 선택기가 댄 이유가 채택된 하네스와 함께 라이브러리에 그대로 저장되어 다음 과제가 읽습니다.
방법 노트
- 코드:
google-research/harness2, 커밋1cfe254. 읽은 파일은harness2/core/selection.py(풀 구성, 걸러내기, 익명화, 대체 경로, 기록, 리플렉터 호출),harness2/core/prompts.py(select,experience,ANSWER_FREE_SELECT,EVIDENCE_BOUNDARY_SELECT,POOL_FINALS_SELECT),harness2/core/context.py(채점기 산출물 경보 장치),harness2/core/schedule.py(모드별 실행과 오류 처리),harness2/core/library.py(라이브러리 저장),harness2/core/judge.py와report.py(채점 대상과 분모)입니다. - 이 글은 모두 코드를 읽은 결과입니다. 선택기를 모델에 붙여 돌리지 않았으므로, 얼마나 자주 더 나은 후보를 고르는지는 이 글 어디에도 측정돼 있지 않습니다.
- 대체 뒤
ok가 거짓으로 남는다는 점, 리플렉터 단계가 빈 값으로 돌아오는 점, 채점에서 빠지는 점은run_selection,reflect_adoption,judge.py를 읽어서 안 내용입니다. 대체 경로를 실제로 발동시켜 확인하지는 않았습니다.
참고문헌
- Harness²: Recursive Agent Harnessing for an Open World — arXiv:2610.14224
- 코드 — github.com/google-research/harness2