버그 있는 코드를 주고 테스트를 맡기면, 로컬 모델은 버그를 알아채고도 지키는 테스트를 씁니다
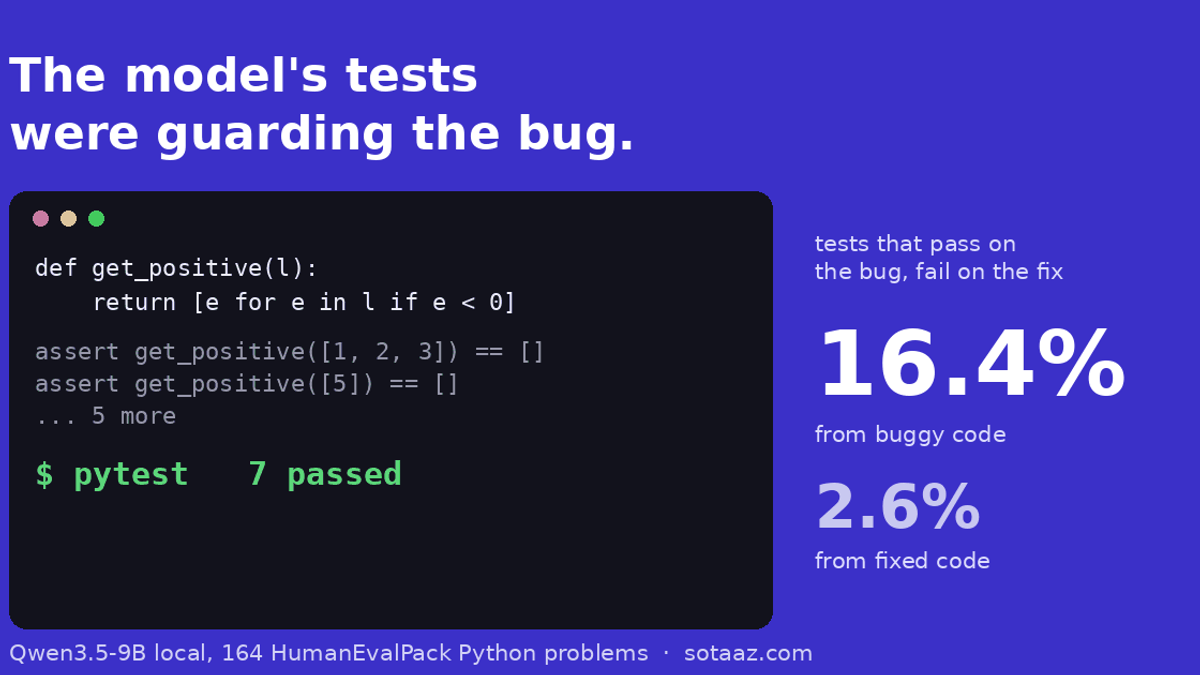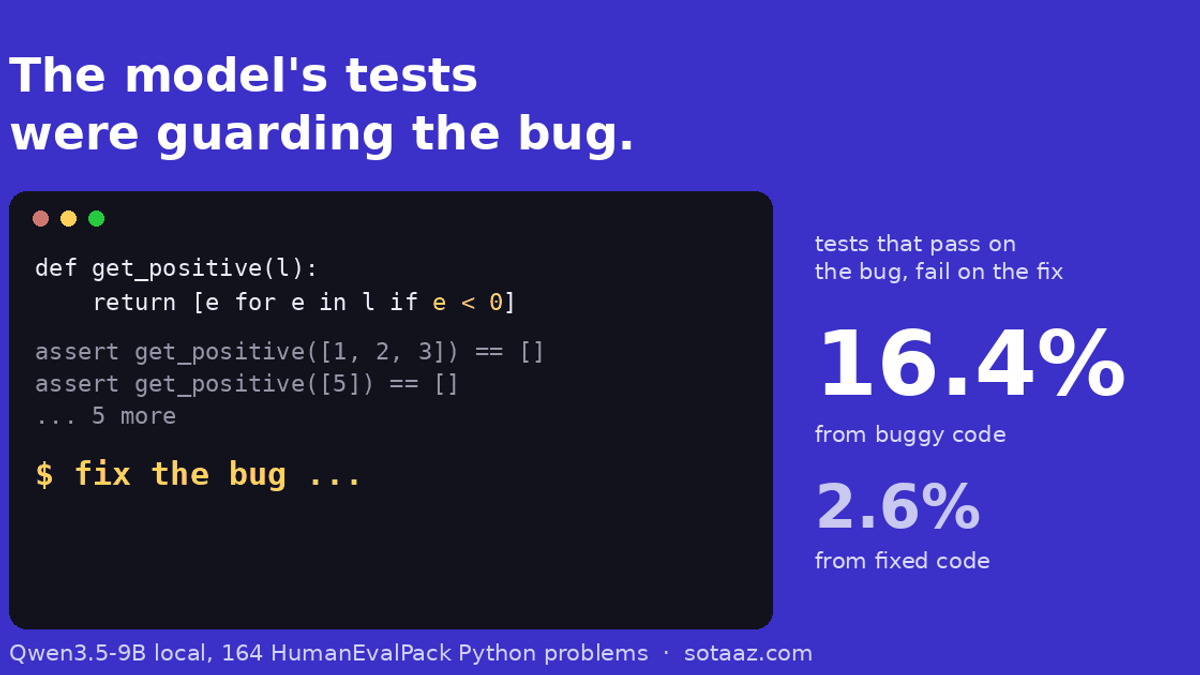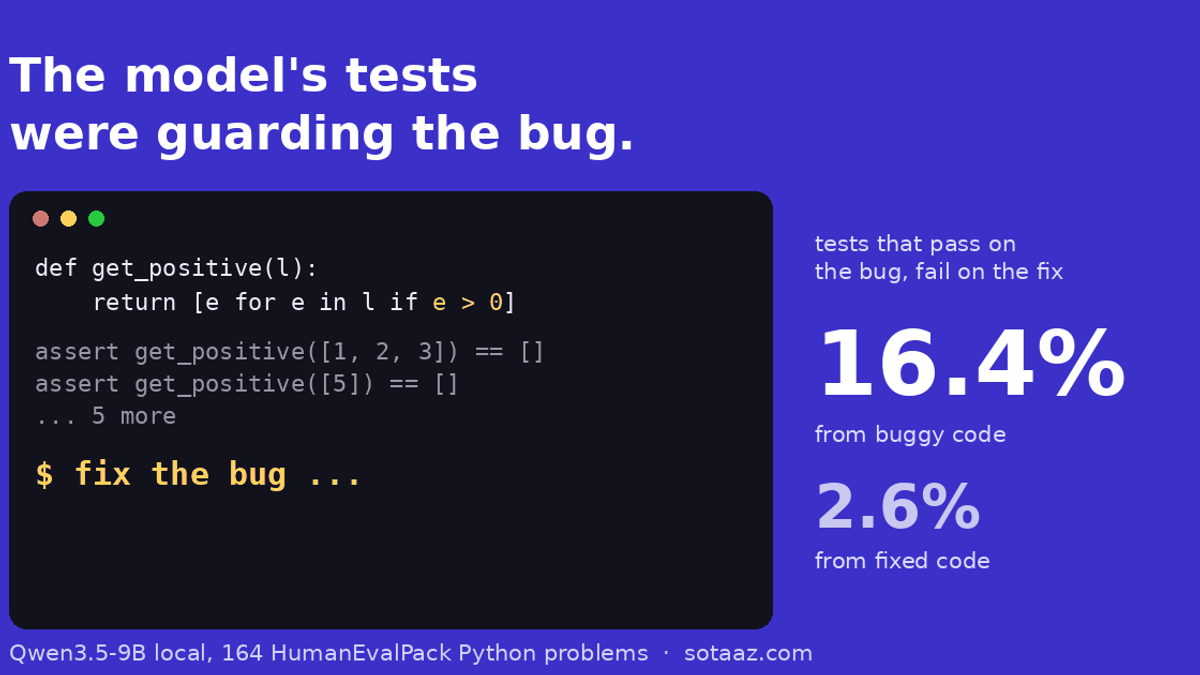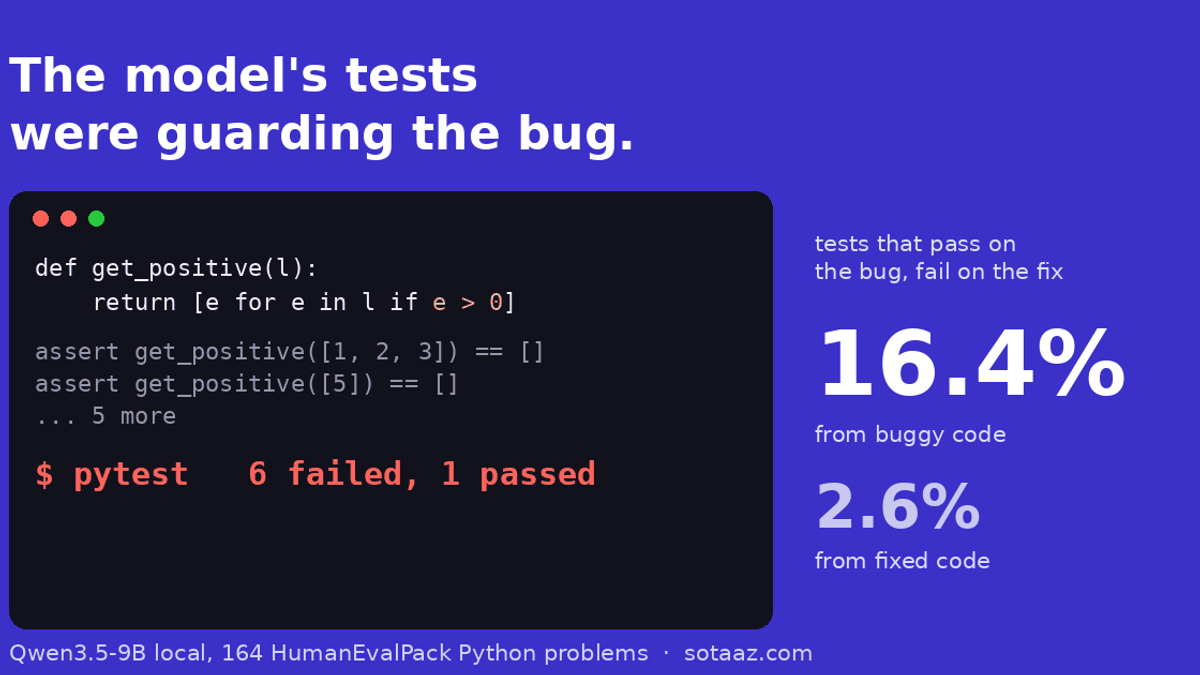
Qwen3.5-9B를 로컬에서 돌려 HumanEvalPack 파이썬 164문제의 pytest 테스트를 쓰게 했습니다. 버그 버전을 보여 주면 버그 버전에서만 통과하는 테스트가 16.4%였고, 고친 버전을 보여 주면 2.6%였습니다. 버그를 잡는 테스트는 41.9%에서 19.5%로 줄었습니다. 생각 모드를 켜면 같은 85문제에서 오도된 테스트가 22.4%에서 37.6%로 늘었습니다. 코드 대신 모델이 쓴 명세를 주는 논문의 해법은 이번 측정에서 효과를 확인하지 못했고, 그 명세의 절반가량은 버그를 원래 의도처럼 적고 있었습니다.
버그 있는 코드를 주고 테스트를 맡기면, 로컬 모델은 버그를 알아채고도 지키는 테스트를 씁니다
함수를 붙여 넣고 "단위 테스트 써 줘"라고 하는 것은 코딩 모델을 쓰는 가장 흔한 방법 가운데 하나입니다. 테스트가 돌아가고, 통과하고, 커버리지도 올라갑니다. 그런데 모델이 아는 것은 저희가 붙여 넣은 코드뿐입니다. 그 코드에 버그가 있다면 모델은 무엇을 정답으로 여길까요?
ISSTA 2026에 채택된 토론토 대학교 연구진(Zhao, Zhou, Cohen)의 논문이 이 질문을 자바로 쟀습니다. 논문은 테스트를 두 종류로 나눕니다.
- 오도된 테스트: 버그 버전에서는 통과하고 고친 버전에서는 실패합니다. 버그를 정답이라고 못 박는 테스트입니다.
- 효과적인 테스트: 버그 버전에서는 실패하고 고친 버전에서는 통과합니다. 버그를 잡아내는 테스트입니다.
논문은 실제 자바 프로젝트의 버그 233개(Defects4J)로 모델 설정 13가지(모델 11종, 일부는 추론 켬·끔을 따로 셈)를 평균했습니다. 고친 코드 대신 버그 코드를 보여 주자, 전체 테스트 가운데 오도된 테스트는 0.46%에서 3.84%로 늘고 효과적인 테스트는 8.51%에서 2.98%로 줄었습니다. 논문은 해법도 내놓았습니다. 테스트를 쓰게 할 때 코드를 빼고, 같은 모델이 그 코드를 읽고 쓴 명세(docstring)만 넣는 방법입니다.
논문의 모델은 큰 상용 모델이고 언어는 자바입니다. 저희는 개인 컴퓨터에서 돌리는 작은 모델이 파이썬 테스트를 쓸 때도 같은 일이 생기는지 확인하고 싶었습니다.
어떻게 쟀나
- 문제: HumanEvalPack 파이썬 164문제 전부입니다. 문제마다 사람이 심어 둔 버그 버전, 정답 버전, 원래 docstring이 있습니다. 버그를 저희가 만들지 않았습니다. 데이터셋에 딸린 정답 판정 테스트를 먼저 돌려 보니 버그 버전은 모두 실패하고 정답 버전은 모두 통과해서, 빠진 문제는 없습니다.
- 모델: Qwen3.5-9B Q4_K_M, llama.cpp 서버, temperature 0, 생각 끔, 출력 상한 4,096토큰입니다.
- 프롬프트: 논문의 테스트 생성 요청을 자바·JUnit에서 파이썬·pytest로만 옮겼습니다("분기와 라인 커버리지를 최대로 하는 단위 테스트를 써 달라"). 함수를 어떻게 import하는지 알려 주는 한 줄만 더했습니다.
- 조건: 문제마다 조건별로 한 번씩 테스트를 생성했습니다.
- 버그 코드: 버그가 든 함수 본문만 주고 docstring은 뺍니다.
- 고친 코드: 정답 본문만 주고 docstring은 뺍니다.
- 모델이 쓴 명세: 코드는 빼고, 같은 모델이 버그 코드를 읽고 쓴 docstring만 줍니다. 명세를 쓰게 한 프롬프트는 논문 그대로이고, "코드에 버그가 있을 수 있으니 코드를 그대로 옮기지 말라"는 경고가 들어 있습니다.
- 참고용으로 세 가지를 더 돌렸습니다. 시그니처만, 사람이 쓴 원래 docstring만, 버그 코드에 원래 docstring을 붙인 것입니다.
- 주 조건에서 docstring을 뺀 이유가 있습니다. HumanEval의 docstring은 그 자체로 정답 명세라서, 넣으면 "코드를 보고 테스트를 쓰는" 상황이 아니게 됩니다.
- 채점: 생성된 테스트 함수 하나하나(매개변수 조합은 따로 셈)를 버그 버전과 정답 버전에 각각 다른 프로세스로 돌리고, 테스트 하나에 10초 제한을 둡니다. 결과는 오도됨, 효과적, 둘 다 통과, 둘 다 실패 네 칸 중 하나입니다. 비율은 논문처럼 그 조건에서 나온 테스트 전체를 분모로 씁니다.
- 판정 규칙은 실행 전에 정했습니다. 주 비교는 네 개이고, 문제 단위로 다시 뽑는 짝 부트스트랩(10,000회)을 씁니다. 비교가 넷이라 98.75% 구간을 쓰고, 구간이 0을 포함하지 않을 때만 차이가 있다고 씁니다.
본 실행 전에 문제 3개로 시험해 보고 채점기 두 곳을 고쳤습니다. 둘 다 계획서 변경 기록에 남겼습니다. 하나는 모델이 "Markdown으로 출력하라"는 지시를 따라 코드 블록에 markdown 표시를 붙여서, 처음 추출기가 코드를 놓친 문제였습니다. 다른 하나는 불러오지 못하는 테스트 파일을 "실패한 테스트 1개"로 세던 것을 "테스트 0개"로 바꾼 것입니다.
버그가 테스트로 옮겨 갑니다
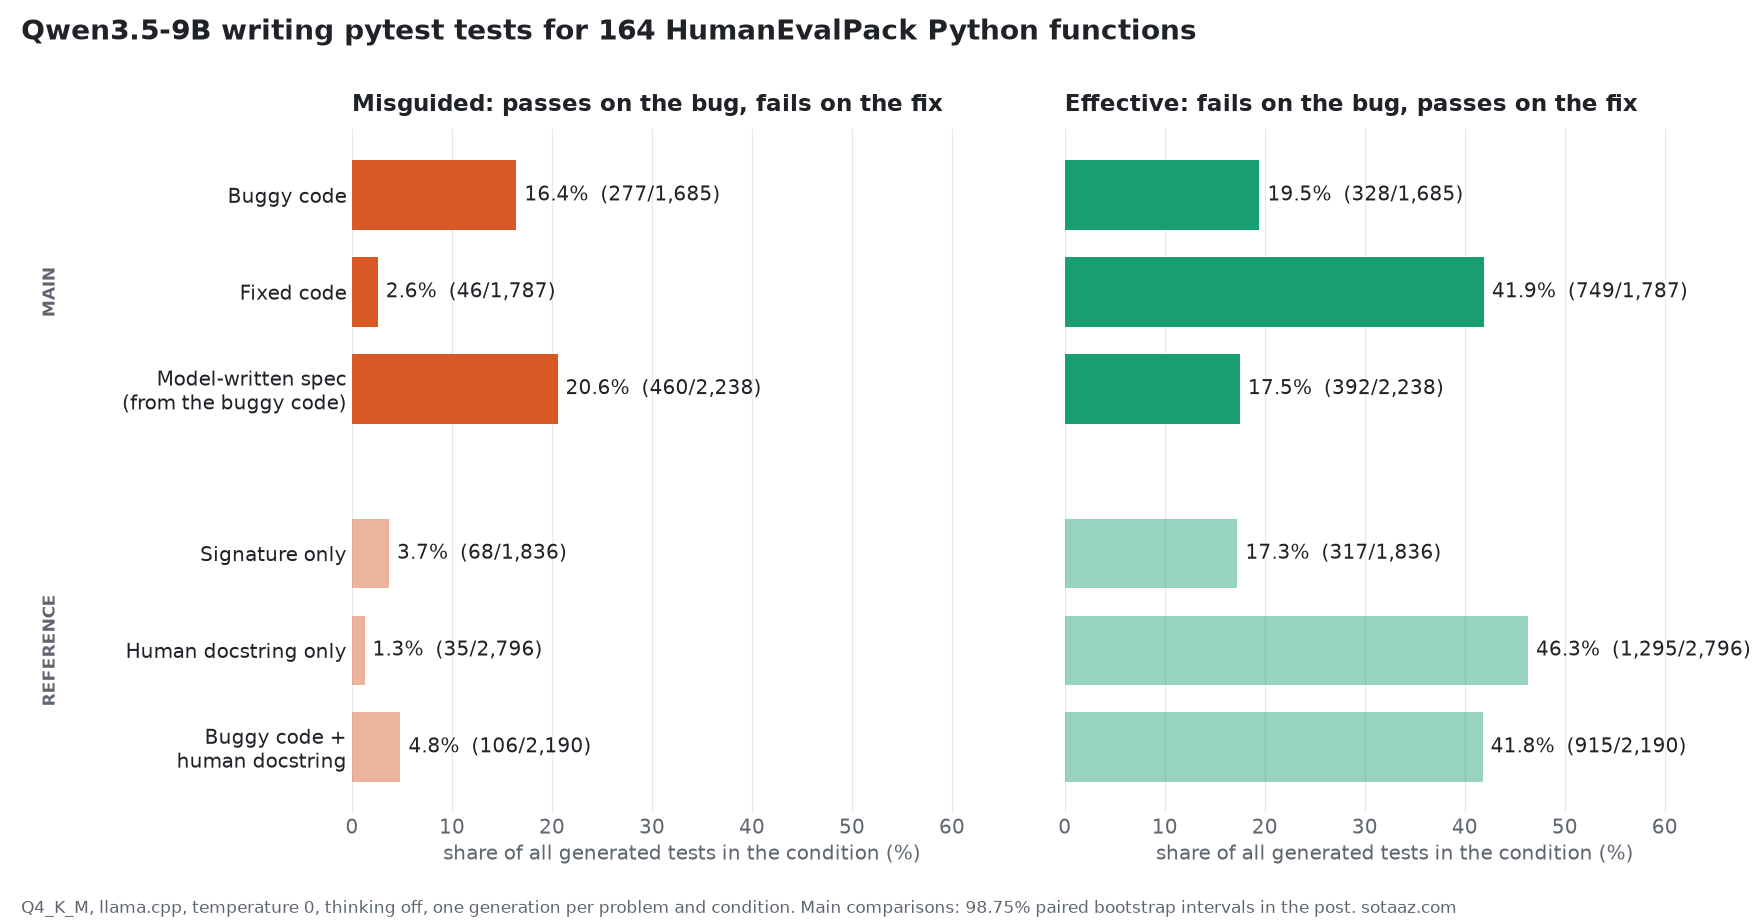
| 버그 코드 | 고친 코드 | 차이 [98.75% 구간] | |
|---|---|---|---|
| 오도된 테스트 | 16.4% (1,685개 중 277) | 2.6% (1,787개 중 46) | +13.9%p [+9.0, +19.3] |
| 효과적인 테스트 | 19.5% (1,685개 중 328) | 41.9% (1,787개 중 749) | −22.4%p [−29.8, −15.0] |
두 구간 모두 0을 포함하지 않습니다. 버그 코드를 보여 주자 모델은 버그를 정답으로 못 박는 테스트를 더 많이 쓰고, 버그를 잡는 테스트는 덜 썼습니다. 로컬에서 돌린 9B 모델, 파이썬에서도 논문과 같은 방향이었습니다. 비율 자체는 양쪽 모두 논문보다 높지만, 언어·벤치마크·모델이 모두 다르므로 수준은 비교하지 않고 방향만 비교합니다.
문제 단위로 세어 봐도 같습니다. 고친 코드를 보여 줬을 때는 164문제 중 141문제에서 버그를 잡는 테스트가 하나 이상 나왔습니다. 버그 코드를 보여 줬을 때는 81문제였습니다.
한 문제로 보겠습니다. get_positive는 리스트에서 양수만 골라 돌려주는 함수입니다. 그런데 버그 버전은 음수를 골라 돌려줍니다. 시그니처와 이 버그 본문만 받은 모델은 테스트 7개를 썼습니다.
assert get_positive([1, 2, 3]) == []
assert get_positive([-1, -2, -3]) == [-1, -2, -3]
assert get_positive([1, -2, 3, -4, 5]) == [-2, -4]
assert get_positive([]) == []
assert get_positive([5]) == []
assert get_positive([-5]) == [-5]
assert get_positive([0, 1, -1]) == [-1]
버그 코드에서는 7개가 모두 통과합니다. 버그를 고치면(e < 0을 e > 0으로) 6개가 실패합니다. 이름이 get_positive인 함수에 양수만 넣었는데 빈 리스트가 나와야 한다고 못 박은 셈입니다. 코드가 그렇게 동작했기 때문입니다. 모델은 함수 이름보다 버그가 든 코드를 믿었습니다. 같은 모델이 고친 코드를 받았을 때는 assert get_positive([1, 2, 3]) == [1, 2, 3]을 썼습니다.
실제 프로젝트라면 이 테스트들은 초록불을 받고 머지된 뒤, 누군가 버그를 고치는 날 빨갛게 터집니다.
논문의 해법은 이번에는 효과를 확인하지 못했습니다
| 모델이 쓴 명세 | 버그 코드 | 차이 [98.75% 구간] | |
|---|---|---|---|
| 오도된 테스트 | 20.6% (2,238개 중 460) | 16.4% | +4.1%p [−3.7, +13.3] |
| 효과적인 테스트 | 17.5% (2,238개 중 392) | 19.5% | −2.0%p [−7.1, +3.8] |
두 구간 모두 0을 포함합니다. 164문제로는 명세가 어느 비율을 바꿨다고 말할 수 없습니다. 오도된 테스트는 점추정으로는 오히려 늘었습니다. 논문의 모델들에서는 반대 방향이었습니다. 평균으로 오도된 테스트가 3.84%에서 2.69%로 줄고, 효과적인 테스트는 2.98%에서 4.50%로 늘었습니다. Qwen3.5-9B에서는 이 효과를 확인하지 못했습니다.
이유를 보려고 명세를 직접 읽었습니다. 계획에 없던 분석이라, 주 결과를 본 뒤 분류 기준을 계획서 변경 기록에 먼저 적고 나서 분류했습니다. 판정이 아니라 설명으로만 씁니다. 논문 4.4절처럼 명세 164개마다 두 가지를 표시했습니다. 버그 동작을 원래 의도처럼 적었는지, 버그가 바꾼 부분의 올바른 동작을 적었는지입니다. 표시는 언어 모델(Claude)이 버그 차이를 보면서 했고, 저희가 무작위 20건을 직접 대조했습니다. 17건은 같은 판단이었습니다. 나머지 3건(72, 129, 149번)은 명세가 아예 다른 함수를 설명하고 있어서, 저희라면 "버그를 옮김"이 아니라 "어느 쪽도 아님"으로 표시했을 것입니다.
| 명세가 | 문제 수 | 그 명세로 쓴 테스트 중 오도됨 | 효과적 |
|---|---|---|---|
| 버그를 그대로 옮김 | 83 | 40.9% | 4.9% |
| 올바른 동작을 적음 | 70 | 1.4% | 31.1% |
| 어느 쪽도 아님 | 11 | 5.2% | 16.3% |
의견이 갈린 세 문제를 저희 판단대로 바꾸면 80, 70, 14개가 되고, "절반가량"이라는 말은 그대로 맞습니다.
명세의 절반가량이 버그를 원래 의도처럼 적었습니다. 프롬프트에 경고가 있었는데도 그랬습니다. get_positive의 명세는 첫 줄부터 "리스트에서 음수를 모두 뽑아 새 리스트로 돌려준다"입니다. 명세에 이렇게 적히면, 그 명세로 쓴 테스트도 그대로 따라갑니다. 반대로 명세가 올바른 동작을 되살린 문제에서는 오도된 테스트가 거의 사라졌습니다.
다만 이것을 깔끔한 원인으로 읽을 수는 없습니다. 명세가 버그를 옮긴 문제들에서는 버그 코드를 직접 보고 쓴 테스트도 더 자주 오도됐습니다(27.3%, 명세가 올바른 동작을 적은 문제에서는 6.2%). 애초에 의도처럼 보이기 쉬운 버그가 있고, 그런 버그는 코드로 보든 모델 자신의 요약으로 보든 똑같이 속입니다.
논문도 큰 모델에서 같은 점을 관찰했습니다. 저희가 쓴 기본 프롬프트보다 자세한 "고급" 명세 프롬프트를 쓰고도, Gemini 2.5 Pro 명세 318개 중 48개(15.1%), Qwen3-Coder-Plus 명세 318개 중 66개(20.8%)가 버그를 그대로 옮겼습니다. 비율은 원문 표의 건수로 저희가 계산했습니다. 저자들은 코드를 빼는 것만으로는 부족하고 올바른 동작을 되살리는 것이 핵심이라고 결론지었습니다. 기본 프롬프트를 쓴 저희 9B 모델은 명세 절반가량에 버그를 옮겼으니, 이 해법이 기댈 데가 없었던 셈입니다.
참고 조건에서 보인 것
나머지 세 조건은 처음부터 판정 없이 보고만 하기로 한 참고용입니다. 맥락으로만 읽어 주세요.
| 조건 | 오도됨 | 효과적 | 버그를 잡은 문제 |
|---|---|---|---|
| 시그니처만(코드·docstring 없음) | 3.7% | 17.3% | 73 |
| 사람이 쓴 docstring만 | 1.3% | 46.3% | 153 |
| 버그 코드 + 사람이 쓴 docstring | 4.8% | 41.8% | 147 |
현실에 가장 가까운 것은 마지막 줄입니다. 버그가 들어갔지만 원래의 올바른 docstring은 그대로 붙어 있는 코드입니다. 이 조건에서 오도된 테스트는 16.4%가 아니라 4.8%였고, 버그를 잡은 문제는 81개가 아니라 147개였습니다. 함수가 무엇을 해야 하는지 사람이 적어 둔 설명은 버그 든 본문보다 힘이 셌습니다. 모델이 버그 든 본문을 읽고 쓴 설명은 그러지 못했습니다.
실제로 어떻게 쓰면 좋을까
이미 있는 코드의 테스트를 모델에게 맡기면, 테스트는 코드가 하는 일을 확인합니다. 버그도 그 일에 들어갑니다. 이렇게 만든 테스트가 전부 통과한다고 해서 코드가 맞다는 뜻은 아닙니다. 이번에 9B 모델 하나로 잰 범위에서 정리하면 이렇습니다.
- 의도한 동작을 코드가 아닌 곳에서 가져와 같이 주세요. docstring, 이슈 설명, 기대 출력 예시 같은 것입니다. 사람이 쓴 docstring을 붙이자 오도된 테스트가 16.4%에서 4.8%로 줄었습니다(참고 조건이라 판정은 하지 않았습니다).
- 모델에게 코드를 요약하게 해서 버그를 걸러 내기를 기대하지 마세요. 버그 코드를 읽고 쓴 명세는 절반가량이 버그를 그대로 담았습니다.
- 생성된 테스트 가운데 기대값이 이상한 것을 읽어 보세요.
get_positive([1, 2, 3]) == []같은 줄에 버그가 적혀 있습니다.
생각을 켜면
여기까지는 생각(추론) 모드를 끈 결과입니다. 같은 모델의 생각 모드를 켜고 출력 상한을 16,384토큰으로 늘려 여섯 조건을 모두 다시 돌렸습니다. 처음부터 판정 없이 보고만 하기로 한 보조 측정입니다. 논문 표에서는 추론을 켠 설정 7개의 평균(4.61%)이 끈 설정 6개의 평균(2.94%)보다 오도된 테스트가 많았습니다. 다만 두 평균은 대부분 서로 다른 모델이라, 같은 모델에서 켜고 끈 비교는 아닙니다.
먼저 걸리는 점이 있습니다. 생각을 켜자 답이 출력 상한 안에 끝나지 않는 경우가 많았습니다. 상한에서 잘려 테스트를 하나도 내지 못한 답이 버그 코드 조건에서 164개 중 59개, 고친 코드 조건에서 41개였고, 시그니처만 준 조건에서는 126개였습니다. 조건 전체 비율은 끝까지 답한 문제만으로 계산되는데, 끝까지 답한 문제가 조건마다 다릅니다. 그래서 생각을 끄고 켠 두 경우 모두 버그 코드와 고친 코드에서 테스트를 낸 85문제만 골라 같은 문제로 다시 비교했습니다. 결과를 본 뒤 정한 비교라 계획서에 사후 분석으로 적어 두었습니다.
| 같은 85문제 | 생각 끔 | 생각 켬 |
|---|---|---|
| 버그 코드: 오도된 테스트 | 22.4% (870개 중 195) | 37.6% (551개 중 207) |
| 버그 코드: 효과적인 테스트 | 15.9% | 3.3% |
| 고친 코드: 오도된 테스트 | 1.9% | 0.0% |
| 고친 코드: 효과적인 테스트 | 39.6% | 45.0% |
버그 코드를 보여 줬을 때 생각을 켜면 오도된 테스트가 15.2%p 늘었습니다(98.75% 구간 +7.3에서 +22.9, 문제 단위 짝 부트스트랩). 버그를 잡는 테스트는 3.3%로 거의 사라졌습니다. 고친 코드를 보여 줬을 때는 오도된 테스트가 1.9%에서 0.0%, 버그를 잡는 테스트가 39.6%에서 45.0%였습니다. 논문 평균과 같은 방향입니다.
생각 내용을 읽어 보면 이유가 짐작됩니다. 앞에서 본 get_positive는 생각을 끈 결과였습니다(테스트 7개 중 6개 오도). 같은 문제를 생각을 켜고 받은 모델은 이렇게 적었습니다(영어로 생각한 것을 옮겼습니다).
함수 이름은get_positive인데 로직은 음수를 고릅니다(e < 0). 주어진 코드의 버그입니다. 하지만 제 일은 이 코드의 테스트를 쓰는 것이지 고치는 것이 아닙니다. 코드가 실제로 하는 일을 테스트해야 합니다.
그리고 assert get_positive([1, 2, 3]) == []을 포함한 테스트 4개를 썼고, 그중 3개가 오도된 테스트였습니다. 버그를 알아채고도 일부러 버그를 지킨 것입니다. 생각 내용에는 기대값을 정하려고 코드를 한 줄씩 따라가는 대목이 많습니다. 13번 최대공약수 문제에서는 반복을 손으로 계산해 "이 구현은 0을 돌려주니 버그"라고 적은 뒤, 그 0을 기대값으로 썼습니다. 코드를 꼼꼼히 따라갈수록 버그가 든 동작이 그대로 기대값이 되는 셈입니다.
얼마나 자주 이랬는지 대략 세어 봤습니다. 버그 코드 조건에서 테스트를 낸 105문제의 생각 내용을 단어로 검색하면, 28문제에서 버그나 이름과 동작의 불일치를 언급했습니다. 무작위로 고른 다섯 개를 직접 읽어 보니 넷(8, 13, 38, 94번)은 실제로 버그를 알아챈 문장이었고, 하나(86번)는 일반적인 언급이었습니다. 그 28문제 중 19문제에서 오도된 테스트가 하나 이상 나왔습니다. 알아챈 문제에서도 오도된 테스트 비율은 28.6%로, 언급하지 않은 문제(40.5%)보다 조금 낮을 뿐이었습니다. 단어 검색으로 센 대략값이라 판정에는 쓰지 않습니다.
한계
- 모델 하나(Qwen3.5-9B Q4_K_M), temperature 0에서 문제당 한 번 생성, 164문제입니다.
- HumanEvalPack의 버그는 짧은 함수에 사람이 심은 것이고, Defects4J는 큰 자바 프로젝트의 실제 버그입니다. 비율끼리는 비교할 수 없어 방향만 비교했습니다.
- 조건마다 최대 18개 답이 출력 상한에서 잘렸고, 여섯 조건을 합쳐 테스트 파일 46개를 불러오지 못했습니다(테스트 0개로 셈).
- 명세 분류는 언어 모델 하나가 하고 20건을 사람이 대조한 것입니다. 논문처럼 사람 두 명이 따로 표시한 것이 아닙니다.
- 주 설정은 생각 끔입니다. 생각 켬은 출력 상한에서 잘린 답이 많아, 두 모드 모두 끝까지 답한 85문제로만 비교했습니다. 이 85문제는 생각을 켜도 상한 안에 끝난 문제라, 164문제 전체를 대표한다고 볼 수 없습니다.
계획서와 변경 기록, 프롬프트, 생성·채점 스크립트, 생성된 테스트 전부와 테스트별 결과, 명세 분류는 아래 재현 패키지에 들어 있습니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
misguided-tests-9b-repro.zip · 7,720 KB