로컬 모델이 짜 준 테스트가 내 버그를 지키고 있는지, 10분이면 알 수 있습니다
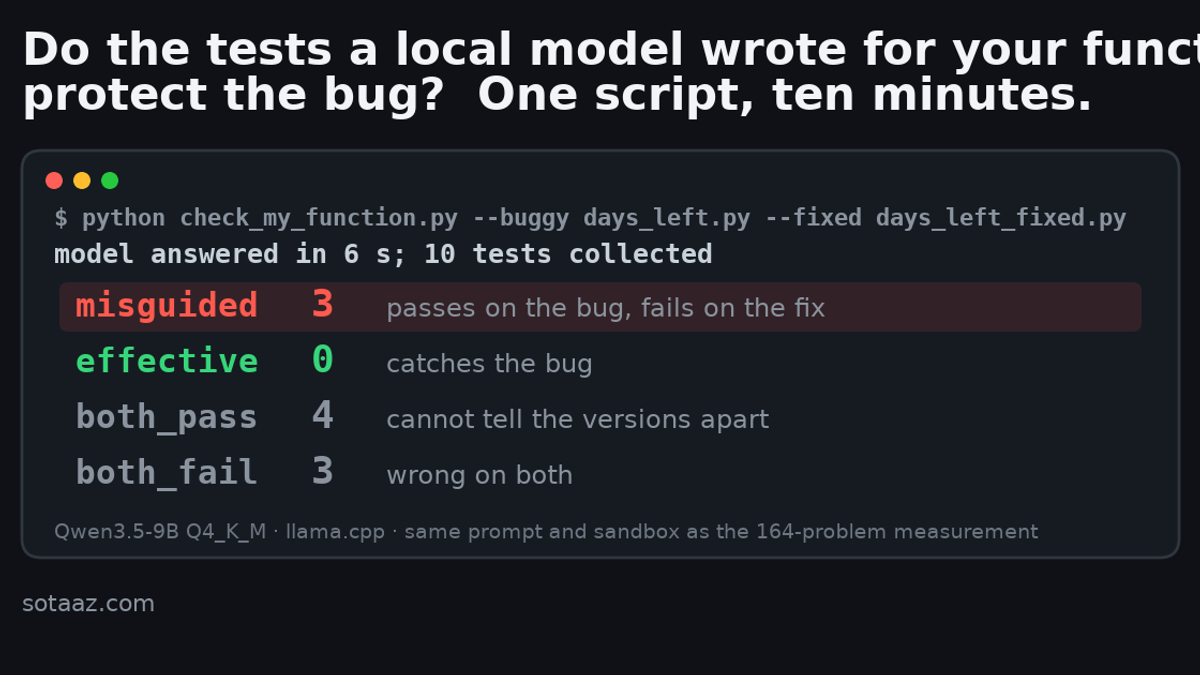
스크립트 하나, 함수 두 판본, 로컬 모델 하나. 지금 버전만 보여 주고 pytest 테스트를 받아서 두 판본에 다 돌려 보면, 오늘은 통과하다가 버그를 고치는 날 깨질 테스트가 어느 것인지 나옵니다. 마감일을 하루 적게 세는 함수에 Qwen3.5-9B가 6초 만에 테스트 10개를 썼고, 그중 3개가 버그를 정답으로 적었고 버그를 잡는 테스트는 없었습니다. 164문제 측정과 같은 프롬프트, 같은 채점기입니다.
로컬 모델이 짜 준 테스트가 내 버그를 지키고 있는지, 10분이면 알 수 있습니다
아래 함수를 로컬 모델에게 주고 pytest 테스트를 써 달라고 했습니다. 6초 만에 열 개가 나왔습니다. 그중 셋은 "마감일 당일은 세지 않는다"고 단정합니다. 그게 바로 버그입니다. 열 개 가운데 버그 버전에서는 깨지고 고친 버전에서는 통과하는 테스트, 그러니까 버그를 잡아 주는 테스트는 하나도 없었습니다. 이 테스트를 오늘 돌리면 일곱 개가 통과합니다(나머지 셋은 두 판본에서 다 실패합니다). 함수를 고치는 날 그 일곱 중 셋이 빨개지면서 "고친 게 틀렸다"고 말할 겁니다.
def days_left(today: date, deadline: date) -> int:
    """Days remaining until the deadline, inclusive of the deadline day. 0 when the deadline has passed."""
    diff = (deadline - today).days
    if diff < 0:
        return 0
return diff # 버그: 마감일 당일을 안 셈. diff + 1 이어야 함(# 버그 주석은 독자용입니다. 모델에게는 이 주석 없이, 영어 docstring이 붙은 파일 그대로 갔습니다.)
지난주에 이걸 164문제로 쟀습니다. docstring 없이 버그 있는 본문만 보여 주면 Qwen3.5-9B가 쓴 테스트의 16.4%가 버그에서는 통과하고 고친 코드에서는 깨졌습니다. 고친 본문을 보여 주면 2.6%였습니다. 위 함수는 docstring이 붙은 채로 들어갔으니, 측정에서 견줄 조건은 "버그 본문 + 사람이 쓴 docstring"이고 그 평균은 4.8%입니다. 열 개 중 셋은 그 조건에서 한 번 뽑은 결과이지 16.4% 쪽이 아닙니다. 이 글은 그 측정을 내 함수 하나에 10분 안에 적용하는 방법입니다. 프롬프트는 그때 그대로이고, 샌드박스도 같은 방식입니다.
준비물
- 함수 하나를 두 파일로. 지금 버전(
my_func.py)과 맞다고 믿는 버전(my_func_fixed.py). 모델은 첫 번째만 봅니다. 가장 자연스러운 재료는 git 기록입니다. 이미 고친 버그 하나를 골라 고치기 전 커밋과 후 커밋에서 함수를 꺼내면, 모델이 쓴 테스트를 내 코드에서 믿어도 되는지 시험할 짝이 생깁니다. 고친 버전이 없으면 맞다고 생각하는 쪽을 써 두세요. 테스트가 두 판본을 가려내느냐가 핵심입니다. - OpenAI 호환 주소로 떠 있는 로컬 모델. 저희는 llama.cpp의
llama-server에 Qwen3.5-9B Q4_K_M(5.7GB 파일)을 씁니다. Ollama나 LM Studio도 같은 주소 형식을 냅니다. - Python 3와
pytest. 그게 전부입니다. - 글 끝 재현 패키지의
tutorial/check_my_function.py. 109줄이고, 프롬프트는 측정 코드 그대로, 샌드박스는 같은 방식에 단순화 하나(아래에 적음)입니다.
돌리기
서버를 띄웁니다(측정 때 쓴 옵션 그대로입니다).
llama-server -m Qwen3.5-9B-Q4_K_M.gguf -ngl 99 -fa on --parallel 1 -c 20480 --jinja --port 8080그다음:
python check_my_function.py --buggy my_func.py --fixed my_func_fixed.py --name my_func \
    --server http://127.0.0.1:8080 --save test_generated.py
순서는 이렇습니다. 지금 버전을 저희가 재현한 논문의 요청문("branch와 line coverage를 최대로 하는 pytest 테스트를 써 달라", temperature 0, 생각 끔, 최대 4,096 토큰)과 함께 보냅니다. 답에서 코드 블록을 꺼냅니다. 임시 폴더에 두 판본을 각각 solution.py로 두고 pytest를 두 번 돌립니다(네트워크 차단, 테스트 파일 전체에 120초 제한. 측정 채점기는 시간이 넘으면 테스트 하나씩 10초로 다시 돌렸는데, 이 스크립트에는 그 단계가 없습니다). 테스트마다 네 칸 중 하나에 넣습니다.
위 함수로 돌리면 이렇게 나옵니다.
model answered in 6 s (finish_reason=stop); 10 tests collected
  misguided    3   test_deadline_leap_year, test_deadline_today, test_deadline_tomorrow
  effective    0
  both_pass    4   test_deadline_far_past, test_deadline_leap_year_past, test_deadline_past, test_deadline_same_day_different_year
  both_fail    3   test_deadline_far_future, test_deadline_future, test_deadline_next_year
misguided tests assert the current behaviour as correct. If your current version is the buggy one, these tests would pass today and fail after the fix.
네 칸 읽는 법
- misguided: 지금 버전에서 통과, 고친 버전에서 실패. 테스트가 버그를 정답으로 받아 적은 겁니다.
test_deadline_today는days_left(today, today) == 0이라고 단정하는데, docstring대로면 당일을 세니까 1이 맞습니다. - effective: 지금 버전에서 실패, 고친 버전에서 통과. 원했던 테스트입니다. 여기가 0이면 이 테스트 묶음은 이 버그를 못 잡습니다.
- both_pass: 두 판본을 가리지 못합니다(여기서는 마감이 지난 경우들. 두 판본 다 0을 돌려줍니다).
- both_fail: 둘 다 틀립니다. 이번 실행에서는 날수를 잘못 센 테스트 셋이었는데, 코드 문제가 아니라 모델이 날짜를 잘못 센 겁니다.
봐야 할 건 첫 줄과 둘째 줄입니다. misguided가 0보다 크고 effective가 0이면, 그 테스트들은 버그까지 포함한 현재 동작의 스냅숏입니다. 커버리지는 멀쩡하다고 할 겁니다.
이렇게 나오면 할 일
코드가 아닌 곳에서 나온 "의도"를 모델에게 주세요. 측정에서 버그 본문에 사람이 쓴 docstring을 붙이자 misguided 테스트가 16.4%에서 4.8%로 줄고 effective 테스트는 19.5%에서 41.8%로 늘었습니다. 위 함수는 이미 docstring이 붙은 채였는데도 모델은 세 테스트에서 그 반대로 단정했습니다. 4.8% 평균이 함수 하나에서는 이렇게 보입니다. 믿을 숫자는 164문제 평균입니다. 도움이 안 된 것도 있습니다. 모델에게 버그 코드로 명세부터 쓰게 하고 그 명세로 테스트를 짜게 하는 방법(misguided 20.6%, 나아진 게 없음), 그리고 생각 모드(두 모드가 다 끝낸 85문제에서 22.4%→37.6%. 생각 과정에서 버그를 알아채고도 그대로 단정하는 경우가 많았습니다).
그러니 순서는 이렇습니다. 스크립트를 돌리고, misguided가 나오면 본문 대신 명세(docstring, 이슈 글, 기대 출력 예시 하나)를 모델에게 주고 다시 돌립니다. 같은 두 파일을 쓰면 되고, 코드 없는 조건을 원하면 my_func.py에 docstring만 두고 본문을 비우세요.
한계
모델 하나(llama.cpp의 Qwen3.5-9B Q4_K_M), temperature 0, 호출당 생성 한 번이라 다른 모델이나 두 번째 실행은 다르게 나올 수 있습니다. 예시는 함수 하나이고, 인용한 비율은 사람이 심은 버그 164문제에서 나온 값이지 실제 코드베이스에서 나온 값이 아닙니다. 스크립트는 채점할 고친 버전이 있어야 하니, 이미 버그를 의심하고 있을 때 쓰는 도구입니다. 모르는 버그를 찾아 주는 게 아니라, 테스트가 그 버그를 말해 줬을지를 보여 줍니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
misguided-tests-9b-repro.zip · 7,725 KB