Unsloth로 결정 모델을 직접 학습해 봤습니다: BANKING77 75%, 학습에서 빼면 56%
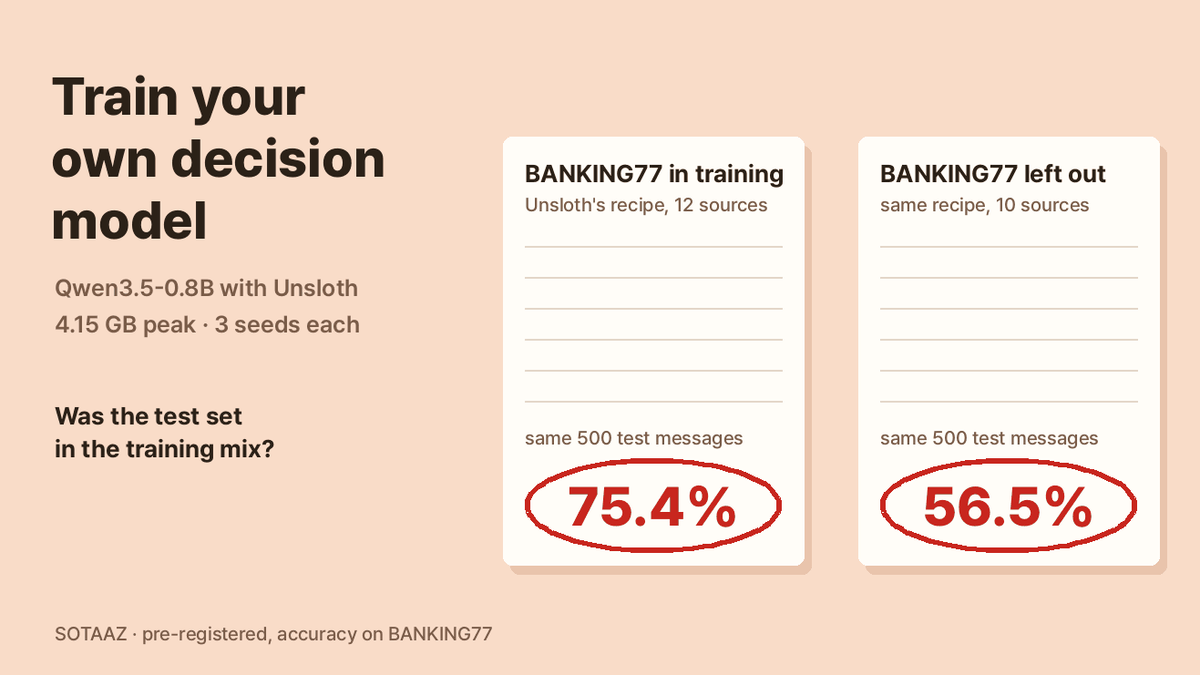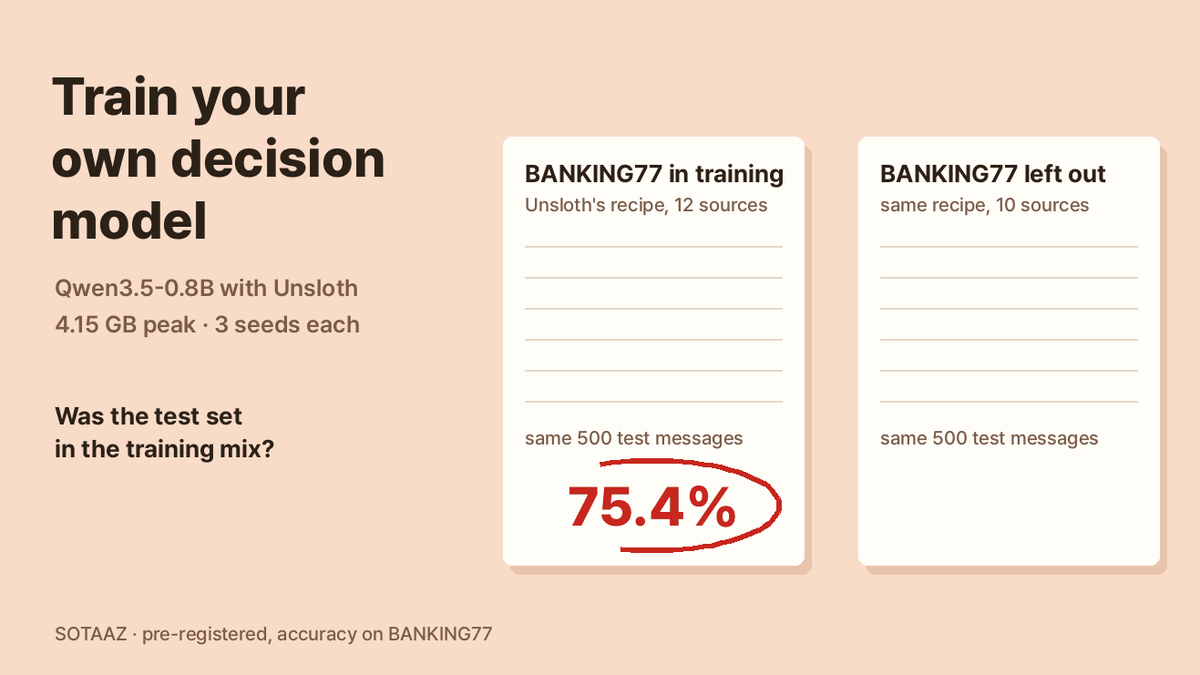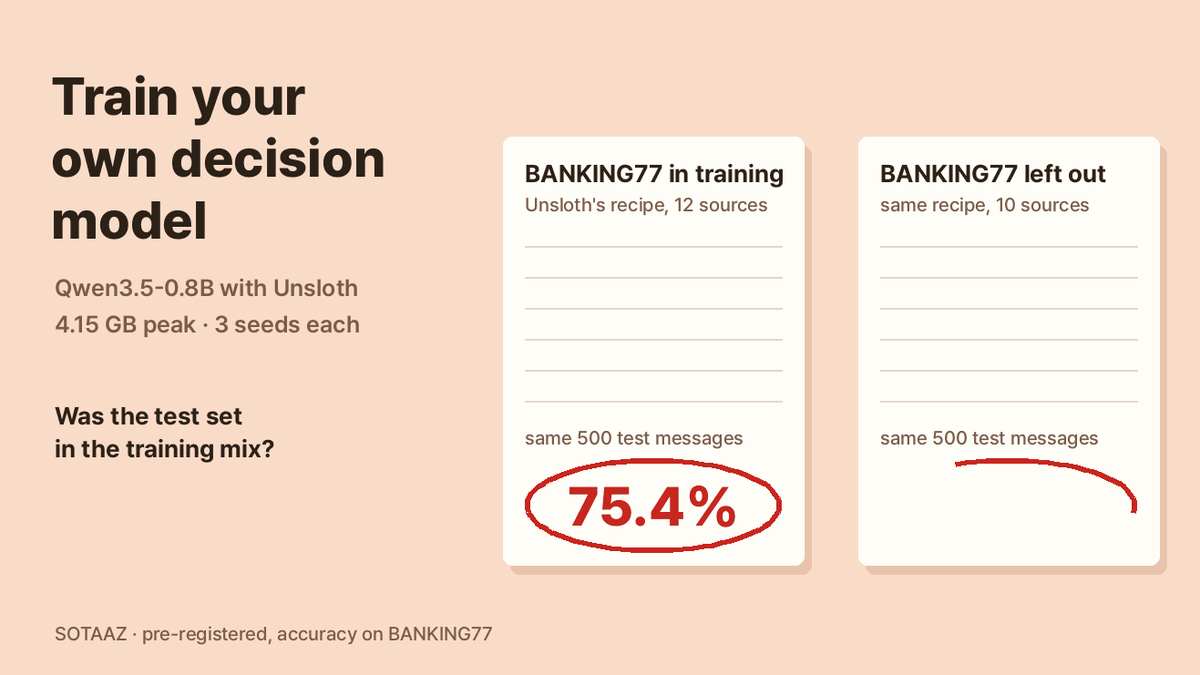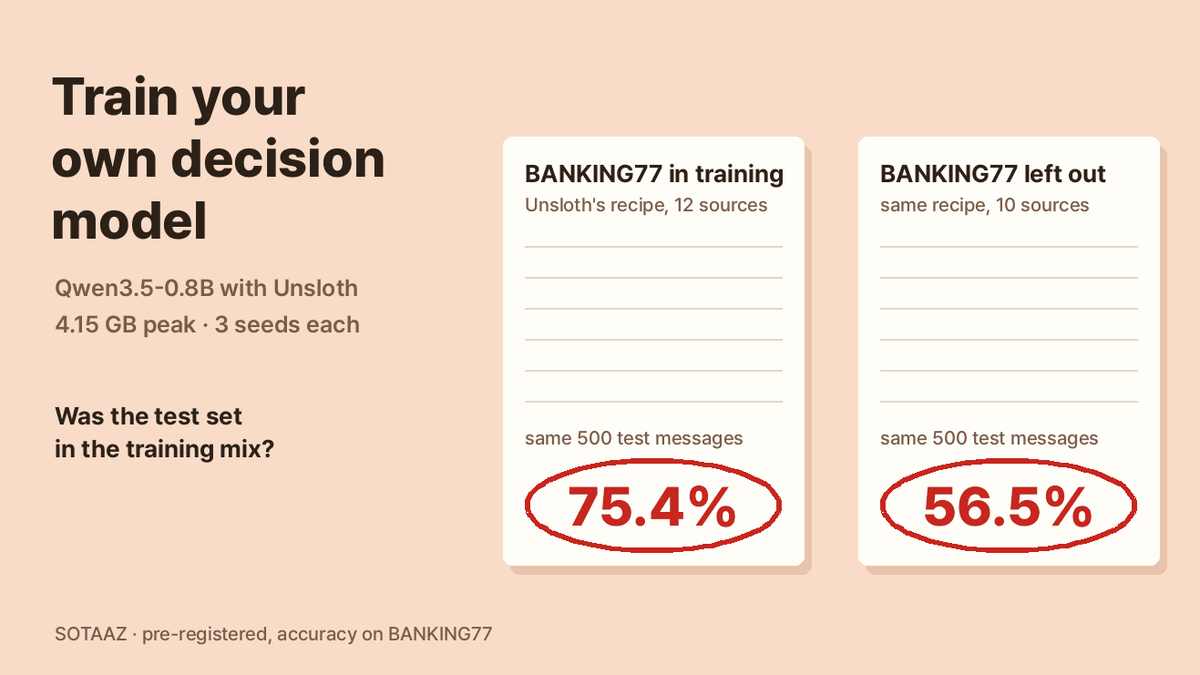
Unsloth가 공개한 방법대로 Qwen3.5-0.8B를 결정 모델로 학습했습니다(최대 메모리 4.15GB, GPU를 나눠 쓴 상태에서 한 번에 20분 안팎). BANKING77과 CLINC150은 Unsloth 표와 거의 같게 나왔지만(75.4%, 75.0%), 두 시험 데이터셋은 학습 데이터에도 들어 있었습니다. 두 데이터셋을 학습에서 빼자 같은 500문장에서 56.5%와 55.9%였습니다. typed-decisions는 표보다 11.8%p 낮았습니다. 학습 스크립트의 오염 제거 단계가 이 데이터셋의 학습 사례 1,200건 중 850건을 버리는데, 사후 실행에서 이 사례를 남기자 74.3%가 나왔습니다.
Unsloth로 결정 모델을 직접 학습해 봤습니다: BANKING77 75%, 학습에서 빼면 56%
결정 모델은 입력 하나와 그에 대한 질문 몇 개를 받아서, 글을 쓰는 대신 미리 준 선택지 중 하나를 고르고 얼마나 확신하는지 확률로 알려 주는 모델입니다. "이 문의는 결제·기술·영업 중 어느 팀이 맡아야 하나요?"라고 물으면 billing이라는 답과 확률이 돌아옵니다. 저희 블로그에서는 이런 모델을 여러 번 재 봤는데, 대부분 남이 학습한 모델이었습니다.
이번 주 Unsloth가 평범한 언어 모델을 결정 모델로 바꾸는 가이드를 냈습니다. 학습 코드는 10월 7일 Unsloth에 들어갔습니다. 가이드의 표를 보면 Qwen3.5-0.8B가 GPU 메모리 4GB 정도로 BANKING77(은행 문의 의도 77가지)에서 7%에서 74%로, CLINC150(의도 150가지와 '해당 없음')에서 19%에서 76%로 올라갑니다. Unsloth가 직접 잰 숫자입니다.
작은 분류기를 직접 만들고 싶은 사람에게는 반가운 숫자라서 저희도 해 봤습니다. 그런데 가이드와 코드를 같이 읽다 보니 표에 드러나지 않는 점이 하나 보였습니다. BANKING77과 CLINC150이 둘 다 학습 데이터에 들어 있었습니다. 가이드는 시험 데이터를 학습 데이터 기준으로 "오염 제거"했다고 적었는데, 그것이 어디까지를 걸러 내는지 확인하고 싶었습니다.
그래서 학습을 시작하기 전에 질문 세 개와 판정 기준, 결과별로 쓸 문장을 정해 두었습니다.
- 재현. Unsloth의 학습 스크립트를 기본값 그대로 쓰면 표의 숫자가 나오는가.
- 학습 범위. BANKING77과 CLINC150을 학습에서 빼면 같은 시험 문장에서 정확도가 얼마나 달라지는가.
- 써 보기. 학습한 모델을 저장해 저희가 만든 문제 몇 개를 물어봅니다. 이것은 시연이고, 판정하지 않습니다.
어떻게 학습했나
가이드에는 설정이 두 가지 나옵니다. 표 옆에는 LoRA 랭크 64로 한 번(1 epoch) 학습했다고 적혀 있고, 아래 코드 예시에는 "epoch 2, 랭크 16"이라고 적혀 있습니다. 다만 코드 예시는 4B 모델을 데이터셋 하나로 학습하는 다른 상황입니다. Unsloth 저장소의 학습 스크립트(scripts/train_decision_from_lm.py)가 앞쪽과 맞습니다. 기본값이 랭크 64, 1 epoch이고, 가이드가 나열한 공개 데이터셋 12개에서 12,000행을 섞으며, 시험 세트도 가이드와 같습니다(typed-decisions 결정 2,000개, BANKING77과 CLINC150 각 500문장). 저희는 Unsloth 저장소의 d632c82b 버전에 있는 이 스크립트를 고치지 않고 썼습니다.
- 모델:
unsloth/Qwen3.5-0.8B, 16비트(스크립트 기본값이라 4비트 로드는 쓰지 않았습니다) - 학습 데이터: 공개 데이터셋 12개에서 1,000행씩, 그리고 업무 판단 벤치마크인 typed-decisions. 한 번에 16행씩 755스텝입니다.
- 장비: A100 80GB 한 장을 다른 학습과 나눠 썼습니다. 나눠 쓴 상태에서 한 번 학습에 17-21분이 걸렸는데, 이 때문에 시간은 대략적인 값이라 실행끼리 비교하지 않습니다. PyTorch가 잡은 최대 메모리는 4.15GB로, 가이드의 4GB와 비슷했습니다.
- 시드: 조건마다 3407(스크립트 기본값), 1, 2. 시험 문장은 모든 실행에서 같습니다.
- 판정 기준: 시드 세 개로 구한 표준오차의 두 배를 넘을 때만 차이가 있다고 봅니다. 재현은 평균이 표와 3%p 안이면 맞은 것으로 봅니다.
Unsloth를 설치한 뒤라면 직접 해 보는 데 명령 한 줄이면 됩니다.
python scripts/train_decision_from_lm.py --model unsloth/Qwen3.5-0.8B \
  --sources banking77,clinc150,mnli,snli,wanli,boolq,ag_news,sst5,mmlu,commonsense_qa,arc,prompt_injections \
  --out my-decision-model
데이터셋 12개를 직접 적는 이유가 있습니다. 스크립트 기본 목록에는 13번째 데이터셋이 하나 더 있는데, Hugging Face에서 이용 약관에 동의해야 받을 수 있는 데이터셋이라 동의하지 않은 계정에서는 한 줄 메시지만 남기고 건너뜁니다. 그래서 같은 명령도 컴퓨터마다 다른 데이터로 학습할 수 있습니다.
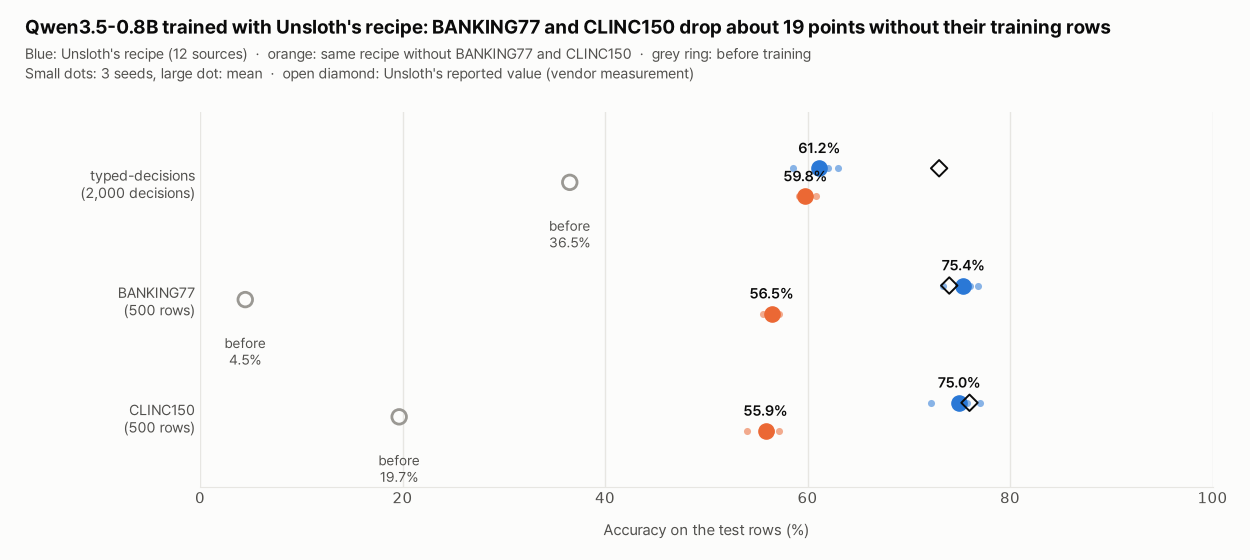
1. 표의 숫자 셋 중 둘은 그대로 나왔습니다
| 시험 세트 | 학습 전 | 학습 후(시드 3개 평균) | Unsloth 표 |
|---|---|---|---|
| typed-decisions(결정 2,000개) | 36.5% | 61.2% | 73% |
| BANKING77(500문장) | 4.5% | 75.4% | 74% |
| CLINC150(500문장) | 19.7% | 75.0% | 76% |
학습 전 숫자는 표의 출발점(36%, 7%, 19%)과 비슷합니다. 학습 뒤 BANKING77과 CLINC150은 표와 1.4%p 안으로 들어왔습니다. typed-decisions는 11.8%p 낮아 정해 둔 3%p를 벗어났으니, 재현은 세 세트 중 두 세트에서만 됐습니다.
원인을 먼저 데이터에서 찾았습니다. typed-decisions 데이터 파일은 가이드보다 3주 앞선 9월 16일 이후 바뀌지 않았으니, 데이터셋이 새 버전이라서 생긴 차이는 아닙니다. 원인은 학습 방법 안에 있었고, 3절에서 다룹니다.
표의 네 번째 열 "Holdout 78%"는 저희 실행에서 82.1%였습니다. 이 숫자는 학습 데이터에서 10%를 떼어 두고 잰 값이라, BANKING77과 CLINC150 문장도 섞여 있습니다.
2. BANKING77과 CLINC150을 학습에서 빼면
가이드는 시험 데이터를 학습 데이터 기준으로 오염 제거했다고 적었습니다. 코드를 보면 시험 문장과 13단어가 연속으로 겹치는 학습 행을 버리는 처리입니다. 그런데 BANKING77과 CLINC150 문장은 짧습니다. 중앙값이 10단어와 9단어이고, 시험 문장 500개 중 332개와 430개가 13단어보다 짧습니다. 그래서 이 검사는 사실상 단어까지 똑같은 문장만 거릅니다. 스크립트가 데이터셋마다 뽑는 후보 2,000행에서 실제로 빠진 것은 BANKING77 3행, CLINC150 0행이었습니다. 나머지 학습 행 1,000개는 시험 문장과 같은 라벨 체계를 단 채 학습에 그대로 들어갑니다.
같은 데이터셋 안에서 잰 정확도를 보고하는 방법으로는 문제가 없습니다. 다만 모델이 처음 보는 과제에서의 정확도와는 다른 것을 잽니다. 그래서 같은 방법을 한 번 더 돌리되, 학습 데이터 목록에서 두 데이터셋만 뺐습니다. 전체 12,000행은 그대로 두었으니 나머지 데이터셋 10개가 1,000행 대신 1,200행씩 들어갔습니다.
| 시험 세트 | Unsloth 방법 | 두 데이터셋 제외 | 차이 | 표준오차의 두 배 |
|---|---|---|---|---|
| BANKING77 | 75.4% | 56.5% | -18.9%p | 2.3 |
| CLINC150 | 75.0% | 55.9% | -19.1%p | 3.5 |
| typed-decisions | 61.2% | 59.8% | -1.4%p | 2.9 |
의도 분류 두 세트는 19%p 안팎 떨어졌고, 시드가 바뀌어서 생기는 흔들림보다 훨씬 큽니다. 두 조건 모두 학습한 typed-decisions는 흔들림 이상으로 달라지지 않았습니다.
표의 BANKING77·CLINC150 숫자는 같은 데이터셋으로 학습한 결과입니다. 학습에서 빼면 둘 다 56% 안팎이었습니다. 그렇다고 56%가 하찮은 숫자는 아닙니다. 학습 전 BANKING77은 4.5%였고, 77가지 의도 중 아무거나 고르면 1.3%입니다. 나머지 데이터셋 10개로부터 의도 분류를 꽤 배운 셈입니다. 직접 다루는 과제가 학습에 없던 의도를 분류하는 일이라면 56% 쪽이 더 가까운 예상치입니다.
3. typed-decisions가 낮게 나온 이유
같은 13단어 검사가 typed-decisions에도 적용되는데, 여기서는 사정이 다릅니다. typed-decisions의 입력은 틀에 맞춰 만든 JSON 기록이라, 학습 사례와 시험 사례가 필드 이름과 상투 문구를 길게 공유하는 일이 많습니다. 학습 사례 1,200건 중 이 검사가 버리는 수를 세어 봤습니다.
| typed-decisions 업무 | 버려진 학습 사례 |
|---|---|
| 에이전트 실행 기록 검토 | 300건 중 300건 |
| 청구서 처리 | 300건 중 300건 |
| 보안 사고 | 300건 중 210건 |
| 고객 상담 | 300건 중 40건 |
시험 입력과 완전히 똑같은 학습 입력은 하나도 없었습니다. 그런데도 검사를 거치고 나면 모델은 에이전트 기록 검토와 청구서 처리 사례를 하나도 보지 못한 채 학습하고, 이 두 업무가 typed-decisions 시험의 절반입니다. 에이전트 기록 검토 쪽은 시험에 나오는 작업 문장이 모두 학습 데이터에도 있는데, 데이터셋이 같은 작업을 여러 기록에 재사용하도록 만들어져 있기 때문입니다.
11.8%p 차이의 유력한 원인이지만, 결과를 보고 나서 찾은 것이라 따로 시험했고 사후 분석으로 표시합니다. Unsloth 방법에서 한 가지만 바꿨습니다. typed-decisions 학습 사례는 BANKING77·CLINC150 시험 문장 기준으로만 검사해서 1,200건을 모두 남겼습니다. 데이터셋이 직접 나눈 학습·시험 분할을 그대로 따르는 설정이고, 데이터셋 소개 페이지가 "학습 분할로 학습한 모델"을 비교할 때 쓰는 분할과 같습니다.
| 시험 세트 | Unsloth 방법 | 1,200건 모두 유지(사후) | 차이 | 표준오차의 두 배 | Unsloth 표 |
|---|---|---|---|---|---|
| typed-decisions | 61.2% | 74.3% | +13.1%p | 2.8 | 73% |
| BANKING77 | 75.4% | 75.7% | +0.3%p | 2.2 | 74% |
| CLINC150 | 75.0% | 73.0% | -2.0%p | 5.6 | 76% |
850건을 남기자 typed-decisions가 13.1%p 올라 74.3%가 됐고, Unsloth 표와 1.3%p 차이입니다. BANKING77과 CLINC150은 시드에 따른 흔들림 이상으로 달라지지 않았습니다. CLINC150 평균은 공교롭게도 표보다 정확히 3%p 낮아, 정해 둔 기준의 경계에 걸립니다.
이 사례들을 남기면 표와 1.3%p 안으로 맞는다는 점은, Unsloth의 표가 이 사례들이 학습에 들어간 실행에서 나왔다는 설명과 들어맞습니다. 다만 저희는 한 가지만 바꿔 봤고 Unsloth의 실행을 볼 수도 없으니, 실제로 그랬다고 단정하지는 않습니다. 말할 수 있는 것은 이것입니다. 지금 공개된 방법 그대로 학습하면 typed-decisions는 61% 근처가 나오고, 이 사례들을 남기면 표 근처가 나옵니다.
4. 만든 모델 써 보기
방법 그대로 한 번 더 학습해 모델을 저장하고, 실행 전에 미리 적어 둔 문제 다섯 개를 물어봤습니다. 측정이 아니라 한 건씩의 예시입니다.
| 입력 | 질문 | 답 |
|---|---|---|
| "청구서 #4411이 두 번 결제됐습니다. 중복분을 오늘 환불해 주세요."(영어) | 결제·기술·영업 중 어느 팀? | 결제, 99.4% |
| 같은 문의를 한국어로 | 같은 질문 | 결제, 99.9% |
| 측정값을 공유하면서 GPU 할인 사이트 링크를 단 블로그 댓글 | 홍보성 스팸인가? | 예, 55.7% |
| 배포 로그: 헬스 체크 40개 중 3개 실패, 오류율 0.1%에서 2.4%로 상승 | 심각도: 영향 없음 / 내일 처리 / 오늘 처리 / 당직자 호출 | "오늘 처리", 79.6%(당직자 호출 19.4%) |
| "2주 전에 새 카드를 주문했는데 아직 안 왔어요."(영어) | 저희가 정한 의도 세 개 | 카드 배송, 99.2% |
한국어 문의는 영어 데이터로만 학습한 모델이 한 문장을 맞힌 것이라, 한국어가 된다는 뜻으로 읽으면 안 됩니다. 스팸 댓글은 실제 측정값과 광고가 섞인 글이었고, 답도 55.7%로 반반에 가까웠습니다.
저장하면서 하나 더 알게 된 것이 있습니다. 저장용 실행은 측정한 실행 하나와 시드와 인자가 똑같았는데도 typed-decisions가 3.3%p 낮고 BANKING77이 3.4%p 높았습니다. 이 환경에서는 GPU 학습이 비트 단위로 똑같이 반복되지 않으니, 한 번 돌린 숫자는 몇 %p 움직일 수 있습니다. 작은 차이를 믿기 전에 여러 번 학습해 보세요.
직접 학습할 때 확인할 것
- 시험 데이터셋이 학습 데이터에 들어 있지 않은가. 스크립트 기본 학습 데이터에는 BANKING77과 CLINC150이 있고, "오염 제거"는 거의 같은 문장만 거릅니다. 학습에서 뺀 데이터로 평가하세요.
- 오염 제거 뒤에 학습 행이 몇 개 남았는가. 스크립트가 행 수를 출력합니다. typed-decisions는 1,200건 중 350건만 남았는데, 그냥 지나치기 쉬웠습니다.
- 접근 승인이 필요한 데이터셋을 건너뛰지 않았는가. 데이터셋 목록을 직접 적어 두면 어느 컴퓨터에서나 같은 데이터로 학습합니다.
- 시드를 하나만 돌리지 않았는가. BANKING77은 시드 세 개 사이에서 73.4%부터 76.8%까지 움직였습니다.
다루지 못한 것
- 모델은 Qwen3.5-0.8B 하나, 설정은 Unsloth 스크립트 기본값 하나뿐입니다. 더 큰 모델이나 더 긴 학습에서는 숫자가 모두 달라질 수 있습니다.
- 조건마다 시드 세 개라 3%p보다 작은 차이는 가릴 수 없습니다.
- 두 데이터셋을 뺀 실행에서는 나머지 데이터셋이 1,000행 대신 1,200행씩 들어갔습니다. 변화의 일부는 이 때문일 수 있지만, 두 세트에서 똑같이 나온 19%p 하락을 설명하기에는 부족합니다.
- 의도 분류는 데이터셋마다 시험 문장 500개이고, 모든 실행이 같은 문장을 씁니다.
- typed-decisions 원인 분석은 사후이고, 이를 시험한 실행은 한 가지만 바꿨습니다. 다른 가능한 원인은 따로 시험하지 않았습니다.
- 써 보기 결과는 한 건씩의 예시입니다.
계획, 스크립트, 실행별 결과와 로그는 아래 재현 패키지에 있습니다. 더 큰 모델로 학습하거나, 라벨 편향 글에서 본 "라벨을 읽는 습관"이 직접 학습한 모델에도 있는지 재 보면 뉴스레터로 알려 드리겠습니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
train-decision-model-unsloth-repro.zip · 172 KB