laya는 정의를 읽을까, 라벨을 읽을까: 라벨 편향 실험을 다시 돌려 봤습니다
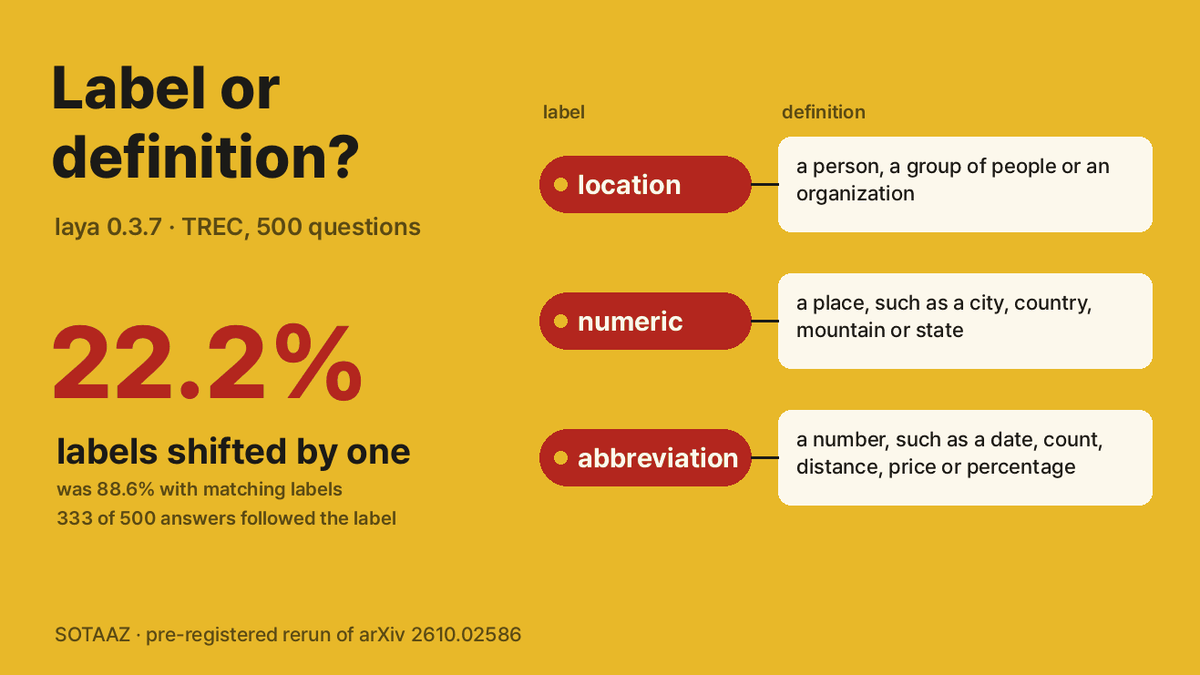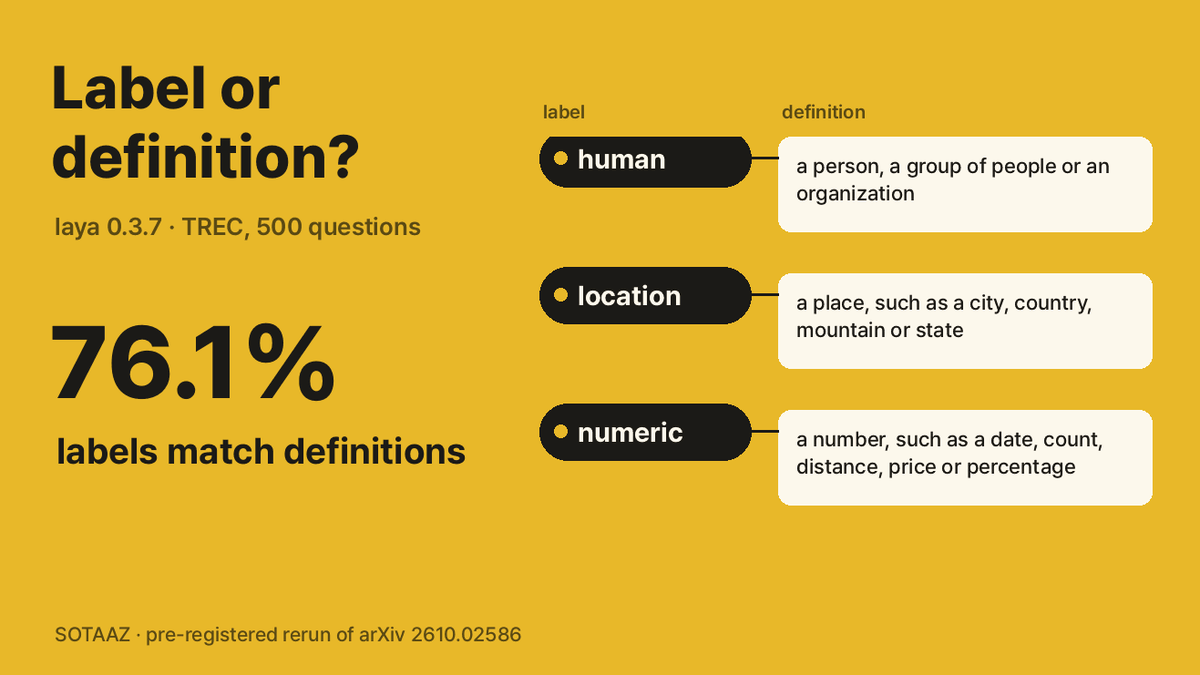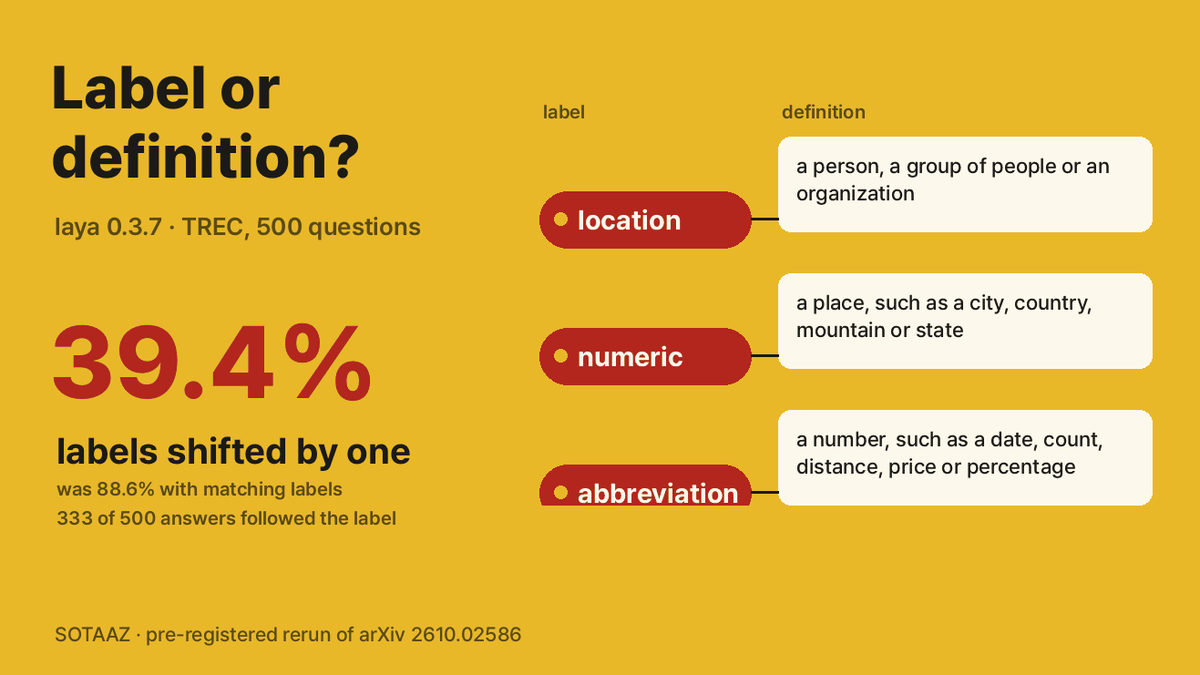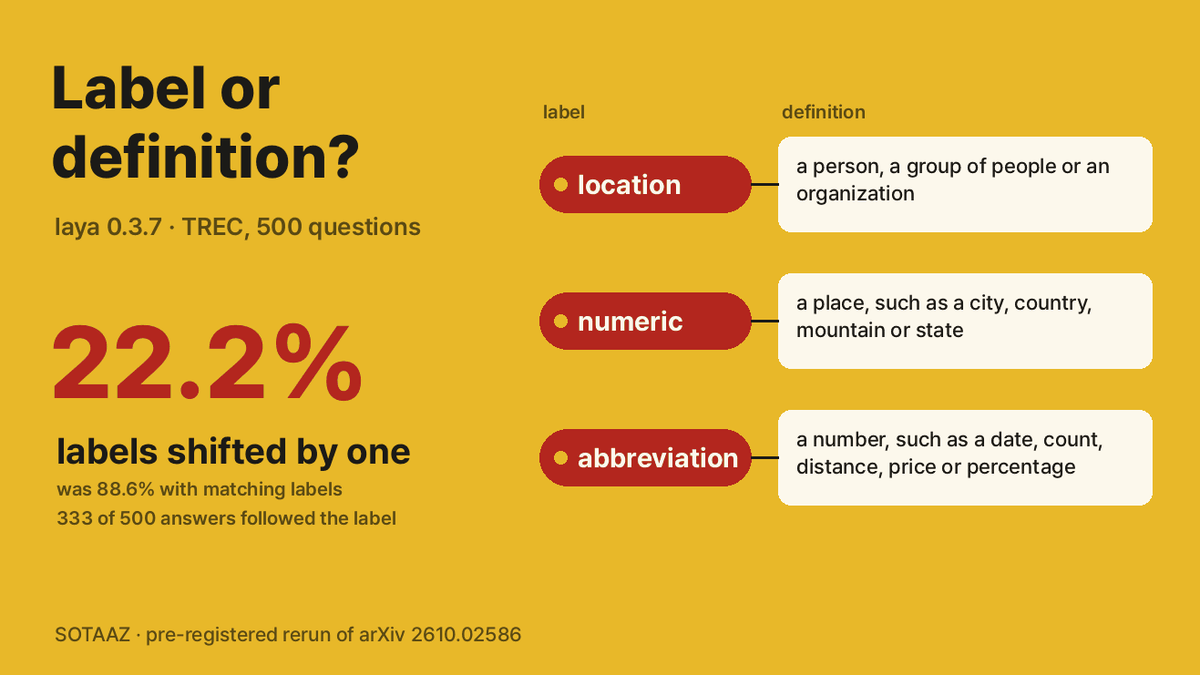
선택지 라벨이 정의를 이긴다는 arXiv 2610.02586의 실험을 laya 0.3.7 체크포인트 두 개와 저희 TREC·AG News 데이터로 다시 쟀습니다. 옵션 문자열을 만드는 코드 한 줄을 바꾸자 라벨 이름과 상관없이 예측이 한 건도 달라지지 않았습니다. 라벨을 정의와 어긋나게 붙이면 laya의 TREC 정확도는 88.6%에서 22.2%로 떨어졌고, 최고 확률은 맞은 답과 틀린 답을 거꾸로 줄 세웠습니다(AUROC 0.36). 논문이 보고한 것과 같은 방향입니다.
laya는 정의를 읽을까, 라벨을 읽을까: 라벨 편향 실험을 다시 돌려 봤습니다
Jev 같은 결정 모델에는 선택지마다 짧은 라벨과 정의를 함께 넘깁니다. 예를 들어 human이라는 라벨에 "사람, 사람들의 집단, 조직"이라는 정의를 붙이는 식입니다. 개발자가 규칙을 적는 곳은 정의입니다. 그런데 10월 1일에 올라온 논문 하나는 공개 구현체들이 그 정의를 거의 읽지 않는다고 주장합니다.
Azizi, Baghaei Potraghloo, Pedram의 논문(arXiv 2610.02586) 초록에는 이런 문장이 있습니다. "Deleting every definition leaves accuracy unchanged (laya-td: 0.8559 against 0.8487)." 원인으로 지목한 곳은 모델 가중치가 아니라 옵션 문자열을 만드는 코드입니다. laya는 선택지를 "{label}: {definition}"으로 쓰고, 영향을 받지 않은 von은 정의만 씁니다. 이 표현 하나만 서로 바꾸자 laya 체크포인트 셋이 정확히 불변(+0.0000)이 됐다고 합니다. 논문은 코드와 벤치마크 생성기, 건별 결과를 공개했다고 적었지만, abs 페이지와 PDF 어디에서도 링크는 찾지 못했습니다.
저희가 이 논문을 그냥 넘기지 못한 이유가 있습니다. 9월 23일 오픈소스 Jev 대안 비교 글에서 TREC에 한 줄 정의를 붙였을 때, laya는 500건 중 433건에서 443건으로 2%p만 움직였습니다(p = 0.25). 같은 정의가 DiffusionGemma 서버는 20%p 움직였습니다. 같은 현상일 가능성이 있었습니다. 그래서 같은 데이터로 논문의 실험을 다시 돌렸고, 판정 기준과 결과별로 쓸 문장은 첫 실행 전에 커밋해 두었습니다.
무엇을 돌렸나
- 모델: 논문이 쓴 laya 체크포인트 셋 중 둘입니다. 하나는 기본 체크포인트
convaiinnovations/laya로, 논문은 LAYA-EN이라 부르고 이 글에서는 laya라고 씁니다. 다른 하나는typed-decisions체크포인트로, 논문의 LAYA-TD이고 이 글에서는 laya-td입니다. 둘 다 laya 0.3.7에서 배포된 설정 그대로 썼습니다. 다국어 체크포인트, von, Qwen2.5 판독은 재지 않았습니다. - 데이터: 9월 글과 같은 파일입니다. 주 데이터는 TREC 500건(질문 유형 6개)입니다. AG News 200건(주제 4개)은 laya 문서가 학습 데이터로 밝힌 세트라 보조로만 씁니다.
- 문제의 한 줄: laya 0.3.7의
laya/common.py에서render_options가 선택지를"%s: %s" % (label, definition)으로 만듭니다. 패치는 라이브러리 파일을 고치지 않고 실행 스크립트 안에서 이 함수를 정의만 돌려주는 함수로 바꿔 끼웁니다. - 채점: 라벨을 바꾸거나 섞어도 정답은 항상 정의가 뜻하는 범주입니다.
조건은 일곱 가지이고, 모두 같은 문장 위에서 돌렸습니다.
| 조건 | 넘기는 선택지 | 렌더링 |
|---|---|---|
| C0 | 원래 라벨 + 정의 | 배포 그대로(라벨: 정의) |
| C1 | 원래 라벨만 | 배포 그대로 |
| C2 | 원래 라벨 + 정의 | 패치(정의만) |
| C3 | A, B, C… + 정의 | 배포 그대로 |
| C4 | A, B, C… + 정의 | 패치 |
| C5 | 엇갈린 라벨 + 정의 | 배포 그대로 |
| C6 | 엇갈린 라벨 + 정의 | 패치 |
엇갈린 라벨은 정의마다 다음 범주의 라벨을 붙인 것입니다. TREC으로 치면 "사람, 사람들의 집단, 조직"이라는 정의에 location 라벨이, "정의, 설명, 이유, 방법"이라는 정의에 human 라벨이 붙습니다. 모델이 라벨을 따르면 답이 정확히 한 칸 밀립니다.
두 조건은 같은 문장끼리 짝지어 비교했습니다(McNemar 정확 검정, p < 0.05). 정확도 차이의 구간은 부트스트랩 10,000회로 구했습니다. C0은 결정성을 보려고 두 번 돌렸고, 확률 마지막 자리까지 같았습니다. C0의 443건과 C1의 433건도 9월 글과 정확히 같게 다시 나왔습니다.
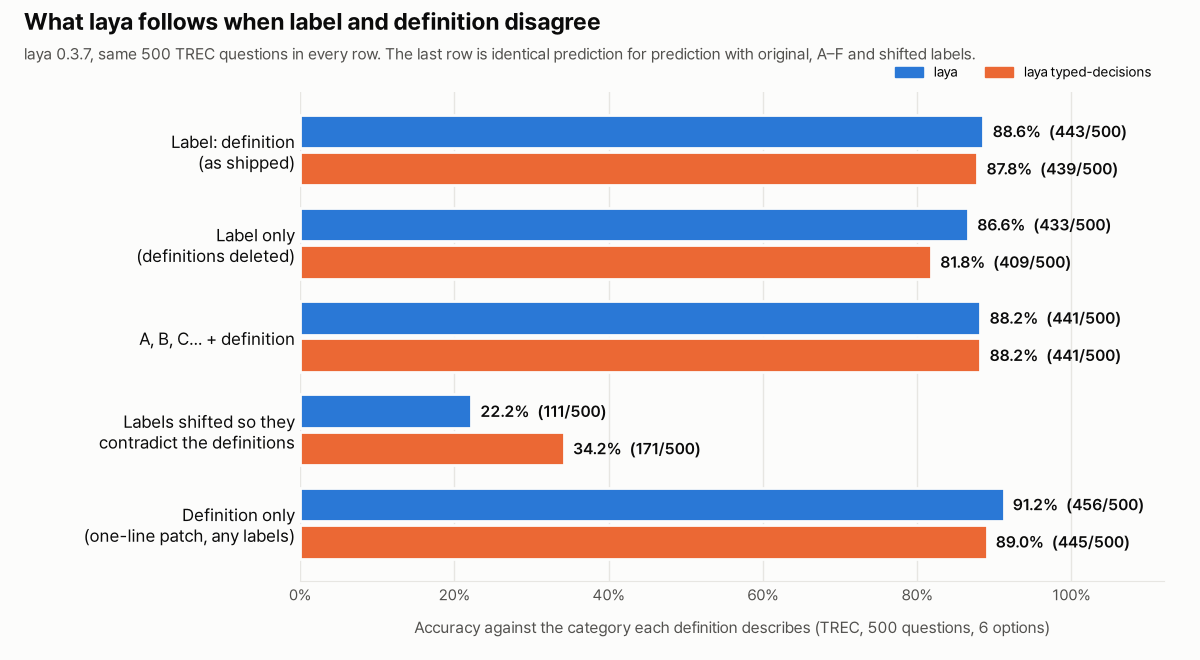
정의를 지우면: 체크포인트에 따라 다릅니다
laya는 정의를 빼자 TREC에서 443건이 433건이 됐습니다(-2.0%p, 구간 -5.0에서 +1.0, p = 0.25). 500건으로는 차이라고 말할 수 없고, 논문의 "변화 없음"과 같은 방향입니다.
laya-td는 다릅니다. 439건이 409건으로 줄었습니다(-6.0%p, 구간 -9.6에서 -2.4, p = 0.002). 이 체크포인트에는 TREC에서 정의가 도움이 됐습니다. 논문의 laya-td 숫자는 논문이 쓴 과제 묶음에서 나온 값이라 틀렸다고 할 수 없습니다. 저희 과제에서는 "변화 없음"이 한 체크포인트에서만 맞았습니다.
AG News에서는 두 체크포인트 모두 200건 중 2건 넘게 움직이지 않아 차이를 말할 수 없었습니다.
라벨을 A, B, C로 바꾸면: TREC에서는 차이가 보이지 않았습니다
논문은 옵션 이름을 A와 B로 바꾸면 정확도가 0.1511 오른다고 보고합니다. 이 숫자는 저자들이 만든 합성 라우팅 세트 PolicyBench에서 나왔습니다. 이 세트는 규칙이 정의에만 들어 있게 일부러 만든 것입니다. 같은 논문의 완화책 절은 분류 과제에서는 이름을 바꾸면 오히려 정확도를 잃는다고 적습니다. 범주 이름 자체가 좋은 단서이기 때문입니다. TREC이 바로 그런 과제입니다. human, location 같은 라벨만 봐도 답의 방향이 보입니다.
그래서 저희도 이름을 지우면 정확도가 떨어지리라 예상했는데, 떨어졌다고 할 만한 차이는 나오지 않았습니다. laya는 441건 대 443건, laya-td는 441건 대 439건으로 둘 다 차이를 말할 수 없었습니다(p = 0.83, 0.84). AG News는 조금 달랐습니다. 바뀐 건이 모두 손해 쪽이었습니다. 200건 중 laya가 4건, laya-td가 3건을 잃었고 새로 맞힌 건은 없었습니다. 이 건수로는 McNemar 검정이 차이를 말하지 못합니다(p = 0.125, 0.25). 부트스트랩 구간은 laya에서 0을 벗어나고(-4.0에서 -0.5%p), laya-td에서는 0에 닿습니다(-3.5에서 0.0%p).
코드 한 줄을 바꾸면: 라벨이 무엇이든 예측이 같습니다
정의만 렌더링하게 바꾸자 원래 라벨(C2), A-F 라벨(C4), 엇갈린 라벨(C6)의 예측이 네 조합(모델 2개 × 데이터 2개) 모두에서 한 건도 다르지 않았습니다. 선택지별 확률의 최대 차이도 0.0이었습니다. 라벨이 입력 문자열에 들어가지 않으니 라벨 이름이 모델에 닿을 길이 없습니다. 논문의 +0.0000을 그대로 재현했습니다.
라벨과 정의가 어긋나면: laya는 라벨을 따릅니다
실무에서 가장 신경 쓸 결과는 이것입니다. enum 이름을 바꾸고 정의는 그대로 둔 경우, 또는 물려받은 라벨이 원래 뜻에서 멀어진 경우에 해당합니다. 엇갈린 라벨에서 laya의 TREC 정확도는 88.6%에서 22.2%(500건 중 111건)로 떨어졌습니다. 500건 중 333건에서 정답 범주의 이름이 붙은 선택지를 골랐는데, 그 선택지의 정의는 다른 범주를 설명하고 있었습니다.
"Who was Galileo?"는 human 질문입니다. 엇갈린 라벨에서 laya는 human 라벨이 붙은 선택지를 0.986 확률로 골랐습니다. 그 선택지의 정의는 "정의, 설명, 이유, 방법"이었습니다.
laya-td는 34.2%로 조금 덜 무너졌습니다(라벨 추종 260건). 그래도 원래의 87.8%와는 거리가 멉니다. 정의만 렌더링하면 둘 다 돌아옵니다(91.2%, 89.0%). AG News도 같은 양상이었습니다. 엇갈린 라벨에서 200건 중 37건과 57건을 맞혔고, 156건과 139건이 라벨을 따랐습니다.
논문도 라벨이 정의와 어긋나는 조건을 따로 쟀습니다. 고정 라벨 분류 과제(SST-2, RTE, CB)에서 LAYA-EN은 정확도 0.124, LAYA-TD는 0.136까지 떨어졌습니다(Table 6). 저희의 엇갈린 라벨은 만드는 방식도 데이터도 달라서 수준은 다르지만(22.2%, 34.2%), 방향은 같습니다.
최고 확률이 맞은 답과 틀린 답을 거꾸로 줄 세웠습니다
확률이 낮은 답은 사람에게 넘기는 안전장치가 흔합니다. 저희도 어떤 실수가 비싼가 글에서 이 방법을 다뤘습니다. 이 장치는 확률이 높을수록 잘 맞을 때만 작동합니다. 그래서 최고 확률이 맞은 답과 틀린 답을 얼마나 잘 가르는지 AUROC로 쟀습니다. 0.5면 동전 던지기와 같습니다.
배포된 라벨 그대로일 때 laya의 TREC AUROC는 0.89(구간 0.84에서 0.93)였습니다. 기준을 0.9로 두면 laya가 스스로 받아들인 314건 중 98.1%가 맞았고, 사람에게 넘긴 186건은 72.6%가 맞았습니다. 안전장치가 제대로 작동하는 모습입니다.
라벨이 어긋나자 AUROC는 0.36(0.31에서 0.42)이 됐습니다. 구간 전체가 0.5 아래라서, 최고 확률이 틀린 답을 맞은 답보다 위에 줄 세운 것입니다. 같은 0.9 기준에서 laya가 받아들인 115건 중 맞은 답은 4.3%였고, 사람에게 넘긴 385건은 27.5%가 맞았습니다. 기준이 틀린 답은 남기고 그나마 나은 답을 넘긴 셈입니다.
laya-td는 TREC 엇갈린 라벨에서 0.52(0.47에서 0.57)라 방향을 말할 수 없었습니다. AG News에서는 두 체크포인트 모두 거꾸로였습니다(0.22, 0.26, 두 구간 모두 0.5 아래).
이 결과는 논문 §5.8과 같은 방향입니다. 논문은 라벨이 어긋난 조건에서 LAYA-EN 0.194, LAYA-TD 0.243을 보고했습니다(Table 6). 결과가 갈린 곳은 TREC의 laya-td 하나입니다. 논문은 거꾸로라고 보고했지만, 저희 결과로는 방향을 말할 수 없었습니다. 논문은 laya가 따로 돌려주는 confidence 필드로 계산했는데, 이 값은 최고 확률과 거의 일치하지 않습니다. 저희 결과를 이 필드로 다시 계산해도(사후 분석) 결론은 같았습니다(TREC laya 0.35, laya-td 0.52, AG News 0.29와 0.30).
laya는 두 체크포인트를 불러올 때마다 경고를 냅니다. 배포된 온도 값 하나가 허용 범위를 벗어나 0.5로 고정된다는 내용입니다. 이 온도는 선택지가 11개 이상인 질문에만 쓰입니다. 저희 과제는 선택지가 6개와 4개라서 이번 실행에는 쓰이지 않았습니다.
미리 정하지 않은 결과 하나
C2와 C0, 즉 원래 라벨에서 패치한 렌더링과 배포 렌더링을 비교하는 것은 사전 등록한 질문이 아니었습니다. 그러니 사후 관찰로만 읽어 주세요. TREC에서 laya는 456건 대 443건이었습니다(+2.6%p, p = 0.019). laya-td는 6건 늘었고(p = 0.42), AG News에서는 두 체크포인트 모두 1-3건 안에서 오르내렸습니다. 체크포인트 하나, 데이터 하나의 결과라 정확도를 올리려고 패치하라는 권고로 읽지 않으셨으면 합니다.
정리하면
- 라벨이 상식적으로 붙은 실제 과제에서는 라벨을 읽어도 손해가 작았습니다. TREC에서 라벨 이름을 지워도 차이가 검출되지 않았고, 정의를 지웠을 때 손해를 본 것은 laya-td뿐이었습니다.
- 위험한 경우는 라벨과 정의가 어긋날 때입니다. 그때 laya는 라벨을 따르고, 최고 확률까지 거꾸로 가리킬 수 있습니다. 오류가 나지 않고 확률도 그럴듯해 보여서 알아채기 어렵습니다.
- 예측이 아니라 확률을 비교하세요. 논문의 two-call test(§5.6)는 같은 질문을 라벨만 바꿔 두 번 보내고, 돌아온 확률 분포를 비교합니다. 조금이라도 다르면 모델이 라벨을 읽고 있다는 뜻이고, 정답 데이터는 필요 없습니다. 바뀐 예측만 세면 놓칩니다. 결과를 본 뒤에 추가한 사후 비교로 보면, TREC에서 A-F로 바꿨을 때 laya의 예측이 바뀐 것은 500건 중 27건뿐이라 괜찮아 보입니다. 그런데 확률 분포는 359건에서 0.01 넘게(총변동 거리 기준) 움직였습니다. 라벨이 정의와 어긋나면 22.2%로 무너지는 바로 그 모델입니다.
- 라벨을 읽는다고 나오면 고치는 방법은 두 가지입니다. 렌더링을 직접 고칠 수 있다면 정의만 쓰게 바꾸는 것으로 이 의존이 사라집니다. 라이브러리를 건드리지 않으려면 선택지 이름을 A, B, C로 바꾸고 규칙을 전부 정의에 적으면 됩니다. TREC에서는 이렇게 해도 검출할 만한 손해가 없었습니다(441건 대 443건). 다만 논문은 이 방법을 첫 번째 완화책으로 꼽으면서도 분류 과제에서는 손해가 난다고 보고했고, 저희 AG News에서도 몇 건을 잃었습니다. 직접 쓰는 과제에서 먼저 재 보시길 권합니다.
측정 범위와 한계
- laya 체크포인트는 논문의 LAYA-EN과 LAYA-TD 두 개만 봤습니다. LAYA-ML, von, Qwen2.5 판독, 호스팅 Jev는 재지 않았습니다. 호스팅 Jev는 논문도 재지 않았습니다.
- 공개 분류 데이터 두 개입니다. AG News는 laya 학습 데이터에 들어 있어서 결론은 TREC 기준으로 썼습니다.
- 엇갈린 라벨은 일부러 극단적으로 만든 모순입니다. 실제로는 선택지 하나만 이름이 바뀌거나, 정의만 늘어나고 라벨은 그대로인 식의 부분적인 어긋남이 흔합니다. 부분적인 경우는 재지 않았습니다.
- 조건마다 한 번씩 돌렸습니다. 추론이 결정적이고 C0을 두 번 돌린 결과가 같아서 시드는 해당하지 않습니다.
사전 등록 문서, 실행 스크립트, 건별 원시 결과, 집계 스크립트는 drafts/label-bias/에 있습니다(사전 등록 커밋 925bfb4, 첫 실행 전). 다음 재측정 글은 뉴스레터로 먼저 알려 드립니다.