어떤 실수가 비싼가: 오답 한 건의 비용을 바꿔 가며 같은 시스템을 다시 채점했습니다
BANKING77 테스트 3,080건을 비용표 네 개로 다시 채점했습니다. 오답 한 건의 비용이 바뀌면 모델을 바꿀 때보다 자동 처리 비율이 훨씬 크게 움직였고, 판단 모델은 오답 한 건이 사람 이관 두 건 이하의 비용일 때만 비용을 줄였습니다.

어떤 실수가 비싼가: 오답 한 건의 비용을 바꿔 가며 같은 시스템을 다시 채점했습니다
지난 글에서는 확실한 문의는 자동으로 답하고 나머지는 사람에게 넘기는 시스템을 만들었습니다. 기준값은 정확도 목표로 정했습니다. 자동으로 답한 것 중 95%(또는 98%)가 맞도록 했습니다. 그런데 그 글은 중요한 것 하나를 재지 않고 끝났습니다. 틀린 답 한 건이 사람의 시간에 비해 얼마나 비싼가입니다.
이번 글은 그 비용을 넣어 다시 셉니다. 새 모델은 돌리지 않았습니다. 지난 글의 결과(분류기 단독 1개와, 분류기 뒤에 판단 모델을 붙인 시스템 8개)를 BANKING77 검증 1,003건과 테스트 3,080건 그대로 두고, 채점 방식만 바꿨습니다.
문의 한 건의 비용
문의 하나는 세 가지 중 하나로 끝납니다. 비용은 "사람에게 넘긴 한 건"을 1로 놓고 셉니다.
- 자동으로 답했고 맞았으면 0
- 사람에게 넘겼으면 1
- 자동으로 답했는데 틀렸으면 r
r은 오답 한 건이 사람 이관 몇 건과 맞먹는지를 뜻합니다. 카드 배송 문의에 엉뚱한 답을 하면 사람에게 넘긴 것과 비용이 크게 다르지 않을 수 있습니다. 카드를 도난당한 고객에게 비밀번호 바꾸는 법을 안내하면 훨씬 비쌉니다. 자기 r을 정확히 아는 곳은 드뭅니다. 그래서 r을 1부터 100까지 바꿔 가며 채점하고, 어디서 결정이 바뀌는지 봤습니다.
비용표를 하나만 두면 원하는 시스템이 이기도록 표를 고를 수 있습니다. 그래서 채점 스크립트를 쓰기 전에 시나리오 네 개를 연재 계획서에 먼저 적어 두었습니다(무엇으로 확인할 수 있는지는 글 끝 설정에 적었습니다).
- 균일: 모든 오답이 r입니다.
- 위험 의도: 고객의 돈이나 계정이 지금 위험한 의도 11개(카드 분실·도난, 카드 정보 유출, 모르는 결제·출금·자동이체, 받는 사람에게 도착하지 않은 송금, 송금 취소 요청 등)를 틀리면 5r입니다.
- 같은 담당 팀: 의도 77개를 담당 팀 8개(카드 발급·배송, 카드 문제, 카드 결제, 현금·ATM, 충전, 송금, 환전, 계정·본인 확인)로 나눴습니다. 틀렸어도 답이 같은 팀 안에 있으면 0.2r입니다. 동료가 옆자리로 넘겨 주면 되기 때문입니다.
- 둘 다: 위험 의도를 먼저 보고, 그다음 같은 팀인지 봅니다.
시나리오마다, r마다, 시스템마다 검증 세트에서 평균 비용이 가장 낮은 기준값을 고르고, 그 값으로 테스트 세트를 채점했습니다. 지난 글의 정확도 목표 기준값도 같은 비용으로 함께 채점했습니다.
요약
- 오답의 비용이 바뀌면 자동 처리 비율이 크게 움직였습니다. 모델을 바꿀 때보다 훨씬 컸습니다. 분류기 단독으로, r마다 고른 기준값은 테스트 문의의 99.0%(r = 1), 82.5%(r = 5), 74.3%(r = 20), 57.9%(r = 50)를 자동으로 처리했습니다.
- 정확도 목표는 r을 말없이 정해 버립니다. 지난 글의 95% 설정과 98% 설정은 r = 5.37에서 비용이 같습니다. r = 20에서는 95% 설정이 그 r에 맞춰 고른 기준값보다 두 배 가까이 비쌌습니다.
- 판단 모델은 오답이 쌀 때만 비용을 줄였습니다. 네 시나리오 모두 r = 1과 r = 2에서는 일부 시스템이 분류기 단독보다 쌌습니다. 차이는 1,000건당 이관 14건 이하였습니다. r = 5부터는 더 싼 시스템이 없었습니다.
- 가장 싼 시스템의 이름은 r 범위 안에서 9번에서 19번 바뀌었습니다. 대부분 비용을 서로 구분할 수 없는 시스템끼리 자리를 바꾼 것입니다.
오답의 비용이 기준값을 움직입니다
분류기 단독, 균일 비용에서 검증으로 고른 기준값이 테스트에서 낸 결과입니다. 오른쪽 두 칸은 지난 글의 정확도 목표 설정을 같은 r로 채점한 것입니다.
| r (오답 한 건 = 이관 r건) | 자동 처리 | 그중 정답 | 오답 | 사람에게 | 1,000건당 비용 | 95% 목표 설정 | 98% 목표 설정 |
|---|---|---|---|---|---|---|---|
| 1 | 99.0% | 93.5% | 197 | 31 | 74 | 103 | 187 |
| 2 | 94.4% | 95.8% | 123 | 174 | 136 | 139 | 203 |
| 5 | 82.5% | 98.1% | 48 | 538 | 253 | 245 | 252 |
| 10 | 80.2% | 98.4% | 39 | 611 | 325 | 422 | 333 |
| 20 | 74.3% | 99.1% | 21 | 793 | 394 | 776 | 495 |
| 50 | 57.9% | 99.4% | 10 | 1,296 | 583 | 1,837 | 982 |
| 100 | 57.9% | 99.4% | 10 | 1,296 | 745 | 3,607 | 1,794 |
1,000건당 비용은 (오답 × r + 사람에게 넘긴 수) ÷ 3,080 × 1,000으로 계산했습니다. r이 1에서 50으로 오르는 동안 자동 처리 비율은 41%p 내려갔습니다. 반면 같은 r에서 9개 시스템의 자동 처리 비율은 이 시나리오에서 최대 4.0%p 차이였습니다. 다른 시나리오에서도 최대 10.6%p였고, 그것도 둘 다 시나리오의 r = 20에서 Tev1 후보 5개가 아직 쓰이던 경우였습니다.
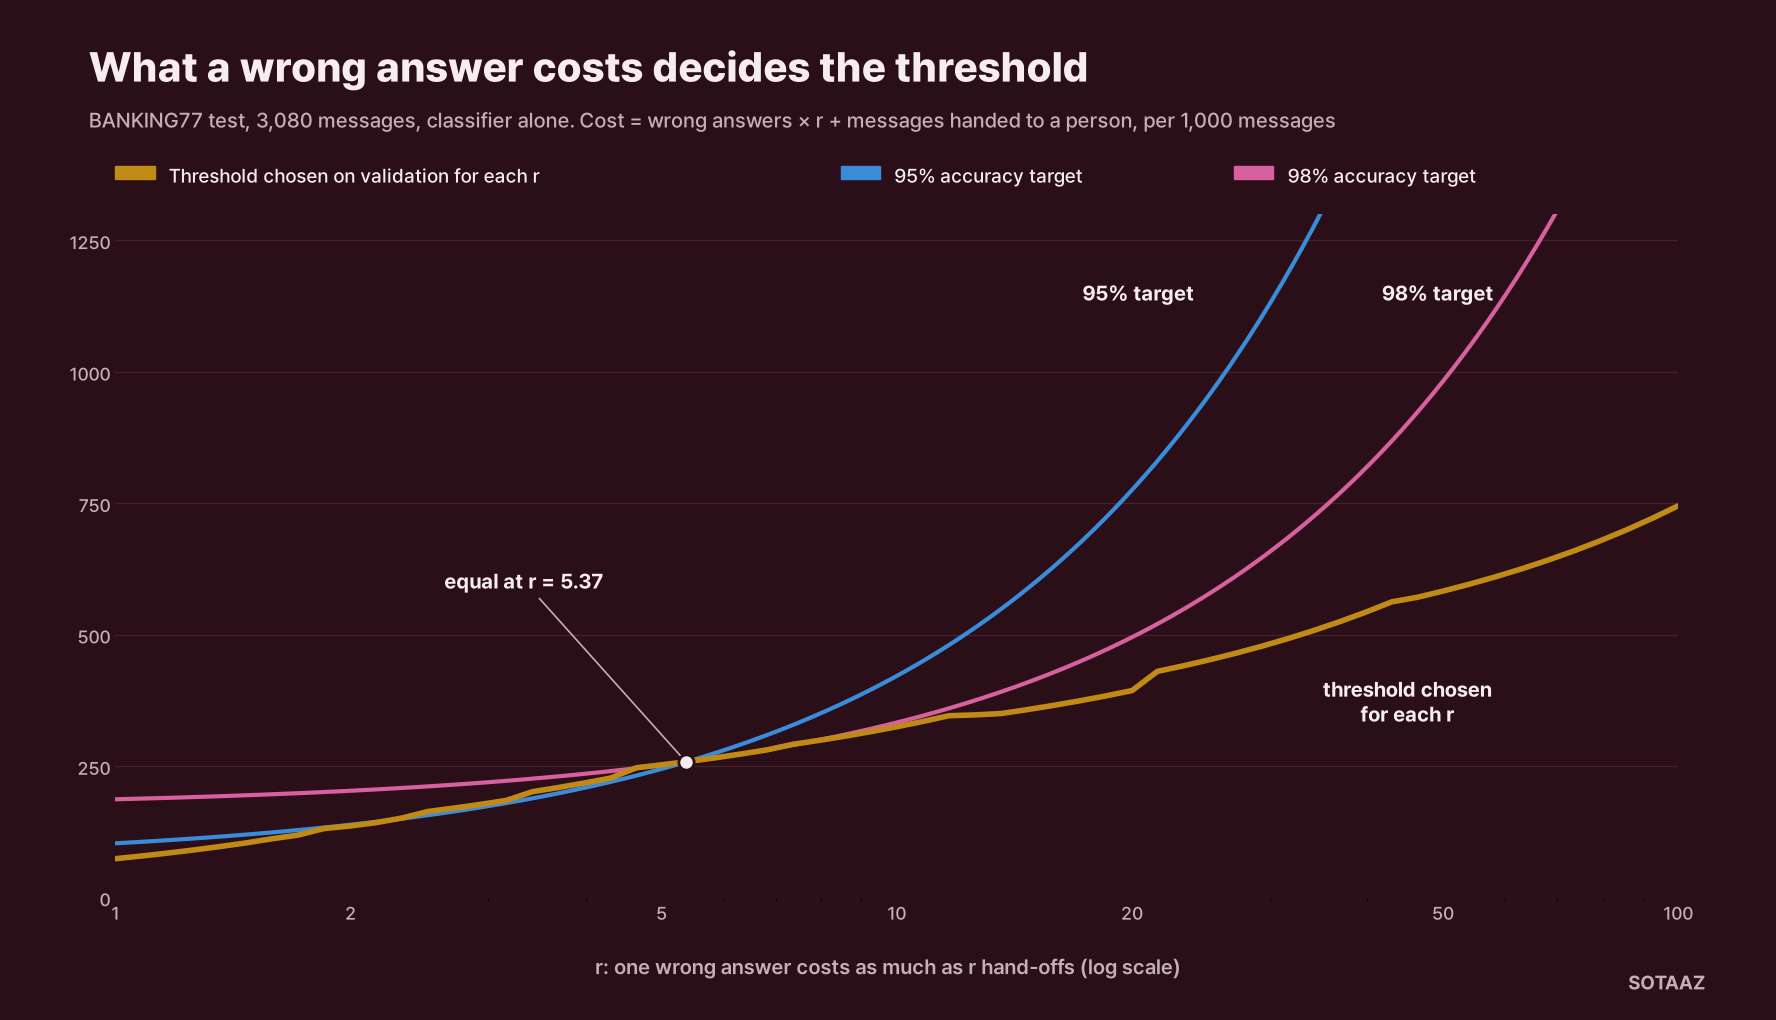
정확도 목표는 좁은 구간에서만 최선에 가깝습니다. r = 2와 r = 5에서는 95% 설정이 r에 맞춰 고른 기준값만큼 쌌습니다(1,000건당 차이 -2와 +8, 짝지은 부트스트랩 구간 -6에서 +1, -14에서 +30). r = 20에서는 r에 맞춰 고른 기준값이 95% 설정보다 1,000건당 이관 382건만큼 쌌습니다(271에서 492).
두 설정이 같아지는 점
어디서 선택이 뒤집히는지는 표 없이도 계산할 수 있습니다. 지난 글의 두 설정은 같은 테스트 3,080건에서 이랬습니다.
- 95% 목표: 오답 109건, 사람에게 209건
- 98% 목표: 오답 50건, 사람에게 526건
비용은 각각 109r + 209와 50r + 526이고, r = (526 - 209) ÷ (109 - 50) = 5.37에서 같아집니다. 오답 한 건이 이관 다섯 건 남짓보다 비싸면 엄격한 쪽이 싸고, 그보다 싸면 느슨한 쪽이 쌉니다. "95%"를 고른 것은 r이 5.37보다 작다고 적지 않은 채 정한 것과 같습니다.
판단 모델은 오답이 쌀 때만 도움이 됐습니다
지난 글에서는 BANKING77에서 판단 모델(Ollama로 돌린 Nimble 9B와 Tev1 4B, API로 부른 Jev 1.13)이 95%·98% 목표에서 사람 몫을 줄이지 못했습니다. 기준값을 비용으로 고르자 r이 낮은 구간에서는 줄였습니다.
균일 시나리오에서 r = 1일 때는 세 시스템이 분류기 단독보다 쌌습니다(Nimble 후보 5개가 1,000건당 5.8건, 구간 0.6에서 11.4. 그리고 Tev1 후보 5개와 10개). r = 2에서는 Nimble 세 설정이 모두 쌌고, 가장 큰 차이는 1,000건당 136건 중 10.4건이었습니다(5.5에서 14.9). r = 5에서는 분류기와 구분되는 시스템이 없었고, r = 10부터는 검증 세트가 모든 모델에서 두 번째 단계의 답을 하나도 받지 않는 쪽을 골랐습니다. 두 번째 단계가 무엇이든 답하도록 남아 있던 마지막 r은 시스템에 따라 2.15에서 5.84였습니다.
다른 시나리오도 모양이 같았습니다. r = 1과 r = 2에서는 시나리오와 r에 따라 8개 중 1개에서 6개 시스템이 쌌고, 가장 크게 줄인 것은 1,000건당 14.2건이었습니다(둘 다 시나리오, r = 2, Nimble 후보 20개, 구간 10.1에서 18.7). r = 5와 10에서 더 싼 시스템은 없었습니다. 같은 팀 시나리오에서는 오답이 팀 안에 머무는 경우가 많아, 대부분의 시스템에서 두 번째 단계가 균일 시나리오보다 오래 쓰였습니다(r = 5.84에서 10.80까지). 가장 오래 쓰인 것은 Tev1 후보 5개로, 같은 팀 시나리오에서 r = 34까지, 둘 다 시나리오에서 r = 68까지 쓰였습니다. Tev1은 학습 데이터에 BANKING77이 들어 있다고 밝힌 모델입니다.
이유는 산수로 설명됩니다. 넘겨받은 문의에 답하는 편이 사람에게 넘기는 것보다 싸려면, 그 답이 1 - 1/r보다 자주 맞아야 합니다. r = 2면 50%, r = 5면 80%, r = 10이면 90%입니다. r = 5의 기준값에서 분류기가 넘긴 문의 중, 각 모델이 확률 0.99 이상으로 답한 것의 정답률은 이랬습니다.
| 넘겨받은 문의, 확률 0.99 이상인 답 | 검증 | 테스트 |
|---|---|---|
| Nimble 후보 5 / 10 / 20 | 77% / 78% / 82% (23/30, 21/27, 23/28) | 89% / 88% / 85% |
| Tev1 후보 5 / 10 | 83% / 59% (5/6, 10/17) | 80% / 75% |
| Jev 후보 5 / 10 / 전체 77 | 57% / 59% / 64% (36/63, 29/49, 29/45) | 78% / 79% / 80% |
검증에서 80%를 넘은 것은 Nimble 후보 20개(28건 중 23건)와 Tev1 후보 5개(6건 중 5건)뿐이었습니다. r = 5에서 두 번째 단계가 켜져 있던 시스템도 이 둘뿐이었고, 비용은 분류기 단독과 구분되지 않았습니다. 테스트에서는 Nimble 세 설정과 Jev 전체 77개 설정이 80%를 넘었습니다. 검증 데이터가 더 많았다면 이 중 일부는 r = 5에서도 조금은 이득을 냈을 수 있습니다. 넘겨받은 문의는 검증 쪽이 전반적으로 더 어려웠고(분류기 1순위 정답률 검증 60%, 테스트 68%), 표본도 작습니다.
가장 싼 시스템은 자주, 대부분 잡음으로 바뀌었습니다
채점한 r 65개 지점을 따라가면 가장 싼 시스템의 이름이 균일 시나리오에서 9번, 위험 의도에서 11번, 같은 팀에서 19번, 둘 다에서 15번 바뀌었습니다. 그 뒤에 있는 차이는 작았습니다. r = 1에서는 네 시나리오 모두 1위와 2위를 구분할 수 없었고, r = 2에서 1위가 2위보다 싼 정도는 1,000건당 2.3건에서 4.2건이었습니다. r 하나에서 매긴 모델 순위는 결과라고 부르기 어렵습니다. 두 번째 단계를 쓰느냐 마느냐, 분류기 기준값을 어디에 두느냐가 결과입니다.
검증으로 고른 기준값이 더 나빴던 경우
비용에 맞춰 검증에서 고른 기준값이 테스트에서 언제나 정확도 목표보다 나았던 것은 아닙니다. 위험 의도 시나리오의 r = 2에서는 95% 설정보다 1,000건당 15.9건 비쌌고(2.9에서 26.6), 둘 다 시나리오의 r = 2에서는 22.1건 비쌌습니다(9.4에서 32.5). 검증 세트는 1,003건, 의도마다 4건에서 19건입니다. 위험 의도 11개를 다 합쳐도 155건이고, 의도 하나에 6건에서 18건입니다.
r이 클 때는 다른 한계도 있었습니다. r = 50과 r = 100에서 같은 기준값(0.976)이 골라졌습니다. 그 위로 검증 문의 553건이 답해졌는데 오답이 2건뿐이었기 때문입니다. 오답 2건으로는 오답률 0.4%와 1%를 가를 수 없고, r = 100에서는 바로 그 차이가 문제입니다. 오답이 비쌀수록, 그 오답에 맞춰 기준값을 정하는 데 필요한 검증 문의도 많아집니다.
실제로 헷갈린 쌍
테스트 3,080건 전체에서 분류기의 1순위는 219번 틀렸습니다. 그중 137건(63%)은 같은 팀 안에서 틀렸고, 42건은 위험 의도의 문의였습니다.
| 테스트에서 분류기가 헷갈린 쌍 (양방향 합) | 횟수 | 같은 팀 | 위험 의도 포함 |
|---|---|---|---|
| card_arrival / card_delivery_estimate | 7 | 예 | 아니오 |
| verify_my_identity / why_verify_identity | 6 | 예 | 아니오 |
| exchange_via_app / fiat_currency_support | 5 | 예 | 아니오 |
| card_payment_not_recognised / compromised_card | 5 | 아니오 | 예 |
| card_payment_not_recognised / direct_debit_payment_not_recognised | 5 | 예 | 예 |
| declined_card_payment / declined_transfer | 5 | 아니오 | 아니오 |
| balance_not_updated_after_bank_transfer / pending_transfer | 5 | 예 | 아니오 |
| balance_not_updated_after_bank_transfer / transfer_not_received_by_recipient | 4 | 예 | 예 |
마지막 칸은 쌍의 어느 한쪽이라도 위험 의도인지를 표시합니다. 위험 의도 비용은 정답 쪽이 위험 의도일 때만 붙습니다.
가장 잦은 쌍은 싼 실수입니다. "When will I get my card?"는 정답이 카드 도착(card_arrival)인데 카드 배송 예정일로 답했습니다. 그래도 같은 사람들이 처리합니다. 네 번째 쌍은 다릅니다. "제가 하지 않은 이상한 결제가 며칠 전부터 있습니다. 카드를 도난당한 건가요, 그렇다면 해지해야 하나요?"라는 문의(원문은 영어)는 정답이 모르는 결제인데, 카드 정보 유출로 답했습니다. 두 의도는 다른 팀이 맡고, 사람이 읽어도 망설일 만한 문장입니다.
모델을 만들기 전에 이런 쌍을 찾을 수 있을까요? 의도마다 학습 문장의 평균(단어와 글자 TF-IDF, 학습 데이터만 사용)을 내고, 의도 쌍 2,926개를 유사도 순으로 줄 세웠습니다. 가장 닮은 77쌍(전체 쌍의 2.6%)이 오답 219건 중 116건(53%)을 덮었고, 가장 닮은 30쌍은 55건(25%)을 덮었습니다. 본인 확인 쌍은 1위였습니다. card_payment_not_recognised와 compromised_card 쌍은 177위였습니다. 문장만 보고 만든 목록은 출발점으로는 쓸 만하지만, 비싼 실수는 바로 이런 목록이 놓칩니다.
평가 세트 점검표
- 재고 싶은 것을 잴 만큼 의도마다 문의가 있는가. 어떤 의도를 90% 맞힌다면, 95% 구간의 폭이 13건에서는 34%p, 40건에서는 19%p, 400건에서는 6%p입니다. BANKING77 테스트 세트는 의도마다 40건이고, 제 검증 분할은 4건에서 19건입니다.
- 비싼 의도가 충분히 들어 있는가. 위험 의도 11개는 테스트에 모두 440건이 있지만, 검증에는 의도마다 6건에서 18건뿐입니다.
- 엄격한 기준값을 정할 만큼 오답이 있는가. r = 50에서는 검증 오답 2건이 기준값을 정했습니다.
- 어느 의도에도 맞지 않는 질문이 들어 있는가. BANKING77에는 없습니다. 그런 질문 없이 기준값을 정하면 어떻게 되는지는 지난 글의 CLINC150 결과에 있습니다.
- 채점 전에 비용표를 적었는가. 어떤 의도가 위험한지, 어느 팀이 무엇을 맡는지, r의 범위를 어디까지 볼지입니다.
그래서 어떻게 할까
- 오답 한 건이 사람 이관 몇 건과 맞먹는지 대략이라도 정합니다. 이 데이터에서는 "5에서 20 사이"라는 답만으로도 95% 설정을 지울 수 있습니다.
- r 하나가 아니라 여러 r에서 채점합니다. 믿는 범위 안에서 결정이 뒤집히면 1위가 아니라 그 범위를 보고합니다.
- 두 번째 단계 모델은 내 r에서 확인합니다. 오답이 싸면 사람 일을 조금 덜 수 있지만, 오답 한 건이 이관 다섯 건 이상이면 이 실험에서 잴 만한 이득이 없었습니다.
- 라벨은 비용이 있는 곳에 씁니다. 이번 기준값에는 모델을 하나 더 붙이는 것보다 위험 의도의 검증 문의를 늘리는 편이 더 도움이 됐을 것입니다.
이 결과가 말하지 않는 것
데이터셋 하나, 분류기 하나, 지난 글과 같은 모델 버전입니다. 비용표도 제가 정했습니다. 위험 의도 11개, 팀 8개, 5배와 0.2배라는 가중치는 은행마다 다르게 그을 것입니다. 테스트 세트는 지난 글에서 이미 채점했습니다. 이번에 고른 값은 모두 검증에서 골랐지만, 테스트 세트가 처음 보는 데이터는 아니라는 점은 밝혀 둡니다. 두 번째 단계의 지연과 API 비용은 비용에 넣지 않았습니다(둘 다 지난 글에 있습니다). 두 번째 단계 기준값은 0.01 간격으로 찾았고, Jev의 확률은 소수 둘째 자리에서 반올림되어 나옵니다. Tev1은 학습 데이터에 BANKING77이 있다고 밝혔습니다.
이 시스템을 처음부터 끝까지 만드는 책을 쓰고 있습니다
BANKING77 예제 하나로 데이터 분할, 분류기, 판단 모델, 모르는 문의 넘기기, 운영까지 따라갑니다. 1장과 2장은 지금 읽을 수 있습니다. 이메일을 남겨 주시면 책이 나올 때 한 번 알려 드립니다.
설정: 지난 글의 결과를 그대로 썼습니다(분류기 sentence-transformers/all-MiniLM-L6-v2와 로지스틱 회귀, 온도 보정. 두 번째 단계는 Ollama 0.35.0의 Nimble 9B와 Tev1 4B, API의 Jev 1.13. BANKING77 분할 9,000 / 1,003 / 3,080, 시드 20261001). 비용은 자동 정답 0, 이관 1, 자동 오답 r × 심각도이고, 심각도는 위험 의도 11개 5, 같은 팀 0.2, 그 밖 1로 채점 스크립트를 쓰기 전에 연재 계획서(docs/decision-system-plan.md)에 적었습니다. 그 순서는 제 작업 기록에 남아 있지만, 계획서를 결과와 함께 나중에 커밋해서 리포지터리로는 확인할 수 없습니다. 계획서가 아니라 코드에서 정한 것이 둘 있습니다. 실행 중에 r 격자에 보고용 7개 값을 더했고, 첫 실행 전에 두 번째 기준값이 동점이면 높은 쪽을 고르도록 했습니다. r은 1에서 100까지 로그 간격 61점에 1, 2, 5, 10, 20, 50, 100을 더했습니다. 기준값 t1은 검증 확률의 모든 고유값, t2는 0에서 1까지 0.01 간격에서 검증 평균 비용이 가장 낮은 값을 골랐고, 동점이면 더 높은 기준값을 골랐습니다. 차이는 테스트 3,080건을 다시 뽑는 짝지은 부트스트랩 구간입니다(2,000회, 시드 20261001). 쌍 유사도는 학습 분할에서 의도별 평균 TF-IDF 벡터(단어 1-2그램, 글자 2-5그램, sublinear tf) 사이의 코사인입니다. 스크립트 scripts/jev-bench/cost_scenarios.py, scripts/jev-bench/confusion_vs_text.py, 결과 drafts/jev-bench/results/cost-banking77.json, confusion-vs-text-banking77.json. 2026-10-04 실행.
이 글과 이어지는 강좌
SOTAAZ 강좌강좌는 하나씩 살 수 있습니다. 13개 전체가 필요하면 $199 평생 번들도 있습니다.
이메일로 받아보기
관련 포스트
분류기, LLM, 판단 모델 중 무엇을 쓸까: 직접 잰 결과로 정리한 텍스트 분류 안내
이 블로그의 텍스트 분류 실측을 한 흐름으로 묶었습니다. 같은 은행 문의 154건에서 CPU 분류기는 90.3%, 가까운 사례 다섯 개를 붙인 LLM은 94.8%, Jev는 76.0%였습니다. 무엇을 언제 쓸지 순서대로 정리합니다.

무엇을 판단하고, 어떤 실수가 비싼가: 『작은 AI로 판단 시스템 만들기』 1장
무료로 공개하는 1장입니다. 아무것도 학습하기 전에 의도마다 데이터가 얼마나 되는지 세고, 헷갈리기 쉬운 의도를 찾고, 실수마다 비용을 적어 둡니다. 코드는 1초 안에 돌아갑니다.

단순한 분류기로 어디까지 될까: 『작은 AI로 판단 시스템 만들기』 2장 미리 보기
무료 샘플 장입니다. BANKING77을 학습 전에 먼저 나누고, CPU 분류기 두 개로 테스트 정확도 91.2%와 92.9%를 냅니다. 1분 남짓이면 돌아가는 코드도 함께 받을 수 있습니다.