분류기, LLM, 판단 모델 중 무엇을 쓸까: 직접 잰 결과로 정리한 텍스트 분류 안내
이 블로그의 텍스트 분류 실측을 한 흐름으로 묶었습니다. 같은 은행 문의 154건에서 CPU 분류기는 90.3%, 가까운 사례 다섯 개를 붙인 LLM은 94.8%, Jev는 76.0%였습니다. 무엇을 언제 쓸지 순서대로 정리합니다.
분류기, LLM, 판단 모델 중 무엇을 쓸까: 직접 잰 결과로 정리한 텍스트 분류 안내
9월 중순부터 짧은 글에 라벨을 붙이는 방법을 열 가지 넘게 재 왔습니다. 직접 학습한 분류기, 최신 LLM, 로컬 모델, 그리고 Jev처럼 선택지마다 확률을 돌려주는 판단 모델까지입니다. 글마다 질문 하나에 답했는데, 따로 읽으면 무엇부터 해야 하는지가 잘 보이지 않습니다. 이 글은 그 글들을 실제로 시스템을 만들 때 부딪히는 순서대로 다시 엮은 것입니다. 무엇을 먼저 해 볼지, 언어 모델은 언제 도움이 되는지, 판단 모델은 무엇을 고를지, 확률은 언제 믿어도 되는지 순서로 갑니다.
bag-of-words부터 트랜스포머, Jev식 점수 헤드까지 분류 모델이 어떻게 발전했고 내부가 어떻게 생겼는지는 Sebastian Raschka의 그림 설명 글이 잘 정리하고 있습니다. 이 글은 그쪽이 아니라 고르는 일을 다루고, 숫자는 모두 같은 문장으로 잰 것입니다.
먼저 표 하나
대부분의 글이 같은 시험지를 썼습니다. 은행 고객 문의를 의도 77개로 나눈 공개 데이터 BANKING77에서 의도마다 두 건씩, 고정 시드로 뽑은 154건입니다. 같은 문장에 같은 라벨 이름 77개를 주고 사람이 붙인 정답으로 채점했습니다.
| BANKING77 154건 | 정답 | 쓴 라벨 데이터 | 출처 |
|---|---|---|---|
| GPT-5.6 Terra + 가까운 학습 사례 다섯 개 검색 | 94.8% (146) | 10,003건에서 검색 | 입력 구성 실험 |
| MiniLM 임베딩 + 로지스틱 회귀, CPU | 90.3% (139) | 10,003건 | 라벨 출력 기준선 |
| GPT-5.6 Terra, 라벨 이름만 | 83.8% (129) | 0 | 라벨 출력 기준선 |
| Kev-9B (BANKING77로 학습한 모델) | 82.5% (127) | 학습에 포함 | Kev와 MoJev |
| Jev 1.13 | 76.0% (117) | 0 | Kev vs Jev |
| openjev(DiffusionGemma), 한 번 읽기 | 66.9% | 0 | Jev 대안 셋 |
| Jeff v1.1, 0.8B와 2B | 66.2%, 64.9% | 0 | Jeff vs Jev |
| Nimble 9B, Tev1 (Ollama 0.35) | 선택지 26개 초과로 거절 | 0 | Ollama 판단 모델 |
분류기는 첫 글에서 139건, 문장별 결과를 남기려고 GPU에서 다시 돌렸을 때 138건이었습니다. GPT-5.6 Terra에 라벨 이름만 준 구성은 네 번 돌려 125건에서 129건 사이였습니다. 154건이면 몇 %p 차이는 그 자체로 유의하지 않으니, 각 글에 적은 짝지은 검정을 같이 봐야 합니다.
이 표에서 보이는 두 가지는 다른 글에서도 대체로 그대로였습니다. 선택지가 많고 라벨이 충분하면 작은 분류기를 이기기 어려웠습니다. 선택지가 적으면 달랐습니다. 선택지 6개인 TREC에서는 Nimble이 95.6%로 분류기(90.4%)를 앞섰습니다. 그리고 LLM에 라벨 데이터를 보여 줄 때는 가장 가까운 사례 몇 개를 찾아 붙이는 것이 제가 시험한 어떤 방법보다 효과가 컸습니다.
1단계: 기준선부터 학습합니다
라벨 데이터가 있다면 문장 임베딩 위에 로지스틱 회귀를 올린 분류기를 먼저 만들어 봅니다. 학습은 몇 초면 끝나고, CPU에서 한 건에 10ms가 안 걸립니다. BANKING77에서는 사례를 보지 못한 모든 모델을 이겼습니다. 최신 LLM 두 개, 문법 제약을 건 Qwen3-8B, 오픈소스 Jev 대안 셋이 모두 아래였습니다(라벨 출력 기준선, Jev 대안 셋).
2단계: 판단 모델은 라벨 몇 개의 값어치인가
분류기는 라벨이 있어야 하고, 판단 모델은 라벨 없이 바로 씁니다. 그러면 판단 모델은 라벨 몇 개만큼의 값을 할까요. Kev가 한 번도 학습하지 않은 과제 셋에서 Kev-9B는 클래스마다 라벨 2개에서 20개로 학습한 분류기와 비슷했습니다. 같은 과제에서 Jev는 셋 중 둘에서 Kev-9B보다 정확했고(CLINC150 68.5% 대 62.0%, MASSIVE 82.9% 대 76.0%, Kev vs Jev), 클래스마다 20개로 학습한 분류기와 비슷한 자리였습니다.
| 같은 400건, 175건 | CLINC150 (상한 75%) | MASSIVE |
|---|---|---|
| 분류기, 클래스당 라벨 5개 | 64.8% | 71.2% |
| 분류기, 클래스당 라벨 20개 | 69.8% | 82.3% |
| 분류기, 라벨 전부 | 72.5% | 84.6% |
| Jev 1.13, 라벨 없음 | 68.5% | 82.9% |
라벨 5개, 20개 행은 사례를 다섯 번 새로 뽑아 낸 평균이고, 뽑을 때마다 1-5%p씩 달랐습니다. 그래서 이 표는 대략의 위치를 보여 줄 뿐 짝지은 검정은 아닙니다. CLINC150의 상한이 75%인 것은 표본의 4분의 1이 어느 선택지에도 맞지 않는 질문이기 때문입니다. 클래스마다 몇십 개씩 라벨을 달 수 있다면 분류기가 더 싸고 정확도도 비슷합니다. 라벨을 달 여유가 없다면 판단 모델이 가장 빨리 시작하는 방법입니다.
3단계: LLM을 쓴다면 규칙보다 사례를 줍니다
BANKING77에서 GPT-5.6 Terra는 그대로 두고 입력만 바꿔 봤습니다. 라벨 순서를 섞거나 주제별로 묶거나 추론 강도를 바꿔도 정확도는 유의하게 움직이지 않았습니다. 가장 가까운 학습 사례 다섯 개를 붙이자 19건이 맞게 바뀌었고 틀리게 바뀐 것은 없었습니다(입력 구성 실험). 모델이 틀린 문장들에서 규칙을 뽑아 붙이는 방법은 그만큼 효과가 없었습니다. 규칙 40줄은 4건을 고치고 5건을 망쳤습니다(Paper of the Week #4).
4단계: 판단 모델 고르기
여기 나오는 모델은 모두 같은 요청을 받습니다. 글 하나와 선택지가 정해진 질문을 보내면, 선택지마다 확률을 돌려줍니다. 차이는 무엇으로 학습했는지와 선택지를 몇 개까지 받는지에 있습니다.
- Jev(TypeSafe의 API)는 Kev가 처음 보는 과제 셋 중 둘에서 Kev-9B보다 정확했고, 추론이 필요한 문항에서는 어떤 오픈 모델보다 앞섰습니다. Jeff의 4,599문항 패널에서 85.7이었습니다(Jeff vs Jev). Jev가 무엇이고 어떻게 동작하는지는 10분 만에 이해하는 Jev에 정리했습니다.
- Kev(0.8B에서 9B, 가중치 공개)는 학습한 데이터셋에서는 Jev와 같거나 앞섰고(TREC 93.8% 대 89.0%), 학습하지 않은 셋 중 둘에서는 뒤졌습니다(Kev vs Jev, Kev와 MoJev).
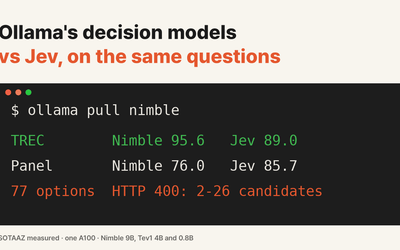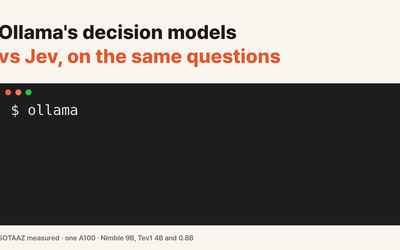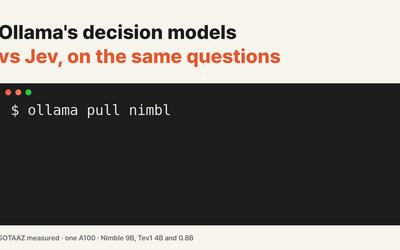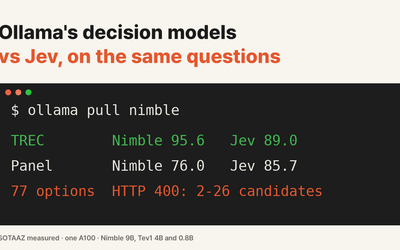
- Nimble 9B(Ollama)는 미세조정 데이터에 TREC가 없는데도 TREC에서 95.6%로 Jev(89.0%)를 앞섰습니다. 다만 추론 위주 패널에서는 76.0 대 85.7로 뒤졌습니다(Ollama 판단 모델).
- Jeff(0.8B, 2B)는 금융 감성 분류와 답변을 근거 문서와 대조하는 일에서 Jev보다 나았고, 추론에서는 뒤졌습니다(Jeff vs Jev).
- laya, openjev, NanoJev, DiffusionGemma는 빨랐지만 선택지가 77개가 되면 크게 뒤졌습니다(Jev 대안 셋, DiffusionGemma).
가장 먼저 볼 것은 선택지 개수입니다. 여러 모델이 26개에서 멈춥니다. Ollama 엔드포인트는 그보다 많으면 거절하고, DiffusionGemma 예제 서버도 26개가 한도이고, Jeff v1.0은 긴 목록을 받기는 했지만 27번째 이후를 한 번도 고르지 않았습니다(v1.1에서 고쳐짐). 선택지가 그보다 많으면 후보를 먼저 추리거나, 전체 목록을 받는 모델을 써야 합니다.
다음은 학습 데이터입니다. Kev는 BANKING77, TREC, AG News로, Tev1은 AG News와 BANKING77로, laya는 AG News로 학습했습니다. 학습에 쓴 데이터셋에서 나온 점수는 내 과제에서 어떨지를 거의 알려 주지 않습니다.
5단계: 확률을 믿고 처리해도 될 때
라벨만 받으면 되는데 굳이 판단 모델을 쓰는 이유는 확률입니다. 확신이 높은 답은 자동으로 처리하고, 나머지는 사람에게 넘길 수 있다는 것입니다. 실제로 그게 되는지는 모델보다 과제에 더 크게 좌우됐습니다.
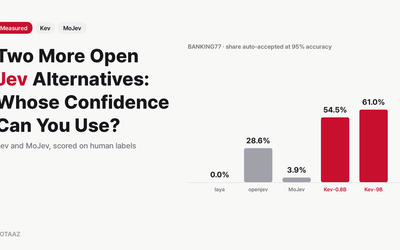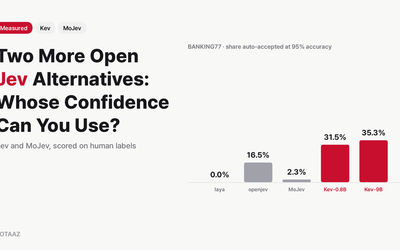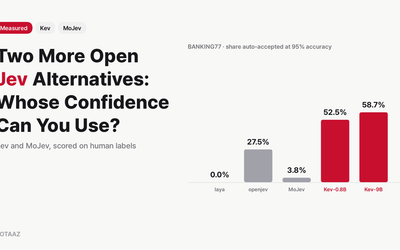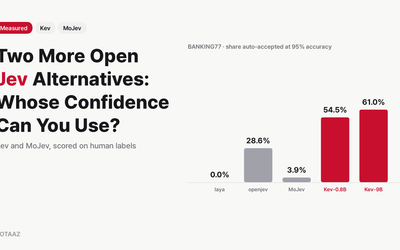
- BANKING77에서 Kev는 자동 처리한 답의 정확도를 95%로 지키면서 문의의 53-61%를 자동 처리할 수 있었습니다. 같은 조건에서 laya는 0%였습니다(Kev와 MoJev).
- Jev의 확률은 실제 정확도보다 높게 나오고 소수 둘째 자리로 반올림돼 있어서, BANKING77에서는 95%를 지키는 임계값이 없었습니다(Kev vs Jev).
- Kev가 처음 보는 과제에서는 확률이 실제보다 10-17%p 낮게 나왔습니다. 대신 어느 선택지에도 맞지 않는 질문 100개 중 95% 기준을 넘은 것은 5개뿐이었습니다. 이런 질문은 넘겨야 하니 바라던 동작입니다(Kev가 처음 보는 과제).
- 같은 모델에 여러 번 물어보는 방법으로는 틀린 답을 가려내지 못했습니다. openjev가 틀린 답의 77-80%는 여덟 번 모두 같은 답이었습니다(판단 모델의 확신을 믿어도 될까).
어떤 모델을 쓰든 임계값은 과제마다 내 라벨 데이터 몇백 건으로 정해야 합니다.
아직 다루지 않은 것
모두 영어 짧은 글에 라벨 하나를 붙이는 분류였습니다. 시간이 지나며 돌아가는 시스템은 재지 않았습니다. 들어오는 문장이 바뀌면 정확도가 어떻게 변하는지, 임계값을 언제 다시 맞춰야 하는지, 일부를 사람에게 넘기는 데 비용이 얼마나 드는지가 그렇습니다. 각 모델은 한 버전만 쟀고, 표본이 154건에서 500건인 글이 많아서 몇 %p 차이는 함께 적은 짝지은 검정만큼만 믿을 수 있습니다.
이 글의 숫자는 모두 링크한 글에서 가져왔고, 실험 설정과 표본, 시드, 짝지은 검정은 그 글에 있습니다. BANKING77 표본은 테스트셋에서 의도마다 두 건씩 뽑은 154건(시드 20260918)입니다. CLINC150 표본은 범위 안 테스트 질문 300건과 범위 밖 질문 100건, MASSIVE는 영어 테스트 문장 175건입니다.
이 글과 이어지는 강좌
SOTAAZ 강좌강좌는 하나씩 살 수 있습니다. 13개 전체가 필요하면 $199 평생 번들도 있습니다.
이메일로 받아보기
관련 포스트
Kev와 MoJev 실측: 오픈소스 Jev 대안 두 개의 정확도와 확률
Jev와 같은 API를 쓰는 Kev(0.8B~9B)와 MoJev(0.85B)를 BANKING77·TREC·AG News에서 사람 라벨로 채점했습니다. Kev의 확률은 쓸 만했습니다. 정확도 95%를 지키며 BANKING77의 53~61%를 자동 통과시켰고, 같은 조건에서 laya는 0%였습니다. 다만 Kev는 이 세 데이터셋으로 학습된 모델이고, 같은 데이터로 학습한 작은 분류기가 BANKING77에서는 여전히 앞섰습니다. MoJev는 보정 오차 0.79%를 발표했지만 여기서는 6~22%였고, 확률이 실제보다 낮게 나왔습니다.
Ollama 판단 모델을 Jev와 같은 문항으로 재 봤습니다: Nimble과 Tev1
Ollama 0.35가 Jev식 판단 모델을 로컬에서 돌립니다. 같은 문항에서 Nimble 9B는 TREC 95.6%로 Jev(89.0%)를 앞섰고, 추론 위주 4,599문항에서는 76.0 대 85.7로 뒤졌습니다. 선택지가 26개를 넘는 질문은 Ollama 엔드포인트가 세 모델 모두 거절했습니다.
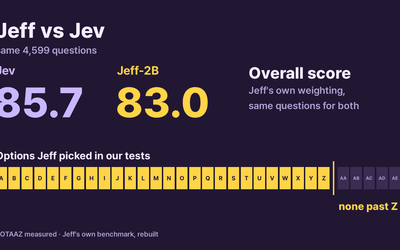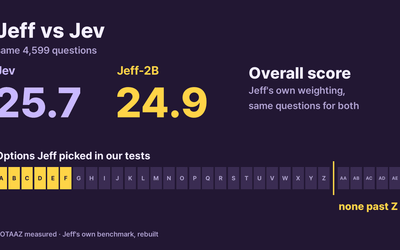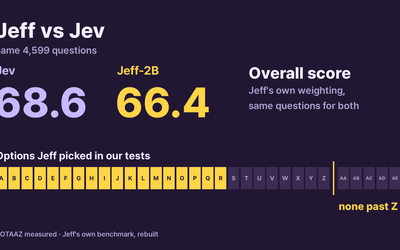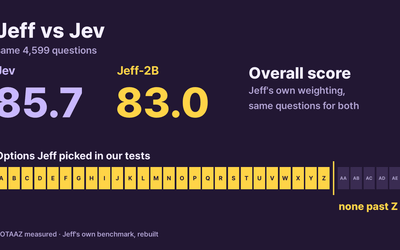
Jeff vs Jev, 같은 문항으로 재 보니: 종합 점수와 선택지 26개 한계(v1.1에서 해결)
Jeff 자체 벤치마크 4,599문항에서 Jev 85.7, Jeff-2B 83.0이었습니다. README의 83.1 대 83.0은 다른 표본끼리 비교한 값입니다. 제 측정에서 Jeff v1.0은 27번째 이후 선택지를 고르지 않았고, v1.1에서 고쳐졌습니다.