Paper of the Week #4 — 절차를 쌓은 것인가, 사례를 쌓은 것인가
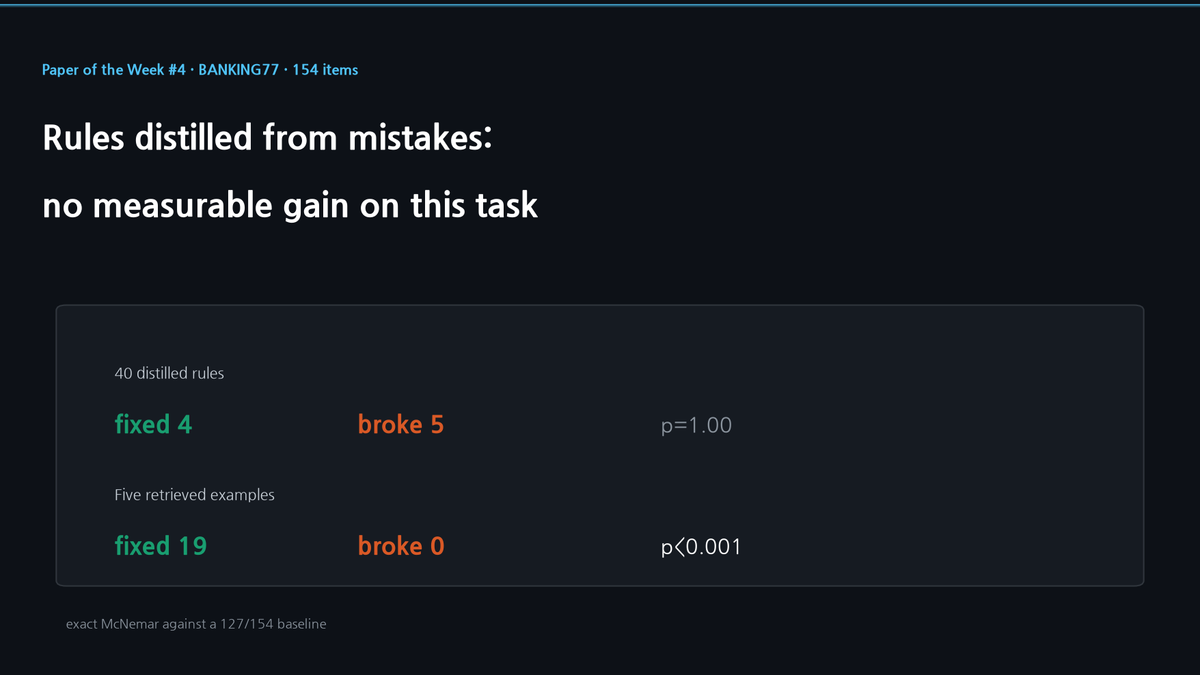
Designer-RSI는 사용자 트래픽에서 자연어 스킬을 모아 실행 성공률을 72.7%에서 99.3%로 올렸다고 보고합니다. 정답이 있는 과제에서 좁은 판으로 만들어 봤습니다. 모델 자신의 오답에서 뽑은 규칙 40줄은 4건을 고치고 5건을 망쳤습니다. 가공하지 않은 사례 다섯 개를 검색해 붙이자 19건을 고치고 하나도 망치지 않았습니다.
Paper of the Week #4 — 절차를 쌓은 것인가, 사례를 쌓은 것인가
배운 것을 글로 적어 두고 나중에 다시 읽는 에이전트는 요즘 가장 매력적인 형태입니다. 파인튜닝도 가중치 갱신도 없이 스킬 파일만 자랍니다. 이번 주 논문은 그 형태로 실행 성공률이 72.7%에서 99.3%가 됐다고 보고합니다. 정답이 있는 과제에서 좁은 판으로 만들어 봤더니 규칙은 아무것도 움직이지 못했고, 가공하지 않은 사례 다섯 개를 건네주자 기준선이 틀린 27건 중 19건이 고쳐졌습니다.
2026년 9월 17일~23일 · Designer-RSI · SWE-bench 리더보드 감사 · TypeSafe Jev 평가
주장
"외부 메모리"라는 말은 서로 다른 둘을 덮고 있습니다. 하나는 절차를 담습니다. 과제를 어떻게 하는지에 대한 자연어 규칙입니다. 다른 하나는 사례를 담습니다. 답이 붙은 지난 건들입니다. 논문은 앞의 것을 보고하지만 실제로는 둘이 함께 돌아가는 경우가 많습니다. 절차가 사례에서 뽑혀 나오고, 그 사례가 루프 안에 그대로 남아 있기 때문입니다.
제 주장은 이렇습니다. 라벨이 고정되고 정답이 있는 과제에서 점수를 올린 것은 절차가 아닙니다. 규칙은 원하는 만큼 정성껏 써도 됩니다. 점수를 바꾸는 것은 관련 있는 사례가 프롬프트에 닿느냐입니다. 이 말이 맞다면, "진화하는 절차 메모리" 덕으로 설명된 시스템은 메모리를 남기고 사례를 뺐을 때 거의 잃지 않아야 하고, 반대로 했을 때 크게 잃어야 합니다.
영수증
Designer-RSI(Hongyang Du, Lan Yan, Christian Flores, Asim Kadav, 2026년 9월 18일 제출)는 프런티어 모델의 가중치를 고정한 채, 실제 사용에서 자연어 스킬 저장소를 키웁니다. 저장소는 "반복해서 나타나는 미해결 하위 작업의 절차를 획득하며 넓어지고", "자기 성공과 실패 실행에 비추어 기존 절차를 고치며 깊어집니다". 실제 사용자 브리프 1,406건과 자동 채점된 궤적 1,869건을 거치며 절차가 76개에서 139개로 늘고, "가중치 갱신도 사람 라벨도 없이" 실행 성공률이 72.7%에서 99.3%가 됐다고 보고합니다. 전용 벤치마크 네 개에서 스킬 없는 에이전트 대비 승률은 61.8%와 67.6%, 미공개 브리프에서는 58.5%(p = 0.025)인데 넓히기만 하면 49.4%, 깊게만 하면 48.6%입니다.
제 주장에 필요한 칸은 논문에 없습니다. 같은 과제, 같은 모델, 같은 채점으로 절차와 사례를 맞대는 칸입니다. 디자인 품질에는 정답지가 없어서 저자들은 모델로 채점했습니다. 저는 정답지가 있는 곳에서 그 비교를 돌렸습니다.
과제는 BANKING77입니다. 은행 의도 77개, 사람이 단 라벨, 테스트 154건(의도마다 2건)입니다. 모델은 GPT-5.6 Terra, 추론 강도 low, 출력은 77개 라벨 중 하나로 제한했습니다. 기준선 프롬프트는 라벨 목록뿐이고 154건 중 127건을 맞힙니다.
그 위에 좁은 판의 Designer-RSI를 만들었습니다. 학습 세트 600건을 기준선으로 분류해 틀린 72건을 모으고, 혼동 쌍 52종으로 묶은 뒤, 빈도 상위 40종마다 운영 규칙을 한 줄씩 쓰게 했습니다. "배송 예상 기간을 묻는 경우에는 card_delivery_estimate를, 카드가 이미 도착했는지 말하거나 묻는 경우에만 card_arrival을 고르십시오" 같은 문장입니다. 규칙에는 예시 문장을 한 줄도 넣지 않았습니다. 논문이 긋는 구분 그대로 절차만 남겼습니다. 이 메모리는 7,138자이고 모든 프롬프트에 함께 실립니다.
결과는 4건을 고치고 5건을 망쳤습니다. 같은 기준선, 같은 154건에서 정확 McNemar 검정으로 p = 1.0입니다.
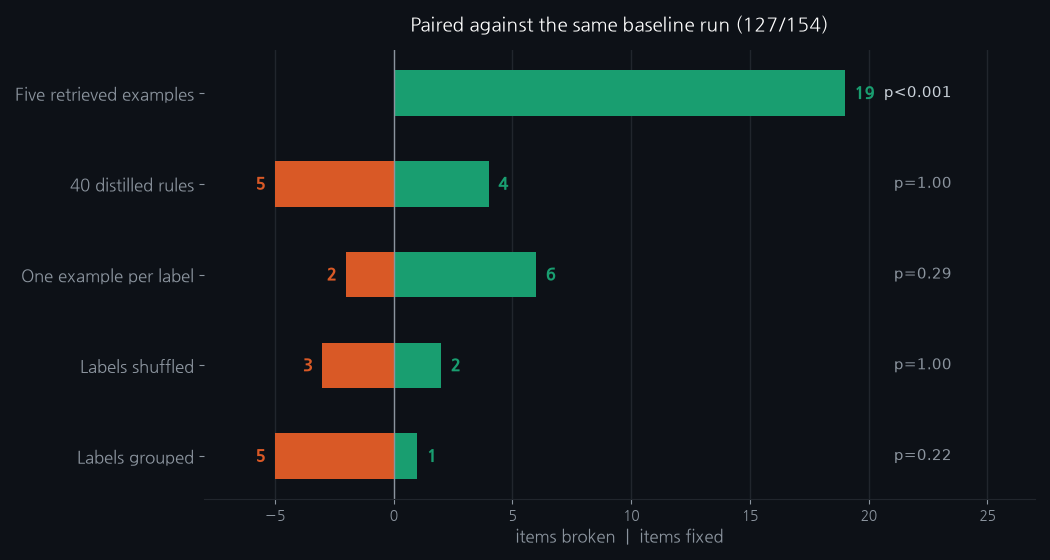
대비가 이 글의 핵심입니다. 규칙을 빼고 같은 학습 세트에서 임베딩으로 찾은 사례 다섯 개를 붙이면, 규칙도 증류도 없이 가장 가까운 라벨 달린 사례만 주는데도 같은 모델이 19건을 고치고 하나도 망치지 않습니다. p는 약 3.8×10⁻⁶입니다. 라벨마다 예시 하나씩 고정으로 넣은 판은 중간입니다. 6건을 고치고 2건을 망쳐 p = 0.29입니다. 라벨 순서를 섞거나 주제로 묶는 것은 어느 쪽으로도 움직이지 않았고, 그것이 이 비교의 잡음 수준입니다.
제 실험의 약한 곳을 적습니다. 과제 하나, 모델 하나, 한 가지 방식으로 만든 메모리 하나입니다. 제 규칙은 600건에서 한 번에 뽑았는데, 논문은 다섯 라운드를 돌며 절차를 자기 결과에 비추어 고칩니다. 그 수정 루프를 저는 구현하지 않았고, 고쳐지지 않는 규칙 저장소는 이 발상의 가장 약한 판본입니다. 분류는 검색에 가장 유리한 경우이기도 합니다. 답이 라벨이고, 가까운 사례가 그 답을 그대로 들고 있습니다. 디자인 작업에는 답을 손에 쥔 최근접 이웃이 없고, 그래서 그 영역에는 절차가 필요합니다.
대비
Designer-RSI가 주장을 세웁니다. 절차 자체를 지지하는 가장 강한 증거는 절제 실험입니다. 미공개 브리프에서 넓히기만 49.4%, 깊게만 48.6%, 둘 다 하면 58.5%(p = 0.025)입니다. 다만 이것은 루프가 중요하다는 논증이지 자연어 규칙이 사례를 이긴다는 논증이 아닙니다. 비교에 사례만 쓰는 조건이 없고, 채점은 전 구간 자동입니다.
SWE-bench 리더보드 감사(arXiv 2609.17394)는 다른 쪽에서 같은 문제를 짚습니다. 같은 모델 안 스캐폴드 폭이 29.8%p에 이르고 상위 30개 항목 사이 폭은 8.8%p라고 보고한 뒤, 스캐폴드 논문들이 대개 건너뛰는 일을 합니다. 문항을 짝지어 정확 McNemar 검정을 돌리는 것입니다. 결론도 다른 의미에서 절차적입니다. 모델과 스캐폴드의 출처를 함께 적고, 작은 총점 차이를 순위로 읽지 말라는 것입니다.
TypeSafe의 Jev 평가는 증거로 쓸 수 없는 쪽이고, 왜 그런지 적을 값어치가 있습니다. 네 워크플로 종합에서 Jev는 67.8%, GPT-5.6 Terra(workflow)는 67.9%로 보고하는데, 정답이 GPT-6 Astra와 Claude Fable 5.1에 높은 추론 강도로 받은 응답의 평균입니다. 프런티어 모델 둘을 기준으로 잰 숫자는 정답률이 아니라 일치율입니다. Designer-RSI의 자동 채점은 BANKING77의 사람 라벨보다 이쪽에 가깝습니다.
제가 틀렸다고 판정될 조건
둘 다 확인 가능한 조건입니다. 첫째, 수정 루프를 붙였을 때입니다. 새 학습 오답에 비추어 규칙을 세 라운드 다시 채점하고 한 번도 걸리지 않는 규칙을 버린 뒤, 같은 154건에서 규칙 메모리가 망친 것보다 고친 것이 많고 p < 0.05가 나오면, 문제는 절차가 아니라 한 번에 뽑은 증류였습니다. 둘째, 검색한 사례가 답을 들고 있지 않은 과제에서 같은 비교를 돌렸을 때입니다. 여러 단계 도구 사용 같은 경우인데, 거기서 규칙이 이기면 제 주장은 참이 아니라 조회형 과제에 한정된 이야기가 됩니다. 둘 다 돌려서 6호에서 채점하겠습니다.
당장 바꿀 것
에이전트용 스킬 파일을 만들려는 참이라면, 사례 조건을 먼저 재십시오. 저는 반나절과 API 비용 몇 달러가 들었습니다. 학습 세트에 기준선을 돌려 오답을 남기고, 프롬프트 두 개를 같은 검증 문항에서 비교하면 됩니다. 하나는 증류한 규칙을 싣고 하나는 가장 가까운 라벨 달린 사례를 싣습니다. 채점은 정확도 두 개를 나란히 적는 대신 짝지은 검정으로 합니다. 제 과제에서는 검색 쪽이 이득의 전부였고 규칙은 버려도 됐습니다. 여러분 과제에서는 반대일 수 있는데, 스킬 저장소가 계속 관리해야 할 기반이 되기 전에 알아 두는 편이 낫습니다.
정산
3호는 이번 호에 세 가지를 약속했습니다. 둘은 지키지 못했고, 조건부였던 하나는 확인하지 않았습니다. norm_topk_prob: false인 또 다른 모델인 DeepSeek-V2-Lite를 두 번째 대조군으로 돌려 k₂가 효과가 있는지 보겠다고 했는데 돌리지 않았습니다. batch 8과 32에서 생긴 생성 텍스트 차이를 없애려고 모든 조건에 같은 토큰 열을 강제로 넣겠다는 약속도 지키지 못했습니다. Scale-QLoRA의 단순 병합은 본문과 코드가 공개되면 다루겠다는 조건부 약속이었는데, 공개됐는지 확인하지 않았으니 실패가 아니라 미확인으로 둡니다. 2호부터 남아 있던 HoH 10회 반복 항목도 그대로 원장에 있습니다. 이 시리즈가 2주를 건너뛴 것과 한 묶음인 사실입니다. GPU가 다른 측정에 쓰였고 실험 준비가 2주 앞서 있지 않았습니다. 이 시리즈가 스스로 경계했던 바로 그 함정입니다. 이번 호도 9월 23일 주에 쓴 원고이고, 한 주 늦게 발행합니다. 재현 연속 기록은 초기화하고, 이번 호의 영수증으로 1주부터 다시 셉니다. DeepSeek 대조군과 토큰 열 강제는 5호 정산으로 옮기고, DeepSeek을 먼저 다룹니다. 3호의 다른 조건, 배치 1에서 1.5배를 내는 k₂ 융합 커널은 아직 그런 커널이 없어 채점할 수 없습니다. 다음 호에서는 정산란에서 그 대조군을 다루고, 메인 논문은 원고를 쓰기 전에 영수증 실험을 먼저 돌리겠습니다.
이메일로 받아보기
관련 포스트
Jev의 속도 주장, 라벨만 필요한 분류에도 적용될까? BANKING77 기준선 실측
BANKING77 테스트셋에서 라벨만 출력하는 네 가지 분류 방식을 같은 메시지 154건으로 비교했습니다. MiniLM 임베딩과 로지스틱 회귀는 CPU에서 정확도 90.3%, 지연 중앙값 6.8ms를 기록했습니다. Jev 자체는 아직 측정하지 않았습니다.
판단 모델은 라벨 몇 개의 값어치일까: Kev가 처음 보는 과제 세 개 실측
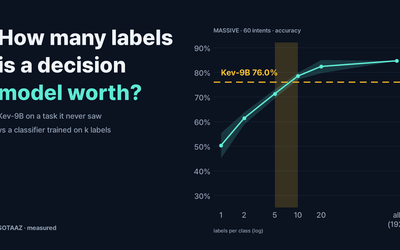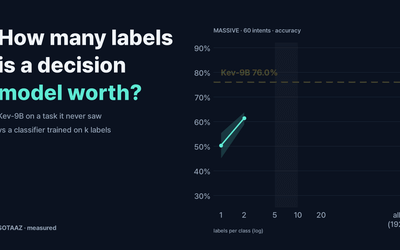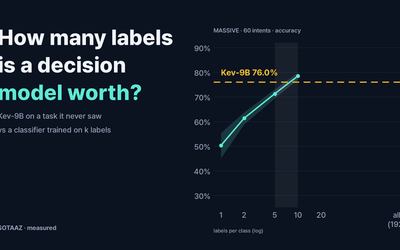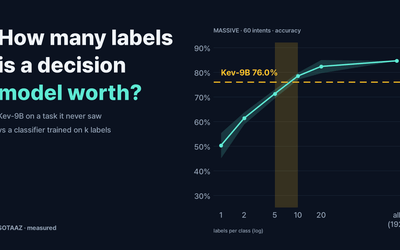
Kev가 학습하지 않은 CLINC150, MASSIVE, 금융 뉴스 트윗에서 Kev-9B의 정확도는 클래스마다 라벨 2~20개로 학습한 작은 분류기와 비슷했습니다. 확률은 실제 정답률보다 10~17%p 낮게 나왔고(보정 오차 11~17%, 익숙한 데이터에서는 2~9%), 정확도 95% 기준으로 자동 통과시킬 수 있는 비율은 23~58%였습니다. 선택지에 없는 질문에는 낮은 확률을 붙여서 100개 중 5개만 그 기준을 넘었습니다. 0.8B 모델은 금융 트윗 200개 중 152개를 'Financials'로 답했습니다.
오픈소스 Jev 대안 셋을 같은 데이터로 재 보니: laya·openjev·NanoJev 실측
laya, openjev, NanoJev를 A100 한 장에서 BANKING77(의도 77개), TREC(질문 유형 6개), AG News로 쟀습니다. 선택지가 6개면 421M짜리 laya가 TREC 86.6%를 23ms에 냈고, 77개면 DiffusionGemma 기반 openjev가 66.9%로 앞섰습니다. 다만 77개에서는 CPU에서 도는 로지스틱 회귀가 90%로 전부를 이겼습니다.