단순한 분류기로 어디까지 될까: 『작은 AI로 판단 시스템 만들기』 2장 미리 보기
무료 샘플 장입니다. BANKING77을 학습 전에 먼저 나누고, CPU 분류기 두 개로 테스트 정확도 91.2%와 92.9%를 냅니다. 1분 남짓이면 돌아가는 코드도 함께 받을 수 있습니다.
단순한 분류기로 어디까지 될까: 『작은 AI로 판단 시스템 만들기』 2장 미리 보기
쓰고 있는 책 『작은 AI로 판단 시스템 만들기』의 2장입니다. 책은 예제 하나를 처음부터 끝까지 따라갑니다. 은행에 들어온 문의를 의도 77개로 나누고, 시스템이 확신하는 문의는 자동으로 답하고 나머지는 사람에게 넘깁니다. 이 장은 혼자 읽어도 되고, 코드는 5KB짜리 파일 하나로 받을 수 있습니다: decision-book-code-ch02.zip. 책 전체 목차는 글 끝에 있습니다.
이 장을 마치면 책의 나머지 장이 기대는 세 가지가 손에 남습니다.
- 아무것도 학습하기 전에 정해 둔 학습·검증·테스트 분할
- 고객 문의를 의도 77개로 나누는 분류기. 노트북 CPU에서 돌고, 한 건에 몇 밀리초면 답합니다.
- 이 분류기가 틀리는 문의의 목록. 뒤의 장들은 여기서 시작합니다.
이 장은 GPU 없이 돌아갑니다. 제 컴퓨터에서는 설치에 1분, 처음 실행(데이터와 모델 다운로드 포함)에 1분 정도 걸렸습니다. 노트북이라면 몇 분 걸립니다.
2.1 어떤 문제를 푸는가
은행에는 "I am still waiting on my card?" 같은 짧은 문의가 들어오고, 누가 답하기 전에 이 문의가 무엇에 관한 것인지부터 정해야 합니다. PolyAI가 공개한 BANKING77은 이런 문의 13,083건을 모아, 사람이 하나하나 의도 77개 중 하나를 붙인 데이터입니다. card_arrival(카드 도착), exchange_rate(환율), verify_my_identity(본인 인증) 같은 식입니다. CC BY 4.0으로 공개돼 있어서 출처만 밝히면 자기 작업에 쓸 수 있습니다.
파일은 둘입니다. 학습용 10,003건과 테스트용 3,080건입니다. 학습 파일은 의도마다 건수가 고르지 않습니다. 아래에서 나눈 뒤 기준으로 가장 적은 의도는 학습 문장이 31건, 가장 많은 의도는 168건입니다.
책 한 권을 이 데이터 하나로 끌고 가는 이유는, 실제 문의 분류와 닮았기 때문입니다. 선택지가 많고, 그중 몇은 서로 아주 가깝습니다("모르는 카드 결제"와 "모르는 자동이체"처럼). 문장은 짧고 말투도 제각각입니다. 그러면서도 크기가 작아서, 책에 나오는 실험은 모두 컴퓨터 한 대에서 몇 분 안에 끝납니다.
2.2 환경 준비
Python 3.11 이상이 필요합니다. 책의 코드가 있는 폴더에서 다음을 실행합니다.
python3 -m venv .venv
source .venv/bin/activate            # Windows: .venv\Scripts\activate
pip install --upgrade pip
pip install torch==2.8.0 --index-url https://download.pytorch.org/whl/cpu
pip install -r requirements.txt
네 번째 줄은 PyTorch의 CPU 전용 판을 설치합니다. 기본 판보다 훨씬 작습니다. 버전을 고정해 두었기 때문에, 같은 버전으로 설치하면 이 장의 숫자와 거의 같은 결과가 나옵니다.
2.3 학습하기 전에 먼저 나눕니다
bank.py를 열어 보세요. load() 함수는 처음 실행할 때 파일 두 개를 내려받고, 정해 둔 해시값과 맞는지 확인합니다. 그래서 책과 같은 데이터를 쓰고 있는지 알 수 있습니다. 그다음 데이터를 셋으로 나눕니다.
- 학습(train): 의도마다 학습 문장의 90%, 모두 9,000건입니다. 모델은 이 문장들로 배웁니다.
- 검증(validation): 의도마다 나머지 10%, 모두 1,003건입니다. 어떤 모델을 쓸지, 설정을 무엇으로 할지, 5장부터는 기준값을 얼마로 할지 같은 선택은 전부 이 문장들을 보고 정합니다.
- 테스트(test): 공식 테스트 문장 3,080건입니다. 선택을 다 끝낸 뒤 마지막에 한 번만 채점합니다.
10%를 의도마다 떼는 이유는, 드문 의도까지 검증 세트에 빠짐없이 들어가게 하려는 것입니다. 무작위 시드를 고정해 두었으니 몇 번을 돌려도, 어느 장에서 돌려도 같은 분할이 나옵니다.
아직 아무것도 학습하지 않았는데 왜 셋으로 나누는지 궁금할 수 있습니다. 습관은 처음부터 들이는 것이 가장 쉽기 때문입니다. 설정 열 가지를 시험해 보고 테스트 세트에서 가장 잘 나온 것을 고르면, 그 테스트 점수는 더 이상 정직한 추정이 아닙니다. 그 점수를 보고 골랐기 때문입니다. 책 뒤쪽에서 기준값을 고를 때는 이 실수의 대가가 커집니다. 이 블로그에서 다른 데이터셋인 CLINC150으로 같은 방식의 라우팅 시스템을 재 봤을 때(어떤 문의를 사람에게 넘겨야 할까), 검증 세트로 고른 기준값이 모르는 질문이 더 많은 테스트 세트에서는 목표에 한참 못 미쳤습니다. 테스트 세트를 따로 두고 한 번만 채점하지 않았다면 모르고 지나갔을 일입니다.
2.4 첫 번째 기준선: 단어 세기
다음을 실행합니다.
python ch02_baseline.py첫 번째 모델은 텍스트 분류에서 가장 오래된 방법입니다. TF-IDF는 문장 하나를 단어와 글자 조각의 빈도에 가중치를 붙인 긴 벡터로 바꾸고, 로지스틱 회귀는 의도마다 각 특징에 붙일 가중치를 배웁니다. 코드로는 몇 줄입니다.
tfidf = make_pipeline(
    make_union(TfidfVectorizer(ngram_range=(1, 2), sublinear_tf=True),
               TfidfVectorizer(analyzer="char_wb", ngram_range=(3, 5), sublinear_tf=True)),
    LogisticRegression(C=10, max_iter=3000),
)
tfidf.fit(train_texts, train_labels)
단어 특징은 "exchange rate" 같은 구절을 잡고, 글자 특징(3-5글자 조각)은 "recieved" 같은 오타와 철자 변형을 잡습니다. 검증 세트에서 89.6%를 맞혔고, 문의 한 건에 1.5ms가 걸렸습니다. 따로 내려받을 것이 없고, 학습은 22초 걸렸습니다.
2.5 두 번째 기준선: 문장 임베딩
두 번째 모델은 단어 빈도 대신 문장 임베딩을 씁니다. 미리 학습된 작은 신경망(all-MiniLM-L6-v2, 매개변수 2,200만 개, 약 90MB)이 문장 하나를 숫자 384개로 바꾸는데, 뜻이 비슷한 문장끼리 가까운 자리에 놓입니다. "Where is my new card?"와 "My card hasn't arrived yet."은 겹치는 단어가 거의 없지만 가까이 놓입니다. 로지스틱 회귀는 이 384개 숫자를 보고 의도를 고릅니다.
encoder = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2", device="cpu")
E_train = encoder.encode(train_texts, normalize_embeddings=True)
emb = LogisticRegression(C=10, max_iter=3000).fit(E_train, train_labels)
검증 세트에서 90.8%를 맞혔고, 한 건에 6.6ms가 걸렸습니다. 대부분은 인코더가 쓰는 시간입니다. 학습은 9초였고, 거의 전부 학습 문장 9,000건을 인코딩하는 시간이었습니다.
| 검증 세트 (1,003건) | 정확도 | 상위 5개 안에 정답 | 한 건 (CPU) |
|---|---|---|---|
| TF-IDF + 로지스틱 회귀 | 89.6% | 98.4% | 1.5ms |
| 임베딩 + 로지스틱 회귀 | 90.8% | 99.0% | 6.6ms |
두 모델은 비슷합니다. 1,003건에서 1.2%p 차이는 문장 12건입니다. 그러니 어느 쪽이 앞섰는지에 큰 뜻을 두지 않는 편이 좋습니다. 두 모델을 같은 문장으로 제대로 비교하는 방법은 4장에서 다룹니다. 그보다 눈여겨볼 것은 둘 다 이미 열에 아홉을 맞힌다는 점입니다. 언어 모델 없이도 그렇습니다.
2.6 틀린 문의 읽기
스크립트는 가장 자주 헷갈린 의도 쌍을 출력합니다. 임베딩 모델의 검증 결과는 이렇습니다.
3 x  transfer_not_received_by_recipient  ->  predicted transfer_timing
3 x  direct_debit_payment_not_recognised  ->  predicted card_payment_not_recognised
2 x  pending_cash_withdrawal  ->  predicted declined_cash_withdrawal
2 x  contactless_not_working  ->  predicted card_arrival
2 x  unable_to_verify_identity  ->  predicted verify_my_identity
대부분 이웃한 의도입니다. 사람이 분류해도 한 번 더 생각해야 하는 쌍입니다. 모델이 틀렸다기보다 라벨을 어떻게 붙였느냐의 문제로 볼 만한 것도 있습니다. 검증 세트에서 direct_debit_payment_not_recognised(모르는 자동이체)로 라벨이 붙은 문장 하나는 "There is a payment in my app that I did not make. I have not used that card all day…"입니다. 모델은 card_payment_not_recognised(모르는 카드 결제)라고 답했는데, 사람이 읽어도 그렇게 답할 수 있습니다.
표의 다른 칸도 같은 이야기를 합니다. 검증 문장의 99.0%는 모델이 고른 상위 5개 안에 정답이 있었습니다. 모델이 틀릴 때는 대개 조금 틀립니다.
다만 이 관찰만으로 무엇을 해야 할지가 정해지지는 않고, 성급하게 결론을 내리기 쉬운 지점입니다. 5장에서는 그럴듯해 보이는 방법 하나를 시험합니다. 분류기가 자신 없어 하는 문의를, 분류기가 고른 후보와 함께 판단 모델에 넘기는 것입니다. 이 블로그에서 해 봤을 때는 CLINC150에서는 도움이 됐고 BANKING77에서는 그렇지 않았습니다. 데이터에 따라 답이 달라진다는 뜻입니다.
2.7 테스트 세트는 한 번만
선택을 마쳤으니(두 모델 모두 다음 장으로 가져갑니다) 테스트 세트를 채점합니다.
python ch02_baseline.py --test| 테스트 세트 (3,080건) | 정확도 | 상위 5개 안에 정답 |
|---|---|---|
| TF-IDF + 로지스틱 회귀 | 91.2% | 99.0% |
| 임베딩 + 로지스틱 회귀 | 92.9% | 99.3% |
두 모델 모두 검증보다 테스트에서 점수가 높았습니다. 이유는 아직 확인하지 못했습니다. 검증 문장은 학습 파일에서, 테스트 문장은 별도 파일에서 왔으니 두 파일의 차이부터 보는 것이 순서입니다. 테스트 세트는 어떤 선택에도 쓰지 않았으므로 정보가 샌 흔적으로 볼 이유는 없습니다. 점수가 어떤 데이터로 쟀느냐에 따라 달라진다는 것을 처음 보여 주는 장면입니다.
2.8 다른 방법과 비교하면
이 블로그에서는 이 테스트 문장 중 154건(의도마다 2건)으로 다른 방법들을 비교했습니다(텍스트 분류 안내). 같은 154건에서 이 임베딩 분류기(거기서는 학습 문장 10,003건 전부로 학습)는 90.3%, 라벨 이름 77개만 받은 GPT-5.6 Terra는 네 번 돌려 81.2-83.8%, 호스팅 판단 모델인 Jev는 76.0%를 맞혔습니다. 154건이면 각 숫자가 문장 몇 건씩 오르내릴 수 있습니다. 볼 것은 방향입니다. 이미 가진 라벨 데이터로 학습한 분류기는 출발점으로 삼기 좋고, 문의 한 건마다 드는 비용도 없습니다.
이 분류기가 못 하는 일은, 자기 답 중 어느 것을 믿어도 되는지 알려 주는 것입니다. 자신 없는 문의에도, 어느 의도에도 맞지 않는 문의에도 똑같이 답을 냅니다. 이 책의 나머지가 다루는 것이 바로 그 부분입니다.
연습문제
- 규제 강도 바꾸기.
ch02_baseline.py에서 두 모델의C를 1과 100으로 바꿔 봅니다. 검증 세트로만 비교합니다. 두 모델의 순위가 바뀌나요? - 라벨 줄이기. 임베딩 모델을 의도마다 20건씩만으로 학습해 봅니다(
train에서 시드를 고정해 뽑습니다). 정확도가 얼마나 떨어지나요? 4장에서는 라벨 예시가 하나도 필요 없는 판단 모델과 이 결과를 비교합니다. - 틀린 문의 열 건 읽기. 임베딩 모델이 틀린 검증 문장 열 건을 정답 의도, 예측 의도와 함께 출력합니다. 하나씩 모델이 틀렸는지, 라벨이 틀렸는지, 두 의도 모두 맞는지 판단해 봅니다. 이 목록은 남겨 두세요. 5장에서 이런 문의를 다시 다룹니다.
실행이 안 될 때
ensurepip is not available이 나오거나 Python이 오래된 경우. 일부 리눅스는venv없이 Python을 설치합니다. python.org에서 Python 3.11 이상을 설치하거나, 패키지 관리자로 설치합니다(Debian·Ubuntu는python3.11-venv).- PyTorch가 몇 GB를 내려받는 경우. CPU 전용 설치 줄을 건너뛰어서 pip가 GPU 판을 받은 것입니다. 가상환경을 지우고 2.2의 명령으로 다시 시작합니다.
- 모델을 내려받지 못하는 경우(인터넷이 막혀 있거나 프록시가 있을 때). 인터넷이 되는 컴퓨터에서 한 번 실행한 뒤 Hugging Face 캐시 폴더(
~/.cache/huggingface)를 옮기거나,HF_HOME을 옮길 수 있는 폴더로 지정합니다. unexpected contents (sha256 …)가 나오는 경우. 데이터 파일이 덜 받아졌거나 바뀐 것입니다.data/폴더를 지우고 다시 실행합니다.- 숫자가 책과 조금 다른 경우.
pip list로 패키지 버전을requirements.txt와 비교합니다. 마지막 자리 정도의 차이는 CPU가 달라서 생길 수 있습니다. 1%p 이상 다르다면 다른 무언가가 바뀐 것입니다.
측정 환경: 이 장의 코드, Python 3.11.4, torch 2.8.0(CPU 판), scikit-learn 1.9.1, sentence-transformers 6.1.0, numpy 2.4.6, AMD EPYC 7742(64코어), GPU는 숨기고 빈 모델 캐시에서 시작했습니다. 속도는 검증 문장 200건을 한 건씩 처리한 중앙값이고, PyTorch 기본값인 CPU 스레드 64개로 쟀습니다(스레드 4개로 잰 이 블로그의 라우팅 실측에서는 같은 분류기가 8ms였습니다). 노트북에서는 더 느립니다. 이 장의 숫자는 모두 measured/ch02.json에 있습니다. 데이터는 BANKING77 커밋 57ec275, 분할 시드는 20261001입니다.
책의 나머지 장
| 장 | 답하는 질문 | 장을 마치면 손에 남는 것 |
|---|---|---|
| 1. 무엇을 판단하는가 | 선택지는 무엇이고, 어떤 실수가 비싼가? | 라벨 정의, 평가용 데이터, 실수 종류마다 매긴 비용 |
| 2. 첫 기준선 | 단순한 분류기로 어디까지 되는가? | 고정한 학습·검증·테스트 분할, 열에 아홉을 맞히는 CPU 분류기 두 개 |
| 3. 언어 모델 활용 (API) | LLM에 예시와 설명을 어떻게 줄까? | 가까운 예시를 찾아 붙이는 LLM 분류기와, 같은 문장으로 비교한 결과 |
| 4. 판단 모델 (API, GPU가 있으면 로컬) | 전용 판단 모델은 언제 쓸 만한가? | 내 분류기와 같은 문장으로 비교한 보고서 |
| 5. 모르는 것은 사람에게 | 어떤 답을 자동 처리하고 어떤 답을 넘길까? | 검증 세트로 기준값을 고르고 테스트로 한 번 확인한 라우팅 시스템. BANKING77에는 77개 의도 밖의 질문이 없어서, 의도 10개를 학습에서 빼고 그 문장들을 "모르는 질문"으로 씁니다 |
| 6. 운영하기 | 들어오는 문장과 의도가 바뀌면 무엇을 해야 하나? | 새 의도가 들어올 때의 반응을 기록한 로그와, 다시 확인할 항목과 시점(5장에서 뺀 의도 10개가 새 의도로 들어옵니다) |
1, 2, 5, 6장은 GPU 없이 컴퓨터 한 대에서 돌아가고, 3장과 4장은 호스팅 API를 부릅니다(API 키와 몇 달러). GPU가 있다면 4장은 Ollama로 로컬에서 돌릴 수도 있습니다.
책이 나오면 알려 드립니다
나머지 다섯 장도 같은 방식으로 쓰고 있습니다. 예제 하나, 직접 돌려 볼 수 있는 코드, 그 코드에서 나온 숫자입니다. 이메일을 남겨 주시면 책이 나올 때 한 번 알려 드립니다.
이 글과 이어지는 강좌
SOTAAZ 강좌강좌는 하나씩 살 수 있습니다. 13개 전체가 필요하면 $199 평생 번들도 있습니다.
이메일로 받아보기
관련 포스트
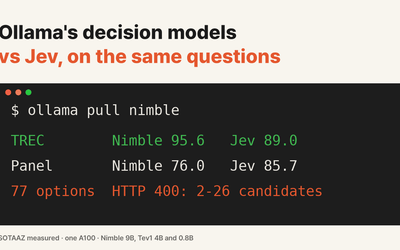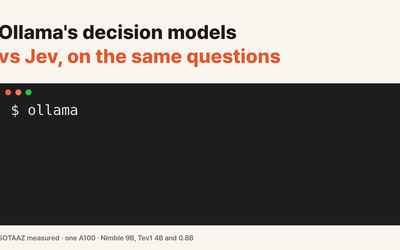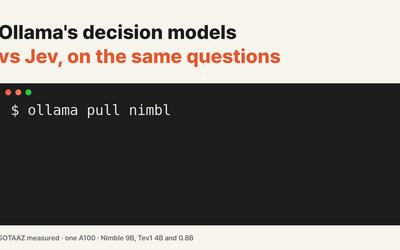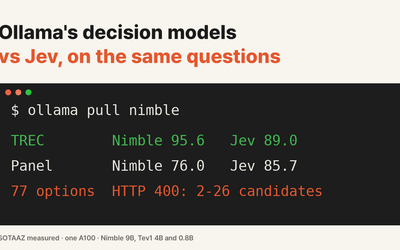
Ollama 판단 모델을 Jev와 같은 문항으로 재 봤습니다: Nimble과 Tev1
Ollama 0.35가 Jev식 판단 모델을 로컬에서 돌립니다. 같은 문항에서 Nimble 9B는 TREC 95.6%로 Jev(89.0%)를 앞섰고, 추론 위주 4,599문항에서는 76.0 대 85.7로 뒤졌습니다. 선택지가 26개를 넘는 질문은 Ollama 엔드포인트가 세 모델 모두 거절했습니다.
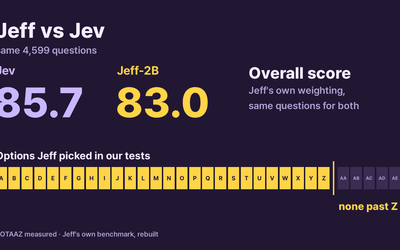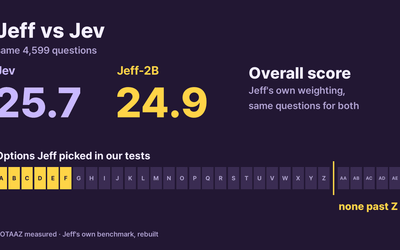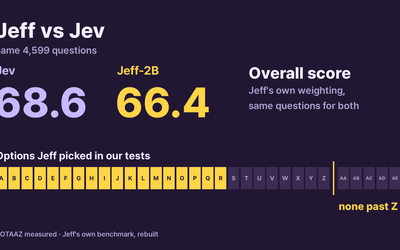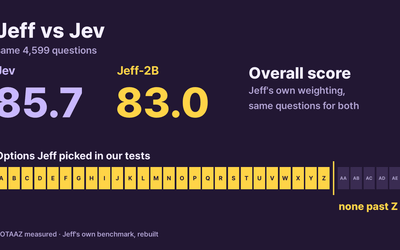
Jeff vs Jev, 같은 문항으로 재 보니: 종합 점수와 선택지 26개 한계(v1.1에서 해결)
Jeff 자체 벤치마크 4,599문항에서 Jev 85.7, Jeff-2B 83.0이었습니다. README의 83.1 대 83.0은 다른 표본끼리 비교한 값입니다. 제 측정에서 Jeff v1.0은 27번째 이후 선택지를 고르지 않았고, v1.1에서 고쳐졌습니다.
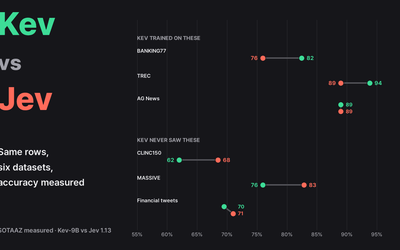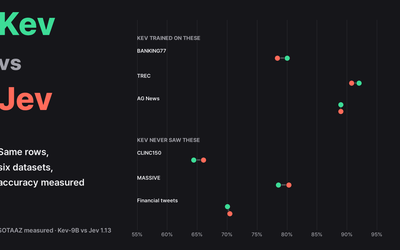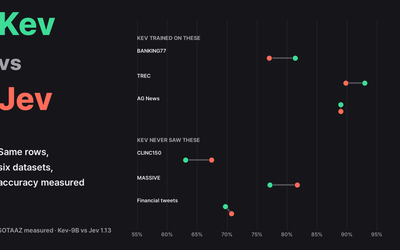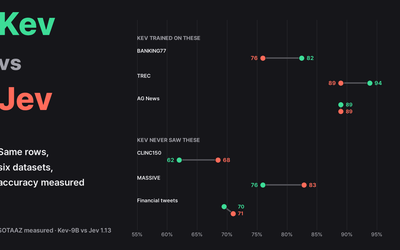
Kev vs Jev: Kev 0.8B~9B와 Jev의 정확도·확률 보정 비교
같은 문장 1,629개(요청 2,329건)에 Kev(0.8B, 4B, 9B)와 Jev 1.13을 돌렸습니다. Kev가 학습한 데이터셋 세 개에서는 Kev-9B가 같거나 앞섰고(TREC 93.8% 대 89.0%), 처음 보는 세 개 중 두 개에서는 Jev가 앞섰습니다(CLINC150 68.5% 대 62.0%, MASSIVE 82.9% 대 76.0%). Jev 확률은 실제 정확도보다 높게 나오고 소수 둘째 자리로 반올림돼 있어서, BANKING77에서는 정확도 95%를 지키는 임계값이 없었습니다.