결정 모델은 이런 문장에서 틀립니다: 여러 모델이 함께 틀린 문장에서 되풀이된 네 가지 상황
결정 모델 최대 14개를 데이터 6개에 돌린 건별 결과를 다시 읽고, 절반 이상의 모델이 틀린 문장 433개를 모았습니다. 이 문장들을 묶고 간단한 특징을 비교해 보니 네 가지 상황이 되풀이됐습니다. 질문의 겉모양과 데이터의 정답 규칙이 다른 경우, 범주가 겹치는 경우, 문장에 다른 선택지의 이름이 들어 있는 경우, 맞는 선택지가 없는 경우입니다. 예시, 전체 묶음 표, 선택지에서 확인할 점을 정리했습니다.
결정 모델은 이런 문장에서 틀립니다: 여러 모델이 함께 틀린 문장에서 되풀이된 네 가지 상황
지난 몇 주 동안 Jev 같은 결정 모델 십여 개를 공개 데이터 6개로 쟀습니다. 그 글들은 어느 모델이 더 잘 맞히는지를 물었습니다. 이번에는 질문을 바꿨습니다. 모델 대부분이 공통적으로 틀린 문장은 어떤 문장일까요?
선택지를 직접 설계할 때는 잘되는 것보다, 안 되는 부분을 확인하는 게 더 유용할 때가 있습니다. 모델 열 개가 똑같이 틀린 문장이라면 모델 하나의 버릇이라기보다, 선택지를 쓴 방식이나 들어오는 입력에 원인이 있을 가능성이 큽니다.
이번 글을 위해 새로 돌린 모델은 없습니다. 앞선 글들에서 저장해 둔 건별 결과를 다시 읽었습니다. 모델별 점수나 순위는 싣지 않습니다.
무엇을 다시 읽었나
- 데이터: TREC(질문 500개, 답 유형 6개), AG News(기사 200개, 주제 4개), 금융 뉴스 트윗(200개, 주제 20개), MASSIVE(요청 175개, 의도 60개), CLINC150(요청 400개, 의도 150개), BANKING77 표본 154개(의도 77개).
- 모델: API로 부른 Jev 1.13, Kev 0.8B·4B·9B, Jeff v1.1 0.8B·2B, laya, MoJev, NanoJev, openjev, DiffusionGemma 예제 서버, Ollama의 Nimble 9B·Tev1 4B·Tev1 0.8B. 데이터마다 실제로 돌린 모델만 씁니다. TREC과 AG News는 14개, 트윗과 BANKING77은 11개, MASSIVE와 CLINC150은 8개입니다.
- 조건: 선택지 이름만 주고 설명은 주지 않은 실행입니다. Kev와 MoJev 실측, Kev가 처음 보는 과제, Kev vs Jev, Jeff vs Jev, Ollama 글, 오픈소스 대안 비교에서 돌린 결과입니다.
- 어려운 문장: 그 데이터의 모델 중 절반 이상이 틀린 문장입니다. 데이터 6개를 합쳐 433개입니다.
- 묶음: 정답이 같고, 모델들이 가장 많이 고른 오답도 같은 어려운 문장끼리 묶었습니다. 3문장 이상인 묶음은 모두 글 끝의 표에 있고, 본문에서는 그중 일부를 다룹니다. 어떤 문장이 어느 묶음에 들어가는지는 규칙이 정합니다. 소제목은 문장을 읽은 뒤 저희가 붙인 해석입니다.
- 특징: 미리 정한 간단한 특징으로 문장을 표시하고, 표시한 문장과 나머지 문장에서 틀린 모델 비율을 비교했습니다. 3번 상황은 묶음이 아니라 이 비교에서 나왔습니다.
| 데이터 | 선택지 | 모델 | 문장당 틀린 모델 비율(평균) | 어려운 문장 | 모든 모델이 틀린 문장 |
|---|---|---|---|---|---|
| TREC | 6 | 14 | 28% | 500개 중 87개 | 5 |
| AG News | 4 | 14 | 16% | 200개 중 21개 | 4 |
| 금융 트윗 | 20 | 11 | 45% | 200개 중 80개 | 16 |
| MASSIVE | 60 | 8 | 33% | 175개 중 45개 | 11 |
| CLINC150 | 150 | 8 | 44% | 400개 중 154개 | 105 |
| BANKING77 | 77 | 11 | 38% | 154개 중 46개 | 13 |
CLINC150의 105개에는 어느 선택지로도 맞힐 수 없는 범위 밖 요청 100개가 들어 있습니다. 4번 상황에서 따로 다룹니다.
1. 질문의 겉모양과 데이터의 정답 규칙이 다를 때
TREC은 질문이 기대하는 답의 종류로 라벨을 붙입니다. 그런데 많은 모델이 질문의 겉모양을 읽습니다. TREC의 어려운 문장 87개 중 73개가 세 묶음에 들어갑니다.
- 장소를 묻는데 사물로 읽은 경우(33문장). "What is the brightest star?"는 TREC에서
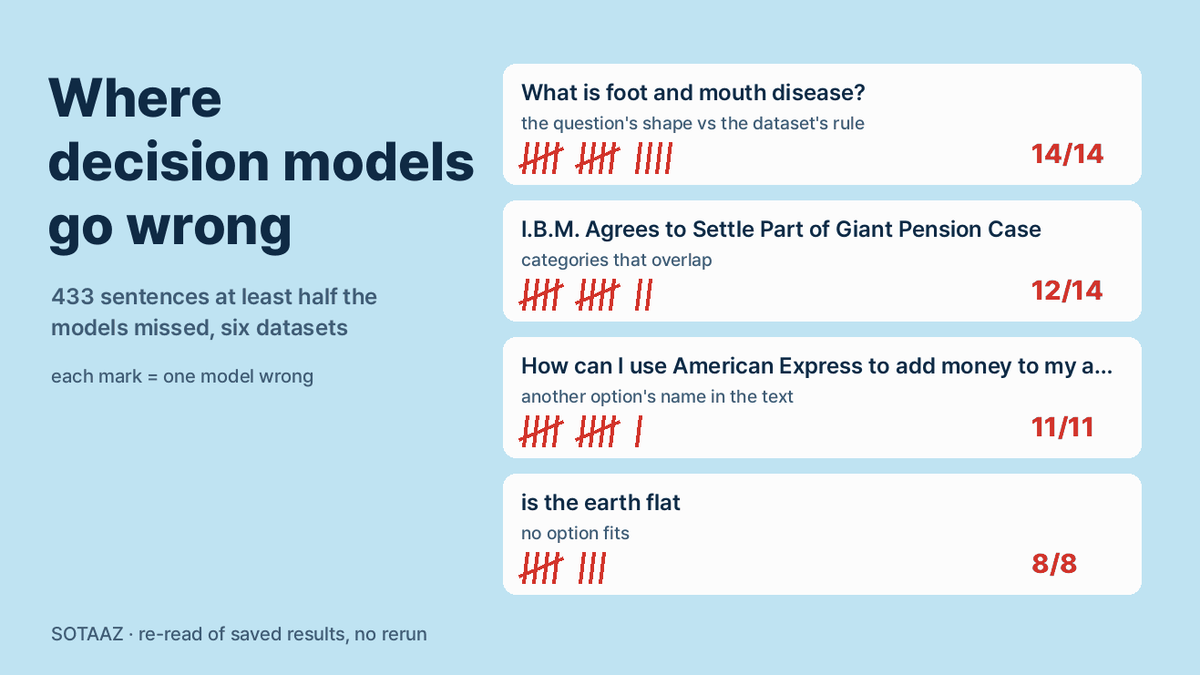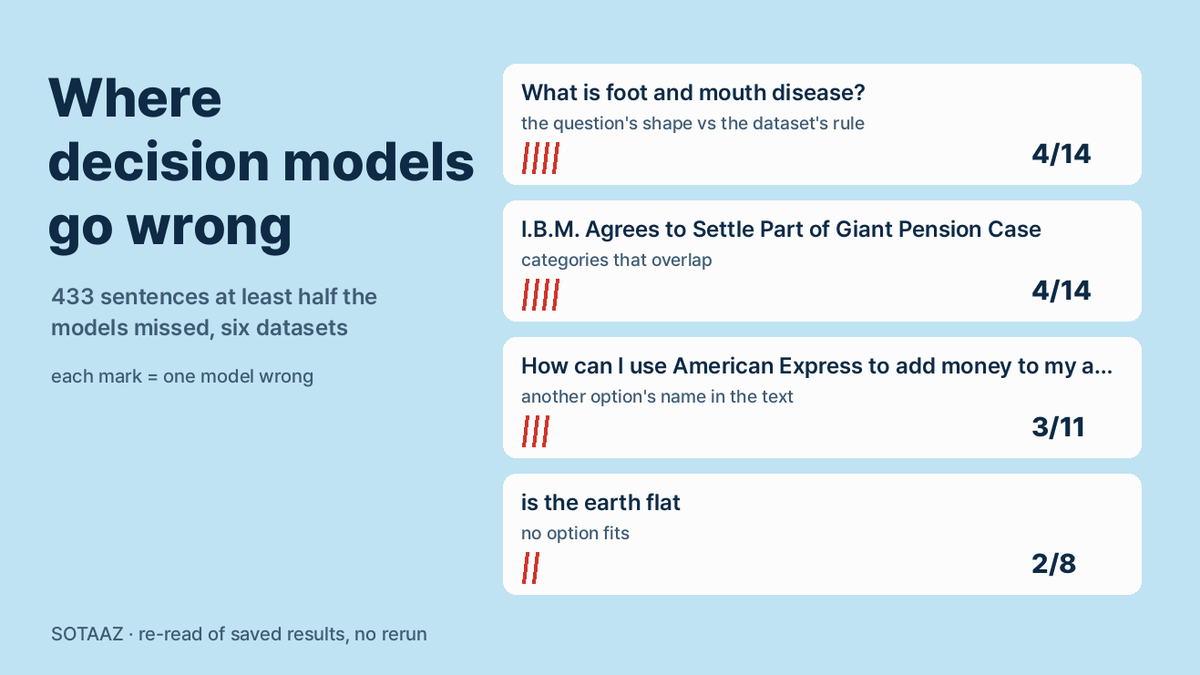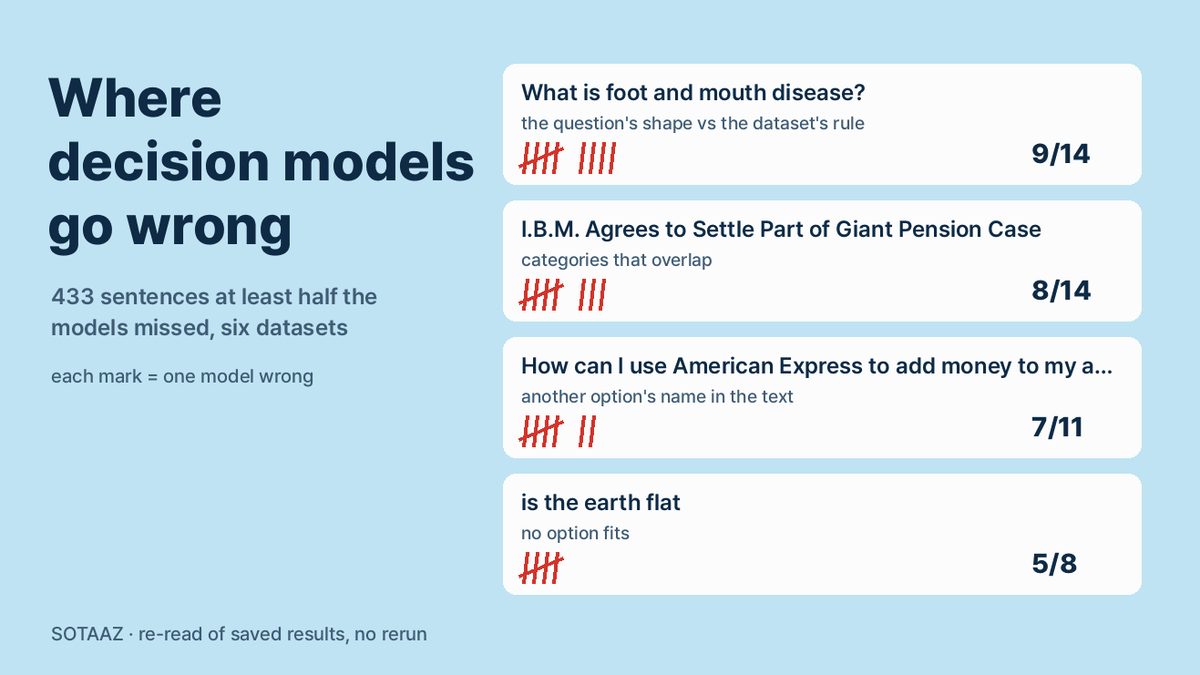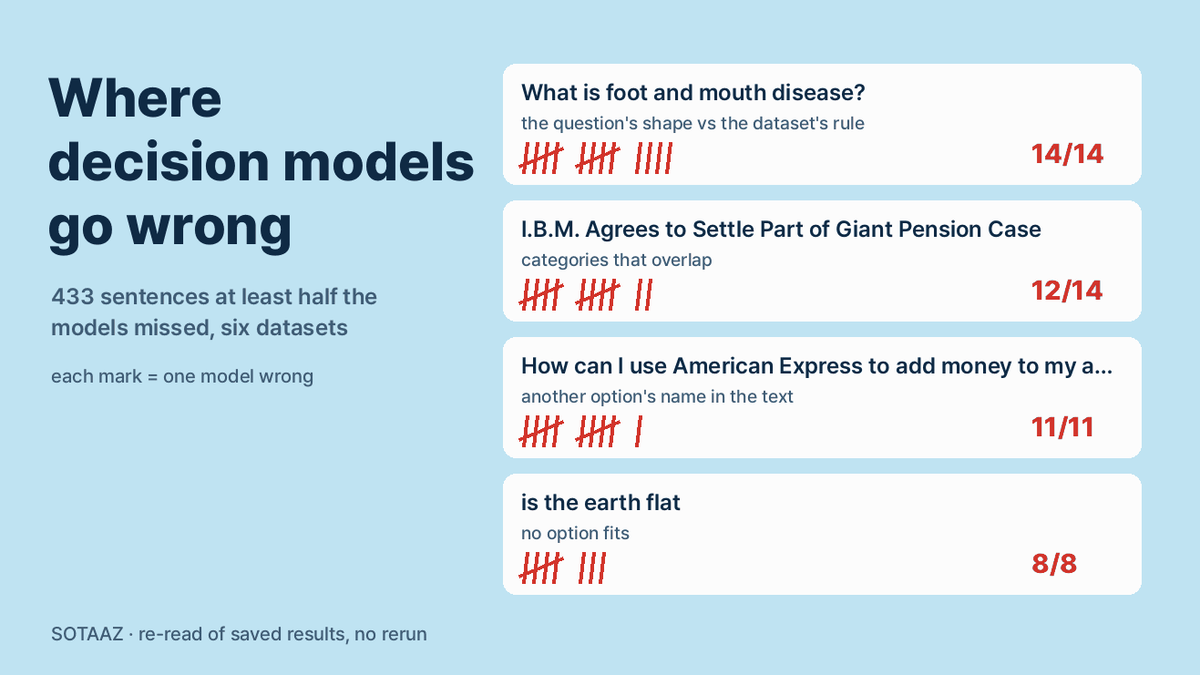
location입니다. 14개 모델 중 12개가 틀렸고, 그중 11개가entity를 골랐습니다. "What is the longest suspension bridge in the U.S.?"는 11개가 틀렸고 그중 9개가entity였습니다. - 사물을 묻는데 정의로 읽은 경우(22문장). "What is foot and mouth disease?"는 답이 질병 이름이라
entity입니다. 14개 모델이 모두 틀렸고, 13개가description을 골랐습니다. "What is X?"는 보통 정의를 묻는 형태이기 때문입니다. - 단체를 묻는데 사물로 읽은 경우(18문장). "George Bush purchased a small interest in which baseball team?"은
human입니다. TREC은 단체도 사람으로 칩니다. 14개 모델이 모두 틀렸고, 13개가entity를 골랐습니다.
14개 모델 모두 TREC의 한 줄 설명을 붙인 실행 결과가 있어서, 사전 등록 밖에서 사후로 비교해 봤습니다. 설명에 규칙이 적혀 있는 것은 단체 묶음 하나뿐입니다("human: a person, a group of people or an organization"). location 설명은 도시, 나라, 산, 주를 예로 들 뿐 별은 없고, entity 설명에도 질병은 없습니다. 그런데도 세 묶음 모두 틀린 모델 비율이 내려갔습니다. 장소 묶음은 0.63에서 0.38로, 정의 묶음은 0.61에서 0.30으로, 단체 묶음은 0.69에서 0.41로 줄었습니다. 오히려 늘어난 묶음도 있습니다. TREC의 네 번째 묶음 3문장은 0.86에서 1.00으로 올라, 설명을 붙이자 모든 모델이 틀렸습니다. "What is the sales tax in Minnesota?"(정답 entity, 설명 없이 14개 중 13개 오답, 그중 12개가 numeric)가 이 묶음입니다. 질문 500개 전체로는 0.28에서 0.22로 내려갔습니다. 다만 이 묶음들은 설명이 없을 때 어려웠던 문장을 골라 만든 것이라, 다시 재면 어느 정도는 저절로 내려갑니다.
2. 범주가 겹칠 때
여기서는 모델의 답도 일리가 있는 경우가 많습니다. 문제는 데이터가 경계를 어디에 그었느냐입니다.
- AG News, 기술과 경제(묶음 둘, 7문장과 5문장). "I.B.M. Agrees to Settle Part of Giant Pension Case"의 정답은 Sci/Tech인데, 14개 중 12개 모델이 Business를 골랐습니다. "Halo 2 scores record sales of $125 million in first 24 hours"는 정답이 Business입니다. 14개 중 10개가 틀렸고 그중 9개가 Sci/Tech를 골랐습니다. 기술 회사의 돈 이야기는 양쪽 모두에 들어맞습니다.
- 금융 트윗, 업종과 보고서 종류(8문장). "$MLI - Mueller GAAP EPS of $3.65, revenue of $1.15B"의 정답은 Financials인데, 11개 중 9개 모델이 Earnings를 골랐습니다.
- MASSIVE, 날짜와 달력(3문장). "what day of the week does christmas fall on this year"는 날짜 질문입니다. 8개 중 5개 모델이 틀렸고 그중 4개가 달력 쪽으로 분류했습니다. 묶음이 작고, 틀린 모델도 절반 안팎입니다.
트윗에는 내용이 거의 없는 입력도 있었습니다. "$AMTB $ALSN $VZ $BAESY $VLTA"는 종목 기호 다섯 개뿐이고 정답은 Stock Commentary입니다. 11개 중 10개 모델이 틀렸는데 답이 흩어졌습니다. Stock Movement 5개, Financials 4개, Markets 1개입니다. 읽을 내용이 없으니 답이 한곳에 모이지 않습니다.
3. 문장에 다른 선택지의 이름이 들어 있을 때
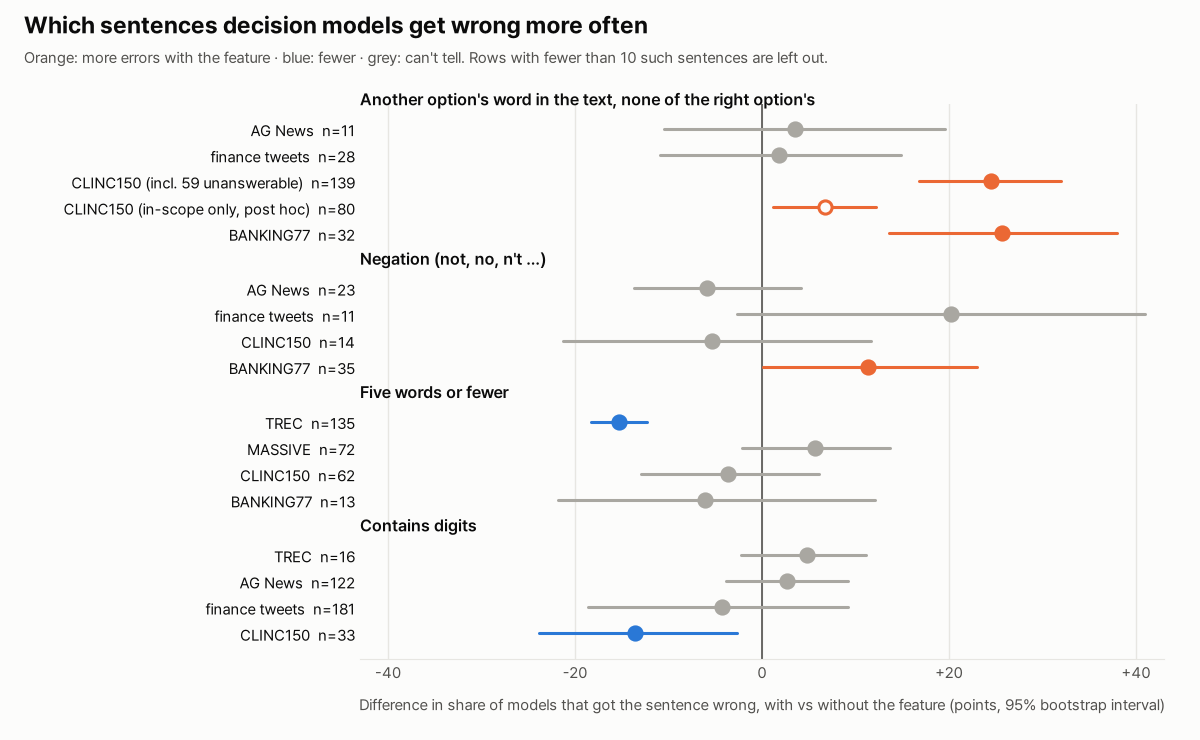
다른 선택지 이름의 단어(네 글자 이상)가 문장에 있고 정답 선택지 이름의 단어는 없는 문장을 표시했습니다. 그리고 표시한 문장과 나머지 문장을 비교했습니다.
- BANKING77: 표시한 문장에서 틀린 모델 비율이 25.7%p 높았습니다(95% 구간 13.5에서 37.9, 32문장). "How can I use American Express to add money to my account?"의 정답은
supported_cards_and_currencies입니다. 11개 모델이 모두 틀렸고, 그중 8개가topping_up_by_card를 골랐습니다. - CLINC150: 사전 등록한 비교에서는 +24.5%p였습니다. 이 숫자에는 맞힐 수 없는 범위 밖 요청 100개 중 59개가 들어 있습니다. 정답 라벨
oos에는 기준 단어가 없어서, 다른 선택지 단어만 있으면 표시됐기 때문입니다. 결과를 본 뒤 100개를 모두 빼고 다시 계산하니 차이는 6.7%p였습니다(1.2에서 12.2, 80문장). - AG News와 트윗: 구간이 0을 걸쳐서 차이를 말할 수 없었습니다. TREC과 MASSIVE는 표시된 문장이 너무 적어 판정하지 않았습니다.
이것은 상관관계입니다. 어디를 살펴볼지는 알려 주지만, 선택지 이름을 바꾸면 고쳐진다는 뜻은 아닙니다. 선택지 이름이 정의보다 답을 더 크게 좌우하는 현상은 라벨 편향 재측정 글에서 laya로 따로 쟀습니다.
이 "오답" 중에는 정답 라벨만큼 그럴듯한 것이 있습니다. "Why did the app refuse to make an approved payment"의 정답은 reverted_card_payment?입니다. 물음표는 오타가 아니라 BANKING77 라벨 이름에 원래 들어 있는 것입니다. 11개 모델이 모두 틀렸고, 그중 8개가 declined_card_payment를 골랐습니다. 모델 대부분이 정답이 아닌 같은 답으로 몰린다면, 모델을 탓하기 전에 정답 라벨부터 확인해 볼 만합니다.
함께 등록한 다른 특징들은 일부 데이터에서만 차이가 나타났습니다. 부정 표현(not, no, n't)은 BANKING77에서만 오답이 많았고(+11.4%p, 구간 0.1에서 23.0, 35문장), 그런 문장이 충분한 다른 데이터에서는 차이를 말할 수 없었습니다. 다섯 단어 이하의 짧은 질문은 TREC에서 오답이 적었고(-15.3%p, 구간 -18.3에서 -12.3), 숫자가 든 문장은 CLINC150에서 오답이 적었습니다(-13.6%p). 어느 것도 여러 데이터에 걸쳐 나타나지 않아서 일반화하지 않습니다.
4. 맞는 선택지가 없을 때
CLINC150에는 150개 의도 어디에도 속하지 않는 요청 100개가 있습니다. "is the earth flat", "watch the fbi" 같은 요청입니다. 앞선 Kev vs Jev 실행에서는 확률만으로 이런 요청을 걸러낼 수 있는지 보려고 일부러 "해당 없음" 선택지를 넣지 않았습니다. 그래서 모든 모델이 어떤 의도든 하나를 골라야 했고, 답은 항상 틀렸습니다.
눈여겨볼 것은 답이 어디로 몰렸는지입니다. 답 800개(요청 100개 × 모델 8개) 중 128개가 no, 49개가 yes였습니다. 이 요청 중 일부는 예/아니오 질문이고(5분의 1가량이 is, can, do 같은 말로 시작합니다), 모델들이 분류를 하는 대신 질문에 답을 해 버렸습니다. "is the earth flat"에는 8개 중 4개 모델이 no라고 답했습니다. 나머지는 구체적인 의도들로 흩어졌습니다. reminder_update 74개, what_can_i_ask_you 67개, accept_reservations 55개입니다. 해법은 "해당 없음" 선택지를 넣거나, 확률이 낮은 답을 사람에게 넘기는 기준을 두는 것입니다. Kev vs Jev 글에서는 이 데이터에서 그 기준이 통했습니다. Jev의 최고 확률은 범위 밖 요청과 범위 안 요청을 AUROC 0.94로 갈랐습니다.
확인해 볼 것
- 이름만 보고 규칙을 알 수 있는가. 단체를
human으로 친다면 이름만 읽는 모델은 그걸 모릅니다. TREC에서는 설명을 붙였을 때 네 묶음 중 셋이 줄고 하나가 늘었습니다. 붙이기 전후를 재 보세요. - 여러 모델이 같이 헷갈리는 쌍은 무엇인가. 평가 세트에 모델 몇 개를 돌리고, 공통으로 나오는 정답·오답 쌍을 뽑아 보세요. 그 범주들은 합치거나, 경계를 한 문장씩 정의합니다.
- 선택지 이름이 흔한 메시지와 단어를 공유하는가. BANKING77에서는 그런 문장에서 오답이 훨씬 많았습니다. 그런 쌍이 있는지부터 확인하세요. 이름을 바꾸면 나아지는지는 저희가 재지 않았습니다.
- 빠져나갈 길이 있는가. "해당 없음"이나 확률 기준이 없으면, 예/아니오 질문에는 답을 해 버리고 다른 엉뚱한 요청은 관계없는 의도로 분류됩니다.
- 모델 대부분이 정답이 아닌 같은 답을 고르는가. 그렇다면 라벨을 보세요. 그중에는 라벨이 잘못됐거나 애매한 문장이 있습니다.
- 평가 세트에 이런 문장이 있는가. 짧은 "What is X" 질문, 기술 회사의 돈 이야기, 종목 기호만 있는 글, 어느 선택지에도 맞지 않는 요청입니다.
측정 범위와 한계
- 선택지 이름만 준 실행입니다. TREC 사후 비교에서 보듯 설명을 붙이면 줄어드는 묶음도, 늘어나는 묶음도 있습니다. 설명을 붙인 실행으로 이 분석 전체를 다시 하지는 않았습니다.
- 영어 데이터만 썼고, 데이터마다 154-500문장입니다. 데이터마다 모델 구성도 다릅니다.
- 모델들은 서로 독립적이지 않습니다. 같은 기반 모델이나 학습 데이터를 나눠 쓰는 경우가 있어서, "11개 중 10개"는 서로 무관한 판정자 열 명만큼 강한 근거가 아닙니다.
- BANKING77은 오답이 77개 의도에 흩어져, 3문장 이상 모인 묶음이 없었습니다.
- 다른 선택지 단어 표시는 단순한 단어 일치입니다. 동의어는 놓치고 우연한 일치는 셉니다.
- 소제목은 문장을 읽고 저희가 붙인 해석입니다. 묶음 자체는 규칙이 정했습니다.
3문장 이상 모인 묶음 전체
| 데이터 | 정답 → 가장 많이 고른 오답 | 문장 수 | 본문 |
|---|---|---|---|
| TREC | location → entity | 33 | 1번 |
| TREC | entity → description | 22 | 1번 |
| TREC | human → entity | 18 | 1번 |
| TREC | entity → numeric | 3 | 1번 |
| AG News | Sci/Tech → Business | 7 | 2번 |
| AG News | Business → Sci/Tech | 5 | 2번 |
| AG News | World → Business | 3 | |
| 금융 트윗 | Financials → Earnings | 8 | 2번 |
| 금융 트윗 | Fed / Central Banks → Macro | 3 | |
| 금융 트윗 | Markets → Stock Movement | 3 | |
| 금융 트윗 | Stock Commentary → Stock Movement | 3 | 2번 |
| 금융 트윗 | Stock Commentary → Company / Product News | 3 | |
| 금융 트윗 | Treasuries / Corporate Debt → Financials | 3 | |
| MASSIVE | datetime_query → calendar_query | 3 | 2번 |
| CLINC150 | oos → no / yes / fun_fact / accept_reservations / time / smart_home / directions / what_can_i_ask_you | 26 / 9 / 8 / 5 / 4 / 3 / 3 / 3 | 4번 |
사전 등록 문서(집계 전 커밋), 집계 스크립트, 고른 결과 파일 목록, 사후 분석은 drafts/failure-clusters/에 있습니다. 다음 글은 뉴스레터로 먼저 알려 드립니다.