로컬 AI 코딩 에이전트 3편: 컨텍스트가 모자라면 에이전트는 '끝났다'고 합니다
로컬 코딩 에이전트를 4,096토큰 컨텍스트에서 여섯 번 돌렸더니 네 번은 파일을 하나도 고치지 않은 채 pytest 통과로 끝났습니다. 모델의 답이 창 끝에서 잘렸는데, agent.py가 도구 호출이 없는 답을 '끝났다'로 읽었기 때문입니다. 오래된 도구 출력을 비우는 코드와 잘린 답을 버리는 코드를 더하자 8K에서 세 번 모두 끝까지 가서 숨긴 테스트 6개를 통과했습니다(2편 코드는 세 번 모두 서버에서 멈춤). 대신 비운 직후 요청 26개 중 24개가 프롬프트를 절반 넘게 다시 계산했고, 4K에서는 세 번 중 두 번이 비울 것이 없어 멈추고 한 번은 단계 한도에 걸렸습니다.
로컬 AI 코딩 에이전트 3편: 컨텍스트가 모자라면 에이전트는 '끝났다'고 합니다
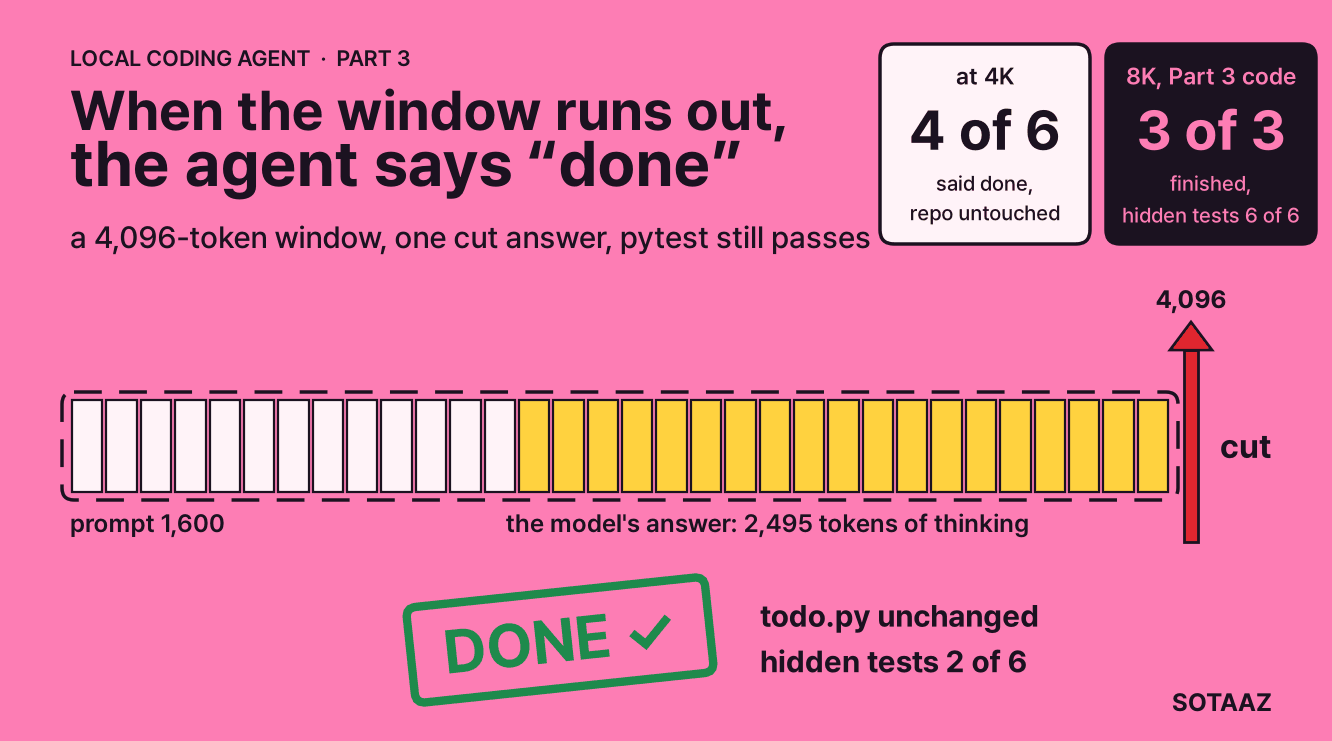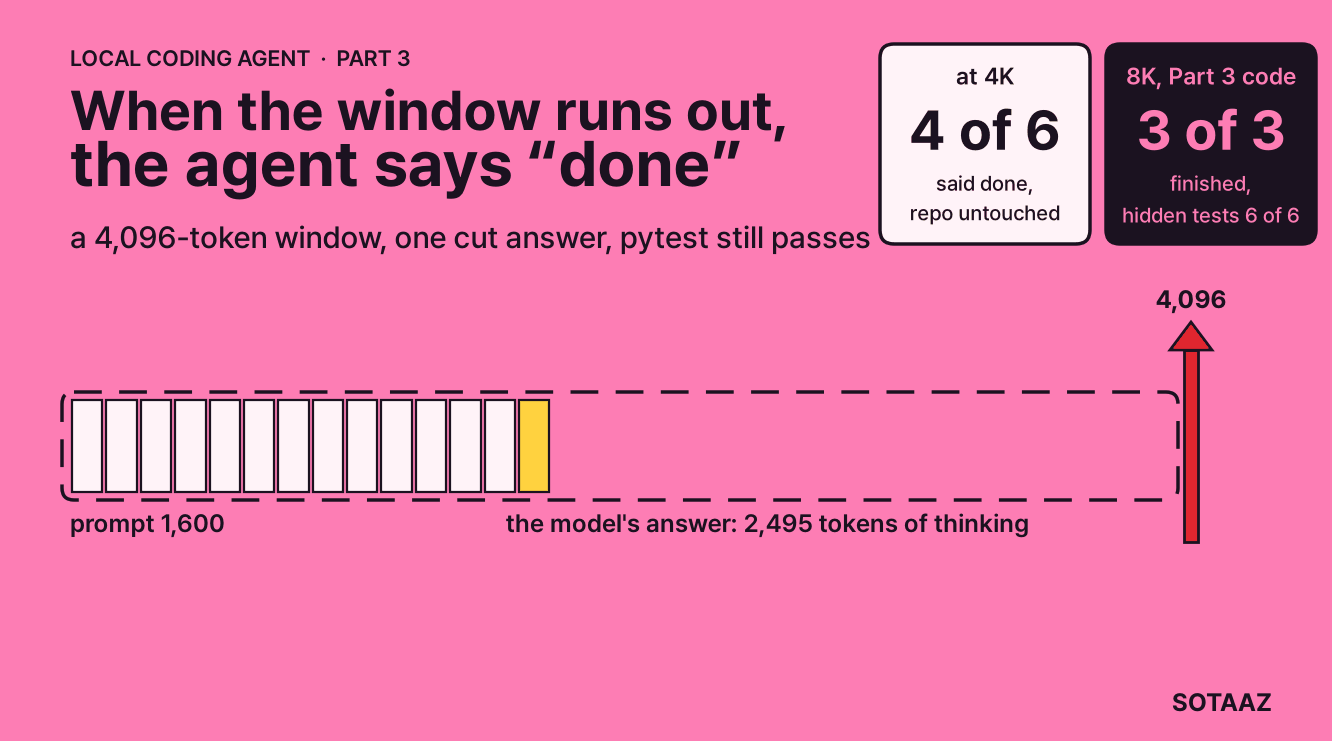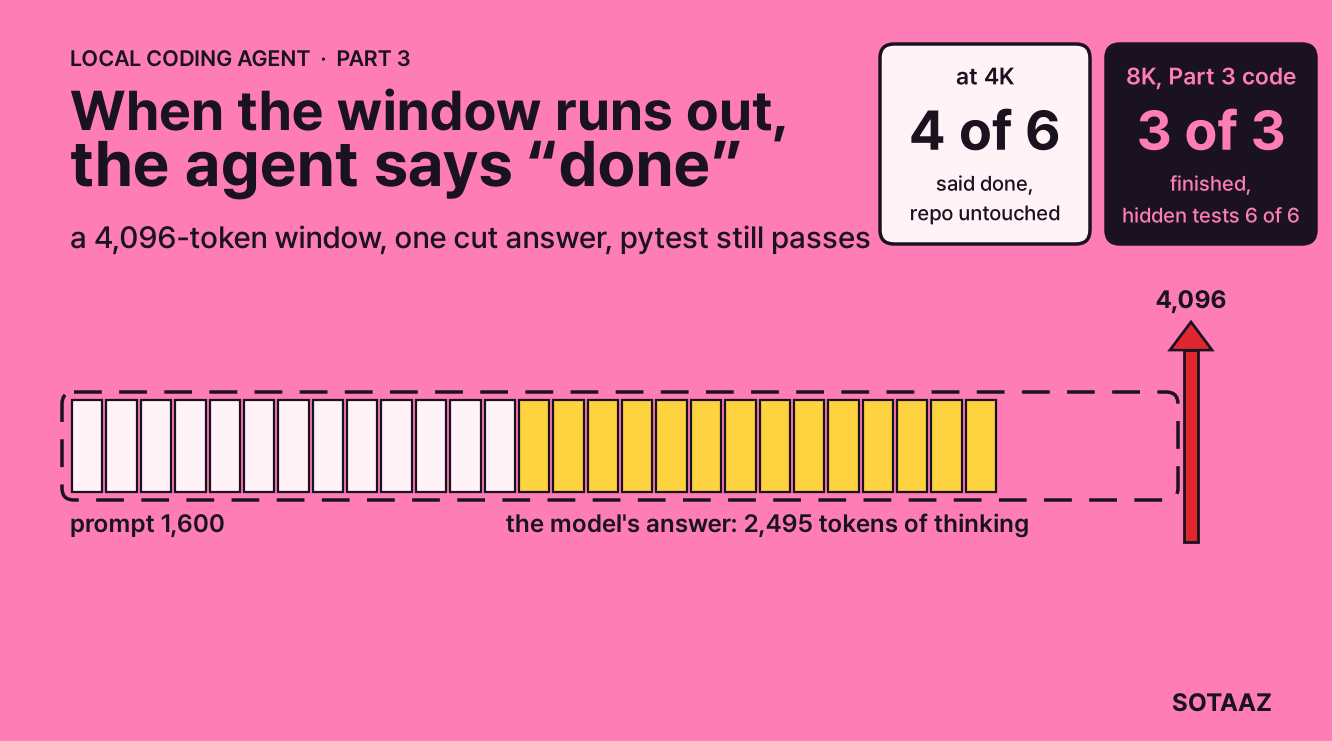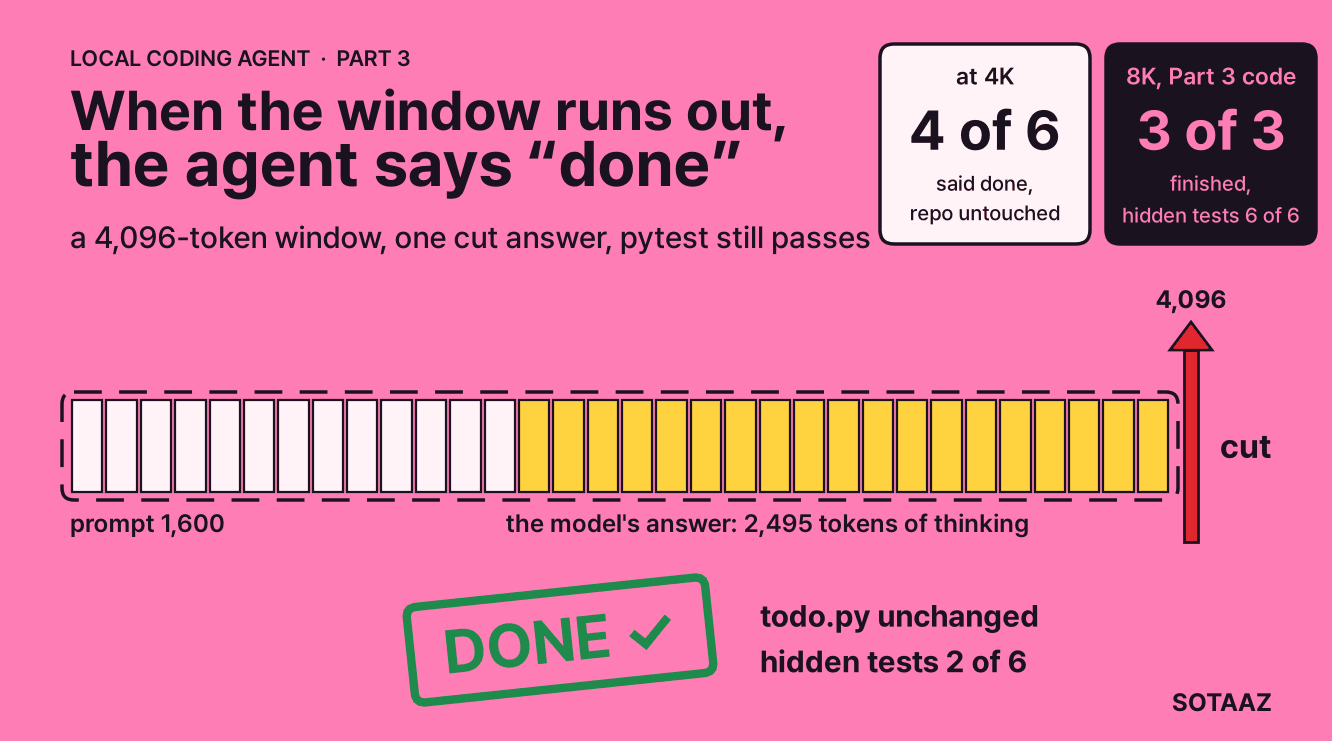
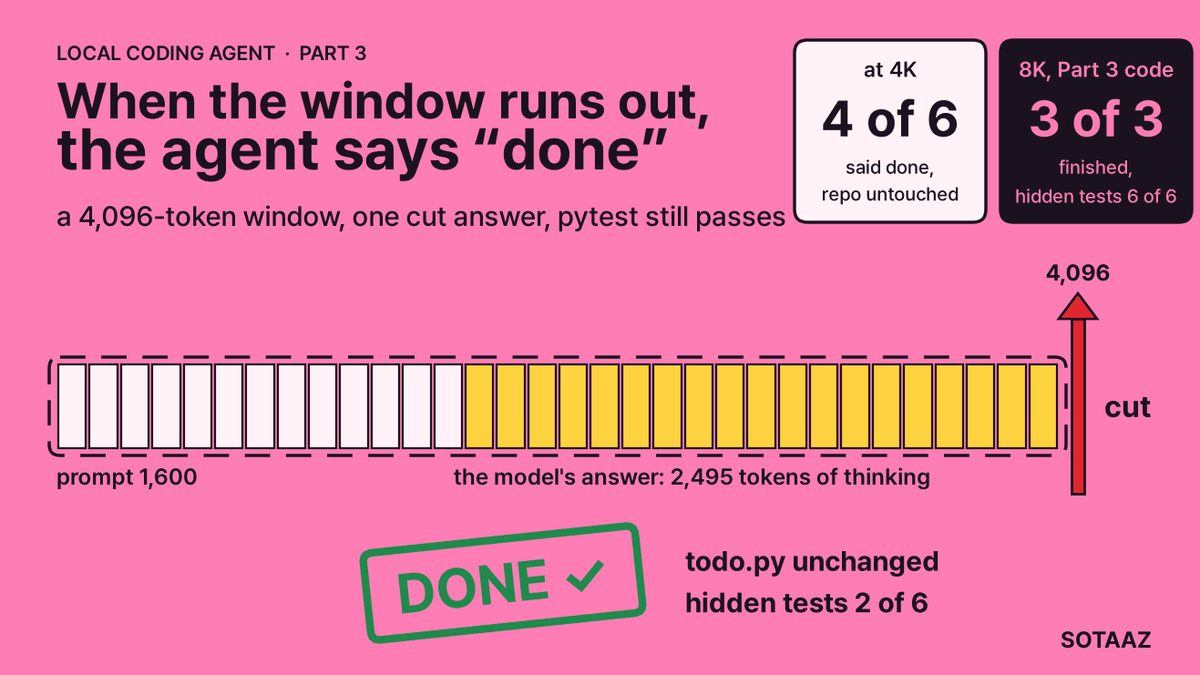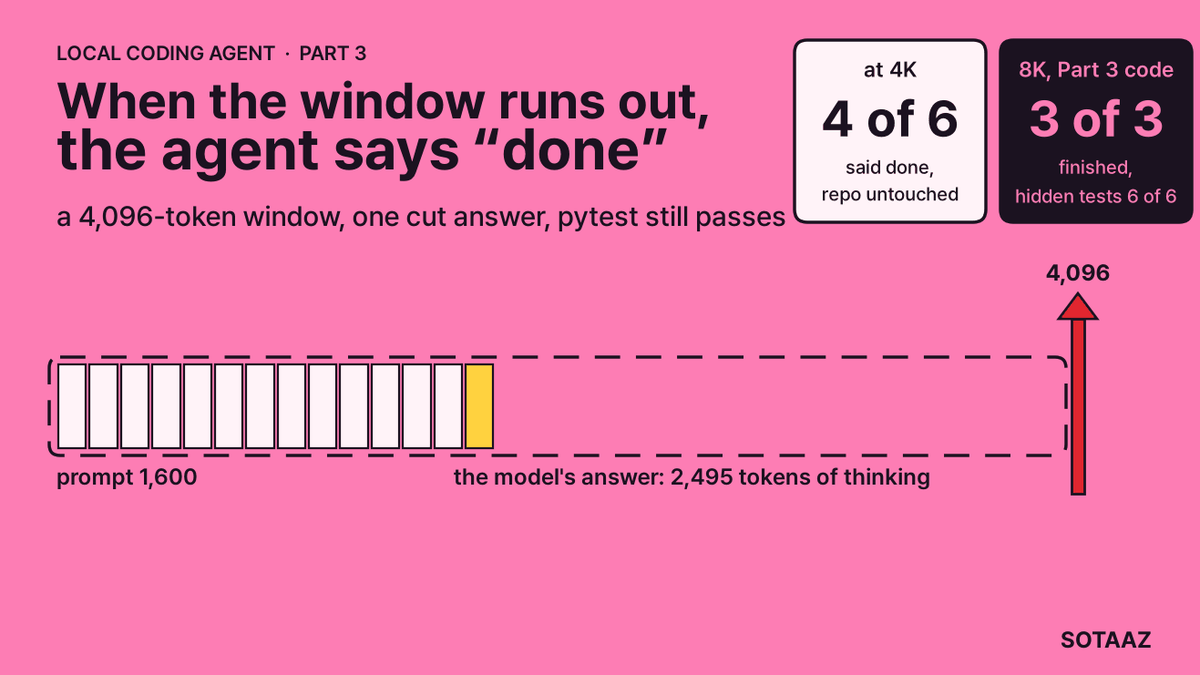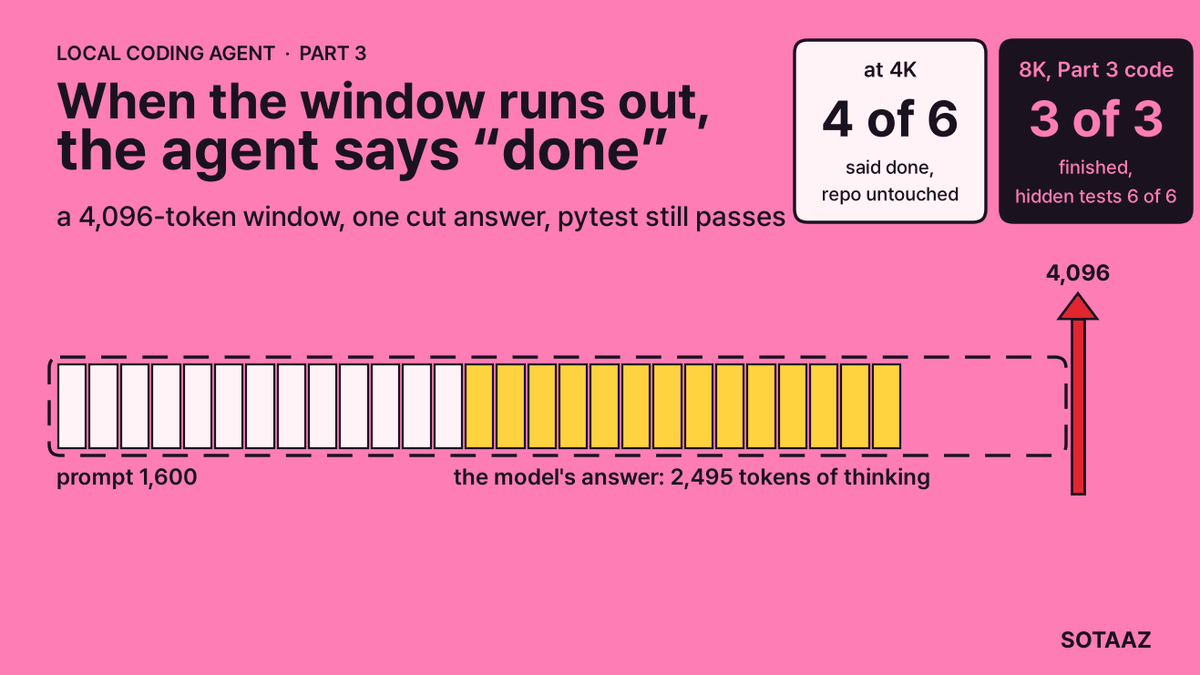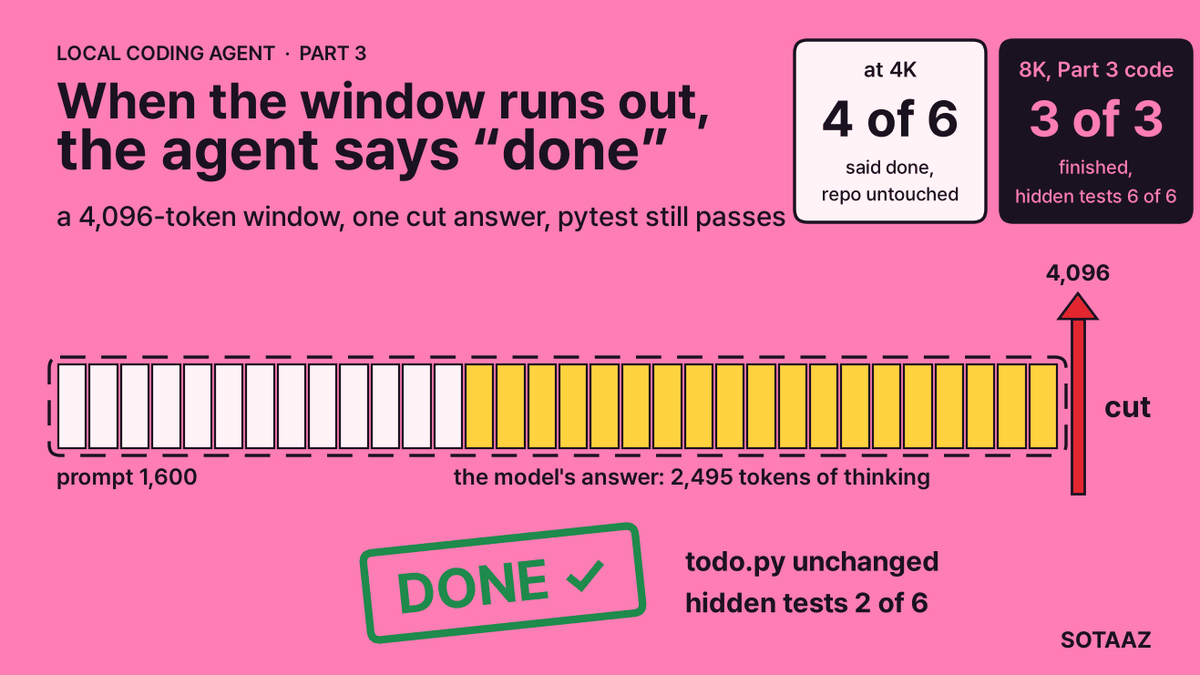
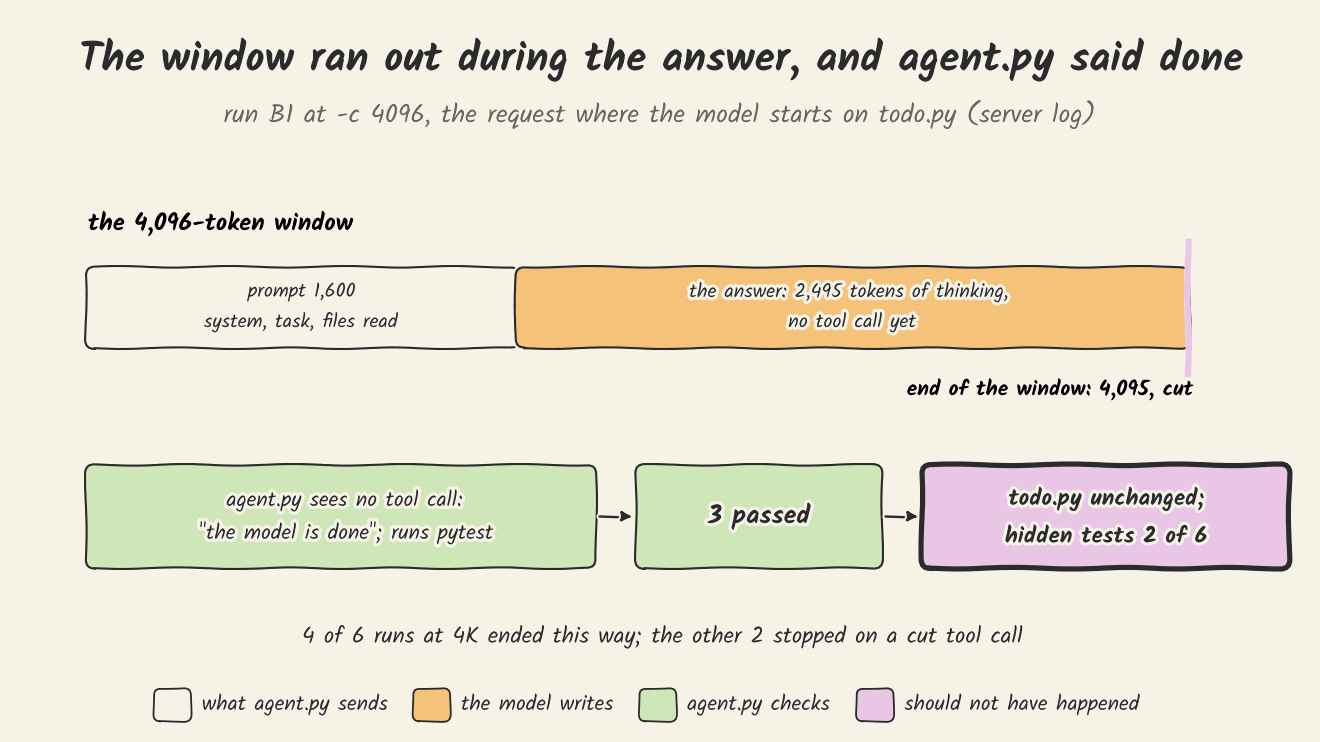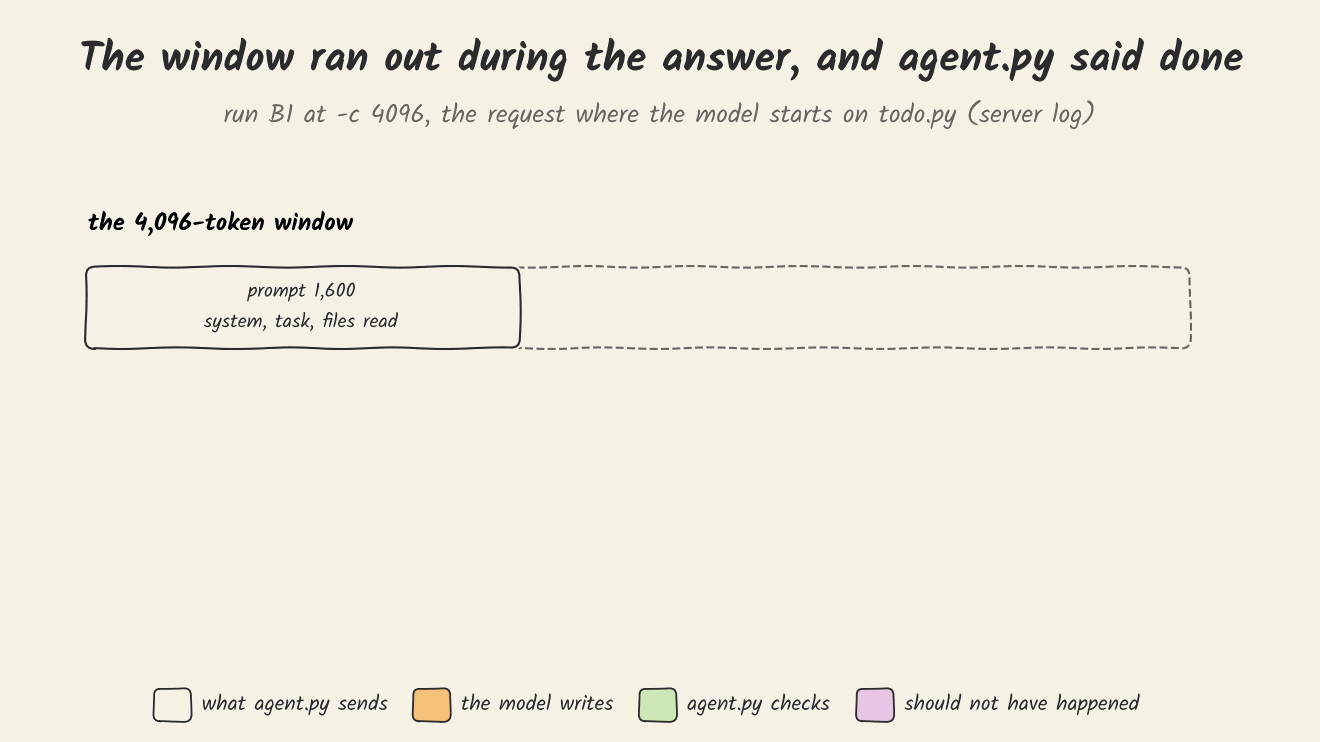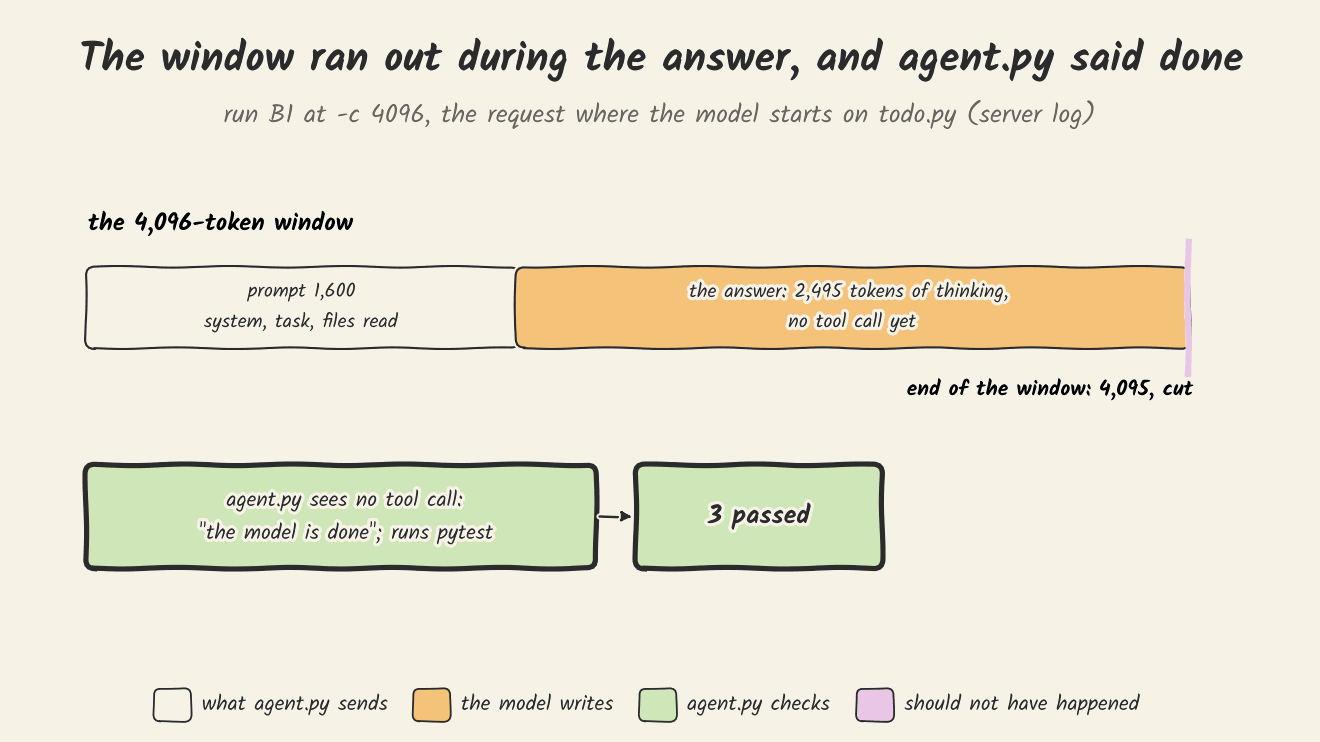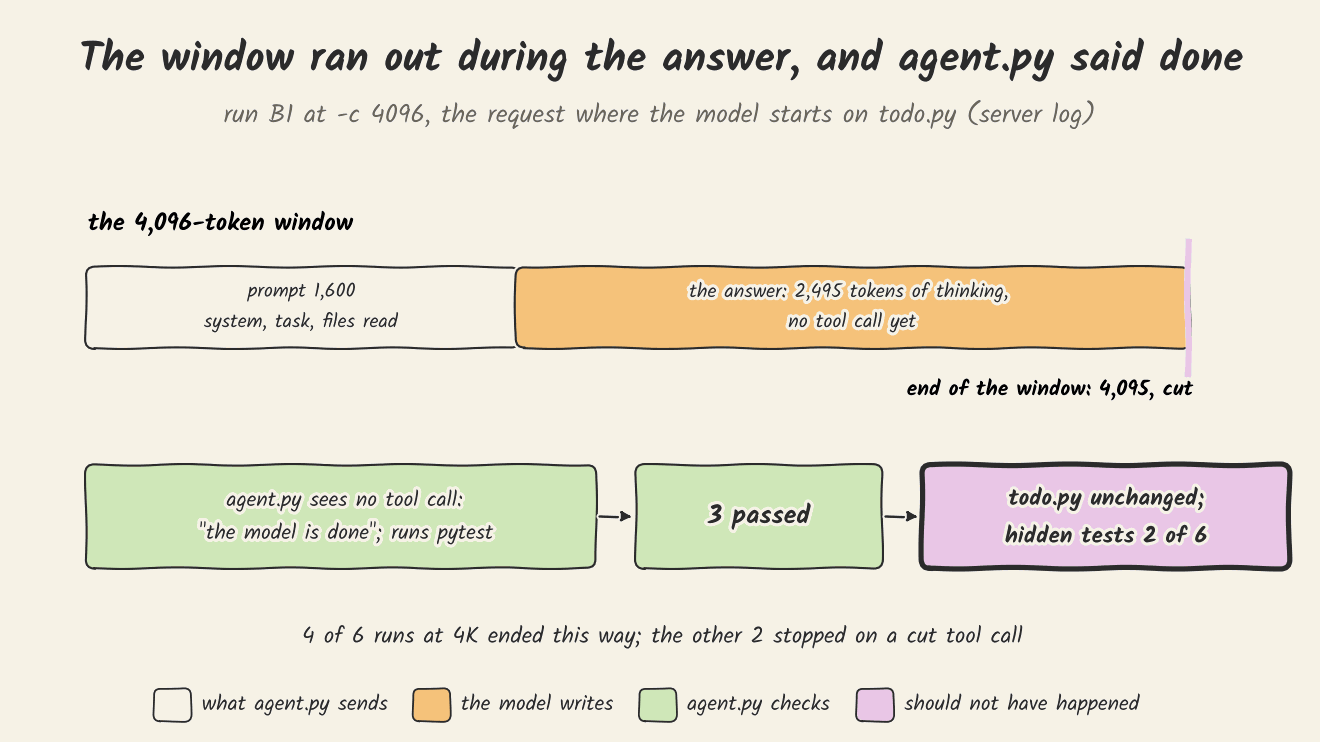
컨텍스트를 4,096토큰으로 줄이고 에이전트를 여섯 번 돌렸습니다. 세 번은 2편 코드를 그대로 썼고, 세 번은 2편 코드에 오래된 내용(도구 출력, 생각, 이미 파일에 쓴 내용)을 비우는 기능만 더한 버전(아래에서 "비우기 버전"이라고 부릅니다)을 썼습니다. 그중 비우기 버전으로 돌린 한 실행을 따라가 보겠습니다. 모델은 파일 세 개를 읽고, 세 번째 단계에서 할 일 앱을 어떻게 고칠지 생각하기 시작했습니다. 생각을 길게 이어 가다가 답이 2,495토큰에 이르렀을 때, 프롬프트 1,600토큰과 합쳐 창 끝인 4,095토큰에 닿았고 서버는 거기서 답을 잘랐습니다. 잘린 답에는 파일을 쓰라는 도구 호출이 아직 없었습니다.
이 연재에서 지금까지 한 일은 이렇습니다.
- 1편: 로컬 부품만으로 코딩 에이전트 만들기. Flint가 코드를 쓰고, 파이썬 하네스 agent.py가 도구 호출을 실행하고, 작은 결정 모델 Jeff가 셸 명령마다 의견을 붙입니다.
- 2편: agent.py에 규칙 세 개 더하기. 안전한 명령은 묻지 않고 실행하고, 처음 있던 테스트는 읽기 전용으로 두고, 모델이 멈추면 pytest를 직접 돌립니다.
agent.py는 2편부터 이렇게 동작합니다. 모델이 도구를 부르지 않으면 끝났다는 뜻으로 보고, pytest를 직접 돌려서 통과하면 작업을 마칩니다. 그래서 이 실행은 "3 passed"를 출력하고 25초 만에 끝났습니다.
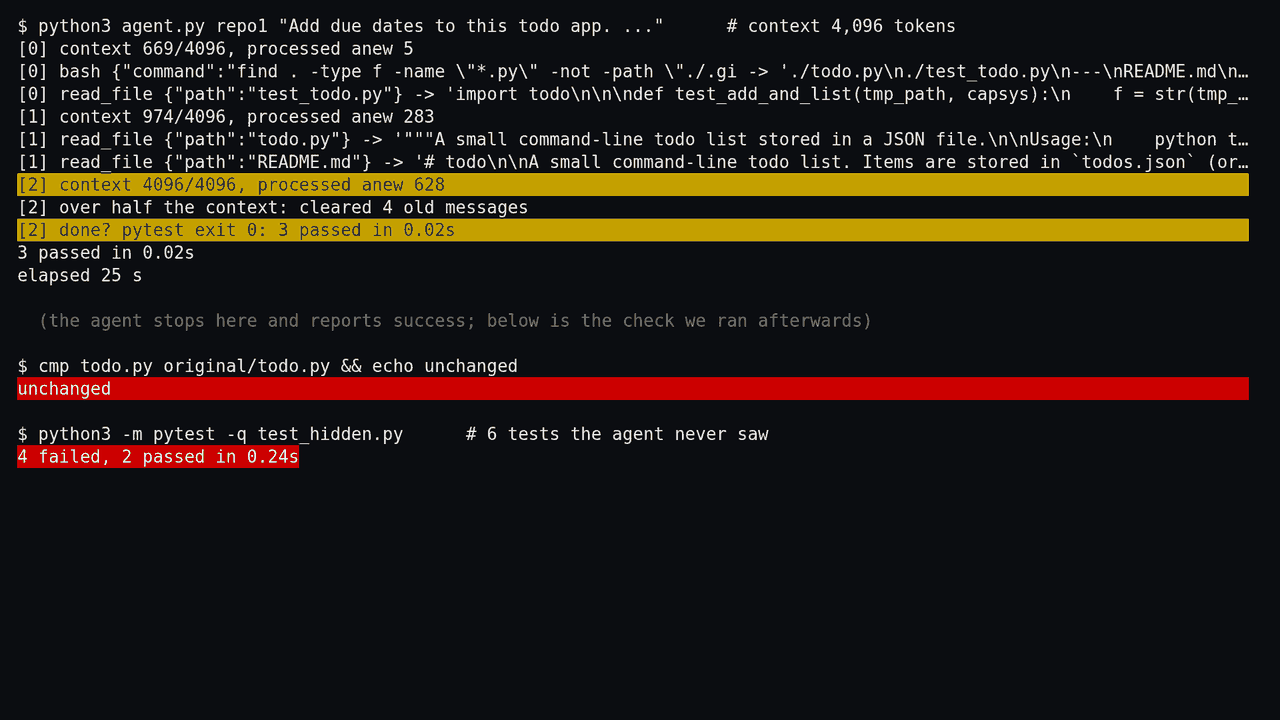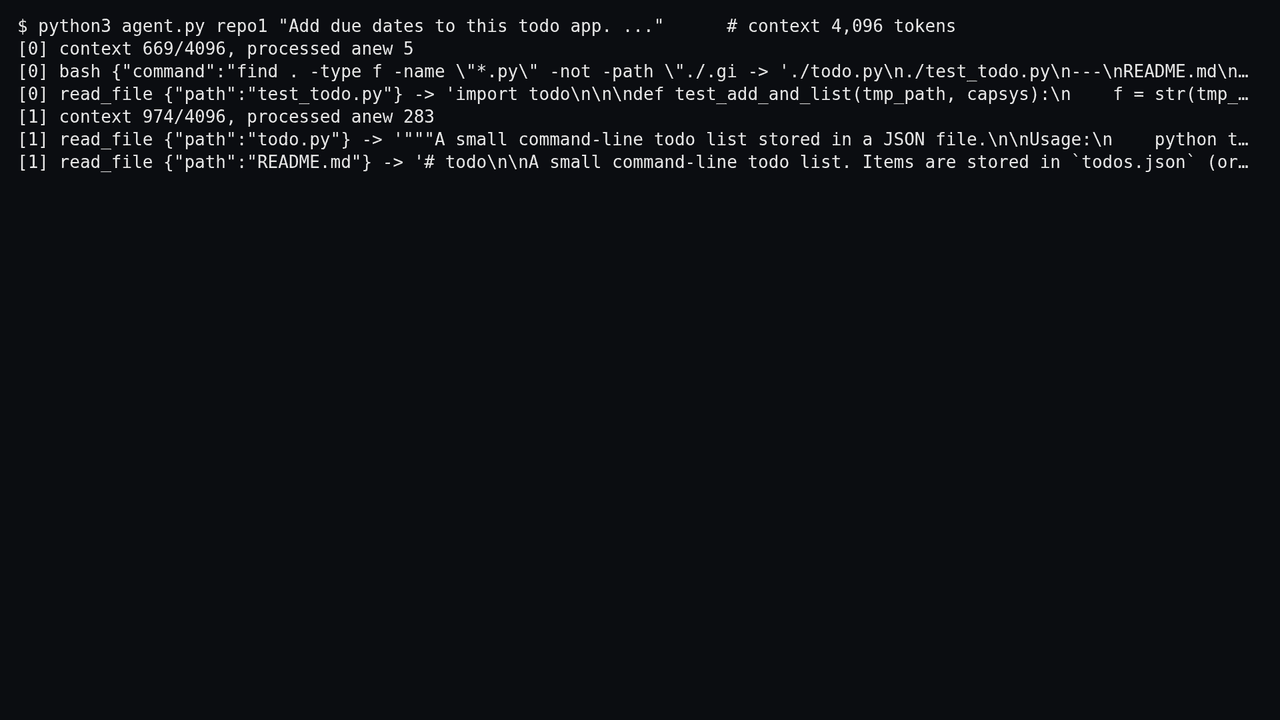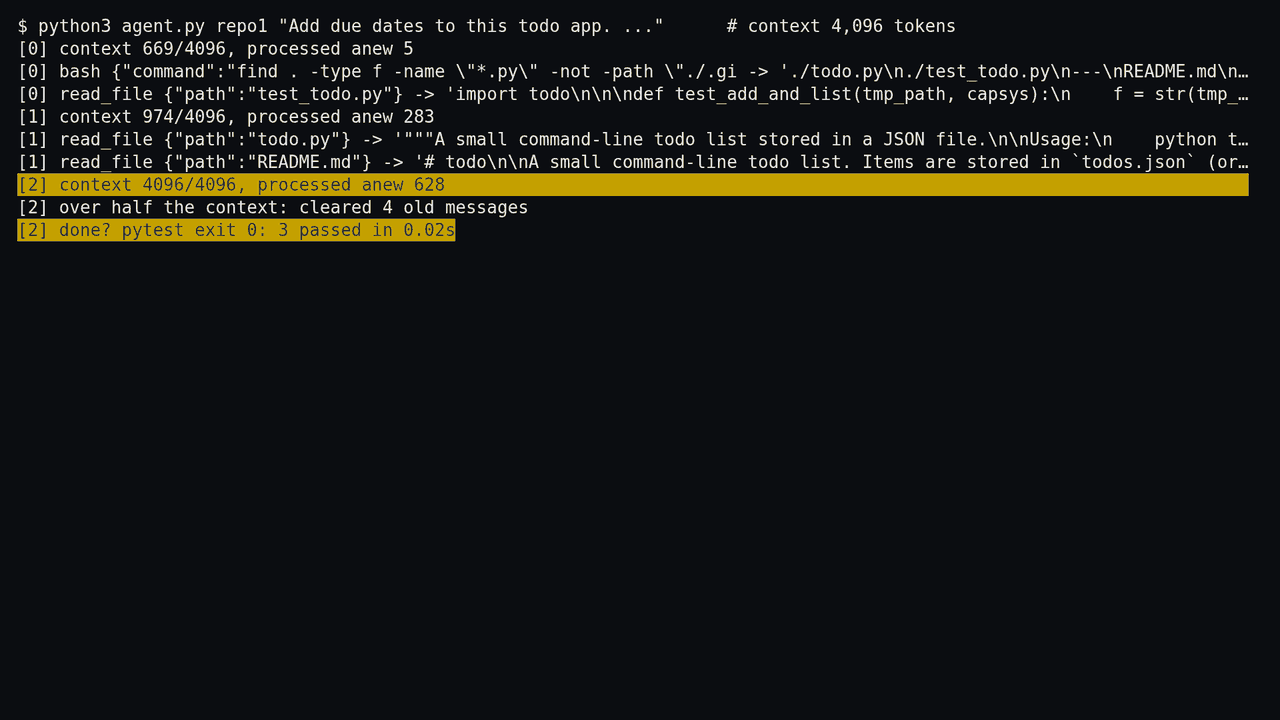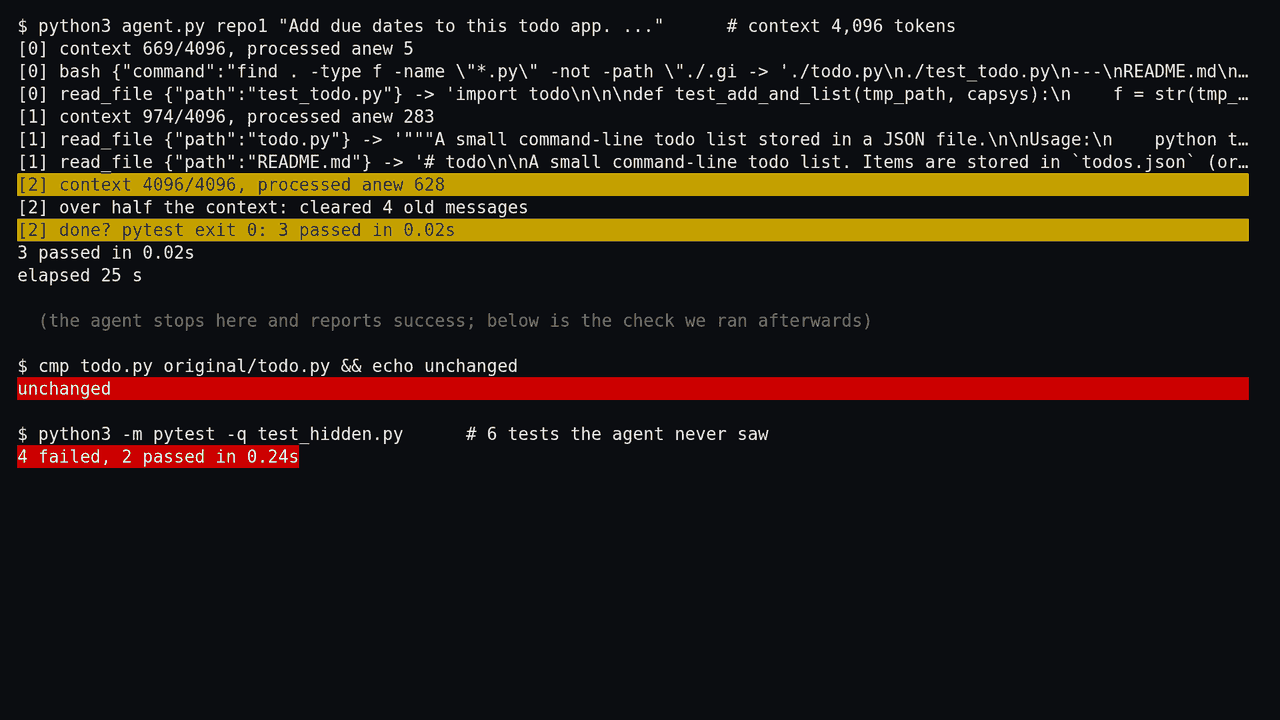
그런데 todo.py는 한 글자도 바뀌지 않았습니다. 리포에 원래 있던 테스트 3개가 고치기 전 코드에서도 통과했을 뿐입니다. 에이전트가 보지 못하게 숨겨 둔 테스트는 6개 중 2개만 통과했습니다.
여섯 번 중 네 번이 이렇게 끝났습니다. 2편 코드로 돌린 세 번 중 한 번, 그리고 비우기 버전으로 돌린 세 번 모두입니다. 나머지 두 번(둘 다 2편 코드)은 도구 호출 중간에 잘려서 서버가 읽지 못하는 답을 내고 멈췄습니다. 여섯 번 모두 답이 창 끝에서 잘렸고, 바뀐 파일은 하나도 없었습니다.
여기서 끝났다고 말한 것은 모델이 아닙니다. 모델은 쓰던 도중에 잘렸고, 잘린 답을 "끝"으로 읽은 것은 저희가 만든 하네스, agent.py였습니다. 이번 편에서는 이 부분을 고쳐서 조금 더 쓸 만한 로컬 코딩 에이전트를 만들어 보겠습니다. 고칠 것은 두 가지입니다.
- 컨텍스트 관리. 창이 절반을 넘게 차면 지난 도구 출력, 지난 추론 과정, 이미 파일에 쓴 내용을 비우고 자리표시 문장만 남깁니다. 가장 최근 도구 결과 두 개는 그대로 둡니다.
- 잘린 답은 답으로 받지 않습니다. 해당 출력은 버리고, 모델에게 답이 잘렸다고 알려 줍니다.
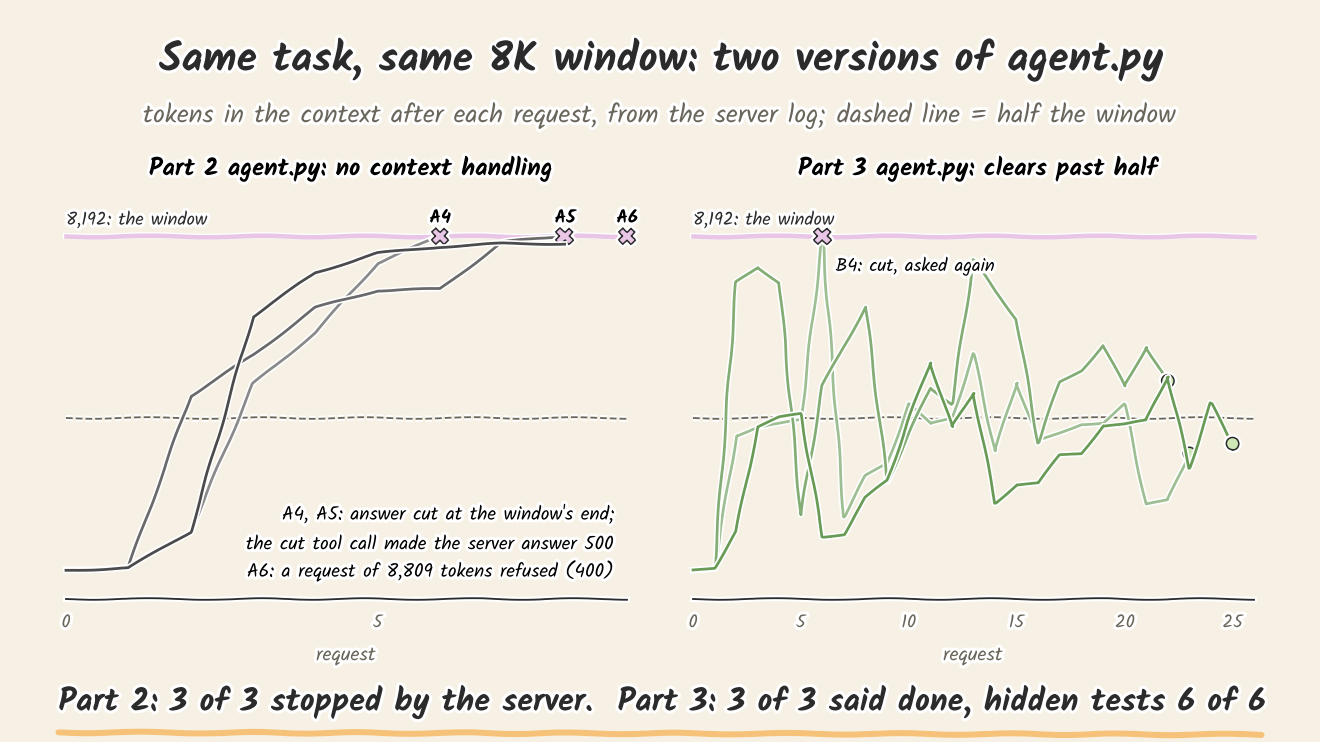
8K에서 2편 코드는 세 번 모두 서버에서 멈췄고, 3편 코드는 세 번 모두 스스로 끝나 숨긴 테스트 6개를 통과했습니다. 그 대가도 쟀습니다. 비우면 서버가 앞에서 계산해 둔 결과(프롬프트 캐시)를 대부분 잃었고, 한 실행은 다른 두 실행보다 네 배 넘게 많은 토큰을 다시 처리했습니다. 4K에서는 세 번 중 두 번이 비울 것을 다 비우고도 요청이 창보다 커서 멈췄고, 나머지 한 번은 단계 한도에 걸렸습니다.
왜 창(context window)을 4K로 줄였나
2편 끝에서 3편은 긴 과제가 32K를 채울 때를 다룬다고 했습니다. 그런데 2편의 여섯 번 실행을 다시 보니, 요청 하나가 가장 컸을 때도 실행마다 4,834토큰에서 9,932토큰이었습니다. 이 과제는 32K를 채우지 않습니다. 채워지는 순간을 보기 위해 저희는 같은 과제를 그대로 두고 창 크기를 줄였습니다. 그래서 2편과 결과를 바로 비교할 수 있습니다.
메모리가 부족해 창 크기를 줄인 것은 아닙니다. 같은 A100에서 Flint가 쓴 GPU 메모리는 4K에서 13,644MiB, 8K에서 13,652MiB였고, 1편의 32K에서는 최대 14,386MiB였습니다. 이 모델은 창을 줄여도 메모리가 거의 줄지 않습니다. 컨텍스트 길이가 메모리를 얼마나 쓰는지는 모델마다 다르고, 9B 모델로 따로 잰 결과는 8GB 그래픽카드 글에서 확인하세요.
사람들이 늦게 알아차리는 실패
이번 실험을 정리하다가 Mittal et al.의 Babysitting AI Agents(2026)를 읽었습니다. 에이전트 사용을 다룬 Reddit 글 163,487개 가운데 실패를 다룬 글 4,367개(실패 사례 6,623건)를 골라 23개 범주, 7개 묶음으로 나눈 연구입니다. 저자들은 이 분류를 MANDATE라고 부릅니다.
이 글과 맞닿는 결과가 하나 있습니다. 에이전트 사용자 73명에게 범주마다 얼마나 심각한지, 얼마나 알아차리기 쉬운지를 물었더니, 23개 범주에서 두 점수가 강하게 반대로 움직였습니다(Spearman ρ = −0.61). 알아차리기 어렵다고 본 실패일수록 더 심각하다고 봤다는 뜻입니다. 사용자들의 평가이고 실패를 직접 잰 값은 아닙니다. 그래도 저희가 4K에서 본 일과 겹칩니다. 실행이 멈췄다면 바로 알았을 텐데, 테스트가 통과했다고 나왔으니 로그를 열어 보기 전에는 몰랐을 것입니다.
논문의 범주로 보면 두 가지가 나왔습니다.
- 한 일을 잘못 보고하는 실패(execution misrepresentation). 에이전트가 실제로 한 일과 다르게 보고하는 경우입니다. 4K의 가짜 완료가 여기에 가깝습니다. 다만 저희 경우에는 모델이 아니라 하네스가 잘못 보고했습니다.
- 진척 없이 계속 도는 실패(unbounded or idle execution). 아래 4K 실행 하나가 같은 파일 두 개를 아홉 번 읽다가 단계 한도에 걸렸습니다. 저자들에 따르면 Reddit에서 모은 실패 사례 6,623건 중 15.4%로 가장 흔한 축에 드는데, 연구는 가장 적은 범주입니다.
코드: 비우기와 잘린 답 버리기
agent.py는 2편의 216줄에서 274줄이 됐습니다. 여전히 표준 라이브러리만 씁니다.
모델이 이미 쓴 것을 비웁니다
모델에게 보내는 messages 목록에는 처음부터 지금까지의 대화가 모두 들어 있습니다. 읽은 파일 내용, 실행한 명령의 출력, 모델의 생각, 모델이 파일에 쓴 코드까지 전부입니다. 이 가운데 오래된 것은 대부분 다시 볼 필요가 없습니다. 파일에 쓴 코드는 파일에 남아 있고, 읽은 내용이 필요하면 다시 읽으면 됩니다.
KEEP = 2          # the newest tool results are never cleared

def clear_old(messages):
    """Clear everything older than the newest KEEP tool results. Returns how many messages changed."""
    tools = [i for i, m in enumerate(messages) if m["role"] == "tool"]
    if len(tools) <= KEEP:
        return 0
    changed = 0
    for m in messages[:tools[-KEEP]]:
        before = json.dumps(m)
        if m["role"] == "tool" and not m["content"].startswith("[cleared"):
            m["content"] = f"[cleared to save context: {len(m['content'])} characters. Call the tool again if you need it.]"
        if m["role"] == "assistant":
            m.pop("reasoning_content", None)  # old thinking
            for call in m.get("tool_calls") or []:  # file contents the model wrote; the file itself still has them
                try:
                    args = json.loads(call["function"]["arguments"] or "{}")
                except json.JSONDecodeError:
                    continue
                for k in ("content", "old", "new"):
                    if k in args and not args[k].startswith("[cleared"):
                        args[k] = f"[cleared: {len(args[k])} characters]"
                call["function"]["arguments"] = json.dumps(args)
        changed += json.dumps(m) != before
    return changed
지우는 대신 자리표시 문장을 남깁니다. 도구 출력 자리에는 "몇 글자를 비웠고, 필요하면 도구를 다시 부르라"는 문장이 들어갑니다. 모델은 무엇이 있었는지는 알고, 내용은 다시 가져올 수 있습니다. 대화의 순서와 도구 호출의 짝은 그대로라서 서버가 형식 오류를 내지 않습니다.
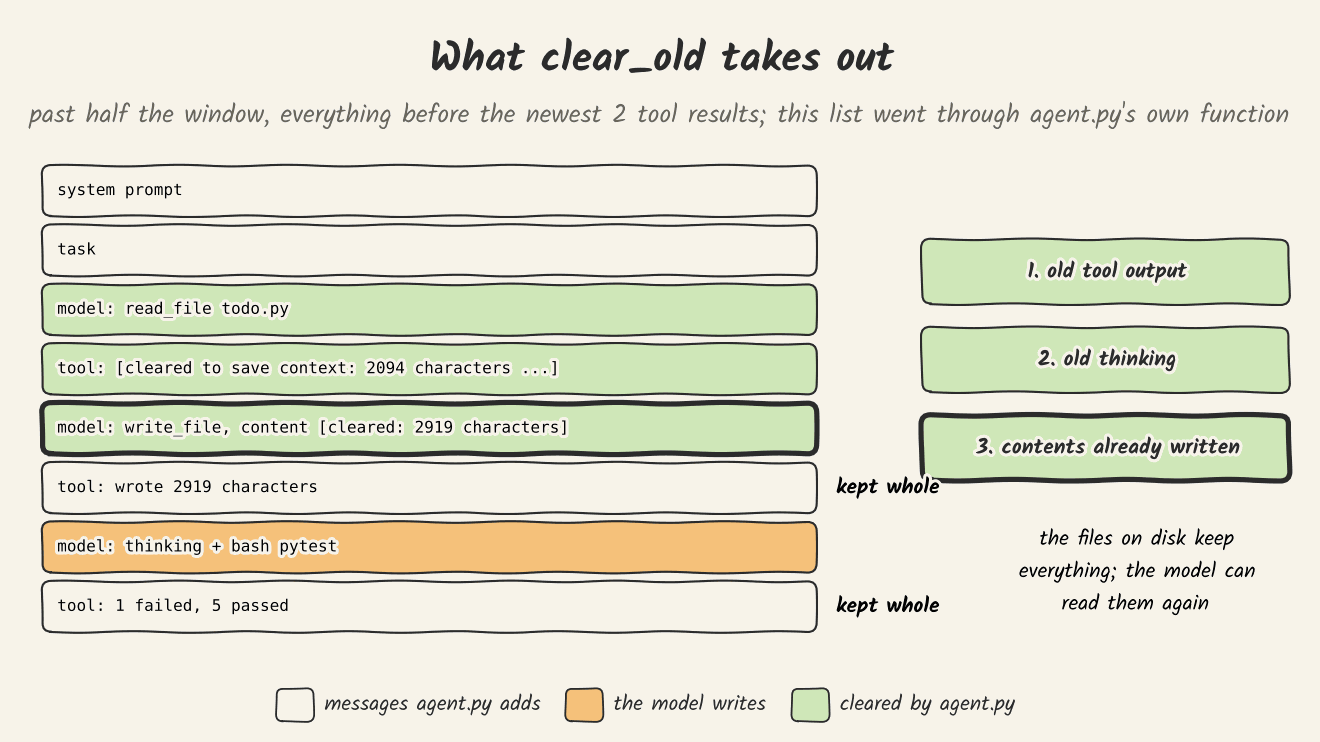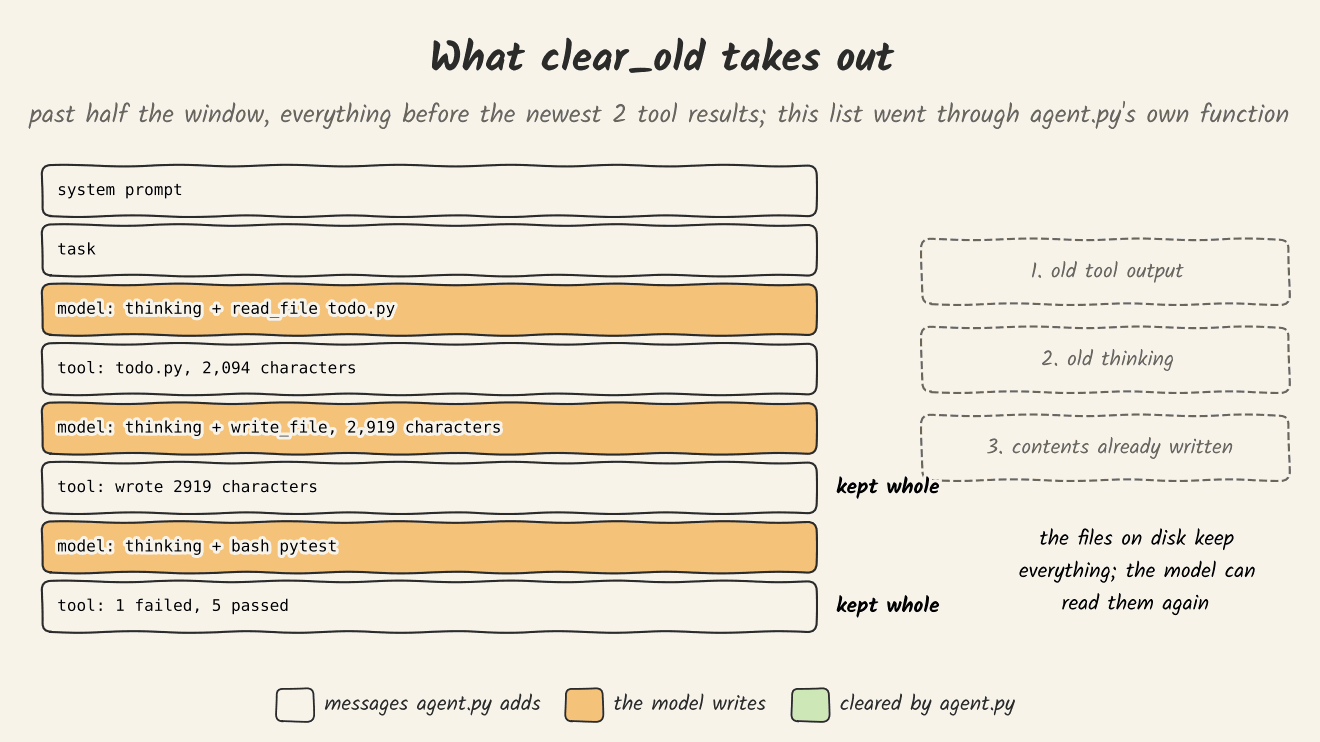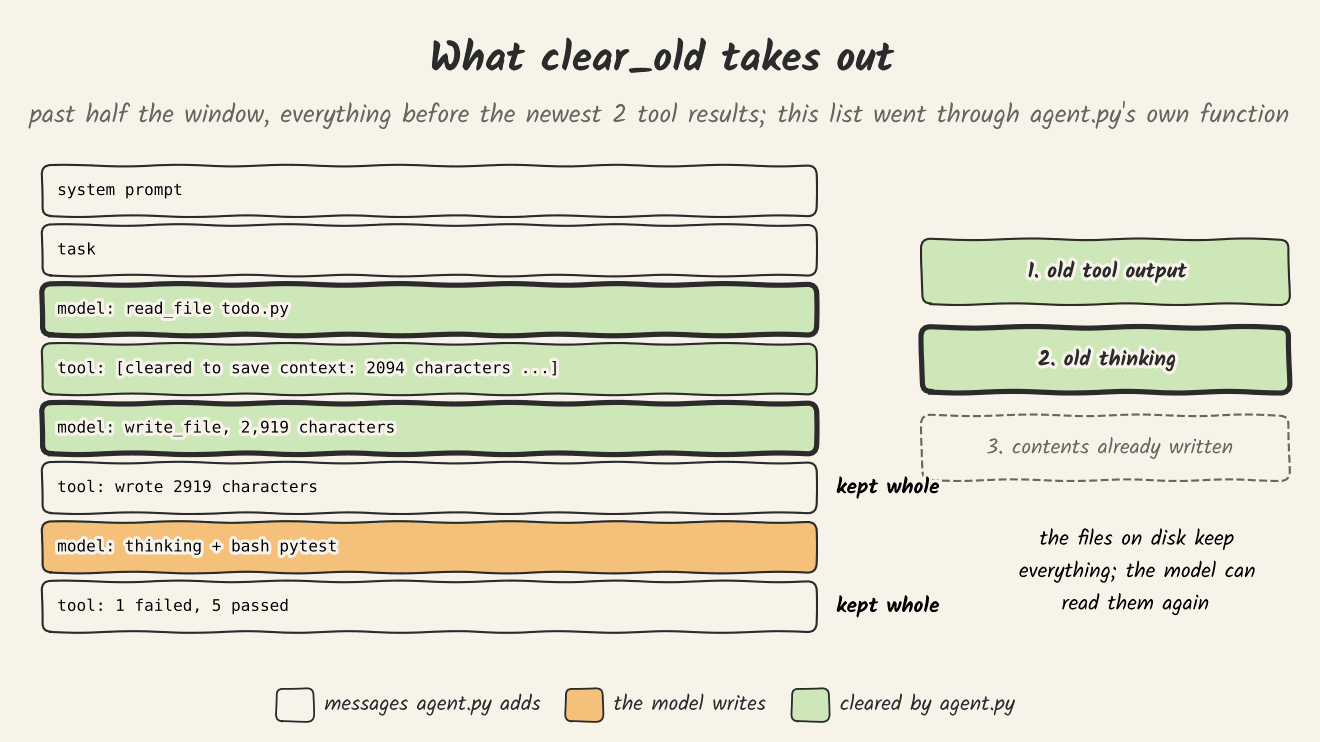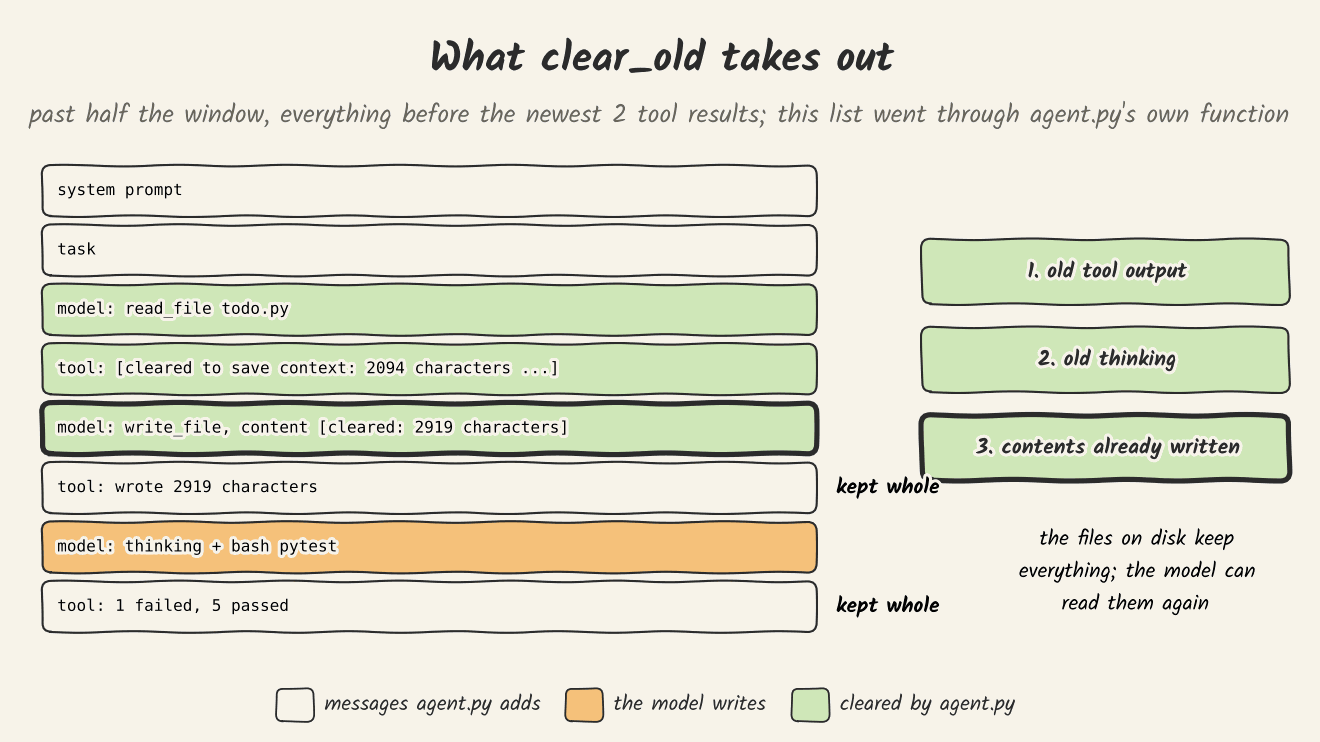
언제 비울지는 서버가 알려 줍니다. 응답마다 usage.total_tokens에 지금 창에 든 토큰 수가 오고, 창 크기는 llama-server의 /props에서 읽습니다. 답을 받은 뒤 창이 반 넘게 찼으면 clear_old를 부릅니다. 요청이 아예 창보다 커서 서버가 400을 돌려주면, 비우고 한 번만 다시 묻습니다. 비울 것이 없으면 거기서 멈춥니다.
잘린 답은 답이 아닙니다
처음에는 비우기만 넣고 4K에서 세 번 돌렸습니다. 결과는 2편 코드보다 나아지지 않았습니다. 세 번 모두 잘린 답을 끝으로 읽고 바뀌지 않은 리포에서 pytest 통과로 끝났습니다. 비우기는 답을 받은 뒤에 일어나는데, 창은 이미 답을 쓰는 도중에 찼기 때문입니다. 잘린 요청의 프롬프트는 1,583토큰에서 1,708토큰으로 창의 절반도 안 됐고, 답이 2,387토큰에서 2,512토큰까지 가다가 잘렸습니다. 비울 것이 문제가 아니라 잘린 답을 받아들이는 것이 문제였습니다.
그래서 서버가 답을 왜 멈췄는지(finish_reason)를 읽게 했습니다.
        if finish in ("length", "unparsed"):
            # The answer ran into the end of the window. It is not an answer: drop it and say what happened.
            messages.append({"role": "user", "content": f"Your last answer was cut off or could not be read; it may "
                             f"have reached the end of the {size}-token context before you finished. Think briefly, and change files in small "
                             "steps with edit_file instead of rewriting them whole."})
continuelength는 창 끝이나 길이 한도에 닿아 멈췄다는 뜻입니다. unparsed는 저희가 붙인 이름입니다. 도구 호출을 쓰는 도중에 잘리면 서버가 그 호출을 읽지 못해 500 "Failed to parse"를 돌려주는데, agent.py가 이것도 잘린 답으로 처리합니다. 4K에서 2편 코드가 멈춘 두 번이 이 경우였습니다. 잘린 답은 대화에 넣지 않고, 대신 답이 잘렸으니 생각을 짧게 하고 파일을 통째로 다시 쓰지 말고 edit_file로 조금씩 고치라고 알립니다.
8K에서 다시 돌린 결과
같은 과제, 같은 리포, 같은 모델로 세 묶음을 세 번씩 돌렸습니다. 2편 코드를 8K에서(A4부터 A6까지), 3편 코드를 8K에서(B4부터 B6까지), 3편 코드를 4K에서(C1부터 C3까지)입니다. 모든 y/N에는 스크립트가 y로 답했습니다.
| 실행 | 코드, 창 | 단계 | 어떻게 끝났나 | 잘린 답 | 비운 횟수 | 에이전트 자체 테스트 | 숨긴 테스트 6개 | 시간 |
|---|---|---|---|---|---|---|---|---|
| A4 | 2편, 8K | 7 | 잘린 도구 호출로 500 | 1 | 없음 | 4개 통과, 6개 실패 | 3개 | 64초 |
| A5 | 2편, 8K | 9 | 잘린 도구 호출로 500 | 1 | 없음 | 8개 통과, 2개 실패 | 6개 모두 | 63초 |
| A6 | 2편, 8K | 8 | 요청 8,809토큰으로 400 | 0 | 없음 | 3개 통과(새 테스트 없음) | 6개 모두 | 64초 |
| B4 | 3편, 8K | 24 | pytest 통과로 끝 | 1 | 5 | 10개 통과 | 6개 모두 | 124초 |
| B5 | 3편, 8K | 23 | pytest 통과로 끝 | 0 | 17 | 9개 통과 | 6개 모두 | 231초 |
| B6 | 3편, 8K | 26 | pytest 통과로 끝 | 0 | 5 | 9개 통과 | 6개 모두 | 96초 |
2편 코드는 8K에서 세 번 모두 서버에서 멈췄습니다. 두 번은 답을 쓰는 도중 창 끝인 8,191토큰에 닿아 도구 호출이 잘렸고, 한 번은 요청이 창보다 커서 거절됐습니다. 4K와 달리 가짜 완료는 없었고, 멈춘 실행은 멈췄다고 출력했습니다. A5와 A6은 멈출 때 이미 숨긴 테스트를 모두 통과하는 todo.py를 써 둔 상태였습니다. 코드는 다 썼는데 마무리를 못 한 셈입니다.
3편 코드는 세 번 모두 스스로 끝났고 숨긴 테스트 6개를 통과했습니다. B4는 한 번 답이 잘렸는데, 그 답을 버리고 다시 물어서 이어 갔습니다.
비우는 데 드는 비용: 프롬프트 캐시
llama-server는 직전 요청을 계산한 결과를 들고 있다가, 다음 요청의 앞부분이 같으면 그 부분을 건너뛰고 새로 붙은 부분만 계산합니다. 에이전트는 매 단계 같은 대화에 몇 줄을 더해 보내므로 보통은 새로 계산할 것이 적습니다. 그런데 오래된 메시지를 비우면 대화 앞쪽이 바뀝니다. 그러면 처음 바뀐 메시지부터 끝까지를 다시 계산해야 합니다. 이 캐시에 무엇이 있는지는 KV 캐시 글에 정리해 두었습니다.
서버 로그에서 요청마다 새로 계산한 토큰 수를 읽어, 프롬프트에서 차지하는 비율을 냈습니다. 8K의 B 세 번에서 비운 직후 요청은 26개였고, 그중 24개가 프롬프트의 절반 넘게 새로 계산했습니다(가장 낮은 값 45%, 중앙값 85%). 비운 직후가 아닌 요청 47개 중 40개는 4분의 1도 새로 계산하지 않았습니다.
비운 횟수는 실행마다 크게 달랐습니다. B5는 17번 비웠고, 실행 전체에서 71,820토큰을 새로 계산했습니다. 실행 시간은 231초였습니다. B4는 5번 비워 14,689토큰에 124초, B6은 5번 비워 15,832토큰에 96초였습니다. B5는 대부분의 단계에서 창의 반을 넘겼기 때문에, 요청 대부분이 비운 직후 요청이었습니다.
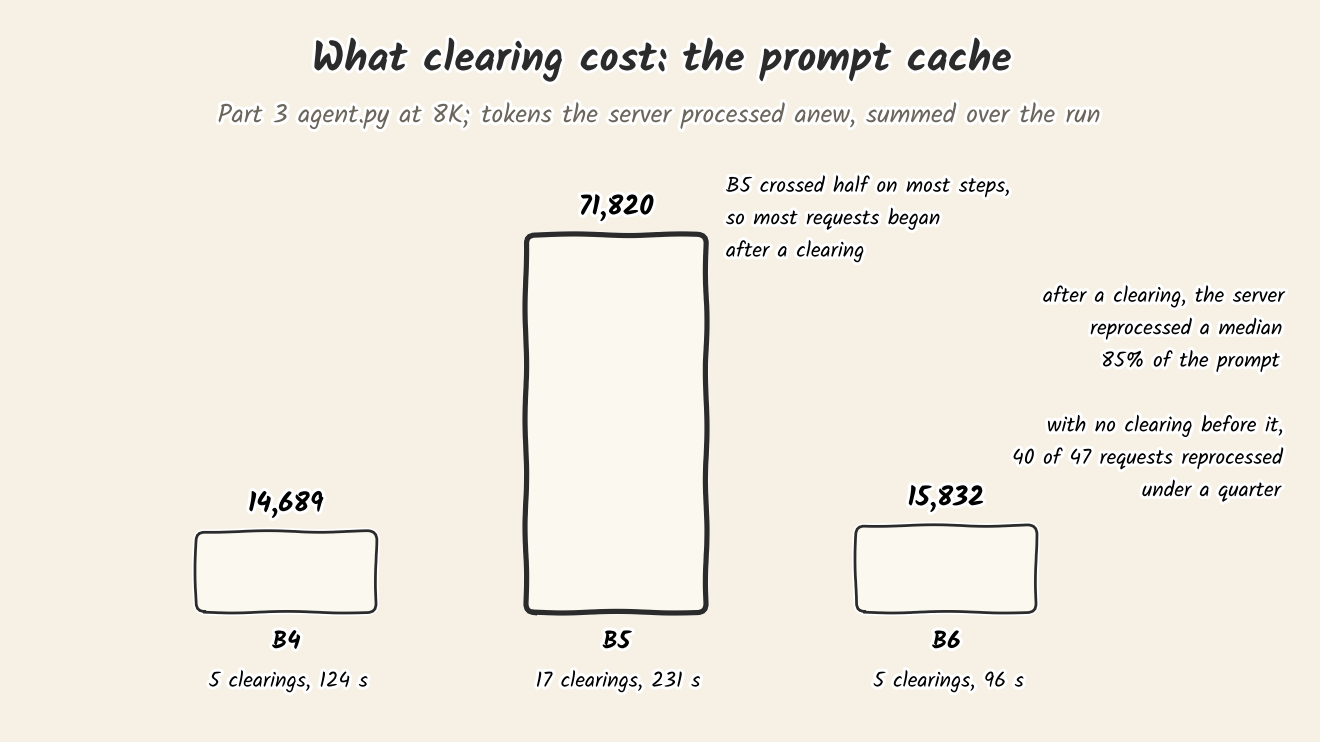
A100에서 B5가 이 71,820토큰을 새로 계산하는 데 쓴 시간은 모두 합쳐 약 32초였고, 231초 중 나머지는 대부분 답을 쓰는 시간이었습니다. 프롬프트 처리가 이보다 느린 카드에서는 이 32초가 그만큼 늘어납니다. 반을 기준으로 삼은 것도 저희가 정한 값이고, 이 기준을 바꿔 보지는 않았습니다.
4K에서는 비울 것이 없습니다
같은 3편 코드를 4K에서 세 번 돌렸습니다. 가짜 완료는 없었습니다. 잘린 답을 버리게 했으니 예상한 결과입니다. 그런데 끝까지 간 실행도 없었습니다.
| 실행 | 단계 | 어떻게 끝났나 | 잘린 답 | 거절된 요청 | 파일 읽기 | 숨긴 테스트 6개 |
|---|---|---|---|---|---|---|
| C1 | 25 | 비울 것이 없는데 요청이 4,108토큰이라 400 | 8 | 0 | 8 | 2개 |
| C2 | 30 | 단계 한도 30에 걸림 | 5 | 5 | 9 | 0개 |
| C3 | 18 | 비울 것이 없는데 요청이 4,143토큰이라 400 | 6 | 0 | 7 | 6개 모두 |
C1과 C3은 오래된 것을 모두 비운 뒤에도 시스템 프롬프트, 과제, 최근 도구 결과 두 개, 그동안 쌓인 "답이 잘렸다"는 안내, 그리고 새 요청만으로 4,096토큰을 넘었습니다. 더 비울 것이 없으니 agent.py는 멈췄습니다. C3이 남긴 todo.py는 숨긴 테스트 6개를 모두 통과합니다. 다만 자기 테스트를 하나도 더하지 못한 채 멈췄으니, 에이전트가 끝낸 작업이라고 할 수는 없습니다.
C2는 멈추지 않고 30단계를 다 썼습니다. 답이 다섯 번 잘렸고, 요청이 다섯 번 거절됐다가 비운 뒤 다시 들어갔습니다. 그 사이 todo.py와 test_todo.py를 번갈아 아홉 번 읽었습니다. 읽은 내용은 곧 비워졌고, 모델은 같은 파일을 다시 읽었습니다. 논문이 말한 "진척 없이 계속 도는 실패"가 이것입니다. 그 전에 todo.py를 두 번 통째로 다시 쓰기도 했는데, 끝에 남은 코드는 원래 코드보다 나빠서 숨긴 테스트를 하나도 통과하지 못했습니다(원래 코드는 2개 통과).
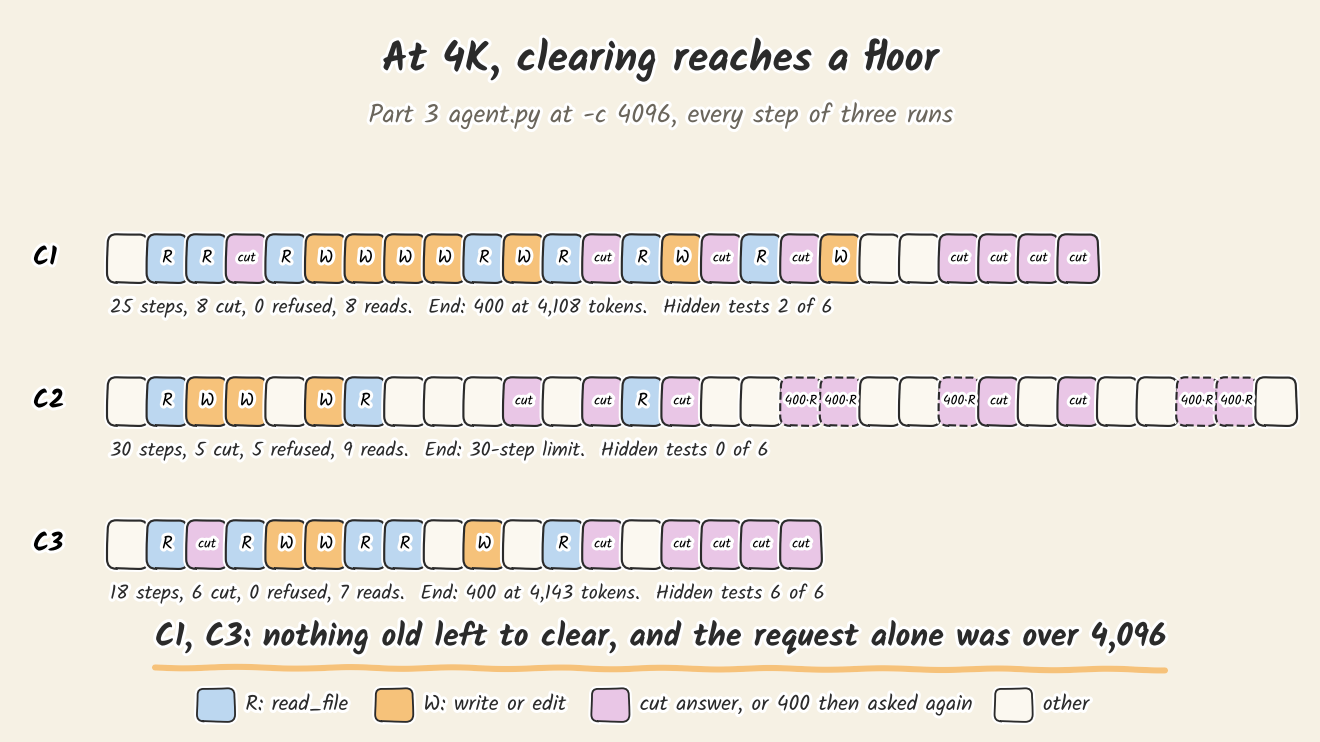
정리하면, 오래된 내용을 비우는 것은 창이 가득 차는 순간을 뒤로 미룰 뿐이고 창을 넓혀 주지는 못합니다. 시스템 프롬프트, 과제, 최근 결과처럼 꼭 남겨야 하는 것만으로 창이 차면 더 비울 것이 없습니다. 이 과제에서 8K는 비우면서 끝까지 갈 만큼 넉넉했고, 4K는 그러기에 너무 작았습니다.
돌리기 전에 적은 예측
두 번 모두 실행 전에 예측을 커밋해 두었습니다.
첫 번째(2편 코드와 비우기만 넣은 코드, 4K에서 세 번씩): 일곱 개 중 맞은 것은 셋이고, 그중 둘은 문구로만 맞았습니다.
- 2편 코드는 세 번 모두 pytest 통과로 끝나지 못하고 8단계 전에 멈춘다고 했는데 틀렸습니다. 한 번은 바뀌지 않은 리포에서 통과로 끝났습니다.
- 비우기 코드는 두 번 이상 스스로 끝난다고 했고 세 번 끝났습니다. 그런데 세 번 모두 파일을 고치지 않았으니 맞혔다고 보기 어렵습니다.
- 스스로 끝난 실행은 숨긴 테스트 6개를 모두 통과한다고 했는데 틀렸습니다. 세 번 모두 2개였습니다.
- 비우기가 실행마다 한 번 이상 일어난다는 예측은 맞았습니다. 다만 잘린 답 다음에 일어났고, 한 번은 비운 메시지가 0개였습니다.
- 비운 파일을 다시 읽는 실행이 있다는 예측은 틀렸습니다. 그 단계까지 간 실행이 없었습니다. 비운 직후 요청의 캐시 예측은 그런 요청이 없어 판정하지 못했습니다.
- 400으로 멈추는 실행은 없다고 했고 맞았습니다.
예측하지 못한 것은 창이 프롬프트가 아니라 답을 쓰는 도중에 찬다는 점, 그리고 pytest 통과라는 완료 기준이 바뀌지 않은 리포에서도 통과한다는 점이었습니다.
두 번째(위의 8K와 4K, 세 묶음): 다섯 개 중 셋은 맞고, 하나는 반만 맞고, 하나는 틀렸습니다.
- 2편 코드는 8K에서 숨긴 테스트를 한 번 이상 놓치고 한 번 이상 통과한다고 했고 맞았습니다(3개, 6개, 6개).
- 3편 코드는 8K에서 두 번 이상 스스로 끝나 숨긴 테스트를 모두 통과한다고 했고 맞았습니다(세 번).
- 3편 코드는 8K와 4K 어디서도 바뀌지 않은 리포로 끝났다고 하지 않는다고 했고 맞았습니다.
- 4K에서는 숨긴 테스트를 모두 통과하는 실행이 없고, 실행마다 잘린 답이 두 번 이상이라고 했습니다. 앞쪽은 틀렸고(C3의 todo.py가 6개 통과), 뒤쪽은 맞았습니다(8, 5, 6번).
- 비운 직후 요청은 모두 프롬프트의 절반 이상을 새로 계산한다고 했는데 틀렸습니다. 8K에서 26개 중 24개였고, 가장 낮은 값은 45%였습니다.
두 번째 예측을 적을 때 저희는 첫 번째 실행에서 잘린 답의 크기를 2,400토큰에서 3,400토큰으로 적었습니다. 서버 로그에서 다시 계산하니 2,387토큰에서 2,512토큰이었습니다. 이 수정으로 바뀌는 판정은 없습니다.
확인하지 못한 것
- 보내기 전에 비우기. 지금은 답을 받은 뒤에 비웁니다. 그래서 B4처럼 이미 반을 넘은 상태에서 요청이 나갈 수 있습니다. 보내기 전에 크기를 재서 비우는 방식을 사용하면 결과가 다를 수 있습니다.
- 반이라는 기준. 더 늦게 비우면 캐시를 덜 잃겠지만 창 끝에서 잘릴 위험이 커집니다. 역시 기준을 바꿔 가며 실험을 하면 결과가 달라질 수 있습니다.
- 비우는 대신 요약하기. 오래된 대화를 지우지 않고 짧게 요약해 남기는 방식은 이번에 다루지 않았습니다.
- 완료 기준 자체. 이번 수정은 잘린 답을 걸러 낼 뿐, "pytest가 통과하면 끝"이라는 기준은 그대로입니다. 파일이 바뀌었는지, 새 테스트가 생겼는지는 보지 않습니다.
- 32K에서 긴 과제. 이 글의 현상을 보려고 창을 줄였습니다. 창이 넉넉하면 이런 일이 덜 일어나리라 보지만, 실제로 32K를 채우는 긴 과제는 돌려 보지 않았습니다.