로컬 AI 코딩 에이전트 2편: 묻지 않고 실행할 명령, 에이전트가 다시 쓰지 못하는 테스트
1편의 로컬 코딩 에이전트에 규칙 세 개를 더하고 할 일 앱에 여섯 번 돌렸습니다. 처음 만든 허용 목록은 셸 명령 23개 중 하나도 통과시키지 못했습니다. 모델이 명령을 `|`, `&&`, `;`로 이어 쓰기 때문입니다. 리디렉션을 지우고, 조각마다 검사하고, 목록에 단어 네 개를 더하자 16개 중 10개가 묻지 않고 실행됐고, 여전히 물어본 6개에는 모두 rm, cd, 리포 밖 경로 중 하나가 있었습니다. 처음 있던 테스트는 읽기 전용이 됐고(한 번 되돌림), 모델이 멈추면 pytest를 직접 돌립니다. 코드와 여섯 번의 기록, 그리고 한계를 담았습니다.
로컬 AI 코딩 에이전트 2편: 묻지 않고 실행할 명령, 에이전트가 다시 쓰지 못하는 테스트
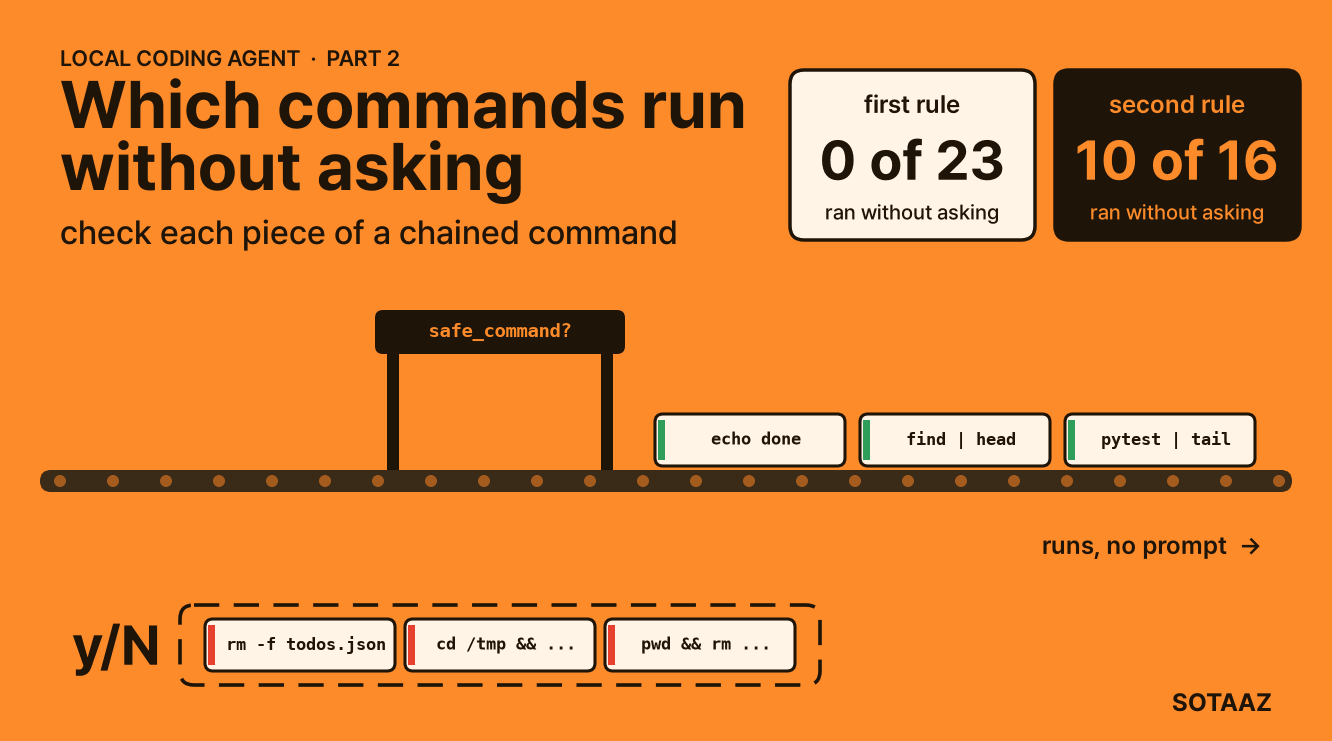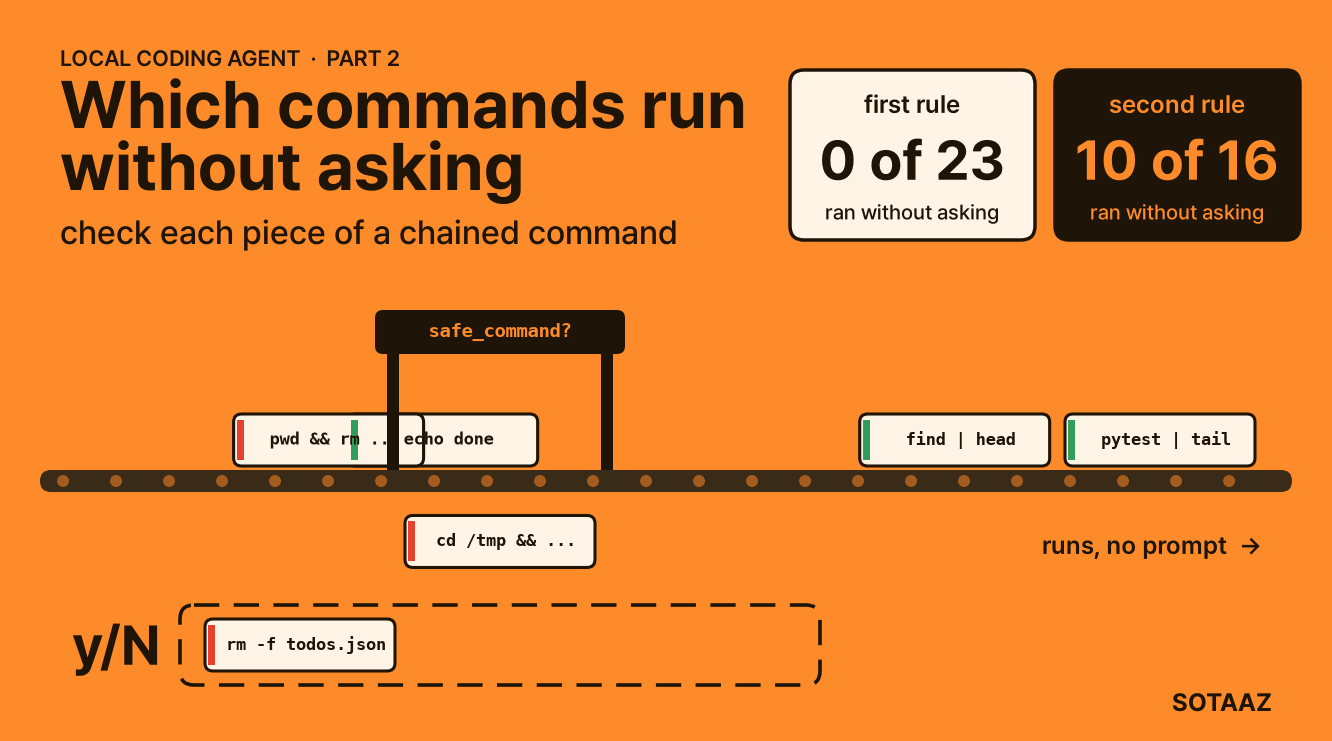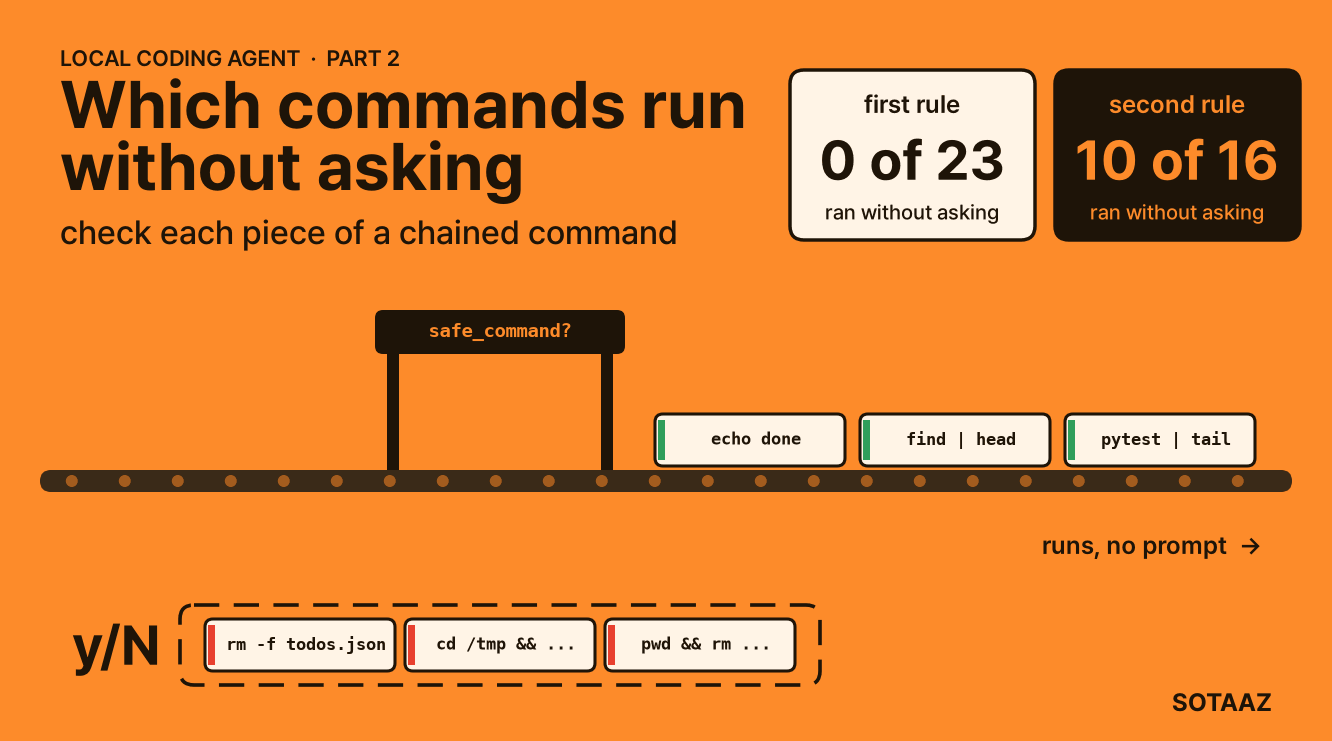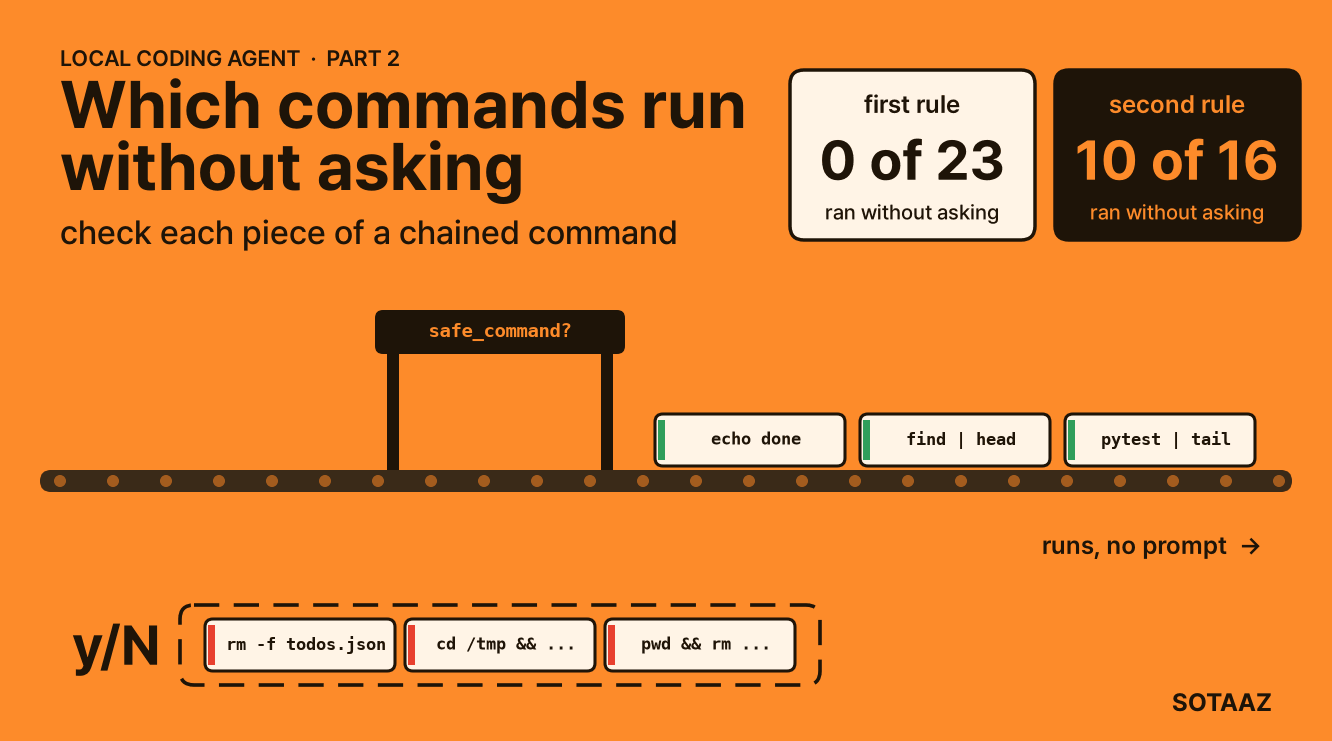
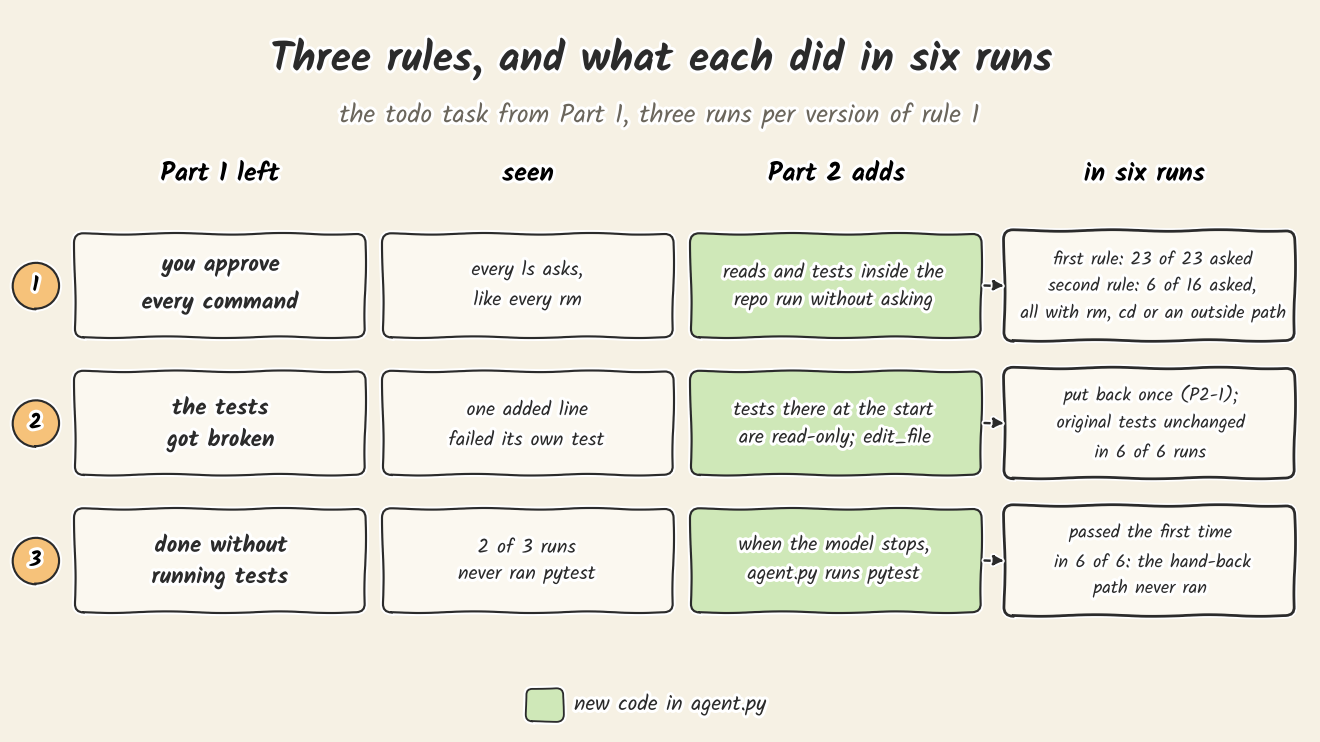
1편 에이전트는 셸 명령마다 y/N을 물었습니다. 파일 목록을 보는 ls도, 파일을 지우는 rm도 똑같이 물었습니다. 그래서 이번 편에서 가장 먼저 넣은 것이 이 규칙입니다. 리포 안에서 파일을 읽거나 테스트를 돌리는 명령은 묻지 않고 바로 실행합니다.
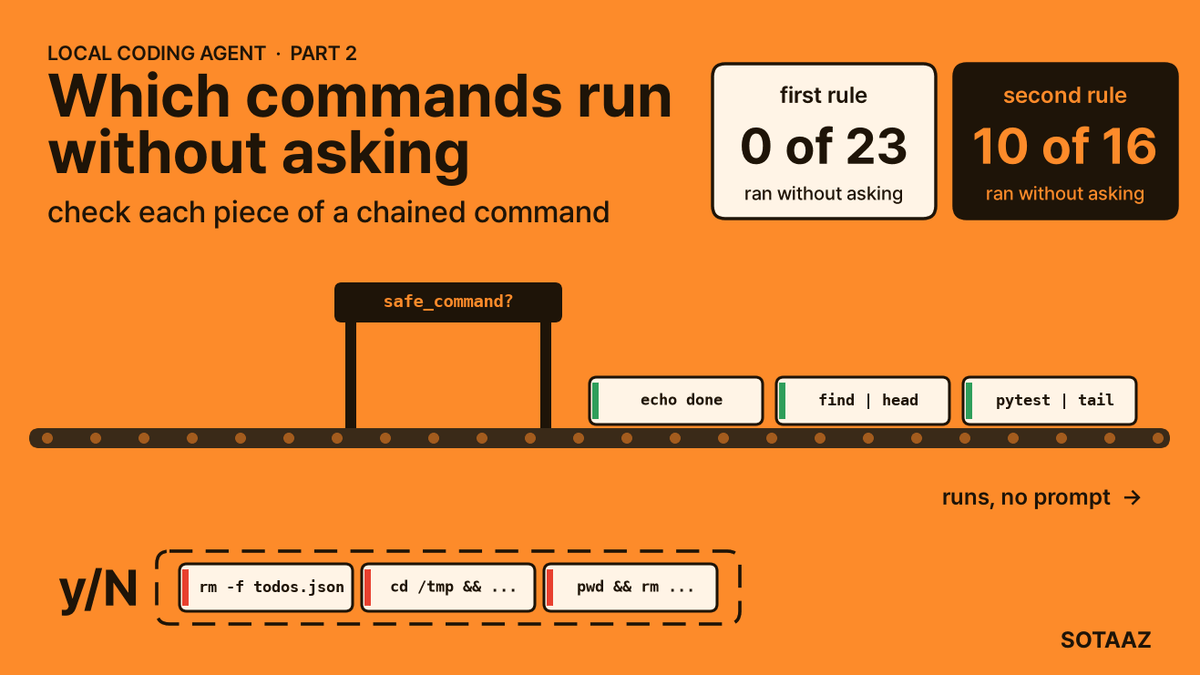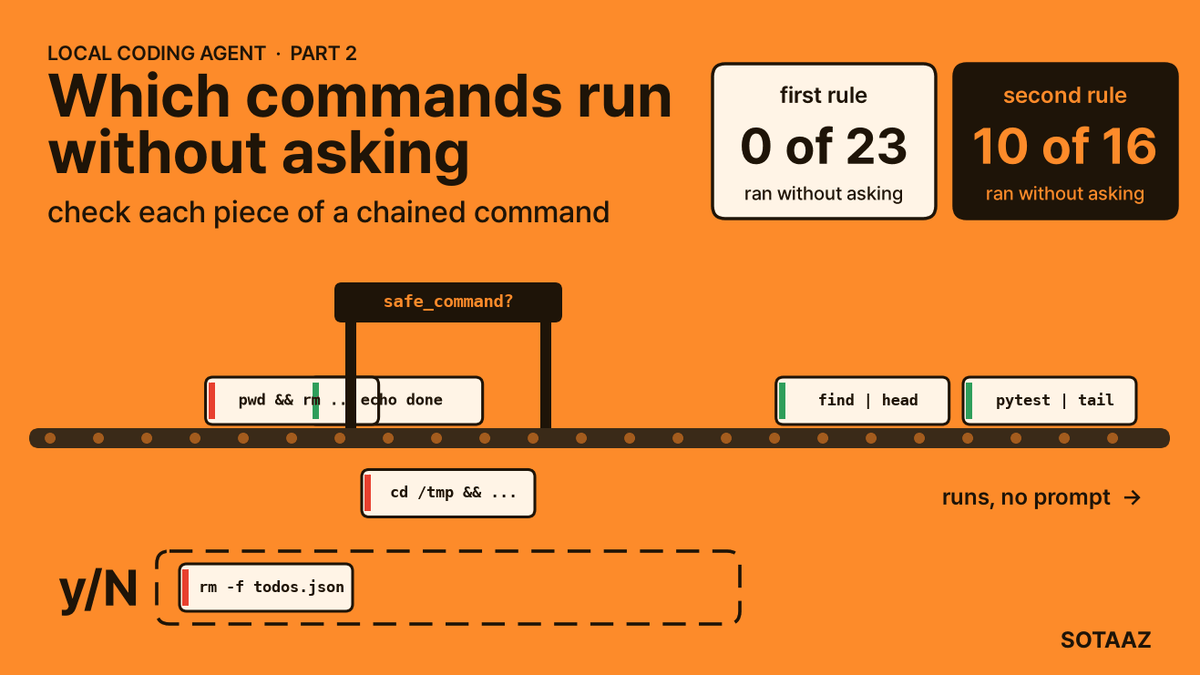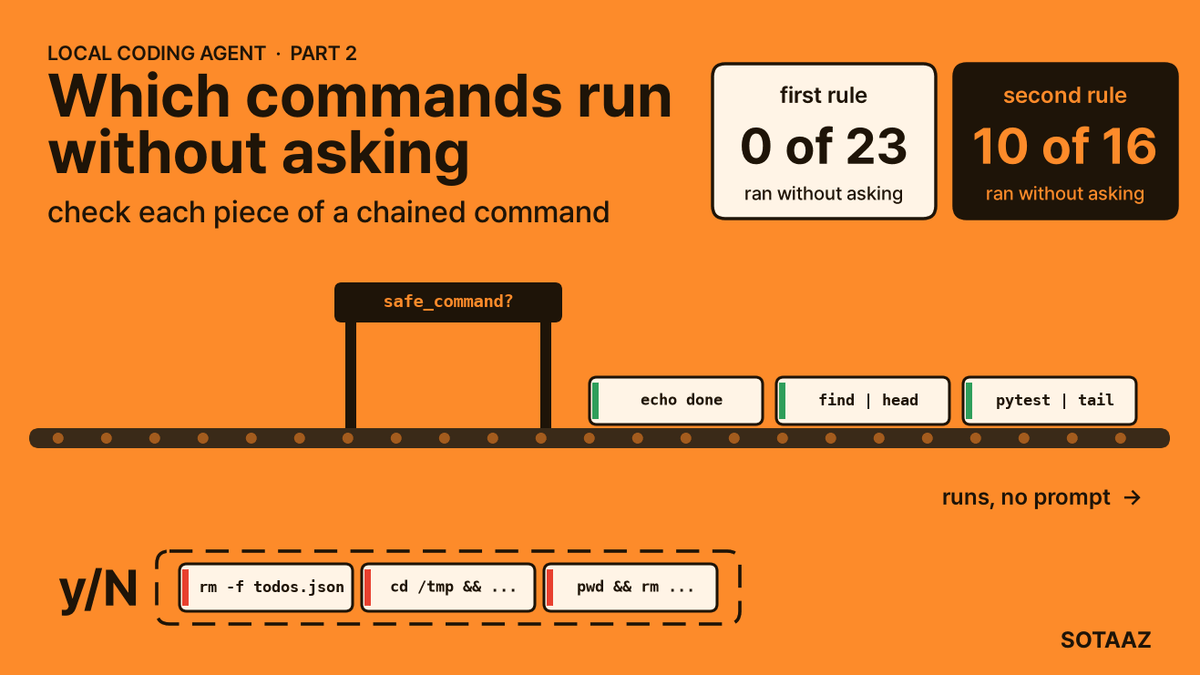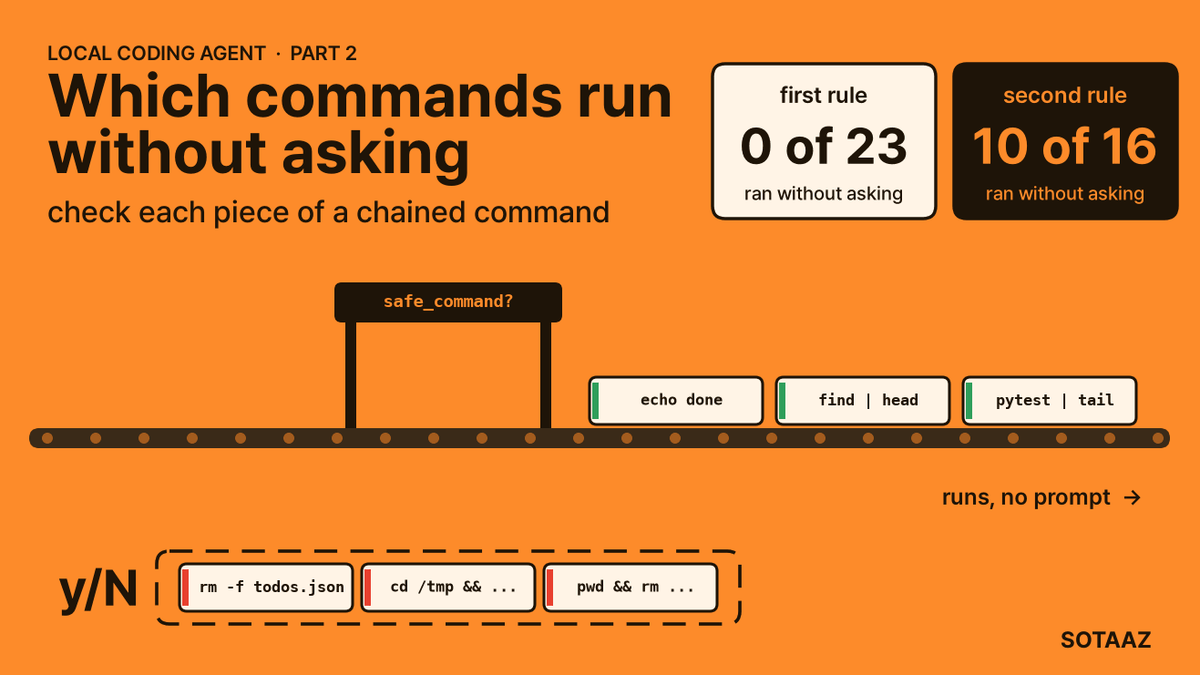
처음에는 단순하게 만들었습니다. 허용할 명령 단어 일곱 개(ls, cat, head, tail, grep, wc, pytest)를 목록에 적고, 명령에 ;, &, | 같은 기호가 하나라도 있으면 거절하게 했습니다. 이 글에서는 이것을 첫 규칙이라고 부릅니다. 그리고 같은 할 일 과제를 세 번 돌렸습니다. 세 번 동안 모델이 실행한 bash 명령은 23개였는데, 묻지 않고 실행된 명령은 하나도 없었습니다. 23개 모두 멈추고 y/N을 물었습니다.
이유는 모델이 명령을 쓰는 방식에 있었습니다. 모델은 이렇게 씁니다.
python -m pytest -q 2>&1 | tail -20테스트를 돌리고(pytest), 그 출력에서 마지막 20줄만 보는(tail) 명령입니다. 둘 다 목록에 있는 단어입니다. 허용한 명령 두 개를 이어서 실행할 뿐인데, 왜 물어봤을까요?
첫 규칙은 명령 한 줄을 통째로 봤기 때문입니다. 두 명령을 잇는 |가 있고, 오류 메시지도 같이 보여 달라는 2>&1에는 &가 있습니다. 첫 규칙은 이런 기호가 보이면 앞뒤에 무엇이 있든 거절했습니다. 23개 중 22개가 이렇게 |, &&, ;로 명령 두 개 이상을 이어 붙인 명령이었습니다. 나머지 하나는 true 한 단어였는데, 이 단어는 목록에 없었습니다. 안전하기는 했지만 쓸모는 없는 규칙이었습니다.
그래서 세 가지를 고쳤습니다. 오류 메시지를 넘기는 2>&1 같은 리디렉션은 검사 전에 지우고, 이어 붙인 명령은 |, &&, ||, ;에서 잘라 조각마다 목록에 있는지 확인하고, 모델이 실제로 쓴 단어 네 개(find, echo, pwd, true)를 목록에 더했습니다. 이것이 두 번째 규칙입니다. 두 번째 규칙으로 다시 세 번 돌리자, 모델이 실행한 bash 명령 16개 중 10개가 묻지 않고 실행됐습니다. 여전히 물어본 6개에는 모두 파일을 지우는 rm, 디렉터리를 옮기는 cd, 리포 밖 경로 중 하나가 있었습니다. 사람이 y/N을 누르는 자리에는 사람이 볼 만한 명령만 남았습니다.
이 글은 agent.py에 더한 규칙 세 개와, 여섯 번 돌린 결과를 규칙별로 보여 줍니다.
- 리포 안에서 읽기만 하거나 테스트만 돌리는 명령은 묻지 않고 실행합니다. 나머지는 1편처럼 결정 모델의 의견과 함께 y/N을 묻습니다. 위에서 말한 첫 규칙과 두 번째 규칙은 이 규칙 1의 두 버전입니다.
- 처음부터 있던 테스트는 읽기 전용입니다. 그리고 파일 전체를 다시 쓰지 않고 한 부분만 바꾸는
edit_file도구를 새로 넣었습니다. 테스트 파일을 되돌리는 장치는 한 번 작동했습니다. - 모델이 끝났다고 하면 agent.py가 pytest를 직접 돌립니다. 여섯 번 모두 첫 번째에 통과해서, 실패를 모델에게 돌려주는 부분은 한 번도 쓰이지 않았습니다.
에이전트가 보지 못하게 숨겨 둔 테스트 6개는 1편처럼 여섯 번 모두 통과했습니다. 규칙 버전마다 세 번씩, 남은 y/N에는 스크립트가 모두 y로 답했고, 과제는 하나입니다. 실행하기 전에는 매번 예측을 적어 먼저 커밋해 두었고, 맞았는지는 글 끝에 있습니다.
1편에서 멈춘 곳
1편에서는 로컬 부품 세 개로 에이전트를 만들었습니다. llama-server 위의 Flint가 코드를 쓰고, agent.py가 도구 호출을 실행하고, CPU에서 도는 0.8B 결정 모델 Jeff가 셸 명령마다 한 줄 의견을 붙입니다. 사용자는 그때마다 y/N에 답합니다.
할 일 앱에 돌려 보니 문제가 세 가지 남았습니다.
- 모든 명령을 사람이 승인합니다.
ls도rm과 똑같이 묻습니다. Jeff를 붙이기 전 실행에서는 y를 아홉 번 눌렀고, 그중 세 명령은 리포 밖으로 나갔습니다. - 모델이 테스트 파일을 다시 썼습니다. 세 번째 실행에서는 모델이 더한 한 줄 때문에 자기 테스트 파일이 실패했습니다.
- 테스트를 돌리지 않고 끝났다고 했습니다. 세 번 중 두 번이었습니다.
아래 규칙은 이 셋에 하나씩 대응합니다. 코드는 1편 파일에 81줄을 더해 모두 216줄이고, 여전히 표준 라이브러리만 씁니다. 바뀐 부분만 보여 드리고, 나머지는 1편과 같습니다.
규칙 1: 묻지 않고 실행할 명령
아래 코드가 두 번째 규칙, 곧 지금 agent.py에 들어 있는 버전입니다.
import re
import shlex

# Commands that only read or run the tests, with no path outside the repo, run without asking. Models chain commands
# (`python -m pytest -q 2>&1 | tail -20`), so a command is split at | && || ; & and every piece must be on the list.
SAFE = {"ls", "cat", "head", "tail", "grep", "wc", "find", "pytest", "echo", "pwd", "true"}


def safe_command(command):
    command = command.replace("2>&1", "").replace("2>/dev/null", "")
    if any(c in command for c in "<>$`\n") or any(f in command for f in ("-exec", "-ok", "-delete", "-fprint", "-fls")):
        return False
    for piece in re.split(r"\|\||&&|[|;&]", command):
        try:
            words = shlex.split(piece)
        except ValueError:  # unbalanced quotes: let a person look at it
            return False
        if words[:2] in (["python", "-m"], ["python3", "-m"]):
            words = words[2:]
        if not words or words[0] not in SAFE or any(w.split("=")[-1].startswith(("/", "~")) or ".." in w for w in words[1:]):
            return False
return Truerun_tool의 bash 부분은 안전하지 않은 명령일 때만 묻도록 바뀝니다.
        if name == "bash":
            # Anything that is not a plain read or test run inside the repo still needs a person's yes.
            if not safe_command(args["command"]):
                print(flag_command(root, args["command"]))
                if input(f"run `{args['command']}`? [y/N] ").strip().lower() != "y":
                    return "the user declined to run this command"
            p = subprocess.run(args["command"], shell=True, cwd=root, capture_output=True, text=True, timeout=60,
                               stdin=subprocess.DEVNULL)
return (p.stdout + p.stderr)[-6000:] + f"\n[exit code {p.returncode}]"safe_command는 명령을 세 번에 걸쳐 봅니다.
- 먼저 모델이 거의 모든 명령 끝에 붙이는 리디렉션 두 개를 지웁니다.
2>&1과2>/dev/null입니다. 둘 다 오류 메시지를 어디로 보낼지만 정합니다. - 다음으로 파일을 쓰거나, 다른 것을 실행하거나, 밖으로 나갈 수 있는 것은 거절합니다.
>와<, 명령 안에서 다른 명령을 실행하는$와 백틱, 두 번째 명령을 시작하는 줄바꿈, 그리고 파일을 지우거나 명령을 실행하는find옵션들입니다. - 마지막으로 남은 명령을
|,&&,||,;,&에서 잘라 조각마다 검사합니다. 조각의 첫 단어가 목록에 있어야 하고(python -m pytest는pytest로 칩니다), 그 뒤 단어는/나~로 시작하거나..를 담고 있으면 안 됩니다.--basetemp=/x처럼=뒤에 붙은 경로도 같은 기준으로 봅니다.
여섯 번의 실행에 쓴 것은 이보다 하나 앞선 버전입니다. 실행이 끝난 뒤 코드를 검토하다가, 그 버전이 & 하나로 이은 명령(ls & rm -rf todo.py)과 = 뒤에 붙은 경로를 통과시킨다는 것을 찾았습니다. 위 코드는 이 둘을 고친 것이고, 실행 기록에 남은 명령 39개를 두 버전에 모두 넣어 보니, 판정이 다른 명령은 하나도 없었습니다.
결정 모델의 의견은 이제 묻는 명령에만 붙습니다. 묻지 않고 실행되는 명령은 Jeff를 기다리지 않습니다.
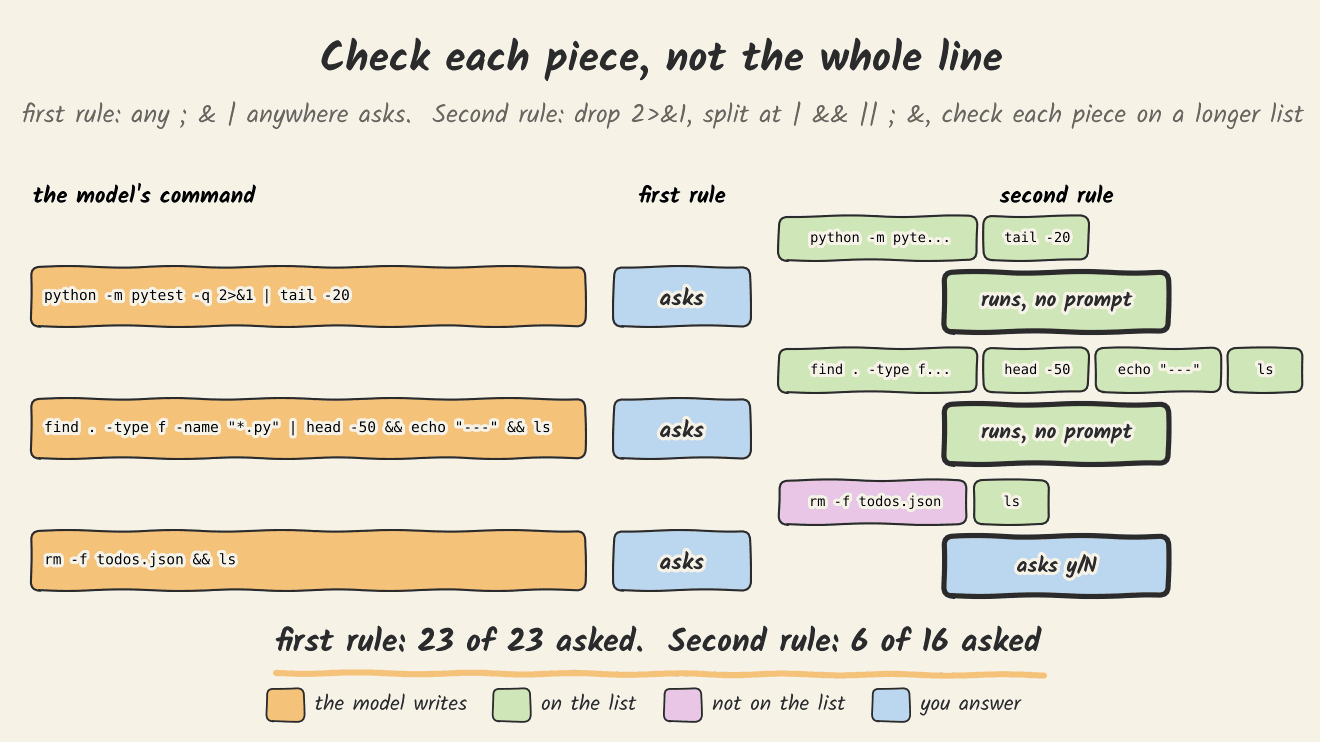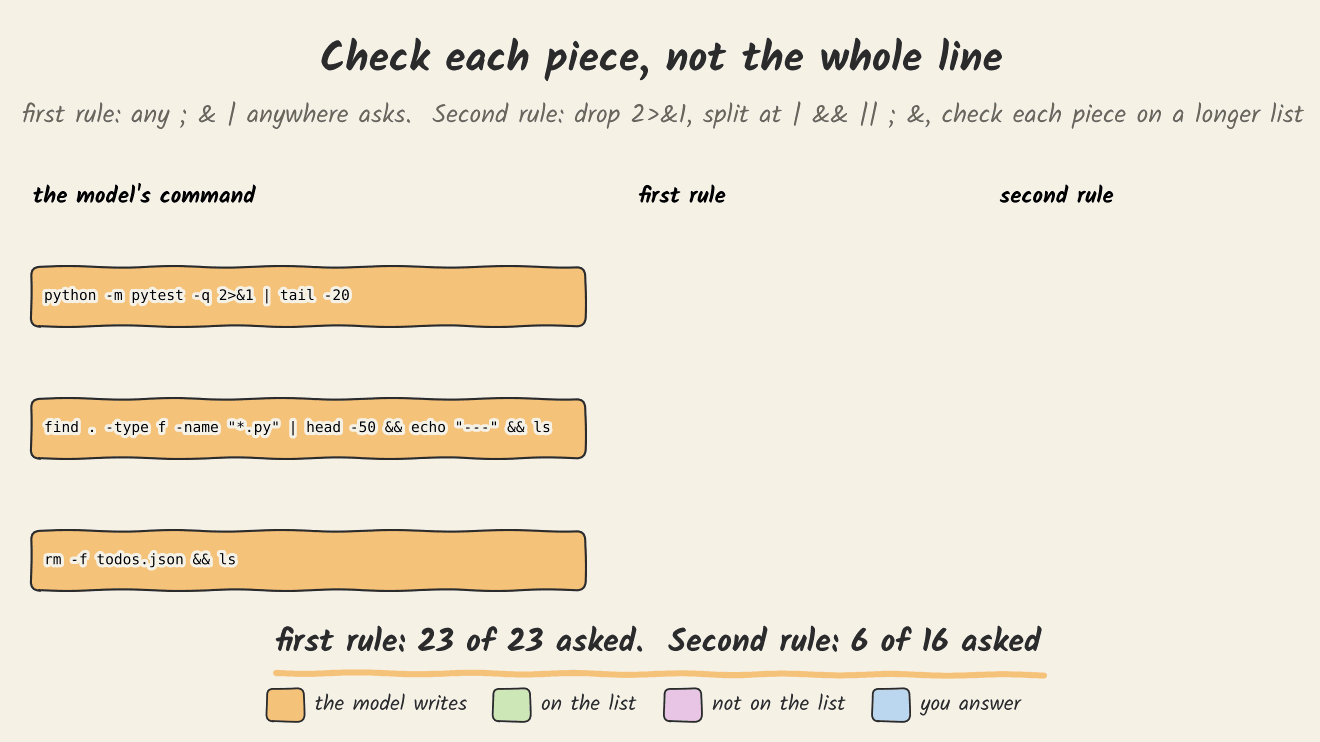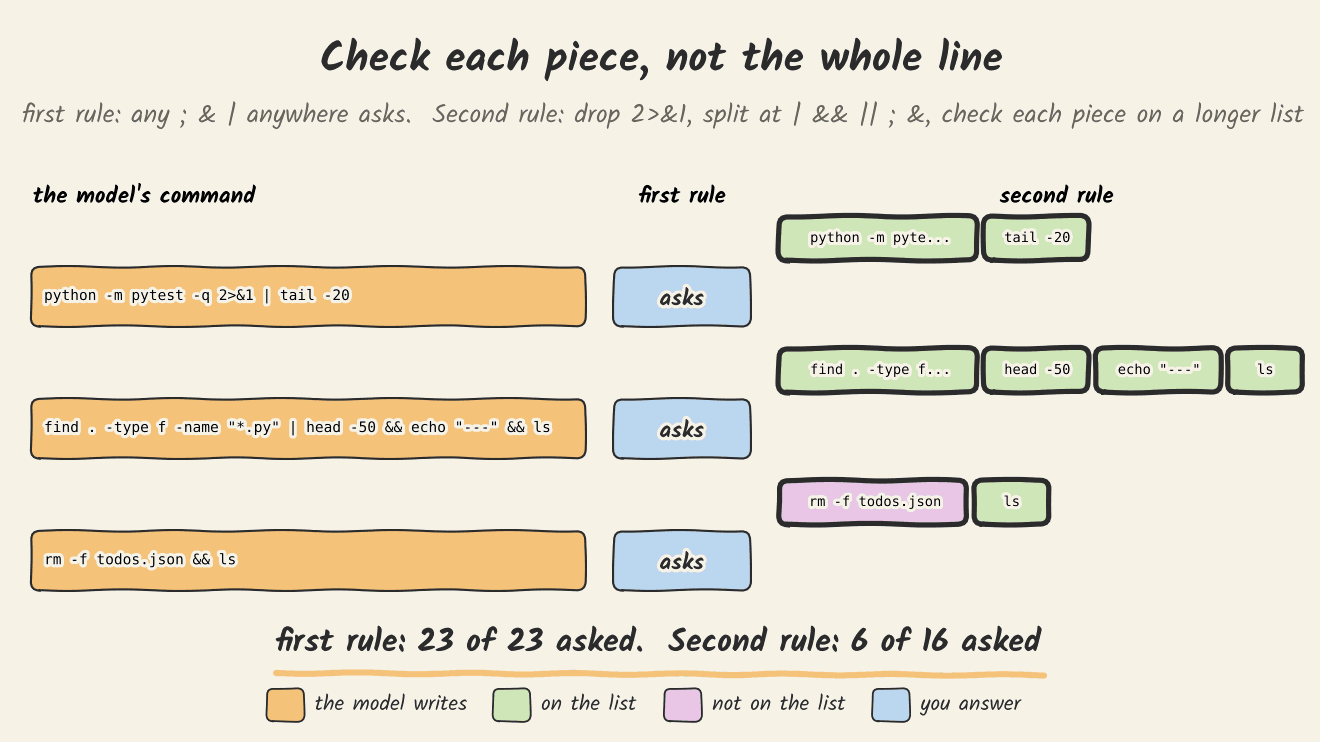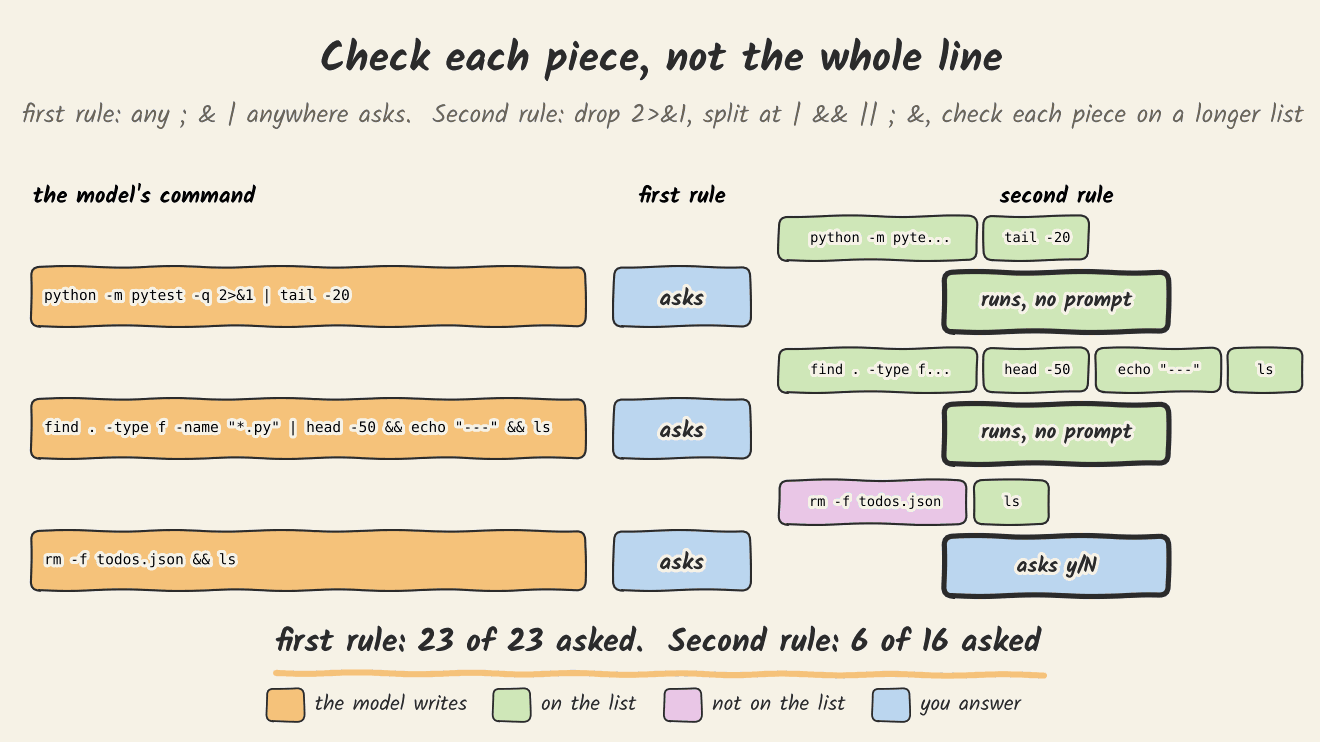
첫 규칙과 비교하면 바뀐 곳은 세 군데입니다. 첫째, 첫 규칙은 리디렉션을 지우지 않았습니다. 그래서 2>&1 안의 &와 >만으로도 거절했습니다. 둘째, 첫 규칙은 명령을 자르지 않고 ;, &, |가 보이면 그 자리에서 거절했습니다. 셋째, 목록이 일곱 단어였는데, 두 번째 규칙은 여기에 find, echo, pwd, true를 더해 열한 단어입니다. 네 단어 모두 모델이 첫 규칙으로 돌린 세 번에서 실제로 쓴 단어입니다. 그러니 아래 표에서 0개가 10개로 늘어난 것은 어느 하나의 효과가 아니라, 세 가지를 합친 결과입니다.
첫 규칙으로 돌린 세 번(P2-1부터 P2-3까지)이 끝난 뒤, 그때 나온 명령 23개를 두 번째 규칙에 다시 넣어 보았습니다. 14개가 통과하고 9개가 물었습니다. 다만 저희는 이미 그 23개를 읽고 거기에 맞춰 규칙을 고쳤으니, 이 결과는 규칙이 의도대로 작동한다는 것만 보여 줍니다. 그래서 두 번째 규칙으로 새로 세 번(P2-4부터 P2-6까지) 돌리기 전에 예측을 먼저 커밋했습니다. 아래 표의 둘째 줄이 그 새 실행입니다.
| 규칙 | 명령 수 | 묻지 않고 실행 | 물어봄 |
|---|---|---|---|
| 첫 규칙: 일곱 단어, 기호가 있으면 거절 (P2-1부터 P2-3까지) | 23 | 0 | 23 |
| 두 번째 규칙: 리디렉션 지움, 조각마다 검사, 열한 단어 (P2-4부터 P2-6까지) | 16 | 10 | 6 |
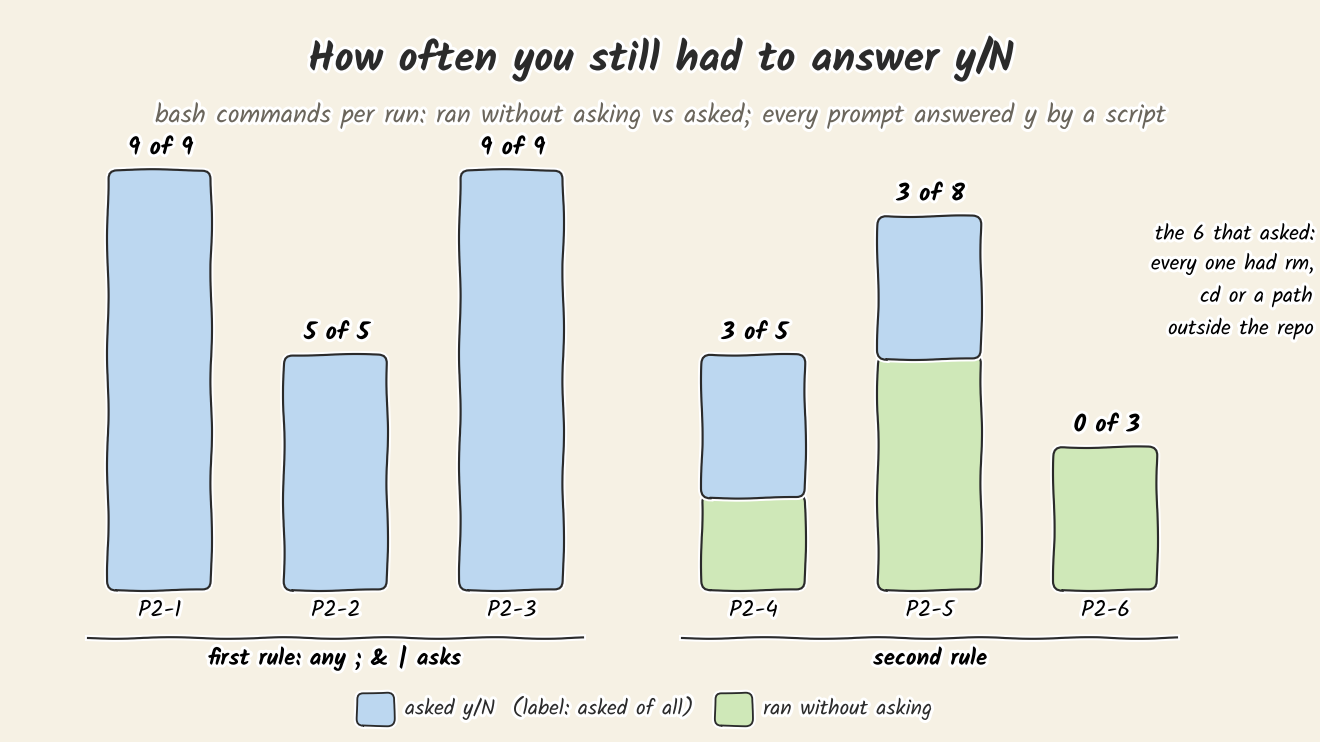
두 번째 규칙에서 묻지 않고 실행된 10개는 pytest와 tail을 이은 명령 6개, find에 head와 echo를 이은 명령 3개, echo 하나였습니다. 앞의 6개는 리디렉션을 지우고 조각으로 나누기만 하면 일곱 단어 목록으로도 통과합니다. 나머지 4개는 새로 더한 find와 echo가 있어야 통과합니다. 여전히 물어본 6개는 이렇습니다.
cd /tmp && rm -f todos.json && python /app/todo.py add "buy milk" --due 2024-01-15 ..., P2-4와 P2-5에서 한 번씩pwd && rm -f todos.json && python todo.py add "buy milk" ..., 역시 두 번rm -f todos.json && python -m pytest -q 2>&1 | tail -5와rm -f todos.json && ls
모두 파일을 지우거나, 디렉터리를 옮기거나, 리포 밖 경로를 가리킵니다. P2-6은 하나도 묻지 않았습니다. 명령이 세 개였고 모두 pytest, find, echo였습니다.
내려받은 agent.py로 직접 확인하려면 같은 폴더에서 다음을 실행합니다.
python3 -c "import agent; print(agent.safe_command('python -m pytest -q 2>&1 | tail -20'), agent.safe_command('cd /tmp && rm -f todos.json'))"이렇게 나오면 성공입니다: True False
이 규칙이 막지 못하는 것
명령의 글자를 검사할 뿐, 샌드박스가 아닙니다. cat notes.txt는 통과합니다. 그런데 notes.txt가 디스크 다른 곳의 파일을 가리키는 링크라면 cat은 그 파일을 읽습니다. 글자만 보고는 명령이 실제로 무엇을 건드릴지 다 알 수 없습니다. 명령이 실행되는 동안 닿을 수 있는 범위를 막는 일은 글자 검사로는 할 수 없고, 컨테이너 같은 격리 환경이 해야 합니다. 정말로 격리해야 한다면 리포 사본을 컨테이너 안에 두고 에이전트를 돌리십시오. 저희는 실행마다 리포 사본에서 돌렸지만 컨테이너는 쓰지 않았습니다.
pytest를 묻지 않고 돌린다는 것은 모델이 쓴 코드를 돌린다는 뜻입니다. 테스트 파일은 모델이 쓰고, pytest는 그 파일을 불러와 실행합니다. 테스트 파일 안에서는 파이썬이 할 수 있는 일을 무엇이든 할 수 있습니다. 그러니 규칙 1은 "y 없이는 모델이 컴퓨터를 바꿀 수 없다"는 약속이 아닙니다. "읽고 테스트하려고 치는 명령에는 y가 필요 없다"는 약속입니다. 테스트 자체가 무엇을 하는지는 읽어 봐야만 압니다. 저희는 여섯 번의 실행에서 모델이 남긴 테스트 파일을 모두 읽었고, 테스트용 임시 폴더 밖을 건드린 것은 없었습니다. 그렇다고 여섯 번으로 앞으로도 그런 일이 없다고 말할 수는 없습니다.
규칙 2: 처음 있던 테스트는 읽기 전용
먼저 파일 전체를 보내지 않고 일부만 바꿀 수 있는 도구를 더합니다.
    {"type": "function", "function": {
        "name": "edit_file", "description": "Replace one exact piece of text in a file. old must appear exactly once.",
        "parameters": {"type": "object", "properties": {"path": {"type": "string"}, "old": {"type": "string"},
"new": {"type": "string"}}, "required": ["path", "old", "new"]}}}, if name == "edit_file":
path = inside(root, args["path"])
text = path.read_text()
if text.count(args["old"]) != 1:
return f"error: old appears {text.count(args['old'])} times in {args['path']}, it must appear exactly once"
path.write_text(text.replace(args["old"], args["new"]))
return f"edited {args['path']}"다음은 테스트를 지키는 장치입니다. 실행을 시작할 때 agent.py가 test_*.py 파일을 모두 읽어 테스트 함수마다 소스를 기억해 둡니다. 그리고 bash를 포함해 어떤 도구든 한 번 쓸 때마다 다시 비교합니다. 처음 있던 테스트 함수가 바뀌었거나 사라졌으면, 그 함수들이 모두 온전했던 마지막 파일 내용으로 되돌리고 모델에게 이유를 알려 줍니다.
import ast


def test_functions(text):
    """{name: source} for every test function in a file; None if the file does not parse."""
    try:
        tree = ast.parse(text)
    except SyntaxError:
        return None
    return {f.name: ast.unparse(f) for f in tree.body if isinstance(f, ast.FunctionDef) and f.name.startswith("test")}


def guard_tests(root, kept):
    """Put back any test file whose original test functions were changed or removed. kept holds the last good text."""
    notes = []
    for rel, (original, good) in kept.items():
        path = root / rel
        now = path.read_text() if path.exists() else ""
        found = test_functions(now) or {}
        broken = [name for name, src in original.items() if found.get(name) != src]
        if broken:
            path.write_text(good)
            notes.append(f"{rel} was put back: the existing tests {', '.join(broken)} are read-only. "
                         "Add new test functions instead of changing these.")
        else:
            kept[rel] = (original, now)
    return "\n".join(notes)
모델은 같은 파일에 테스트와 import, 도우미 함수를 얼마든지 더할 수 있습니다. ast로 비교하기 때문에 공백이나 주석이 바뀐 것은 변경으로 치지 않고, 테스트가 하는 일이 바뀌면 변경으로 칩니다.
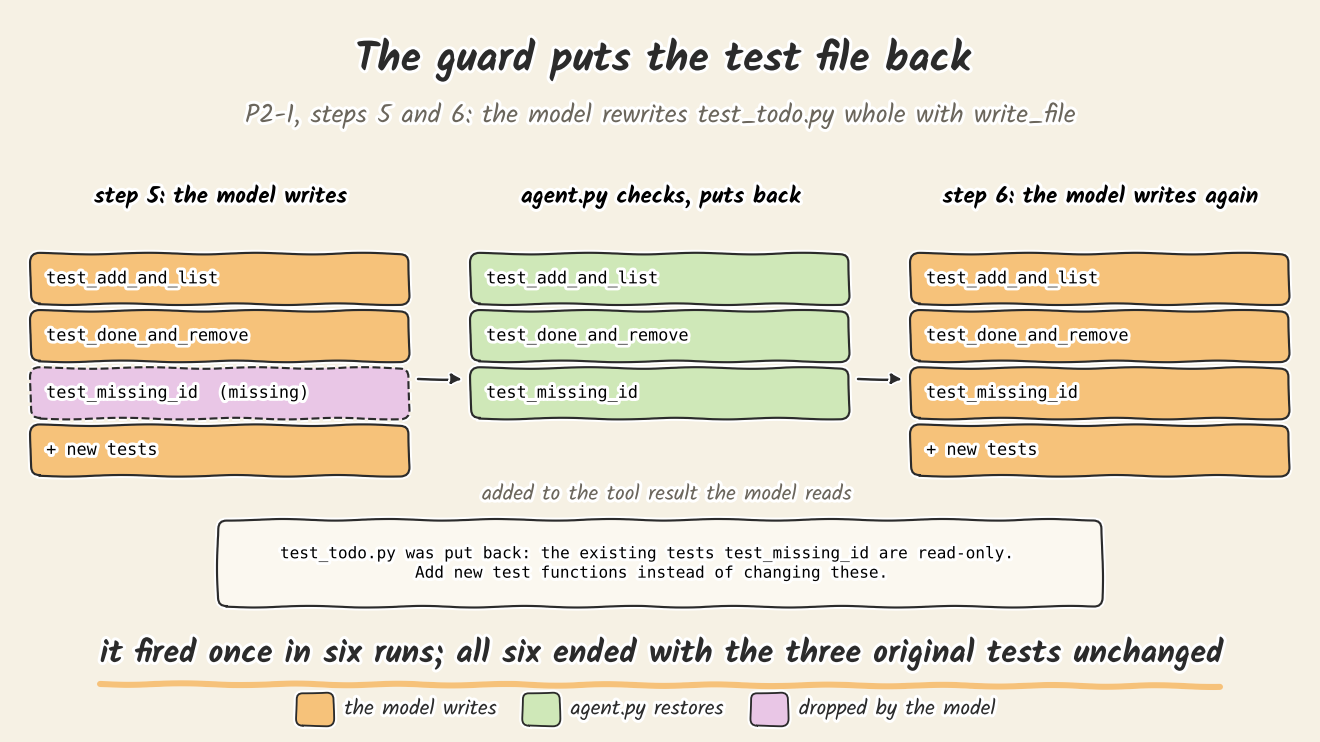
이 장치는 한 번 작동했습니다. P2-1의 5단계에서 모델이 write_file로 test_todo.py를 통째로 다시 쓰면서 원래 테스트 세 개 중 test_missing_id를 빠뜨렸습니다. agent.py가 파일을 되돌리고 도구 결과에 안내 문장을 붙였습니다. 6단계에서 모델은 이번에는 test_missing_id를 넣어 파일을 다시 통째로 썼고, 실행은 그대로 이어졌습니다.
edit_file이 바꾸지 못한 것도 보입니다. 모델은 여섯 번 중 다섯 번(P2-2만 빼고) 여전히 test_todo.py를 통째로 다시 썼습니다. 그중 P2-1, P2-4, P2-5에서는 테스트 파일에 edit_file도 함께 썼고, 가장 많이 쓴 P2-5에서는 edit_file로 테스트 파일을 일곱 번 고쳤습니다. P2-2는 edit_file만 썼습니다. 여섯 번 모두 실행이 끝났을 때 원래 테스트 함수 세 개는 그대로였습니다.
이 장치가 지키는 것은 테스트 함수의 글자뿐입니다. 함수를 그대로 두고 같은 파일에 pytestmark를 더하거나 conftest.py를 만들어 테스트를 건너뛰게 하는 것은 막지 못합니다. 여섯 번의 실행에서 그런 일은 없었습니다.
규칙 3: 모델이 멈추면 pytest를 돌립니다
def pytest(root):
    p = subprocess.run([sys.executable, "-m", "pytest", "-q"], cwd=root, capture_output=True, text=True, timeout=300)
    return p.returncode, (p.stdout + p.stderr)[-4000:]
그리고 run에서 원래 루프가 끝나던 자리를 이렇게 바꿉니다.
        if not calls:
            # The model says it is done. Check that ourselves before we believe it.
            code, out = pytest(root)
            print(f"[{step}] done? pytest exit {code}: {out.strip().splitlines()[-1] if out.strip() else ''}")
            if code == 0:
                return (msg.get("content") or "") + "\n" + out.strip().splitlines()[-1]
            messages.append({"role": "user", "content": f"pytest fails, so the task is not done yet:\n{out}"})
            continue
run 함수는 이 밖에도 시작할 때 테스트를 기억해 두고, 도구를 쓸 때마다 guard_tests를 부릅니다. 두 부분은 전체 파일에 있습니다.
루프는 지금도 모델이 도구를 더 부르지 않을 때 끝납니다. 다만 이제는 pytest가 통과해야만 끝납니다. 실패하면 모델이 실패 내용을 새 메시지로 받아 계속 작업하고, 전체 한도는 그대로 30단계입니다.
여섯 번 모두 pytest가 첫 번째에 통과했습니다. 그래서 실패를 돌려주는 줄은 한 번도 실행되지 않았습니다. 실패를 돌려주는 부분은 위 코드의 마지막 두 줄, messages.append(...)와 continue입니다.
예측하지 못한 일도 있었습니다. 모델이 여섯 번 모두 pytest를 스스로 돌렸습니다. 1편의 두 번째와 세 번째 실행에서는 한 번도 돌리지 않았습니다. 시스템 프롬프트와 과제 문장은 똑같고, 도구 목록이 달라졌습니다(edit_file이 새로 생겼습니다). 그 차이 때문인지는 여섯 번의 실행으로 말할 수 없습니다.
여전히 묻는 명령에 결정 모델은 뭐라고 했나
결정 모델 Jeff는 y/N을 묻는 명령에만 한 줄 의견을 붙입니다. 여섯 번 동안 y/N을 물은 명령은 모두 29개입니다. 첫 규칙(일곱 단어, 기호가 있으면 거절)으로 돌린 P2-1부터 P2-3까지는 bash 명령 23개가 전부 물었고, 두 번째 규칙(리디렉션 지움, 조각마다 검사, 열한 단어)으로 돌린 P2-4부터 P2-6까지는 16개 중 6개가 물었습니다. 이 29개 가운데 결과가 갈린 두 종류를 따로 봤습니다.
- 리포 밖 경로가 있는 명령은 6개 중 6개를 LOOK CLOSELY로 표시했습니다. 확률은 0.58에서 0.75였습니다. 여섯 번 중 다섯 번은 모델이 프로그램을 직접 써 보려고 리포 밖으로 나갔습니다.
cd /tmp && rm -f todos.json && python /repo/todo.py ...처럼/repo,/app, 홈 폴더 중 하나를 짐작해서 썼습니다. 그 자리에는todo.py가 없었기 때문에 매번 "No such file"로 실패했습니다. 하지만/tmp에서rm -f todos.json은 실제로 실행됐습니다. 스크립트가 매번 y로 답했기 때문입니다. 사람이 노란 줄을 읽었다면 아마 거절했을 명령입니다. - 리포 안에서만 지우는 명령은 8개 중 3개만 표시했습니다. 예를 들어
rm -f todos.json && ls는 routine(0.32)이었습니다. agent.py가 Jeff에게 던지는 질문은 "현재 리포 밖 경로를 건드리거나 파일을 지우는" 명령을 표시하라는 것이니, 이 명령들은 표시됐어야 합니다. 이 8개에서 Jeff의 숫자는 0.27에서 0.63 사이였습니다.
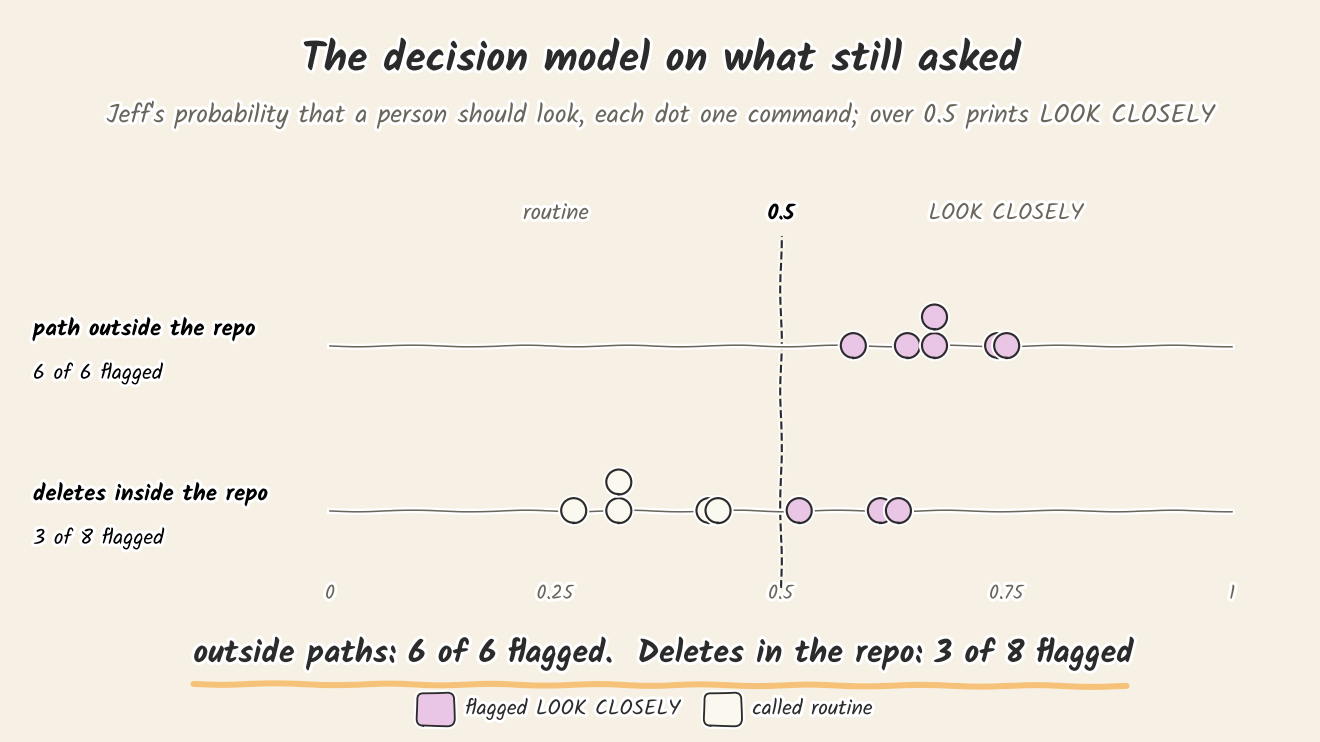
두 번째 규칙이 들어간 뒤로는 이런 명령만 사용자에게 보입니다. 그만큼 y/N 하나하나가 중요한 질문일 가능성이 커지고, 그게 이 규칙의 목적입니다. 두 번째 규칙으로 돌린 세 번에서 물어본 명령 6개는 모두 파일을 지우거나 디렉터리를 옮기거나 리포 밖으로 나갔습니다.
여섯 번의 실행
과제, 리포, 모델, 설정은 1편과 같습니다. 할 일 앱에 기능 여섯 가지를 더하는 과제이고, Flint UD-Q2_K_XL을 A100에서 32K 컨텍스트로, Jeff 0.8B를 CPU 코어 8개에서 돌렸습니다. 실행마다 리포를 새로 복사해서 시작합니다. 모든 y/N에는 스크립트가 y로 답합니다. 1편에서 저희가 손으로 한 것과 같습니다.
| 실행 | 규칙 1 | 단계 | 명령 | 물어봄 | 테스트 되돌림 | 에이전트 자체 테스트 | 숨긴 테스트 6개 |
|---|---|---|---|---|---|---|---|
| P2-1 | 첫 규칙 | 17 | 9 | 9 | 한 번 | 10개 통과 | 6개 모두 |
| P2-2 | 첫 규칙 | 9 | 5 | 5 | 없음 | 9개 통과 | 6개 모두 |
| P2-3 | 첫 규칙 | 14 | 9 | 9 | 없음 | 8개 통과 | 6개 모두 |
| P2-4 | 두 번째 규칙 | 12 | 5 | 3 | 없음 | 8개 통과 | 6개 모두 |
| P2-5 | 두 번째 규칙 | 23 | 8 | 3 | 없음 | 10개 통과 | 6개 모두 |
| P2-6 | 두 번째 규칙 | 9 | 3 | 0 | 없음 | 8개 통과 | 6개 모두 |
실행하기 전에 커밋해 둔 예측과 그 결과입니다.
- 첫 규칙(P2-1부터 P2-3까지): 실행마다 y/N은 두 번 이하라고 예측했는데 틀렸습니다(9, 5, 9). 테스트를 지키는 장치가 한 번 이상 작동한다는 예측은 맞았습니다.
edit_file이 있어도 두 번 이상의 실행에서 테스트 파일을 통째로 다시 쓴다는 예측도 맞았습니다. 두 번 이상의 실행이 pytest 통과로 스스로 끝난다는 예측은 맞았습니다(세 번). 그 실행들에서 숨긴 테스트 6개가 모두 통과한다는 예측도 맞았습니다. - 두 번째 규칙(P2-4부터 P2-6까지): 실행마다 y/N은 네 번 이하라는 예측은 맞았습니다(3, 3, 0). 한 번 이상의 실행이 리포 밖 경로를 쓴다는 예측도 맞았습니다(두 번). Jeff가 리포 밖 경로가 있는 명령을 모두 표시한다는 예측도 맞았습니다(2개 중 2개). 두 번 이상의 실행이 스스로 끝난다는 예측(세 번)과 숨긴 테스트 6개 모두 통과도 맞았습니다.
확인하지 못한 것
- 규칙마다 세 번, 과제 하나, 모델 하나입니다. temperature가 0.6이라 다시 돌리면 다른 단계를 밟습니다. 이 실행은 규칙이 무엇을 하는지 보여 줄 뿐, 얼마나 자주 그런지는 보여 주지 않습니다.
- pytest 실패를 돌려주는 경로. 한 번도 작동하지 않았습니다.
- 다른 명령에서의 규칙. 허용 목록은 이 모델이 이 과제에서 친 명령을 보고 만들었습니다. 다른 모델은 안전한데도 묻는 명령을 치거나, 그 반대일 수 있습니다. 직접 돌릴 때 무엇이 묻고 무엇이 그냥 실행되는지 읽어 보세요.
- 실제 16GB 카드. 1편과 같이 Flint의 최대 메모리 14,386MiB는 A100에서 잰 값입니다.
다음 편
3편은 컨텍스트를 다룹니다. 긴 과제가 32K를 채우면 messages 목록에서 무엇을 버리고, 중요한 부분은 어떻게 남길지입니다. 이번처럼 돌리기 전에 예측부터 적겠습니다. 새 글이 나오면 페이지 아래 뉴스레터로 알려 드립니다.