8GB GPU에서 멀티모달 모델 돌리는 법: LFM3 네 모델 모두 가장 많이 쓸 때도 5GiB 이하로 사용했습니다
LiquidAI의 LFM3 텍스트·이미지·음성·Omni 모델 네 개를 llama.cpp로 띄우는 방법을 모델별로 정리했습니다. 각 모델을 최대 context로 띄우고 이미지·음성(텍스트 모델은 긴 프롬프트)을 넣었을 때 가장 많이 쓴 메모리는 3.7-4.8GiB였고, 8GB 카드에서 쓸 수 있는 메모리 안에 들어갑니다(A100에서 측정). 짧게 두 번 띄워 내 카드에 맞는 context를 가늠하는 방법과, VL 모델이 생각하느라 답을 비워 돌려주는 함정도 다룹니다.
8GB GPU에서 멀티모달 모델 돌리는 법: LFM3 네 모델 모두 가장 많이 쓸 때도 5GiB 이하로 사용했습니다
LiquidAI가 LFM3를 공개했습니다. 휴대폰과 노트북에서 돌리는 것을 목표로 만든 소형 모델 제품군인데요, 글을 읽고 쓰는 텍스트 모델 LFM3-1.7B에 더해 이미지를 보는 VL, 음성을 듣고 말하는 Audio, 이미지와 음성을 함께 다루는 Omni까지 나왔습니다. 세 멀티모달 모델의 이름에는 2B가 붙어 있습니다.
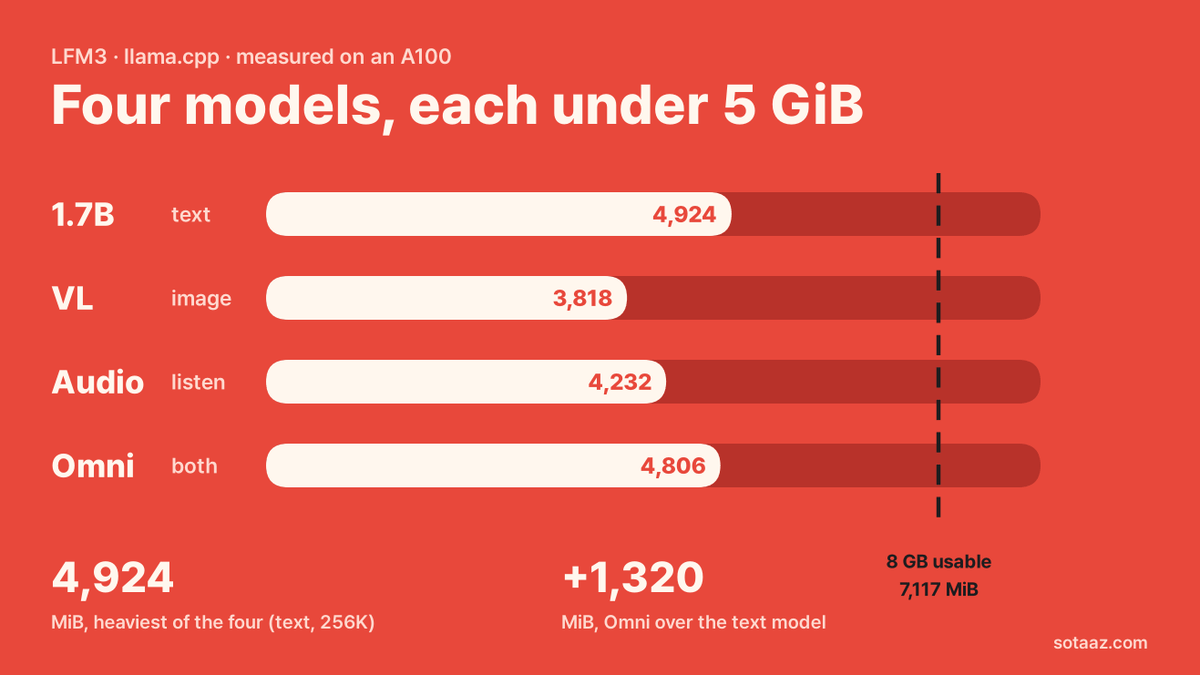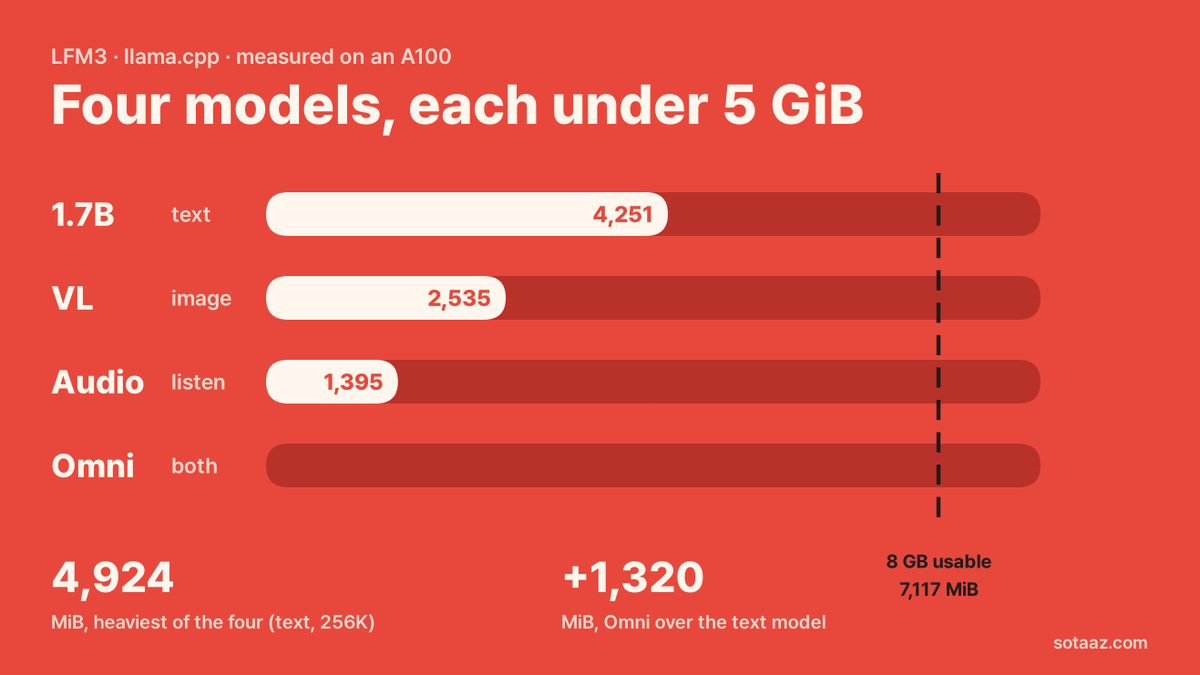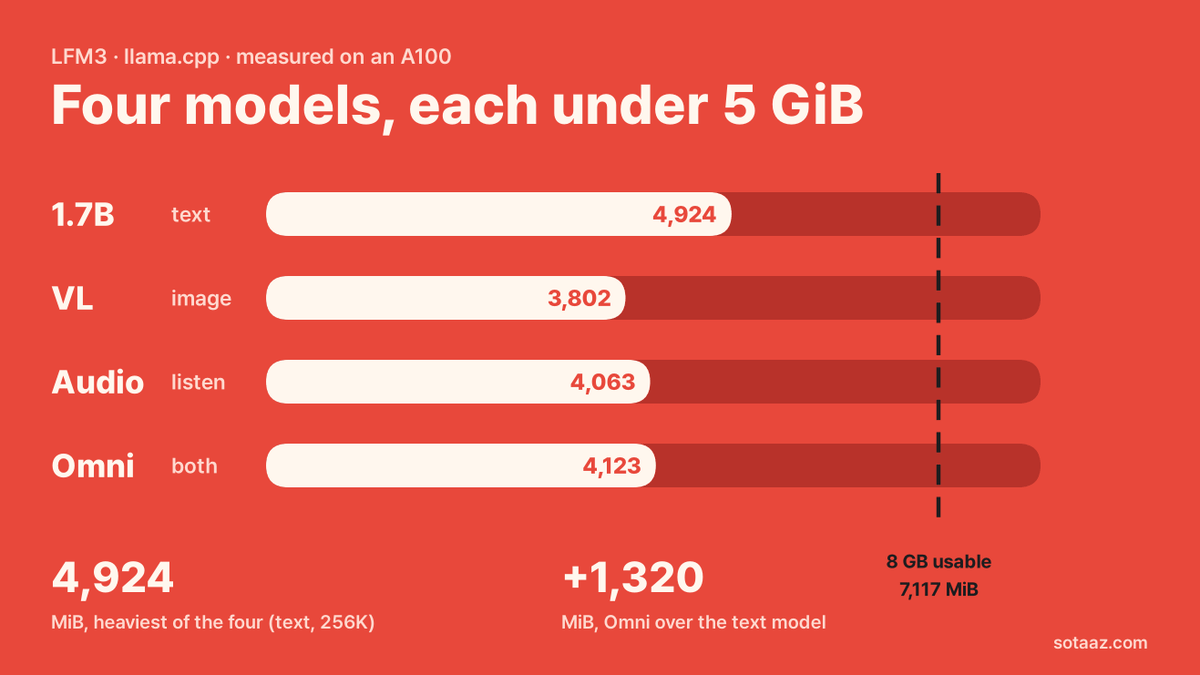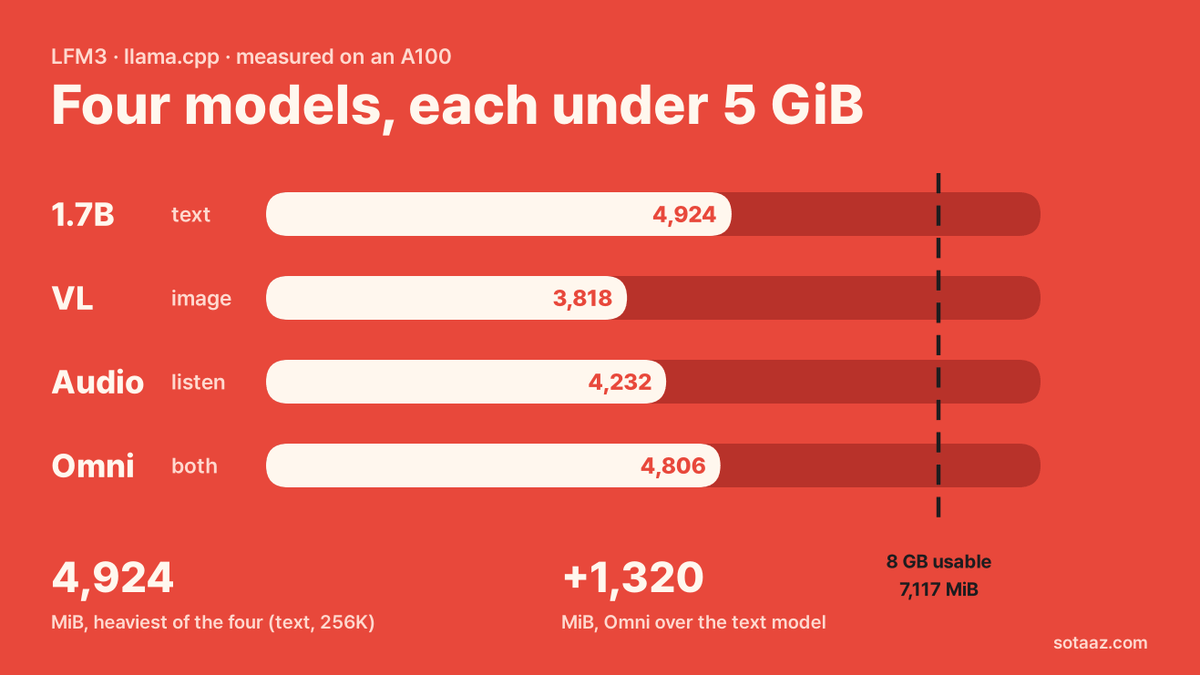
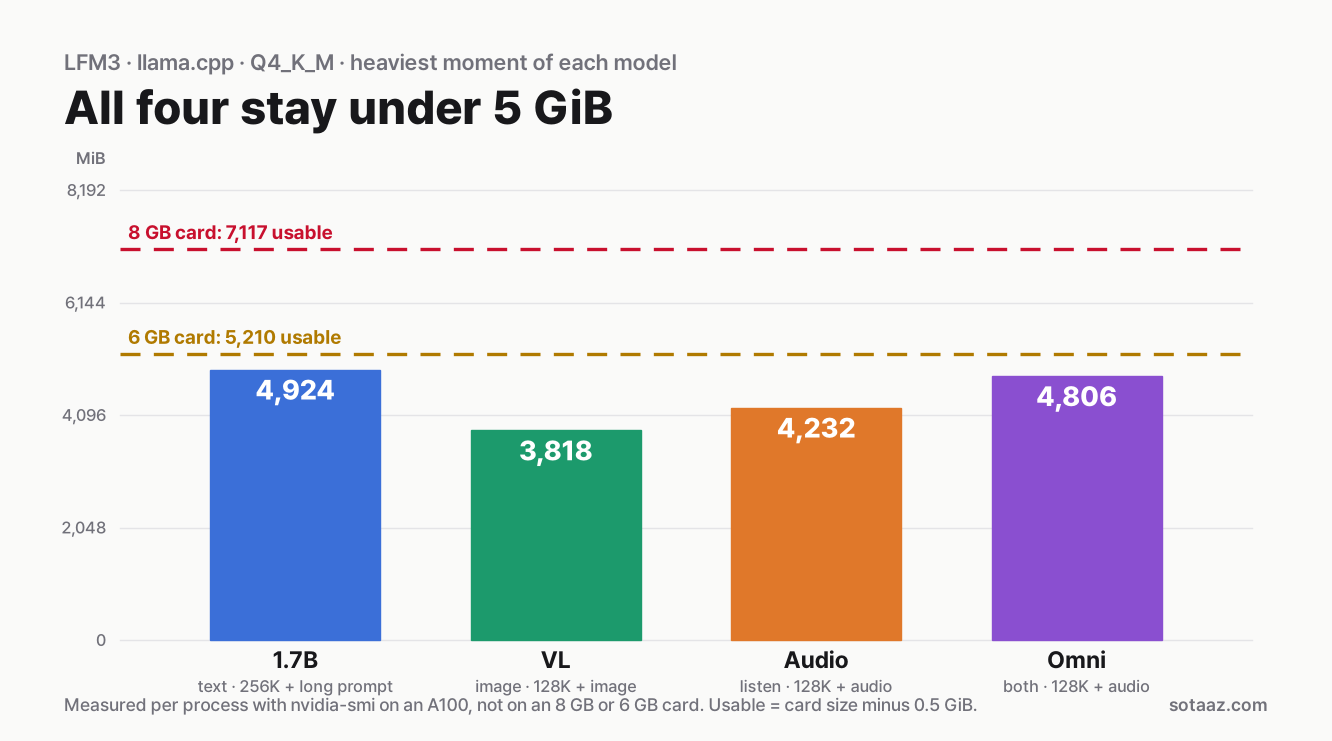
그렇다면 8GB GPU 하나로 이 네 모델을 다 돌릴 수 있을까요? 저희는 네 모델을 llama.cpp로 각각 최대 context로 띄우고, 이미지와 음성을 넣어 가며 GPU 메모리를 쟀습니다. context는 모델이 한 번에 읽을 수 있는 토큰 길이입니다. 가장 많이 쓴 경우도 4,924MiB(4.8GiB)였습니다. 8GB 카드에서 데스크톱 몫을 빼고 쓸 수 있는 메모리(약 6.95GiB) 안에 넷 다 들어갑니다. 다만 8GB 카드에서 직접 돌린 것이 아니라 A100에서 잰 값입니다.
의외였던 것은 가장 무거운 쪽이 이미지·음성을 다 받는 Omni가 아니라 텍스트 모델이었다는 점입니다. 텍스트 모델은 최대 context가 두 배 길기 때문입니다. 같은 context에서 비교하면 멀티모달 모델은 텍스트 모델보다 568-1,320MiB를 더 씁니다. 로그로 나눠 보니 세 조각을 더한 값이 실측과 12MiB 안쪽으로 맞았습니다. mmproj 파일, mmproj 계산 버퍼, 그리고 음성을 받는 두 모델에서만 커지는 텍스트 쪽 계산 버퍼입니다.
이 글은 네 모델을 띄우는 순서를 모델별로 정리하고, 각 모델이 메모리를 얼마나 쓰는지, 짧게 두 번 띄워 그 메모리를 가늠하는 방법을 설명합니다.
준비할 것
- NVIDIA GPU 8GB. 네 모델 모두 최대 context에 이미지·음성까지 넣어도 들어갑니다. 6GB 카드도 메모리 합으로는 들어갑니다. 다만 네 모델 모두 llama-server가 시작할 때 비워 두려는 양보다 적게 남고, 그 상태로 띄우는 것은 시험하지 않았습니다(아래 카드별 표 참고). A100에서 잰 값을 카드별 메모리와 비교한 것이고, 작은 카드에서 직접 돌려 보지는 않았습니다.
- llama.cpp b11960 이상. 모델 카드가 LFM3를 지원하는 첫 빌드로 b11960을 적어 두었습니다. 저희는 b11976을 썼습니다.
- Ollama와 LM Studio. VL과 Omni의 모델 카드에는 Ollama가 macOS용으로만 나와 있고, LM Studio는 이미지 입력만 지원한다고 적혀 있습니다. Audio 모델 카드에는 두 앱이 나오지 않습니다. 저희는 둘 다 써 보지 않았고, 이 글은 llama.cpp로 진행합니다.
판정용으로 따로 나온 d1 모델과 base 모델은 이 글에서 다루지 않습니다.
1단계: llama.cpp 받기
Windows에서는 llama.cpp 릴리스 페이지에서 llama-b11976-bin-win-cuda-12.4-x64.zip(또는 더 새 빌드)을 받아 압축을 풉니다. 아래 명령의 ./build/bin/llama-server는 압축을 푼 폴더의 llama-server.exe로 바꿔 실행합니다.
Linux용으로는 llama-b11976-bin-ubuntu-cuda-12.8-x64.tar.gz가 있습니다. 다만 저희 Ubuntu 22.04 서버에서는 이 파일이 실행되지 않았습니다. GLIBC_2.38 not found와 GLIBCXX_3.4.32 not found 오류가 나고 서버가 아예 뜨지 않았습니다. 이 파일은 C 라이브러리(glibc) 2.38 이상과 더 새 C++ 표준 라이브러리를 요구하는데, 22.04에는 2.35가 들어 있습니다. Ubuntu 24.04에는 2.39가 들어 있지만 저희가 24.04에서 돌려 보지는 않았습니다. 22.04라면 소스에서 빌드합니다. GPU 드라이버만으로는 부족하고 CUDA toolkit(nvcc), cmake, C++ 컴파일러가 있어야 합니다.
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
git checkout b11976
cmake -B build -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES=80 -DCMAKE_BUILD_TYPE=Release -DLLAMA_CURL=OFF
cmake --build build -j --target llama-server llama-cli llama-ttsllama-tts는 음성을 만드는 프로그램이라 Audio와 Omni를 쓸 때만 필요합니다. -DCMAKE_CUDA_ARCHITECTURES=80은 저희 A100에 맞춘 값입니다. 내 카드에서 빌드할 때는 이 옵션을 빼면 cmake가 장착된 GPU에 맞춰 빌드합니다. 이렇게 뺀 빌드는 저희가 해 보지 않았습니다. 서버 시작 로그에 찍히는 빌드 번호(저희는 build 803 (2e0d86beb))는 릴리스 태그와 다르니, 태그는 git describe --tags로 확인합니다.
2단계: 모델 받기
멀티모달 모델은 파일이 두 개입니다. 하나는 텍스트를 만드는 본체이고, 다른 하나는 이미지나 음성을 모델이 읽을 수 있는 형태로 바꾸는 부품입니다. llama.cpp는 이 부품을 mmproj라고 부릅니다. 저희는 본체는 4비트 Q4_K_M, mmproj는 모델 카드의 음성 생성 예시가 쓰는 Q8_0을 받았습니다.
python3 -m venv hf-env
. hf-env/bin/activate
pip install -U huggingface_hub
hf download LiquidAI/LFM3-1.7B-GGUF LFM3-1.7B-Q4_K_M.gguf --local-dir models
hf download LiquidAI/LFM3-VL-2B-GGUF LFM3-VL-2B-Q4_K_M.gguf mmproj-LFM3-VL-2B-Q8_0.gguf --local-dir models
hf download LiquidAI/LFM3-Audio-2B-GGUF LFM3-Audio-2B-Q4_K_M.gguf mmproj-LFM3-Audio-2B-Q8_0.gguf --local-dir models
hf download LiquidAI/LFM3-Omni-2B-GGUF LFM3-Omni-2B-Q4_K_M.gguf mmproj-LFM3-Omni-2B-Q8_0.gguf --local-dir models
필요한 모델만 받으면 됩니다. Ubuntu에서 python3 -m venv를 쓰려면 python3-venv 패키지가 필요합니다. 본체 파일은 네 모델 모두 1.10GB이고, mmproj는 VL 203MB, Audio 338MB, Omni 541MB입니다.
여기서 하나 알 수 있는 것이 있습니다. GGUF 메타데이터를 보면 세 "2B" 모델의 텍스트 부분 파라미터 수는 1,728,801,600개로 LFM3-1.7B와 같습니다. 층 구성도 같습니다. 이름의 2B는 mmproj까지 더한 크기로 보입니다. 그래서 아래에서 보듯, 멀티모달 모델의 메모리는 텍스트 모델 메모리에 mmproj 몫을 더한 값이 됩니다.
llama.cpp에 -hf LiquidAI/LFM3-VL-2B-GGUF:Q4_K_M처럼 주면 본체와 mmproj를 함께 내려받기도 합니다. 하지만 HTTPS 지원을 넣고 빌드했을 때만 됩니다. 저희 소스 빌드는 서버에 OpenSSL 헤더가 없어서 HTTPS 없이 빌드되었고, HTTPS is not supported 오류로 멈췄습니다. hf download로 받으면 이 문제를 피할 수 있습니다.
3단계: 텍스트 모델 LFM3-1.7B
./build/bin/llama-server -m models/LFM3-1.7B-Q4_K_M.gguf \
  -ngl 99 -c 262144 -fa on --parallel 1 \
  --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
--port 8080-c는 llama-server가 메모리를 미리 잡아 두는 context 길이, 즉 대화 하나가 담을 수 있는 프롬프트와 답의 최대 토큰 수입니다. -c 262144는 이 모델의 최대치(약 256K)를 쓰겠다는 뜻이고, -ngl 99는 모든 층을 GPU에 올리라는 뜻입니다. 측정은 -fa on(flash attention)과 --parallel 1을 넣고 했습니다. --parallel 1을 빼고 띄우자 이 빌드는 캐시 하나를 함께 쓰는 슬롯 4개를 열었고, 그 설정에서는 메모리를 재지 않았기 때문입니다. 작은 카드라면 -c를 낮추고, 시작 로그의 n_ctx와 common_fit_params 줄에서 실제로 잡힌 값을 확인합니다.
샘플링 값은 모델 카드가 대화·도구 호출·에이전트용으로 권하는 값이고, 저희 시험 질문이 대화형이라 이 값을 썼습니다. 모델 카드는 수학·과학 문제에는 --temp 1.0 --top-p 0.95 --top-k 20을 권하지만 이유는 적어 두지 않았습니다. 저희 추측은 이렇습니다. temperature가 낮으면 긴 추론에서 같은 말을 되풀이하기 쉽습니다. temperature를 높여 다른 풀이 길도 시도하게 하고, top-p와 top-k로 가능성이 낮은 토큰을 잘라 엉뚱한 쪽으로 새지 않게 하려는 설정으로 보입니다. 이 추측은 시험하지 않았습니다.
질문은 이렇게 보냅니다.
curl -s localhost:8080/v1/chat/completions -H 'Content-Type: application/json' -d '{
  "messages": [{"role": "user", "content": "In two sentences, what is a KV cache in an LLM?"}],
  "max_tokens": 4096
}'
이 모델은 답하기 전에 먼저 생각합니다. 처음 보낸 요청에는 max_tokens를 300으로 주었더니, 답 본문인 content가 빈 채로 돌아왔습니다. 300토큰을 모두 생각 과정(reasoning_content)에 쓰느라 답까지 가지 못한 것입니다. max_tokens를 4096으로 올리자 같은 질문에 412토큰을 쓰고 두 문장으로 답했습니다. 생각을 끄면 69토큰이었습니다. 질문 하나로 본 결과라 평소에 얼마나 더 쓰는지에 대한 측정은 아닙니다. 요청 하나에서 생각을 끄려면 요청 본문에 아래 줄을 넣습니다.
"chat_template_kwargs": {"enable_thinking": false}모델 카드는 이렇게 꺼도 "특히 추론이 많이 필요한 과제에서는 일관되지 않을 수 있다"고 적어 두었습니다.
서버 로그에서 알아 둘 줄이 하나 더 있었습니다. llama-server는 앞선 턴의 생각 과정을 대화에 그대로 남겨 두는 것이 기본값입니다(로그 문구: "may use more tokens, disable via --no-reasoning-preserve"). 모델 카드에 적힌 기본 동작은 반대입니다. 앞선 턴의 생각 과정은 preserve_thinking=True가 아니면 지운다고 나옵니다. 그래서 llama-server로 대화가 길어지면 남겨 둔 생각 과정도 context를 차지합니다. 얼마나 차지하는지는 재지 않았습니다.
4단계: 이미지를 보는 LFM3-VL-2B
./build/bin/llama-server -m models/LFM3-VL-2B-Q4_K_M.gguf \
  --mmproj models/mmproj-LFM3-VL-2B-Q8_0.gguf \
  -ngl 99 -c 128000 -fa on --parallel 1 \
  --temp 0.1 --top-p 1.0 --top-k 50 --min-p 0.0 --repeat-penalty 1.1 \
  --no-reasoning-preserve --port 8080
텍스트 모델과 다른 점은 --mmproj로 부품 파일을 함께 준다는 것입니다. 세 멀티모달 모델의 최대 context는 128,000토큰이라 -c 128000을 줍니다. 샘플링 값과 --no-reasoning-preserve는 모델 카드가 권하는 대로 넣었습니다.
이미지와 음성은 요청 본문에 base64 문자열로 담아 보냅니다. 파일이 조금만 커도 curl 명령줄에 다 들어가지 않아서, 저희는 짧은 Python 스크립트를 썼습니다. 파일 이름이 .wav로 끝나면 음성을, 아니면 PNG 이미지를 보냅니다.
# ask.py: python3 ask.py photo.png  또는  python3 ask.py speech.wav
import base64, json, sys, urllib.request

path = sys.argv[1]
data = base64.b64encode(open(path, "rb").read()).decode()
if path.endswith(".wav"):
    messages = [{"role": "system", "content": "Perform ASR in English."},
                {"role": "user", "content": [{"type": "input_audio", "input_audio": {"data": data, "format": "wav"}}]}]
else:
    messages = [{"role": "user", "content": [{"type": "image_url", "image_url": {"url": "data:image/png;base64," + data}},
                                             {"type": "text", "text": "Describe this image."}]}]
body = {"messages": messages, "max_tokens": 2048, "chat_template_kwargs": {"enable_thinking": False}}
req = urllib.request.Request("http://localhost:8080/v1/chat/completions", json.dumps(body).encode(),
                             {"Content-Type": "application/json"})
print(json.load(urllib.request.urlopen(req))["choices"][0]["message"]["content"])
저희 블로그의 메모리 그래프(1250×660 PNG)를 넣자 VL은 그래프 제목을 그대로 읽고 축과 선을 설명했습니다. 답의 품질은 채점하지 않았습니다.
VL도 기본으로 먼저 생각합니다. 스크립트의 enable_thinking: False 줄이 없으면 답이 비어 돌아올 수 있습니다. 저희 측정 요청은 생각을 켠 채 max_tokens를 1,024로 주었는데, 1,024토큰을 모두 생각에 쓰고 답은 비어 있었습니다. 한도를 모델 카드 예시처럼 16,384로 올리자 같은 그림 설명에 6,318토큰을 썼고, 생각을 끄면 103토큰이었습니다. 각각 한 번씩 돌린 결과입니다.
어느 쪽을 쓸지는 과제에 달려 있습니다. 모델 카드는 생각이 수학, 차트, 여러 단계를 거치는 시각 질문에 가장 도움이 된다고 적어 두었습니다. 그림을 간단히 설명하게 하는 정도라면 생각을 끄는 편이 빠르고 context도 덜 씁니다. 생각을 켠 채 쓴다면 max_tokens를 넉넉히 줍니다. 서버 전체에서 끄려면 --reasoning off를 붙입니다. 이 방법으로도 같은 103토큰 답이 나왔습니다.
5단계: 음성을 듣고 말하는 LFM3-Audio-2B
./build/bin/llama-server -m models/LFM3-Audio-2B-Q4_K_M.gguf \
  --mmproj models/mmproj-LFM3-Audio-2B-Q8_0.gguf \
  -ngl 99 -c 128000 -fa on --parallel 1 --temp 0 --port 8080
받아 쓰기(음성 인식)는 위 스크립트에 .wav 파일을 주면 됩니다. 모델 카드대로 system 메시지에 Perform ASR in English.를 넣었고, 언어를 모델이 알아서 정하게 하려면 Perform ASR.라고 씁니다. 저희 영상의 영어 내레이션 53초(16kHz wav)를 넣자 "The file is 4.68 gigs. Loaded with a 32k context, it took 9.44 on the card."로 시작하는 내레이션 대본을 단어 하나 빠짐없이 받아 적었습니다. 화면 자막은 이 양을 GiB·MiB·KiB로 적었지만, 내레이션은 "half a gig"(0.47GiB)처럼 말로 읽었습니다. 이 음성은 686토큰이 되었습니다. Audio 모델은 생각 없이 바로 받아 적었습니다.
음성을 만드는 것은 서버가 아니라 llama-tts가 합니다.
./build/bin/llama-tts -m models/LFM3-Audio-2B-Q4_K_M.gguf \
  -mm models/mmproj-LFM3-Audio-2B-Q8_0.gguf -ngl 99 \
  -p "The file is 4.68 GiB. Loaded with a 32K context, it took 9.44 GiB on the card." \
  -o out.wav
24kHz wav 파일이 9초 길이로 나왔습니다. 모델 카드에 따르면 --tts-voice male로 남자 목소리를, --tts-lang으로 언어를 고를 수 있습니다. 저희는 기본값(여자 목소리, 영어)만 썼습니다.
만든 음성을 다시 Audio 모델에 넣어 받아 적게 해 봤습니다. 단어는 맞게 나왔지만 숫자가 깨졌습니다. "4.68 GiB"가 "4CHGB"로, "9.44 GiB"가 "9 more 4GB"로 받아 적혔습니다. 같은 숫자가 든 영상 내레이션은 숫자를 제대로 받아 적었습니다. 하지만 내레이션은 목소리가 다르고 단위도 "gigs"처럼 읽은 음성이었습니다. 음성을 만드는 쪽이 틀렸는지, 받아 적는 쪽이 "GiB"를 못 알아들었는지는 이것만으로 가릴 수 없습니다. 저희가 들어서 확인하지는 않았고, 한 문장으로 본 것입니다. 숫자가 중요한 문장이라면 만든 음성을 직접 들어 보기를 권합니다.
6단계: 둘 다 하는 LFM3-Omni-2B
./build/bin/llama-server -m models/LFM3-Omni-2B-Q4_K_M.gguf \
  --mmproj models/mmproj-LFM3-Omni-2B-Q8_0.gguf \
  -ngl 99 -c 128000 -fa on --parallel 1 --reasoning off --temp 0 --port 8080
모델 카드는 Omni가 생각하지 않는 모델이라며 --reasoning off를 붙이라고 적어 두었습니다. 같은 ask.py로 이미지와 음성을 둘 다 보낼 수 있습니다. 같은 그래프는 제목을 읽고 설명했고, 같은 내레이션은 Audio와 글자 하나 다르지 않게 받아 적었습니다. 음성 만들기도 위 llama-tts 명령에서 파일 이름만 Omni로 바꾸면 됩니다. 저희가 만든 음성은 8초 길이였습니다. 이 음성을 Audio 모델에 받아 적게 하자 숫자 부분이 Audio 때와는 다른 모양으로 깨졌습니다("4.68 GiB"가 "4-set show, GB"로).
모델 카드에는 영상 입력과 실시간 음성 대화(/v1/realtime) 기능도 나와 있지만, 이 글에서는 시험하지 않았습니다.
모델별 메모리
각 모델을 context 길이 세 가지로 두 번씩 띄우고, 띄운 지 3초 뒤 nvidia-smi에서 서버 프로세스가 쓰는 메모리를 읽었습니다. 두 번의 값은 모든 경우에 같았습니다. 그다음 최대 context로 띄운 서버에 이미지나 음성을 보내고, 처리하는 동안 0.2초마다 읽은 최댓값을 적었습니다. 텍스트 모델은 이미지 대신 249,036토큰짜리 긴 프롬프트를 보냈습니다.
| 모델 | 4K로 띄움 | 32K로 띄움 | 최대 context로 띄움 | 입력을 넣었을 때 최댓값 |
|---|---|---|---|---|
| LFM3-1.7B | 1,638MiB | 2,002MiB | 4,914MiB (256K) | 4,924MiB (긴 프롬프트) |
| LFM3-VL-2B | 2,206MiB | 2,570MiB | 3,780MiB (128K) | 3,818MiB (이미지) |
| LFM3-Audio-2B | 2,384MiB | 2,748MiB | 3,956MiB (128K) | 4,232MiB (음성 53초) |
| LFM3-Omni-2B | 2,958MiB | 3,322MiB | 4,530MiB (128K) | 4,806MiB (음성 53초) |
음성 생성(llama-tts)은 서버와 따로 도는 프로그램이고, 가장 많이 쓸 때 Audio 3,974MiB, Omni 4,548MiB였습니다.
표를 보면 세 가지가 눈에 띕니다. 첫째, 4K에서 32K로 갈 때 네 모델이 모두 정확히 364MiB씩 늘었습니다. 텍스트 부분이 같은 모델이라 context가 늘 때 쌓이는 캐시도 같습니다. 둘째, 같은 context에서 멀티모달 모델은 텍스트 모델보다 일정한 양을 더 씁니다. VL 568MiB, Audio 746MiB, Omni 1,320MiB이고, context가 바뀌어도 이 차이는 1MiB 안에서 그대로였습니다. 셋째, 입력을 넣어도 이미지는 38MiB, 음성은 276MiB만 늘었습니다.
텍스트 모델이 계산보다 훨씬 적게 쓰는 이유
흔히 쓰는 VRAM 계산 방식에 LFM3-1.7B를 넣으면 최대 context에서 13.0GiB가 나옵니다. 12GB 카드에도 안 들어간다는 답입니다. 실제는 4,914MiB(4.8GiB)였습니다.
| context | 계산값 | 실측 | 차이 |
|---|---|---|---|
| 4,096 | 1,241MiB | 1,638MiB | 계산이 397MiB 작음 |
| 32,768 | 2,585MiB | 2,002MiB | 계산이 583MiB 큼 |
| 131,072 | 7,193MiB | 3,250MiB | 계산이 3,943MiB 큼 |
| 262,144 | 13,337MiB | 4,914MiB | 계산이 8,423MiB 큼 |
계산값은 GGUF 파일 크기에, 24개 층 모두가 16비트 KV 캐시를 쌓는다고 보고 더한 값입니다. KV 캐시는 모델이 이미 읽은 토큰마다 key와 value를 저장해 두는 메모리입니다. 층 24개 × KV 헤드 4개 × 값 128개 × key·value 2개 × 2바이트를 곱하면 토큰당 48KiB가 됩니다.
그런데 LFM3는 24개 층 모두에 캐시를 쌓지 않습니다. 설정 파일을 보면 층 구성이 셋으로 나뉩니다. 짧은 convolution 층이 13개, 바로 앞 256토큰만 보는 sliding window attention 층이 5개, 전체 토큰을 보는 global attention 층이 6개입니다. 모든 토큰을 저장하는 것은 global 층 6개뿐이라 토큰당 12KiB이고, 계산값의 4분의 1입니다. llama-server 로그도 같았습니다. KV 캐시가 32K에서 384MiB, 256K에서 3,072MiB였습니다. sliding window 층의 캐시는 길이와 상관없이 7.5MiB, convolution 층의 상태는 0.61MiB로 고정이었습니다. 세 멀티모달 모델도 같은 층 구성이라 128K에서 KV 캐시가 똑같이 1,500MiB였습니다.
context가 짧을 때 계산값이 오히려 작은 이유는 따로 있습니다. 계산 방식이 두 가지를 빼먹기 때문입니다. 하나는 llama.cpp가 계산 중간값을 담아 두는 계산 버퍼(compute buffer)입니다(4K에서 66MiB, 256K에서 318MiB). 다른 하나는 nvidia-smi에는 잡히지만 서버 로그 어디에도 나오지 않는 477MiB입니다. CUDA가 GPU를 쓰려고 미리 잡아 두는 메모리가 대부분일 것으로 보지만, 더 나눠 보지는 않았습니다. 짧게 두 번 띄워 -c를 정하는 방법을 다룬 앞 글에서 다른 모델 세 개를 쟀을 때도 이 몫이 476-481MiB로 비슷했습니다.
모델 카드는 4비트로 줄인 LFM3-1.7B가 메모리를 약 1GB 쓴다고 소개합니다. 이 값은 가중치 크기와 맞습니다. 파일이 1.10GB(1,049MiB)입니다. 서버로 띄우면 여기에 KV 캐시, 계산 버퍼, 로그에 없는 477MiB가 더해져 4K에서도 1,638MiB가 됩니다.
멀티모달 모델의 메모리를 가늠하는 법
내 카드에서 쓸 수 있는 가장 긴 -c를 찾을 때는 이렇게 합니다.
- 멀티모달 모델을
--mmproj까지 붙여 짧게 두 번 띄우고 직선을 긋습니다. 4K와 32K에서 잰 두 값을 이어 128K를 계산하면 VL 3,779MiB, Audio 3,957MiB, Omni 4,531MiB입니다. 실측은 3,780MiB, 3,956MiB, 4,530MiB로 1MiB 차이였습니다. 텍스트 모델도 같은 방법으로 128K 3,250MiB, 256K 4,914MiB를 맞혔습니다. 앞 글에서 쓴 방법입니다. - 실제 입력 하나를 넣어 늘어나는 양을 더합니다. 저희 그림은 38MiB, 53초 음성은 276MiB를 더했습니다. 이 값은 그림 크기와 음성 길이에 따라 달라질 수 있으니, 내가 넣을 입력으로 한 번 확인합니다.
두 번 띄울 때 --mmproj를 빼면 안 됩니다. 아래에서 보듯 mmproj 몫은 파일 크기보다 훨씬 큽니다.
텍스트 모델보다 더 쓰는 메모리를 나눠 보면
아래 표는 측정을 마친 뒤 로그를 보고 나눈 것입니다. 멀티모달 모델이 텍스트 모델보다 더 쓰는 양은 세 조각으로 나뉘었습니다.
| 모델 | mmproj 파일 | mmproj 계산 버퍼 | 텍스트 계산 버퍼 증가 | 합 | 실측 차이 |
|---|---|---|---|---|---|
| VL | 194MiB | 372MiB | 0 | 566MiB | 568MiB |
| Audio | 322MiB | 215MiB | 205MiB | 742MiB | 746MiB |
| Omni | 516MiB | 372 + 215MiB | 205MiB | 1,308MiB | 1,320MiB |
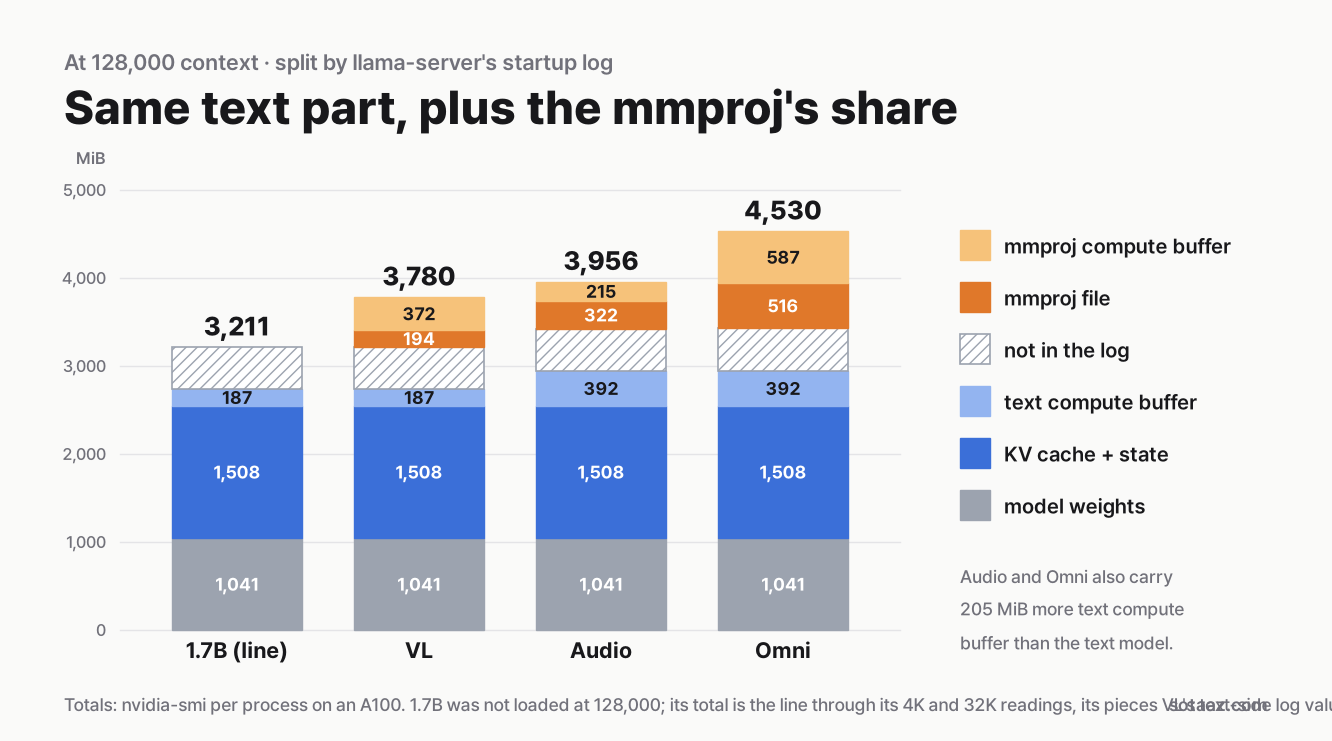
첫째 조각은 mmproj 파일 자체입니다. 파일 크기만큼 GPU에 올라갑니다. 둘째는 mmproj가 이미지나 음성을 처리할 때 쓰는 계산 버퍼입니다. 시작 로그의 reserve_compute_meta: CUDA0 compute buffer size 줄에 나오고, 이미지용은 372MiB, 음성용은 215MiB였습니다. 둘 다 다루는 Omni는 두 버퍼를 모두 잡았습니다.
셋째는 저희가 예상하지 못한 조각입니다. 텍스트 쪽 계산 버퍼는 sched_reserve: CUDA0 compute buffer size 줄에 나옵니다. 이 값은 텍스트 모델에도 원래 있는 몫이라, 같은 context의 텍스트 모델 값과 비교해 차이만 셉니다. 4K에서 텍스트 모델과 VL은 66MiB로 같았고, 음성을 받는 Audio와 Omni는 271MiB였습니다. 이 205MiB 차이는 context를 바꿔도 그대로였습니다.
시작 로그에는 [mtmd] estimated worst-case memory usage of mmproj 줄도 찍힙니다(VL 591MiB, Audio 540MiB, Omni 1,136MiB). 이름만 보면 mmproj 몫 전체 같지만, 음성 모델의 텍스트 계산 버퍼 증가 205MiB는 이 값에 들어 있지 않았습니다. 이 줄만 더하면 Audio와 Omni는 실제보다 적게 잡힙니다.
카드별로 어디까지 들어가는지
8GB 카드의 context 예산을 다룬 글과 같은 규칙을 씁니다. N GB로 팔리는 카드의 용량은 N × 10⁹바이트로 보고, 데스크톱과 드라이버 몫으로 0.5GiB를 남깁니다. 그렇게 남는 양이 4GB 카드는 3,303MiB, 6GB는 5,210MiB, 8GB는 7,117MiB입니다. 아래 표는 각 모델을 최대 context로 띄우고 입력을 넣었을 때의 최댓값을 기준으로 남는 메모리를 적은 것입니다.
| 카드 | LFM3-1.7B (256K) | VL (128K) | Audio (128K) | Omni (128K) |
|---|---|---|---|---|
| 8GB | 2,193MiB 남음 | 3,299MiB 남음 | 2,885MiB 남음 | 2,311MiB 남음 |
| 6GB | 286MiB 남음 | 1,392MiB 남음 | 978MiB 남음 | 404MiB 남음 |
| 4GB | 들어가지 않음 | 들어가지 않음 | 들어가지 않음 | 들어가지 않음 |
8GB 카드에서는 네 모델 모두 메모리가 먼저 차지 않고, 모델의 최대 context가 한계입니다. 이 카드들에서 직접 돌려 본 것은 아닙니다. A100에서 잰 값을 각 카드의 쓸 수 있는 메모리와 비교한 결과이고, 카드별 계산은 측정을 마친 뒤에 했습니다.
작은 카드라면 하나 더 볼 것이 있습니다. llama-server는 시작할 때 GPU 메모리를 일정량 비워 두도록 설정을 맞춰 봅니다(로그의 will leave ... >= N MiB 줄). 이 양은 모델마다 달라서 저희 로그에서는 1.7B 1,024MiB, VL 1,589MiB, Audio 1,561MiB, Omni 2,133MiB였습니다. 8GB 줄은 네 모델 모두 이보다 많이 남지만, Omni는 그 차이가 178MiB뿐입니다. 6GB 줄은 네 모델 모두 이보다 적게 남습니다. 그때 서버가 무엇을 바꾸는지는 시험하지 않았습니다. 4GB 카드는 직선으로 계산하면 context를 줄여야 들어갑니다(1.7B 약 13만 4천, VL 약 8만 7천, Audio 약 5만 4천, Omni 약 9천 토큰). 남는 메모리를 0으로 잡은 계산이라, 비워 두는 양까지 생각하면 더 줄여야 합니다.
측정 전에 세운 예측
텍스트 모델 측정과 멀티모달 측정 모두, 첫 실행 전에 예측을 정해 두었습니다. 텍스트 모델 예측 여섯 개(최대 context에서 6,000MiB 이하, 계산 방식이 7,000MiB 이상 크게 잡음 등)는 모두 맞았습니다. 멀티모달 예측은 다섯 개 중 네 개가 맞았습니다.
| 예측 | 결과 | |
|---|---|---|
| F1 | 128K에서 세 모델 모두 5,000MiB 이하 | 3,780 / 3,956 / 4,530MiB |
| F2 | 텍스트 모델보다 더 쓰는 양이 mmproj 파일 크기에서 그보다 400MiB 큰 값 사이 | VL 568MiB 맞음, Audio 746MiB·Omni 1,320MiB 틀림 |
| F3 | 4K에서 32K로 갈 때 346-382MiB 늘어남 | 세 모델 모두 364MiB |
| F4 | 이미지·음성을 넣어도 512MiB 넘게 늘지 않음 | 38MiB, 276MiB |
| F5 | llama-tts가 7,117MiB 이하 | 3,974 / 4,548MiB |
F2가 틀린 이유는 위에서 본 셋째 조각입니다. 저희는 mmproj 계산 버퍼만 생각해 400MiB를 여유로 잡았는데, Audio는 음성 쪽 텍스트 계산 버퍼 205MiB가 더해져 넘쳤고, Omni는 계산 버퍼를 두 개 잡아 더 크게 넘쳤습니다.
이 결과의 한계
- 8GB 카드가 아니라 A100에서 쟀습니다. 로그에 없는 477MiB(CUDA가 미리 잡아 두는 몫으로 보는 부분)는 GPU와 드라이버에 따라 다를 수 있습니다. 데스크톱이 쓰는 몫도 환경마다 다릅니다.
- 메모리만 쟀습니다. 속도와 답·받아 적기·음성의 품질은 재지 않았습니다. 답과 받아 적기 예시는 동작을 확인한 것이지 채점한 것이 아닙니다.
- 입력 하나씩만 넣었습니다. 그림 한 장(1250×660)과 영어 음성 하나(53초)입니다. 더 큰 그림이나 더 긴 음성은 입력을 넣었을 때 늘어나는 양이 다를 수 있습니다. 영상 입력과 실시간 음성 대화는 시험하지 않았습니다.
- 한국어는 시험하지 않았습니다. 모델 카드의 지원 언어 목록에는 한국어가 있습니다.
- 모델 카드의 벤치마크 점수는 LiquidAI가 잰 값이고, 저희가 다시 재지 않았습니다.
- 양자화 한 가지, 16비트 캐시 한 가지만 봤습니다. Q8_0 본체나 8비트 KV 캐시는 시험하지 않았습니다. 모델 카드가 권하는 QAD Q4_0 파일(Q4_0으로 줄일 때의 손실을 되찾도록 학습한 체크포인트)도 재지 않았습니다.
- 설치 함정 두 가지는 저희 서버 한 대에서 겪은 것입니다. Ubuntu 22.04와 HTTPS 문제는 더 새 시스템에서는 생기지 않을 수 있습니다.
다음에 해 볼 것
다른 멀티모달 모델로 내 카드에서 쓸 수 있는 가장 긴 -c를 찾고 싶다면, 그 모델을 --mmproj까지 붙여 짧게 두 번 띄워 직선을 긋고, 실제 입력 하나를 넣어 늘어나는 양을 더하면 됩니다. 실제 작업이 토큰을 얼마나 쓰는지(20턴 코딩 대화, 76쪽 PDF)는 8GB context 예산 글에 정리해 두었습니다.