Inkling 2 Mini, 12·16·24GB GPU에 들어가는 양자화와 -ub 128로 컨텍스트 두 배 늘리는 법
Inkling 2 Mini의 Unsloth Mainline_Support GGUF(Q2·Q3·Q4_K_XL)를 A100에서 llama.cpp b12611로 실행해 8·12·16·24GB 카드 예산과 대조했습니다. KV 캐시는 물리 24층이 아니라 루프 48회 방문 기준으로 정확히 할당됐고(32K 1,264 MiB), 계산 버퍼(32K 기본 3,356.2 MiB)를 -ub 128로 줄이면 12GB 43K(Q2), 16GB 41K(Q3), 24GB 121K(Q4)로 띄워 3만 토큰 프롬프트를 처리해도 예산 안에 남습니다. 4개 코딩 과제(16K)에서 Q2는 12GB 예산 안에서 0.975점을 기록했습니다(남은 여유 174 MiB).
Thinking Machines Lab 공식 모델 카드(Parameters·Required hardware 절)에 따르면 Inkling 2 Mini는 총 26.4B 파라미터(패스당 3.4B, 3회 루프 패스 기준 유효 5.4B 활성)이며, 약 20GB 공식 체크포인트 기준으로 32GB 이상 VRAM 또는 32GB 이상 Apple Silicon Mac을 권장합니다. 그런데 Unsloth가 공개한 GGUF 양자화 파일을 내려받으면 12GB·16GB·24GB 그래픽카드에도 올라가는지, 그리고 실사용에 필요한 32K 컨텍스트가 들어가는지가 궁금해집니다. 저희는 Unsloth Mainline_Support의 UD-Q2_K_XL, UD-Q3_K_XL, UD-Q4_K_XL 세 파일을 llama.cpp b12611로 직접 띄워 메모리 할당과 코딩 과제 통과율을 쟀습니다.
먼저 KV 캐시는 물리 층 수(24)가 아니라 루프 방문 수(48)로 계산해야 맞았습니다. 가운데 12개 층을 세 번 도는 구조라 32K 기준 KV가 1,264 MiB로 계산됐고, llama-server 실측 할당도 오차 0 MiB로 일치했습니다.
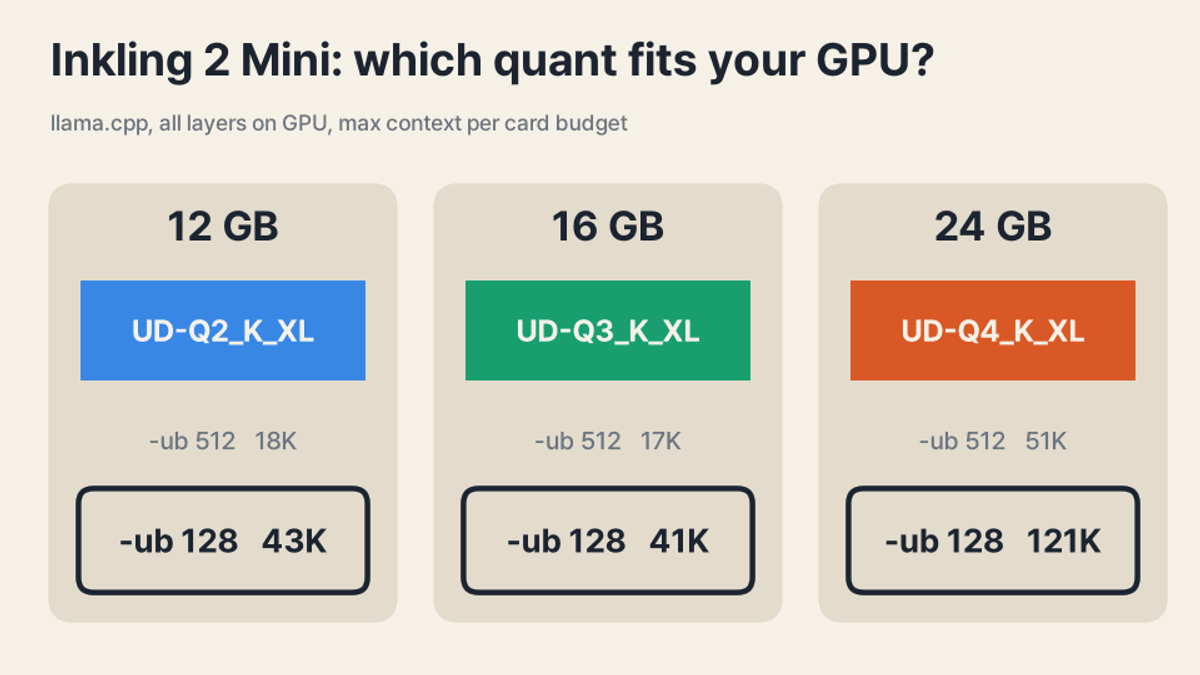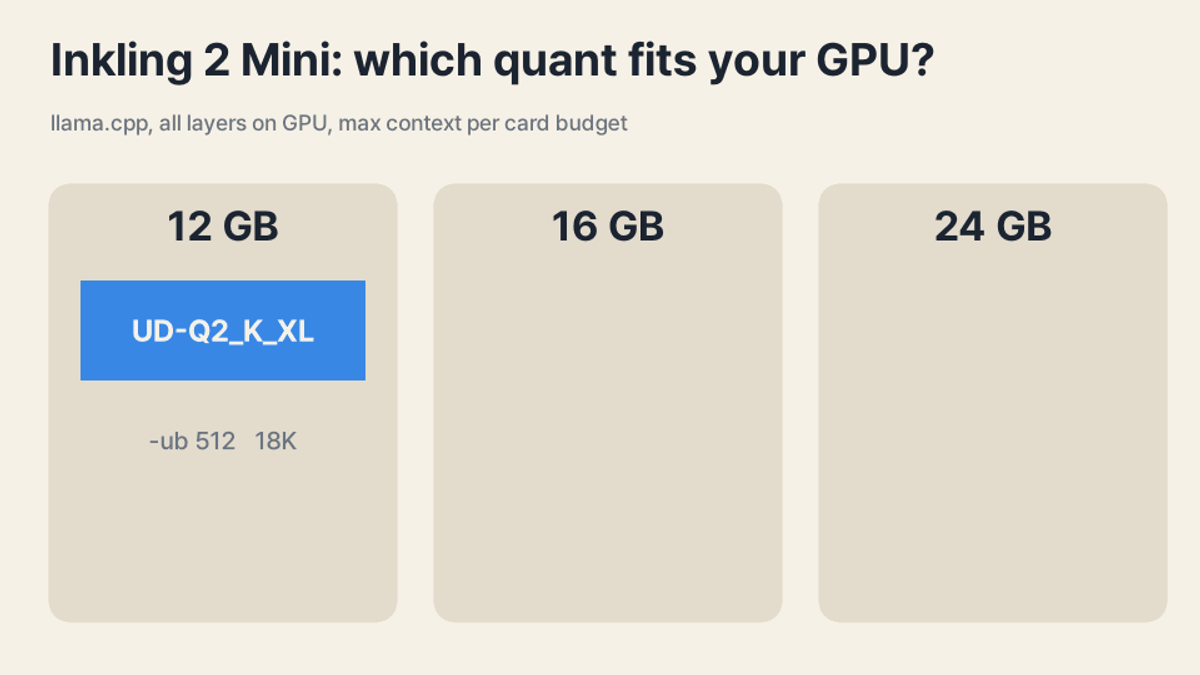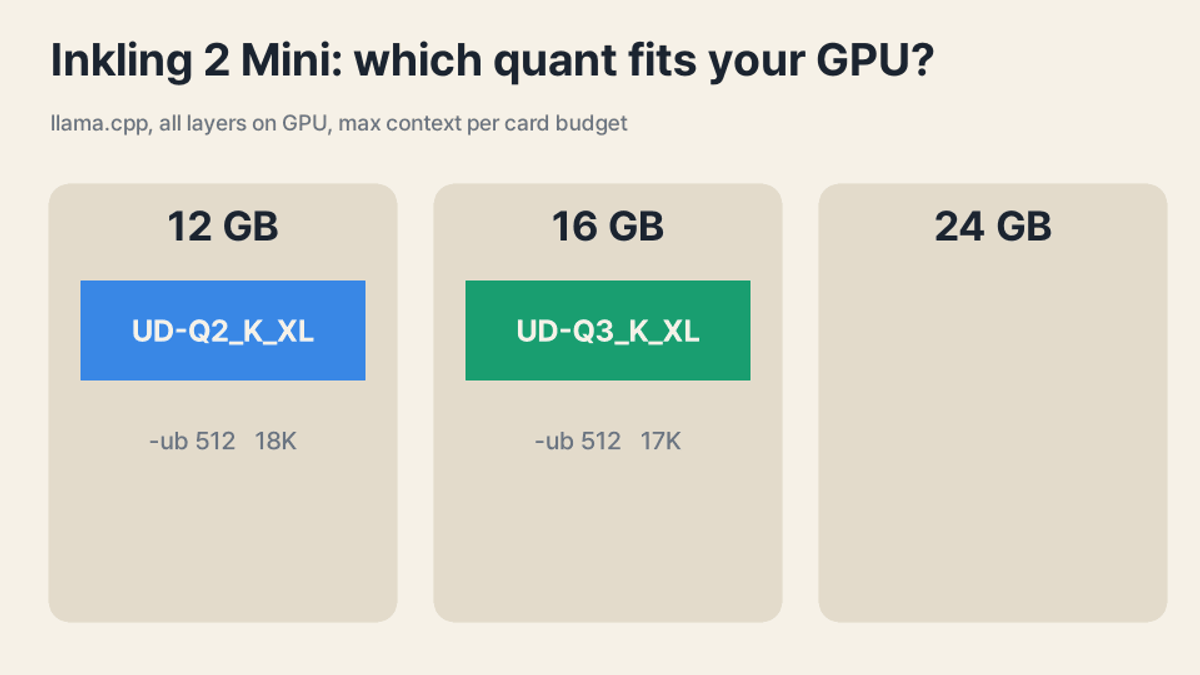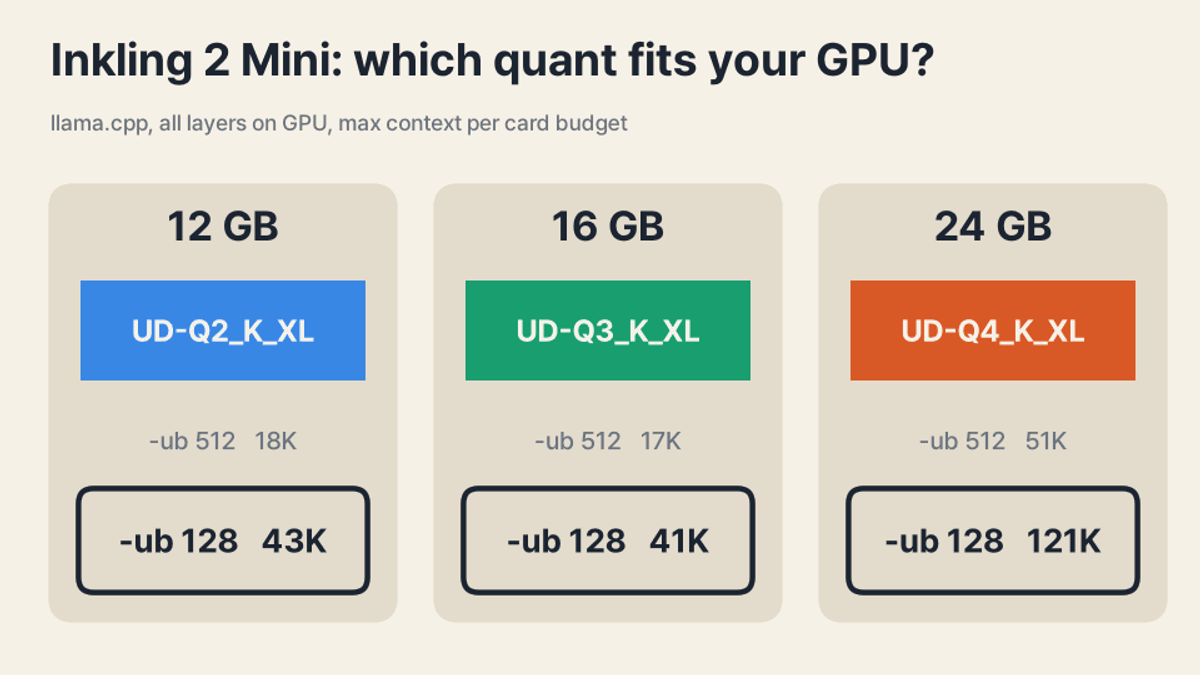
정작 컨텍스트를 키울 때 메모리를 더 많이 먹는 쪽은 CUDA 계산 버퍼였습니다. 32K 기본 설정(-ub 512)에서 계산 버퍼만 3,356.2 MiB를 차지하는데, -ub를 128로 낮추면 단계마다 거의 정확히 절반씩 줄어듭니다. 그 덕분에 해당 -c로 띄워 3만 토큰 프롬프트를 처리해도 12GB(Q2) 43K, 16GB(Q3) 41K, 24GB(Q4) 121K까지 예산 안에 남습니다.
코딩 실력도 Q2에서 크게 떨어지지 않았습니다. Python 코딩 과제 4개(16K, -ub 512)에서 Q2_K_XL은 12GB 예산(11,760 MiB) 안쪽인 최대 11,586 MiB(남은 여유 174 MiB)로 돌아 평균 0.975점을 받았습니다.
이 글의 숫자는 A100 80GB PCIe에서 카드 용량만큼 메모리 예산(8GB 7,664 / 12GB 11,760 / 16GB 15,856 / 24GB 24,048 MiB, 각 GiB × 1,024 − 512 − 16 MiB)을 잡고 잰 값이며, 본문의 tok/s는 모두 A100 속도입니다. 8GB 카드에는 Q2_K_XL도 전부 GPU에 올릴 수 없습니다(CUDA 모델 버퍼만 8,469.3 MiB). 또한 upstream llama.cpp에서는 저장소 루트 파일 대신 Mainline_Support/ 폴더의 파일과 b12611 이상 빌드가 필요합니다.
1. KV 캐시는 물리 24층이 아니라 48회 방문으로 셉니다
Inkling 2 Mini의 구조(config.json 및 inkling2-loop.cpp)를 보면 물리 층은 24개(0-23번)인데, 가운데 12개 층(6-17번)을 3번 반복해 토큰당 총 48회 층을 거칩니다. llama.cpp의 루프 구현은 반복할 때마다 별도의 KV 캐시 슬롯을 둡니다. 전체 어텐션 층(5·11·17·23번) 중 5·23번은 1번씩, 11·17번은 3번씩 지나므로 전역 방문 8회, 나머지 슬라이딩 윈도(창 크기 1,024토큰) 층은 로컬 방문 40회가 됩니다.
f16 KV 캐시 기준(KV 헤드 8개 × 차원 128 × 2바이트 × K·V 2개)으로 층·방문 1회당 토큰 1개는 4,096바이트입니다. -ub 512에서 슬라이딩 윈도 캐시는 1,536칸으로 잡혀 40회 × 1,536칸 × 4,096B = 240 MiB가 되고, -ub 256과 128에서는 1,280칸(200 MiB)이 잡힙니다. 이 식으로 계산한 값과 llama-server 로그의 실측 KV 버퍼 크기를 나란히 놓으면 다음과 같습니다.
| 컨텍스트 | 48회 방문 계산 (전역 + 로컬) | 실측 KV 버퍼 | 24층으로 셌을 때 |
|---|---|---|---|
| 8,192 (8K) | 496 MiB (256 + 240) | 496 MiB | 248 MiB |
| 32,768 (32K) | 1,264 MiB (1,024 + 240) | 1,264 MiB | 632 MiB |
| 65,536 (64K) | 2,288 MiB (2,048 + 240) | 2,288 MiB | 1,144 MiB |
| 131,072 (128K) | 4,336 MiB (4,096 + 240) | 4,336 MiB | 2,168 MiB |
8K 로그를 열어 보면 8192 cells, 8 layers(256.00 MiB)와 1536 cells, 40 layers(240.00 MiB)가 찍히고, 32K 로그에서는 전역 쪽이 32768 cells, 8 layers(1,024.00 MiB)로 늘어 정확히 48슬롯이 잡힙니다. 이 KV 크기는 Q2·Q3·Q4 세 양자화에서 모두 똑같았습니다.
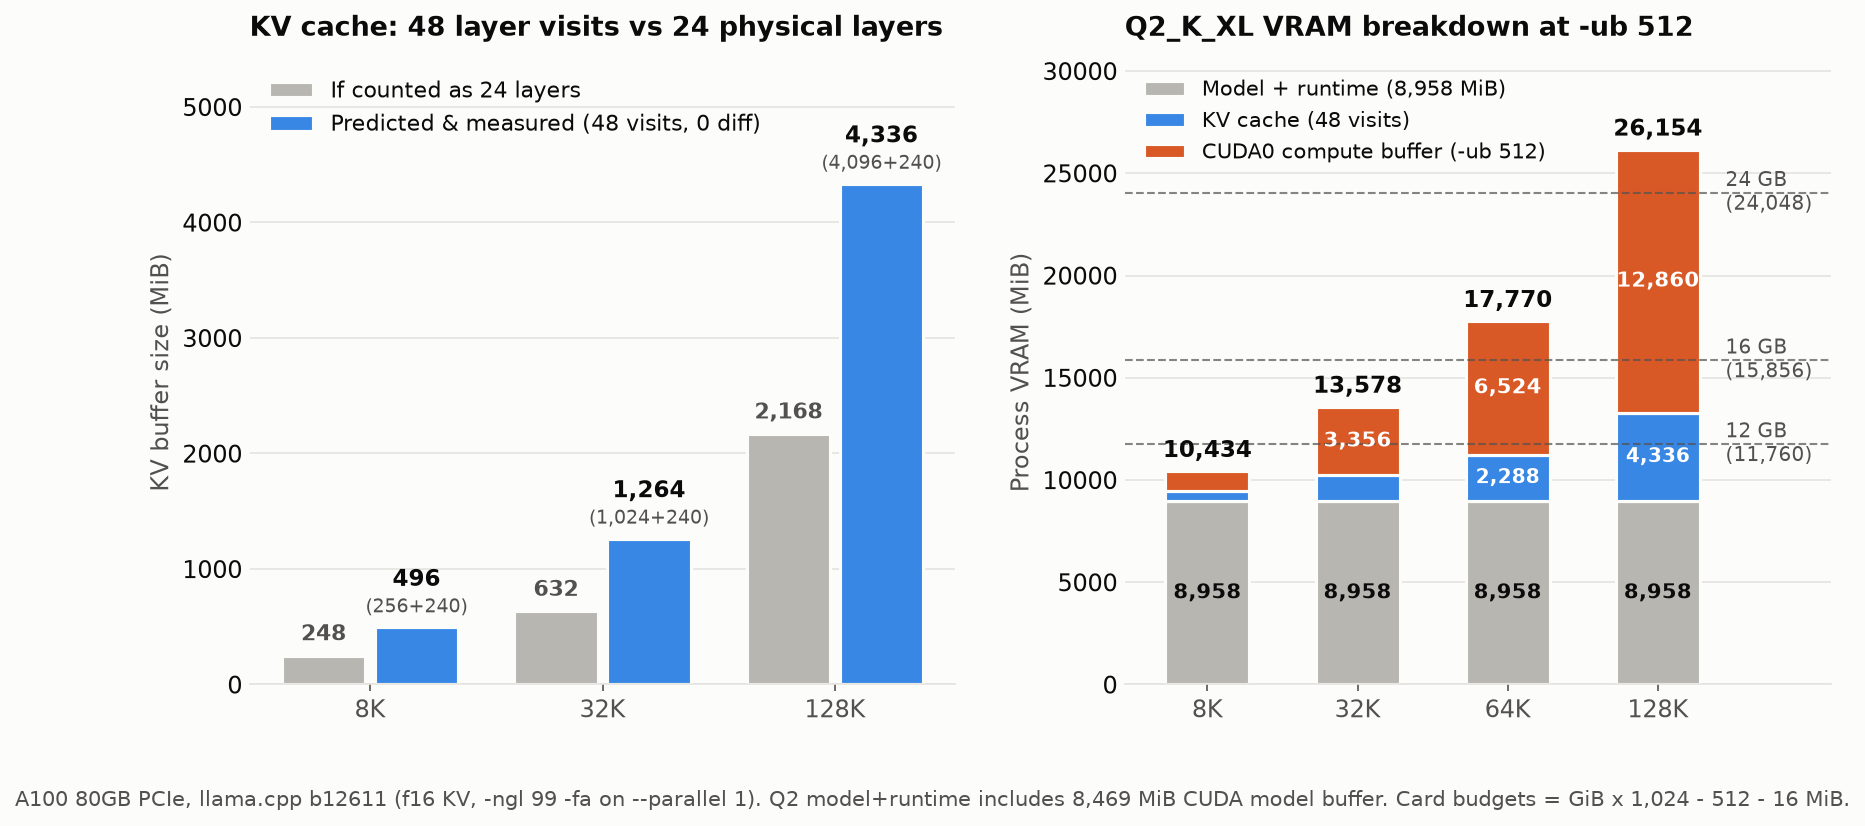
2. 정작 메모리를 먹는 것은 계산 버퍼이고, `-ub`가 절반씩 줄여 줍니다
오른쪽 누적 막대에서 보이듯, -ub 512 기본값으로 띄우면 컨텍스트가 늘어날수록 KV 캐시보다 CUDA0 계산 버퍼가 훨씬 가파르게 불어납니다. 서버가 준비 완료(health ok) 상태가 된 직후 nvidia-smi로 읽은 프로세스 메모리와 로그 버퍼는 다음과 같습니다(공통 플래그 -ngl 99 -fa on --parallel 1 --jinja --no-webui, KV f16).
| 컨텍스트 | KV (MiB) | CUDA0 계산 버퍼 (-ub 512) | Q2 프로세스 | Q3 프로세스 | Q4 프로세스 |
|---|---|---|---|---|---|
| 8K | 496 | 980.2 | 10,434 | 14,650 | 18,298 |
| 32K | 1,264 | 3,356.2 | 13,578 | 17,794 | 21,442 |
| 64K | 2,288 | 6,524.2 | 17,770 | 21,986 | 25,634 |
| 128K | 4,336 | 12,860.2 | 26,154 | 30,370 | 34,018 |
참고로 모델 자체의 CUDA 버퍼는 Q2 8,469.3 MiB, Q3 12,685.2 MiB, Q4 16,332.4 MiB이고, CPU에 매핑되는 CPU_Mapped 버퍼는 각각 234.7, 303.7, 469.3 MiB입니다.
왜 계산 버퍼가 이렇게 클까요? llama.cpp의 inkling2.cpp 코드를 보면, 이 모델은 RoPE 대신 상대 위치 bias를 쓰며 bias 텐서(kq_b, f32)가 헤드 수 × 컨텍스트 × ubatch 크기로 잡히고 연속 복사본이 하나 더 만들어집니다. 실제 실행으로 확인한 것은 -ub를 줄였을 때 계산 버퍼가 정비례해 줄어든다는 점입니다.
이를 확인하려고 32K와 128K에서 -ub를 512, 256, 128로 바꾸고 정확히 토큰 30,000개짜리 프롬프트(토큰 ID를 직접 전달)를 처리한 뒤 프로세스 VRAM과 A100 프롬프트 처리 속도를 쟀습니다.
양자화 · -ub | 32K (로드 / 프롬프트 뒤 / 계산 버퍼 / A100 프롬프트 tok/s) | 128K (로드 / 프롬프트 뒤 / 계산 버퍼 / A100 프롬프트 tok/s) |
|---|---|---|
Q2 · ub 512 | 13,578 / 13,594 / 3,356.2 / 662.8 | 26,154 / 26,170 / 12,860.2 / 665.3 |
Q2 · ub 256 | 11,858 / 11,870 / 1,677.8 / 634.5 | 19,682 / 19,694 / 6,429.8 / 636.3 |
Q2 · ub 128 | 11,018 / 11,126 / 837.3 / 559.6 | 16,466 / 16,574 / 3,213.3 / 560.4 |
Q3 · ub 512 | 17,794 / 17,810 / 3,356.2 / 645.5 | 30,370 / 30,386 / 12,860.2 / 643.6 |
Q3 · ub 256 | 16,074 / 16,086 / 1,677.8 / 602.2 | 23,898 / 23,910 / 6,429.8 / 602.4 |
Q3 · ub 128 | 15,234 / 15,342 / 837.3 / 558.5 | 20,682 / 20,790 / 3,213.3 / 559.8 |
Q4 · ub 512 | 21,442 / 21,456 / 3,356.2 / 642.5 | 34,018 / 34,032 / 12,860.2 / 642.7 |
Q4 · ub 256 | 19,722 / 19,732 / 1,677.8 / 600.3 | 27,546 / 27,556 / 6,429.8 / 600.3 |
Q4 · ub 128 | 18,882 / 18,982 / 837.3 / 563.7 | 24,330 / 24,430 / 3,213.3 / 563.9 |
결과는 깔끔합니다. -ub를 절반으로 내릴 때마다 CUDA0 계산 버퍼가 거의 정확히 절반으로 줄어듭니다(32K에서 1,677.8 → 837.3 MiB, 절반은 838.9 MiB). 32K와 128K 두 지점으로 계산한 토큰 1K개당 VRAM 증가 기울기는 세 양자화가 모두 같아, -ub 512에서 131.0 MiB, -ub 256에서 81.5 MiB, -ub 128에서 56.8 MiB입니다. 대가는 A100 기준 프롬프트 처리 속도입니다. -ub 512 대비 256은 약 4-7%, 128은 약 12-16% 느려집니다. 컨텍스트가 길수록 VRAM 절감 폭이 커집니다.
3. 8·12·16·24GB 카드별 최대 `-c`와 비전(`mmproj`) 여유분
카드별 예산은 sotaaz-8gb 및 GPU 맞춤 연재와 같은 기준(GiB × 1,024 − 512 − 16 MiB)으로 잡았습니다. 8GB는 7,664 MiB, 12GB는 11,760 MiB, 16GB는 15,856 MiB, 24GB는 24,048 MiB입니다. 32K·128K 두 점 직선에서 예산 이하로 내려오는 최대 -c를 1,024 단위로 내림해 구한 뒤, 18개 칸 전부를 그 -c로 띄워 3만 토큰(30K 미만 3칸은 -c − 512) 프롬프트를 처리한 뒤 예산 안에 남는지 확인했습니다. 18칸 모두 예산 안쪽이었습니다. 다만 18칸 중 30K 이상 15칸은 컨텍스트를 끝까지 채우지 않고 3만 토큰 프롬프트까지만 넣어 본 결과입니다(259K 칸은 전체의 약 12%).
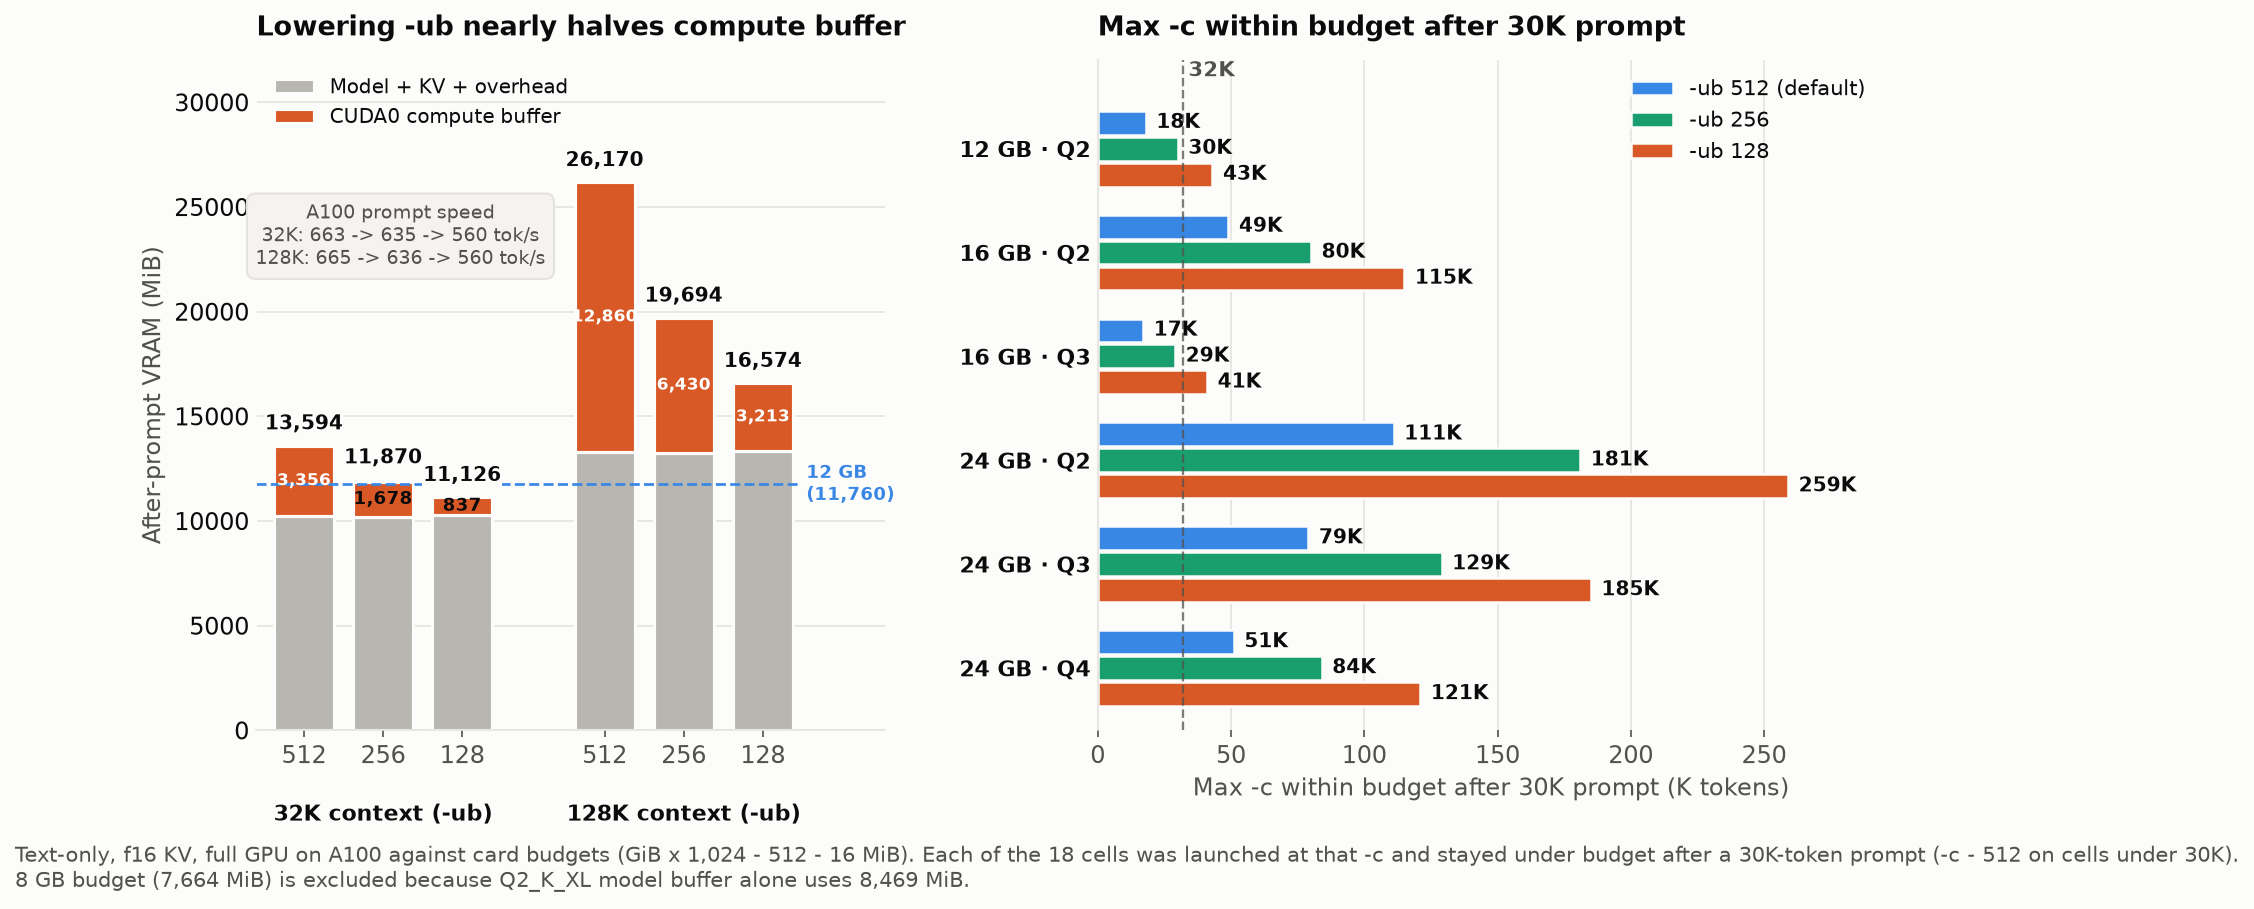
텍스트 전용, KV f16, 전부 GPU에 올린 기준으로, 각 칸의 -c로 띄워 3만 토큰(30K 미만은 -c − 512)을 처리한 뒤 예산 안에 남은 최대 -c 표입니다.
| 양자화 | -ub | 8GB (7,664 MiB) | 12GB (11,760 MiB) | 16GB (15,856 MiB) | 24GB (24,048 MiB) |
|---|---|---|---|---|---|
UD-Q2_K_XL | 512(기본) | 안 들어감 | 18K | 49K | 111K |
UD-Q2_K_XL | 256 | 안 들어감 | 30K | 80K | 181K |
UD-Q2_K_XL | 128 | 안 들어감 | 43K | 115K | 259K |
UD-Q3_K_XL | 512(기본) | 안 들어감 | 안 들어감 | 17K | 79K |
UD-Q3_K_XL | 256 | 안 들어감 | 안 들어감 | 29K | 129K |
UD-Q3_K_XL | 128 | 안 들어감 | 안 들어감 | 41K | 185K |
UD-Q4_K_XL | 512(기본) | 안 들어감 | 안 들어감 | 안 들어감 | 51K |
UD-Q4_K_XL | 256 | 안 들어감 | 안 들어감 | 안 들어감 | 84K |
UD-Q4_K_XL | 128 | 안 들어감 | 안 들어감 | 안 들어감 | 121K |
실제 카드에서 쓸 때 함께 볼 단서 네 가지가 있습니다.
- 여유분은 경계에 딱 붙어 있습니다. 그
-c로 띄워 3만 토큰(또는-c − 512)을 처리한 18칸에서(예산 − 프롬프트 뒤 MiB)여유는0-106 MiB였습니다. 특히 12GBQ2 -ub 512(18K, 17,920토큰 프롬프트)는 남은 여유가0 MiB, 16GBQ3 -ub 128(41K)은2 MiB였습니다. 실제 환경에서는 데스크톱 점유가 512 MiB보다 클 수 있으므로, 표의 최대값보다 한두 단계 낮춰 잡는 편이 안전합니다. - 12GB에서 32K를 쓰려면
-ub조정이 필요합니다. 기본-ub 512로는 18K가 한계이고(32K는13,594 MiB),-ub 256에서30K,-ub 128을 주어야43K로 32K를 넘깁니다. - 8GB 카드는 전부 GPU 올리기가 불가능합니다.
Q2_K_XL모델 버퍼만8,469.3 MiB라 예산7,664 MiB를 넘습니다. 8GB 카드에서 띄워 보려면--n-cpu-moe같은 CPU 오프로드 옵션을 함께 써 보시기 바랍니다. - 비전(
mmproj-F16.gguf)과 긴 컨텍스트 품질:mmproj를 붙이면 8K와 32K, 세 양자화 모두에서 계산 버퍼+98.8 MiB를 포함해+710 MiB가 더 듭니다. 예를 들어Q4 + mmproj는 32K에서 로드 직후(이미지 입력 전)22,152 MiB로 24GB 예산(24,048 MiB) 안에 들어갑니다. 710 MiB를 기울기로 나눈 계산값 기준으로는 최대-c가-ub 512에서 약5K,-ub 128에서 약12K줄어드므로, 비전을 켤 때는 표 값에서 그만큼 여유를 빼고 잡으시기 바랍니다. 모델의 학습 상한(n_ctx_train)은 1M(1,048,576)이라 128K를 넘는 칸도 모델 한도 안쪽이며, 긴 구간을 쓸 때는 실제 작업 프롬프트로 출력을 먼저 확인해 보시기 바랍니다.
4. Q2까지 내려도 코딩 과제가 돌아갈까
가장 작은 UD-Q2_K_XL을 골랐을 때 실력이 얼마나 떨어지는지 보려고, 앞선 8·12·16·24GB 로컬 코딩 모델 비교 글과 똑같은 하네스(agent.py 11568cd, Python 과제 T1-T4 × 3회씩 양자화당 12회, -c 16384, -ub 512)를 돌렸습니다. 점수는 실행 종료 시점 작업 폴더에 숨긴 테스트를 돌려 통과한 비율의 평균입니다. 다만 에이전트가 스스로 done을 선언했는지와 숨긴 테스트를 통과했는지는 구분해서 봅니다.
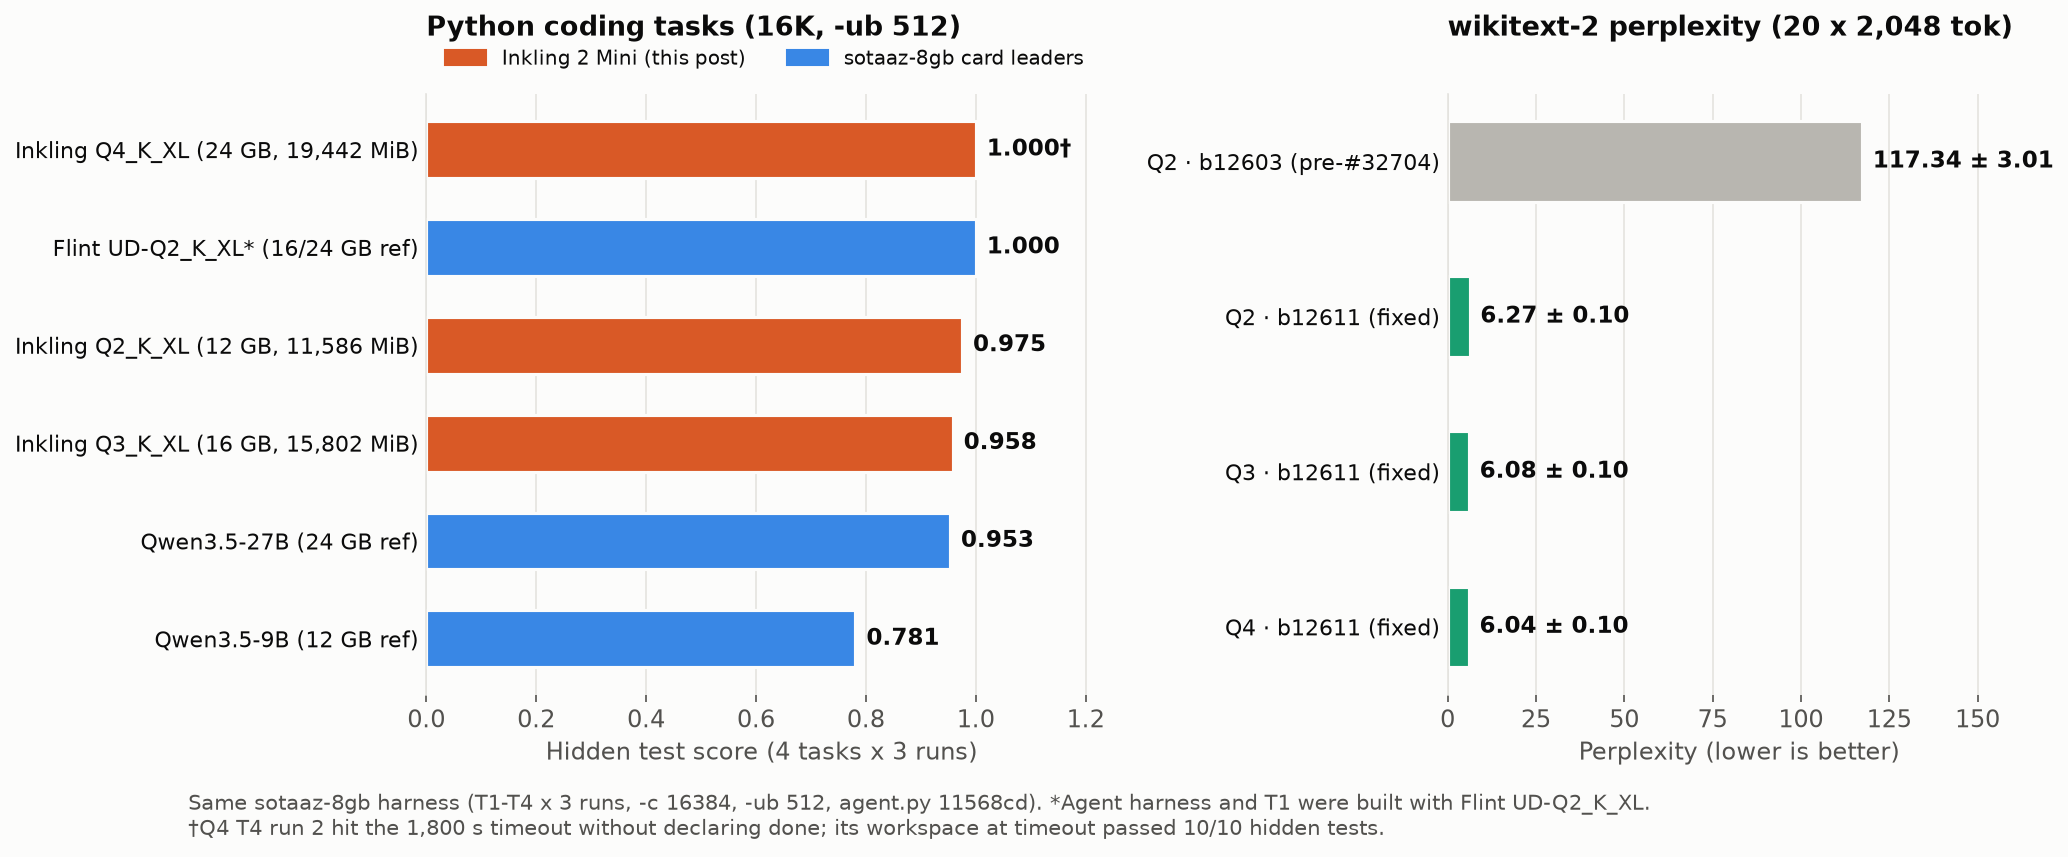
| 양자화 | 평균 점수 | T1 (6문제) | T2 (8문제) | T3 (8문제) | T4 (10문제) | 최대 VRAM | A100 디코드 tok/s | wikitext-2 PPL (b12611) |
|---|---|---|---|---|---|---|---|---|
UD-Q2_K_XL | 0.975 | 6/6 ×3 | 8/8 ×3 | 8/8 ×3 | 10, 7, 10 | 11,586 MiB (12GB 가능) | 35.1-43.0 (중앙값 42.6) | 6.27 ± 0.10 |
UD-Q3_K_XL | 0.958 | 6/6 ×3 | 8/8 ×3 | 8/8 ×3 | 9, 10, 6 | 15,802 MiB (16GB 가능) | 41.8-42.3 (중앙값 42.0, 10회) | 6.08 ± 0.10 |
UD-Q4_K_XL | 1.000 | 6/6 ×3 | 8/8 ×3 | 8/8 ×3 | 10, 10, 10 | 19,442 MiB (24GB 가능) | 33.3-41.6 (중앙값 41.3) | 6.04 ± 0.10 |
- 실점은 전부 T4(semver 버전 범위 파서)에서 나왔습니다. T1·T2·T3은 세 양자화 모두 3번씩 전부 만점이었습니다. T4에서 점수가 깎인 3회(
Q2 r27/10의<·<=비교 오류,Q3 r19/10의max_satisfying이"v1.10.1"대신"1.10.1"을 반환한 오류,Q3 r36/10의=1.2.3·||범위ValueError와 프리릴리스 제외 오류)에서는 모두 공개 테스트만 통과한 상태에서 에이전트가done을 선언했습니다. - Q4 T4 2회차의 시간 초과: Q4는 12회 중 11회만
done을 선언했습니다. T4 2회차는 1,800초 제한에 걸려 완료 선언 없이 끝났지만, 시간 초과 시점의 작업 폴더를 채점한 결과 숨긴 테스트 10/10을 모두 통과해 하네스 규칙대로 1.0점으로 집계됐습니다(전체 36회 중 35회가done선언). - Q3 속도와 표본 수 단서: Q3 12회 중 T3 2회차와 T4 2회차는 GPU 1을 다른 외부 프로세스(11,898 MiB)가 동시에 점유해 속도가 느려졌으므로, 위 디코드 속도 범위와 중앙값(
42.0)은 이를 제외한 정상 10회 기준입니다(시간 초과는 없어 점수는 그대로 포함). 또한 과제당 3회 반복은 표본이 작아Q3 r3한 번의 T4 실수(6/10)로 Q2(0.975)가 Q3(0.958)보다 높게 나왔습니다. wikitext-2 test(2,048토큰 20청크) perplexity는 Q46.04 ± 0.10, Q36.08 ± 0.10, Q26.27 ± 0.10입니다. Q2가 Q3·Q4보다 약 0.2 높지만, Q3와 Q4의 차이(0.04)는 오차(±0.10)보다 작아 두 양자화의 우열을 이 수치로 단정할 수 없습니다. - 기존 카드 1위와의 비교 및 174 MiB 여유: 같은 하네스·16K 컨텍스트·
-ub 512조건에서sotaaz-8gb의 12GB 1위는 Qwen3.5-9B(0.781), 16GB·24GB 참고 기준은 Flint UD-Q2_K_XL(1.000, 당시 에이전트와 T1을 만든 모델), 24GB 2위는 Qwen3.5-27B(0.953)였습니다. InklingQ2_K_XL은 최대11,586 MiB로 12GB 예산(11,760 MiB) 안에 들면서0.975를 받아, 이 4개 과제 묶음에서는 12GB 카드의 맨 위 자리를 바꿨습니다. 다만 Qwen3.5-9B는 12GB 예산에서5,708 MiB가 남았던 반면, Inkling Q2의 남은 여유는174 MiB뿐입니다. 앞 절에서 적었듯 데스크톱 점유가512 MiB를 넘는 환경이라면 기본-ub 512에서는 아슬아슬하므로, 아래처럼-ub를 내려 여유를 확보하시는 편이 안전합니다.
5. 받기 전에 꼭 맞춰야 할 두 가지: `Mainline_Support/` 파일과 `b12611` 이상 빌드
Unsloth 저장소에서 파일을 받아 upstream llama.cpp로 띄울 때는 파일 위치와 빌드 버전 두 가지를 맞춰야 합니다. Unsloth README가 이미 적어 두었듯 저장소 맨 위 루트 파일(Inkling-2-Mini-UD-Q2_K_XL.gguf 등)은 Unsloth Studio 및 자체 빌드용으로 루프를 48개 블록으로 펼친 레이아웃(general.architecture = inkling2, block_count = 48)을 씁니다. upstream llama.cpp로 이 루트 파일을 열면 check_tensor_dims: tensor 'blk.24.attn_q.weight' not found 오류를 내며 로드가 멈춥니다.
upstream llama.cpp용은 Mainline_Support/ 폴더 안에 있는 .gguf_file을 받아 확장자만 .gguf로 바꿔 써야 합니다(24개 물리 층 + 루프 메타 키를 쓰는 inkling2_loop 아키텍처). 그리고 빌드도 루프 모델의 전문가별 NVFP4 스케일 처리가 들어간 PR #32704가 반영된 b12611(커밋 690b87d, 2026-11-21) 이상이어야 합니다. 같은 Mainline_Support Q2 파일에 빌드만 바꿔 재면 차이가 극단적으로 나타납니다.
| 빌드 | Q2_K_XL wikitext-2 PPL | "n번째 피보나치 함수, 코드만" (temp 0, 120토큰) |
|---|---|---|
b12603 (수정 전) | 117.34 ± 3.01 | "The user is a Python function/ ... F. F." 뒤 보이지 않는 zero-width space 반복 |
b12611 (수정 후) | 6.27 ± 0.10 | "Need decide indexing convention. Common: F(0)=0, F(1)=1." 정상 추론 후 def fibonacci(n): 작성 시작 |
6. 카드별 추천 세팅과 실행 명령
12·16·24GB 카드에서 지금 바로 Inkling 2 Mini를 써 보신다면 저희 측정 기준으로는 아래 조합이 가장 실용적입니다.
- 12GB 카드 (RTX 3060 12GB 등):
UD-Q2_K_XL. 16K에서도 기본-ub 512는 남은 여유가174 MiB(11,586대11,760 MiB)뿐이라 데스크톱 점유가 큰 환경에서는 빡빡하므로, 16K에는-ub 256(3만 토큰 프롬프트 기준30K까지 예산 안)을 권합니다. 32K 컨텍스트를 쓰려면-ub 128을 함께 주십시오(3만 토큰 프롬프트 기준43K까지 예산 안). - 16GB 카드 (RTX 4070 Ti Super 등):
UD-Q3_K_XL에-ub 128(3만 토큰 프롬프트 기준41K까지 예산 안)을 조합하면 32K 컨텍스트를 넘기면서 Q2(6.27 ± 0.10)보다 perplexity가 낮은 Q3(6.08 ± 0.10)를 쓸 수 있습니다.80K-115K긴 컨텍스트가 꼭 필요하다면UD-Q2_K_XL에-ub 256(80K)이나128(115K)을 씁니다. - 24GB 카드 (RTX 4090 등):
UD-Q4_K_XL이 기본-ub 512에서도 3만 토큰 프롬프트 기준51K까지 예산 안입니다. 비전 입력(mmproj)까지 붙이면서 32K로 띄우면 로드 직후(이미지 입력 전)22,152 MiB로 예산(24,048 MiB) 안에 여유 있게 남습니다. 100K 안팎의 컨텍스트가 필요하면UD-Q4_K_XL에-ub 128(121K)을 쓰거나UD-Q3_K_XL(-ub 256129K /-ub 128185K)을 고르십시오. - 8GB 카드: 전부 GPU에 올리는 구성에는 들어가지 않습니다. GPU 단독 구성이라면 앞서 측정한 sotaaz-8gb의 Qwen3.5-9B를 유지하시거나, CPU MoE 오프로드(
--n-cpu-moe등) 구성을 따로 시험해 보시기 바랍니다.
llama.cpp b12611 이상을 준비한 뒤, 예를 들어 12GB 카드에서 32K 컨텍스트로 UD-Q2_K_XL을 띄우는 명령은 다음과 같습니다.
hf download unsloth/Inkling-2-Mini-GGUF Mainline_Support/Inkling-2-Mini-UD-Q2_K_XL.gguf_file --local-dir models
mv models/Mainline_Support/Inkling-2-Mini-UD-Q2_K_XL.gguf_file models/Inkling-2-Mini-UD-Q2_K_XL.gguf

llama-server \
  -m models/Inkling-2-Mini-UD-Q2_K_XL.gguf \
  -c 32768 -ub 128 -ngl 99 -fa on --parallel 1 --jinja --no-webui --port 8080
서버를 띄운 뒤 API를 호출할 때는 응답 필드에 주의하십시오. Inkling 2 Mini는 추론 모델이라 /v1/chat/completions 응답에서 생각 과정이 reasoning_content 필드로 먼저 나옵니다.
표의 최대 -c 근처를 쓰기 전에는 nvidia-smi --query-gpu=memory.free --format=csv로 내 카드의 실제 여유 VRAM을 확인하고, 짧게 두 번 띄워 직선을 긋는 방법으로 내 환경의 여유분을 한 번 검증한 뒤 컨텍스트를 잡으시기 바랍니다.
이 연재의 다음 편이 나오면 아래 뉴스레터로 보내 드립니다.