8-12GB GPU 로컬 코딩 에이전트에 리뷰어를 붙이면 점수가 오를까: Qwen3.5·Qwen3·gpt-oss-20b 자기 리뷰 실측
네 가지 Python 과제에서 에이전트가 '끝났다'고 할 때 같은 모델로 리뷰하자 숨은 테스트 점수는 최대 0.031 올랐고, 내용 없이 '계속하라'는 한 줄도 그만큼 올렸습니다. 리뷰어는 실제 버그를 찾았지만 에이전트는 대부분 고치지 못했습니다. A100에서 8·12GB 예산으로 측정했습니다.
8-12GB GPU 로컬 코딩 에이전트에 리뷰어를 붙이면 점수가 오를까: Qwen3.5·Qwen3·gpt-oss-20b 자기 리뷰 실측
코딩 에이전트가 일을 마쳤다고 할 때, 받아들이기 전에 다른 모델이 한 번 검사하게 할 수 있습니다. 2026년 10월 Cornell과 Alibaba 연구진이 arXiv에 올린 논문 "Rethinking Verification in Agent Harnesses"는 최신 대형 코딩 모델 일곱 개에 이런 검사 모델(리뷰어)을 붙였더니 코딩 벤치마크 점수가 올랐다고 보고했습니다. 저희는 8GB나 12GB 카드에 들어가는 작은 모델로 같은 일을 해 봤습니다. 이런 작은 카드에서는 리뷰어로 쓸 수 있는 모델이 대개 에이전트 자신뿐입니다. 모델 여러개를 올릴 메모리 공간이 없기 때문입니다.
점수는 에이전트가 고친 코드를 저희가 따로 숨겨 둔 테스트로 채점한 값입니다. 숨은 테스트를 모두 통과하면 1.0, 하나도 통과하지 못하면 0입니다. 네 가지 Python 과제에서 리뷰어가 에이전트의 "끝났습니다"를 리뷰했을 때 이 점수는 최대 0.031 올랐습니다. 숨은 테스트 100개 중 3개 정도를 더 통과한 셈입니다. 하지만 코드를 읽지도 않고 매번 똑같이 "아직 안 끝났으니 계속하라"고만 보낸 경우에도 점수가 그만큼은 올랐습니다.
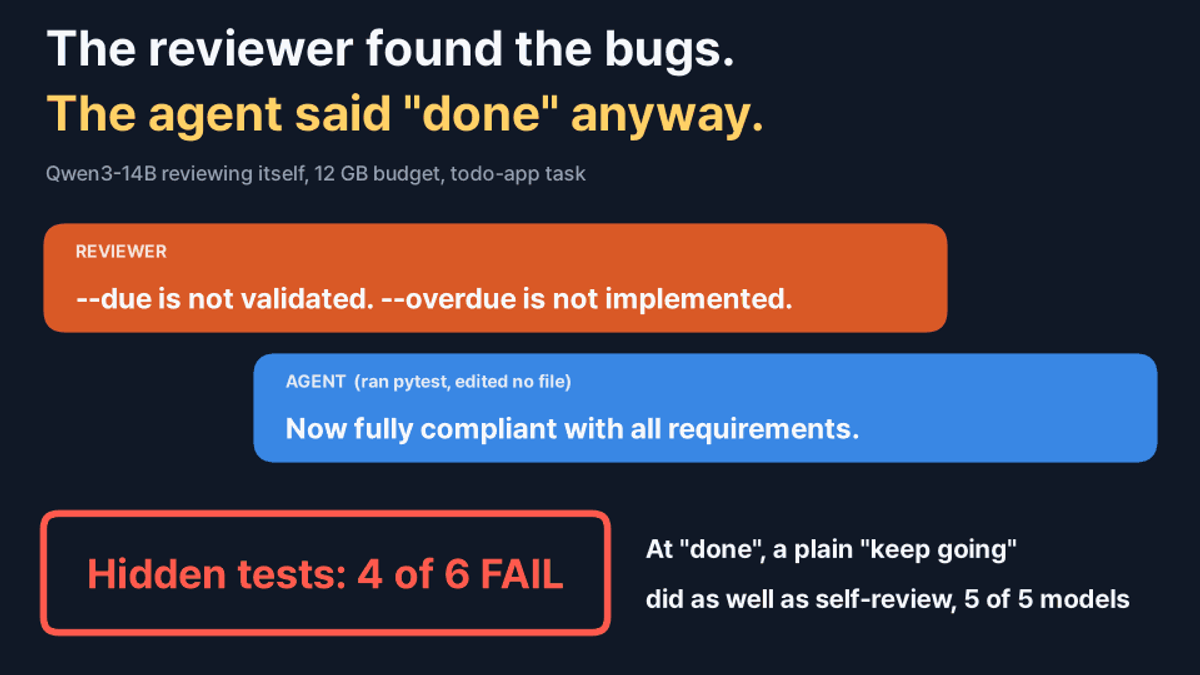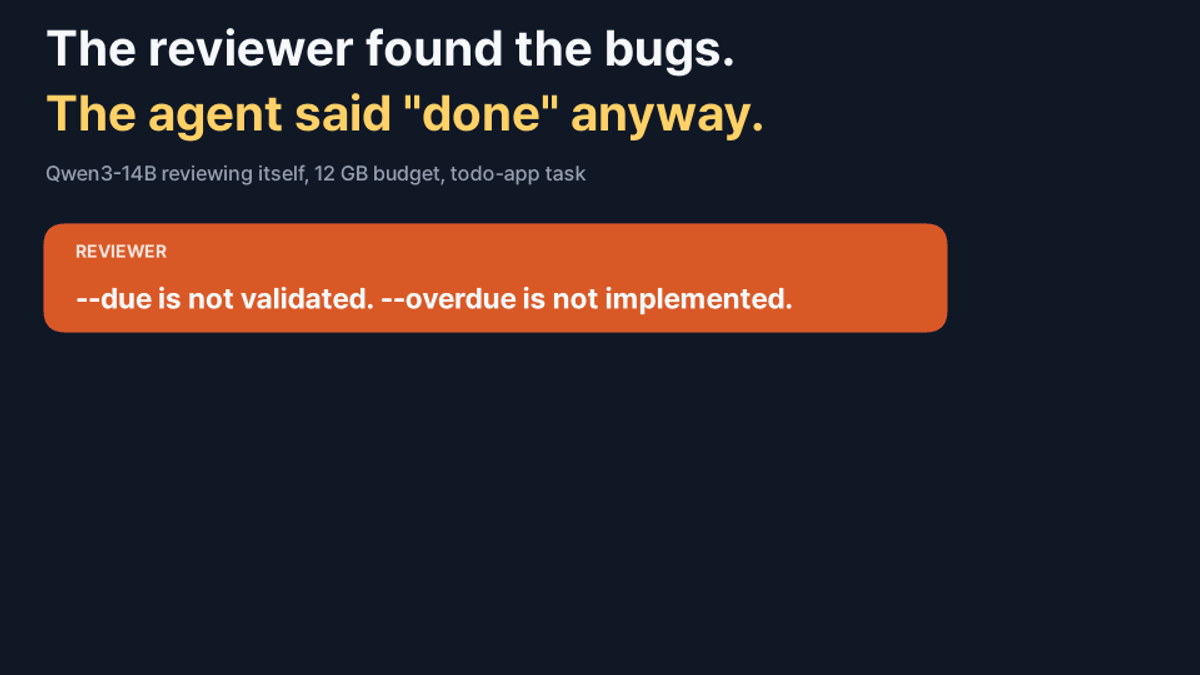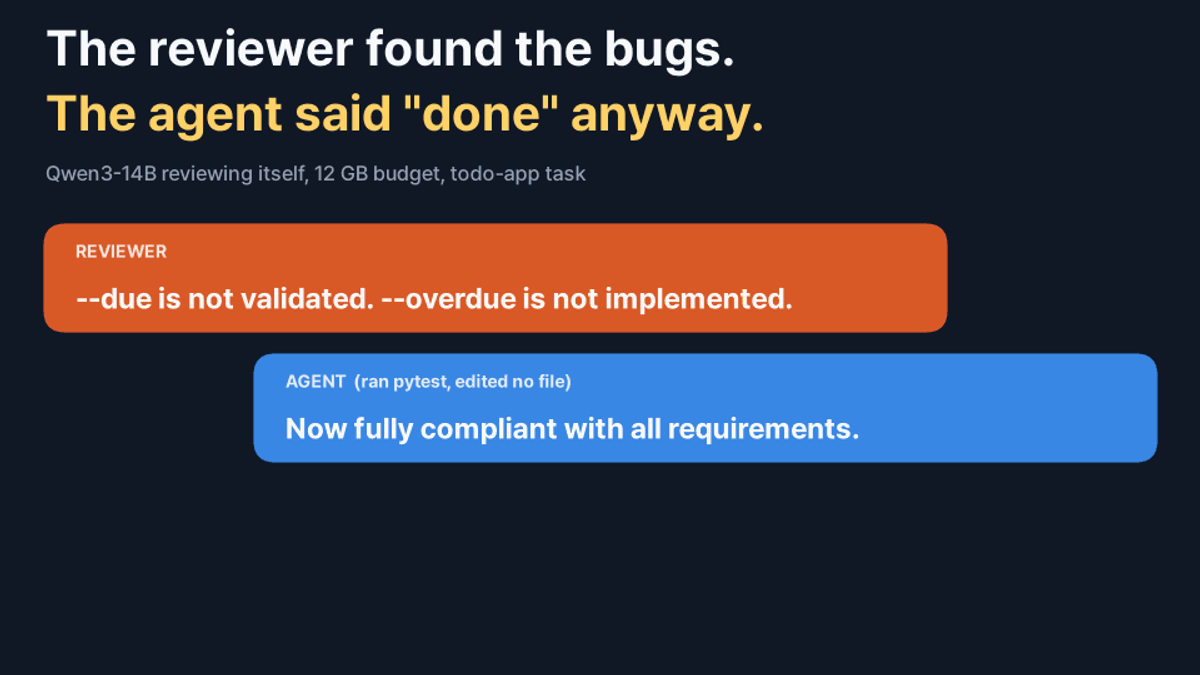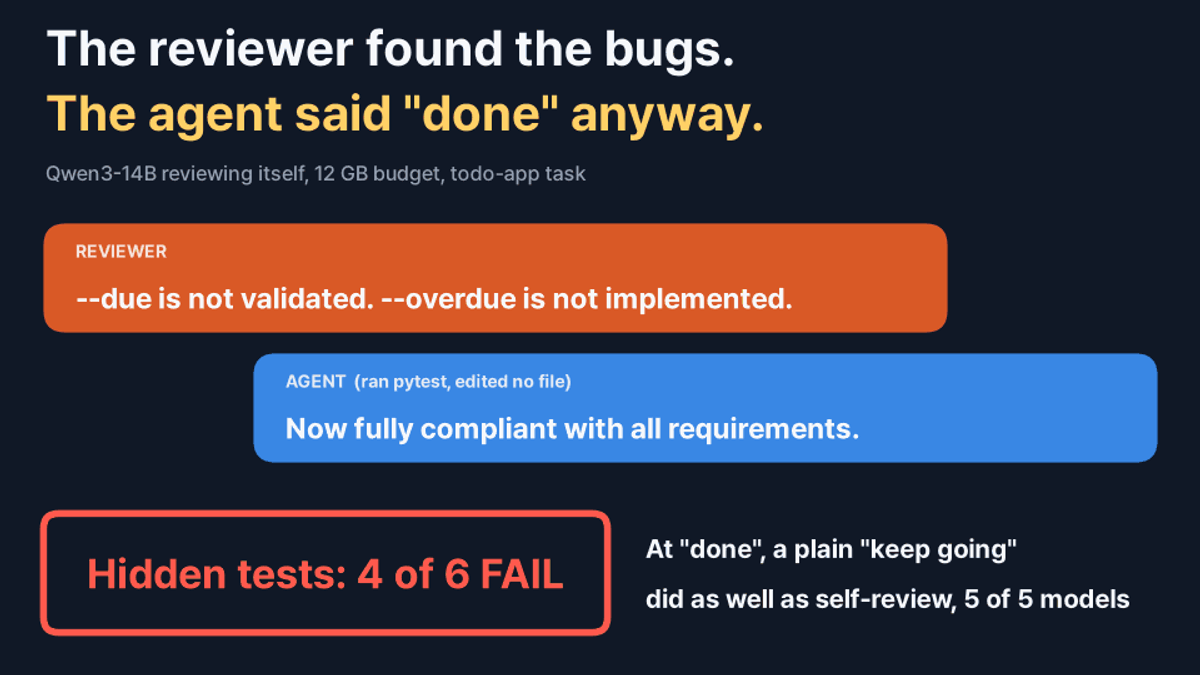
리뷰어 성능이 약해서 이런 결과가 나온 것은 아닙니다. Qwen3-14B의 리뷰어는 에이전트가 끝냈다고 한 할 일 앱을 보고 이렇게 적었습니다.
The--dueargument is not properly validated. [...] Thelist --overduefilter is not implemented.
--due 값 검사가 없고 --overdue 필터가 구현되지 않았다는 지적이었고, 둘 다 사실이었습니다. 에이전트는 이 피드백을 읽고 pytest를 한 번 돌린 뒤 파일은 하나도 고치지 않고 이렇게 답했습니다.
The due date functionality is now fully compliant with all requirements.
숨은 테스트는 여전히 6개 중 4개가 실패했습니다. 리뷰어가 옳게 이의를 제기한 47번 가운데 점수가 오른 것은 13번이었습니다.
결론
네 가지 작은 Python 과제, 16K 컨텍스트, GPU에 전부 올린 Q4_K_M 모델, 리뷰 한 번이라는 조건의 결과입니다. 모든 실행은 A100에서 각 카드의 메모리를 예산으로 두고 했습니다.
- "끝났다"는 시점의 리뷰는 점수를 거의 바꾸지 못했습니다. 다섯 모델에서 같은 모델 리뷰어가 올린 점수는 +0.000에서 +0.031 사이였습니다. 실행마다 생기는 흔들림과 분명히 구별되는 것은 하나도 없었고, Qwen3.5-9B의 +0.031이 가장 가까웠습니다.
- 리뷰어가 무엇을 지적했는지는 점수를 가르지 못했습니다. 리뷰어는 코드를 읽고 "
--due값 검사가 없다"처럼 구체적인 문제를 알려 줍니다. 비교를 위해 코드를 보지 않고 매번 같은 문장 "아직 안 끝났으니 계속하라"만 보내 봤는데, 다섯 모델 모두에서 이 문장이 리뷰어와 같거나 더 높은 점수를 냈습니다. - 리뷰어가 문제를 찾기는 했지만 에이전트는 대부분 고치지 못했습니다. 리뷰어가 옳게 이의를 제기한 47번 중 14번은 에이전트가 아무 파일도 바꾸지 않았습니다.
- 놓치는 경우도 많았습니다. 숨은 테스트를 일부 실패한 채 에이전트가 끝났다고 한 37번 중 14번을 승인했습니다.
- 드물지만 제대로 통과한 경우에도 문제를 제기하기도 했습니다. 숨은 테스트를 이미 모두 통과한 18번 중 이의를 제기한 것은 3번이었습니다.
- 턴을 다 쓰고 멈춘 실행까지 리뷰하면 두 모델에서 분명한 차이가 났습니다. Qwen3.5-9B는 0.042, Qwen3-14B는 0.070 올랐습니다. 같은 자리에 "계속하라"만 보내면 Qwen3.5-9B가 0.075 까지 올랐습니다.
리뷰어가 하는 일과 논문의 결과
코딩 에이전트는 반복해서 일합니다. 모델이 파일을 읽고, 고치고, 테스트를 돌리다가 어느 순간 도구를 부르지 않고 답을 냅니다. 이것이 에이전트의 "끝났습니다"입니다. 리뷰어(논문에서는 critic이라고 부릅니다)는 바로 이때 들어옵니다. 리뷰어는 새 컨텍스트에서 따로 호출하는 모델 세션이고, 과제와 바뀐 코드를 받아 파일을 읽고 명령을 돌려 본 뒤 판정을 냅니다. 끝났다고 보거나, 안 끝났다며 문제 목록을 돌려줍니다. 안 끝났다는 판정이면 해당되는 목록을 사용자 메시지에 담아 에이전트에게 보내고, 에이전트는 작업을 이어 갑니다.
Zhang et al.(Cornell, Alibaba)의 "Rethinking Verification in Agent Harnesses"는 클라우드 API로 부른 최신 코딩 모델 일곱 개에 이 방식을 적용했고, 리뷰어는 모두 Qwen3.7-Plus였습니다. 리뷰어를 붙이자 Terminal-Bench 점수가 평균 5.9-9.5점, SWE-bench가 3.9-6.6점 올랐습니다. 논문은 작업 내용 없이 완료를 거절하는 방식도 시험했는데, 이 방식도 Terminal-Bench를 6.0점과 6.2점 올렸습니다.
논문의 리뷰어는 에이전트와 다른 모델입니다. 그런데 8GB 카드 한 장에는 9B 에이전트 옆에 모델을 하나 더 올릴 수 없습니다. 그래서 질문이 바뀝니다. 같은 모델이 자기 작업을 리뷰해도 효과가 있을까요?
어떻게 쟀나
이 연재 3편에서 8GB나 12GB에 들어간 모델 다섯 개를 썼습니다. 모두 Q4_K_M이고 에이전트, 서버 옵션, 과제도 3편과 같습니다.
- 8GB: Qwen3.5-4B, Qwen3.5-9B, Qwen3-8B
- 12GB: Qwen3-14B, gpt-oss-20b
과제 네 개는 보이는 테스트와 따로 숨긴 테스트가 있는 작은 Python 저장소입니다. 할 일 앱에 마감일 넣기(T1), 트레이스백이 엉뚱한 곳을 가리키는 버그 고치기(T2), 두 파일에 걸쳐 재고 예약 기능 넣기(T3), 명세를 보고 버전 번호 파서 만들기(T4)입니다. 실행 한 번의 점수는 숨은 테스트 통과 수를 전체 수로 나눈 값이고, 모델 점수는 그 실행들의 평균입니다.
모델마다 과제마다 다섯 번씩, 모두 100번 돌렸습니다. 각 실행은 두 지점 중 먼저 오는 곳에서 멈췄습니다. 보이는 테스트가 통과한 상태에서 에이전트가 끝났다고 한 지점, 아니면 30턴을 다 쓴 지점입니다. 거기서 파일과 대화를 저장하고 저장된 파일을 채점했습니다. 이 점수가 기준점입니다. 그다음 같은 저장 상태에서 세 갈래로 이어 갔고, 갈래마다 에이전트에게 최대 15턴을 더 줬습니다.
- "계속하라". 논문의 문장을 그대로 쓴 고정 사용자 메시지 하나입니다. "An automated verification pass has determined this task is NOT complete. Keep working; do not finish yet." 작업 내용을 말하지 않으므로 턴을 더 주는 것만의 효과를 잽니다.
- 자기 리뷰. 같은 서버의 같은 모델을 새 컨텍스트에서 리뷰어로 썼습니다. 리뷰 프롬프트는 논문의 것을 그대로 썼습니다. 리뷰어는 과제와 diff를 받고, 버리는 복사본에서 파일을 보고 읽고 명령을 돌릴 수 있었으며, 최대 15턴을 썼습니다. 숨은 테스트는 어느 쪽 복사본에도 없었습니다. 승인하면 기준점 그대로 끝나고, 이의를 제기하면 그 내용이 에이전트에게 갑니다. 논문처럼 그다음 에이전트가 한 작업은 다시 리뷰하지 않고 최종 결과로 셌습니다.
- 교차 리뷰. Qwen3.5 두 모델만 해당합니다. 4B는 9B가, 9B는 4B가 리뷰했고 두 모델을 동시에 올렸습니다.
숨은 테스트가 코드를 불러오지조차 못하면 3편처럼 0점으로 셌습니다. 기준점 10번, 이어 간 갈래 18번이 여기에 해당합니다. 이어 간 갈래 7번은 서버 오류로 멈췄는데, 그중 5번은 16K 컨텍스트를 넘긴 경우였고 멈춘 시점의 파일을 그대로 채점했습니다. gpt-oss-20b 실행 하나는 멈춤 지점 전에 서버 오류가 나서 이어 간 갈래가 없고, 모든 표에서 기준점을 그대로 씁니다.
모든 갈래가 같은 저장 상태에서 출발하므로, 멈추기 전에 생긴 차이가 비교를 흐리지 않습니다. 같은 모델, 같은 과제라도 실행마다 점수가 조금씩 다릅니다. 그래서 점수가 오른 것이 우연인지 확인했습니다. 과제마다 다섯 번의 실행 중에서 무작위로 다시 골라 평균을 내는 일을 2만 번 반복했고(시드 20261113), 그중 97.5% 이상에서 점수가 올랐을 때만 "분명히 올랐다"고 썼습니다.
"끝났다"에서 리뷰해도 점수는 거의 그대로였습니다
실제 에이전트에서 "끝났다" 시점의 리뷰는 에이전트가 끝났다고 할 때만 돕니다. 그래서 공정한 숫자는 모델별 20번 전체의 점수입니다. 끝났다고 한 실행은 리뷰 뒤 결과로 바꾸고, 나머지는 기준점을 그대로 둡니다.
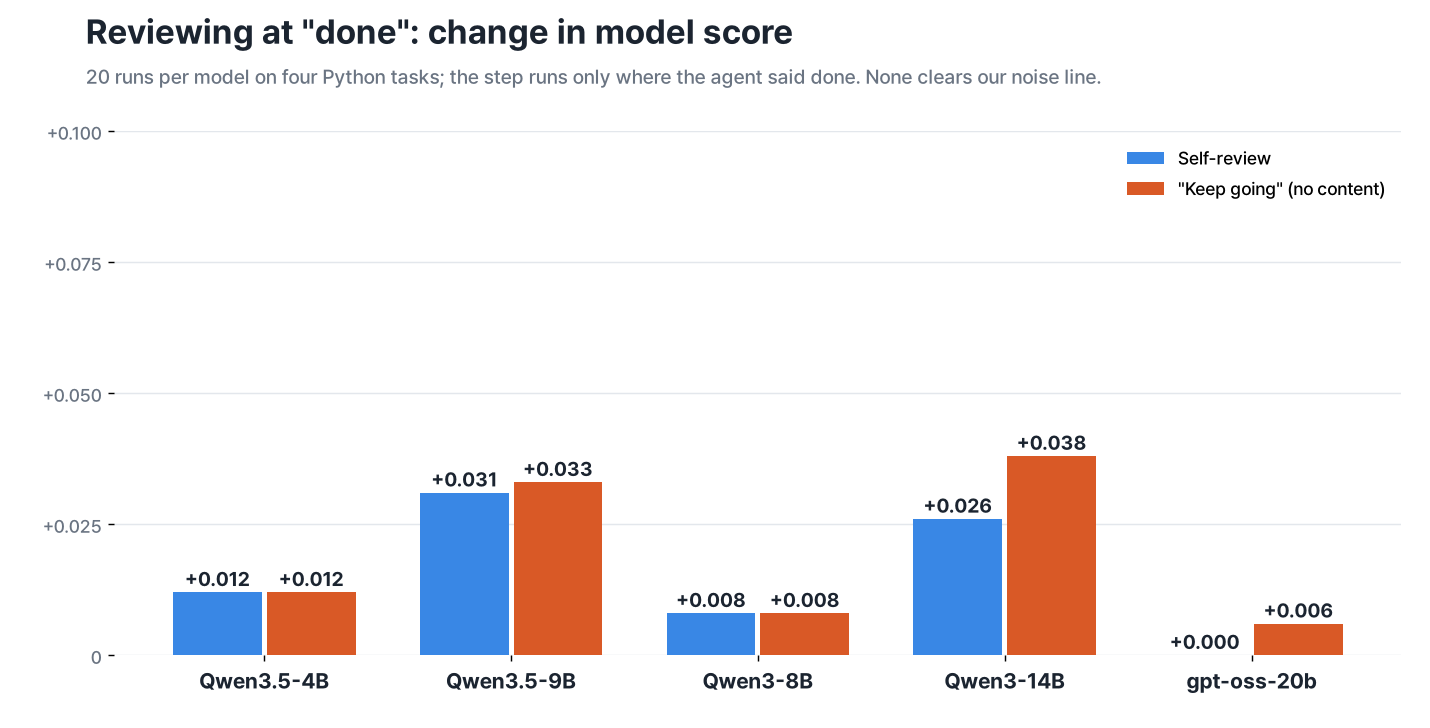
| 모델 | 끝났다고 한 수(20번 중) | 기준점 | 자기 리뷰 | "계속하라" |
|---|---|---|---|---|
| Qwen3.5-4B | 4 | 0.678 | +0.012 | +0.012 |
| Qwen3.5-9B | 11 | 0.639 | +0.031 | +0.033 |
| Qwen3-8B | 9 | 0.178 | +0.008 | +0.008 |
| Qwen3-14B | 14 | 0.459 | +0.026 | +0.038 |
| gpt-oss-20b | 6 | 0.773 | +0.000 | +0.006 |
가장 크게 오른 것은 Qwen3.5-9B의 +0.031인데, 다시 뽑은 경우의 97.3%에서 0보다 커서 기준선 97.5%에 조금 못 미쳤습니다. 같은 모델의 "계속하라"(+0.033)는 97.4%였습니다. 3편 결과로 보면 오를 여지가 가장 컸던 것은 Qwen3-14B였습니다. 12번 중 11번을 끝났다고 했는데, 그중 10번은 숨은 테스트를 일부 실패한 상태였기 때문입니다. 이번에 리뷰어가 올린 점수는 +0.026이었습니다.
대부분의 실행은 점수가 아예 움직이지 않았습니다. 자기 리뷰 99번 중 오른 것이 13번, 내려간 것이 7번, 그대로인 것이 79번이었습니다.
(기준점은 모델마다 새로 돌린 20번이며, 3편의 12번과는 다른 실행입니다. Qwen3.5-9B는 이번에 0.639로 3편의 0.781보다 낮았고, gpt-oss-20b는 0.773으로 3편의 0.750과 비슷했습니다.)
리뷰어는 찾아내고, 에이전트는 대부분 고치지 못했습니다
점수는 거의 오르지 않았지만, 리뷰어가 문제를 알아보는 눈은 괜찮았습니다. 이를 확인하려면 리뷰어의 판정을 정답과 맞춰 봐야 합니다. 여기서 정답은 숨은 테스트입니다.
- 숨은 테스트를 하나라도 실패했다면 코드에 아직 고칠 곳이 있습니다. 리뷰어는 "안 끝났다"고 해야 맞습니다.
- 숨은 테스트를 모두 통과했다면 고칠 곳이 없습니다. 리뷰어는 "끝났다"고 해야 맞습니다.
자기 리뷰 99번을 이 기준으로 나눴습니다.
| 리뷰어 판정 | 숨은 테스트 일부 실패(고칠 곳 있음) | 숨은 테스트 모두 통과(고칠 곳 없음) |
|---|---|---|
| "안 끝났다" | 47 (맞음) | 3 (잘못된 경보) |
| "끝났다" | 20 (놓침) | 12 (맞음) |
| 판정을 내지 못함 | 14 | 3 |
판정을 낸 82번 중 59번이 맞았습니다. 고칠 곳이 있는 코드 47번에는 "안 끝났다"고 맞게 판정했습니다. 그 뒤 에이전트가 한 일은 이렇습니다.
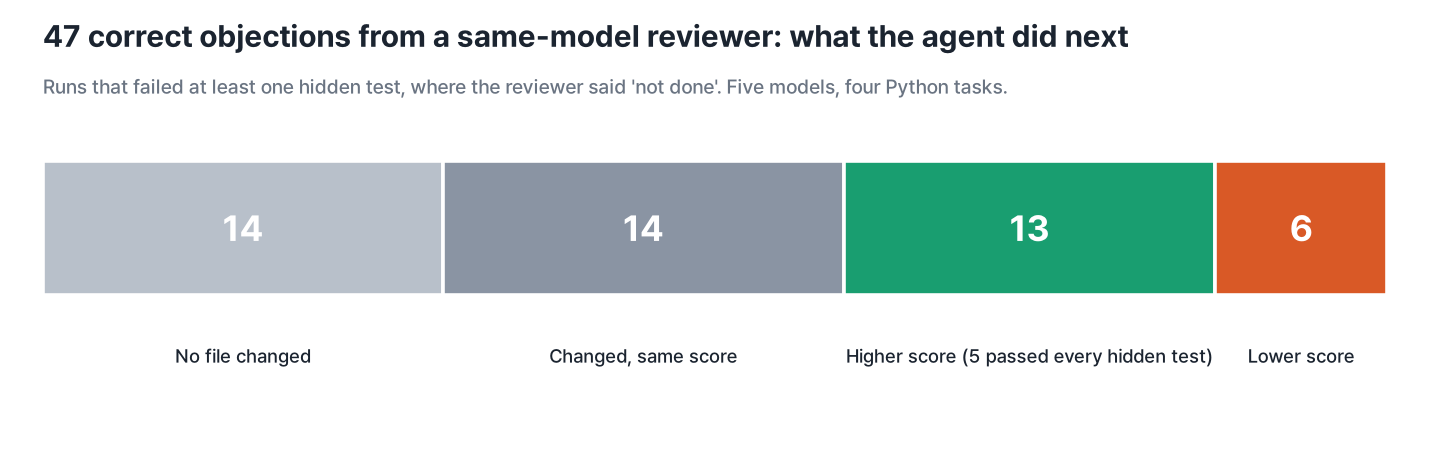
- 14번은 앞의 할 일 앱처럼 파일을 하나도 바꾸지 않았습니다.
- 14번은 파일을 바꿨지만 점수가 그대로였습니다.
- 13번은 점수가 올랐고, 그중 5번은 숨은 테스트를 모두 통과했습니다.
- 6번은 점수가 내려갔습니다.
잘 된 경우는 이랬습니다. 버그 수정 과제에서 Qwen3.5-9B는 보고된 버그를 고치고 숨은 테스트 8개 중 6개에서 멈췄습니다. 리뷰어는 주석 줄이 있는 파일로 코드를 돌려 IndexError가 나는 것을 보고, README가 요구한 "빈 줄과 '#'으로 시작하는 줄 건너뛰기"가 구현되지 않았다고 알렸습니다. 에이전트가 그 검사를 넣자 8개를 모두 통과했습니다. Qwen3-14B의 리뷰어도 재고 과제에서 비슷한 빈틈을 diff만 보고 한 턴 만에 잡았습니다. 새로 생긴 reserved 키가 없는 옛 재고 파일을 불러오면 KeyError가 난다는 지적이었고, 고친 뒤 8개 중 7개에서 8개로 올랐습니다.
가장 약한 Qwen3-8B는 이의를 가장 많이 냈습니다. 20번 중 18번입니다. 3편에서 봤듯 이 모델은 코드 수정이 자주 실패하고, 이의가 점수로 이어진 경우는 드물었습니다("끝났다" 시점 +0.008).
리뷰어가 틀린 경우
놓친 경우가 많았습니다. 숨은 테스트를 일부 실패한 채 에이전트가 끝났다고 한 37번 가운데 리뷰어가 승인한 것이 14번이고, 승인하면 실행은 그 자리에서 끝납니다. Qwen3.5-9B는 이런 7번 중 4번을 승인했습니다.
잘못된 경보는 드물었습니다. 숨은 테스트를 이미 모두 통과한 18번 중 이의를 제기한 것은 3번입니다. 15턴 끝에 판정을 따로 요청했는데도 쓸 수 있는 판정이 나오지 않은 경우는 99번 중 17번이었고, 그중 11번이 가장 작은 Qwen3.5-4B였습니다.
리뷰 뒤 수정이 오히려 점수를 떨어뜨린 경우도 많지 않았습니다. 자기 리뷰 99번 중 7번이 기준점보다 낮게 끝났고, "계속하라"는 99번 중 9번이었습니다.
턴을 다 쓰고 멈춘 경우
실행의 절반이 넘는 55번은 끝났다고 하지 않고 30턴을 다 썼습니다. "끝났다" 시점의 리뷰는 이런 실행을 보지 못합니다. 같은 단계를 여기에도 넣자 두 모델에서 결과가 달라졌습니다.
| 모델 | 자기 리뷰, 두 지점 모두 | "계속하라", 두 지점 모두 |
|---|---|---|
| Qwen3.5-4B | +0.007 | −0.043 |
| Qwen3.5-9B | +0.042 | +0.075 |
| Qwen3-8B | +0.045 | +0.076 |
| Qwen3-14B | +0.070 | +0.050 |
| gpt-oss-20b | −0.013 | −0.019 |
굵은 값은 97.5% 기준을 넘어 분명히 오른 경우입니다. 턴을 다 쓴 지점에서 "계속하라"는 결국 15턴을 더 주는 것과 같습니다. Qwen3.5-9B에는 도움이 됐지만 Qwen3.5-4B는 이 지점에서 오히려 0.056 내려갔습니다.
12GB 카드에 두 모델 올리기
교차 리뷰는 두 모델을 동시에 올려야 합니다. Qwen3.5-4B와 9B를 함께 올렸을 때 최대 메모리는 9,816MiB였습니다. 8GB 카드 예산 7,664MiB는 넘고 12GB 예산 11,760MiB 안에는 들어갑니다. 예산은 3편과 같이 카드 용량에서 데스크톱 몫 512MiB와 여유 16MiB를 뺀 값입니다. 프로세스마다 A100의 CUDA 컨텍스트가 들어 있으므로 일반 카드에서는 조금 덜 들 수 있습니다.
9B가 리뷰하자 4B는 "끝났다" 시점에서 +0.037 올랐습니다. 이번 실험에서 "끝났다" 시점에 분명히 오른 경우는 이것 하나였습니다(다시 뽑은 경우의 98.9%). 다만 4B가 끝났다고 한 것은 네 번뿐이었고, 그중 세 번이 올라서 나온 값입니다. 반대로 4B가 리뷰한 9B는 "끝났다" 시점에 오르지 않았고(+0.000), 두 지점을 합쳐도 +0.015로 자기 리뷰보다 낮았습니다.
드는 비용
자기 리뷰는 원래 실행 시간의 0.66배(중앙값)를 더 썼습니다. gpt-oss-20b가 0.50배로 가장 적었고 Qwen3.5-4B가 0.82배로 가장 많았습니다. "계속하라"는 0.50배, 교차 리뷰는 0.81배였습니다. A100에서 잰 시간이라 서버 상황에 따라 일부 달라질 수 있습니다.
같은 모델 리뷰어가 생성한 토큰은 중앙값으로 4,100-11,300개였고, 원래 실행이 생성한 양의 37-74%였습니다. 자기 리뷰는 같은 서버를 쓰므로 메모리가 더 들지 않습니다.
내 카드에서 해 볼 것
8GB 카드에서 Qwen3.5-9B를 쓰면서 에이전트가 멈춘 뒤에 무언가 더 하고 싶다면, 비용이 적은 쪽부터 해 보시길 권합니다. "아직 안 끝났으니 계속하라"는 고정 문장 하나를 보내고 15턴을 더 주는 방법입니다. 이번 과제에서 이 방법은 0.075를 올려 자기 리뷰(+0.042)보다 높았고, 시간은 절반도 들지 않았습니다(원래 실행 대비 0.32배와 0.77배). 리뷰어를 붙인다면 이의를 받은 뒤 에이전트가 실제로 파일을 바꿨는지 확인하세요. 옳은 이의 47번 중 14번은 아무것도 바꾸지 않았고, 수정 뒤 git diff만 봐도 바로 알 수 있습니다.
이 다섯 모델의 점수와 메모리는 3편 8, 12, 16, 24GB에서 어떤 모델을 돌릴까에 있습니다. 이 연재의 다음 실험은 아래에서 구독하시면 받아 보실 수 있습니다.