GPU 메모리를 늘리지 않고 32K 로컬 에이전트에 장기 기억 붙이기: Mnemonic Proxy 실측
AI 모델은 대화를 기억하지 않고, 앱이 매번 이전 대화를 다시 보낼 뿐이라 컨텍스트 창이 한계가 됩니다. Mnemonic Proxy는 오래된 내용을 요약하지 않고 원문을 보관소에 둡니다. Qwen3.5-9B와 opencode로 아홉 턴 과제를 돌려 보니 128K 창은 6턴 무렵 가득 찼고, 같은 GPU 메모리의 32K 창에 프록시를 붙인 쪽은 9턴까지 가면서 1턴 값을 그대로 지켰습니다. 힌트 없이 recall로 꺼낸 세션은 셋 중 하나였습니다.

GPU 메모리를 늘리지 않고 32K 로컬 에이전트에 장기 기억 붙이기: Mnemonic Proxy 실측
Mnemonic Proxy는 코딩 에이전트와 로컬 모델 서버 사이에 끼우는 프록시로, 대화가 길어져도 앞의 내용을 장기 기억처럼 쓸 수 있게 해 주는 도구입니다. 사용자와 AI 에이전트의 대화 기록을 장기 기억으로 바꿔 주는 방법과 도구는 전에도 많았고, Mnemonic Proxy도 그중 하나입니다. 다른 점은 저장하는 방식입니다. 흔히 쓰는 방법은 오래된 대화를 요약해서 남기는데, Mnemonic Proxy는 원문을 그대로 저장해 두고 모델에게는 그 원문을 찾아올 수 있는 한 줄만 남깁니다.
AI를 쓸 때 장기 기억만큼 헷갈리는 말도 없습니다. 이름만 들으면 AI가 대화를 기억하는 것 같지만, 모델은 대화를 기억하지 않습니다. 요청 하나를 받아 답을 내고 나면 그 요청에 무엇이 있었는지는 남지 않습니다. 그러면 ChatGPT나 Claude는 어떻게 앞에서 한 이야기를 아는 걸까요? 장기 기억을 도와준다는 솔루션과 라이브러리는 무엇을 해 주는 걸까요?
방법은 허탈할 만큼 단순합니다. 이전 대화 기록을 요청할 때마다 모델에게 처음부터 다시 보내는 것입니다. 대화창을 넘어서는 기억도 원리는 같아서, 저장해 둔 메모를 요청에 같이 넣어 줍니다. 모델은 아무것도 기억하지 않지만, 매번 앞의 내용을 다시 읽으니 기억하는 것처럼 답할 수 있습니다.
이 방법에는 당연히 한계가 있습니다. 모델이 한 번에 읽을 수 있는 분량, 즉 컨텍스트 윈도우(줄여서 창)가 정해져 있기 때문입니다. 단위는 토큰이고, 저희가 쓴 32K 창은 32,768토큰입니다. 대화 기록이 창보다 길어지면 서버는 요청을 받지 않습니다. 창을 키우면 되지만 그만큼 GPU 메모리가 더 듭니다. 저희 측정에서 같은 모델의 서버가 32K 창에서는 6,580MiB, 128K 창에서는 9,748MiB를 썼습니다. 게다가 코딩 에이전트는 파일을 통째로 읽고 명령 출력을 받아 보기 때문에, 128K 창도 생각보다 빨리 찹니다.
그래서 지금까지의 장기 기억 방법은 계속 늘어나는 대화를 어떻게 줄이느냐에 초점을 맞췄습니다. 창이 차면 오래된 부분을 요약하고 요약만 들고 가는 방식이 대표적이고, 코딩 에이전트 opencode에도 이 압축 기능이 들어 있습니다. 문제는 요약하면서 버린 내용은 다시 찾을 수 없다는 점입니다.
Mnemonic Proxy는 줄이는 대신 치워 둡니다. 오래된 도구 출력은 "무엇을 읽었는지"만 적힌 한 줄짜리 영수증으로 바꾸고, 원문은 로컬 보관소에 그대로 저장합니다. 모델에게는 보관소를 검색해 원문을 다시 가져오는 recall 도구를 줍니다. 창이 거의 차면 모델이 인계 메모를 쓰고 프록시가 새 구간을 시작하므로, 창 크기는 32K 그대로 두고 대화를 계속 이어 갈 수 있습니다. llama-server와 쓰면 서버 상태를 디스크에 저장해 두기 때문에, 서버를 다시 켜도 긴 대화를 처음부터 읽지 않습니다.
정말 그렇게 기억할 수 있는지 Qwen3.5-9B와 opencode로 아홉 턴짜리 코딩 과제를 돌려 봤습니다. 1턴에 값 세 개를 출력하고 8턴에 그 값을 묻는 과제입니다. 32K 창에 opencode 압축을 켠 경우, 32K 창에 Mnemonic Proxy를 붙인 경우, 압축 없이 128K 창을 쓴 경우를 세 번씩 돌렸습니다.
결과부터 말씀드리면 압축을 켠 세 세션은 값을 하나도 맞히지 못했습니다. 128K 창은 세 번 모두 6턴 무렵 가득 차서 그 뒤 요청이 전부 거부됐습니다. Mnemonic Proxy를 붙인 쪽은 32K 창과 같은 GPU 메모리(6,568-6,580MiB)로 세 번 모두 9턴까지 갔고(B1과 B2는 중간에 한두 턴이 30분 제한에 걸렸습니다), 1턴 값은 세 세션 모두 9-12MB짜리 보관소에 원문 그대로 남아 있었습니다. 그중 한 세션은 8턴에 recall을 부르기 전까지 구간을 25번 새로 시작했는데도, recall 한 번으로 세 값을 모두 맞혔습니다.
다만 꺼내 쓰는 것은 모델 몫이었습니다. 8턴에 값을 묻자 recall로 값을 찾으러 간 세션은 셋 중 하나였고, 9턴에 값이 어디서 나왔는지 알려 주자 두 세션이 값을 맞혔습니다. 지어낸 값은 하나도 없었고, 압축과 프록시 세션에서 못 찾은 값은 모두 unknown으로 적었습니다.
이 조합은 프로젝트 README에서도 아직 실험 단계라고 밝히고 있습니다. opencode와 llama-server를 붙여 긴 실사용 세션을 돌린 적은 없다고 적혀 있습니다. README가 보고한 벤치마크 일부 결과는 32K 창의 프록시가 86점, 요약 방식이 47점, 더 큰 창에 전체 기록을 넣은 방식이 69점이었고, 다시 돌린 결과는 85, 57, 75점이었습니다(재실행에서 전체 기록과의 차이는 유의하지 않았습니다). 저희 과제는 이 벤치마크와 다르므로, 아래 숫자는 저희 조건에서 나온 값으로 읽으시면 됩니다.
실험 조건
모든 실행에 같은 모델 파일(Qwen3.5-9B, Q4_K_M), llama.cpp 빌드 947, opencode 2.0.32, Mnemonic Proxy 0.3.24를 썼고 temperature 0.6, seed 42로 고정했습니다. 에이전트는 네트워크를 끊은 컨테이너 안에서 돌았고, 모델 포트 하나만 열어 두었습니다.
| 조건 | 서버 창 | 프록시 | opencode 압축 |
|---|---|---|---|
| A: 압축 | 32,768 | 없음 | 켬 |
| B: 프록시 | 32,768 | 있음, 상태 저장 포함 | 끔 |
| C: 큰 창 | 131,072 | 없음 | 끔 |
C는 GPU 메모리를 더 써서 컨텍스트 윈도우(창)를 네 배로 늘리는 방법입니다. 압축은 꺼 두어서, 기록이 창에 들어가는 동안은 대화 전체를 그대로 들고 가게 했습니다.
실행은 모두 A100에서 했고, 서버 프로세스가 12GB 메모리 제한 안에서 실행되는지만 확인했습니다. 32K에서 6,568-6,580MiB, 128K에서 9,748MiB였습니다.
과제는 Click 라이브러리를 복사해 사용했고, 아홉 턴을 정해진 순서로 줬습니다. 에이전트에게 보낸 프롬프트 원문(영어)은 아홉 턴 프롬프트에 그대로 있습니다.
- 1턴:
setup_env.py를 실행합니다. 설정 로그 35줄을 출력하는데, 그 사이 세 줄에 빌드 ID, p95 지연 시간, 건너뛴 마이그레이션 수가 들어 있습니다(출력 예시). 세 값은 세션마다 무작위이고, 출력한 뒤 스크립트가 스스로 지워지므로 프로젝트 폴더 어디에도 값이 남지 않습니다. - 2-5턴: Click 모듈을 통째로 읽고 모듈마다 문서를 씁니다(
docs/core.md외 세 개). - 6-7턴: 표 포매터와 CSV 쓰기·읽기 기능을 담은
table.py를 새로 쓰고 테스트도 붙입니다. - 8턴: 세 값을 담은
REPORT.md를 씁니다. 프롬프트에 "기억하라"나 "아까"라는 말은 없고, 모르는 값은unknown으로 적으라고만 합니다. - 9턴: 힌트를 줍니다. 값은 처음에 실행한
setup_env.py출력에 있었다고 알려 주고REPORT2.md에 적게 합니다.
코드는 에이전트가 한 번도 보지 못한 숨김 테스트 18개로 채점했고, 8턴과 9턴은 저희가 만든 값과 정확히 같은지로 채점했습니다. 턴마다 30분(8턴과 9턴은 10분), 세션마다 90분 제한을 두었으므로 느린 세션은 뒤쪽 턴이 더 일찍 끊길 수 있었습니다.
아홉 세션 결과
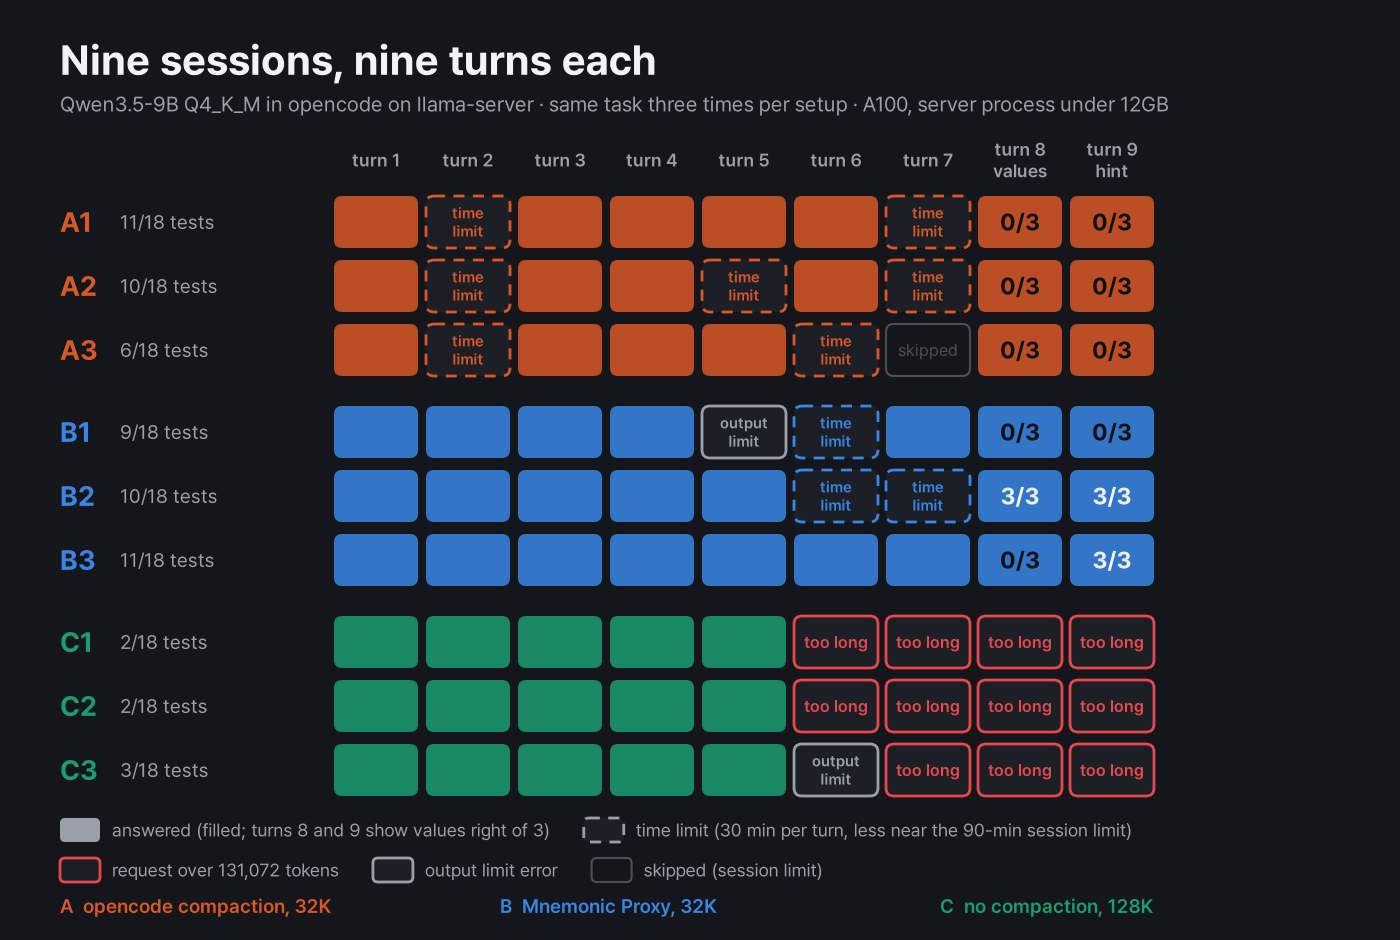
| 세션 | 답한 턴(9턴 중) | 8턴 맞힌 값(3개 중) | 9턴 맞힌 값 | 숨김 테스트(18개 중) |
|---|---|---|---|---|
| A1 | 7 | 0 | 0 | 11 |
| A2 | 6 | 0 | 0 | 10 |
| A3 | 6 | 0 | 0 | 6 |
| B1 | 7 | 0 | 0 | 9 |
| B2 | 7 | 3 | 3 | 10 |
| B3 | 9 | 0 | 3 | 11 |
| C1 | 5 | 거부됨 | 거부됨 | 2 |
| C2 | 5 | 거부됨 | 거부됨 | 2 |
| C3 | 5 | 거부됨 | 거부됨 | 3 |
틀린 값을 적은 세션은 없었습니다. A와 B에서 못 맞힌 값은 프롬프트가 시킨 대로 전부 unknown이었고, C는 보고서를 쓸 차례까지 가지 못했습니다. A 중 한 세션은 다른 곳을 뒤졌습니다. A2는 9턴에 opencode 자체 상태 폴더와 로그를 12번 검색했지만 쓸 만한 것을 찾지 못하고 unknown을 적었습니다.
먼저 바닥난 쪽은 128K 창이었습니다. C 세 세션은 6턴까지 프롬프트가 약 129,000-131,000 토큰에 이르렀습니다. C1과 C2는 6턴 도중 파일 두 개를 쓴 뒤 보낸 요청을 llama-server가 거부했습니다(C1의 오류는 "request (143,011 tokens) exceeds the available context size"였습니다). C3는 6턴을 출력 한도 오류로 끝냈고 7턴부터 거부당했습니다. 그 뒤 요청은 8턴과 9턴까지 모두 거부됐고, 표 코드도 끝내지 못해 숨김 테스트가 2-3개에 그쳤습니다. C1과 C2는 요청 수(27번)와 프롬프트 토큰 중 llama-server 캐시에서 재사용된 비율(87.85%)까지 같았습니다. 프롬프트 크기는 조금 달랐습니다. 모든 세션이 같은 seed를 썼으므로, 반복 세 번이 서로 완전히 독립된 세 번만큼의 정보를 주지는 않을 수 있습니다.
코드 점수는 A와 B가 비슷했습니다. 숨김 테스트 평균이 A 9.0개, B 10.0개였고 범위는 A 6-11개, B 9-11개였습니다. 조건마다 세 번만 돌려서는 한 개 차이를 노이즈와 구분할 수 없습니다.
다시 읽기 루프 안에서 일어난 일
opencode의 read 도구는 범위를 주지 않고 부르면 click/core.py의 앞 1,313줄까지만 돌려줍니다. 나머지를 읽으려면 시작 줄(offset)을 지정해 다시 불러야 합니다. B와 C는 그렇게 했습니다. 두 번째 호출이 1,314줄부터를 요청했습니다. 그 뒤 C 세 세션과 B1, B2는 docs/core.md를 썼고, B3는 같은 문서를 click/core.py.md라는 엉뚱한 경로에 썼습니다.
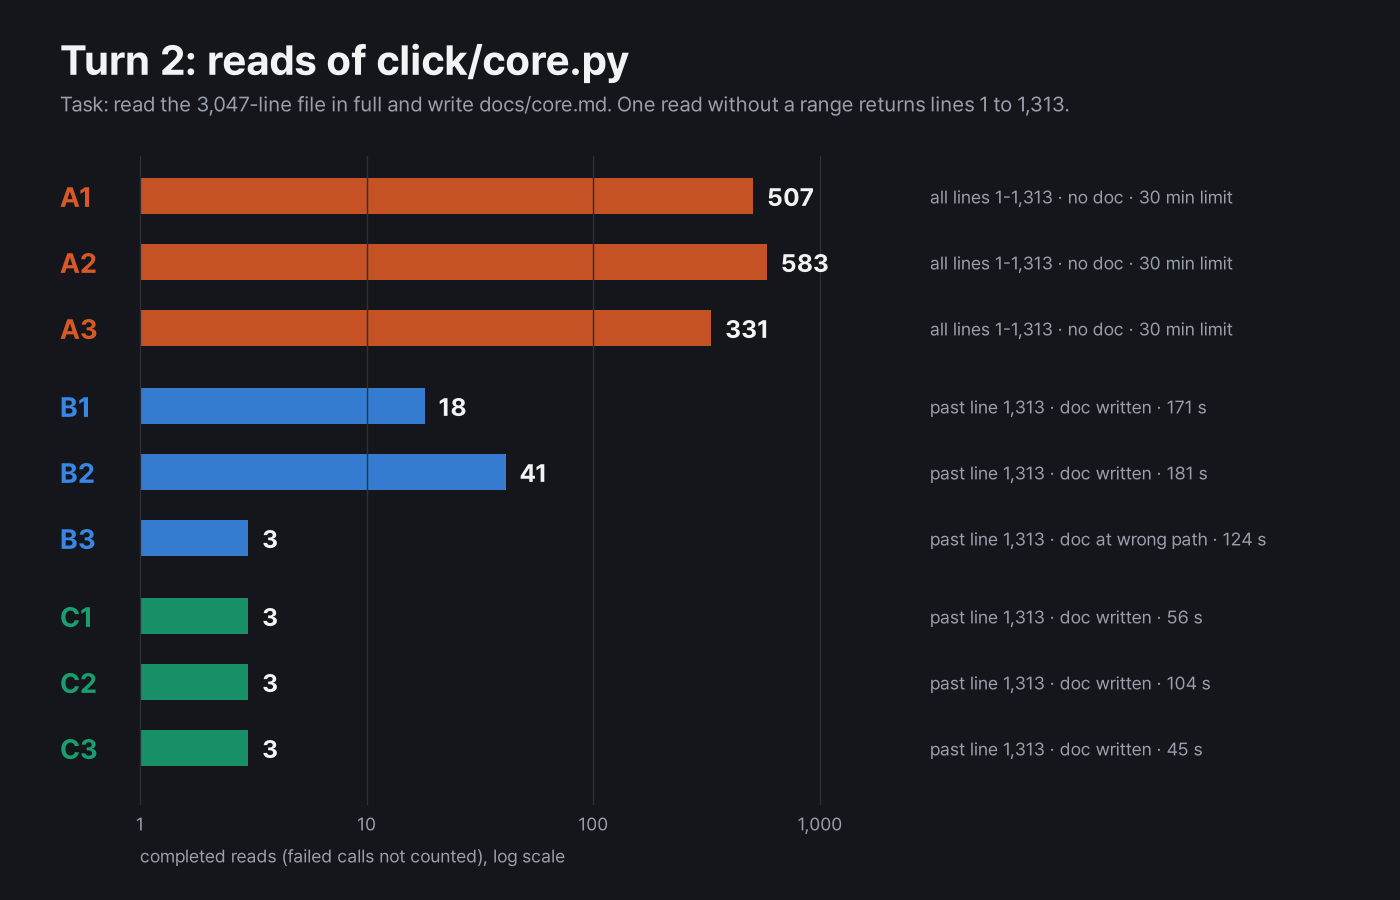
A1의 507번은 전부 범위 없는 같은 호출이었고, 매번 1-1,313줄을 받았습니다. 세션 데이터베이스를 보면 그 턴의 메시지가 모델 한 단계, 압축 한 번, 모델 한 단계, 압축 한 번 순서로 정확히 번갈아 나옵니다. 그중 한 번 읽은 뒤 opencode가 쓴 요약은 이렇습니다.
## Work State
### Completed
- Located click/core.py at /work/click/core.py
- Read full contents of click/core.py (1313 lines)

## Next Move
1. Analyze click/core.py to identify all public classes
2. Write docs/core.md with one section per public class listing purpose and main methods
요약에는 파일을 다 읽었다고 적혀 있고 파일이 1,313줄이라고 믿고 있지만, 파일 내용은 들어 있지 않습니다. 다음 할 일은 지금 손에 없는 파일을 분석하는 것이니 모델은 파일을 다시 읽고, 그러면 창이 차서 다음 압축이 일어납니다. A 세 세션 중 2턴에 write를 부른 세션은 하나도 없었습니다. 1,313줄에서 잘리는 것이 루프의 원인은 아닙니다. A2는 5턴에 통째로 다 읽힌 더 짧은 파일 세 개로 같은 루프에 빠졌고, 파일마다 311번씩 읽다가 다시 시간 제한에 걸렸습니다.
프록시도 압축도 없는 C는 B와 같은 방식으로 파일을 읽었습니다. 그러니 루프는 압축을 켰을 때 생겼습니다. B도 파일 전체를 들고 있지는 않았습니다. 프록시는 그 턴 안에서 읽어 온 core.py 내용을 한 줄짜리 영수증으로 바꿨는데, B1에서 13번, B2에서 17번이었고 두 번째로 읽은 부분이 들어오자마자 시작됐습니다. 그러자 모델은 파일을 더 작은 조각으로 다시 읽었고, B1의 18번과 B2의 41번은 거기서 나왔습니다. A와 달리 앞부분만 되풀이하지 않고 파일을 따라 내려가며 읽었고, 턴은 문서를 쓰는 것으로 끝났습니다. B3는 다른 길로 갔습니다. 2턴 안에서 프록시가 구간을 두 번 바꿨고, 모델은 recall을 아홉 번 부른 뒤 마지막 74줄(2,974-3,047줄)을 처음 읽었습니다. 2,681-2,973줄은 클래스 정의 검색 결과로만 봤습니다. B가 끝내 받지 않은 것은 파일 전체를 읽었다고 적힌 요약이었습니다. 모델이 영수증의 어느 부분에 기댔는지는 저희가 시험하지 않았습니다.
A의 기억 결과도 같은 압축으로 설명됩니다. A1의 맨 첫 요약은 2턴에 1턴 내용을 정리한 것인데, 여기에는 값 두 개가 남아 있었습니다("build ID BLD-9W2LNZYG and p95 latency of 428ms", 마이그레이션 수는 이미 빠져 있었습니다). 다음 요약은 core.py 이야기였고 1턴 내용은 하나도 없었습니다. A 세 세션 모두 맞는 값을 담은 요약은 그 첫 요약뿐이었고, 8턴 전에 그 요약은 수백 번 다른 요약으로 바뀌었습니다.
기억을 가른 것은 recall이었습니다
B에서 값은 사라진 적이 없습니다. 세 세션 모두 보관소에 setup_env.py의 원래 출력이 있었고, 35단계 설정 로그 사이에 세 값이 들어 있었습니다. 차이는 모델이 그것을 가지러 갔느냐였습니다.
| 세션 | 구간 전환 | recall 호출 | 8턴에 recall | 8턴 | 9턴 |
|---|---|---|---|---|---|
| B1 | 13 | 0 | 아니요 | 3개 중 0 | 3개 중 0 |
| B2 | 25 | 5 | 예 | 3개 중 3 | 3개 중 3 |
| B3 | 19 | 15 | 아니요 | 3개 중 0 | 3개 중 3 |
B2는 8턴에 "build_id p95_ms skipped_migrations"라는 질의로 recall을 불러 세 값을 모두 찾았습니다. B3는 세션 동안 recall을 15번 썼는데 대부분 2턴이었고, 8턴에는 찾아보지 않고 unknown을 적었습니다. 9턴에 힌트를 받고 나서야 recall을 불러 세 값을 다 찾았습니다. B1은 힌트를 받은 뒤에도 recall을 한 번도 부르지 않았습니다.
인계 메모에도 값은 실리지 않았습니다. 보관소 데이터베이스에 저장된 메모(세션별 13개, 24개, 19개) 중 빌드 ID를 담은 것은 하나도 없었습니다. 그러니 이 모델과 이 프롬프트에서 프록시는 정보를 안전하게 지켰지만, 다시 꺼내는 일은 모델이 스스로 검색하느냐에 달려 있었습니다. 앞서 나온 사실은 보관소에서 찾아보라고 시스템 프롬프트에 적어 주면 달라질 수도 있는데, 그런 프롬프트는 시험하지 않았습니다.
서버를 다시 켠 뒤 복원
프록시가 내건 또 하나의 약속은 재시작 뒤의 속도입니다. 긴 대화를 처음부터 다시 읽는 대신 llama-server가 저장된 상태를 불러옵니다. 이것은 따로 시험했고, 매번 GPU에 다른 작업이 없을 때만 시작했습니다. 한 번의 실행은 이렇게 진행했습니다. 프록시를 거쳐 정해진 크기의 대화를 만들고, 프록시가 상태를 저장하기를 기다린 다음, llama-server를 다시 켜고 프록시를 거쳐 후속 질문을 보냅니다. 그다음 서버를 한 번 더 다시 켜고 같은 후속 질문을 llama-server에 바로 보냅니다. 이쪽은 전부를 다시 읽어야 합니다. 시간은 요청을 보낸 순간부터 32토큰 답이 끝날 때까지입니다.
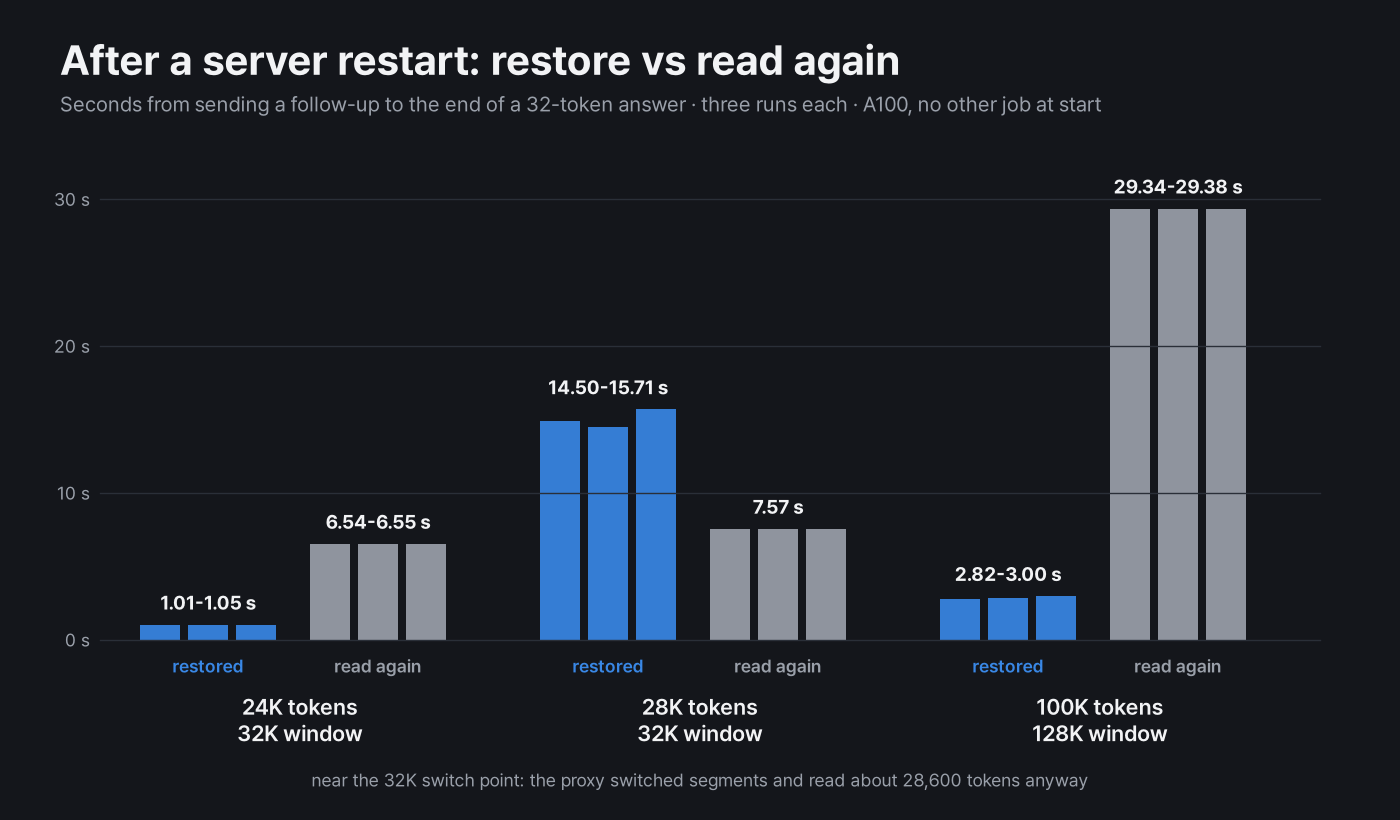
| 대화 크기 | 창 | 프록시로 복원 | 다시 읽기 | 상태 파일 |
|---|---|---|---|---|
| 24K 토큰 | 32K | 1.01-1.05초 | 6.54-6.55초 | 1.0GB |
| 28K 토큰 | 32K | 14.5-15.7초(구간 전환, 아래 설명) | 7.57초 | 2.4GB(저장 상태 두 개) |
| 100K 토큰 | 128K | 2.82-3.00초 | 29.3-29.4초 | 3.5GB |
24K는 구간 전환이 끼지 않는 복원을 보려고 함께 쟀습니다.
24K와 100K에서는 설명대로 복원이 됐습니다. 상태를 불러온 뒤 서버가 새로 처리한 토큰은 22개뿐이었고, 답은 매번 처음부터 다시 읽은 쪽과 같았습니다. 상태를 불러오는 데 걸린 시간만 따지면 24K에서 0.36-0.39초, 100K에서 약 1.08초였습니다. README는 110K에서 1.4초 대 약 50초를 보고하는데, 하드웨어가 다르고 README에 따르면 측정 대부분이 llama-server가 아니라 Strata에서 나왔습니다. 저희 A100과 llama-server에서 100K의 차이는 약 열 배였습니다.
28K 행은 복원이 아니라 경계에서 생긴 일을 보여 줍니다. 프록시는 첫 요청을 28,768 토큰으로 추정했고, 답을 위해 남겨 두는 4,096 토큰을 더하면 32,864로 32,768 토큰 창을 넘습니다. 그래서 첫 요청부터 구간 전환이 일어났고(첫 실행에서 인계 메모를 쓰는 데 11.8초가 걸렸습니다), 재시작 뒤 후속 질문에서 또 한 번 일어나 결국 약 28,600 토큰을 읽어야 했습니다. 상태 자체는 0.5초 안에 불러왔지만, 전환 때문에 요청 전체는 그냥 다시 읽는 것보다 느렸습니다. 2.4GB에는 전환 때 저장된 상태가 포함돼 있고, 자동 저장 하나는 1.2GB였습니다.
디스크도 꽤 씁니다. B 세션 하나가 남긴 저장 상태는 24.5-34.0GB였고, 보관소 자체는 9-12MB에 불과했습니다.
직접 써 보려면
- opencode 설정. README는
chunkTimeout: false를 권합니다. 그런데 opencode 2.0.32에서 이 값을 넣으면 opencode가 오류 없이 프로바이더를 통째로 빼 버렸습니다(로그에는provider.no-route만 남습니다).3600000처럼 큰 숫자를 넣으면 됐습니다. - 에이전트가 같은 파일을 계속 읽으면 요약을 열어 보십시오. 저희 실행에서 다시 읽기 루프는 압축을 켰을 때만 나왔습니다. 요약은 파일을 읽었다는 사실만 남기고 내용은 버렸습니다.
- 기억은 보관소에 있고, 모델이 검색할 때만 쓸모가 있습니다. 8턴에 힌트 없이 값을 찾으러
recall을 부른 세션은 셋 중 하나였습니다. - 전환 지점을 조심하십시오. 창 크기에 거의 닿은 대화는 다음 요청에서 구간 전환을 일으킬 수 있고, 그러면 복원이 빠르지 않습니다.
- 보관소는 평문입니다. 에이전트가 출력한 비밀값까지 도구 출력 그대로 저장되고, 프록시에는 인증이 없으므로 127.0.0.1에서만 듣게 해야 합니다(두 가지 모두 README에 나와 있습니다).
이 실험이 보여 주는 것과 보여 주지 않는 것
- 조건마다 세 세션, 과제 하나, 모델 하나, opencode 버전 하나입니다. 다른 모델은
recall을 더 많이 쓸 수도, 덜 쓸 수도 있습니다. - A100에서 돌렸고, 서버가 12GB 아래였는지만 확인했습니다. 세션 시간은 대략적인 값입니다.
- 모든 세션이 같은 seed를 썼고, C1과 C2는 요청 수와 캐시 재사용 비율까지 같았습니다.
- README 벤치마크를 재현한 것이 아닙니다. 과제와 채점 방식이 다릅니다.
- 큰 창은 압축을 끈 128K 하나만 봤습니다. 압축을 켠 128K나 그 사이 크기는 재지 않았습니다.
다음으로 알고 싶은 것은 시스템 프롬프트에 한 줄, 즉 앞선 도구 출력이 검색 가능한 보관소에 있다고 알려 주는 문장이 이 3분의 1을 바꾸는지입니다. 그 결과를 메일로 받고 싶으시면 아래 뉴스레터 양식을 이용해 주십시오.