DeerFlow 2.0 Multi-Agent 워크플로우 심화 — StateGraph, Plan-Execute, Human-in-the-Loop
DeerFlow의 LangGraph StateGraph 기반 Multi-Agent 워크플로우를 코드 수준에서 분석합니다. Supervisor 라우팅, Plan-Execute 패턴, 서브 에이전트 동적 생성.
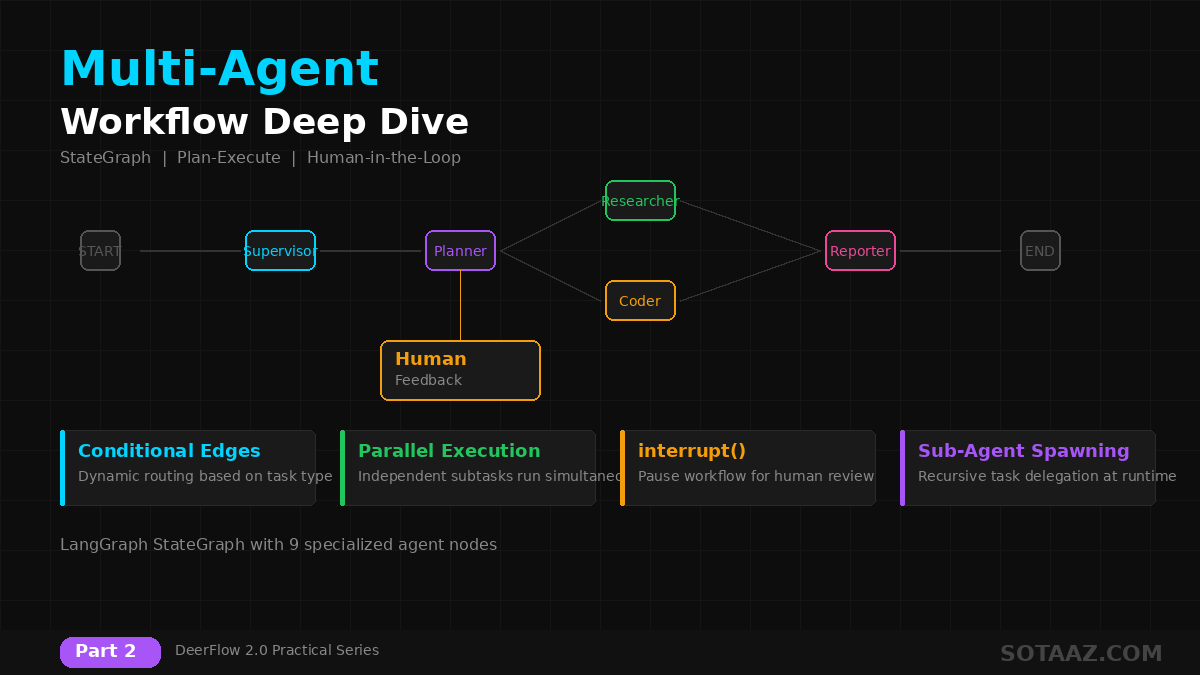
DeerFlow 2.0 Multi-Agent 워크플로우 심화 — StateGraph, Plan-Execute, Human-in-the-Loop
Part 1에서 DeerFlow의 전체 아키텍처와 설치를 다뤘습니다. 이번 글에서는 DeerFlow의 핵심인 Multi-Agent 워크플로우를 코드 수준에서 분석합니다.
DeerFlow가 복잡한 태스크를 어떻게 분해하고, 어떤 에이전트에게 위임하며, 결과를 어떻게 종합하는지 살펴봅니다.
1. LangGraph StateGraph 기초
DeerFlow의 워크플로우는 LangGraph StateGraph 위에 구축되어 있습니다.
StateGraph란?
StateGraph는 에이전트 간 흐름을 유향 그래프(directed graph)로 정의하는 도구입니다. 각 노드는 에이전트이고, 엣지는 상태 전이(transition)입니다.
from langgraph.graph import StateGraph, START, END

# 상태 정의
class AgentState(TypedDict):
    messages: list[BaseMessage]
    plan: list[dict]
    current_step: int
    results: dict

# 그래프 구성
workflow = StateGraph(AgentState)
workflow.add_node("supervisor", supervisor_node)
workflow.add_node("researcher", researcher_node)
workflow.add_node("coder", coder_node)
workflow.add_node("reporter", reporter_node)

# 엣지 정의
workflow.add_edge(START, "supervisor")
workflow.add_conditional_edges("supervisor", route_to_agent)
workflow.add_edge("reporter", END)
DeerFlow의 상태 구조
DeerFlow는 이 기본 패턴을 확장하여 9개 노드를 연결합니다. 상태 객체에는 다음이 포함됩니다:
messages— 에이전트 간 메시지 이력plan— Planner가 생성한 실행 계획current_step— 현재 실행 중인 단계results— 각 에이전트의 출력 결과memory— 영구 메모리 컨텍스트artifacts— 생성된 파일/문서
2. Supervisor: 오케스트레이션의 중심
Supervisor는 DeerFlow 워크플로우의 진입점이자 의사결정자입니다.
역할
- 태스크 분석: 사용자 입력을 파싱하여 의도 파악
- 계획 생성: 구조화된 실행 계획 수립
- 에이전트 선택: 각 서브태스크에 적합한 에이전트 배정
- 결과 검증: 서브태스크 결과를 검토하고 재실행 여부 결정
Supervisor의 의사결정 흐름
def supervisor_node(state: AgentState) -> AgentState:
    # 1. 태스크 분석
    task_analysis = llm.invoke(
        f"Analyze this task and determine the best approach: {state['messages'][-1]}"
    )

    # 2. 라우팅 결정
    if task_analysis.requires_research:
        return {"next": "researcher"}
    elif task_analysis.requires_code:
        return {"next": "coder"}
    elif task_analysis.is_complex:
        return {"next": "planner"}  # 복잡한 태스크 → Planner로 위임
    else:
        return {"next": "reporter"}  # 단순 태스크 → 바로 보고서
라우팅 패턴
Supervisor는 조건부 엣지(conditional edges)를 통해 다음 에이전트를 결정합니다:
| 태스크 유형 | 라우팅 대상 | 예시 |
|---|---|---|
| 단순 질문 | Reporter 직접 | "DeerFlow란?" |
| 리서치 필요 | Researcher | "최신 AI 트렌드 조사" |
| 코딩 필요 | Coder | "Python 스크립트 작성" |
| 복합 태스크 | Planner | "보고서 작성 + 코드 실행" |
| 확인 필요 | Human Feedback | "이 접근이 맞나요?" |
3. Planner: 태스크 분해
복잡한 태스크는 Planner가 더 작은 단위로 분해합니다.
Plan-Execute 패턴
DeerFlow는 Plan-Execute 패턴을 사용합니다:
- Plan: 전체 태스크를 서브태스크 목록으로 분해
- Execute: 각 서브태스크를 적합한 에이전트가 순차/병렬 실행
- Verify: 결과를 검증하고 필요시 재실행
# Planner가 생성하는 계획 구조
plan = {
    "goal": "AI 에이전트 프레임워크 비교 보고서 작성",
    "steps": [
        {
            "id": 1,
            "agent": "researcher",
            "task": "DeerFlow 2.0 기능 및 아키텍처 조사",
            "depends_on": [],
        },
        {
            "id": 2,
            "agent": "researcher",
            "task": "CrewAI, AutoGen, LangGraph 기능 조사",
            "depends_on": [],  # step 1과 병렬 실행 가능
        },
        {
            "id": 3,
            "agent": "analyst",
            "task": "수집된 데이터를 비교 표로 정리",
            "depends_on": [1, 2],  # step 1, 2 완료 후 실행
        },
        {
            "id": 4,
            "agent": "reporter",
            "task": "최종 비교 보고서 작성",
            "depends_on": [3],
        },
    ],
}
병렬 실행
depends_on이 비어있거나 이미 완료된 스텝만 참조하면 병렬 실행됩니다. 위 예시에서 step 1과 step 2는 동시에 실행됩니다.
Step 1 (Researcher) ─┐
                     ├→ Step 3 (Analyst) → Step 4 (Reporter)
Step 2 (Researcher) ─┘
4. 에이전트 노드 상세
4-1. Researcher
웹 검색을 통해 정보를 수집하고 인용을 포함합니다.
사용 도구:
- Tavily/Brave/DuckDuckGo 검색
- Arxiv 논문 검색
- 웹 크롤링
출력 형식:
{
  "findings": [
    {
      "title": "DeerFlow 2.0 Architecture",
      "summary": "...",
      "source": "https://...",
      "relevance": 0.95
    }
  ],
  "citations": ["[1] https://..."]
}
4-2. Coder
샌드박스 내에서 코드를 실행합니다.
사용 도구:
bash— 셸 명령write_file— 파일 생성read_file— 파일 읽기str_replace— 파일 수정
# Coder 에이전트의 코드 실행 흐름
def coder_node(state: AgentState) -> AgentState:
    # 1. 코드 생성
    code = llm.invoke(f"Write code for: {state['current_task']}")

    # 2. 샌드박스에서 실행
    result = sandbox.execute(code)

    # 3. 에러 시 자동 수정
    if result.error:
        fixed_code = llm.invoke(f"Fix this error: {result.error}\nCode: {code}")
        result = sandbox.execute(fixed_code)

    return {"results": {state["current_step"]: result}}
4-3. Analyst
데이터 분석과 시각화를 담당합니다.
- 수집된 데이터를 구조화
- 비교 표, 차트 생성
- 통계적 인사이트 도출
4-4. Reporter
모든 결과를 종합하여 최종 결과물을 생성합니다.
- 마크다운 보고서
- 인용 포함
- 구조화된 섹션 (요약, 본문, 결론)
5. Human-in-the-Loop
DeerFlow는 LangGraph의 interrupt() 기능을 활용하여 사람의 개입을 지원합니다.
인터럽트 지점
from langgraph.types import interrupt

def human_feedback_node(state: AgentState) -> AgentState:
    # 워크플로우 일시 중지 — 사람의 응답을 기다림
    feedback = interrupt({
        "question": "이 계획대로 진행할까요?",
        "plan": state["plan"],
        "options": ["approve", "modify", "reject"],
    })

    if feedback["decision"] == "approve":
        return {"next": "execute"}
    elif feedback["decision"] == "modify":
        return {"next": "planner", "modifications": feedback["notes"]}
    else:
        return {"next": END}
활용 시나리오
- 계획 검토: 복잡한 태스크의 실행 계획을 사람이 승인
- 중간 결과 확인: 리서치 결과가 올바른 방향인지 확인
- 위험한 작업 승인: 파일 삭제, 외부 API 호출 등
- 품질 게이트: 최종 보고서 발행 전 검토
웹 UI에서의 동작
DeerFlow UI에서는 인터럽트가 발생하면 채팅에 승인 요청이 표시됩니다. 사용자가 승인/수정/거부를 선택하면 워크플로우가 재개됩니다.
6. 서브 에이전트와 동적 생성
DeerFlow의 강력한 기능 중 하나는 런타임에 서브 에이전트를 생성하는 것입니다.
Task 도구
Supervisor나 다른 에이전트가 Task 도구를 호출하면 새로운 서브 에이전트가 생성됩니다:
# Task 도구 호출 예시
task_result = task_tool.invoke({
    "description": "Research the latest developments in DeerFlow",
    "agent_type": "researcher",
    "context": "Focus on v2.0 architecture changes",
})
서브 에이전트의 특징
- 격리된 컨텍스트: 각 서브 에이전트는 독립적인 상태를 가짐
- 병렬 실행: 여러 서브 에이전트가 동시에 실행 가능
- 결과 합성: 부모 에이전트가 서브 에이전트의 결과를 수집하고 종합
재귀적 위임
서브 에이전트도 다시 Task 도구를 호출할 수 있습니다. 이를 통해 복잡한 태스크를 재귀적으로 분해할 수 있지만, 무한 재귀를 방지하기 위해 깊이 제한이 있습니다.
7. 에러 처리와 복구
재시도 메커니즘
에이전트 실행이 실패하면 DeerFlow는 자동으로 재시도합니다:
- LLM 호출 실패: 지수 백오프로 재시도
- 도구 실행 실패: 에러 메시지를 LLM에 전달하여 대안 생성
- 타임아웃: 장시간 실행 태스크의 타임아웃 처리
폴백 전략
# 에러 발생 시 Supervisor가 대안을 결정
def handle_agent_failure(state: AgentState) -> AgentState:
    error = state["last_error"]

    if error.type == "tool_error":
        # 대안 도구 사용
        return {"next": "retry_with_alternative_tool"}
    elif error.type == "timeout":
        # 태스크를 더 작은 단위로 분해
        return {"next": "planner", "instruction": "Break this into smaller steps"}
    else:
        # 사람에게 도움 요청
        return {"next": "human_feedback"}
8. 커스텀 워크플로우 만들기
DeerFlow의 기본 워크플로우를 확장하여 커스텀 에이전트를 추가할 수 있습니다.
커스텀 에이전트 노드 추가
from deerflow.harness import register_agent

@register_agent("translator")
def translator_node(state: AgentState) -> AgentState:
    """번역 에이전트 — 리서치 결과를 다국어로 번역"""
    content = state["results"].get("reporter", "")

    translated = llm.invoke(
        f"Translate the following report to Korean:\n\n{content}"
    )

    return {"results": {"translator": translated}}
워크플로우에 노드 연결
# 기존 워크플로우에 번역 에이전트 추가
workflow.add_node("translator", translator_node)
workflow.add_edge("reporter", "translator")
workflow.add_edge("translator", END)
정리
이 글에서 다룬 내용:
- LangGraph StateGraph — DeerFlow 워크플로우의 기반
- Supervisor — 오케스트레이션의 중심, 조건부 라우팅
- Plan-Execute 패턴 — 복잡한 태스크의 분해와 병렬 실행
- 9개 에이전트 노드 — 각각의 역할과 도구
- Human-in-the-Loop —
interrupt()기반 사람 개입 - 서브 에이전트 — 동적 생성과 재귀적 위임
- 에러 처리 — 재시도, 폴백, 사람에게 에스컬레이션
다음 글에서는 커스텀 스킬, MCP 서버 연동, 샌드박스 시스템을 다룹니다. 나만의 도구를 만들고, 외부 서비스를 연결하고, 격리된 환경에서 코드를 실행하는 방법을 알아봅니다.
이 글은 DeerFlow 2.0 실전 시리즈의 Part 2입니다.
- Part 1: DeerFlow 2.0 소개 + 설치 + 첫 태스크
- Part 2: Multi-Agent 워크플로우 심화 (이 글)
- Part 3: 커스텀 스킬 + MCP + 샌드박스
- Part 4: 프로덕션 배포 + 메시지 게이트웨이
여기서 쓴 코드 전체와 연습문제 풀이는 LLM Agent Cookbook에 있습니다.
이메일로 받아보기
관련 포스트
OpenClaw vs DeerFlow 2.0 — 개인 AI 비서 vs 멀티 에이전트 런타임, 뭐가 다른가?
OpenClaw(333K 스타)과 DeerFlow 2.0(40K 스타) 비교. 개인 AI 집사 vs AI 리서치 팀, 아키텍처·채널·스킬·실전 벤치마크 전면 비교.
AgentScope 프로덕션 배포 — Runtime, 모니터링, 스케일링
agentscope-runtime Docker 배포, OpenTelemetry 트레이싱, AgentScope Studio, RL 파인튜닝, 프로덕션 체크리스트.
AgentScope 실시간 음성 에이전트 — 3가지 음성 AI 앱 직접 만들기
음성 챗봇, AI 동시통역기, 음성 CS 봇 — RealtimeAgent + Gradio로 3가지 실전 음성 앱 직접 구축.