8GB VRAM에서 오디오 포함 10초 영상을? FreeVideo(MiniMax H3) 엔진을 뜯어봤습니다
MiniMax H3(오디오 포함)를 8GB VRAM에서 돌린다는 FlashML-org/FreeVideo의 소스코드와 Adaptive Execution Planner를 직접 실행해 9개 하드웨어 조합을 비교하고, 공식 커뮤니티 실측 146건을 집계했습니다. 8GB+16GB에서는 10초 영상 1편에 SSD 76.1GB·PCIe 173GB를 읽으며, RAM만 32GB로 올려도 SSD 읽기가 0GB로 사라집니다.

로컬 AI 영상 생성은 오랫동안 24GB~80GB GPU의 전유물이었습니다. 그런데 FlashML-org/FreeVideo가 8GB VRAM + 16GB RAM에서 오디오까지 함께 생성하는 MiniMax H3(OpenVDN 8-step VDN-H3)를 돌린다고 발표하면서 관심이 쏟아지고 있습니다. 최근에는 Claude Code·Codex 같은 AI 에이전트가 타임라인 편집까지 수행하는 v0.4.0과 16MP 로컬 이미지 생성(H3 Image)을 넣은 v0.5.0까지 연달아 나왔습니다.
"8GB에서 진짜 돌아가긴 하는데, 안에서 대체 무슨 일이 벌어지길래 가능한가? 그리고 실제로 10초 영상 하나 뽑는 데 몇 분이나 걸리는가?" 이 질문에 답하려고 FreeVideo 저장소를 직접 받아 내장 실행 계획기(freevideo_engine.prediction_cli)를 9개 하드웨어 조합으로 실행하고, 공식 저장소에 쌓인 커뮤니티 실측 리포트 146건(docs/community-results.md)을 전수 집계했습니다.
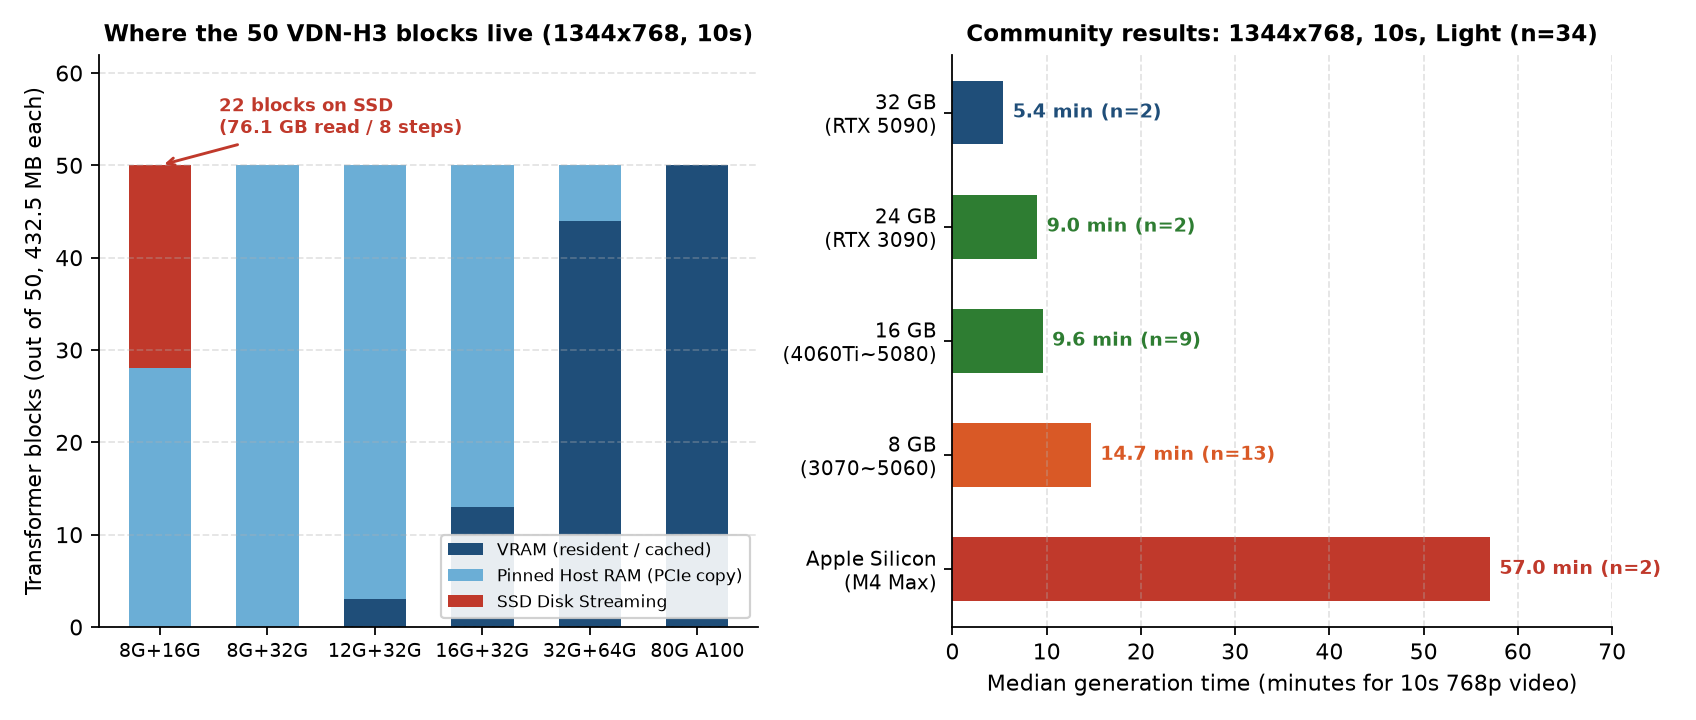
결론부터 말하면, 8GB에서 돌아가는 것은 마법이 아니라 극단적인 3계층 스트리밍(VRAM → Pinned RAM → SSD) 덕분입니다. 1344×768 10초 영상(243프레임, 72,576 비디오 토큰, 8스텝) 기준으로 8GB VRAM + 16GB RAM에서는 트랜스포머 50개 블록(21.6GB) 중 VRAM에 상주하는 블록이 0개입니다. 28개는 RAM에 고정하고 나머지 22개는 매 스텝 SSD에서 다시 읽어 들입니다. 영상 1편을 뽑는 동안 SSD에서 76.1GB를 읽고 PCIe로 173.0GB를 실어 나릅니다. 반대로 GPU는 그대로 8GB를 두고 시스템 RAM만 16GB에서 32GB로 올리면 SSD 읽기가 0GB로 완전히 사라집니다.
아래에서는 FreeVideo 실행 계획기가 9개 하드웨어 조합에 내린 실제 배치표, 메모리 절약 기법 5가지, 커뮤니티 146건 실측 기준 GPU·맥북별 실제 생성 시간, 그리고 설치 전 반드시 확인해야 할 디스크·드라이버 조건을 정리합니다.
50개 블록이 VRAM·RAM·SSD를 오가는 실제 배치표
VDN-H3 트랜스포머는 50개 블록(블록당 432.5MB, 합계 약 21.6GB)으로 이루어져 있습니다. FreeVideo의 prediction_cli에 1344×768, 10초(243프레임, 8스텝) 조건을 넣고 VRAM과 RAM 용량만 바꿔 가며 실제 실행 계획을 뽑았습니다.
| 하드웨어 (VRAM + RAM) | VRAM 상주/캐시 | RAM 고정 (Pinned) | SSD 스트리밍 | Prefetch | Head Chunk | 8스텝 PCIe 전송 | 8스텝 SSD 읽기 |
|---|---|---|---|---|---|---|---|
| 8 GB + 16 GB | 0 블록 | 28 (12.35 GB) | 22 블록 | OFF | 4 | 173.0 GB | 76.1 GB |
| 8 GB + 32 GB | 0 블록 | 50 (21.62 GB) | 0 블록 | OFF | 4 | 173.0 GB | 0.0 GB |
| 12 GB + 16 GB | 3 블록 | 28 (12.35 GB) | 19 블록 | ON | 16 | 162.6 GB | 65.7 GB |
| 12 GB + 32 GB | 3 블록 | 47 (20.33 GB) | 0 블록 | ON | 16 | 162.6 GB | 0.0 GB |
| 16 GB + 32 GB | 8+ 블록 | 37 (16.00 GB) | 0 블록 | ON | 16 | 145.3 GB | 0.0 GB |
| 24 GB + 64 GB | 8+ 블록 | 17 (7.35 GB) | 0 블록 | ON | 28 | 145.3 GB | 0.0 GB |
| 32 GB + 64 GB | 8+ 블록 | 6 (2.60 GB) | 0 블록 | ON | 56 | 145.3 GB | 0.0 GB |
| 80 GB + 128 GB (A100) | 50 블록 | 0 (0.00 GB) | 0 블록 | ON | 56 | 0.0 GB | 0.0 GB |
(참고: 16~32GB 구간에서 resident_blocks 기본 하한은 8이지만, 2-pass 첫 패스에서 VRAM 여유분에 추가 블록을 캐시하므로 RAM 고정 블록 수가 37 → 17 → 6으로 줄어듭니다.)
표에서 실무적으로 가장 중요한 변곡점이 세 곳 보입니다.
- 8GB GPU에서 가장 큰 업그레이드는 GPU가 아니라 RAM 32GB입니다. 8GB+16GB에서는 22개 블록이 RAM에 못 들어가 8스텝 동안 SSD를 76.1GB나 읽습니다. RAM만 32GB로 늘리면 SSD 읽기가 0GB로 떨어집니다.
- 12GB VRAM에서 실행 엔진 성격이 바뀝니다. 8GB에서는 비동기
prefetch가 꺼지고 어텐션head_chunk도 4로 쪼개집니다. 12GB로 올라가면 비동기prefetch가 켜지고(연산과 PCIe 전송 중첩),head_chunk도 16으로 4배 넓어집니다. - 24GB·32GB에서는 어텐션 병렬도가 확 열립니다.
head_chunk가 28(24GB), 56(32GB)으로 커지면서 72,576개 비디오 토큰의 어텐션 오버헤드가 크게 줄어듭니다.
소스코드(adaptive.py)에서 확인한 메모리 절약 기법 5가지
FreeVideo가 기존 ComfyUI 영상 워크플로우보다 OOM이 덜 나는 이유는 단순 오프로딩이 아니라 다섯 가지 장치를 엮어 놓았기 때문입니다.
- 텍스트 인코더 프로세스 격리: 텍스트 인코더를 아예 별도 자식 프로세스에서 돌리고 결과를 저장한 뒤 프로세스를 종료합니다. 트랜스포머가 올라올 때 텍스트 인코더 메모리가 단 1MB도 남지 않습니다.
- Video DeltaNet 하이브리드 어텐션 + 8스텝 증류: 기반 모델인 OpenVDN VDN-H3는 전체 어텐션 대신 선형 DeltaNet과 하이브리드 어텐션을 결합해 8스텝만으로 10초 영상을 뽑습니다. 스텝 수가 30~50스텝에서 8스텝으로 줄어드니 오프로딩 전송 횟수 자체가 4~6배 줄어듭니다.
- GPU 세대별 GEMM 자동 분기: FP8 텐서 코어가 없는 Ampere(RTX 30 시리즈·A100)와 일부 GeForce 카드에서는 int8 + ConvRot 회전 양자화 경로를, Ada(SM89)·Hopper(SM90)·Blackwell(SM120)에서는 FP8 경로를 자동으로 고릅니다.
- 36개 블록 VAE 디코더 스트리밍: 영상 생성만큼 OOM이 잦은 구간이 마지막 VAE 디코딩입니다. FreeVideo는 20 GiB 미만 VRAM에서 36개 VAE 블록(블록당 268.6MB) 중
floor((VRAM - 3.25 GiB) / 268.6 MB)개만 상주시키고 나머지를 스트리밍합니다. - OOM 자동 복구 +
resource-history.sqlite3자가 학습: 실행 중 OOM이 나면 최대 2회 새 프로세스에서 재시도합니다. 먼저 블록 배치를 줄이고, 그래도 모자라면head_chunk→ FF/projection 청크 → 어텐션 출력 CPU 스테이징 순으로 축소하며, 성공한 설정과 소요 시간을 SQLite에 저장해 다음 요청부터 바로 적용합니다.
커뮤니티 실측 146건 집계: 실제로 10초 영상 뽑는 데 몇 분 걸리나
공식 저장소의 커뮤니티 진단 리포트 146건 가운데, 조건이 동일한 1344×768(또는 768×1344), 10초(9.5~10.8초), Light 품질 34건만 추려 VRAM 등급별로 집계했습니다.
| 하드웨어 등급 | 표본 수 | 중앙값 (10초 768p) | 최단 ~ 최장 | 포함 GPU 예시 |
|---|---|---|---|---|
| 32 GB NVIDIA | 2건 | 5.4분 (324초) | 4.2분 ~ 6.7분 | RTX 5090 *(공식 2-pass 최단 2.0분)* |
| 24 GB NVIDIA | 2건 | 9.0분 (540초) | 6.3분 ~ 11.7분 | RTX 3090 |
| 16 GB NVIDIA | 9건 | 9.6분 (575초) | 4.0분 ~ 18.5분 | RTX 5080(4.0분), 5060 Ti, 4060 Ti |
| 8 GB NVIDIA | 13건 | 14.7분 (882초) | 9.8분 ~ 21.1분 | RTX 4070 Laptop, 3070, 4060, 5060 |
| 12 GB NVIDIA | 6건 | 16.9분 (1,012초) | 6.2분 ~ 27.7분 | RTX 5070 Ti Laptop(6.2분), 3060(최장) |
| Apple Silicon (Unified) | 2건 | 57.0분 (3,422초) | 56.7분 ~ 57.4분 | M4 Max (64~128 GB) |
실측 표가 현실을 냉정하게 보여 줍니다.
- 8GB NVIDIA에서 10초 768p 영상은 약 15분 걸립니다. "돌아가긴 한다"는 주장은 사실이지만, 프롬프트를 10번 고쳐가며 실시간으로 작업하기보다는 프리뷰(v0.3.2 반해상도 1차 패스)로 구도를 확인한 뒤 마음에 드는 컷만 밤새 배치로 돌리는 용도에 가깝습니다.
- 16GB 이상 최신 세대(RTX 5060 Ti / 5080 / 5090)부터는 4~9분대로 들어와 실무 프로토타입 용도로 체감이 확 달라집니다.
- Apple Silicon Mac은 아직 프리뷰 단계입니다. M4 Max(64~128GB)에서 10초 768p에 57분이 걸려 8GB NVIDIA 노트북보다 3.9배 느립니다. 맥에서 쓰려면 960×544, 5초 클립(M5 Pro 48GB 기준 8.8분) 수준으로 타협해야 합니다.
설치 전 반드시 체크할 3가지 현실 조건
- 디스크 여유 공간: 기본 영상 모델 팩(트랜스포머 약 21.6GB + 텍스트 인코더 + VAE/오디오 디코더 + ComfyUI 런타임)만으로도 최소 40~50GB 이상 비워 두어야 안전합니다. 여기에 v0.4.0의 배경 음악 생성 모델(약 20GB)과 음성 더빙 모델(약 4.9GB)까지 쓰면 70GB 이상 필요합니다.
- Linux 드라이버 버전:
docs/Linux.md기준 NVIDIA 드라이버 580 이상이 필수입니다. 구형 드라이버가 깔린 서버에서는./setup.sh단계에서 막힙니다. - 헤드리스 CLI & 에이전트 연동: ComfyUI 브라우저 화면 없이도 터미널에서 바로 뽑을 수 있습니다.
git clone https://github.com/FlashML-org/FreeVideo.git && cd FreeVideo
./setup.sh

# 설치 전 내 장비의 블록 배치만 먼저 확인하려면
./freevideo plan --vram-gib 8 --ram-gib 32 --width 1344 --height 768 --seconds 10

# CLI 직접 생성
./freevideo generate --prompt-file prompt.txt --out video.mp4
결론: 누가 로컬에서 쓰고, 누가 API를 쓰는 게 나을까
- 로컬 FreeVideo가 맞는 경우: RTX 4060 Ti/5060 Ti 16GB 이상(또는 8GB GPU + 32GB RAM)을 이미 갖고 있고, 월 수십 편 이상 시안을 뽑거나, 사내 보안·커스텀 LoRA·에이전트 자동 편집(v0.4.0)이 필요한 팀.
- 클라우드 영상 API가 나은 경우: 8GB + 16GB 노트북이나 Apple Silicon 맥북에서 하루 1~2편씩 빠르게 결과물을 받아야 하는 경우. SSD 76GB를 긁으며 15~57분을 기다리는 시간 비용이 API 크레딧 몇 달러보다 훨씬 비쌉니다.