GPT-2의 GELU를 ReLU²로 바꾸니 10억 토큰 뒤 loss가 0.051 낮았습니다
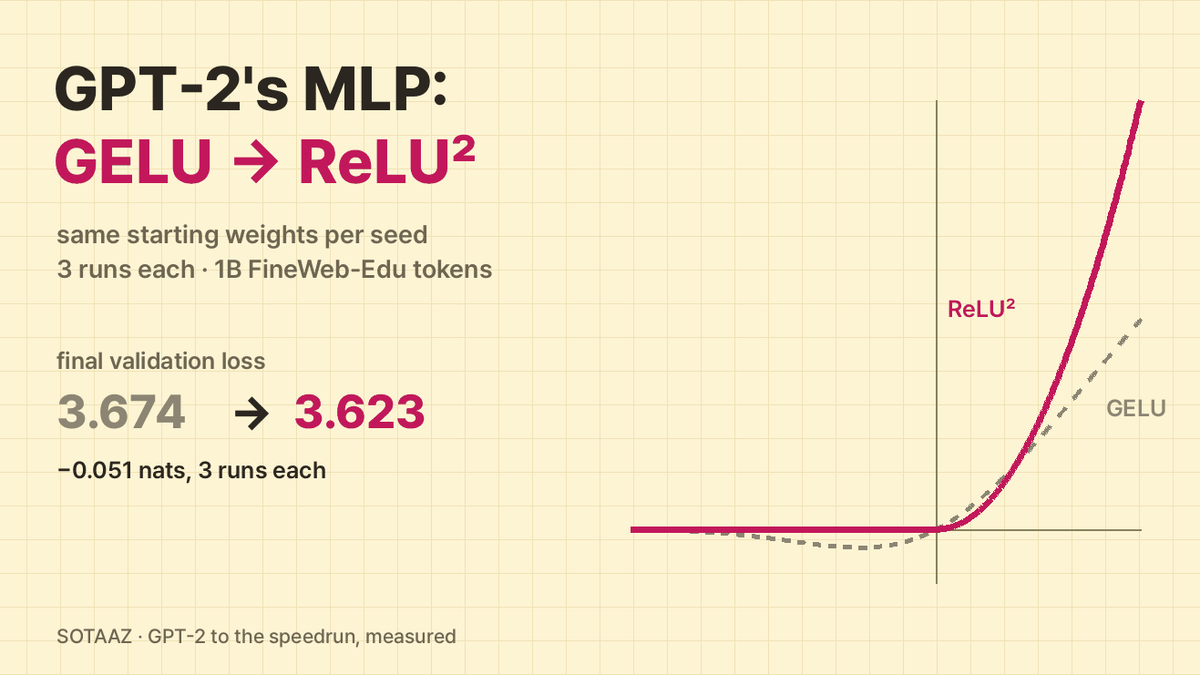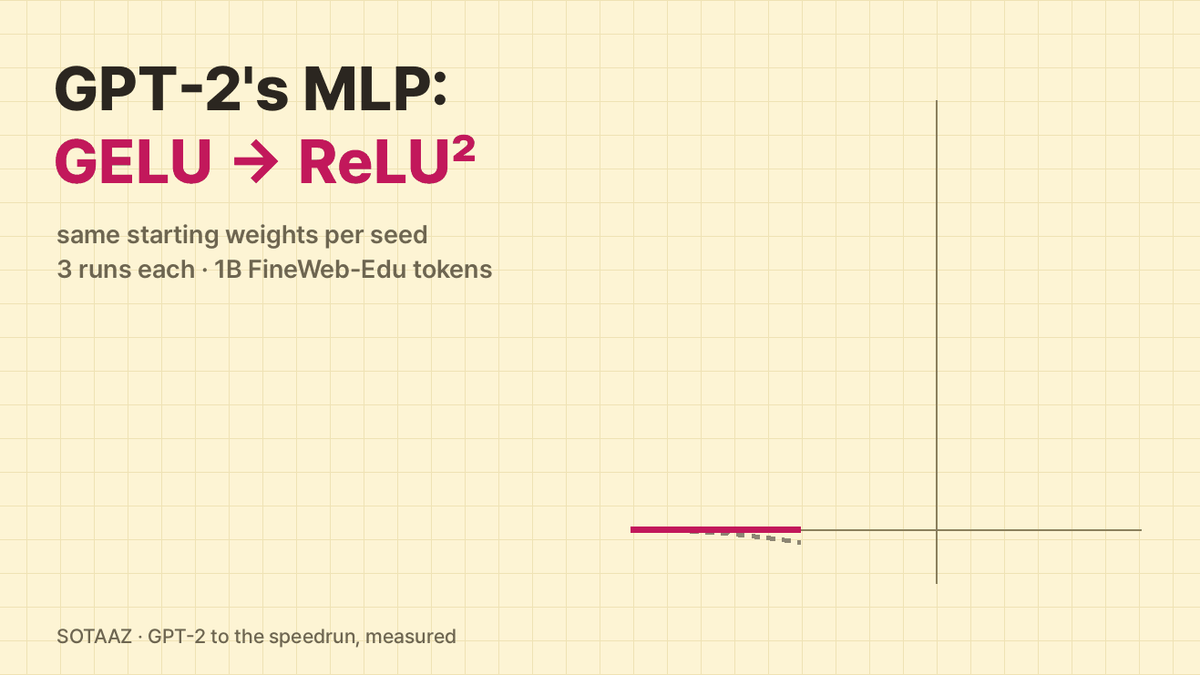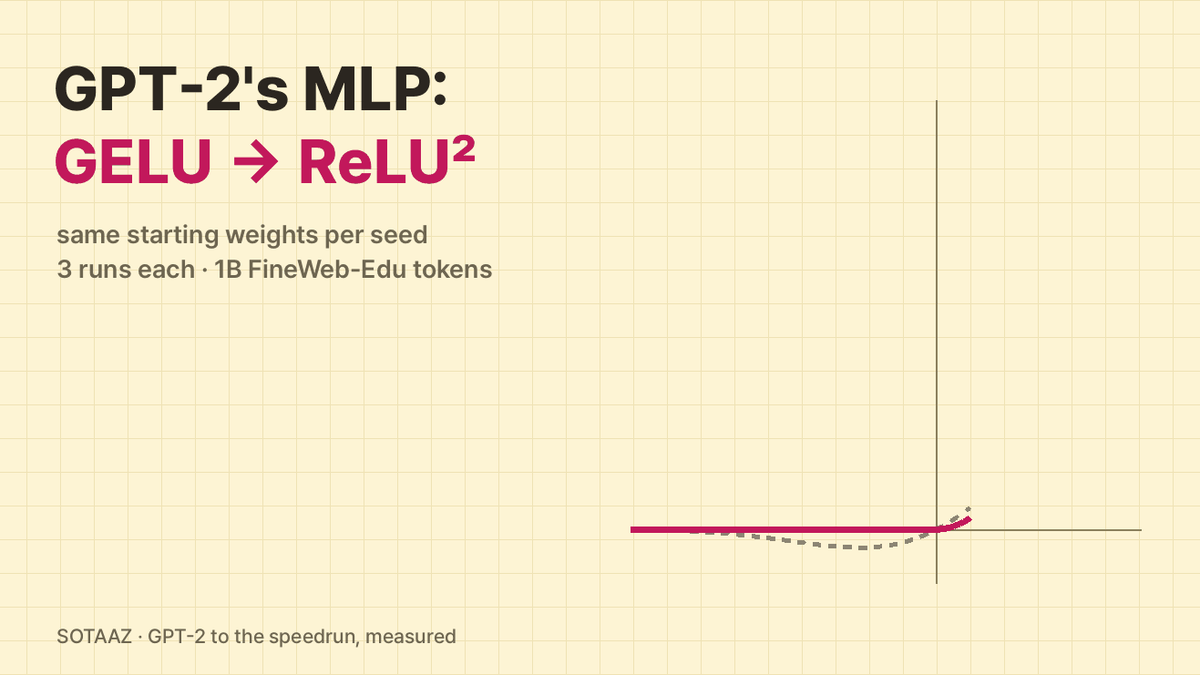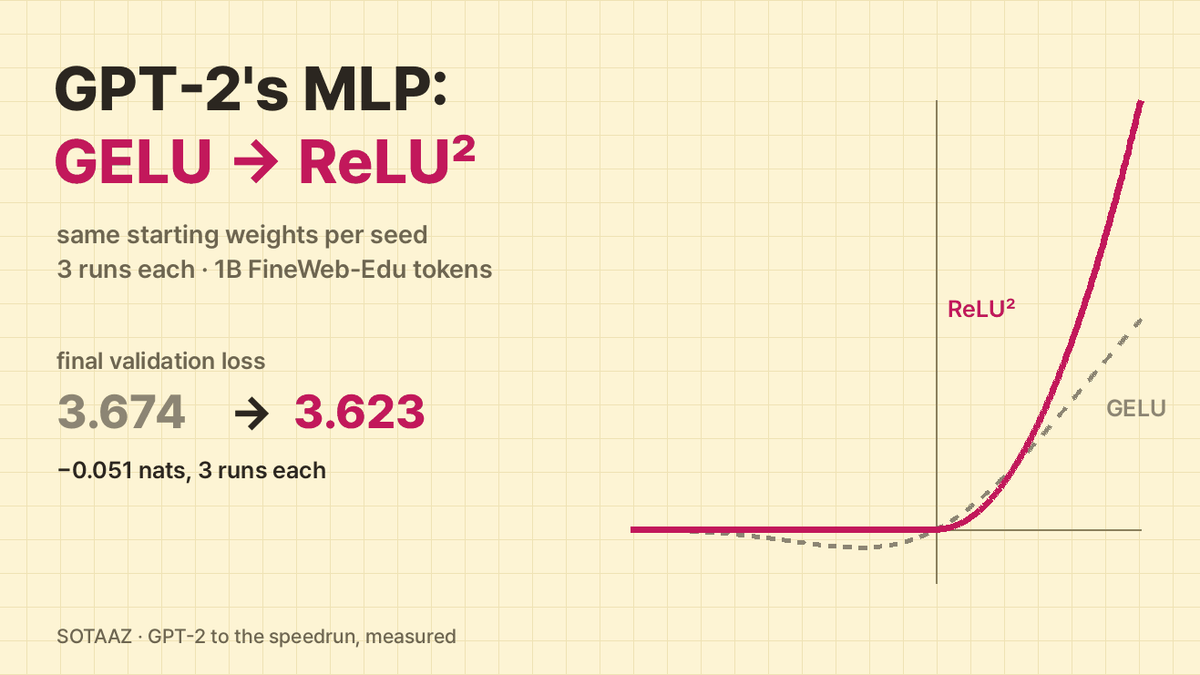
GPT-2(124M) MLP의 활성화 함수를 GELU에서 ReLU²로 바꾸고 나머지는 그대로 둔 채 세 번씩 학습했습니다. FineWeb-Edu 10억 토큰 뒤 평균 검증 loss는 ReLU² 3.623, GELU 3.674였습니다. 짝마다 처음 가중치까지 같아 활성화 함수만 달랐고, 차이는 미리 정한 기준(0.010)의 다섯 배였습니다.
GPT-2의 GELU를 ReLU²로 바꾸니 10억 토큰 뒤 loss가 0.051 낮았습니다
GPT-2의 MLP 블록 안에는 활성화 함수가 하나 있습니다. 원래는 GELU(tanh 근사)인데, 저희는 이것을 ReLU²로 바꿨습니다. ReLU²는 음수 입력을 0으로 만들고 양수 입력은 제곱하는 함수입니다. 다른 것은 바꾸지 않았습니다. MLP 폭, 파라미터 수, 학습 데이터 10억 토큰과 그 순서, 학습률이 모두 같습니다.
두 버전을 세 번씩 학습한 뒤 검증 loss를 비교했습니다. 검증 loss는 학습에 쓰지 않은 글에서 모델이 다음 토큰을 얼마나 잘 맞히는지 나타내는 값이고, 낮을수록 좋습니다. ReLU² 쪽은 평균 3.623, GELU 쪽은 3.674로 끝났습니다.
차이는 0.051입니다. 이 연재는 비교마다 얼마나 차이가 나야 실제 차이로 볼지를 미리 정해 둡니다. 이번 비교의 기준은 0.010이었으니, 차이가 기준의 다섯 배쯤 됩니다.
이번 비교는 지금까지 연재에서 다른 조건이 가장 적게 섞인 비교이기도 합니다. 학습은 난수로 정한 처음 가중치에서 시작하고, 그 난수를 정하는 번호를 시드라고 부릅니다. 활성화 함수에는 학습할 파라미터가 없어서, 같은 시드를 쓰면 두 버전이 정확히 같은 가중치에서 출발합니다. 실행 기록으로도 확인했습니다. 그러니 짝마다 처음부터 끝까지 다른 것은 MLP의 두 행렬 사이에서 숫자를 어떻게 바꾸느냐 하나뿐입니다.
요약
- ReLU²가 GELU보다 0.051 낮게 끝났습니다(3.623과 3.674, 조건마다 3회). 기준은 0.010이었습니다.
- 여덟 개 평가 지점 모두에서 ReLU² 세 실행이 GELU 세 실행보다 낮았습니다. 같은 처음 가중치에서 출발한 짝끼리 보면, 시드마다 ReLU² 쪽이 0.048에서 0.057 낮았습니다.
- 차이는 학습 초반에 가장 컸고, 끝날 때까지 줄어들고 있었습니다. 2.6억 토큰에서 0.144, 5.2억 토큰에서 0.074, 10억 토큰에서 0.051이었습니다. 더 오래 학습하면 어디서 멈출지는 이번 실행으로 알 수 없습니다.
- 속도 차이는 측정되지 않았습니다. ReLU² 실행 셋 가운데 둘은 GELU보다 2.2% 빨랐고, 하나는 실행 도중 다른 작업들이 GPU를 같이 써서 느려졌습니다. 이 연재에서 같은 설정의 실행끼리도 처리량이 3%까지 벌어진 적이 있어서, 2.2%를 속도 이득으로 세지 않습니다.
무엇을 바꿨는지
모델은 앞 글들과 같은 GPT-2 small입니다. 12층, 폭 768, 헤드 12개, 문맥 1,024토큰이고, 위치 정보는 학습되는 표로 넣고, 정규화는 LayerNorm이며, 입력 임베딩과 출력층이 행렬을 같이 씁니다. MLP 블록은 768차원을 3,072차원으로 넓힌 뒤 활성화 함수를 거쳐 다시 768차원으로 줄입니다.
| GELU(GPT-2) | ReLU² | |
|---|---|---|
| 함수 | x · Φ(x), tanh 근사 | max(0, x)² |
| 음수 입력 | 작은 음수 출력(가장 낮을 때 약 −0.17) | 정확히 0 |
| 파라미터 수 | 124,475,904 | 124,475,904 |
| 시드 0, 1, 2의 처음 가중치 | GELU와 같음(기록의 해시가 일치) |
나머지는 앞 글들과 같습니다. FineWeb-Edu 데이터를 같은 순서로 읽고, 524,288토큰짜리 스텝을 1,907번(10억 토큰) 돌렸습니다. 옵티마이저는 AdamW, 최대 학습률 6e-4, 워밍업 100스텝 뒤 코사인으로 10%까지 줄였고, bfloat16으로 A100 80GB 두 장에서 학습했습니다. GELU 쪽은 계획대로 첫 측정 글의 세 실행을 그대로 썼습니다.
실행 전에 두 버전이 같은 loss에서 출발하는지 CPU에서 확인했습니다. 앞 글들과 같은 4,096토큰에서 초기 loss는 시드 0이 GELU 10.940, ReLU² 10.950이었고, 시드 1이 11.031과 11.035였습니다.
실행 전에 정한 판정 규칙
질문과 실행, 판정 규칙은 10월 7일 13시 16분에 적어 두었습니다. 첫 ReLU² 실행은 그다음 날인 10월 8일 8시 56분에 시작했습니다. 규칙은 앞 글들과 같습니다. 두 조건의 평균 최종 loss 차이가 2 × σ × √(1/3 + 1/3)보다 클 때만 차이로 봅니다. σ는 시드를 바꿨을 때 결과가 퍼지는 정도(표준편차)이고, 지금까지 연재에서 비교한 모든 설정(GELU, RoPE, RMSNorm, RMSNorm+QK norm, ReLU²)의 값을 합쳐서 구합니다. 판정 스크립트는 ReLU² 실행이 짝이 되는 GELU 실행과 같은 가중치에서 출발하지 않았으면 계산을 멈추도록 해 두었습니다.
| 최종 검증 loss, 시드 0 / 1 / 2 | 평균 | 표준편차 | |
|---|---|---|---|
| GELU | 3.6681, 3.6858, 3.6690 | 3.6743 | 0.0100 |
| ReLU² | 3.6192, 3.6289, 3.6208 | 3.6230 | 0.0052 |
합친 σ는 0.00629(자유도 10)이고, 기준은 2 × 0.00629 × √(2/3) = 0.0103입니다. 차이는 −0.0513입니다.
시드별 짝을 보면 3.6681에서 3.6192(−0.049), 3.6858에서 3.6289(−0.057), 3.6690에서 3.6208(−0.048)입니다. GELU에서 가장 나빴던 시드는 ReLU²에서도 가장 나빴고, 줄어든 폭은 비슷했습니다.
학습 전체에서 본 차이
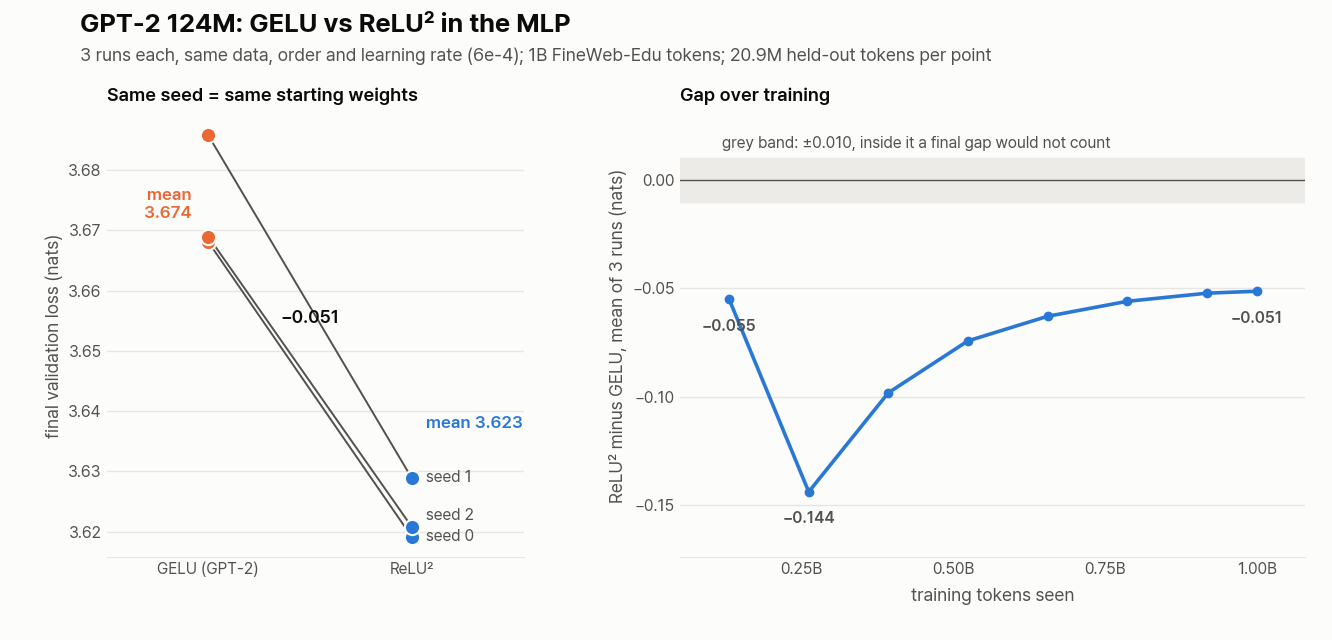
| 학습 토큰 | GELU | ReLU² | 차이 |
|---|---|---|---|
| 1.3억 | 5.5714 | 5.5164 | −0.0550 |
| 2.6억 | 4.7146 | 4.5706 | −0.1440 |
| 3.9억 | 4.1726 | 4.0744 | −0.0982 |
| 5.2억 | 3.9468 | 3.8726 | −0.0742 |
| 6.6억 | 3.8211 | 3.7582 | −0.0629 |
| 7.9억 | 3.7389 | 3.6829 | −0.0560 |
| 9.2억 | 3.6918 | 3.6396 | −0.0522 |
| 10억 | 3.6743 | 3.6230 | −0.0513 |
(각 세 실행의 평균입니다. 모든 지점에서 가장 높은 ReLU² 실행이 가장 낮은 GELU 실행보다 낮았습니다.)
차이는 빠르게 벌어져 2.6억 토큰에서 가장 커졌고, 그 뒤로 줄어들었습니다. 처음에는 빠르게, 나중에는 천천히 줄었습니다. 2.6억에서 5.2억 토큰 사이에 0.070, 5.2억에서 7.9억 토큰 사이에 0.018, 7.9억에서 10억 토큰 사이에 0.005 줄었고, 마지막 8,200만 토큰 동안에는 0.0009 줄었습니다. ReLU² 실행은 7.9억과 9.2억 토큰 사이 어딘가에서 이미 GELU 실행이 끝날 때의 loss(3.674)보다 낮아졌습니다.
2편의 RoPE도 비슷한 모양이었습니다. 초반에 크게 앞서고, 학습이 진행될수록 차이가 좁아졌습니다. 둘 다 왜 좁아지는지는 시험하지 않았고, 예산이 하나뿐이라 ReLU²의 차이가 0.05 언저리에서 멈출지 계속 줄어들지도 말할 수 없습니다.
ReLU²는 어디서 왔을까요
So 외(2021)는 Transformer를 이루는 기본 연산들을 탐색해 학습 비용이 더 적은 구조를 찾았고, 그 과정에서 ReLU²가 나왔습니다. 초록에 따르면 그렇게 찾은 구조(Primer)의 개선은 대부분 두 가지 변경에서 나왔습니다. ReLU 출력을 제곱한 것과, 쿼리·키·값 투영 뒤에 depthwise convolution을 넣은 것입니다. modded-nanogpt 스피드런에서는 ReLU²가 5번 기록에 QK norm, 0으로 초기화한 투영, 임베딩 패딩과 함께 들어갔기 때문에, ReLU² 혼자의 몫은 따로 재지 않았습니다. 이 글은 GPT-2 학습률에서 ReLU²만 바꿔서 잰 것입니다.
지금까지 연재에서 잰 결과입니다. 따로 적은 것 말고는 모두 같은 GPT-2 세 실행과 비교했습니다.
| 변경 | 최종 loss 차이 | 판정 |
|---|---|---|
| 학습되는 위치 임베딩 대신 RoPE(2편) | −0.122 | 낮음 |
| LayerNorm 대신 파라미터 없는 RMSNorm(3편) | +0.038 | 높음 |
| RMSNorm 위에 QK norm(RMSNorm만 쓴 것과 비교) | −0.012 | 낮음, 기준을 0.001 넘음 |
| GELU 대신 ReLU²(이 글) | −0.051 | 낮음 |
이 차이들을 더할 수는 없습니다. 각각 GPT-2에서 출발해 하나씩만 바꿔 잰 값입니다.
속도
| GELU | ReLU² | |
|---|---|---|
| 실행별 학습 처리량 | 초당 361,173 / 361,211 / 361,185토큰 | 초당 369,119 / 369,225 / 282,952토큰 |
| 실행 한 번의 시간(평가 포함) | 각 48.7분 | 47.8 / 47.7 / 62.2분 |
세 번째 ReLU² 실행의 평균이 낮은 것은 실행 도중 한동안 처리량이 초당 121,714토큰까지 떨어졌기 때문입니다. 기록된 스텝들의 중간값은 368,867토큰으로 다른 두 실행과 비슷합니다. 느려진 구간은 10월 8일 10시 35분 무렵부터 11시까지였습니다. 그중 10시 49분부터 11시 1분까지는 같은 장비에서 다른 글을 위해 돌린 저희의 다른 학습 실행과 GPU를 나눠 썼고, 그 실행이 끝나자 처리량이 바로 돌아왔습니다. 10시 35분부터 49분까지 무엇이 실행을 느리게 했는지는 기록하지 않았습니다. 방해받지 않은 두 실행만 보면 ReLU²가 GELU보다 2.2% 빨랐습니다. 다만 GELU 실행은 다른 날 쟀고, 3편에서는 한 설정의 세 실행이 3%까지 벌어진 적이 있어서 측정된 속도 차이로 보지 않습니다. 처리량은 처음부터 판정에 넣지 않았습니다.
한계
- 학습률은 하나만 썼습니다. 두 조건 모두 GPT-2 값인 6e-4입니다. 5편에서 옵티마이저를 바꾸고 학습률을 여러 값으로 바꿔 재 볼 계획입니다.
- 예산 하나, 모델 크기 하나입니다. GPT-2 small을 10억 토큰 학습했고, 끝날 때도 차이는 줄고 있었습니다.
- 왜 나아지는지는 재지 않았습니다. loss와 처리량만 쟀습니다. ReLU²에서 활성화 함수 출력이 정확히 0이 되는 비율이 얼마인지, 그것이 중요한지는 계획에서 뺐습니다.
- MLP 모양도 하나뿐입니다. 폭 3,072이고, SwiGLU 같은 게이트 방식은 해 보지 않았습니다.
- 처리량 숫자는 이 구현과 이 장비의 숫자입니다.
다음 글
계획상 다음은 옵티마이저입니다. Muon과 AdamW를 비교하고, 학습률은 양쪽 모두 여러 값으로 바꿔 각자 가장 좋은 값끼리 견줄 예정입니다. 5편의 비교 실행은 아직 시작하지 않았습니다.
계획서, 스크립트, 여섯 실행의 원시 로그는 아래 재현 패키지에 있고 로그인 없이 받을 수 있습니다. README에 GPU 없이 그 로그에서 이 글의 숫자를 모두 다시 계산하는 명령이 있습니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
gpt2-relu2-repro.zip · 356 KB