나만의 LLM Knowledge Base 구축하기 — Karpathy 스타일 지식 시스템
Obsidian + Claude Code로 영구적인 개인 지식 체계를 만드는 완전 가이드. 위키 + 메모리 두 축의 지식 시스템.
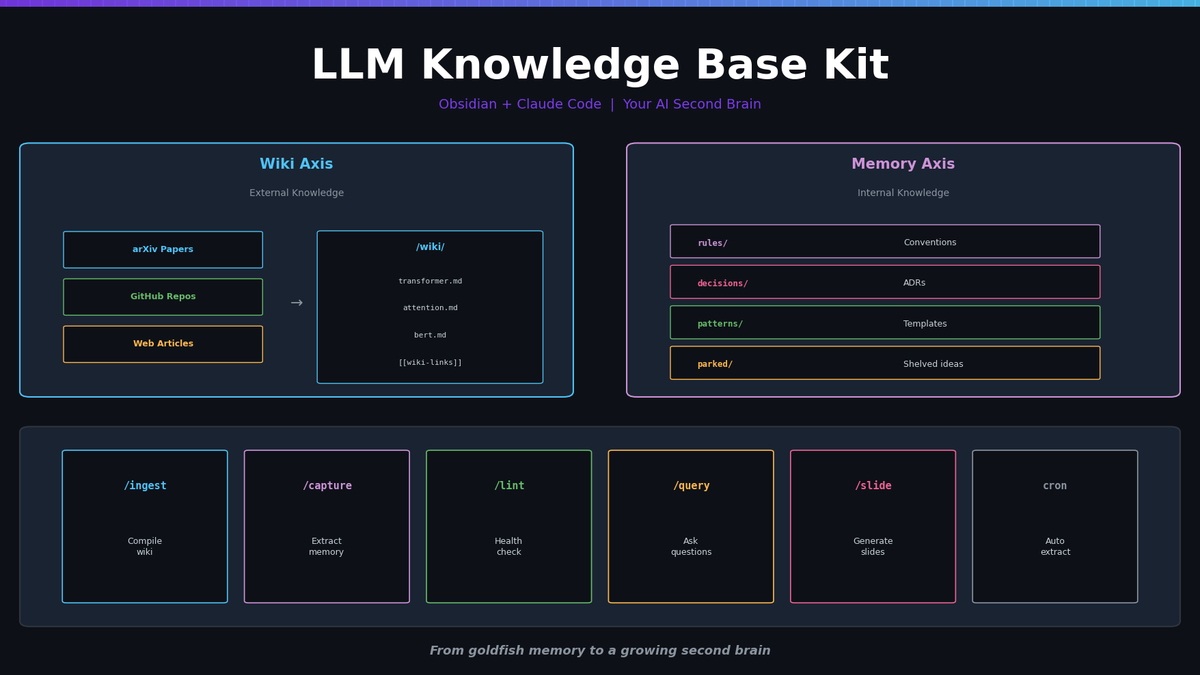
나만의 LLM Knowledge Base 구축하기 — Karpathy 스타일 지식 시스템
AI 세션이 끝나도 지식은 사라지지 않습니다. Obsidian + Claude Code로 영구적인 개인 지식 체계를 만드는 완전 가이드입니다.
왜 개인 지식 베이스가 필요한가
이전 글에서 AI의 기억력 문제를 다뤘습니다. karpathy-skills의 정적 규칙, claude-mem의 자동 캡처, Cognee의 지식 그래프 — 세 가지 접근법 모두 각자의 한계가 있었습니다.
그렇다면 우리가 직접 만들면 어떨까요?
이 글에서 구축하는 시스템은 세 도구의 장점을 합친 것입니다:
| 기존 도구의 장점 | 우리 시스템에서 |
|---|---|
| karpathy-skills의 CLAUDE.md 규칙 | AGENTS.md — 에이전트 행동 지침 |
| claude-mem의 자동 세션 캡처 | ingest_conversations.py — 세션 로그 자동 추출 |
| Cognee의 구조화된 지식 | Obsidian vault — 위키링크로 연결된 지식 그래프 |
결과물은 LLM Knowledge Base Starter Kit — Obsidian 호환 볼트 + Claude Code 슬래시 커맨드 + Python 자동화 스크립트의 조합입니다.
아키텍처: 두 개의 축
이 시스템의 핵심 설계는 두 개의 지식 축입니다:
축 1: Wiki (외부 지식)
논문, 블로그, GitHub 레포에서 수집한 지식을 정리합니다.
/raw/에 원본 투입 → LLM 에이전트가 읽고 분석 → /wiki/에 정제된 문서 생성예를 들어 "Attention Is All You Need" 논문을 /raw/에 넣으면, 에이전트가 이를 분석해서:
wiki/transformer-architecture.md— 아키텍처 개요wiki/self-attention.md— Self-Attention 메커니즘wiki/multi-head-attention.md— Multi-Head Attention 상세
이렇게 개념별로 분리된 위키 문서를 생성하고, [[wiki-links]]로 상호 연결합니다.
축 2: Memory (내부 지식)
AI 대화에서 축적된 나만의 작업 규칙과 결정 기록을 보존합니다.
AI 세션 종료 → 세션 로그 분석 → /memory/에 구조화된 파일 생성Memory는 4가지 하위 폴더로 구분됩니다:
| 폴더 | 용도 | 예시 |
|---|---|---|
rules/ | 반복되는 규칙과 선호 | "한국어 포스트는 합니다체로" |
decisions/ | 기술적 의사결정 기록 | "Sanity CMS를 선택한 이유" |
patterns/ | 재사용 가능한 코드/워크플로우 템플릿 | "Sanity 업로드 스크립트 패턴" |
parked/ | 나중에 할 일, 보류된 아이디어 | "UserEvent 추적 시스템 설계" |
두 축이 만나는 곳
Wiki와 Memory는 같은 Obsidian 볼트에 있기 때문에 자유롭게 상호 참조할 수 있습니다:
<!-- memory/decisions/2026-04-07-attention-library.md -->
FlashAttention v2를 선택했습니다.
이유는 [[Efficient Attention]] 문서에 정리된 벤치마크 결과 참고.

<!-- wiki/efficient-attention.md -->
실제 적용 사례는 [[decisions/2026-04-07-attention-library]] 참고.
이것이 단순한 메모 앱이나 CLAUDE.md와 근본적으로 다른 점입니다. 지식이 고립되지 않고, 네트워크를 형성합니다.
전체 구조
llm-knowledge-base-kit/
├── vault/                    # Obsidian 호환 볼트
│   ├── AGENTS.md             # LLM 에이전트 지침서 (핵심)
│   ├── CLAUDE.md             # Claude Code 프로젝트 설정
│   ├── raw/                  # 원본 소스 투입구
│   ├── wiki/                 # 정제된 위키 문서
│   ├── memory/               # AI 대화에서 추출한 내부 지식
│   │   ├── rules/            # 반복 규칙
│   │   ├── decisions/        # 의사결정 기록
│   │   ├── patterns/         # 재사용 패턴
│   │   └── parked/           # 보류 아이디어
│   ├── outputs/              # 생성물 (슬라이드, 차트)
│   └── _meta/                # 인덱스, 그래프, 변경 이력
├── .claude/commands/         # Claude Code 슬래시 커맨드
│   ├── ingest.md             # /ingest — 원본 → 위키 컴파일
│   ├── capture.md            # /capture — 현재 세션에서 메모리 추출
│   ├── lint.md               # /lint — 볼트 건강 체크
│   ├── query.md              # /query — 위키에 질문하기
│   ├── summarize.md          # /summarize — 주제 요약
│   └── slide.md              # /slide — Marp 프레젠테이션
├── scripts/                  # Python 자동화
│   ├── ingest_arxiv.py       # arXiv 논문 수집
│   ├── ingest_github.py      # GitHub 레포 수집
│   ├── ingest_web.py         # 웹 페이지 수집
│   ├── ingest_conversations.py  # Claude Code 세션 → 메모리 자동 추출
│   └── wiki_stats.py         # 볼트 통계
└── notebooks/                # 실습 튜토리얼
    ├── 01-setup.ipynb        # 설치 및 첫 수집
    ├── 02-compile.ipynb      # 컴파일 프로세스 이해
    └── 03-advanced.ipynb     # 배치 작업, 쿼리, 내보내기
Step 1: 볼트 설정
의존성 설치
cd scripts
pip install -r requirements.txt
필요한 패키지:
arxiv— arXiv API 클라이언트trafilatura— 웹 페이지 본문 추출requests— HTTP 요청pyyaml— YAML 파싱anthropic— Claude API (자동 메모리 추출용)google-genai— Gemini API (대체 제공자)
Obsidian에서 열기
볼트 폴더를 Obsidian에서 "Open folder as vault"로 열면 됩니다. [[wiki-links]]가 자동으로 작동하고, Graph View에서 지식 네트워크를 시각적으로 볼 수 있습니다.
Step 2: 외부 지식 수집 (Wiki 축)
arXiv 논문 수집
# 논문 ID로 직접 수집
python scripts/ingest_arxiv.py 1706.03762

# 키워드 검색으로 수집
python scripts/ingest_arxiv.py --search "flash attention" --max 5
/raw/ 폴더에 arxiv-1706.03762-attention-is-all-you-need.md 같은 파일이 생성됩니다. 본문, 수식, 참조 정보가 마크다운으로 변환됩니다.
GitHub 레포 수집
python scripts/ingest_github.py karpathy/nanoGPT레포의 README, 핵심 코드, 디렉토리 구조를 하나의 마크다운으로 정리합니다.
웹 페이지 수집
python scripts/ingest_web.py https://jalammar.github.io/illustrated-transformer/trafilatura를 사용해 본문만 깔끔하게 추출합니다.
수동 투입
아무 .md 파일이나 /raw/에 직접 넣어도 됩니다. 회의 노트, 강의 필기, 아이디어 메모 — 뭐든 넣을 수 있습니다.
Step 3: LLM 에이전트로 컴파일
원본이 수집되었으면, Claude Code에서 컴파일합니다:
/ingest에이전트가 AGENTS.md를 읽고 다음을 수행합니다:
/raw/의 새 파일을 감지합니다- 각 파일을 완전히 읽습니다
- 핵심 개념을 추출합니다
- 기존 위키 문서가 있는지 확인합니다
- 새 개념이면
/wiki/에 새 문서를 생성합니다 - 기존 개념이면 문서를 보강합니다
[[wiki-links]]로 관련 문서를 연결합니다_meta/INDEX.md와_meta/GRAPH.md를 업데이트합니다
컴파일 품질
에이전트가 생성하는 위키 문서는 이런 구조를 따릅니다:
---
title: Self-Attention
sources: [raw/arxiv-1706.03762-attention-is-all-you-need.md]
created: 2026-04-07
updated: 2026-04-07
tags: [attention, transformer, mechanism]
status: final
---

# Self-Attention

## Overview
Self-Attention은 입력 시퀀스의 각 위치가 다른 모든 위치를
참조하여 표현을 계산하는 메커니즘입니다...

## Key Concepts
### Query, Key, Value
...

## Connections
- [[Transformer Architecture]]의 핵심 구성 요소
- [[Multi-Head Attention]]으로 확장됨
- [[Efficient Attention]]에서 계산 비용 최적화 연구
11개 샘플 문서가 포함되어 있어, 품질 기준과 스타일을 바로 확인할 수 있습니다.
Step 4: 내부 지식 캡처 (Memory 축)
Memory는 세 가지 방법으로 캡처할 수 있습니다.
방법 1: 수동 작성
memory/ 하위 폴더에 직접 파일을 작성합니다. 각 폴더에 TEMPLATE.md가 제공됩니다:
---
title: Korean Writing Style
created: 2026-04-07
updated: 2026-04-07
tags: [writing, korean, style]
status: active
---

# Korean Writing Style

## Rule
한국어 블로그 포스트는 항상 합니다/입니다 존댓말체로 작성합니다.
반말체("~다")는 절대 사용하지 않습니다.

## Context
유저가 여러 차례 반복적으로 지적한 사항입니다.
모든 AI 세션에서 이 규칙을 우선 적용해야 합니다.

## Related
- [[decisions/2026-04-01-blog-platform]]
- [[patterns/sanity-upload-script]]
방법 2: /capture 슬래시 커맨드
Claude Code 세션 중 유용한 규칙이나 결정이 나왔을 때:
/capture에이전트가 현재 대화를 분석해서, 4가지 카테고리(rules/decisions/patterns/parked)에 해당하는 항목을 자동으로 추출하고 파일을 생성합니다.
방법 3: 자동 배치 추출
ingest_conversations.py는 Claude Code의 세션 로그(JSONL)를 파싱하고, LLM으로 메모리 항목을 자동 추출합니다:
# Anthropic Claude 사용
export ANTHROPIC_API_KEY=sk-ant-...
python scripts/ingest_conversations.py --vault /path/to/vault

# Google Gemini 사용 (대안)
export GEMINI_API_KEY=...
python scripts/ingest_conversations.py --vault /path/to/vault
핵심 특징:
- Going-forward 방식: 첫 실행 시 컷오프를 설정하고, 이후 새 세션만 처리합니다
- 라이브 세션 보호:
--idle-minutes 10으로 현재 활성 세션을 건너뜁니다 - 듀얼 프로바이더: Anthropic과 Gemini 중 환경 변수에 따라 자동 감지합니다
- 드라이 런:
--dry-run으로 실제 파일 생성 없이 미리 확인합니다 - 크론 호환: cron이나 launchd 타이머로 자동화할 수 있습니다
# 유용한 플래그
--dry-run           # 파일 생성 없이 미리보기
--no-llm            # LLM 없이 파싱만 테스트
--reset-cutoff      # 컷오프 초기화 (첫 실행처럼)
--since 2026-04-07  # 특정 날짜 이후 세션만
--provider gemini   # 프로바이더 명시 지정
--model gemini-2.5-flash  # 모델 지정
cron 예시 (매시간 실행):
0 * * * * cd /path/to/kit && python scripts/ingest_conversations.py --vault vault/ >> /tmp/kb-ingest.log 2>&1Step 5: 볼트 관리
건강 체크
/lint에이전트가 8가지 항목을 점검합니다:
- 고아 문서 — 아무도 링크하지 않는 문서
- 깨진 링크 — 존재하지 않는 문서를 가리키는
[[wiki-link]] - 오래된 문서 — 30일 이상 업데이트되지 않은 문서
- 누락된 소스 — 존재하지 않는
/raw/파일을 참조하는 문서 - 중복 주제 — 겹치는 내용의 문서
- 인덱스 동기화 —
INDEX.md가 실제 파일과 일치하는지 - 보류 항목 노화 — 30일 이상 방치된
parked/항목 (재부상) - 규칙 충돌 — 서로 모순되는
rules/파일
지식 쿼리
/query FlashAttention은 어떻게 메모리를 줄이나요?에이전트가 INDEX.md에서 관련 문서를 찾고, 위키 링크를 따라가며 컨텍스트를 모은 뒤, 출처를 인용하며 답변합니다.
프레젠테이션 생성
/slide Transformer ArchitectureMarp 형식의 슬라이드를 outputs/slides/에 생성합니다. Obsidian의 Marp 플러그인이나 CLI로 PDF 변환이 가능합니다.
통계
python scripts/wiki_stats.py vault/볼트 크기, 문서 수, 링크 밀도, 태그 분포 등을 한눈에 보여줍니다.
실전 워크플로우
일일 루틴
아침:
1. 관심 있는 논문/글을 /raw/에 투입
2. /ingest 실행 → 위키 자동 확장

저녁:
3. 오늘 Claude Code 세션에서 /capture
4. 또는 cron이 자동으로 ingest_conversations.py 실행

주간:
5. /lint 실행 → 고아 문서, 보류 항목 확인
6. Obsidian Graph View로 지식 네트워크 확인
실제 사용 예시
저는 이 시스템을 블로그 운영에 사용하고 있습니다:
Wiki 축:
- Transformer, Attention, Diffusion 관련 논문 30+편을 위키로 정리
- 블로그 포스트 작성 시
/query로 빠르게 참조
Memory 축:
- "한국어 포스트는 합니다체" →
rules/korean-writing-style.md - "Sanity 업로드 스크립트 패턴" →
patterns/sanity-upload-script.md - "UserEvent 추적 시스템" →
parked/userevent-tracking.md(보류 → 나중에 재개)
매 세션마다 같은 규칙을 반복 설명할 필요가 없어졌습니다. CLAUDE.md에서 AGENTS.md를 참조하도록 설정하면, 모든 규칙이 자동으로 로드됩니다.
Karpathy CLAUDE.md와의 차이
Karpathy의 CLAUDE.md는 "규칙을 파일 하나에 적어두자"입니다. 강력하지만 한계가 있습니다:
| 측면 | CLAUDE.md (정적) | Knowledge Base Kit (동적) |
|---|---|---|
| 규칙 관리 | 하나의 파일에 모든 규칙 | 카테고리별 분리 + 상호 링크 |
| 크기 제한 | 200줄 권장 | 무제한 (Obsidian 볼트) |
| 지식 축적 | 수동 편집만 가능 | 자동 캡처 + 수동 편집 |
| 외부 지식 | 지원하지 않음 | arXiv/GitHub/웹 자동 수집 |
| 검색 | Ctrl+F | /query + Graph View |
| 건강 관리 | 없음 | /lint + 자동 노화 경고 |
Knowledge Base Kit는 CLAUDE.md의 자연스러운 진화형입니다. 규칙 파일 하나에서 시작해서, 분류되고, 연결되고, 자동 갱신되는 지식 시스템으로 성장합니다.
스타터 킷 다운로드
LLM Knowledge Base Starter Kit에는 다음이 포함됩니다:
- Obsidian 호환 볼트 (완전한 폴더 구조 + AGENTS.md + CLAUDE.md)
- 11개 샘플 위키 문서 (Transformer Architecture 시리즈)
- Memory 서브시스템 (4개 폴더 + 템플릿)
- 6개 Claude Code 슬래시 커맨드 (/ingest, /capture, /lint, /query, /summarize, /slide)
- 4개 Python 수집 스크립트 (arXiv, GitHub, Web, Conversations)
- 듀얼 프로바이더 지원 (Anthropic Claude + Google Gemini)
- 3개 실습 노트북 (setup, compile, advanced)
- 볼트 통계 + PDF 내보내기 유틸리티
다운로드 후 폴더를 Obsidian에서 열고 Claude Code를 시작하면, 바로 지식 축적을 시작할 수 있습니다.
마무리
AI의 기억력 문제는 도구 하나로 해결되지 않습니다. 시스템이 필요합니다.
- 정적 규칙 (CLAUDE.md)으로 기본 행동을 제어하고
- 자동 캡처 (ingest_conversations.py)로 세션 지식을 보존하고
- 구조화된 볼트 (Obsidian + wiki-links)로 지식을 연결하고
- 건강 체크 (/lint)로 지식의 품질을 유지합니다
이 네 가지가 합쳐지면, AI는 더 이상 금붕어가 아닙니다. 성장하는 두 번째 뇌가 됩니다.
새 측정은 Paper of the Week로 매주 나갑니다. 다음 편을 받으시려면 아래에서 구독하세요.