북위·서경은 몰라도 N·W는 안다
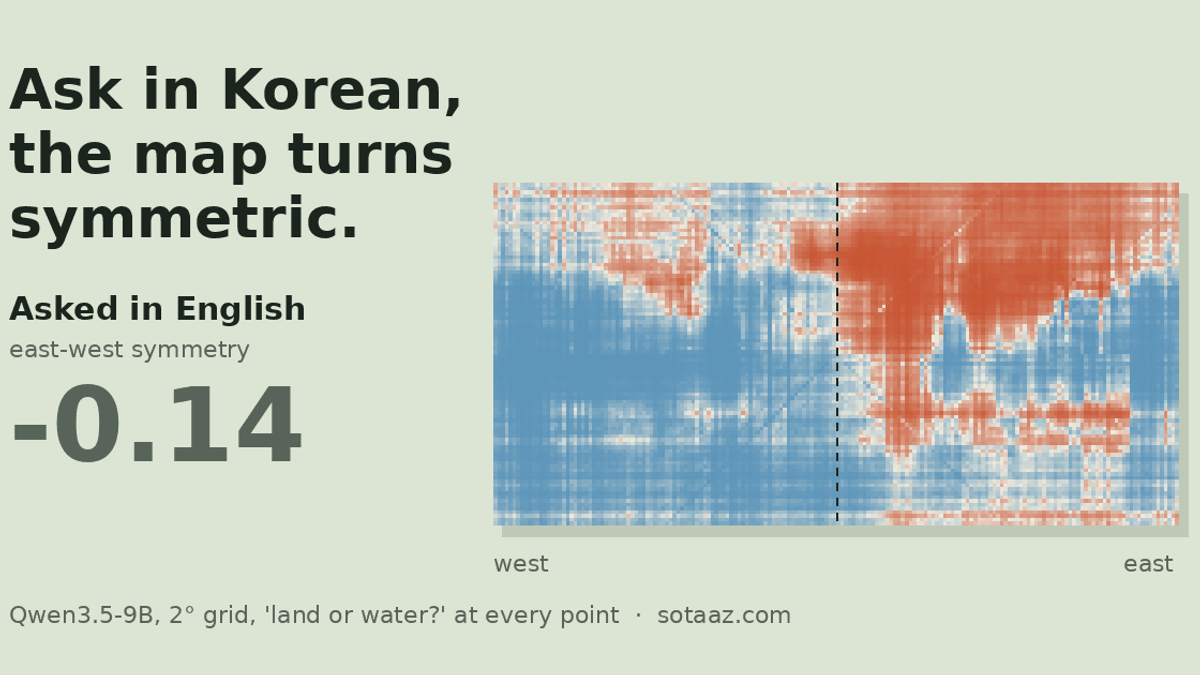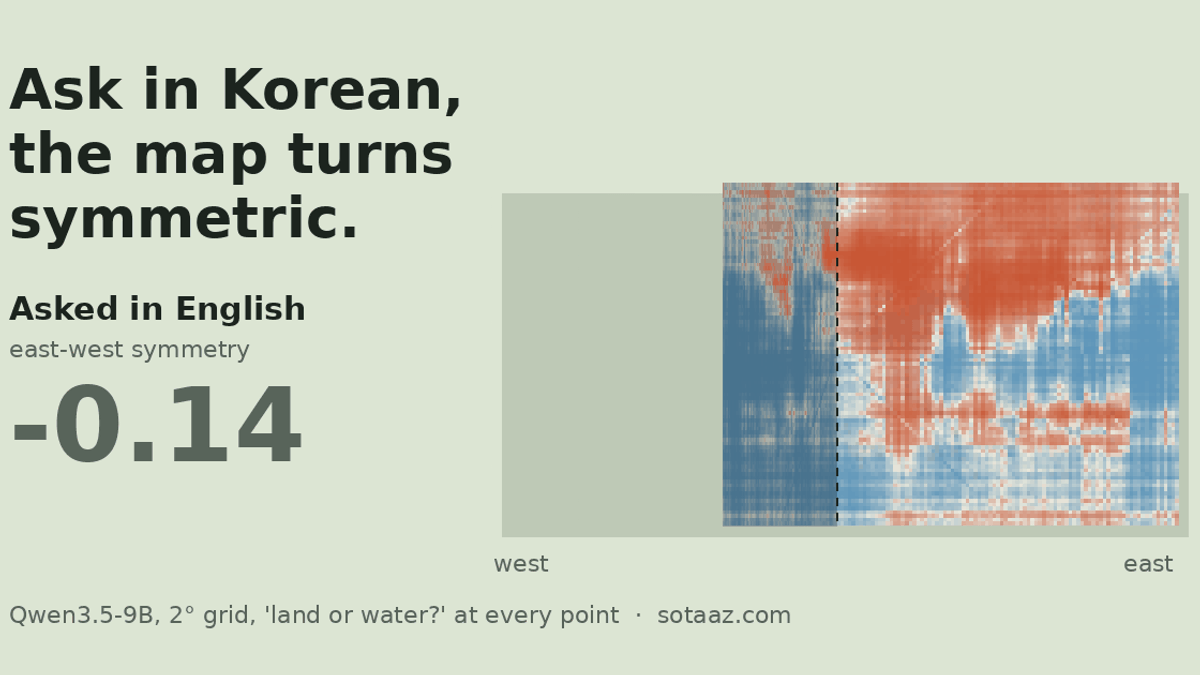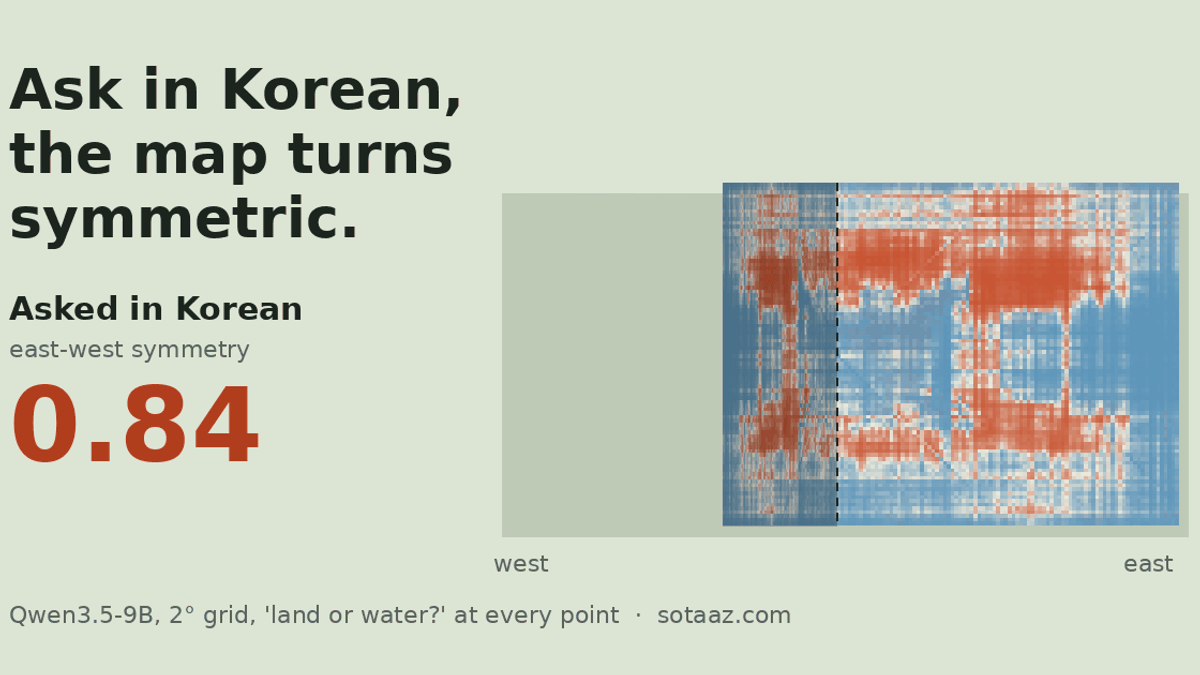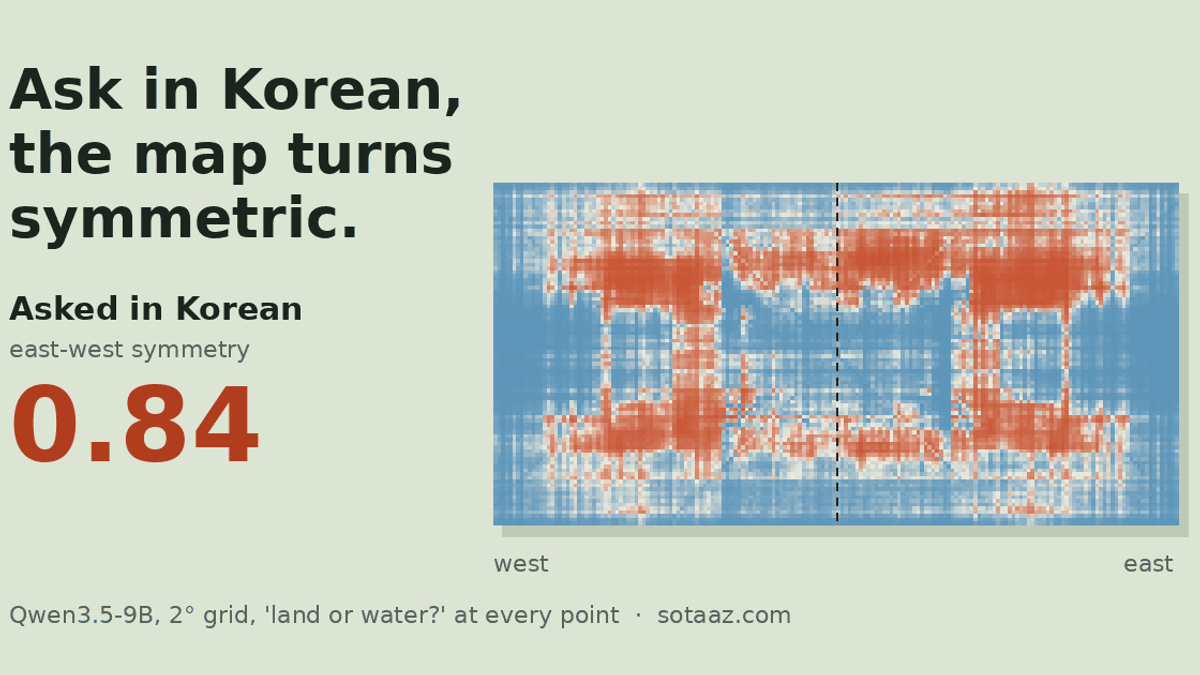
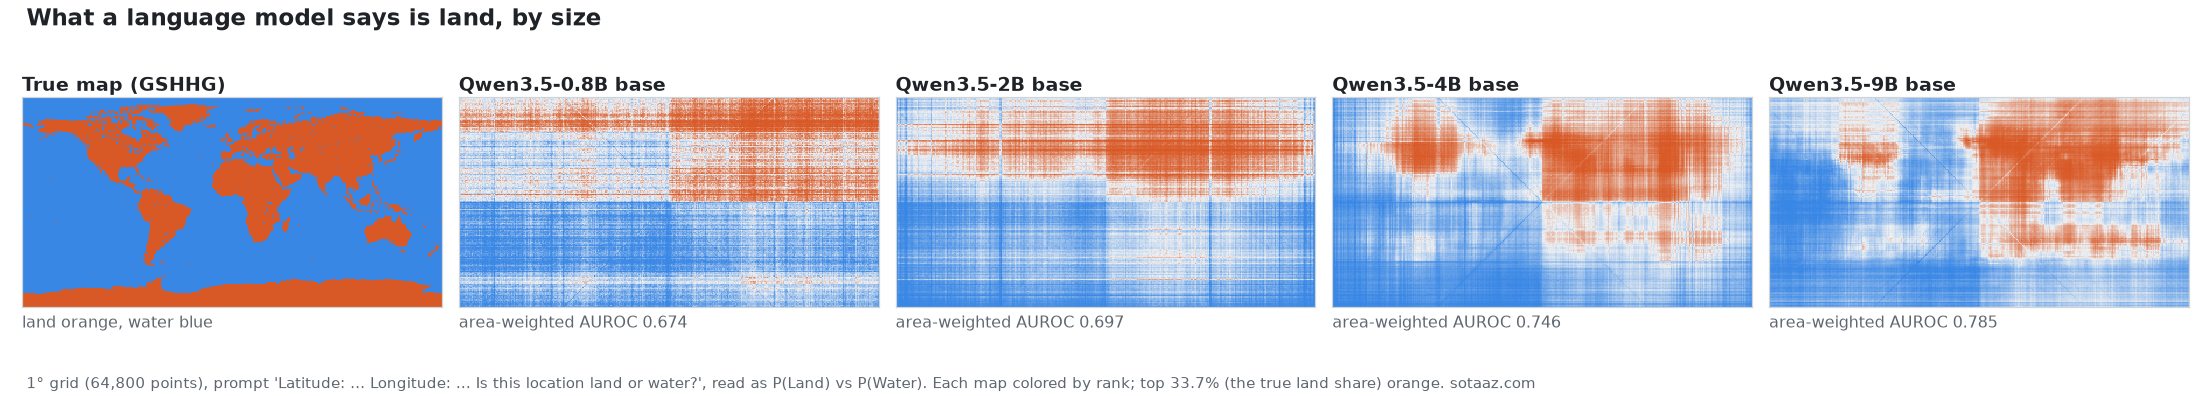
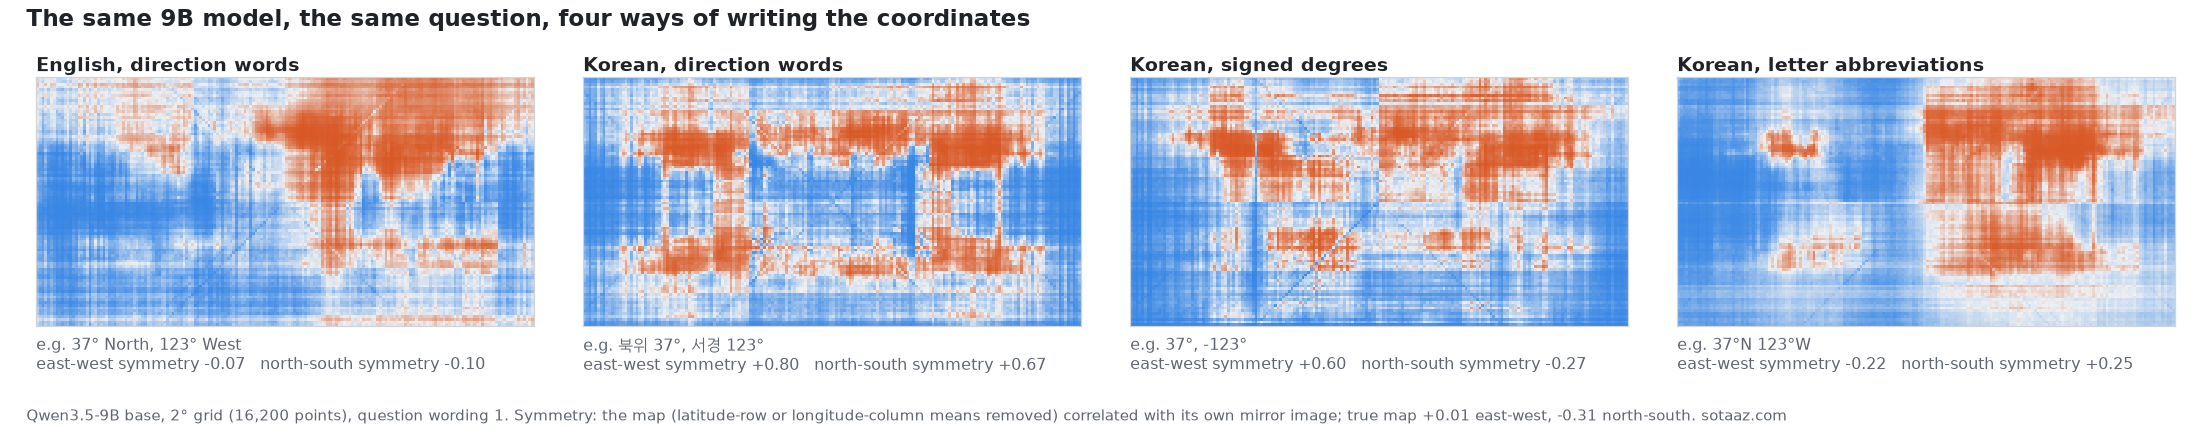
Qwen3.5 모델에게 위도·경도마다 육지인지 바다인지 묻고 그 답으로 세계지도를 그렸습니다. 9B에게 북위·서경 같은 한국어 표기로 물으면 지도가 좌우로 거의 대칭이 되고(동서 대칭 0.84, 영어로 물으면 −0.14) 위아래로도 대칭에 가까워져, 어느 반구인지 가리지 못합니다. 같은 좌표를 37°N 123°W처럼 영문 약자로 쓰면 좌우 대칭이 사라집니다.
북위·서경은 몰라도 N·W는 안다
언어 모델은 지도를 본 적이 없습니다. 대륙이 어디에 있는지는 전부 글에서 주워 모은 지식입니다. 2025년 8월 henry가 Substack 블로그 outsidetext에 쓴 How Does A Blind Model See The Earth?가 이 지식을 눈에 보이게 만들었습니다. 위도·경도 격자의 점마다 "육지인가 바다인가"를 묻고, 답에 따라 점을 칠하면 세계지도가 나옵니다. 이후 egangu/land-water-eval 저장소가 실제 해안선과 대조해 점수를 매기는 판을 공개했습니다.
저희는 지도를 그리는 데서 한 걸음 더 가 보고 싶었습니다. 그래서 측정 전에 예측부터 적었습니다. 큰 모델일수록 대륙이 선명할 것이고, 오답은 해안선에 몰릴 것이고, 은닉 상태를 직접 읽으면 모델이 말하는 것보다 더 많이 알 것이고, 사후학습이 도움이 될 것이고, 한국어로 물으면 지도가 나빠질 것이라고요. 그다음에 쟀습니다. 예측은 대부분 빗나갔습니다. 그리고 빗나간 방식을 따라가다가 가장 재미있는 결과를 만났습니다. 한국어로 물으면 지도가 좌우 대칭이 됩니다.
어떻게 물었나
- 모델: Qwen3.5 기본 모델 0.8B, 2B, 4B, 9B와 사후학습을 마친 4B, 9B입니다. 나중에 다른 계열인 Gemma 2 9B 기본 모델을 하나 더 썼습니다. A100 한 장에서 bf16으로 돌렸습니다.
- 격자: 1도 간격 격자의 칸 중심 64,800곳입니다. 정답은 GSHHG 2.3.7 해안선으로 매긴 육지·바다 라벨이고, egangu 저장소에 들어 있는 파일을 그대로 썼습니다. 언어를 바꾸는 실험은 2도 격자 16,200곳으로 했습니다. 다만 처음 한국어와 영어를 비교한 1차 측정(9B, 0.679 대 0.611)만은 1도 격자입니다.
- 질문: egangu의 기본 모델용 프롬프트를 그대로 썼습니다.
Latitude: 37.5° N, Longitude: 122.5° W.다음 줄에Question: Is this location land or water?, 그다음Answer:입니다. 모델이 이어서 " Land"를 쓸 확률과 " Water"를 쓸 확률을 비교합니다. 글을 생성하지는 않습니다. - 점수: AUROC를 씁니다. 실제 육지인 칸에 "육지" 점수를 더 높게 주는지를 재는 값이고, 어디서 자르든 상관없습니다. 0.5면 동전 던지기, 1.0이면 완벽한 지도입니다. 정확도를 앞세우지 않은 이유가 있습니다. 이 격자에서는 전부 "바다"라고만 답해도 칸 개수로 66.27%가 나옵니다(칸을 면적으로 가중하면 71.2%).
- 리뷰를 받고 더한 보정 두 가지: 위도·경도 격자는 면적이 작은 극지 칸을 많이 담습니다. 그래서 칸마다 실제 면적으로 가중한 AUROC를 함께 적습니다. 또 이웃 칸끼리는 서로 닮아서 독립이 아니므로, 구간은 10도 블록 단위로 통째로 다시 뽑는 방식(1,000번)으로 냈습니다.
큰 모델이 대륙을 더 잘 그립니다, 가장 작은 두 모델만 빼고
| 기본 모델 | AUROC | 면적 가중 AUROC [95% 구간] | 위도 10도 띠 안 |
|---|---|---|---|
| 0.8B | 0.594 | 0.674 [0.635, 0.709] | 0.569 |
| 2B | 0.578 | 0.697 [0.656, 0.737] | 0.624 |
| 4B | 0.618 | 0.746 [0.707, 0.783] | 0.670 |
| 9B | 0.679 | 0.785 [0.748, 0.817] | 0.726 |
저희는 깔끔하게 오르는 계단을 예상했습니다. 그냥 AUROC로는 2B가 0.8B보다 낮습니다. 하지만 그 차이(−0.016, 구간 −0.043에서 +0.011)는 잡음과 구분되지 않고, 면적으로 가중하면 순서가 다시 바로 섭니다. 2B부터 위로는 단계마다 분명히 오릅니다. 칸 가중 AUROC로 4B는 2B보다 +0.040(구간 +0.020에서 +0.061), 9B는 4B보다 +0.061(구간 +0.046에서 +0.078)이고, 면적 가중으로도 각각 +0.049(구간 +0.025에서 +0.072), +0.039(구간 +0.026에서 +0.055)로 구간이 0을 포함하지 않습니다.
마지막 열은 위도 10도짜리 띠 하나 안에서, 동반구와 서반구를 나눠서만 점수를 매긴 값입니다. 이렇게 하면 쉬운 부분이 빠집니다. 남쪽 끝은 육지이고 남위 60도 언저리는 넓은 바다라는 것 같은 위도별 상식 말입니다. 남는 것은 어려운 부분, 같은 위도에서 대륙이 어디쯤 놓이느냐입니다. 여기서는 계단이 깔끔합니다. 0.569, 0.624, 0.670, 0.726입니다.
해안선도 예상과 달랐습니다. 해안 칸의 오답률이 내륙 칸의 두 배 이상일 거라고 예측했는데, 모든 모델에서 1.3-1.5배였습니다. 지도 전체가 흐릿해서 해안만 특별히 틀리지 않는 것입니다.
남극을 육지라고 하는 모델이 없습니다
가장 큰 오답 덩어리는 지도 맨 아래입니다. 남위 70도 이남은 칸 개수로 87%가 육지인데(면적으로는 78%), 0.8B부터 9B까지 기본 모델이 육지라고 답한 비율은 0-1%였습니다.
리뷰에서 이런 지적이 나왔습니다. 남극은 빙상이라 "land or water"를 "얼음은 물"로 읽었을 수 있다는 것입니다. 그래서 9B에게 Is this location land (including land under an ice sheet) or open water?로 다시 물었습니다. 측정 전에 "육지 답이 30% 이상이면 질문 해석 문제였다고 본다"고 적어 두었습니다. 결과는 0%에서 2.9%로, 문구를 바꿔도 남극은 육지 쪽으로 옮겨 가지 않았습니다.
그렇다고 그 지역을 아예 모르는 것은 아닙니다. 남위 60도 이남만 놓고 보면 육지와 바다를 어느 정도 가립니다(AUROC 0.714, 빙상 문구로는 0.794). 다만 그 지역 답이 통째로, 다른 지역 답 전체보다 바다 쪽에 놓여 있을 뿐입니다.
속을 들여다본 지도가 더 알지는 않았습니다
저희가 가장 기대한 예측은 "모델은 말하는 것보다 더 많이 안다"였습니다. 모델이 답하기 직전의 은닉 상태를 꺼내, 거기서 "육지"를 읽어 내는 작은 선형 분류기(프로브)를 학습시키고, 그 프로브가 그린 지도를 모델이 말한 지도와 비교했습니다.
프로브가 지도를 그냥 외워 버리지 못하게, 한쪽 반구로 학습하고 반대쪽 반구에서 채점했습니다. 이렇게 나누지 않고 같은 반구 안에서 학습·채점하면 0.87-0.94가 나오는데, 이 숫자는 대부분 "옆 칸은 옆 칸을 닮는다"는 사실을 반영할 뿐입니다.
| 기본 모델 | 말한 지도 | 프로브 | 위도만 쓴 기준선 |
|---|---|---|---|
| 0.8B | 0.568 | 0.733 | 0.789 |
| 2B | 0.555 | 0.749 | 0.789 |
| 4B | 0.575 | 0.796 | 0.789 |
| 9B | 0.666 | 0.822 | 0.789 |
이 표의 숫자는 모두 학습에 쓰지 않은 반구에서 잰 AUROC이고, 동→서와 서→동 두 방향의 평균입니다. 그래서 "말한 지도" 값이 앞의 표(지구 전체)와 다릅니다. 프로브는 모델 층 9개(깊이 0, 1/8, …, 1) 중 하나를 읽는데, 어느 층을 쓸지와 규제 세기는 학습하는 반구 안에서 경도 30도 블록 6개로 교차검증해 골랐습니다. 채점하는 반구는 고르는 데 쓰지 않았습니다. 층은 학습 방향(서반구로 학습, 동반구로 학습)마다 따로 골랐습니다. 고른 층은 두 방향 순서로 0.8B가 24층 중 15층과 24층, 2B가 24층 중 24층과 18층, 4B가 32층 중 28층과 24층, 9B가 32층 중 20층과 24층이었습니다.
프로브는 말한 지도를 크게 앞섭니다. 그런데 위도 띠만 보고 같은 정답으로 학습한 분류기도 0.789가 나옵니다. 프로브가 이 기준선을 넘은 폭은 4B에서 0.007, 9B에서 0.033입니다. 저희가 미리 정한 기준(두 크기 모두 0.02 이상)에 못 미칩니다. 위도가 도움이 안 되는 위도 띠 안에서는 순서가 아예 뒤집힙니다. 4B는 말한 지도 0.670 대 프로브 0.614, 9B는 0.726 대 0.643입니다.
결국 프로브가 앞선 것은 대부분 저희가 쥐여 준 정보였습니다. 정답 라벨에서 "남쪽 끝은 육지"를 배운 것입니다. 정답을 한 번도 본 적 없는 말한 지도가, 같은 위도에서 대륙이 어디 있는지는 더 잘 압니다.
한국어로 물으면 지도가 좌우 대칭이 됩니다
9B에게 한국어로 물은 지도는 이상했습니다. 왼쪽 절반과 오른쪽 절반이 거의 거울에 비친 모양이었습니다. 실제 세계지도는 좌우 대칭이 아닙니다. 지도가 대칭이 된다는 것은 모델이 반구를 가리는 정보, 즉 동쪽인지 서쪽인지(또는 북쪽인지 남쪽인지)를 잃었다는 뜻입니다. 동서를 전혀 구분하지 못하는 모델이라면 지도의 왼쪽과 오른쪽이 똑같아지고, 아래에서 재는 동서 대칭이 1에 가까워집니다.
얼마나 대칭인가
이것을 숫자로 재기 위해, 지도에서 위도 행마다 평균을 빼고 좌우를 뒤집은 자기 자신과의 상관을 구했습니다. 이 값을 동서 대칭이라고 부르겠습니다. 1이면 완전한 좌우 대칭입니다. 위도마다 다른 육지 비율이 상관을 부풀리지 않게 하려는 것입니다. 언어 실험과 같은 2도 격자에서 실제 지도는 0.01입니다. 9B에게 영어로 물으면 −0.14, 위도: 북위 37°, 경도: 서경 123°처럼 한국어로 물으면 0.84입니다(둘 다 아래 표와 같은 질문 문구 2개의 평균). 10도 블록 bootstrap 구간은 영어 [−0.19, −0.09], 한국어 [0.81, 0.86]입니다. 문구를 4개로 늘려도 영어 −0.14, 한국어 0.78(문구별 0.64-0.87)로 같은 그림입니다. 이 구간은 지도의 어느 칸을 뽑느냐에서 오는 흔들림만 담고 있고, 실제로는 문구에 따른 흔들림이 더 큽니다.
무엇이 대칭을 만드나
그다음에는 이유를 찾으려고, 측정할 때마다 예측을 먼저 적었습니다. 아래 표는 9B 결과이고, 칸마다 질문 문구 2개의 평균입니다.
| 좌표 표기 | 영어 | 한국어 | 중국어 | 일본어 |
|---|---|---|---|---|
| 그 언어의 방향 단어 (North/West, 북위/서경, 北纬/西经, 北緯/西経) | −0.14 | 0.84 | 0.24 | 0.69 |
| 부호 붙은 도수 (37°, −123°) | 0.05 | 0.64 | 0.12 | 0.31 |
| 영문 약자 (37°N 123°W) | −0.54 | −0.06 | −0.16 | 0.03 |
하나씩 지운 원인은 이렇습니다.
- 도쿄 가설. 한국어에서 "동경"은 경도의 동경(東經)과 도시 도쿄(東京)가 한글로는 소리도 글자도 같습니다. 이것 때문일까 싶어 "서쪽 경도"로 풀어 써 봤지만 0.82로 그대로 접혔습니다. 원인이 아닙니다.
- 답 단어. 한국어 질문은 그대로 두고 답만 영어 " Land", " Water"로 읽어도 0.77이었습니다. 대칭은 "육지", "바다"라는 답 단어가 아니라 질문을 읽는 단계에서 생깁니다.
- 방향 단어만의 문제도 아닙니다. 부호 붙은 도수로 바꾸면 한국어 동서 대칭이 0.64로 줄지만 사라지지 않습니다. 방향 단어가 하나도 없는데도 대칭이 남는 것입니다.
- 일본어. 일본어는 동경을 東経으로 써서 도쿄(東京)와 글자가 다릅니다. 그래도 대칭이 됩니다(0.69).
위아래로도 대칭이 됩니다
같은 방식으로 남북도 쟀습니다. 이번에는 경도 열마다 평균을 빼고 위아래를 뒤집은 자기 자신과 상관을 구합니다(남북 대칭). 남북은 실제 지도부터 0이 아니라는 점이 다릅니다. 북반구에 육지가 몰려 있어서 실제 지도가 −0.31입니다. 그러니 남북에서는 0이 아니라 −0.31이 "제대로 그린 지도"의 기준입니다. 9B 결과(문구 2개 평균)를 두 축 모두 한 표에 놓으면 이렇습니다.
| 동서 대칭 | 남북 대칭 | |
|---|---|---|
| 실제 지도 | 0.01 | −0.31 |
| 영어, 방향 단어 | −0.14 | 0.34 |
| 영어, 부호 도수 | 0.05 | −0.46 |
| 영어, 영문 약자 | −0.54 | 0.06 |
| 한국어, 방향 단어 | 0.84 | 0.68 |
| 한국어, 부호 도수 | 0.64 | −0.10 |
| 한국어, 영문 약자 | −0.06 | 0.25 |
남북 열을 보면 영어도 괜찮지만은 않습니다. 영어 방향 단어 지도는 실제 지도(−0.31)보다 한참 위인 0.34라서, 남북으로는 영어로 물어도 상당히 대칭에 가깝습니다. 한국어 부호 도수의 −0.10은 "대칭이 완전히 사라졌다"기보다 실제 지도 쪽으로 많이 돌아온 값입니다.
영어 부호 도수 줄은 다른 것을 알려 줍니다. 영어로 물으면 부호 표기에서 동서(0.05)도 남북(−0.46)도 대칭이 생기지 않습니다. 위도의 마이너스 부호만 읽고 경도의 마이너스 부호를 놓치는 일은 한국어 질문에서만 일어났습니다.
정리하면 이렇습니다.
- 한국어 방향 단어(북위·서경)로 쓰면 좌우로도 위아래로도 강하게 대칭이 됩니다.
- 부호 붙은 도수로 쓰면 좌우 대칭만 남습니다. 같은 마이너스 부호를 위도에서는 읽고 경도에서는 놓칩니다.
- N·E·S·W 글자를 붙이면 좌우 대칭은 사라지고, 남북은 영어 방향 단어 지도와 비슷한 정도(0.25 대 0.34)로 돌아옵니다.
부호 표기와 약자 표기만 비교하면, 이 모델이 한국어 질문에서 동쪽과 서쪽을 가르는 단서는 사실상 경도 뒤의 W 한 글자인 셈입니다. 이 표현은 이 두 표기를 비교할 때만 성립합니다.
왜 대칭인지는 아직 모릅니다
대칭이 된 지도는 두 가지로 설명할 수 있습니다. 서경을 동경으로 잘못 읽어 아메리카 자리에 아시아를 그렸을 수도 있고, 동서를 아예 무시해서 양쪽에 같은 평균 지도를 그렸을 수도 있습니다. 영어 지도에 이미 있는 East 답과 West 답으로 두 경우의 기준 지도를 만들어 비교했고, 미리 "무시하기 쪽이 0.1 이상 가깝다"고 적어 두었습니다. 결과는 문구 1에서 무시하기 쪽 0.53 대 0.46, 문구 2에서 잘못 읽기 쪽 0.46 대 0.40으로, 어느 쪽도 0.1 차이에 이르지 않았습니다. 지금 말할 수 있는 것은 "반구 정보를 잃는다"까지입니다.
중국어 학습 데이터 때문일까
Qwen은 중국어를 많이 학습한 모델입니다. 중국어 지도가 한국어·일본어보다 훨씬 덜 대칭인 것(문구 4개 평균 0.13 대 0.78, 다만 중국어 문구 4개는 −0.06에서 0.40까지 퍼짐)을 이것으로 설명할 수 있을지도 모릅니다. 그렇다면 중국어에 그만큼 무게를 두지 않은 모델은 중국어에서도 대칭이 되어야 합니다. 이 판정 기준을 먼저 커밋하고 Gemma 2 9B로 쟀습니다.
| Gemma 2 9B | 영어 | 한국어 | 중국어 | 일본어 |
|---|---|---|---|---|
| 동서 대칭(문구 2개 평균) | 0.38 | 0.74 | 0.83 | 0.75 |
숫자만 보면 Gemma는 중국어에서도 한국어만큼 대칭이 됩니다. 미리 정한 판정 규칙(중국어·한국어 모두 0.5 이상)도 통과합니다. 그런데 Gemma는 영어에서도 동서 대칭이 0.38이고, 영어 지도의 위도 띠 안 AUROC가 0.455로 대륙 위치를 거의 모릅니다. 0.5보다 낮다는 것은 같은 위도 안에서 대륙을 반대편에 그리는 경향이 조금 있다는 뜻일 수도 있습니다. 영어 대비 늘어난 만큼으로 다시 보면 그림이 달라집니다.
| 영어 대비 증가(문구 2개 평균, 반올림 전 값으로 계산) | 한국어 | 중국어 |
|---|---|---|
| Qwen3.5 9B | +0.97 | +0.38 |
| Gemma 2 9B | +0.36 | +0.45 |
이렇게 보면 Gemma는 "중국어에서도 대칭이 된다"기보다 "어느 언어에서든 원래 동서를 잘 못 읽는다"에 가깝습니다. 그러니 이 비교로 학습 데이터 설명이 시험을 통과했다고 말하기는 어렵습니다. 중국어를 덜 본 모델에서 중국어 대칭이 커진다는 방향과 어긋나지는 않는다는 정도로만 적어 둡니다. 원인을 가리려면 영어 지도가 제대로 나오는 다른 계열 모델이 필요합니다.
Qwen3.5 4B도 9B와 같은 순서를 보입니다. 방향 단어 표기에서 한국어 0.63, 일본어 0.64, 중국어 0.49, 영어 −0.16입니다. 한 칸만 다릅니다. 4B는 영어 약자 표기에서도 대칭이 되는데(0.52) 9B는 그렇지 않습니다(−0.54).
지도에 남은 작은 흉터 두 개
여러 지도에 공통으로 보이는 자국이 두 가지 있습니다.
- 적도와 본초자오선의 이음매. 4B와 9B에서는 이웃한 행·열 사이의 큰 단절 몇 개가 정확히 N이 S로, E가 W로 바뀌는 자리에 있습니다.
- 흐릿한 X자. 위도와 경도가 같은 숫자인 칸(33.5도와 33.5도)에서 대부분의 모델이 자기 지도의 표준편차로 0.3-0.6만큼 "바다" 쪽으로 기웁니다. 대각선을 1도 이상 옮기면 효과가 사라지고, 실제 지도에는 이런 무늬가 없습니다. 2B와 사후학습한 9B에서는 나타나지 않습니다.
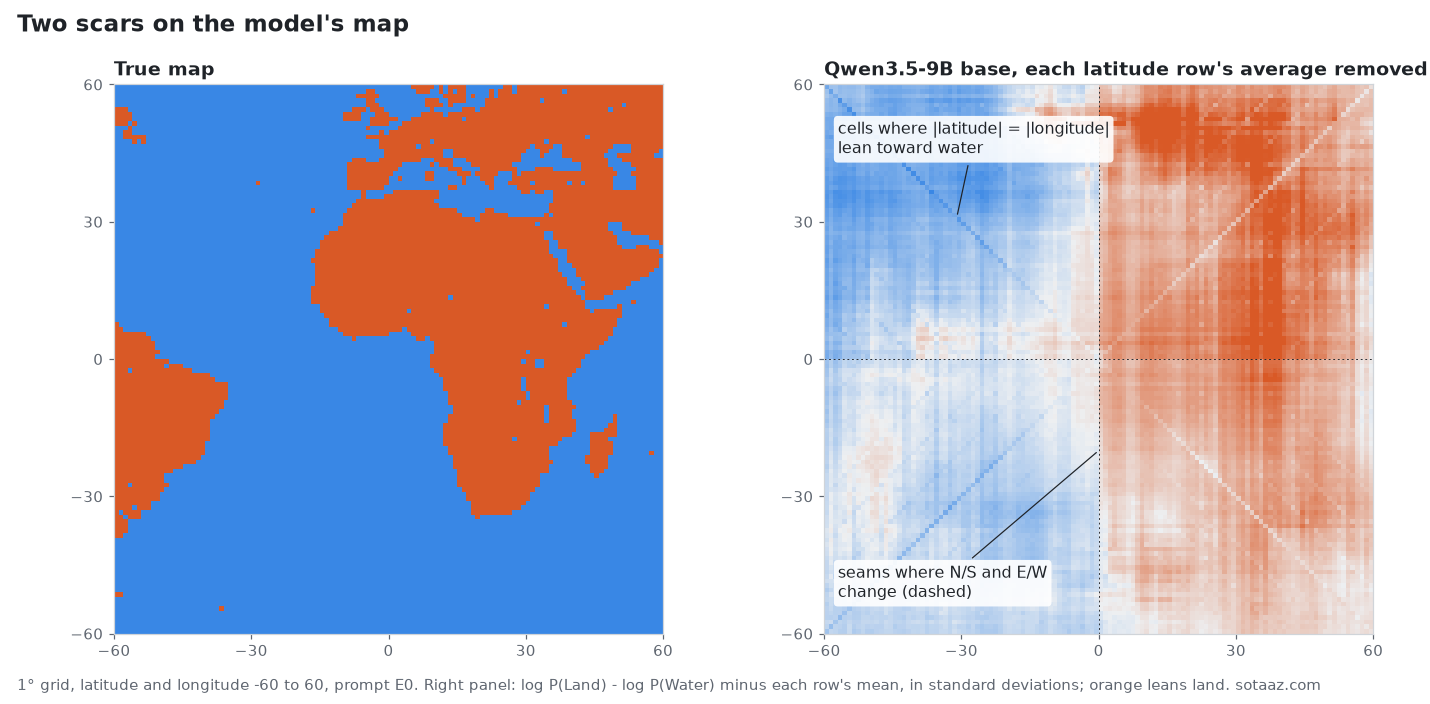
처음에는 토큰화를 의심했습니다. 그런데 Qwen3.5 토크나이저는 숫자를 한 자리씩 끊습니다. Latitude: 33.5° S를 넣으면 3, 3, ., 5가 각각 토큰 하나입니다. 그러니 여러 자리 숫자가 쪼개지는 방식에서 생긴 흔적은 아닙니다. 같은 숫자가 두 번 나온다는 사실 자체가 답을 바꾸는 것으로 보입니다.
저희 예측 성적
| 회차 | 맞힌 수 |
|---|---|
| 1차 (크기, 해안, 프로브, 사후학습, 한국어가 낮음, 문구 안정성) | 6개 중 2개 |
| 언어 후속 (중국어, 도쿄, 부호 표기, 답 단어, 일본어) | 5개 중 2개 |
| 빙상 문구와 표기 | 2개 중 0개 |
| 문구 4개, Gemma 영어, Gemma 중국어 | 3개 중 2개 |
| 잘못 읽기 대 무시하기 | 1개 중 0개 |
17개 중 6개입니다. 그중 둘은 조건부입니다. 하나는 아래 문단의 문구 안정성이고, 다른 하나는 Gemma 중국어 예측으로, 미리 정한 규칙은 통과했지만 앞에서 본 것처럼 영어 대비로 보면 근거가 되지 못합니다. 맞힌 것은 대체로 이미 가진 데이터에 가까운 예측이었고, 재미있는 결과는 틀린 예측에서 나왔습니다.
1차에서 맞힌 두 개는 사정을 덧붙여야 합니다. "한국어가 더 낮다"는 맞았습니다(9B 영어 0.679 대 한국어 0.611, 둘 다 1도 격자에서 잰 AUROC). "문구를 바꿔도 거의 같다"는 칸 가중 기준으로는 맞았지만, 면적으로 가중하면 4B의 영어 문구 세 개가 최대 0.137 차이 나서 이 판정에는 기대지 않습니다. 사후학습은 양쪽으로 갈렸습니다. 4B는 +0.008로 잡음 안이고, 9B는 −0.068로 떨어졌습니다.
한계
- 대부분 한 계열 모델로 쟀고, 다른 계열은 확인용으로 하나만 썼습니다. "한국어로 물으면 지도가 좌우 대칭이 된다"는 저희가 쓴 문구에서 Qwen3.5 4B·9B와 Gemma 2 9B로 잰 사실이지, 언어 모델 전반에 대한 말이 아닙니다.
- 두 답 단어의 확률만 읽었습니다. 생각을 거쳐 답하게 하거나, 채팅 모델에 자기 템플릿을 씌우면 다른 지도가 나올 수 있습니다.
- 중국어가 덜 대칭인 이유는 아직 모릅니다. 학습 데이터 설명은 Gemma 비교로 가려지지 않았습니다.
- 서경을 동경으로 잘못 읽는 것인지, 동서를 무시하는 것인지 아직 구분하지 못했습니다.
- 결과를 본 뒤 더한 분석이 여럿 있습니다. 면적 가중, 위도 띠 안 AUROC, 대칭이 된 지도의 모양, 남북 대칭, 동서 대칭과 그 구간 자체가 그렇습니다. 어느 것이 나중에 더해졌는지는 계획 파일에 시각과 함께 표시해 두었습니다.
예측과 그 시각을 모두 적은 계획 파일, 스크립트, 지도마다의 원시 점수는 아래 재현 패키지에 있습니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
model-world-map-symmetric-repro.zip · 11,261 KB