AI의 풀이에서 계산과 검산을 구분할 수 있을까요?
실제 추론 기록을 계산·도출·검산·탐색으로 나눠 봤습니다. 표지어를 지우자 128개 단계 중 18개의 분류가 달라졌습니다. The Molecular Structure of Thought의 접근과 작은 분류 실험을 설명합니다.
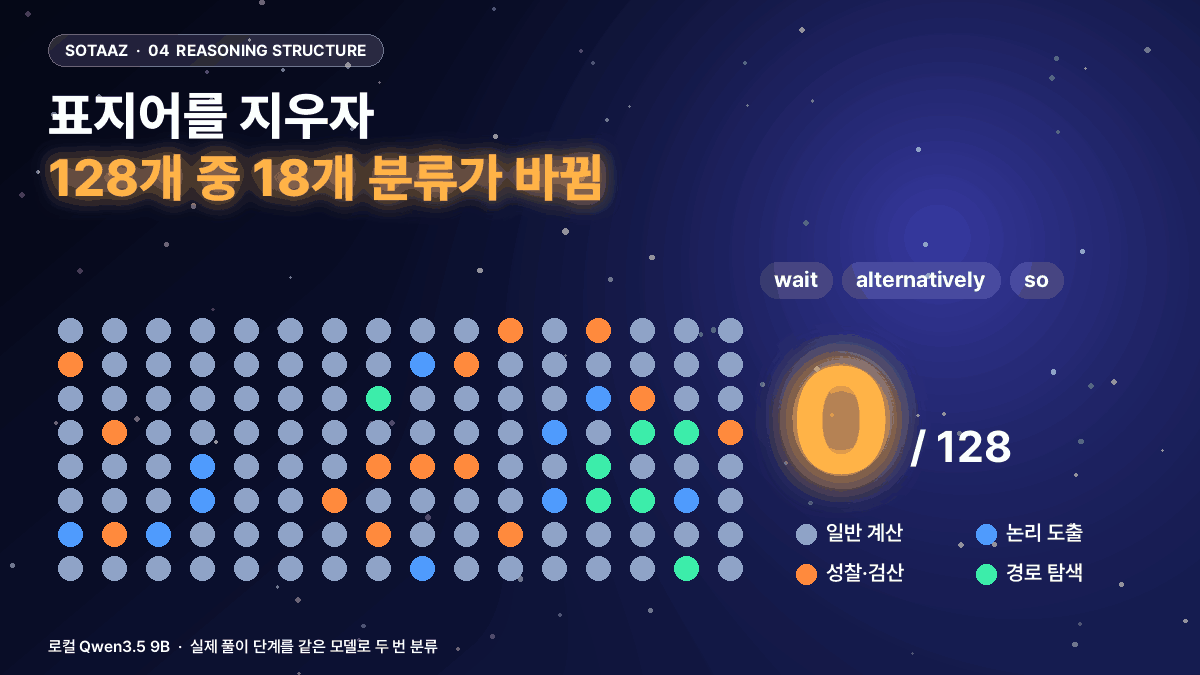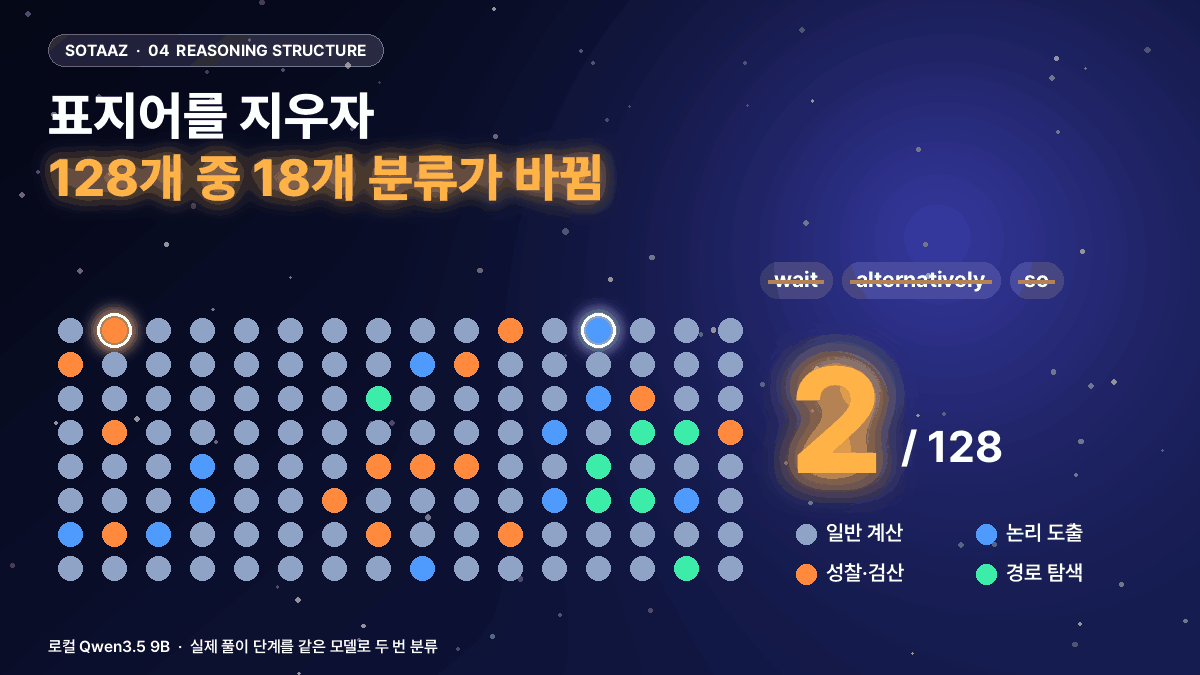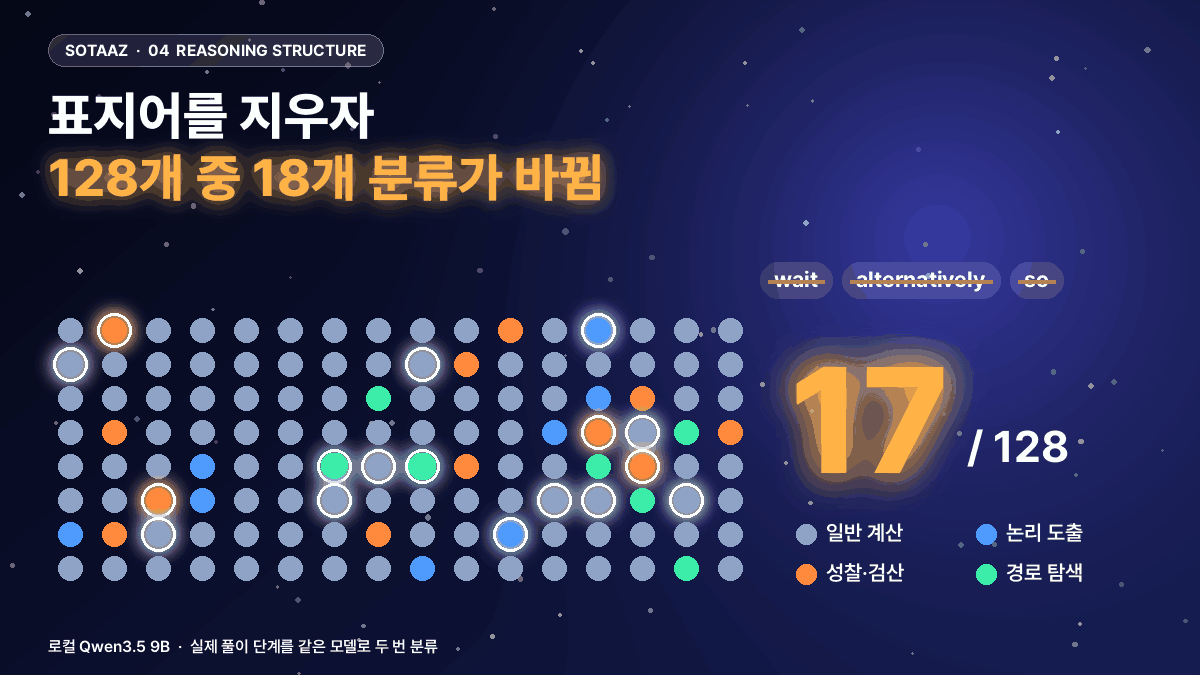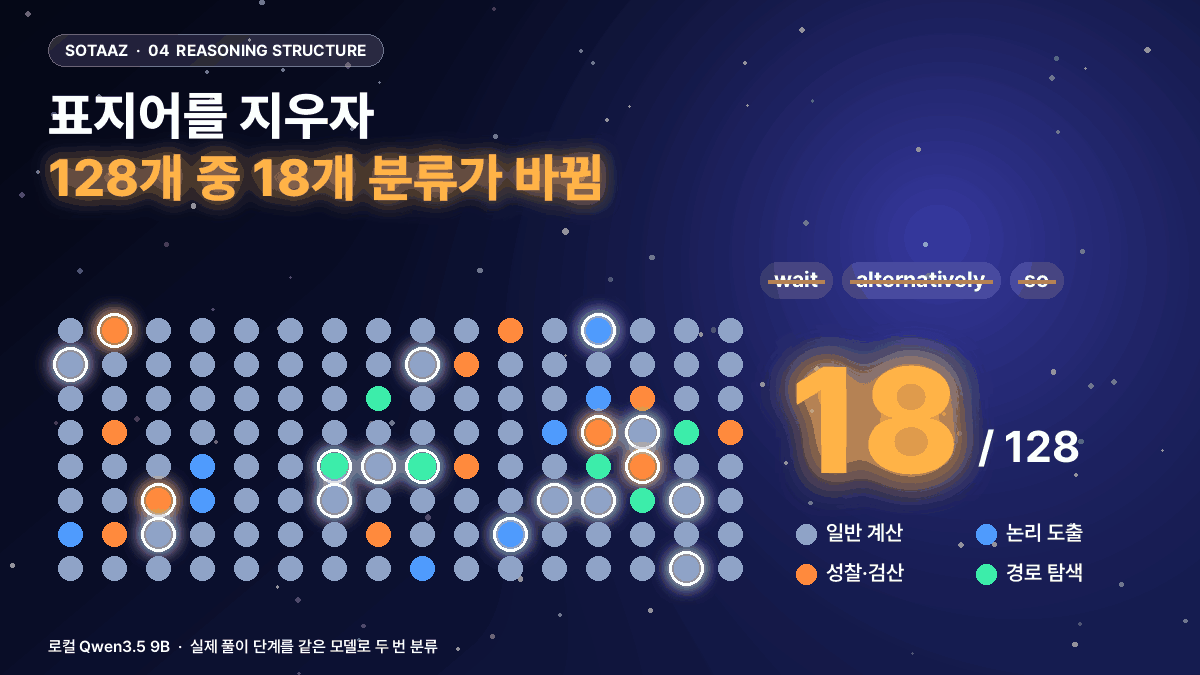
AI가 긴 풀이를 쓰는 동안 무엇을 하고 있는지 구분해 보고 싶었습니다. 숫자를 계산하는 문장, 앞의 계산을 검산하는 문장, 다른 풀이를 시도하는 문장은 역할이 다르기 때문입니다. 풀이 길이만 재서는 이 차이를 알 수 없습니다.
저희는 실제로 생성한 풀이를 단계별로 나누고, 각 단계가 무슨 역할인지 모델에게 분류하게 했습니다. 그런 다음 “wait”, “alternatively” 같은 표현만 지우고 다시 분류했습니다. 비교할 수 있는 128개 단계 중 18개에서 분류가 달라졌습니다.
이 결과는 AI의 사고방식을 알아냈다는 발견과는 거리가 있습니다. 오히려 사고 과정을 지도처럼 그리려면, 그 지도를 만들기 위해 붙인 이름부터 얼마나 믿을 수 있는지 확인해야 한다는 문제를 보여 줬습니다.
긴 풀이를 행동별로 나누는 연구입니다
Qiguang Chen 등 ByteDance Seed·하얼빈공대 및 여러 기관 연구진의 The Molecular Structure of Thought는 긴 추론을 여러 행동으로 나눠 분석합니다. 새 관계를 도출하는 일, 앞의 가정을 다시 확인하는 일, 다른 경로를 시도하는 일을 구분합니다.
제목에는 분자가 등장합니다. 저자들은 행동 사이 관계를 화학 결합에 빗대어 설명합니다. 하지만 모델 안에서 실제 분자를 발견했다는 뜻은 아닙니다. 풀이를 분석하는 틀을 제안하고, 숨은 표현과 어텐션도 조사하고, 그 분석으로 학습 자료를 만드는 연구입니다.
저희는 그중 가장 앞부분을 작게 시험했습니다. 실제 풀이를 나누고 행동 이름을 붙이는 단계입니다. 여기서 분류가 흔들리면 행동이 어떤 순서로 이어지는지 그린 그림도 달라질 수 있기 때문입니다.
먼저 풀이 16개를 모았습니다
정답을 프로그램으로 계산할 수 있는 산술·재고 문제 여덟 개를 준비했습니다. 각 문제를 시드 두 개로 실행해 풀이 16개를 수집했습니다. 결과를 본 뒤 보기 좋은 기록만 고르지 않고 미리 만든 문제 목록의 앞 여덟 개를 사용했습니다.
모델은 Ollama의 qwen3.5:9b, Q4_K_M입니다. 모델 정보상 약 9.7B이고, 문맥 한도는 24,576토큰입니다. 이번에는 추론 모드를 켰습니다. 온도는 0.6이고, 풀이와 최종 답을 합친 출력 한도는 1,024토큰입니다.
모든 풀이가 완성되지는 않았습니다. 16개 중 9개가 출력 한도에 걸렸고 7개는 올바른 최종 답을 냈습니다. 이 결과를 산술 정답률로 일반화하기는 어렵습니다. 일부는 계산을 끝내기 전에 길게 검토하다 잘렸기 때문입니다.
잘린 풀이도 남겼습니다. 끝까지 답을 낸 기록만 모으면 짧게 끝나는 풀이만 분석하게 될 수 있습니다. 대신 이번 자료에는 완성된 풀이와 중간에 끊긴 풀이가 섞여 있다는 점을 기억해야 합니다.
단계는 빈 줄을 기준으로 나눴습니다. 그렇게 나눈 조각이 세 개보다 적으면 줄 단위로 나누는 규칙을 썼습니다. 이 방법으로 총 171개 단계를 얻었습니다. 문단 하나가 언제나 한 행동만 담는 것은 아니므로 이 구분 자체도 완벽하지는 않습니다.
각 단계에 어떤 이름을 붙였습니까?
같은 모델에게 아래 네 종류 중 하나를 고르도록 했습니다. 분류할 때는 추론 모드를 끄고 온도 0을 사용했습니다.
| 기호 | 분류할 행동 | 풀이에서 볼 수 있는 내용 |
|---|---|---|
| N | 일반 계산·재진술 | 주어진 수를 더하거나 문제 조건을 정리합니다 |
| D | 새 관계 도출 | 앞의 조건에서 바로 보이지 않던 중간 결론을 얻습니다 |
| R | 검토·수정 | 앞의 계산이나 가정이 맞는지 다시 확인합니다 |
| E | 다른 경로 시도 | 다른 가설이나 풀이 방법을 시도합니다 |
N과 D를 나누는 경계부터 간단하지 않습니다. 짧은 계산으로 새 값을 얻는 것도 넓게 보면 도출이기 때문입니다. 그래서 분류 요청에는 D를 자명하지 않은 새 논리 관계로 설명했습니다. 그래도 모든 문장이 명확히 한 종류에만 들어가지는 않습니다.
분류 모델은 전체 풀이를 읽고 단계마다 기호 하나를 반환했습니다. 예를 들어 단계 열 개를 주면 기호도 열 개가 나와야 합니다. 이 개수와 허용된 기호를 코드로 검사했습니다. 내용이 맞는지를 보기 전에 결과를 비교할 수 있는 형태인지부터 확인한 것입니다.
표현 몇 개를 지우자 이름이 바뀌었습니다
첫 분류에는 원래 풀이를 넣었습니다. 두 번째에는 wait, however, alternatively, maybe, perhaps, let me, let us, double-check, actually, but, so에 해당하는 표현을 지웠습니다. 숫자와 수식을 바꾸려는 작업은 아니었습니다.
그렇지만 접속어나 추측 표현을 지우면 문맥이 달라질 수 있습니다. 의미를 완벽하게 보존했다고 가정하지는 않았습니다. 이 정도의 표현 변경에도 분류가 얼마나 유지되는지 보는 검사입니다.
총 32번 분류를 요청했고, 요구한 개수와 기호를 모두 지킨 응답은 25번이었습니다. 원본과 수정본 양쪽의 분류가 모두 유효할 때만 단계별로 비교했습니다. 그 결과가 아래와 같습니다.
| 비교 결과 | 단계 수 |
|---|---|
| 같은 이름을 붙인 단계 | 110개 |
| 다른 이름을 붙인 단계 | 18개 |
| 비교한 전체 단계 | 128개 |
일치율은 85.9%입니다. 이 수치는 분류가 정답과 맞은 비율이 아닙니다. 사람이 만든 정답 라벨은 없었습니다. 같은 풀이를 조금 다르게 제시했을 때 두 결과가 얼마나 같았는지를 센 것입니다.
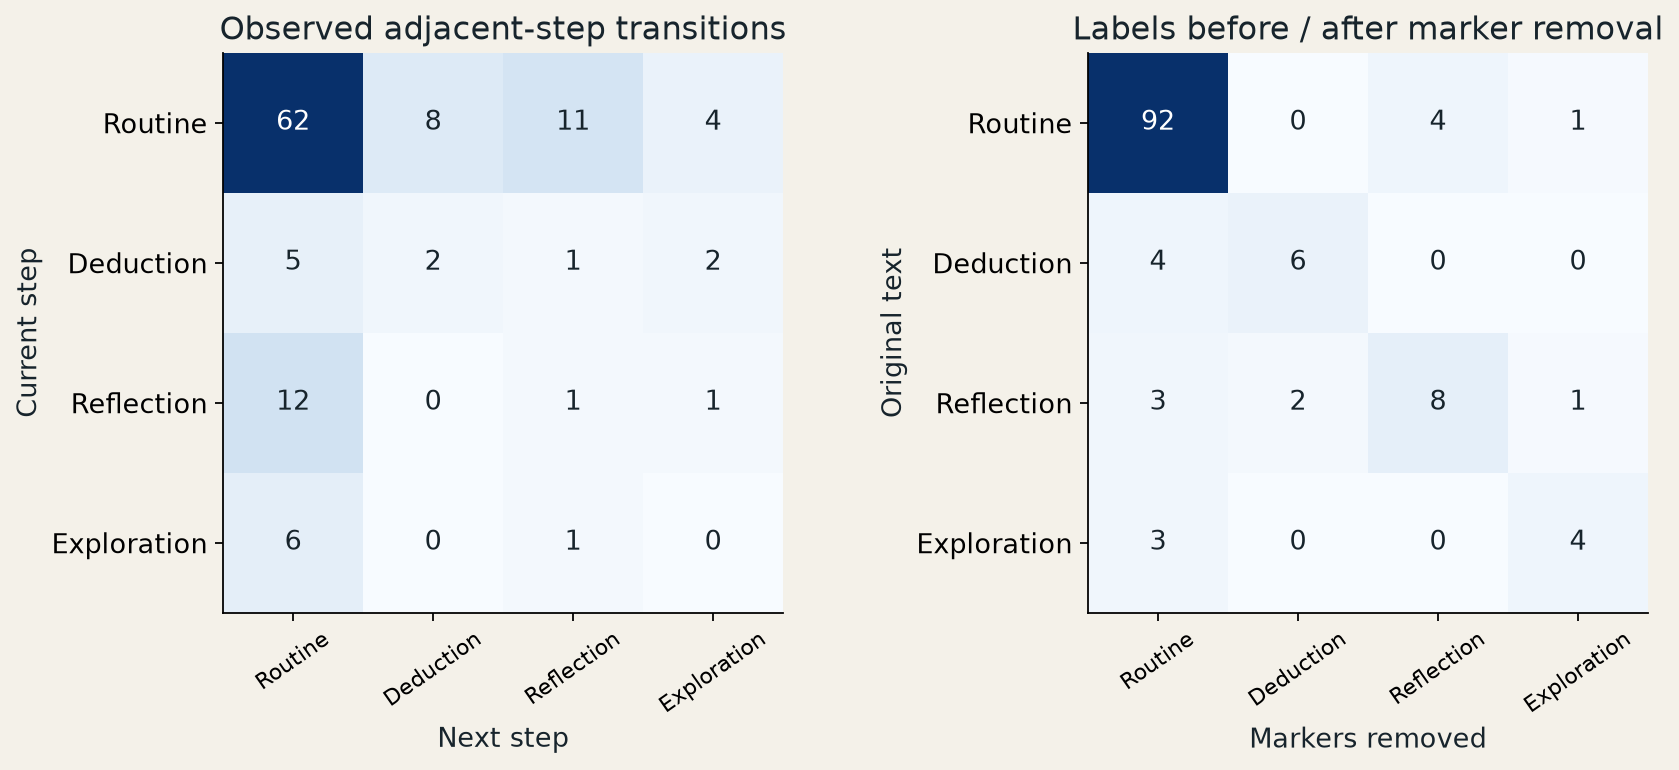
실제 검산 단계 하나에는 972 - 862 = 110, wait. 972 - 860이라는 구절이 있었습니다. 잘못 적은 뺄셈을 바로잡는 대목입니다. 원본을 분류했을 때는 N이었고 표현을 지운 뒤에는 R이 됐습니다. “wait”를 지웠더니 검산이라는 분류가 사라지는 단순한 결과도 아니었습니다.
또 최종 JSON 응답을 만드는 단계가 E로 분류됐다가 N으로 바뀐 사례도 있었습니다. 저희가 읽기에는 출력 형식을 정리하는 단계에 가깝습니다. 분류 결과가 그럴듯한 표로 나왔다고 바로 행동의 정답으로 삼기 어려운 이유입니다.
같은 모델이 풀이를 만들고 다시 분류했다는 한계도 있습니다. 다른 분류 모델이나 여러 사람의 판단과 비교하지 않았습니다. 원시 문장과 이름을 함께 공개해야 독자가 분류가 납득되는지 직접 볼 수 있습니다.
같은 행동이 이어지면 특별한 구조일까요?
분류를 마치면 “계산 다음에 검산이 몇 번 나왔는가”처럼 순서를 셀 수 있습니다. 유효한 원본 분류에서는 이웃한 단계 쌍을 116개 얻었습니다. 이 중 같은 이름이 이어진 쌍은 65개로 56.0%였습니다.
숫자만 보면 같은 행동을 한동안 이어 가는 경향이 있다고 생각하기 쉽습니다. 하지만 일반 계산 N이 원래 많으면 순서를 아무렇게나 바꿔도 N 다음에 N이 자주 나옵니다. 행동의 개수가 많은 것과 순서에 특별한 규칙이 있는 것은 구분해야 합니다.
그래서 각 풀이에 들어 있는 기호의 개수는 그대로 두고 순서만 섞었습니다. 예를 들어 N 다섯 개, R 두 개가 있는 풀이는 그 개수를 유지한 채 배치만 바꾸는 것입니다. 이를 1,000번 반복했습니다.
| 순서 | 같은 행동이 이어지는 비율 |
|---|---|
| 실제 풀이 | 56.0% |
| 순서를 섞은 결과의 평균 | 59.0% |
| 섞은 결과 중 가운데 95%가 들어간 범위 | 54.3~63.8% |
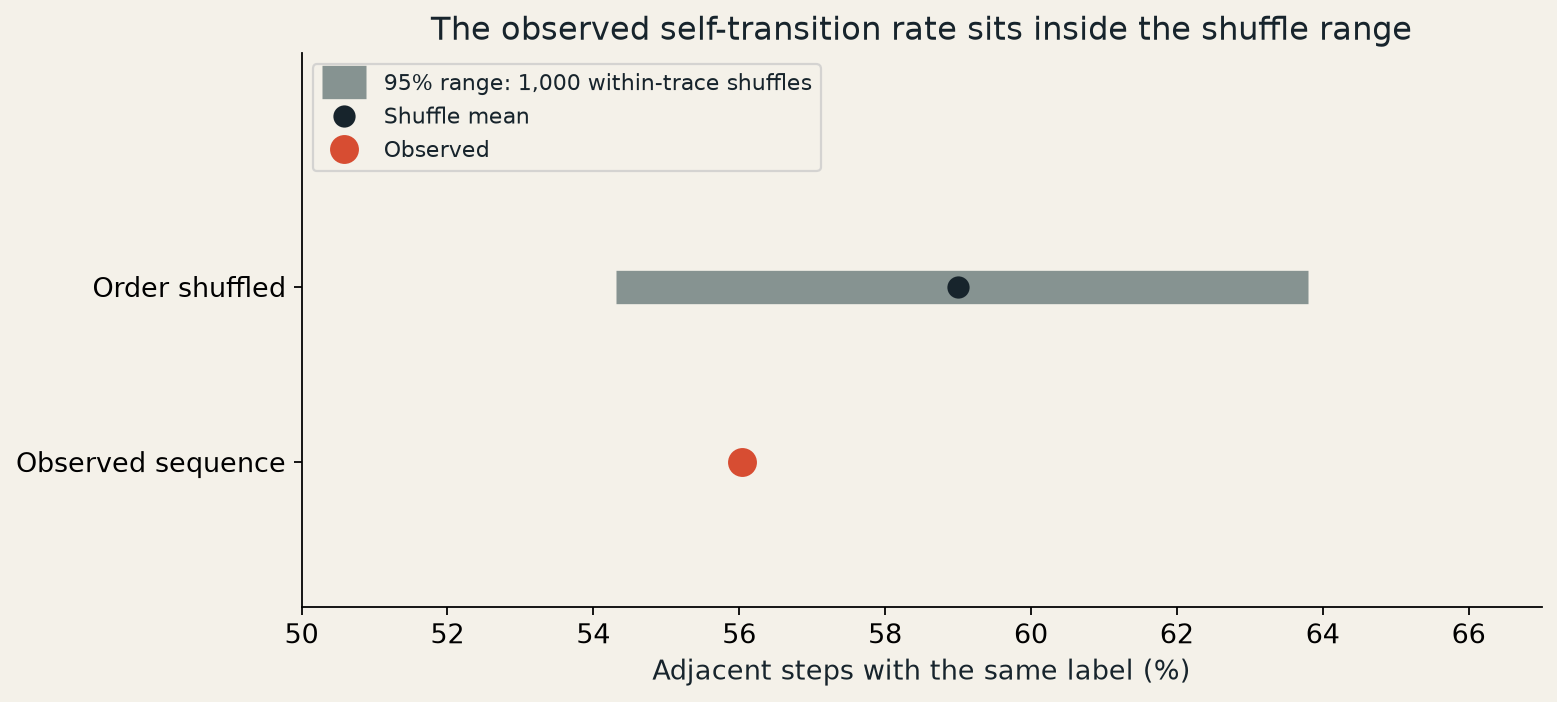
실제 값은 순서를 섞은 결과의 범위 안에 있었습니다. 이번 자료에서는 같은 행동이 연속해서 많이 나왔다는 숫자만으로 특별한 순서 규칙을 주장할 수 없었습니다.
그렇다고 풀이 순서 전체가 무작위라는 결론도 아닙니다. 계산에서 검산으로 넘어가는 특정 패턴이나 멀리 떨어진 단계 사이 관계까지 모두 확인한 것은 아니기 때문입니다. 저희가 검사한 것은 같은 이름이 바로 이어지는 비율 하나입니다.
원문은 이 분석을 학습 자료 생성으로 이어 갑니다
원문의 Mole-Syn은 행동 사이 전환을 이용해 긴 풀이를 만듭니다. 강한 추론 모델의 기록에서 행동의 분포와 전환을 추정한 뒤, 지시 수행 모델에게 단계별 행동을 요청합니다. 이렇게 만든 자료로 학생 모델을 학습하고 결과를 비교합니다.
따라서 “문장에 wait를 넣으면 똑똑해진다”는 주장으로 읽으면 핵심을 놓칩니다. 어느 단계에서 가정을 점검하고 언제 다른 방법을 시도하는지 같은 행동 구성을 학습 자료에 반영하려는 접근입니다. 강한 교사 모델의 정보도 처음 분석에 사용됩니다.
원문은 표지어를 바꾸거나 지운 자료로 모델을 학습하는 비교도 보고합니다. 저자들은 표현이 학습 속도에 영향을 줄 수 있지만 추론 과정이 유지되고 충분히 학습하면 비슷한 성능에 도달할 수 있다고 설명합니다. 저희가 수행한 분류 안정성 검사와는 다른 실험입니다.
저희는 학생 모델을 학습하지 않았습니다. 그러므로 이번 분류 결과가 논문의 학습 효과를 재현하거나 반박하지는 않습니다. 그 효과를 확인하려면 비슷한 길이와 품질의 자료를 준비하고, 행동 순서를 따른 조건과 순서를 바꾼 조건으로 학생을 각각 학습해야 합니다. 정답으로 걸러낸 비율과 학습량도 맞춰야 합니다.
‘분자’라는 표현은 어디까지 받아들이면 될까요?
원문은 행동 분류 외에 숨은 표현을 낮은 차원에 표시하거나, 어텐션 로짓을 분석하는 작업도 합니다. 이때 그림의 점은 뉴런 하나의 위치가 아닙니다. 선택한 모델의 표현을 모으고 변환해 얻은 값입니다. 논문에서 에너지라고 부르는 값도 어텐션 로짓을 바탕으로 정의한 수학적 값입니다.
이런 표현은 분석 방법을 설명하는 데 도움이 될 수 있습니다. 다만 화학 분자와 같은 물리 법칙으로 AI가 생각한다는 사실을 확인한 것은 아닙니다. “이제 AI의 생각이 어떻게 생겼는지 알게 됐다”는 소개는 실제 측정보다 훨씬 넓은 주장입니다.
저희가 이번에 직접 확인한 범위는 작지만 명확합니다. 같은 풀이에도 분류가 달라질 수 있었고, 행동 순서를 해석할 때는 각 행동이 원래 얼마나 많은지도 따져야 했습니다. 이런 검사를 거친 다음에 그림이나 학습 결과를 읽으면 무엇이 관측이고 무엇이 해석인지 구분하기 쉬워집니다.
실행 자료
재현 파일에는 실제 풀이 16개, 단계 구분 결과, 원본과 수정본의 분류, 분류 요청문, 순서 섞기 코드가 들어 있습니다. 저장된 기록을 분석하는 데는 모델이 필요하지 않습니다. 숨은 상태 추출과 학생 학습은 포함하지 않습니다.
2026년 11월 16일 수정: 한국어 본문을 풀이 수집과 분류 사례부터 설명하도록 새로 썼습니다.
논문의 설명과 직접 실행한 결과를 함께 읽고 싶으시면 아래에서 뉴스레터를 구독하실 수 있습니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
molecular-structure-thought-repro.zip · 4,673 KB