멀티 에이전트 구조 5가지를 직접 만들어 같은 일을 시켰습니다: 1등은 에이전트 한 명, 일을 넘기는 팀은 파일을 한 번도 저장하지 못했습니다
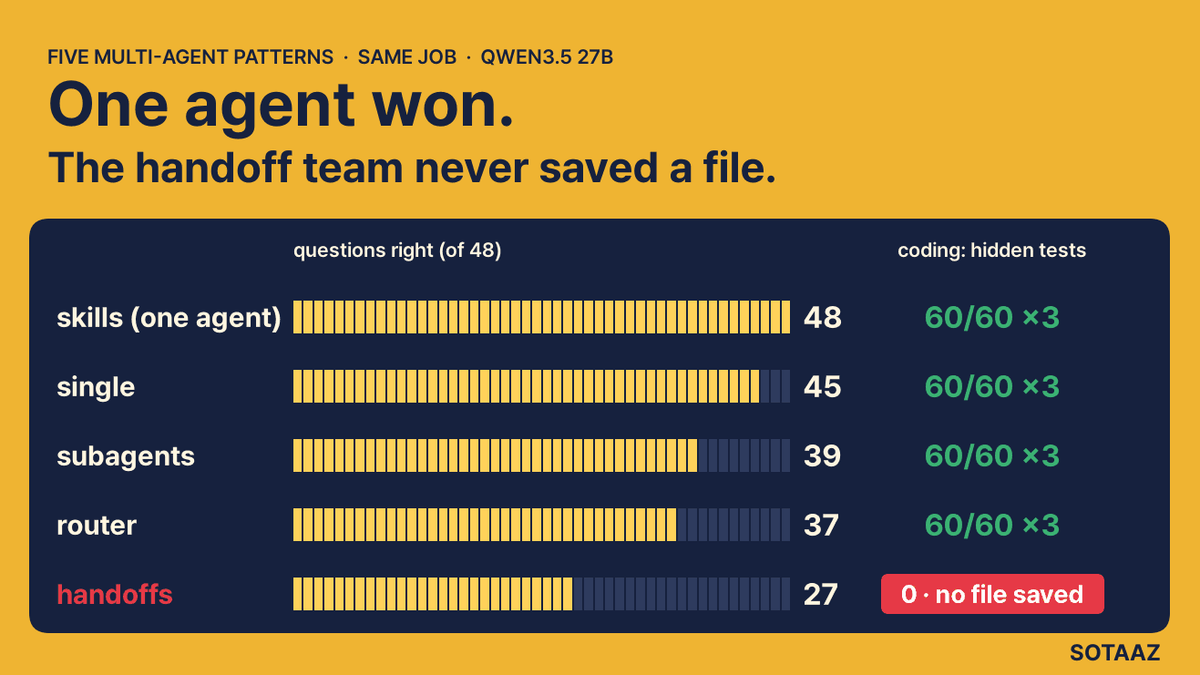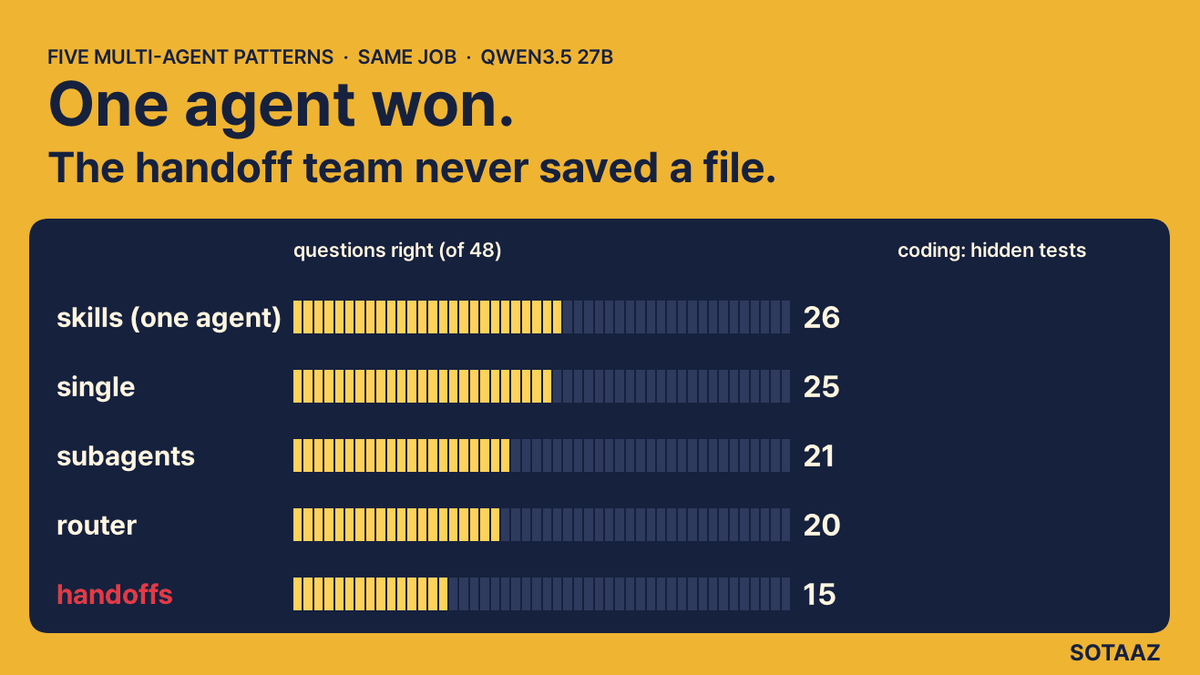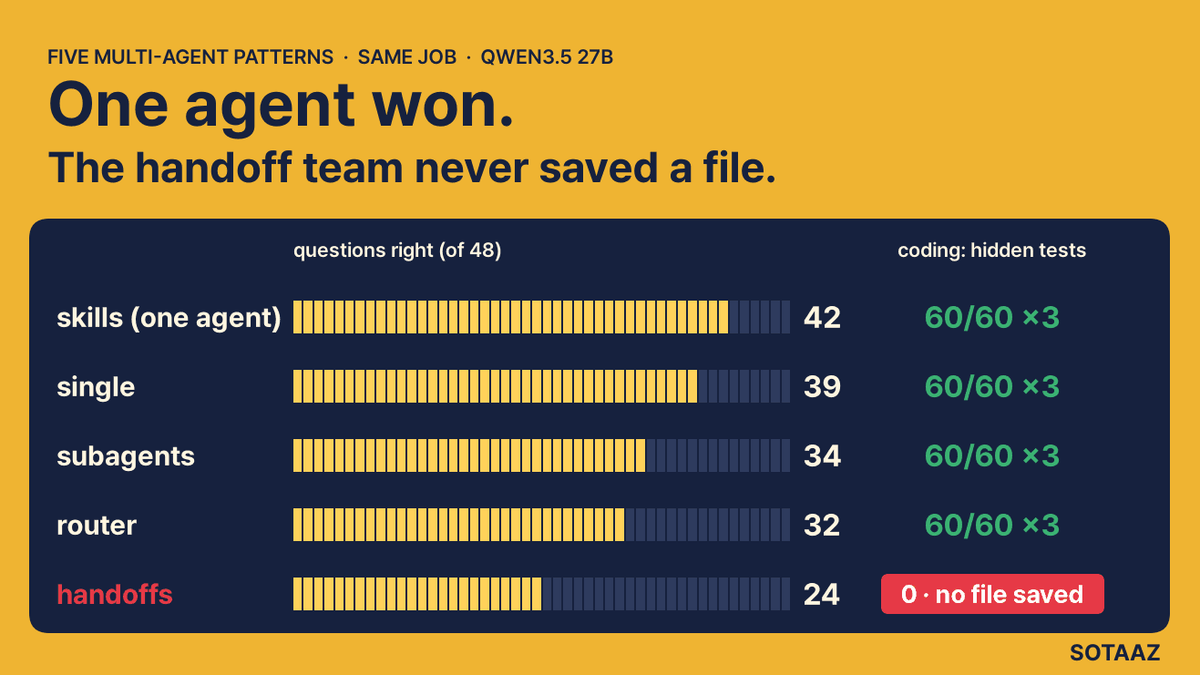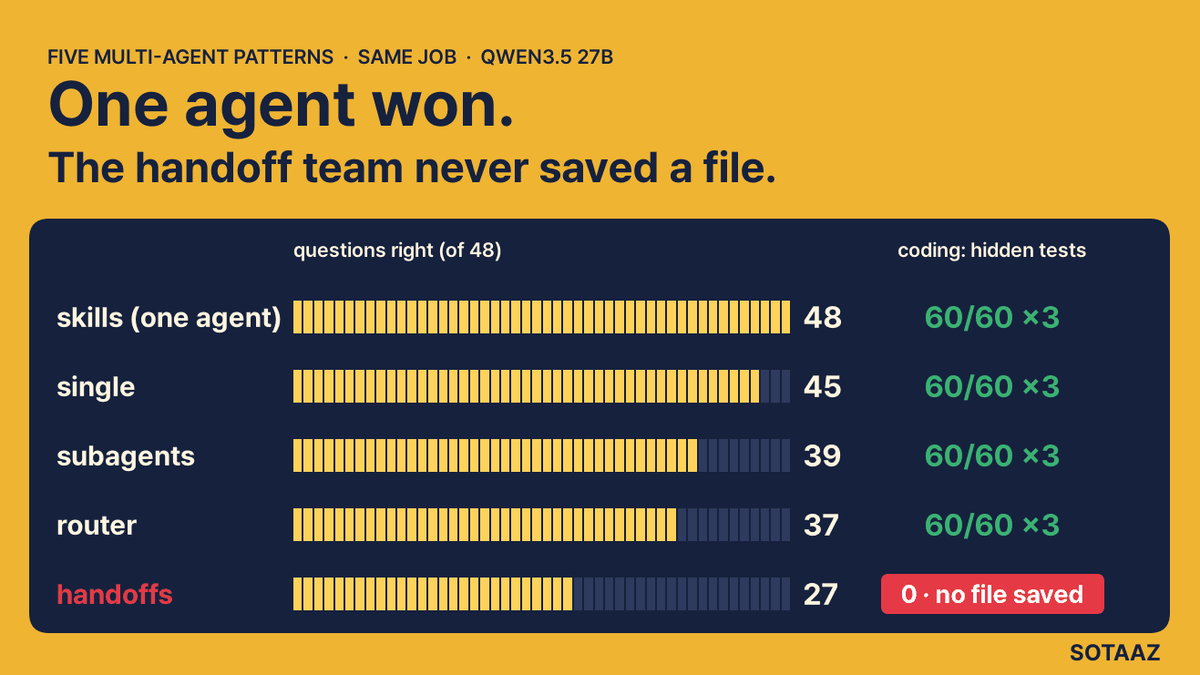
single, skills, subagents, handoffs, router를 파이썬 파일 하나로 만들고 로컬 Qwen3.5 27B로 돌렸습니다. 규정 질문 16개(3회)에서 skills는 48번 중 48번, handoffs는 27번 맞혔습니다. 비공개 테스트 60개로 채점한 코딩 과제에서 네 구조는 세 번 모두 60개를 통과했고 handoffs는 세 번 모두 0개였습니다. 코딩에서 subagents와 router는 skills보다 토큰을 약 2배 썼습니다.
멀티 에이전트 구조 5가지를 직접 만들어 같은 일을 시켰습니다: 1등은 에이전트 한 명, 일을 넘기는 팀은 파일을 한 번도 저장하지 못했습니다
멀티 에이전트는 일을 AI 하나에 다 맡기지 않고 배송, 반품, 멤버십처럼 담당을 나눠 여러 AI에게 맡기는 방식입니다. 각자 자기 부분만 보니 혼자 다 할 때보다 정확할 것 같습니다. 저희가 에이전트를 나누는 방식 다섯 가지를 직접 만들어 같은 일을 시켜 보니 가장 잘한 것은 에이전트 한 명이었을 때입니다. 필요한 문서만 그때그때 불러오는 skills 구조가 질문 48번을 모두 맞혔고, 코딩 과제의 비공개 테스트도 전부 통과했습니다. 만점을 받은 구조 가운데 토큰도 가장 적게 썼습니다.
가장 못한 쪽은 대화를 통째로 넘겨받는 팀이었습니다. 코딩 과제에서 담당자 넷이 일을 넘기기만 했고, 마지막으로 받은 담당자는 한 번도 본 적 없는 배송 요금표를 지어냈습니다(1구역 5달러, 실제 문서는 4달러). 그러다 토큰 한도에 걸려 파일을 저장하지 못했습니다. 비공개 테스트 60개 중 0개였고, 세 번 돌려 세 번 다 같았습니다.
에이전트를 나눈다는 것
에이전트는 반복해서 도는 모델입니다. 대화를 읽고, 답하거나 도구를 부르고, 도구 결과를 본 뒤 다시 돕니다. 문제는 일에 필요한 지식이 프롬프트 하나에 넣기 부담스러울 만큼 많을 때 생깁니다. 이번 실험에서 그 지식은 가상의 온라인 상점이 쓰는 규정 문서 세 장, 즉 배송, 반품, 멤버십 규정입니다.
LangChain은 1월 14일 글 Choosing the Right Multi-Agent Architecture에서 이 상황을 푸는 구조 네 가지를 소개했습니다. 저희는 비교 기준으로 가장 단순한 에이전트 한 명을 더해 다섯 가지를 만들었습니다. 고객 질문 하나가 어떤 길을 지나는지로 설명하면 이렇습니다.
- single: 문서 세 장을 모두 시스템 프롬프트에 넣은 에이전트 한 명입니다. 도구는 없습니다.
- skills: 에이전트 한 명이
load_skill(name)도구를 갖습니다. 문서마다 무엇을 다루는지 짧은 목록만 보고 시작해서, 필요한 문서를 직접 불러옵니다. - subagents: 문서가 없는 관리자가
ask_shipping,ask_returns,ask_membership도구로 전문가를 부릅니다. 전문가는 부를 때마다 새로 시작하고, 자기 문서와 관리자가 쓴 요청만 봅니다. - handoffs: 안내 데스크와 전문가 셋이 대화 하나를 같이 씁니다.
transfer_to(agent)를 부르면 말하는 담당자의 시스템 프롬프트만 바뀌고 대화 기록은 그대로 남습니다. 고객센터에서 전화를 돌리는 것과 같습니다. - router: 분류 호출이 질문에 필요한 담당을 고르고, 고른 전문가들이 동시에 답한 뒤, 마지막 호출이 답을 합칩니다.
프레임워크는 쓰지 않았습니다. 다섯 구조를 파이썬 파일 하나에 직접 써서 모든 호출이 보이게 했습니다. 그래서 skills와 handoffs의 차이도 코드 몇 줄로 드러납니다. skills에서는 도구 결과가 곧 문서이고, 그 문서가 대화에 남습니다.
for tc in msg["tool_calls"]:
    name = args_of(tc).get("name")
    out = DOCS.get(name, f"unknown skill {name}")
    msgs.append({"role": "tool", "tool_call_id": tc.get("id", ""), "content": out})
handoffs에서는 문서가 각 전문가의 시스템 프롬프트에 들어 있습니다. 넘기기는 말하는 사람만 바꾸고, 도구 결과로 남는 것은 "transferred to shipping"이라는 한 줄뿐입니다.
nxt = args_of(tc).get("agent")
convo.append({"role": "tool", "tool_call_id": tc.get("id", ""),
              "content": f"transferred to {nxt}" if ok else f"unknown agent {nxt}"})
if ok:
    state["active"] = nxt
그러니 배송 담당이 반품 담당에게 일을 넘기면 배송 요금표도 함께 사라집니다. 코딩 과제의 결과가 바로 이 차이에서 갈립니다.
직접 재 본 이유
LangChain 글은 구조별 모델 호출 수와 토큰을 표로 비교합니다. 여러 분야가 섞인 질문에서 subagents는 약 9K, skills는 약 15K 토큰으로 적혀 있고, 본문은 subagents가 토큰을 더 적게 쓴다고 설명합니다. 다만 숫자에는 근사치 표시가 붙어 있고, 전제는 에이전트 하나가 맡는 문서가 약 2,000토큰이라는 것 하나입니다. 실제로 돌려서 쟀다는 설명은 없습니다. 비용을 가늠하는 방법으로는 충분히 쓸 만한 추정입니다. 저희는 다섯 구조를 같은 질문에 실제로 돌리면 무엇이 나오는지 보고 싶었습니다.
실험: 가짜 상점과 계산기
존재하지 않는 상점 Kestrel Supply의 규정을 세 장으로 썼습니다. 배송 규정은 1,188토큰, 반품 898토큰, 멤버십 756토큰입니다. 숫자는 모두 지어낸 것이라 모델이 외운 지식으로 답할 수 없습니다. 정답은 규정을 코드로 옮긴 계산기가 내므로 사람이 채점하지 않습니다.
이 중 한 문장이 나중에 중요해집니다. 실제 회사 문서가 흔히 그렇듯 배송 규정에는 담당 범위가 적혀 있습니다. "멤버십 할인은 이 문서에 없고, 멤버십 팀 소관이다." 저희가 일부러 넣은 문장입니다.
조건은 다섯 구조 모두 같습니다. llama.cpp에서 Qwen3.5-27B Q4_K_M을 돌렸고, temperature는 0, 생각 모드는 껐습니다. 과제마다 세 번씩(seed 42, 43, 44) 돌렸습니다. temperature가 0이라 세 번의 결과가 거의 같았습니다. 그러니 세 번은 결과가 우연이 아니라는 근거일 뿐, 독립된 실험 세 번으로 볼 수는 없습니다.
과제는 두 가지입니다.
- 질문 과제: 질문 16개를 구조마다 48번 물었습니다. 마지막 줄
ANSWER: <숫자>가 계산기 값과 0.5센트 안에서 같으면 맞힌 것으로 셉니다. 2,048토큰 한도에 걸려 잘린 답은 틀린 것으로 셉니다. - 코딩 과제: 함수 세 개(
shipping_fee,delivery_days,refund)를 파일 하나kestrel.py에 구현합니다. 에이전트는 공개 테스트 5개를 돌려 볼 수 있고, 채점은 끝난 파일을 비공개 테스트 60개로 돌려서 합니다.
1라운드: 문서를 보고 답하기
문서 한 장만 보면 되는 질문은 다섯 구조 모두 12번 중 12번 맞혔습니다. 차이는 문서 두세 장을 함께 봐야 하는 질문에서 벌어졌습니다.
| 구조 | 정답(48번 중) | 문서 1장 | 문서 2장 | 문서 3장 | 평균 토큰 | 평균 호출 |
|---|---|---|---|---|---|---|
| skills | 48 | 12/12 | 12/12 | 12/12 | 4,391 | 2.3 |
| single | 45 | 12/12 | 12/12 | 9/12 | 4,468 | 1.3 |
| subagents | 39 | 12/12 | 12/12 | 3/12 | 6,422 | 5.0 |
| router | 37 | 12/12 | 9/12 | 4/12 | 6,913 | 4.8 |
| handoffs | 27 | 12/12 | 3/12 | 0/12 | 4,452 | 2.6 |
나머지 12번은 같은 대화에서 후속 질문을 하나 더 하는 2턴 질문이었고, 다섯 구조 모두 둘째 답을 12번 다 맞혔습니다.
가장 분명하게 갈린 것은 문서 두 장짜리 질문입니다. "Silver 회원이 8kg 소포를 일반 배송으로 98로 시작하는 5구역 우편번호에 보냅니다. 배송비는 모두 얼마입니까?" 정답은 28.40달러입니다. 기본 요금 18달러에 Silver 할인 20%를 적용하고, 외딴 지역 추가 요금 14달러를 더한 값입니다.
handoffs에서 안내 데스크는 배송 담당에게 제대로 넘깁니다. 그런데 배송 담당은 그 소관 문장을 읽고 그대로 인용한 뒤에도 질문을 붙잡고 있습니다.
"규정 서문에 '멤버십 할인은 이 문서에 없고, 멤버십 팀 소관이다'라고 분명히 적혀 있습니다. 저는 배송 담당이고 제 문서에는 Silver 회원 할인 규칙이 없으므로 할인을 적용할 수 없습니다." (모델은 영어로 답했고, 위 문장은 저희가 옮긴 것입니다.)
답은 세 번 모두 32달러였습니다. 시스템 프롬프트에는 필요한 규정이 없으면 그 규정을 가진 담당에게 넘기라고 적혀 있었고, 배송 담당은 방금 자기에게 그 규정이 없다고 썼습니다. 같은 질문에서 skills는 첫 호출에 shipping과 membership을 불러와 28.40달러를 맞혔습니다.
이 질문 하나만의 일이 아니었습니다. handoffs는 48번 중 21번 틀렸는데, 그 21번 모두 멤버십 담당은 대화를 한 번도 넘겨받지 못했습니다. subagents도 문서 세 장짜리 질문 하나에서 비슷하게 틀렸습니다. 관리자가 배송과 반품 담당에게만 묻고 멤버십 담당에게는 끝내 묻지 않았습니다.
router는 다른 방식으로 틀렸습니다. Gold 회원의 전자제품 반품 질문에서 반품 담당은 기한이 지나 환불액이 0달러라고 했고, 멤버십 담당은 반품 규정 없이는 금액을 계산할 수 없다고 했습니다. 두 답을 합치는 호출은 그 사이를 오가다(기록된 실행에서 "However" 6번, "Wait" 3번) 답을 쓰기 전에 토큰 한도에 걸렸습니다. 세 번 모두 같은 질문에서 그랬습니다. 질문 과제 전체로 보면 router는 48번 중 11번 잘렸는데, 합치는 단계에서 잘린 때도 있고 전문가 단계에서 잘린 때도 있었습니다.
2라운드: 코드 짜기
코딩 과제는 일을 나눈 팀에 특히 까다롭습니다. 멤버십 규정이 배송비와 환불액을 모두 바꾸기 때문에, 멤버십 부분을 맡은 쪽은 남이 쓴 코드를 고쳐야 합니다.
| 구조 | 비공개 테스트 통과(3회) | 평균 토큰 | 평균 호출 | 파일을 쓴 쪽 |
|---|---|---|---|---|
| skills | 60, 60, 60 | 21,601 | 5.0 | 에이전트 |
| single | 60, 60, 60 | 22,067 | 4.0 | 에이전트 |
| subagents | 60, 60, 60 | 43,002 | 9.3 | 관리자 |
| router | 60, 60, 60 | 45,738 | 8.0 | 병합 담당 |
| handoffs | 0, 0, 0 | 14,376 | 5.3 | 없음 |
에이전트 한 명은 파일을 읽고, 한 번 쓰고, 테스트를 돌리고 끝냈습니다. subagents와 router도 비공개 테스트를 모두 통과했습니다. 관리자나 병합 담당 한 명이 전문가들의 코드를 모아 파일을 썼기 때문입니다. 다만 그러느라 토큰을 skills의 약 2배 썼습니다. skills가 21,601토큰일 때 subagents는 43,002토큰, router는 45,738토큰이었습니다.
handoffs는 이 글 첫머리에 적은 장면입니다. 넘기기가 어떻게 이어졌는지 담당자마다 쓴 토큰 수와 함께 적으면 이렇습니다. 인용한 문장은 첫 번째 실행과 같은 seed로 다시 돌린 기록에서 가져왔고, 이 기록은 호출 순서와 토큰 수까지 같았습니다. 점수는 본 측정의 것만 씁니다.
- 안내 데스크(27토큰, 이어서 94토큰): 파일을 읽고, 자기에게 문서가 없으니 배송 담당에게 넘깁니다. 여기까지는 맞습니다.
- 배송 담당(56토큰): 코드를 쓰지 않습니다. "반품과 멤버십 규정도 받아 오겠다"며 반품 담당에게 넘깁니다. 이 순간 자기 요금표도 같이 사라집니다.
- 반품 담당(49토큰): 똑같습니다. "멤버십 규정도 받아 오겠다"며 멤버십 담당에게 넘깁니다.
- 멤버십 담당(4,096토큰에서 잘림): 첫머리에 "규정 세 개를 다 받았다"고 씁니다. 몇 줄 뒤에는 배송과 반품 규정이 지금 자기 컨텍스트에 없다고 씁니다. 실제로 가진 문서는 멤버십 한 장뿐입니다.
멤버십 담당의 프롬프트에는 "숫자를 추측하지 말라"는 문장이 있고, 모델은 그 문장을 자기 추론 안에 다섯 번이나 다시 적습니다. 그러고는 "배송 규정 가정(일반적인 값)"이라는 제목 아래 숫자를 채워 넣습니다.
| 규칙 | 지어낸 값 | 실제 문서 |
|---|---|---|
| 1구역 기본 요금(2kg 이하) | 5달러 | 4.00달러 |
| 대형 추가 요금 | 10달러 | 9.00달러 |
| 가구 반품 기한 | 14일 | 7일 |
| 전자제품 재입고 수수료 | 15% | 12% |
하나도 맞지 않습니다. 이렇게 쓰다가 4,096토큰 한도에 걸렸고, 세 번 모두 파일은 저장되지 않았습니다. 안내 데스크, 배송, 반품, 멤버십으로 넘어가는 순서도 세 번 모두 같았습니다.
저희가 쓴 도구 설명이 이 실패에 한몫했을 수 있습니다. transfer_to 설명은 "다음 담당이 대화 전체와 같은 파일을 본다"입니다. 문서는 각 담당의 시스템 프롬프트에만 있어서 넘어가지 않는데, 배송과 반품 담당이 "규정도 받아 오겠다"고 쓴 것을 보면 넘기면 규정을 받아 올 수 있다고 읽은 것 같습니다. 설명을 바꾼 버전은 돌리지 않았으므로, 0점 가운데 얼마가 이 문장 때문인지는 이 실험으로 가릴 수 없습니다.
두 과제를 나란히 놓으면 handoffs는 정반대 방향으로 실패했습니다. 질문 과제에서는 넘겨야 할 때 넘기지 않았고, 코딩 과제에서는 넘기기만 했습니다.
LangChain 표와 비교하면
LangChain의 추정에서는 여러 분야가 섞인 질문에서 subagents가 skills보다 토큰을 적게 씁니다. 저희 측정에서는 반대였습니다. 질문 과제에서 subagents는 skills의 1.46배(6,422 대 4,391토큰), 코딩 과제에서는 1.99배(43,002 대 21,601토큰)를 썼습니다.
저희는 문서 크기 때문이라고 추정합니다. 저희 문서는 756토큰에서 1,188토큰으로, LangChain 글이 전제한 2,000토큰보다 작습니다. 문서가 작으면 문서를 불러오는 비용보다 에이전트끼리 주고받는 비용, 곧 관리자의 요청과 전문가의 답과 관리자가 그 답을 다시 읽는 비용이 더 커집니다. 문서가 커지면 순서가 다시 뒤집힐 수 있습니다. 더 큰 문서로는 돌리지 않았으니 이 부분은 추정으로 남습니다.
LangChain 글은 Anthropic의 결과도 인용합니다. Opus 4가 이끌고 Sonnet 4가 서브에이전트를 맡은 멀티 에이전트 리서치 시스템이 Opus 4 단독보다 내부 리서치 평가에서 90.2% 좋았다는 내용입니다. 이것은 여러 곳을 동시에 넓게 찾아보는 일이라, 깨끗한 컨텍스트를 따로 여러 개 두는 것이 도움이 됩니다. 저희 과제는 문서 세 장의 규칙을 합쳐 숫자 하나나 파일 하나를 내는 일이었고, 저희 결과도 그런 일에 대해서만 말해 줍니다.
제안하는 방법
태스크가 어려워보여도 우선 에이전트 한 명으로 시작해보세요. 생각보다 하나의 에이전트가 할 수 있는 일이 많습니다. 문서가 커져 프롬프트 하나에 다 넣기 어려워지면, 그 에이전트가 필요한 문서만 불러오게 합니다. 이번 실험에서 skills는 질문과 테스트를 모두 맞혔고, 만점을 받은 구조 가운데 토큰을 가장 적게 썼습니다. 팀은 정말로 동시에 돌려야 하는 일처럼 한 명이 감당할 수 없는 이유가 생겼을 때 만듭니다.
팀을 만든다면 누가 최종 파일을 쓰고 누가 최종 답을 내는지부터 정해 둡니다. subagents와 router 팀이 코딩 과제를 통과한 것은 파일을 책임지는 한 명이 있었기 때문입니다. handoffs 팀에는 그런 담당이 없었고, 결국 지어낸 요금표만 남긴 채 아무것도 저장하지 못했습니다.
같은 상담 창구 상황은 앞서 Anthropic의 single-agent-loop-kit을 로컬 모델로 돌린 글에서도 다뤘습니다. 그때도 라우터와 서브에이전트 여섯을 루프 하나로 합친 쪽이 과제를 더 많이 풀었습니다(19개 중 18개 대 16개). 다른 모델로 이 다섯 구조를 돌려 보시면 무엇이 달라졌는지 알려 주세요. 새로 잰 결과는 아래 뉴스레터로 보내 드립니다.
주간 뉴스레터에 새 글 링크를 담아 보냅니다. 메일은 영어로 발송됩니다.