Anthropic은 서브에이전트를 루프 하나로 합치라고 합니다. 키트를 직접 돌려 보니 평균 2.5배 빨랐고, 과제 19개 중 18개 대 16개를 풀었습니다
Anthropic이 서브에이전트를 루프 하나로 합치라며 공개한 single-agent-loop-kit을 로컬 모델(Qwen3.8 Flash Next)로 돌렸습니다. 과제 19개에서 라우터 버전은 16개, 단일 루프 버전은 18개를 풀었고 과제당 평균 시간은 19.7초와 8.0초였습니다. 라우터는 팀 규칙 세 개 사이를 맴돌다 빈 답장을 냈고, 단일 루프는 반품 도구 설계 때문에 반품 문의 한 건(t05)을 틀렸습니다. 모델 하나, 결정적 디코딩이라 유의성 주장은 아닙니다.
Anthropic은 서브에이전트를 루프 하나로 합치라고 합니다. 키트를 직접 돌려 보니 평균 2.5배 빨랐고, 과제 19개 중 18개 대 16개를 풀었습니다
Anthropic이 10월 22일 서브에이전트 관련 글 Building agents: When to fold subagents into your main agent loop을 발표했습니다. 일을 여러 서브에이전트에게 나눠 맡기던 에이전트를, 에이전트 하나가 모든 도구를 직접 부르는 루프 하나로 합치라는 내용입니다. 나눌수록 넘겨주는 과정에서 정보가 빠지고, 이제는 모델이 도구 여러 개를 혼자 다룰 만큼 좋아졌다는 것이 이유입니다. 하루 전인 10월 21일에는 실습 자료 single-agent-loop-kit도 공개했습니다. 고객 상담 앱 하나를 라우터와 서브에이전트 여섯 개로 만든 버전과, 루프 하나로 합친 버전이 같이 들어 있습니다.
키트 README에는 아직 실제 모델로 돌려 보지 않은 것들이 적혀 있었고, 합친 버전도 그 목록에 있었습니다. 저희가 두 버전을 저희 서버의 로컬 모델로 돌려 봤습니다. 과제 19개 중 라우터 버전은 16개, 단일 루프 버전은 18개를 완료했고, 과제당 평균 시간은 19.7초와 8.0초였습니다. 모델 하나에서 과제 두 개 차이이고, 합친 버전은 구조 말고도 바뀐 것이 많습니다. 이 단서들은 아래에서 하나씩 짚습니다.
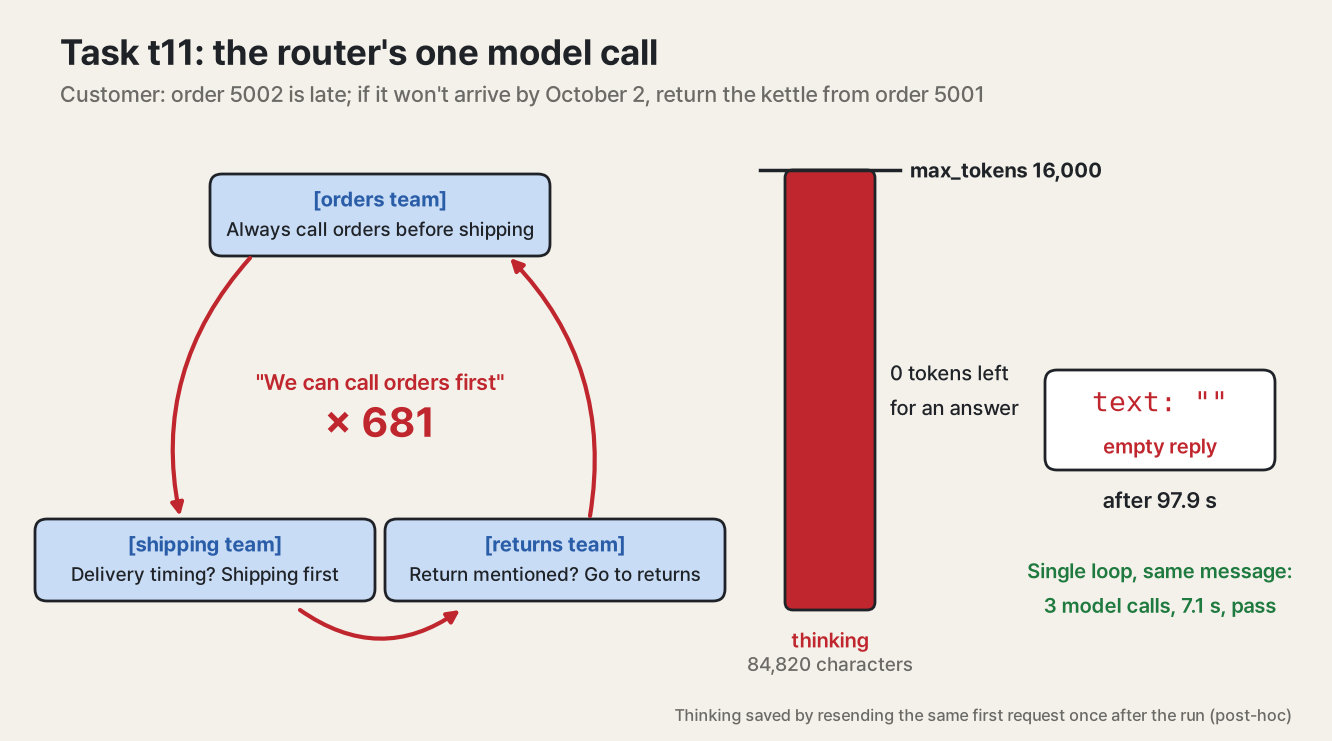
차이가 가장 크게 난 문의는 이것이었습니다. "5002번 주문이 너무 늦어요. 10월 2일까지 안 오면 5001번 주문의 주전자를 반품하고 싶어요." 라우터 버전은 모델을 한 번 불러 출력 한도인 16,000토큰을 전부 생각에 쓰고, 97초 만에 빈 답장을 냈습니다. 생각 내용을 저장해 보니 라우터 프롬프트에 여러 팀이 덧붙인 규칙 세 개 사이를 맴돌고 있었습니다. 단일 루프 버전은 같은 문의를 7.1초에 끝냈고, 10월 3일 도착 예정이라고 알려 준 뒤 반품도 접수했습니다. 이 사례는 "실패 1"에서 자세히 봅니다.
코드 링크와 행 번호는 모두 키트의 유일한 커밋 c437962 기준입니다.
원래 글이 말하는 것
먼저 용어를 정리합니다. 서브에이전트는 메인 에이전트가 일을 맡기는 별도 에이전트입니다. 자기 프롬프트와 자기 도구를 갖고 따로 돌며, 끝나면 요약만 돌려줍니다. 단일 루프는 서브에이전트 없이 에이전트 하나가 모든 도구를 직접 부르는 구조입니다.
Anthropic이 10월 22일 발표한 서브에이전트 관련 글은 많은 에이전트 시스템이 주문, 배송, 반품처럼 문제 유형별로 서브에이전트를 나눴고, 그 결과 일을 넘길 때마다 세부 내용은 빠진 채 유형만 전달하는 "전화 놀이"가 된다고 봅니다. 구조가 조직도를 그대로 닮는다는 지적도 합니다. 그래서 나누려면 문제 유형이 아니라 컨텍스트를 기준으로 나누라고 권합니다. 그러면 서브에이전트가 필요 없는 것 아니냐는 물음에, 그럼에도 서브에이전트를 남길 이유로 세 가지를 듭니다. 컨텍스트가 실제로 너무 커지는 경우, 깨끗한 컨텍스트 여러 개를 병렬로 돌려야 하는 경우, 도구 선택이 헷갈리거나 프롬프트끼리 충돌하는 경우입니다. 그 밖에는 메인 루프로 하나씩 합치고, 과제 완료 평가에서 합친 쪽이 더 나쁠 때만 서브에이전트로 남기라는 것이 결론입니다.
원글에는 관련한 수치도 나옵니다. 한 고객사는 단일 루프로 바꾼 뒤 약 2배 빨라졌고, 도구 정의가 30-50개를 넘으면 도구 선택이 나빠진다고 합니다. 서브에이전트를 루프 하나로 합치는 출발점으로는 "명확한 시스템 프롬프트 하나, 얇은 데이터 도구 4-5개, 단단한 출력 가드레일"을 권합니다. 이 수치들은 원글의 것이고, 저희가 잰 것은 아닙니다.
예제: 에이전트 일곱 개짜리 상담 창구
키트의 examples/support-desk/에는 가상의 가전 판매점 Tamberwick Home이 들어 있습니다. 바꾸기 전 버전인 app/에는 라우터 하나와 서브에이전트 여섯 개(orders, shipping, returns, account, diagnostics, claims)가 있습니다. 바꾼 뒤 버전인 single_loop/에는 루프 하나와 도구 여덟 개가 있습니다.
평가 파일 evals/golden.jsonl에는 고객 문의 19개가 t01부터 t19까지 번호를 달고 들어 있습니다. 문의마다 "답에 October 3이 들어가야 한다", "답에 E42가 나오면 안 된다" 같은 검사 조건이 붙어 있고, 조건을 모두 만족하면 그 과제를 완료한 것으로 셉니다. 이 글에 번호로 나오는 과제는 네 개입니다.
- t01: Ana라는 고객이 5002번 주문 상태를 묻습니다. 배송 중이라는 것과 10월 3일 도착 예정일을 알려 줘야 합니다.
- t05: 다른 고객이 5003번 주문 토스터를 반품하겠다고 합니다. 받은 지 52일이 지나 30일 반품 기한을 넘겼으니, 기한을 설명하고 반품은 접수하지 않아야 합니다.
- t11: 도입부에서 소개한 문의입니다. 5002번 도착 예정일을 알려 주고, 10월 2일까지 못 오니 5001번 주전자 반품을 접수해야 합니다.
- t16: 고객이 청소기가 빨간 불을 깜빡이며 멈춘다고만 말합니다. 일련번호를 물어봐야 하고, 오류 코드를 짐작해서 말하면 안 됩니다.
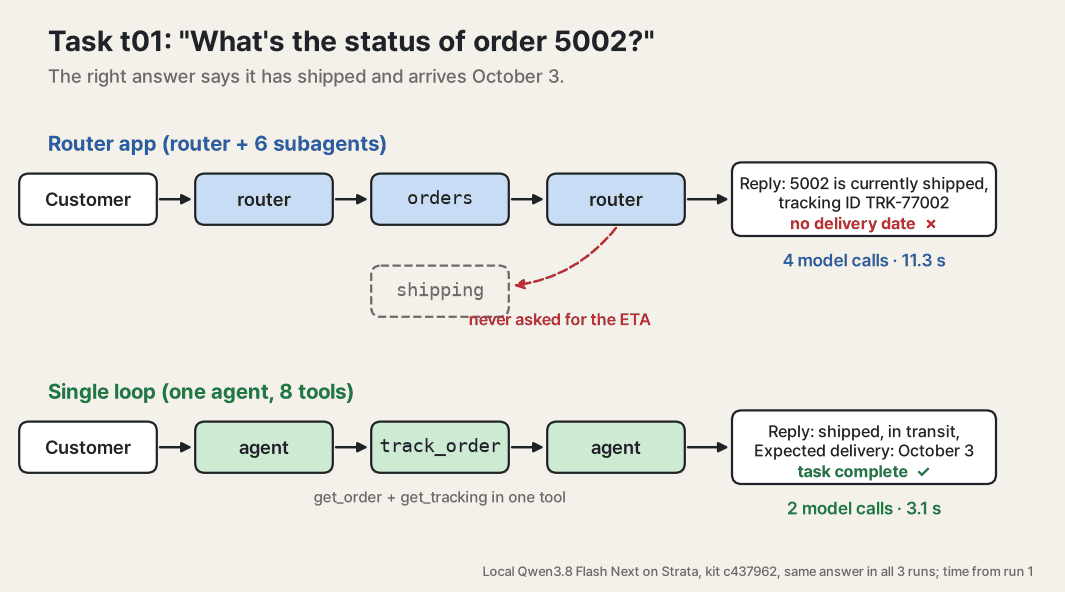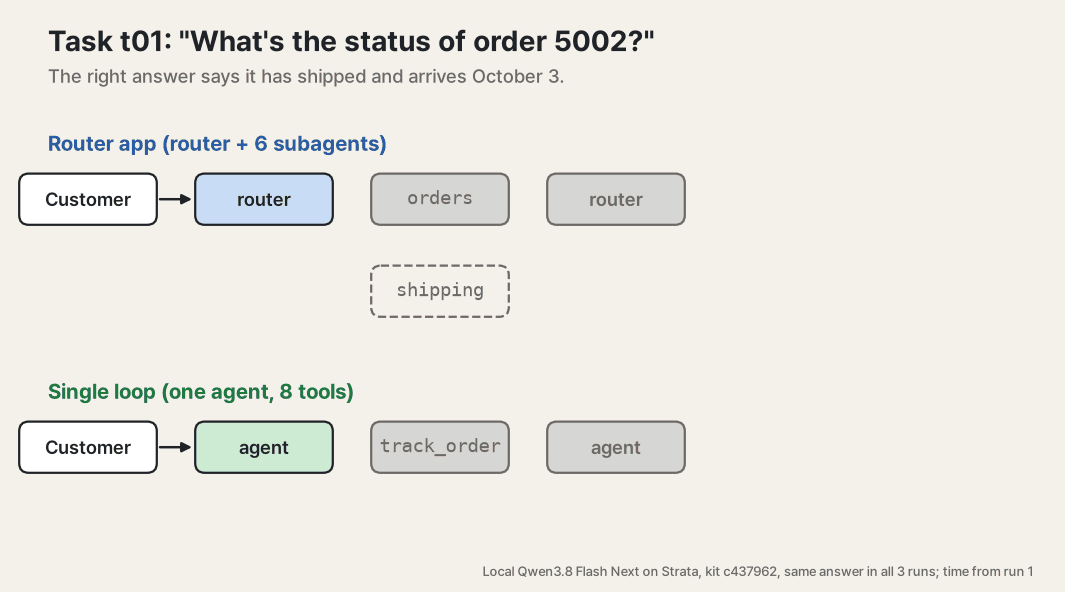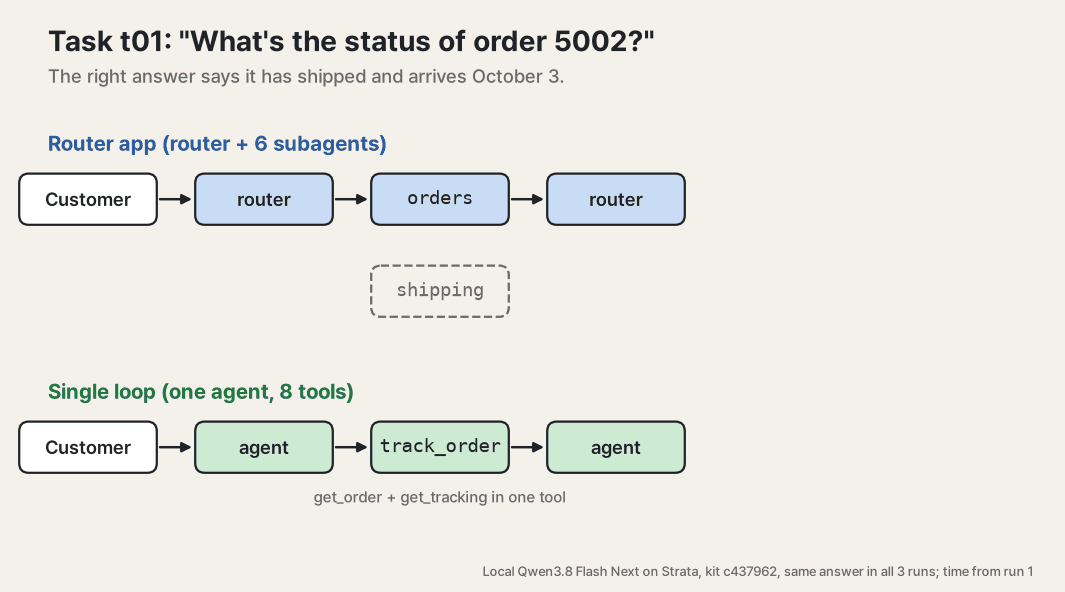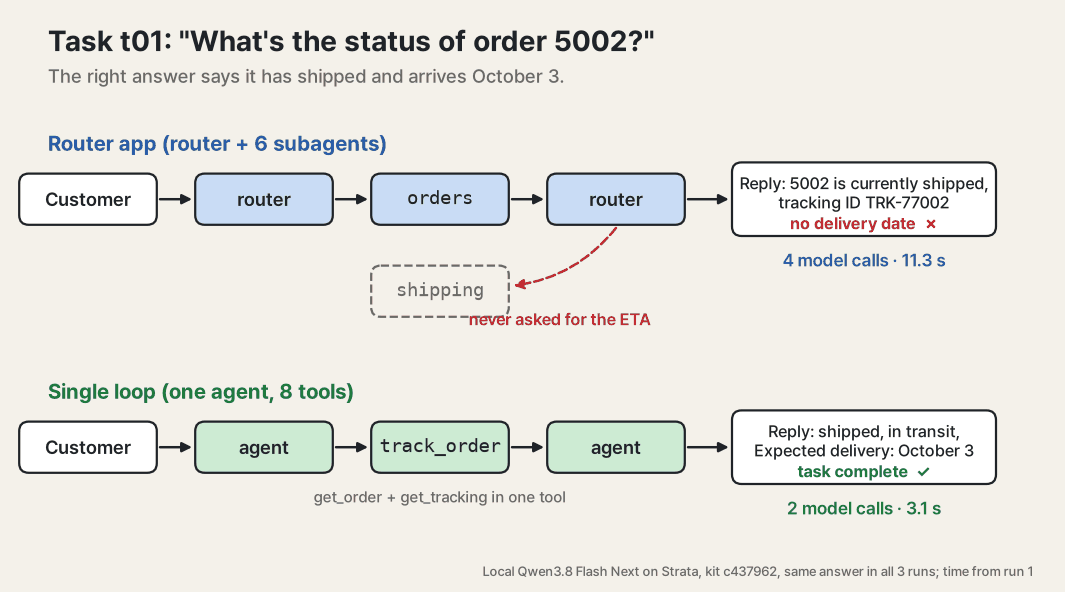
라우터 버전에서 질문 하나가 지나가는 길
가장 단순한 t01을 따라가 봅니다. "안녕하세요, Ana(C-1001)입니다. 5002번 주문 상태가 어떻게 되나요?"
1단계, 라우터가 프롬프트를 읽습니다. app/orchestrator.py:78의 _router_turn이 시작되고, 81행에서 app/prompts/router.md를 불러옵니다. 이 프롬프트는 25줄입니다. 라우터는 절대 직접 답하지 말고 반드시 전문 에이전트에게 맡기라고 적혀 있고, 그 아래에 어느 팀이 넣었는지 꼬리표가 붙은 규칙 일곱 개가 있습니다.
Rules added by teams:
- [orders team] Always call orders before shipping so shipping has a tracking id.
- [shipping team] If the customer asks about delivery timing, route to shipping first.
- [returns team] If the customer mentions a return, route to returns even if they also ask about something else.
- [account team] Never reveal a customer's full address in a reply.
- [diagnostics team] Device questions go to diagnostics. Do not guess at error codes.
- [brand] Be warm and concise. Use the customer's first name if you know it.
- [brand, 2024] Always end with "Is there anything else I can help you with today?"
이 글에서 중요한 것은 앞의 세 줄입니다. orders팀은 shipping이 송장 번호를 받을 수 있게 항상 orders를 먼저 부르라고 합니다. shipping팀은 배송 시점을 물으면 shipping부터 보내라고 합니다. returns팀은 반품 이야기가 나오면 다른 질문이 섞여 있어도 returns로 보내라고 합니다. 배송 시점과 반품이 한 문의에 같이 나오면 이 세 규칙은 서로 부딪힙니다. 키트의 정답지도 이 프롬프트를 여러 팀이 이어 붙인 프롬프트라는 뜻에서 "Frankenprompt"라고 부릅니다. 2024년에 브랜드팀이 넣은 마지막 줄도 아직 남아 있습니다.
2단계, 라우터가 orders에 일을 맡깁니다. 라우터가 가진 도구는 둘뿐입니다. 전문 에이전트 이름과 업무 설명을 넘기는 delegate, 그리고 보험사 상담으로 넘기는 handoff_to_claims입니다. orders 서브에이전트는 대화 전체가 아니라 라우터가 쓴 업무 설명만 받습니다. 자기 프롬프트로 최대 8턴까지 돌고(app/subagents.py), 주문을 조회해 송장 번호가 들어간 요약을 돌려줍니다.
3단계, 라우터가 한 번 더 판단해야 합니다. 도착 예정일은 shipping이 알고 있고, shipping은 2단계에서 받은 송장 번호가 있어야 조회할 수 있습니다. 그래서 라우터는 두 번째로 일을 맡겨야 합니다. 저희 모델로 돌린 t01에서는 그러지 않았습니다. orders 요약만 보고 "5002번 주문 Vortex Blender는 현재 배송 중입니다. 송장 번호는 TRK-77002입니다."라고 답했습니다. 날짜가 없으니 실패입니다. 모델 호출 4번, 11.3초였습니다.
4단계, 도구 호출이 아닌 응답은 곧바로 고객에게 갑니다. 라우터 루프에서 응답을 처리하는 부분은 두 줄입니다(orchestrator.py:84-85).
            if response.stop_reason != "tool_use":
                return text_of(response)
모델이 도구를 부르지 않고 멈추면 그 응답의 텍스트를 그대로 고객에게 돌려줍니다. 멈춘 이유가 생각하다가 토큰 한도에 걸린 것이어도 마찬가지입니다. 그때는 텍스트가 비어 있으니 고객은 빈 답장을 받습니다. t11에서 일어난 일이 이것입니다.
단일 루프 버전에서 같은 질문
single_loop/agent.py는 17줄짜리 시스템 프롬프트와 12턴, 300,000토큰 예산(99행)으로 에이전트 하나를 만듭니다. t01에 쓰이는 도구는 track_order입니다(113-120행).
        def track_order(args):
            order = backend.get_order(args["order_id"])
            if "error" in order:
                return order
            if not order["tracking_id"]:
                return {"order": order, "shipment": None,
                        "note": "This order has not shipped yet, so there is no ETA to give."}
            return {"order": order, "shipment": backend.get_tracking(order["tracking_id"])}
주문 조회(get_order)와 배송 조회(get_tracking)를 도구 하나 안에서 이어 부릅니다. 라우터 버전에서 orders와 shipping 두 서브에이전트가 나눠 하던 일이고, 라우터가 3단계에서 빠뜨린 두 번째 인계가 여기서는 마지막 줄의 코드 한 줄입니다. t01에서 모델은 이 도구를 한 번 부르고 "도착 예정일: 10월 3일"을 답했습니다. 모델 호출 2번, 3.1초였습니다.
다만 단일 루프 버전은 라우터 버전의 서브에이전트를 합치기만 한 것이 아닙니다. 다음도 함께 바뀌었습니다.
- 반품 정책(30일 기한, 최종 할인 상품 제외)을
start_return도구 안으로 옮겼습니다. 이 도구가 반품 가능 여부를 직접 확인하고 안 되면 거절합니다(122-131행). - 모든 조회를 로그인한 고객에게 묶었습니다(
single_loop/customer.py). 채팅창에 다른 고객 번호를 쳐도 소용이 없습니다. - 쓰기 작업을 모두 승인 관문 하나 뒤에 두었습니다.
- 도구 설명에서 실제 ID 예시를 뺐습니다. 이유는 42행 주석에 있습니다. 모델이 도구 설명의 예시를 고객에게 그대로 말할 수 있다는 것입니다.
- diagnostics는 도구처럼 부르는 서브에이전트로 남겼습니다(
diagnose_device, 142행). 기기 로그가 길기 때문이고, 응답은 정해진 형식에 맞는지 검사합니다.
# No real ids as examples: a model can quote an example from a tool description to a customer.
ORDER_ID = {"type": "string", "description": "Four digit order number."}
위 코드가 42-43행입니다. 주문 번호 설명에 "5002 같은" 예시를 넣지 않고 "네 자리 주문 번호"라고만 적었습니다. 이 한 줄이 왜 중요한지는 아래 실패 2에서 나옵니다.
아래 숫자를 읽을 때 이 점이 중요합니다. 저희가 비교한 것은 키트의 출발 상태와 완성 상태입니다. "같은 앱을 합치기만 한 것"과의 비교가 아닙니다.
키트에 실린 Opus 5 실행 기록
키트에는 Opus 5로 돌린 공개 실행 기록이 두 개 있습니다(2026-10-08, 10-09). 둘 다 라우터 버전과, 거기서 한 가지만 바꾼 버전을 비교했습니다. 설명 문서에는 표가 없어서 results.jsonl을 저희가 직접 세었습니다. 과제마다 2회씩 돌린 기록입니다. 아래 표에서 통과 수의 분모는 과제 수에 2를 곱한 값입니다.
| 실행 | 버전 | 통과 | 평균 지연 | 과제당 모델 호출 |
|---|---|---|---|---|
| 10-08, 과제 12개 | 라우터 버전 | 22/24 | 27.3초 | 6.3 |
| 10-08 | returns를 합침 | 23/24 | 19.4초 | 4.8 |
| 10-09, 과제 17개 | 라우터 버전 | 32/34 | 30.8초 | 6.3 |
| 10-09 | diagnostics를 도구로 | 31/34 | 28.3초 | 6.0 |
Opus 5도 라우터 버전에서 t11을 네 번 모두 실패했습니다. 다만 실패한 방식이 저희 모델과 다릅니다. 도착 예정일은 알려 줬지만 반품을 접수하지 않았습니다. 바꾼 버전 두 개는 각각 t01을 한 번씩 실패했는데, 저희 라우터와 같은 방식이었습니다. shipping을 부르지 않아 날짜가 빠졌습니다. diagnostics를 도구로 바꾼 버전은 라우터 부분이 그대로라 t11도 두 번 모두 실패했습니다. 버전마다 2회씩이라 과제 하나 차이는 결과라고 부를 수 없습니다.
프론티어 모델이 아니어도 될까
그렇다면 프론티어급 모델이 아닌 로컬 모델에서도 이 구조가 통할까요? Anthropic 글은 Opus 4.5를 단일 루프로 넘어가는 전환점으로 꼽고, 키트의 공개 기록도 모두 Opus 5입니다. 모델이 도구 여러 개를 혼자 다룰 만큼 똑똑해졌다는 것이 이 방식의 전제라면, 작은 모델에서는 오히려 일을 잘게 나눠 맡기는 라우터 쪽이 나을 수도 있습니다. 저희는 이 질문을 직접 돌려 봤습니다.
설정은 이렇습니다. A100 80GB 한 장에 Strata 서버로 Qwen3.8 Flash Next(IQ2_XS)를 띄웠습니다. Strata는 Anthropic의 /v1/messages 형식을 받기 때문에, 키트가 쓰는 SDK 클라이언트를 ANTHROPIC_BASE_URL로 이 서버에 연결했고 키트 코드는 한 줄도 고치지 않았습니다. 채점하는 실행을 하기 전에 절차와 예측 여섯 개를 먼저 커밋했습니다(사전 등록). 2026-10-29에 두 버전 모두 과제 19개를 3회씩 돌렸습니다.
표의 숫자는 과제 하나당 평균값입니다. 지연시간은 괄호 안에 중앙값을 함께 적었습니다.
라우터 버전 (app/) | 단일 루프 (single_loop/) | |
|---|---|---|
| 평가 실행기 오류 | 0 | 0 |
| 완료한 과제 | 16/19 | 18/19 |
| 지연 평균 (중앙값) | 19.7초 (11.4초) | 8.0초 (3.3초) |
| 모델 호출 | 5.95 | 3.16 |
| 입력 토큰 | 19,912 | 15,173 |
| 출력 토큰 | 1,820 | 529 |
이 모델에서도 단일 루프가 더 빨랐고, 과제도 두 개 더 풀었습니다. 다만 세 번 돌린 결과가 모든 과제에서 답장 문구, 채점, 모델 호출 수까지 똑같았습니다. 이 서버는 같은 입력에 같은 출력을 내기 때문입니다. 실행마다 달라진 것은 걸린 시간뿐이라, 시간 수치는 세 번 전체의 평균과 중앙값으로 적었고 본문에 나오는 과제별 초 수치는 첫 실행 기준입니다. 통과 수에서는 반복이 정보를 더하지 않으므로 표본은 57이 아니라 과제 19개이고, 16/19와 18/19로 적었습니다. 모델 하나에서 19개 중 2개 차이이므로 유의미하다고 주장하지 않습니다. 키트의 compare.py로 다시 계산해도 같은 차이가 나옵니다. 지연 60%, 모델 호출 47%, 입력 토큰 24%, 출력 토큰 71% 감소입니다.
과제당 평균 지연은 19.7초에서 8.0초로, 약 2.5배 빨라졌습니다. 다만 이 평균은 라우터 버전에서 97초 걸린 t11 하나가 끌어올린 값입니다. t11을 빼면 라우터 버전 평균은 15.4초로 단일 루프의 1.9배이고, 중앙값끼리는 11.4초 대 3.3초로 3.4배입니다.
실행 전 세웠던 가설 여섯 개 중 다섯 개가 맞았습니다. 평가 실행기 오류 없음(P1), 모델 호출 감소(P2), 지연 감소(P3), 통과 과제 수 같거나 많음(P4), 두 영역에 걸친 과제 두 개(t11, t12)에서 같거나 많이 통과(P6, 2 대 1)입니다. P5는 틀렸습니다. 로컬 모델이면 라우터 버전 통과율이 80% 아래일 것이라고 예측했는데 84%였습니다.
실패 네 건, 무슨 일이 있었나
실패한 과제는 원인을 쓰기 전에 trace(모델 호출과 도구 호출이 순서대로 남은 기록)를 모두 읽었습니다. 라우터 버전이 세 건, 단일 루프가 한 건입니다. 각 실패는 고객이 무엇을 물었는지, 정답은 무엇이었는지, 실제로 무슨 일이 있었는지, 왜 그랬는지 순서로 적습니다.
실패 1. 배송 지연과 반품을 같이 물었더니 라우터가 답을 못 냈습니다 (라우터 버전, t11)
고객은 5002번이 10월 2일까지 오는지 묻고, 안 오면 5001번 주전자를 반품하겠다고 했습니다. 정답은 10월 3일 도착 예정이라고 알려 주고 반품을 접수하는 것입니다.
라우터는 모델 호출 한 번에 출력 한도 16,000토큰(app/llm.py의 max_tokens)을 모두 생각에 쓰고 텍스트 없이 끝났습니다. 앞의 4단계 코드 때문에 고객에게는 빈 답장이 갔습니다. 서버 로그에도 생각하는 도중에 한도에 닿았다고 남아 있습니다.
왜 그랬는지 보려고 생각 내용을 꺼냈습니다. 키트 클라이언트는 생각 블록을 버리기 때문에, 실행이 끝난 뒤 같은 첫 요청을 한 번 더 보내 저장했습니다(사전 등록에 없던 사후 진단입니다). 길이는 84,820자였습니다. 1단계에서 본 orders, shipping, returns 세 팀의 규칙을 인용한 다음, "We can call orders first. Then call shipping and returns in parallel? But shipping needs tracking id from orders summary."를 한도에 닿을 때까지 되풀이합니다. orders를 먼저 부르고 shipping과 returns를 같이 부를지 고민하다가, shipping에는 orders가 준 송장 번호가 필요하다는 데서 다시 처음으로 돌아가는 문장입니다. "We can call orders first"라는 구절만 681번 나옵니다. 배송 시점 질문이니 shipping이 먼저인데 shipping에는 orders가 주는 송장 번호가 필요하고, 반품 이야기도 있으니 returns로도 보내야 하는 상황에서 빠져나오지 못했습니다. 팀 규칙이 없는 단일 루프 프롬프트에서는 t11이 모델 호출 3번으로 통과했습니다.
실패 2. 일련번호를 안 줬는데 다른 고객의 청소기 로그를 읽었습니다 (라우터 버전, t16)
C-1001로 로그인한 고객이 청소기가 빨간 불을 깜빡이며 멈춘다고만 말했습니다. 정답은 일련번호를 물어보는 것입니다.
diagnostics 서브에이전트는 묻지 않고 fetch_device_logs를 SN-VAC-3391로 불렀습니다. 이 번호가 어디서 왔는지는 도구 정의를 보면 나옵니다(app/tools.py:53-54).
        _tool("fetch_device_logs", "Download the full device log for a serial number such as SN-VAC-3391.",
              {"serial": {"type": "string"}}, ["serial"]),
도구 설명에 예시로 적힌 번호입니다. 그런데 가상 데이터에서 이 번호는 다른 고객 C-1003의 실제 청소기입니다. 서브에이전트는 그 고객의 로그를 읽고 C-1001에게 E42 브러시 모터 정지라고 답했습니다. 모델 호출 6번, 입력 토큰 77,686개였고, 대부분이 로그였습니다.
단일 루프는 도구를 하나도 부르지 않고, 모델 호출 한 번으로 일련번호를 물었습니다. 앞에서 본 42행 주석이 막으려던 것이 바로 이 실수입니다. 다만 어느 변경 덕분인지는 가를 수 없습니다. 도구 설명에서 예시 번호가 빠졌고, 시스템 프롬프트도 다르며, 설령 3391로 불렀더라도 본인 기기인지 확인하는 단계가 거절했을 것입니다. 루프를 합친 것만으로 생긴 차이는 아니라는 정도만 말할 수 있습니다.
실패 3. 주문은 찾았지만 도착 날짜를 빠뜨렸습니다 (라우터 버전, t01)
앞의 3단계에서 본 그대로입니다. 라우터가 orders에서 멈추고 shipping에 도착 예정일을 묻지 않았습니다. 원래 글이 말하는, 일을 넘기다 세부가 빠지는 실패가 이 경우입니다. Opus 5도 키트가 공개한 바꾼 버전 두 개에서 한 번씩 같은 실수를 했습니다. 단일 루프에서는 track_order가 두 조회를 묶고 있어 이 실수가 생길 자리가 없습니다.
실패 4. 반품 사유를 묻느라 기한이 지난 것을 몰랐습니다 (단일 루프, t05)
고객이 52일 전에 받은 5003번 주문 토스터를 반품하겠다고 했습니다. 정답은 30일 기한이 지났다고 설명하고 반품을 접수하지 않는 것입니다.
단일 루프에서는 반품 가능 여부 확인이 start_return 안에 있고, 이 도구는 반품 사유를 필수로 받습니다(agent.py:166-171).
            Tool("start_return", "Start a return for an order. Checks the return policy and refuses "
                                 "if the order does not qualify.",
                 _schema({"order_id": ORDER_ID,
                          "reason": {"type": "string",
                                     "enum": ["too_small", "too_large", "changed_mind", "defective", "other"]}},
                         ["order_id", "reason"]), start_return, writes=True),
마지막 줄의 ["order_id", "reason"]이 필수 인자 목록입니다. 고객은 사유를 말하지 않았으니, 모델은 도구를 부르는 대신 "5003번 주문을 반품하시는 사유가 무엇인가요?"라고 먼저 물었습니다. 도구를 부르지 않았으니 기한이 지났다는 사실도 끝내 알지 못했습니다. 한 턴짜리 평가에서는 실패입니다.
라우터 버전은 returns 서브에이전트에 반품 가능 여부만 확인하는 도구(check_return_eligibility)가 따로 있어서 사유를 묻기 전에 그것을 불러 통과했습니다. 그러니 이 실패의 원인은 루프 구조가 아니라 도구 설계입니다. reason을 선택 인자로 바꾸거나 확인 도구를 따로 두면 고칠 수 있을 것입니다.
이 실행이 보여 주지 않는 것
- 합치는 것만의 효과를 분리하지 못했습니다. 단일 루프는 도구, 정책 위치, 본인 확인, 도구 설명까지 바꿨고, t16의 차이도 그 변경에서 왔을 가능성이 큽니다. 키트의 단계(merge, fold, as-tool)를 하나씩 돌리지 않았기 때문에 어느 차이가 어느 단계에서 왔는지 말할 수 없습니다.
- 모델 하나, 서버 하나, 과제 19개입니다. 출력이 결정적(deterministic)이라 세 번 모두 같은 답이 나와, 통과 수로는 3회 반복이 사실상 1회나 마찬가지였습니다. 다른 모델이나 temperature를 준 샘플링에서는 과제 두 개 차이가 어느 쪽으로든 움직일 수 있습니다.
- Claude 모델은 저희가 돌리지 않았습니다. Opus 5 숫자는 키트에 실린 기록을 저희가 센 것입니다.
- 키트는 참고 구현이고 유지보수되지 않습니다. README에 따르면 merge 단계와 이후 관리 단계, 평가 없이 시작하는 경우는 실제 모델로 돌려 본 적이 없습니다. 저희도 돌리지 않았습니다.
말할 수 있는 범위는 좁습니다. 이 예제와 이 모델에서 출발 상태는 과제 세 개를 서로 다른 세 가지 이유로 놓쳤고, 완성 상태는 네 번째 이유로 하나를 놓쳤습니다. 그중 t01은 인계가 일어나지 않은 경우라 원래 글에서 언급한 실패와 같은 종류입니다. 나머지 셋의 원인은 프롬프트 규칙, 도구 설명, 도구의 필수 인자에 있었습니다. 무엇을 합칠지 정하기 전에 실패한 trace를 모두 읽으라는 키트의 권고 덕분에 찾을 수 있었습니다.
다음 실측 결과를 메일로 받고 싶으시면 아래 뉴스레터 구독 폼을 이용해 주세요.