사진 없이 학습한 AI가 사진 설명을 고를 수 있을까? 얀 르쿤의 JEPA 논문 재현
사진을 입력받지 않고 학습한 텍스트 모델이 사진에 맞는 캡션을 고를 수 있을까요? 랜달 발레스트리에로와 얀 르쿤의 JEPA 코드를 Flickr30k에서 재현했습니다. 사진·캡션 쌍으로 선형 변환을 맞춘 뒤 잰 정답 비율은 같은 사진의 여러 캡션으로 학습했을 때 24.3%, 다음 토큰 예측으로 학습했을 때 12.5%였습니다. 실험 방법과 한계를 설명합니다.
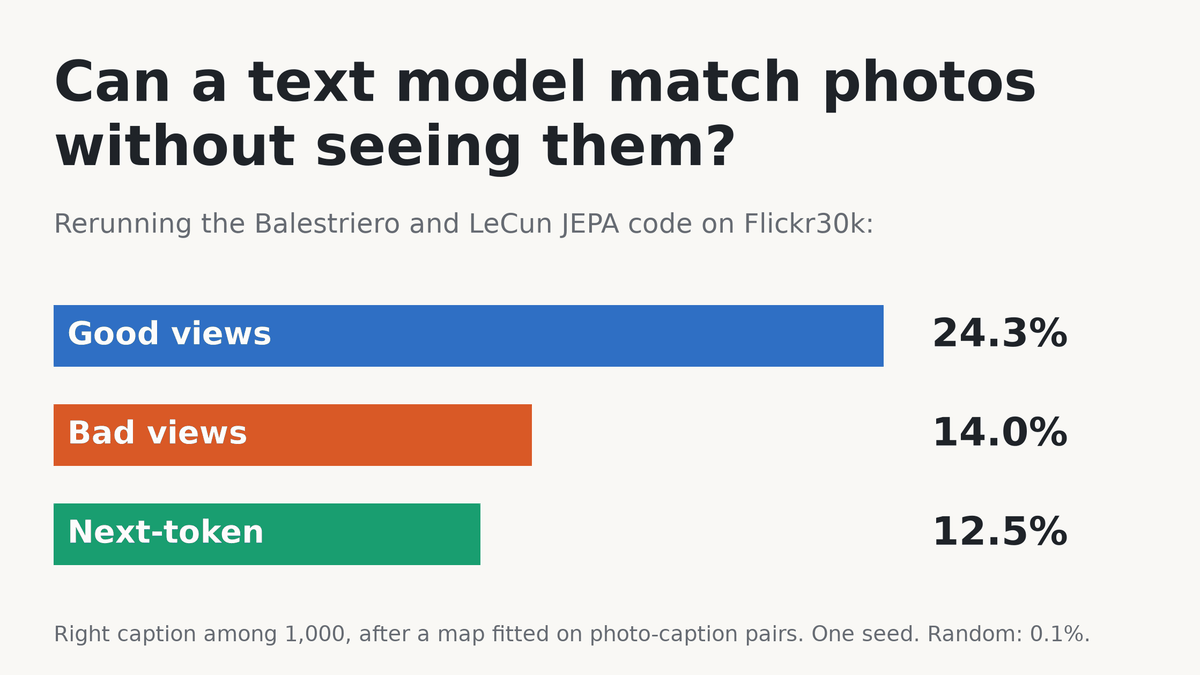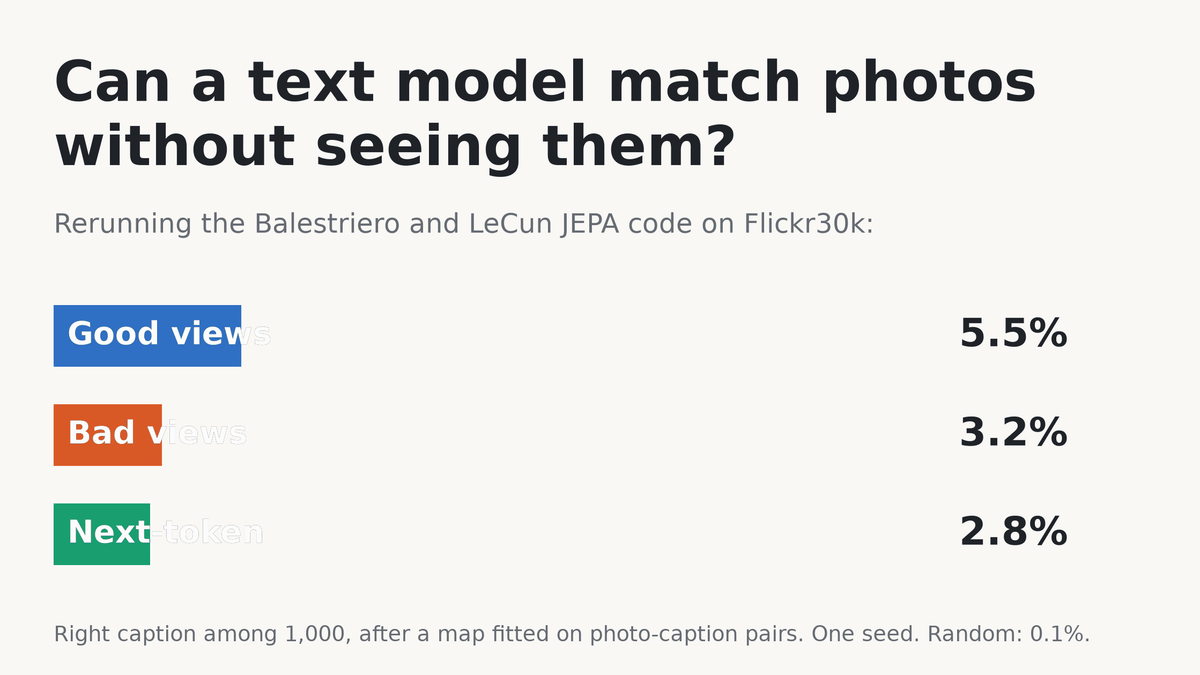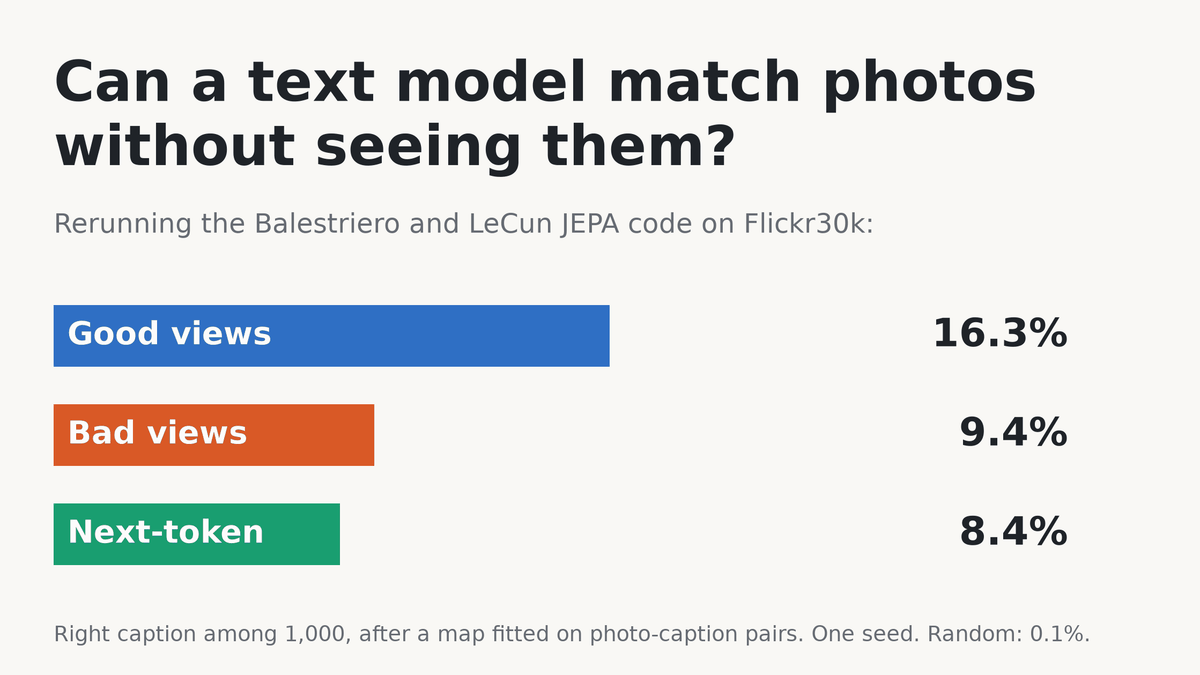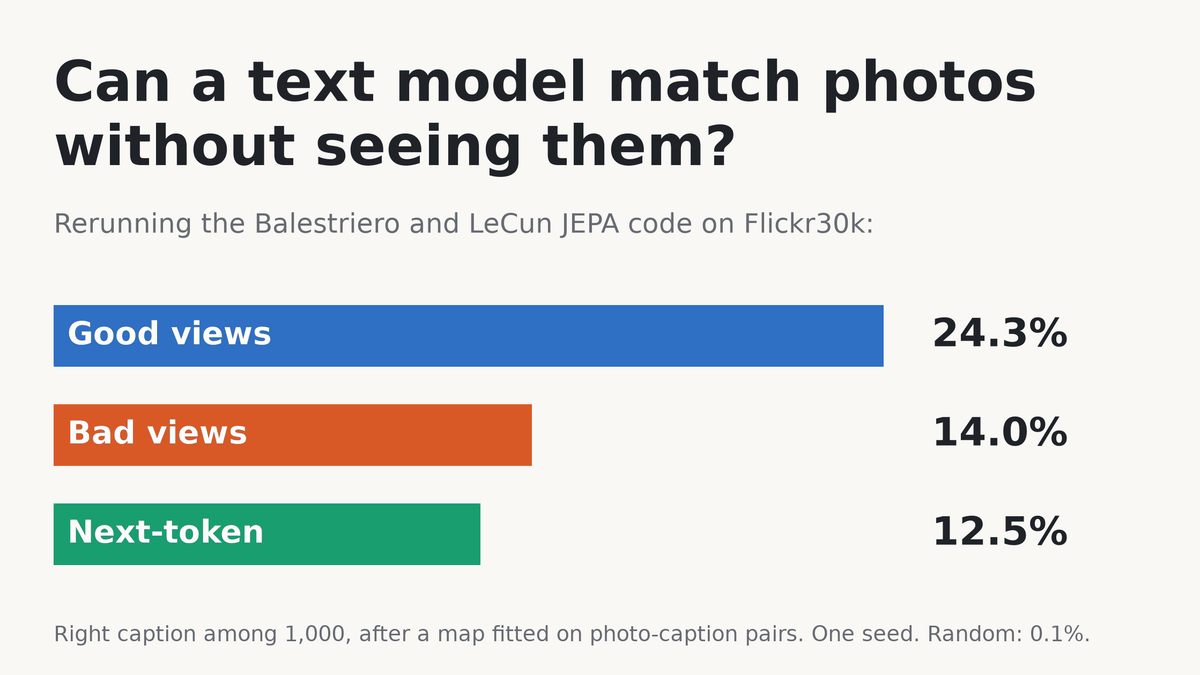
사진 없이 학습한 AI가 사진 설명을 고를 수 있을까? 얀 르쿤의 JEPA 논문 재현
사진을 입력받지 않고 학습한 텍스트 모델이 사진에 맞는 설명문을 고를 수 있을까요? 랜달 발레스트리에로와 얀 르쿤의 논문 Proving and Improving the Platonic Representation Hypothesis with JEPAs는 글과 사진을 따로 학습한 모델이 얼마나 비슷하게 정보를 정리하는지 다룹니다. 저희는 저자들의 코드를 받아 작은 실험을 다시 돌렸습니다.
실험에서는 사진 한 장과 설명문 1,000개를 준비합니다. 사진 모델은 사진을 숫자 벡터로 바꾸고, 텍스트 모델은 설명문들을 숫자 벡터로 바꿉니다. 벡터는 모델이 입력의 특징을 담아 놓은 숫자 목록입니다. 사진·캡션 쌍으로 맞춘 선형 변환을 거쳐 두 모델의 벡터를 비교해 가장 가까운 설명문을 고르고, 그것이 실제로 해당 사진의 설명문인지 확인합니다. 이때 텍스트 모델은 설명문을 읽으며 학습할 뿐, 사진 자체를 입력받지는 않습니다.
바꾼 것은 텍스트 모델의 학습 방식입니다. 같은 사진을 설명하는 문장들은 단어가 달라도 장면을 공유합니다. 예를 들어 "개가 달린다"와 "강아지가 공을 쫓는다"를 가깝게 만들도록 학습하면, 모델이 개별 단어보다 공통된 장면에 주목할 수 있다는 생각입니다. 논문은 이 방식을 한 문장의 조각끼리 가깝게 만드는 방식, 그리고 LLM 학습에 쓰는 다음 토큰 예측과 비교합니다. 다음 토큰 예측은 앞에 나온 토큰을 보고 그다음 토큰을 맞히는 학습입니다.
저희 실험에서 사진에 맞는 설명문을 1등으로 고른 비율은 다음과 같습니다. 무작위로 고르면 0.1%입니다.
| 텍스트 모델의 학습 방식 | 정답 비율 |
|---|---|
| 같은 사진에 달린 여러 설명문을 가깝게 만들기 | 24.3% |
| 설명문 하나에서 잘라 낸 조각들을 가깝게 만들기 | 14.0% |
| 다음 토큰 예측 | 12.5% |
논문은 앞의 두 방식을 각각 "좋은 뷰"와 "나쁜 뷰"라고 부릅니다. 여기서 뷰(view)는 학습할 때 모델에 보여 주는 입력 하나입니다. 이름의 차이는 입력을 어디서 가져오느냐에 있습니다. 좋은 뷰는 같은 사진의 여러 설명문에서, 나쁜 뷰는 설명문 하나에서 가져옵니다. 이 글에서도 논문과 코드를 따라갈 수 있도록 이 이름을 쓰겠습니다. 아래부터는 사진에 붙은 설명문을 캡션이라고 부릅니다.
이 비교에는 학습이 끝난 뒤의 보정 단계가 있습니다. 두 모델이 만든 벡터는 좌표가 다르므로 그대로 비교할 수 없습니다. 사진과 캡션 1,014쌍으로 두 벡터 공간을 연결하는 선형 변환 하나를 구한 뒤, 여기에 쓰지 않은 사진·캡션 1,000쌍으로 채점했습니다. 따라서 24.3%는 이 보정까지 거친 결과입니다. 또 텍스트 모델에 사진이 들어가지는 않지만, 좋은 뷰를 만들려면 어떤 캡션들이 같은 사진에 달렸는지 알아야 합니다. 실험 안에 짝 정보가 있는 셈입니다.
사진 모델은 이미 학습된 DINOv2를 그대로 쓰고, 파라미터 3,300만 개의 작은 텍스트 인코더만 세 방식으로 학습했습니다. 데이터는 Flickr30k의 사진 29,000장에 달린 캡션 145,000개이고, 세 조건 모두 200에폭을 학습했습니다. 에폭은 학습 데이터를 한 차례 도는 단위입니다. 다만 좋은 뷰는 사진마다 캡션 다섯 개에서 입력을 뽑고, 나머지 두 조건은 에폭마다 사진당 캡션 하나만 읽습니다. 학습 에폭이 같아도 처리한 토큰 수는 같지 않으며, 다음 토큰 예측은 한 스텝에 보는 토큰이 더 적습니다. 논문도 이 차이를 적었습니다.
결과의 순서는 논문과 같습니다. 다만 저희는 무작위 초기값을 정하는 시드 하나로만 실행했습니다. 14.0%와 12.5%의 차이는 1.5%포인트이고, 그 차이의 95% 구간은 −0.9에서 4.0%포인트입니다. 이번 실행으로는 이 두 방식 중 어느 쪽이 낫다고 가르기 어렵습니다.
논문은 다음 토큰 예측을 "a remarkably inefficient route to platonic representations"라고 표현합니다. 따로 학습한 모델들이 입력 사이의 관계를 비슷하게 정리하기까지 데이터와 모델 규모가 많이 필요하다는 주장입니다. LLM의 성능 전반을 평가한 말은 아닙니다. 저희의 작은 실험은 정답 비율을 비교한 것이므로 이 효율 주장을 검증하지는 못합니다. 논문이 내세운 "샘플이 42배 적다"는 결과와 대형 LLM 비교는 웹 규모 실험에서 나왔고, 저희는 다시 돌리지 않았습니다. 그 수치는 뒤에서 저희 결과와 구분해 소개합니다.
실제로 어떤 캡션을 고르는지부터 보겠습니다. 아래 그림 여섯 장은 FLUX.1-schnell로 새로 만들었습니다. 어느 인코더도 학습 때 이 그림들을 본 적이 없습니다. 각 그림 아래에는 세 방식으로 학습한 텍스트 모델이 MS COCO 캡션 29,909개 중에서 각각 1등으로 고른 문장을 붙였습니다.
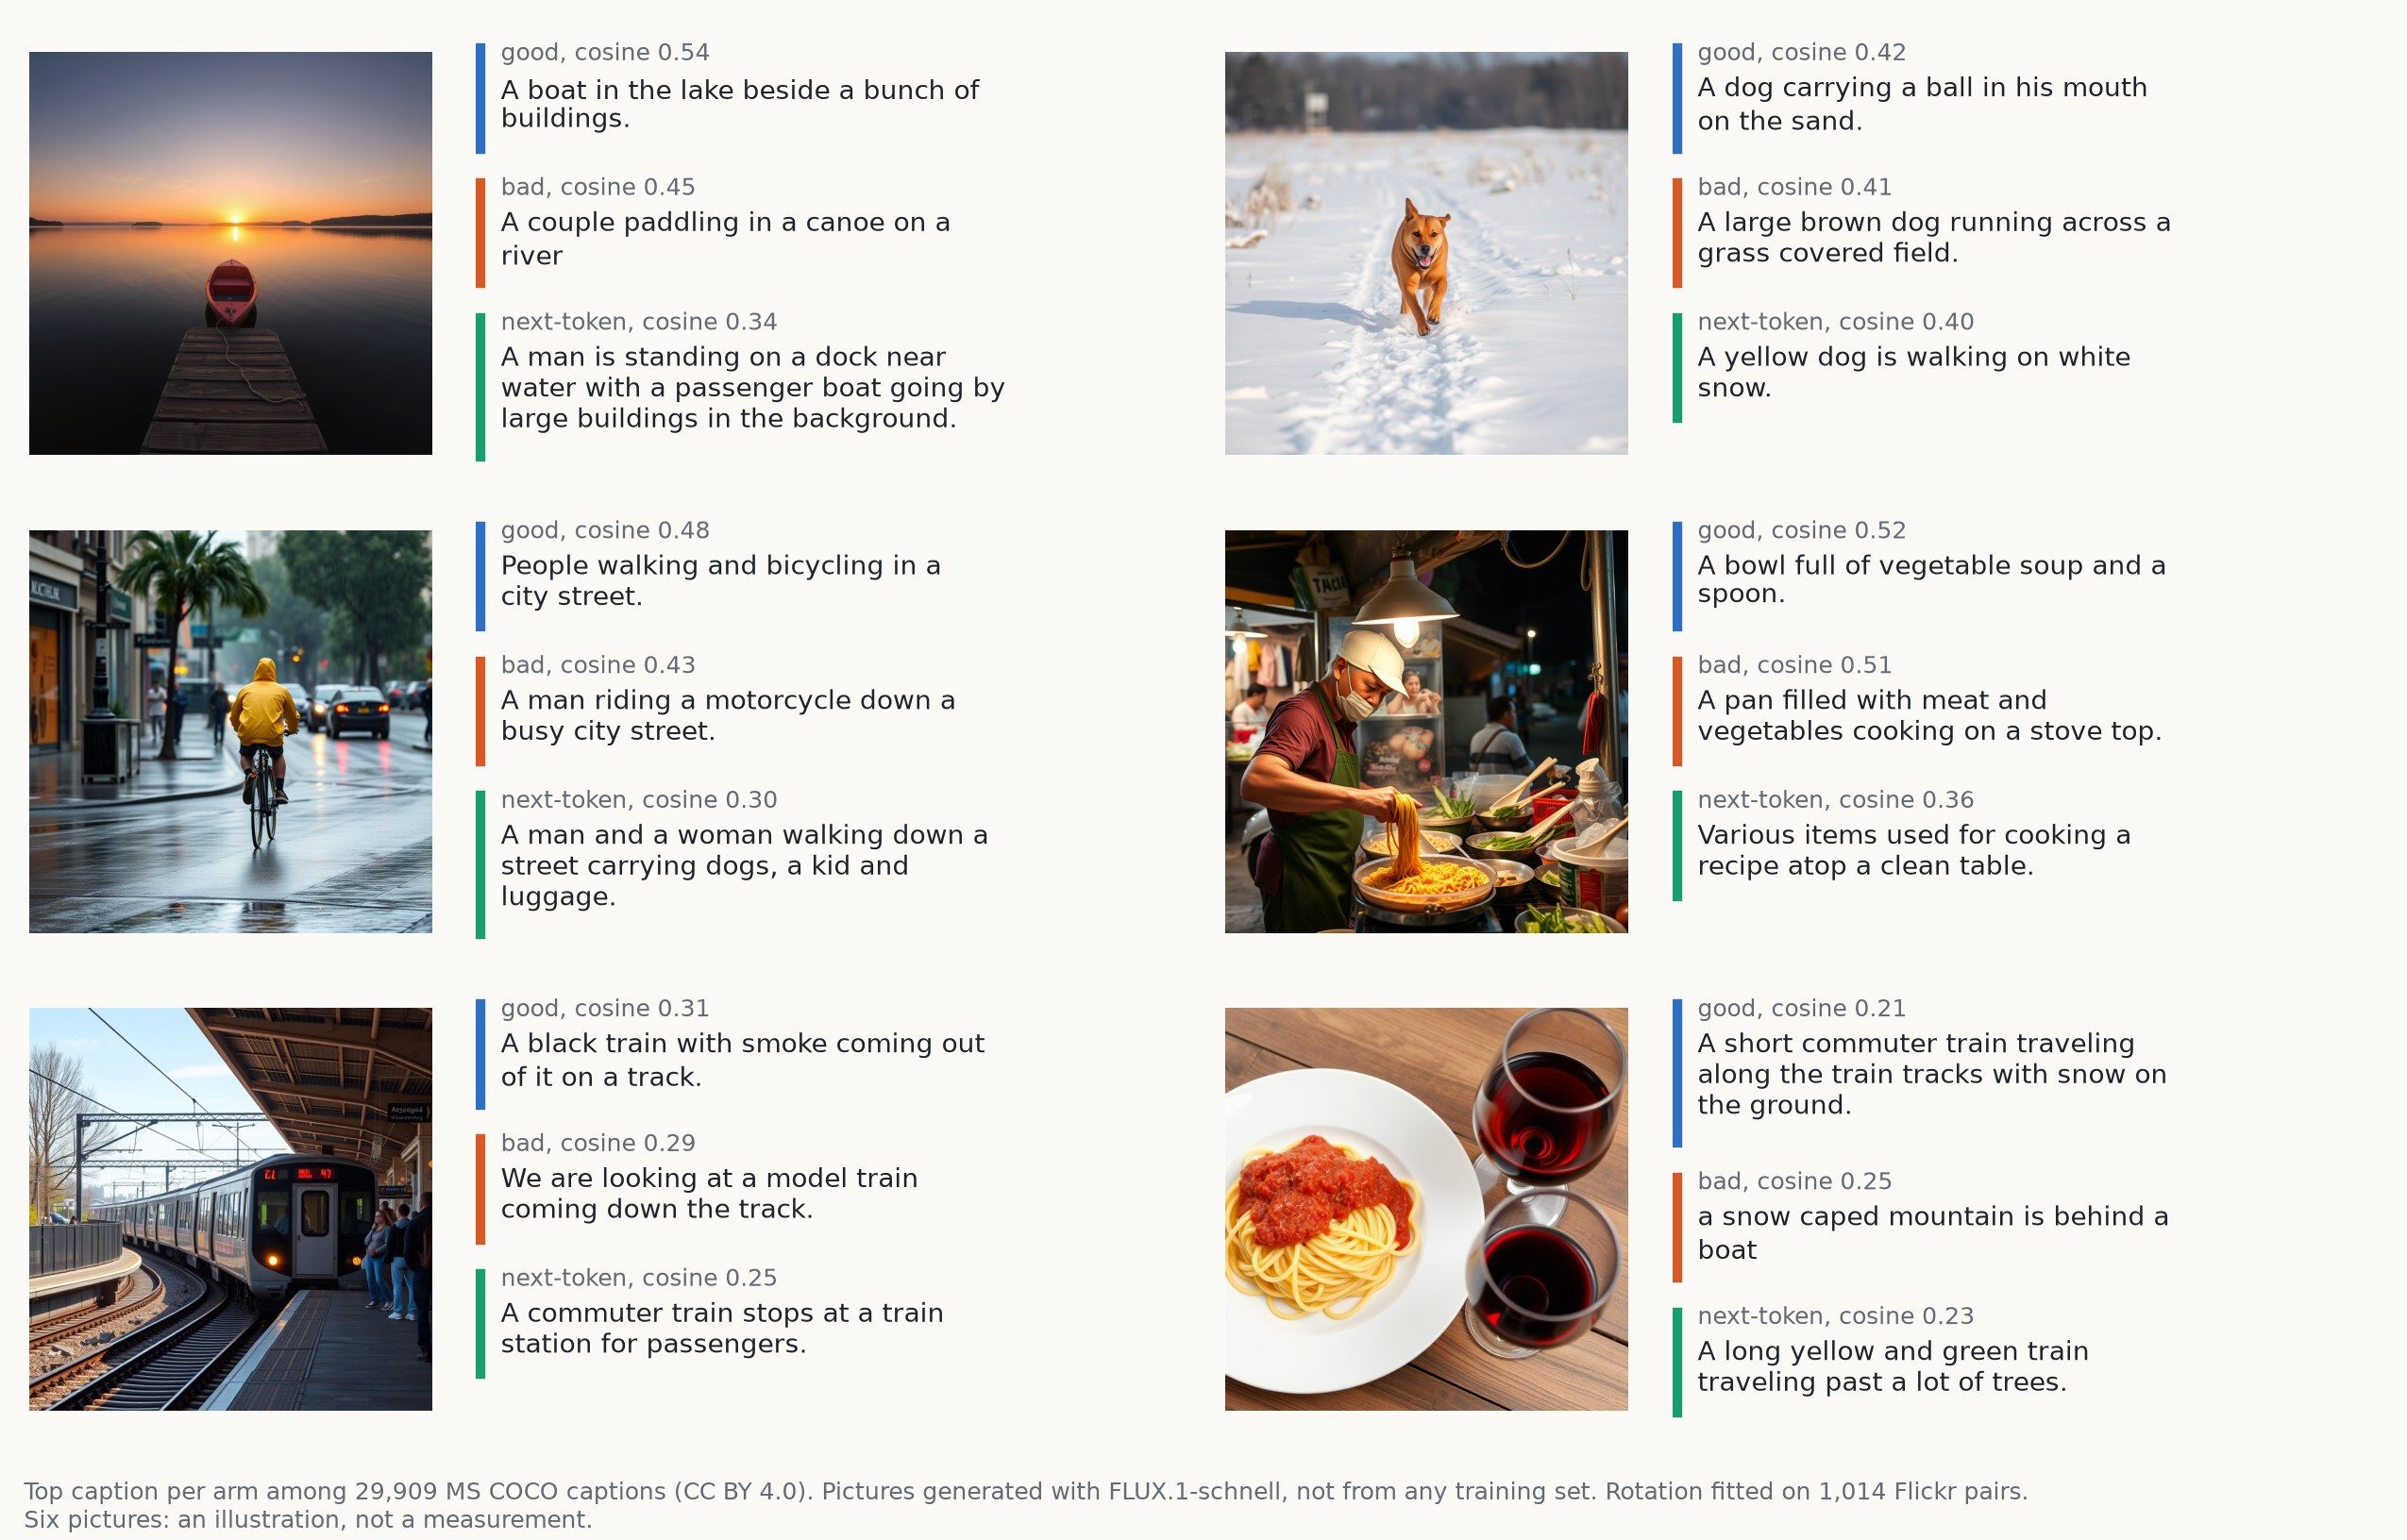
이 여섯 장만으로 학습 방식의 우열을 가릴 수는 없습니다. 보트와 거리, 기차 그림에서는 비슷한 장면의 캡션을 골랐습니다. 눈밭의 개에서는 다음 토큰 예측만 눈을 읽어 냈습니다. 스파게티는 셋 다 틀려서 기차와 산을 골랐습니다. 후보에 답이 없었던 것은 아닙니다. COCO 후보 중 pasta, spaghetti, noodle이 들어간 캡션이 50개 있습니다. 학습에 쓴 Flickr 캡션 145,000개 중에는 54개뿐이라 면 요리 글이 적은 탓을 떠올릴 수 있지만, 이것만으로 설명되지는 않습니다. 국수 노점 그림에서 좋은 뷰 인코더가 고른 1, 2위 캡션은 수프와 요리사였고, 벡터의 방향이 얼마나 비슷한지 재는 코사인 유사도는 .52와 .51입니다(그림에는 1위만 실었습니다). 접시 사진에서 왜 틀렸는지는 따로 시험하지 않았습니다. 스파게티의 코사인 유사도는 .21에서 .25이고, 기차는 .25에서 .31, 보트는 .34에서 .54입니다. 점수만으로 틀렸는지를 가를 수는 없습니다.
논문이 증명한 것
이 실험의 배경에는 Huh 등이 제안한 플라톤적 표현 가설(Platonic Representation Hypothesis)이 있습니다. 서로 다른 데이터로 학습한 모델들도 입력 사이의 관계를 점점 비슷하게 정리한다는 가설입니다. 여기서 표현(representation)은 모델이 입력의 특징을 담은 벡터를 뜻합니다. 두 모델의 벡터 값이 똑같아야 한다는 뜻은 아닙니다. 어떤 입력끼리 가깝고 어떤 입력끼리 먼지, 그 관계가 비슷해질 수 있다는 이야기입니다.
이번 논문은 JEPA(joint-embedding predictive architecture)의 특정 설정에서 이 가설이 성립할 조건을 증명합니다. 이 글에서 다루는 JEPA는 같은 대상에서 만든 여러 입력, 즉 뷰의 벡터를 서로 가깝게 만드는 방식으로 배웁니다. 모든 입력을 같은 벡터로 보내도 거리가 줄어들기 때문에, 그런 무의미한 해를 막는 장치도 필요합니다. 모든 입력의 표현이 한 점으로 모이는 현상을 붕괴(collapse)라고 합니다.
서로 다른 모델의 좌표를 맞춘다는 뜻
논문은 관측 뒤에 공통된 세계 상태가 있다고 가정합니다. 예를 들어 하나의 장면을 사진으로 찍을 수도 있고 문장으로 설명할 수도 있습니다. 그 과정에서 카메라 각도나 단어 선택처럼 관측마다 달라지는 세부 정보가 붙습니다. 논문은 이런 정보를 nuisance라고 부릅니다. 이 글에서는 장면 자체와 구별해 '부가 정보'라고 쓰겠습니다.
정리 1은 두 모델이 어떤 조건에서 같은 관계를 배우는지 설명합니다. 사진과 글에서 '가깝게 만들 입력 쌍'을 고르는 방식이 세계 상태를 기준으로 같아야 합니다. 이런 쌍을 양성 쌍(positive pair)이라고 합니다. 또 학습 문제의 답이 회전 차이를 제외하면 하나로 정해져야 합니다. 그러면 두 인코더가 만든 표현도 회전 하나로 일치시킬 수 있다는 것이 정리의 결론입니다. 여기서 회전은 입력마다 따로 고치는 변환이 아니라, 모든 벡터에 공통으로 적용하는 좌표 변환입니다.
증명은 사진이나 문장으로 관측하는 과정을 좌표 변경으로 보는 데서 출발합니다. 이 과정이 단사, 즉 서로 다른 상태가 같은 관측으로 겹치지 않는다면, 관측을 통해 학습하는 문제를 세계 상태에서 직접 학습하는 문제로 바꿔 쓸 수 있습니다. 두 모델이 결국 같은 문제를 풀고 답도 하나라면, 좌표 방향만 다를 뿐 같은 해를 얻습니다.
이 정리에는 유한한 세계, 단사인 관측 과정, 전체 데이터 분포에서의 최적해라는 가정이 들어갑니다. 실제 실험이 이 조건을 정확히 만족하지는 않는다고 저자들도 밝힙니다. 따라서 실험 결과가 반드시 회전 하나로 완전히 일치한다고 보장하는 정리는 아닙니다.
명제 1은 답이 유일해지는 구체적인 예를 제시합니다. 제곱 오차(squared loss)에 화이트닝(whitening)을 결합한 경우입니다. 화이트닝은 벡터의 평균을 0으로 맞추고 공분산을 단위행렬로 만드는 제약입니다. 고유값에 간격이 있을 때(μₖ > μₖ₊₁), 이 문제의 해는 양성 쌍 사이의 관계를 담은 커널의 상위 고유벡터이며 Laplacian eigenmaps에 해당합니다. 실제 실험에 쓴 SIGReg에서도 답이 유일하다는 점은 증명하지 않고 가정합니다.
좌표 변환을 찾으려면 짝 정보도 필요합니다. 명제 2에 따르면 화이트닝된 벡터는 회전해도 평균과 공분산이 같아서, 짝을 모르는 데이터의 이 두 통계량만으로는 회전을 찾을 수 없습니다. 두 모델의 출력이 같은 k차원이라면, 방향을 결정하기에 충분히 독립적인 위치에 놓인 k쌍으로 회전을 정할 수 있습니다.
왜 여러 캡션을 쓰면 달라질까요?
모델은 가깝게 만들라고 제시한 입력들 사이에서 공통된 정보를 찾습니다. 무엇을 짝지어 주느냐에 따라 남겨 두면 유리한 정보가 달라집니다.
- 좋은 뷰는 같은 세계 상태를 각각 관측해서 얻습니다. 같은 사진을 설명하는 두 캡션은 장면을 공유하지만 단어 선택은 다를 수 있습니다. 논문의 이상화된 설정에서는 관측마다 달라지는 단어 선택이 평균화되고, 공통된 장면 정보가 남습니다.
- 나쁜 뷰는 이미 얻은 관측 하나를 자르거나 일부 가려서 만듭니다. 한 캡션에서 자른 두 조각은 원래 문장의 단어 선택까지 공유합니다. 모델은 그 단어를 기억하는 것으로도 두 조각의 벡터를 가깝게 만들 수 있습니다.
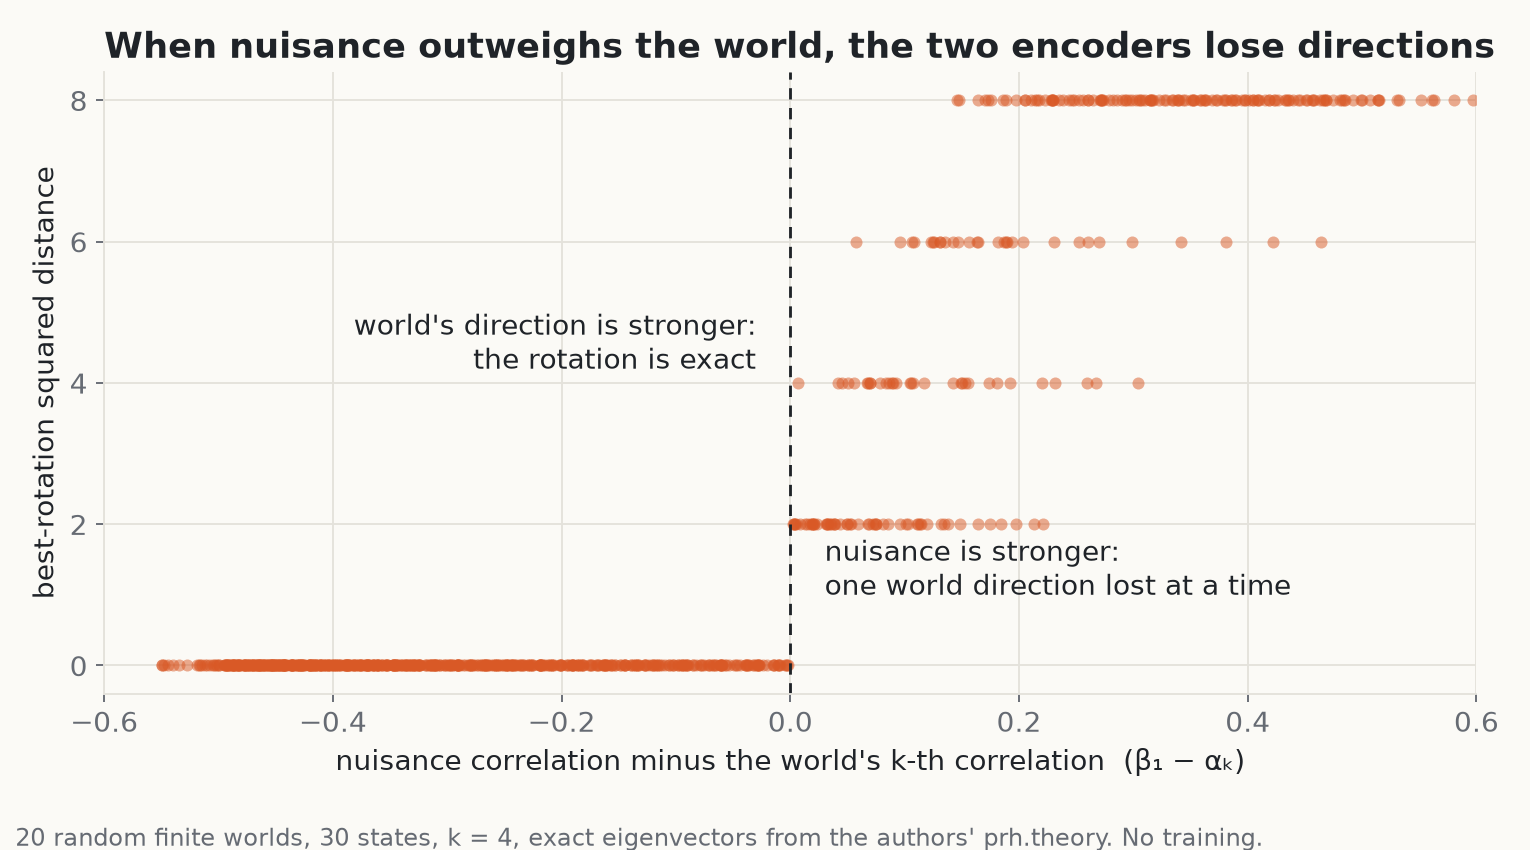
정리 3은 벡터에 세계 상태와 무관한 정보가 많이 남을수록, 두 모델의 좌표를 최적으로 맞춘 뒤에도 오차가 커질 수밖에 없다고 설명합니다. 명제 3은 나쁜 뷰에서 부가 정보가 장면 정보를 밀어내는 조건을 구합니다. 벡터에 담을 수 있는 방향이 k개로 제한된 설정에서, 가장 강한 부가 정보의 상관 β₁이 k번째 장면 정보의 상관 αₖ보다 크면 부가 정보가 적어도 한 방향을 차지합니다(r ≥ 1). 그만큼 장면 정보를 담을 자리가 줄어듭니다.
명제 4는 다음 토큰 예측을 이 틀에 연결합니다. 앞부분과 이어지는 토큰은 한 글에서 나왔으므로 단어 선택 같은 부가 정보도 공유합니다. 또 softmax 손실을 풀어 쓰면 예측 대상을 향해 당기는 항과 붕괴를 억제하는 항으로 나눌 수 있어, 나쁜 뷰를 쓰는 JEPA와 비슷한 형태가 됩니다. 다만 저자들은 이 연결을 휴리스틱, 즉 추가 검증이 필요한 해석으로 제시하며 "a prediction to test"라고 적었습니다.
이 임계 조건은 실제 모델 학습과 별도로 확인했습니다. 저자들의 prh/theory.py로 상태 30개짜리 가상 세계 20개를 만들고, 벡터의 차원을 k = 4로 두었습니다. 신경망을 학습하는 대신 고유벡터를 직접 계산해, 상관의 세기를 바꾼 800개 설정에서 두 모델의 표현이 얼마나 어긋나는지 쟀습니다. 좋은 뷰의 오차는 절댓값으로 최대 5.3e-15였습니다. 나쁜 뷰에서 부가 정보의 상관 β₁이 장면 정보의 상관 αₖ보다 작은 545개 점은 모두 오차의 절댓값이 7.1e-15 이하였습니다. 더 큰 255개 점은 모두 방향을 하나 이상 잃었고, 오차와 2r의 차이가 6e-14 이내였습니다. 이 설정에서는 방향 하나를 잃을 때마다 오차가 꼭 2씩 늘어납니다. 관측을 변형해도 부가 정보가 전혀 바뀌지 않는 특수한 설정 20행은 이 비교에서 제외했습니다. 이때는 네 방향이 모두 부가 정보로 채워져 인코더에 세계 상태가 남지 않습니다. 오차는 2k = 8로, r = 4일 때의 2r과 같습니다. 다만 저자들의 nuisance_directions는 이 행에서 r = 3을 돌려줍니다. 고유값이 정확히 같아서, 정렬한 뒤 아무 정보도 담지 않는 상수 방향 대신 부가 정보 방향 하나를 빼기 때문입니다. 상수 방향을 직접 빼고 세면 20행 모두 r = 4입니다.
논문과 코드 맞춰 보기
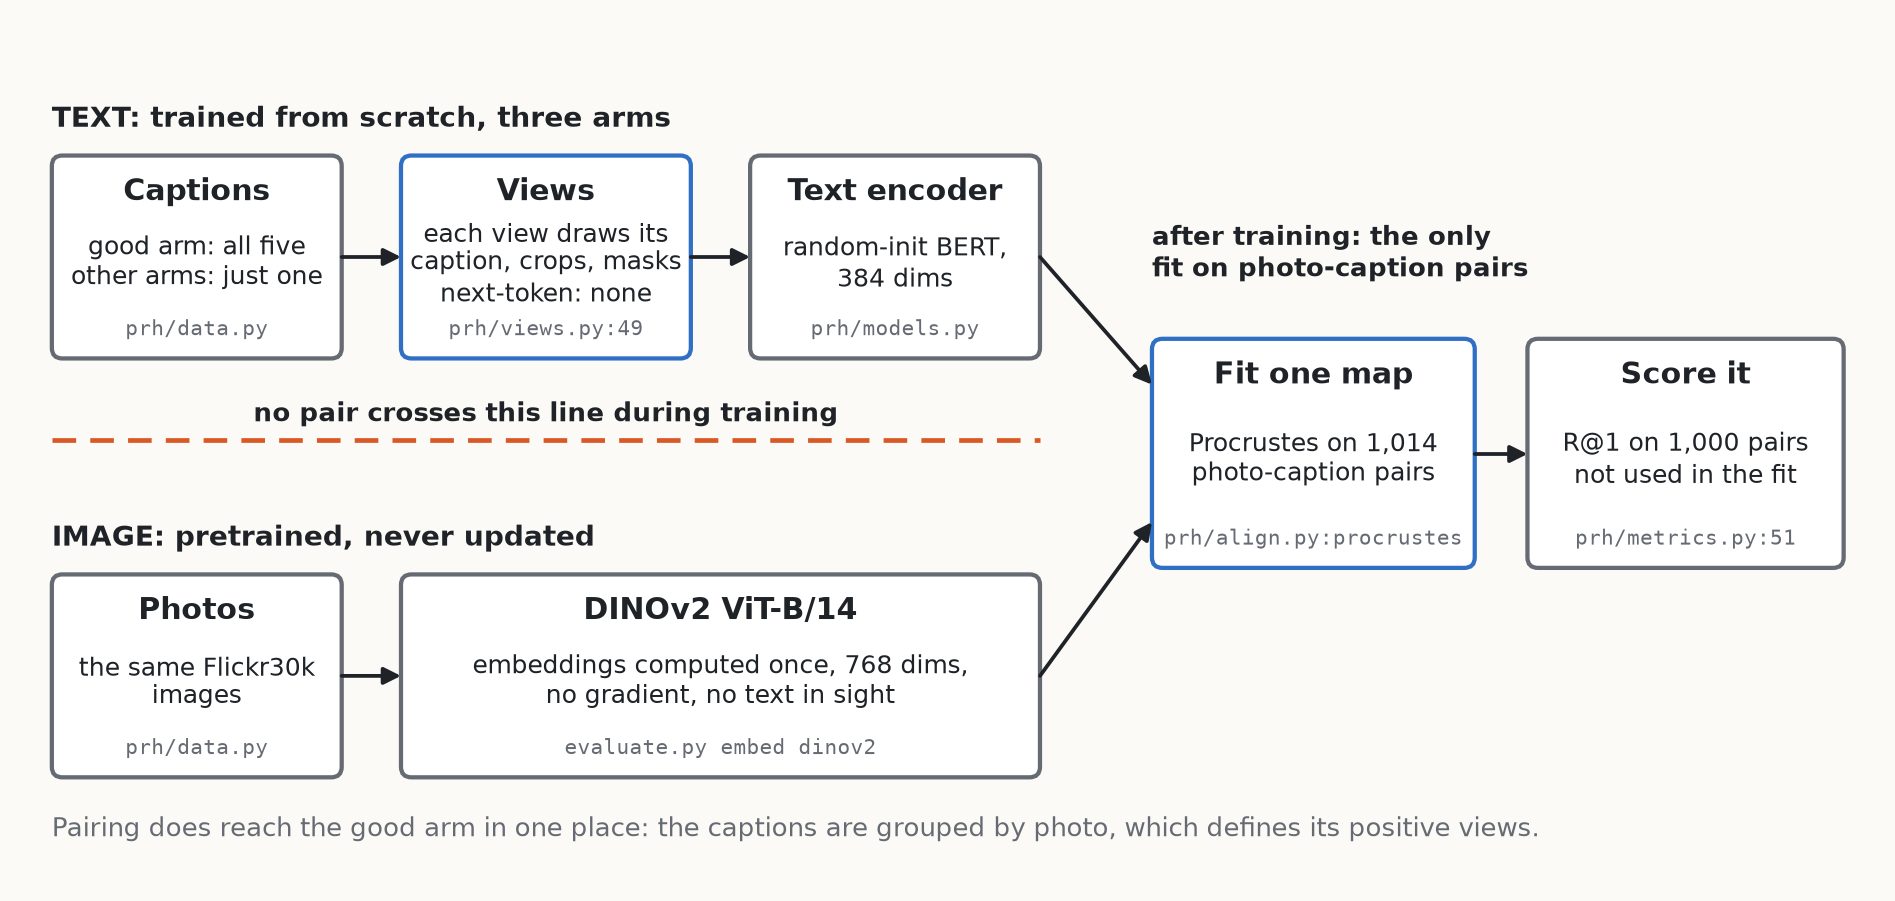
저희 재현 실험에서는 텍스트 모델을 학습할 때 사진과 문장의 벡터를 직접 맞추는 손실을 쓰지 않습니다. 사진·캡션 쌍으로 두 모델 사이의 변환을 구하는 단계는 학습이 끝난 뒤입니다. 다만 좋은 뷰를 만들 때부터 어떤 캡션들이 같은 사진에 달렸는지는 알고 있어야 합니다.
| 논문 | 코드 | 하는 일 |
|---|---|---|
| 좋은 뷰와 나쁜 뷰 (명제 3) | prh/views.py의 TextView.__call__, prh/data.py의 pick | 캡션 목록을 넘길지 하나만 넘길지 정함 |
| 예측기를 항등 함수로 둔 JEPA 손실 | stable_pretraining/methods/lejepa.py의 _compute_loss | 모든 뷰의 벡터를 긴 뷰 두 개의 평균에 가깝게 만듦 |
| 표현의 붕괴 방지 | 같은 파일의 SlicedEppsPulley | 벡터를 여러 방향으로 투영해 정규분포에 가까워지도록 제약 |
| JEPA로 본 다음 토큰 예측 (명제 4) | prh/forward.py의 next_token | 입력 임베딩을 출력에도 쓰는 softmax |
| 회전 하나 (정리 1, 명제 2) | prh/align.py의 procrustes | 짝지은 벡터로부터 좌표 변환을 계산 |
| 평가 | prh/metrics.py의 alignment, recall | 일부 쌍으로 맞추고 나머지로 채점 |
| 코드로 돌려 보는 이론 | prh/theory.py, tests/test_theory.py | 유한한 세계를 NumPy 배열로 계산 |
코드 안 설명문인 docstring의 명제 번호는 arXiv와 다른 곳이 있습니다. prh/forward.py는 다음 토큰 예측을 "Prop. 2"라고 적었지만 arXiv v1에서는 명제 4입니다. 이 글은 arXiv 번호를 따릅니다.
좋은 뷰와 나쁜 뷰를 가르는 한 줄
if isinstance(ids, list):  # good views: each view draws its own caption of the image
    ids = ids[torch.randint(len(ids), ()).item()]
prh/views.py 49-50행입니다. --caption-views를 켜면 prh/data.py의 pick이 사진의 캡션 다섯 개를 목록으로 돌려주고, 뷰 여덟 개가 각자 캡션을 무작위로 하나씩 뽑습니다. 그래서 같은 캡션이 겹칠 수도 있습니다. 플래그를 끄면 pick이 캡션 하나만 돌려주므로 입력 여덟 개를 모두 그 문장에서 잘라 만듭니다. 이후 처리는 같습니다. 임의의 구간을 고르고 토큰 15%를 가립니다. 길게 남기는 입력 두 개(global 뷰)는 캡션의 50-100%를, 짧게 남기는 입력 여섯 개(local 뷰)는 15-50%를 씁니다.
두 조건 모두 같은 방식으로 자르고 가립니다. 코드가 바꾸는 것은 자르기 전의 캡션을 고르는 부분입니다. 한 문장의 단어 선택까지 공유하게 할지, 여러 문장에 공통된 장면을 공유하게 할지 비교하려는 명제 3의 구분이 이 부분에 들어 있습니다.
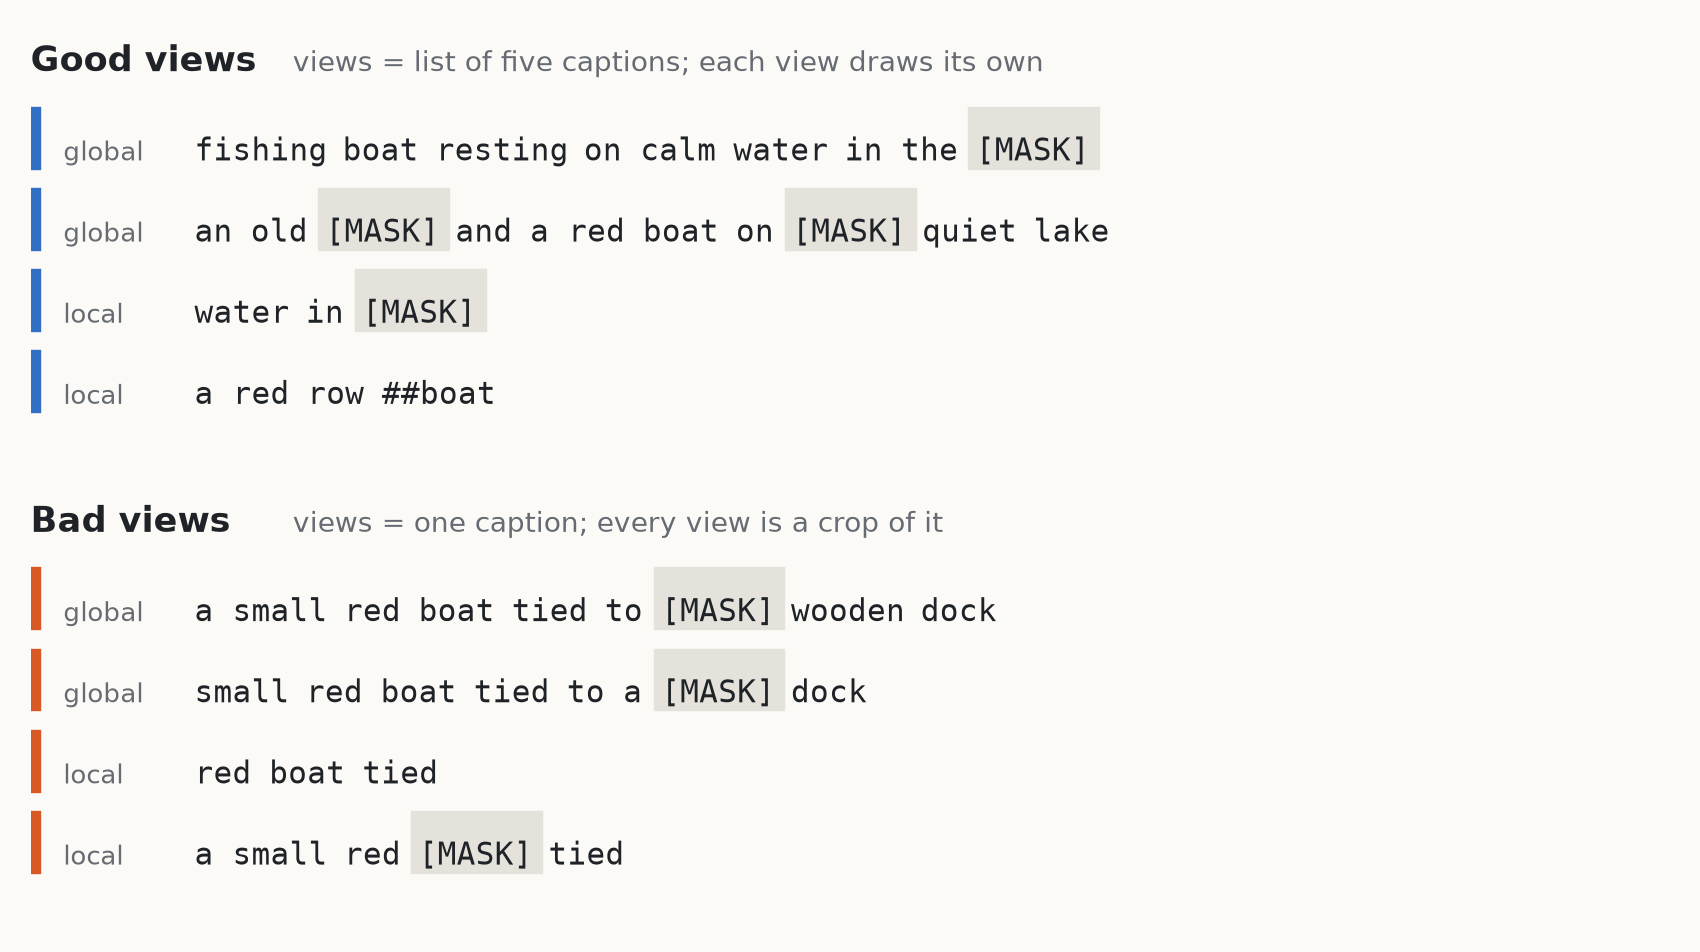
위 그림은 저장소의 실제 변환 코드에 저희가 쓴 캡션 다섯 개를 넣어 나온 결과입니다. 나쁜 뷰 네 개는 모두 한 문장에서 나왔으니 "red"나 "tied" 같은 단어를 그대로 간직해도 서로 맞출 수 있습니다. 좋은 뷰는 서로 다른 문장을 뽑을 수 있으므로, 한 문장의 정확한 단어만 기억하는 것으로는 맞추기 어렵습니다.
사진 없이 학습했다는 말에 단서가 붙는 곳도 여기입니다. 텍스트 인코더에 사진이 들어가지는 않지만, 좋은 뷰를 만들려면 어떤 캡션들이 같은 사진을 설명하는지 알아야 합니다. 즉 어떤 입력을 양성 쌍으로 묶을지 정할 때 사진과 텍스트의 대응 정보를 이용합니다. 논문도 대응 정보가 양성 쌍의 정의, 학습 후의 선형 변환, 웹 이미지 데이터에서 이미지 캡셔너가 만든 텍스트를 통해 들어온다고 밝힙니다. 이미지와 텍스트를 직접 맞추는 손실이 없다는 말과, 둘의 대응 정보를 전혀 쓰지 않는다는 말은 구별해야 합니다.
여러 입력의 벡터를 가깝게 만드는 손실 함수
centers = all_projected[:n_global].mean(0)
inv_loss = (centers.unsqueeze(0) - all_projected).square().mean()
sigreg_loss = sigreg(all_projected.reshape(-1, all_projected.size(-1)))
loss = inv_loss + lamb * sigreg_loss
stable-pretraining 라이브러리의 lejepa.py 268-273행입니다. 길게 남긴 global 뷰 두 개의 벡터 평균을 구하고, 모든 뷰의 벡터가 그 평균에 가까워지도록 오차를 줄입니다. 여기에는 목표 벡터를 예측하는 별도의 학습형 네트워크가 없습니다. 논문도 예측기(predictor)를 입력을 그대로 반환하는 항등 함수로 놓고 분석합니다. 학습형 예측기나 행동 정보를 조건으로 받는 예측기를 쓰는 JEPA는 이 정리들이 다루지 않습니다.
첫 번째 오차 항 inv_loss만 줄이면 모든 입력을 같은 벡터로 보내는 해가 나올 수 있습니다. 그러면 서로 다른 사진이나 문장을 구별할 수 없습니다. 이를 막는 항이 sigreg_loss입니다. SIGReg는 벡터들이 모든 방향으로 비슷하게 퍼진 정규분포, 즉 등방 가우시안에 가까워지도록 제약합니다.
구현은 매 스텝 무작위 단위 방향 1,024개를 새로 뽑고, 벡터를 각 방향으로 투영해 1차원 값으로 바꿉니다. 각 값의 분포를 표준정규분포와 비교할 때 특성 함수의 17개 지점을 사용합니다. 이 장치는 명제 1의 화이트닝처럼 붕괴를 막는 역할을 하지만, 제약은 더 엄격합니다. 화이트닝은 평균과 공분산까지만 맞추는 반면, SIGReg는 분포의 모양까지 정규분포에 가깝게 만듭니다.
SIGReg의 강도는 설정값 하나만으로 판단하기 어렵습니다. 분포를 비교한 통계량에 샘플 수를 곱하기 때문에((err @ self.weights) * N * self.world_size) lamb만으로는 실제 강도가 정해지지 않습니다. 저장소의 docs/reproduce.md도 이 점을 분명히 적어 두었습니다. 논문이 쓴 버전에서 실제 적용되는 가중치는 GPU당 배치 크기에 비례합니다. 이미지 9억 4천만 장을 쓴 실행은 GPU당 배치 128에 가중치 .02를 썼는데, GPU당 256에서 --lamb 0.01을 주면 실제 적용되는 가중치가 같아집니다. self.world_size는 손실을 만들 때 분산 학습이 이미 켜져 있으면 프로세스 수이고 아니면 1인데, 저자들의 실행에서 어느 쪽이었는지는 확인하지 않았습니다. N은 배치 안의 뷰를 모두 세므로, 뷰 개수를 바꿔도 손실에 반영되는 강도가 달라집니다.
논문을 보면 이 차이가 어디서 드러나는지 알 수 있습니다. R@1은 앞에서 본 정답 비율입니다. 이웃이 겹치는 정도를 재는 mutual 10-NN과 WIT 벤치마크는 뒤에서 설명합니다. 실제 적용되는 가중치가 두 배였던 시드는 WIT mutual 10-NN에서 .121로, 나머지 세 시드 평균 .184보다 낮았습니다. 그런데 3만 쌍 변환으로 잰 Flickr R@1은 거의 그대로였습니다(.477 대 .478). 1,014쌍 변환으로 잰 Flickr30k R@1도 배치 512에서 .241로, 기본 설정의 .246과 비슷합니다. 저자들도 이 규모에서는 WIT 점수가 SIGReg 가중치에 민감하며, Flickr 캡션을 쓴 비교 실험에서는 그 민감도가 드러나지 않았다고 적었습니다.
가중치를 더 크게 바꾸면 Flickr에서도 차이가 드러납니다. 기울기가 지나치게 커지지 않도록 제한하는 gradient clipping을 쓴 조건에서 시드 하나씩 돌린 결과, λ = .05에서는 표현이 붕괴했고, λ = .1에서는 R@1이 .202에 그쳤습니다. 지표에 드러나지 않더라도 배치 크기를 바꾸면 같은 .02가 다른 실험이 됩니다.
다음 토큰 예측은 두 줄입니다
logits = h[:, :-1] @ self.backbone.bert.embeddings.word_embeddings.weight.T
loss = F.cross_entropy(logits.flatten(0, 1).float(), tokens[:, 1:].flatten(), ignore_index=self.backbone.pad_id)
이 코드에서는 입력 토큰을 벡터로 바꿀 때 쓴 임베딩 행렬을 출력 점수를 계산할 때도 사용합니다. 문맥을 담은 은닉 상태 h와 각 토큰의 임베딩을 내적해 다음 토큰의 점수를 구합니다. 교차 엔트로피 손실을 풀어 쓰면 −⟨h, e_y⟩ + log Σ e^⟨h, e_v⟩입니다.
첫 항은 h를 정답 토큰의 벡터 e_y에 가깝게 만듭니다. 두 번째 항은 어휘 전체의 점수를 반영하며 붕괴를 억제하는 역할을 합니다. 명제 4는 이 구조를 JEPA의 예측 항과 붕괴 방지 항에 대응시킵니다. 이 실험 조건은 캡션에서 별도의 뷰를 만들지 않고 문장 전체를 읽습니다.
두 모델의 벡터를 연결하는 변환
u, _, vt = torch.linalg.svd(a.T @ b, full_matrices=False)
return u @ vtprh/align.py에 있는 직교 프로크루스테스(orthogonal Procrustes) 계산입니다. 학습이 끝난 두 모델의 벡터를 사진·캡션 쌍으로 연결하는 부분입니다. 앞의 정리는 같은 차원의 공간을 회전시키는 경우를 다루지만, 실제 실험에서는 두 모델의 출력 차원이 다릅니다. DINOv2 ViT-B의 출력은 768차원이고 기본 텍스트 인코더는 384차원이라, 사진 벡터를 텍스트 벡터 쪽으로 옮기는 변환은 768×384 행렬입니다. 각 열은 길이가 1이고 서로 수직입니다. 차원을 768에서 384로 줄이므로 같은 공간 안에서의 회전과는 다릅니다.
저장소의 코드 설명(docstring)에도 "we keep calling it the rotation"이라고 적혀 있습니다. 논문 본문도 이 경우를 "a case the theory does not cover"라고 밝히고 독립적으로 정할 수 있는 파라미터 수를 약 22만 개(0.22M)로 적습니다. 정확히 세면 768·384 − 384·385/2 = 220,992개이고, 이를 1,014쌍으로 맞춥니다. 파라미터에 비해 쌍이 적다는 점이 뒤의 결과에 드러나는 것으로 보입니다.
채점 코드에서 눈여겨볼 곳 두 군데
rank = (s >= s.diag()[:, None]).sum(1) - 1recall의 >=는 동점을 정답에 불리하게 셉니다. 인코더가 한 점으로 뭉치면 모든 점수가 정확히 같아지고, 정답이 꼴찌가 되어 0점을 받습니다. >였다면 같은 인코더가 만점을 받았을 것입니다. docstring은 이 경우를 우연 수준이라고 적었지만, 완전히 동점이면 이 줄의 결과는 0입니다. alignment에서는 평균과 변환을 모두 테스트가 아닌 행에서만 계산하므로 평가에 쓸 정답 정보가 변환을 구하는 과정에 섞이지 않습니다.
저희가 다시 돌린 결과
앞에서 본 정답 비율이 R@1(Recall at 1)입니다. 테스트 사진 1,000장 각각에 대해 캡션 1,000개를 비교하고, 가장 높은 점수를 받은 캡션이 해당 사진의 정답이면 성공으로 셉니다. 아래 표의 .243은 24.3%이며, 무작위 선택의 기준선은 .001, 즉 0.1%입니다.
저장소 기본 인자와 시드 0으로 A100 한 장에서 세 조건을 함께 돌렸고, 모두 3시간 50분 안에 끝났습니다. stable-pretraining은 지정된 버전을 썼고, 나머지 라이브러리는 저자들보다 새 버전입니다(저장소 재현 문서는 PyTorch 2.11, 저희는 torch 2.15).
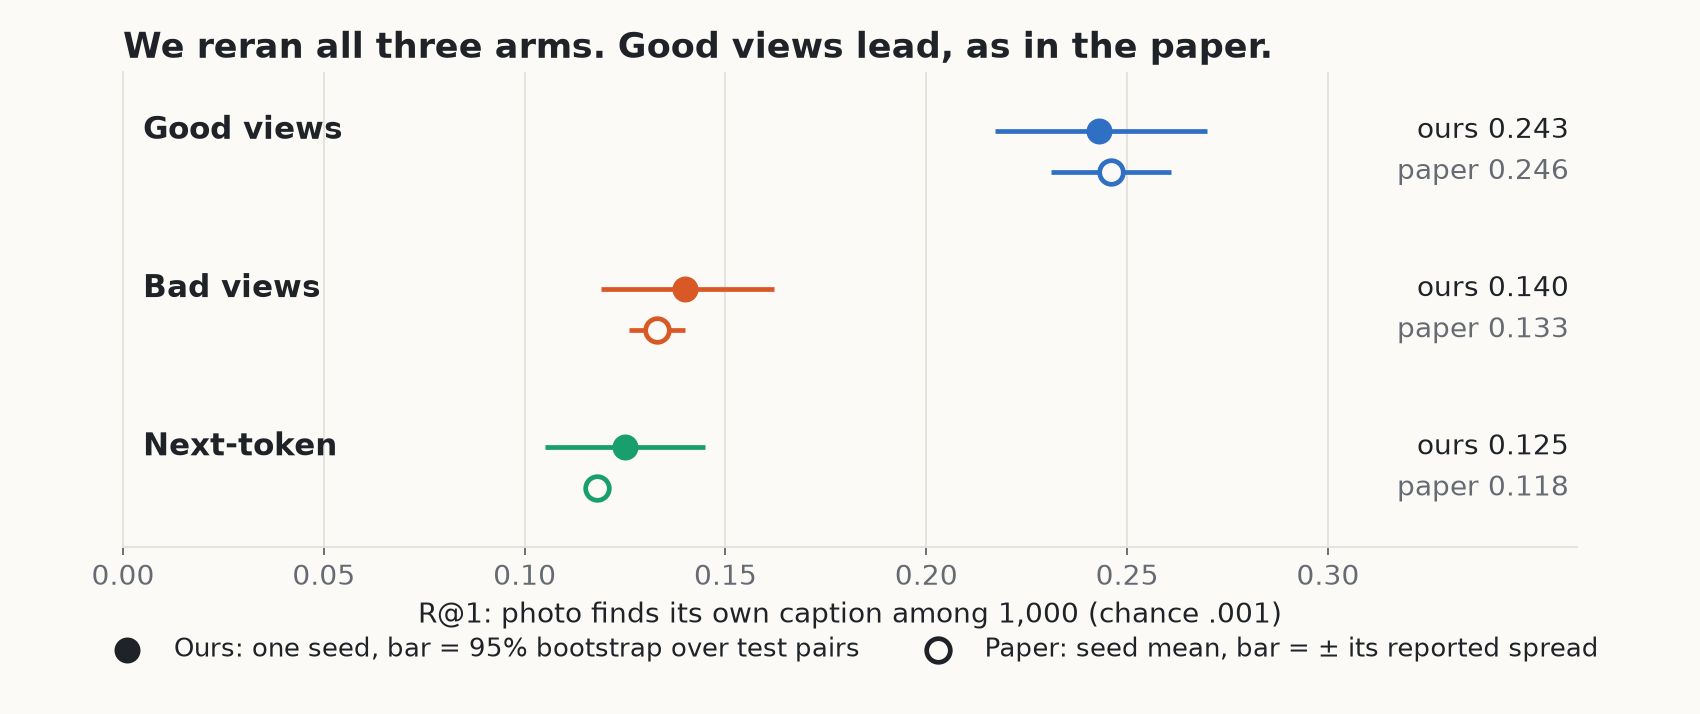
| 조건 | 저희 R@1 [테스트 쌍 95% 구간] | 논문 R@1 | 저희 mutual 10-NN | 논문 mutual 10-NN |
|---|---|---|---|---|
| 좋은 뷰 | .243 [.217, .270] | .246 ± .015 | .233 | .232 ± .006 |
| 나쁜 뷰 | .140 [.119, .162] | .133 ± .007 | .136 | .132 ± .001 |
| 다음 토큰 | .125 [.105, .145] | .118 ± .002 | .121 | .122 ± .001 |
뚜렷하게 재현된 것은 좋은 뷰와 나쁜 뷰의 차이입니다. 정답 비율은 10.3%포인트 높았고, 같은 테스트 쌍들을 함께 재표집하는 부트스트랩으로 구한 차이의 95% 구간은 7.5-13.1%포인트였습니다. 다음 토큰 예측보다도 11.8%포인트 높았고, 구간은 8.9-14.7%포인트입니다.
표의 다른 지표인 mutual 10-NN은 각 모델이 입력 사이의 관계를 얼마나 비슷하게 정리했는지 봅니다. 같은 항목에 대해 사진 모델에서 가까운 이웃 10개를 고르고, 텍스트 모델에서도 가까운 이웃 10개를 고른 뒤 얼마나 겹치는지 평균합니다. 거리는 코사인 유사도로 판단합니다. 앞의 R@1과 달리 두 공간 사이의 변환을 구할 필요가 없습니다. 우연 수준은 약 .01이고, 이 지표에서도 좋은 뷰의 점수가 가장 높았습니다.
이 표를 읽을 때 조심할 점이 셋 있습니다. 저희의 95% 구간은 이미 학습된 모델을 고정한 채 테스트 쌍을 다시 뽑아 계산했습니다. 시드를 바꿔 처음부터 학습할 때의 변동은 담지 않습니다. 시드 하나로는 나쁜 뷰와 다음 토큰을 가를 수 없습니다. 둘의 차이는 +.015 [−.009, .040]입니다.
또 소수 셋째 자리로 보면 저희 숫자 둘은 논문이 제시한 구간(시드 3개 평균 ± 범위의 절반)을 벗어납니다. 다음 토큰 R@1은 .125로 논문의 .118 ± .002 밖이고, 나쁜 뷰 mutual 10-NN은 .136으로 논문의 .132 ± .001 밖입니다. R@1의 경우 논문 평균이 저희 테스트 쌍 구간 안에 들어가긴 합니다.
대조 실험도 두 가지 돌렸습니다. 무작위 정규 직교 변환과 쌍을 섞어서 맞춘 변환은 세 조건 모두 약 .001이 나왔습니다. 점수가 쌍의 대응 관계에서 나온다는 뜻입니다.
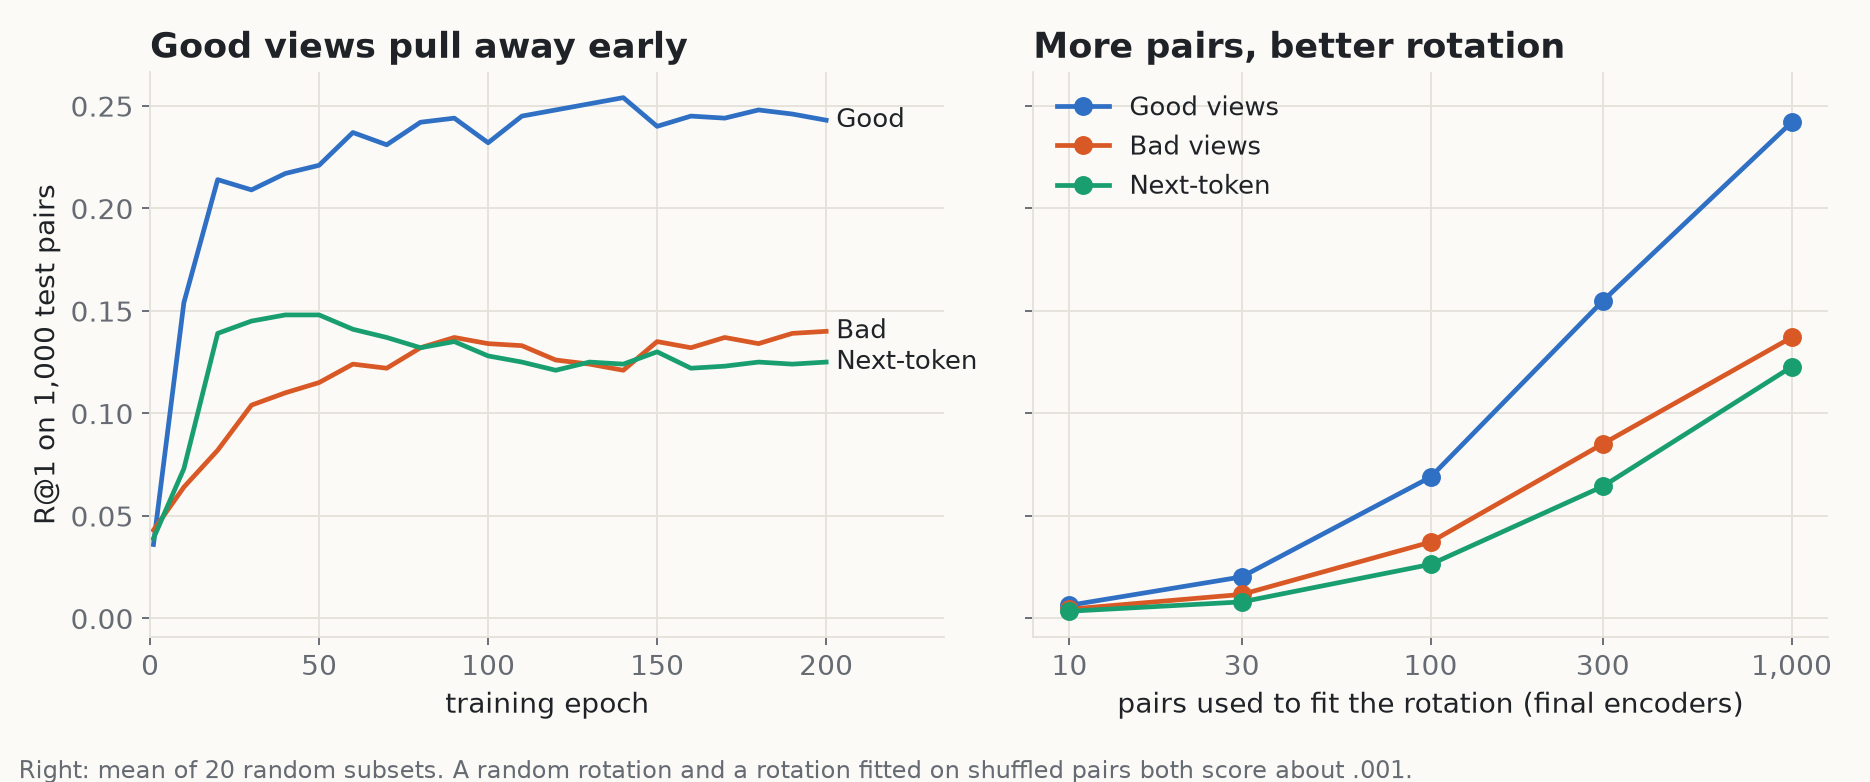
왼쪽 그래프를 보면 .001보다 현실적인 기준선이 나옵니다. 1에폭만 지나도 세 조건 모두 약 .04입니다(.036, .043, .039). 1에폭만 학습한 인코더도 변환을 맞춘 뒤에는 .001을 크게 넘습니다. 따라서 충분히 학습한 모델의 점수는 무작위 선택뿐 아니라 이 초기 점수와도 비교해야 합니다. 좋은 뷰는 140에폭(저희는 1부터 셉니다)에 최고치 .254를 찍고 오르내립니다. 저희도 논문처럼 마지막 에폭 값 .243을 보고합니다.
다음 토큰은 움직임이 다릅니다. 40-50에폭에 .148로 정점을 찍고 끝에는 .125로 내려가므로, 마지막 에폭이 최선은 아닙니다. 논문도 이 점을 다룹니다. 검증 손실이 가장 낮은 지점(논문 번호로 29에폭)에서 멈추면 .134이고, 테스트 쌍으로 최고 체크포인트를 고르더라도 많아야 .146입니다. 저희 정점 .148도 이와 가깝고, 좋은 뷰보다는 한참 아래입니다.
오른쪽 그래프에서는 쌍을 늘릴수록 점수가 계속 오릅니다. 변환을 맞출 때 쓴 1,014쌍 자체로 채점하면 좋은 뷰, 나쁜 뷰, 다음 토큰이 각각 .927, .879, .968입니다. 변환을 구할 때 쓴 쌍에서는 잘 맞지만 새로운 쌍에서는 점수가 크게 떨어집니다. 이는 자유 파라미터 220,992개인 변환이 1,014쌍에 과적합했을 가능성을 보여 줍니다. 따라서 .243에는 텍스트 모델의 학습 결과뿐 아니라, 적은 쌍으로 변환을 추정한 데서 생기는 한계도 들어 있습니다.
논문은 Flickr 학습·검증 쌍 3만 개를 전부 쓰면 좋은 뷰가 .346까지 오르고, 다른 두 조건은 .207과 .213, 훨씬 많은 데이터로 학습한 참조 인코더 둘은 .48에서 .49라고 보고합니다. 3만 쌍 변환은 저희가 돌려 보지 않았습니다.
웹 규모 실험에서 논문이 보고한 것
이 부분은 재실행하지 않았고 아래 숫자는 모두 논문 값입니다. 벤치마크가 Huh 등의 WIT-1024로 바뀌고, 고정된 DINOv2 기준 mutual 10-NN으로 채점합니다. 사진 모델과 텍스트 모델이 이웃 관계를 얼마나 비슷하게 정리했는지 보며, 두 공간을 연결하는 변환은 구하지 않습니다. 각 모델의 여러 층을 비교한 뒤 가장 높은 점수를 내는 층 조합을 씁니다.
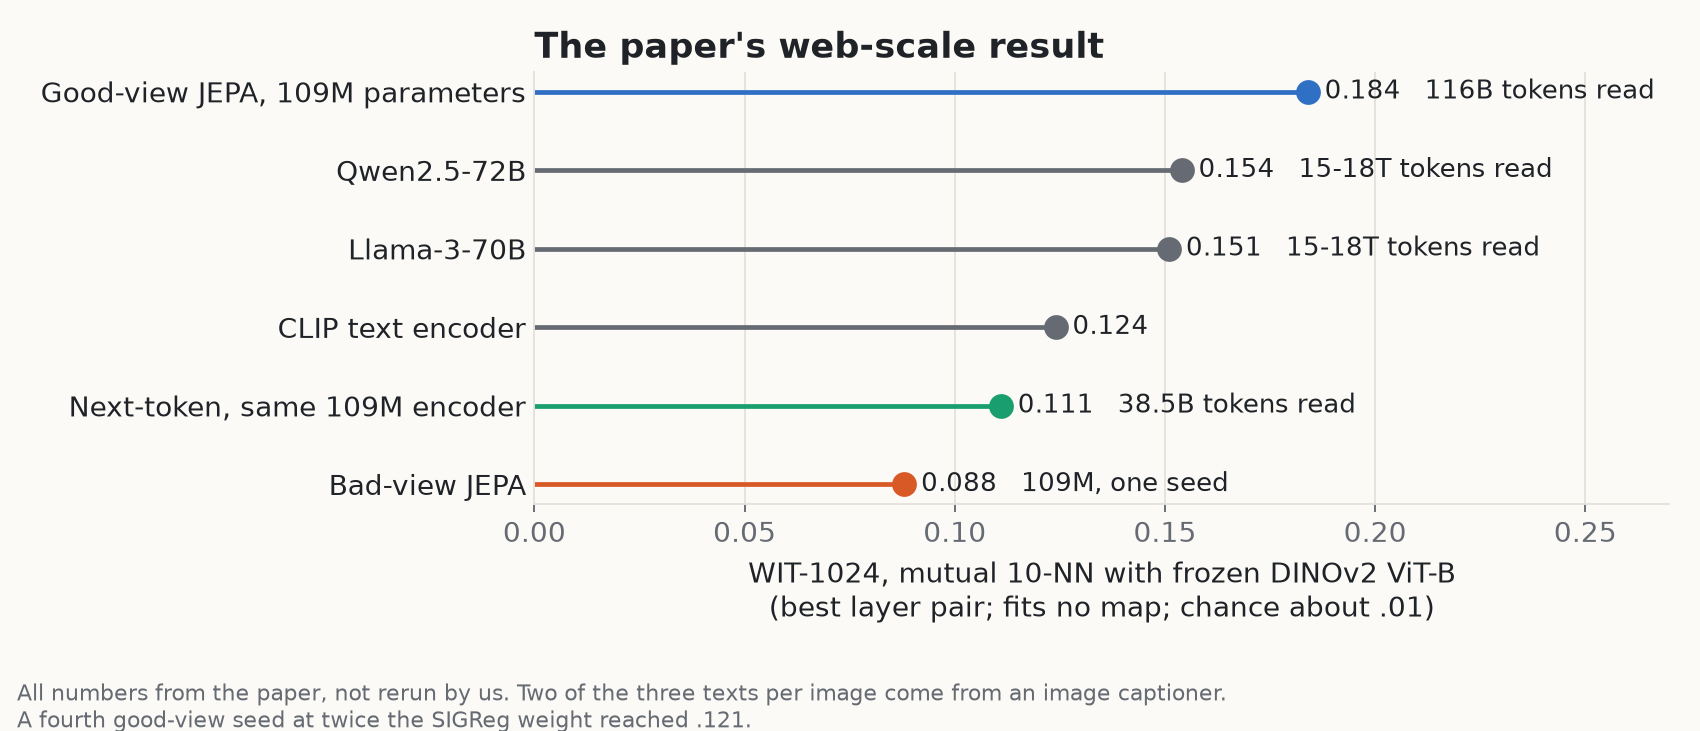
파라미터 1억 900만 개(109M)의 좋은 뷰 인코더가 웹 이미지 9억 4천만 장의 텍스트를 읽고 .184를 얻었습니다. 토큰 15조에서 18조 개로 학습한 Qwen2.5-72B(.154)와 Llama-3-70B(.151)보다 높은데, 좋은 뷰 인코더가 읽은 토큰은 1,160억 개입니다. 저자들은 이 숫자에 다음 단서를 직접 붙였습니다.
- 이미지당 텍스트 세 개 중 두 개는 사진을 보고 설명문을 생성하는 이미지 캡셔너 LLaVA(LLaMA-3-8B 기반)가 썼고, 이 캡셔너는 CLIP ViT-L/14로 이미지를 봅니다. 이미지 캡셔너 없이 이미지 224만 장의 텍스트로 학습한 좋은 뷰는 .060이고, 같은 이미지에 캡셔너 텍스트를 쓰면 .107입니다. 따라서 언어 모델이나 CLIP 텍스트 인코더보다 점수가 높다는 결과에는 이미지 캡셔너가 제공한 정보의 영향도 들어 있습니다. 반면 같은 텍스트를 주고 좋은 뷰와 나쁜 뷰를 비교한 결과는 텍스트 출처가 같다는 조건에서 읽을 수 있습니다.
- 앞에서 말한 실제 적용되는 가중치 두 배 시드는 .121이었습니다. 네 시드 평균은 .168로, 그래도 평가한 언어 모델 모두보다 높습니다. 저자들은 이 결과를 본 뒤에 첫 실행의 가중치를 나머지 9억 4천만 장 실행에 쓰기로 했다며 "so that weight was selected on WIT"라고 밝혔습니다.
- 하이퍼파라미터는 좋은 뷰 JEPA에 대해서만 조정했습니다. WIT 캡션 1,024개 중 적어도 43개가 학습 텍스트에 들어 있습니다(빼도 점수 변화는 많아야 .002입니다).
논문이 앞세운 "샘플이 42배 적다"는 결과는 같은 109M 인코더에서 2,160만 샘플의 .109와 9억 샘플의 .111을 비교한 값입니다. 앞의 값은 좋은 뷰, 뒤의 값은 다음 토큰 예측의 점수입니다. 좋은 뷰 샘플 하나가 텍스트 세 개를 읽으므로 토큰으로 따지면 27.7억 대 385.2억, 14배 차이입니다.
이 비교에는 한계가 있습니다. 저자들은 다음 토큰 모델을 더 일찍 저장한 체크포인트는 채점하지 않았다고 밝혔습니다. 두 실행의 설정도 규모에 따라 다릅니다(학습률 1e-4와 배치 256, 학습률 2e-4와 배치 2,048). 그러니 다음 토큰 실행은 9억 샘플 전에 이미 .109에 닿았을 수도 있고, 42배는 저자들이 채점한 체크포인트 하나를 기준으로 잰 값입니다.
같은 대목에서 논문은 Flickr R@1도 .388 대 .335로 더 높고, 샘플 수를 2,160만으로 맞춘 33M 인코더에서는 .108 대 .071로 차이가 더 크다고 보고합니다.
논문의 표 7도 하나 더 보겠습니다. 같은 숫자가 저장소의 paper/data/text_sources.csv에 들어 있습니다. 이미지 5천만 장 규모에서 세 시드를 평균한 값입니다. alt 텍스트는 웹 이미지에 붙은 대체 텍스트를 뜻합니다.
| 텍스트 | 뷰 | WIT mutual 10-NN | R@1(3만 쌍 변환) |
|---|---|---|---|
| 세 종류 전부 | 좋은 뷰 | .125 | .376 |
| 세 종류 전부 | 나쁜 뷰 | .063 | .290 |
| LLaVA만 | 좋은 뷰 | .096 | .386 |
| LLaVA만 | 나쁜 뷰 | .092 | .325 |
| alt 텍스트만 | 나쁜 뷰 | .056 | .199 |
논문의 표 설명에는 같은 텍스트라면 좋은 뷰의 mutual 10-NN 점수가 두 배라고 되어 있습니다("with the same texts, good views double alignment"). 세 종류 전부를 쓴 행은 그 설명과 맞습니다. LLaVA만 쓴 행에서는 WIT 평균이 .096과 .092로 가까워지고, 개별 시드 점수도 .093에서 겹칩니다. 다만 R@1에서는 .386 대 .325로 차이가 남습니다. 이미지 224만 장의 alt 텍스트에서는 텍스트만으로 고쳐 쓴 문장을 좋은 뷰로 써도 나쁜 뷰보다 앞선다고 논문은 보고합니다(WIT .060 대 .055, R@1 .233 대 .180). 저자들도 나쁜 뷰에서도 데이터의 종류가 중요하고, 어떤 텍스트를 쓰든 뷰를 만드는 방식이 중요하다고 적었습니다. 다만 이 표에서 보듯 효과의 크기는 평가 지표와 텍스트 출처에 따라 달라집니다.
영상 데이터에서도 같은 효과가 있었을까요?
논문은 MSR-VTT 영상 데이터에서도 좋은 뷰와 나쁜 뷰를 비교했습니다. 이 실험에서는 이미지 모델과 텍스트 모델을 모두 처음부터 학습했습니다. 저희는 다시 돌리지 않았으며, 다음 토큰 예측 조건은 이 비교에 없습니다.
좋은 뷰는 한 영상의 서로 다른 프레임과 그 영상을 설명하는 서로 다른 문장으로 만듭니다. 나쁜 뷰는 프레임 하나와 문장 하나를 각각 잘라 만듭니다. mutual 10-NN은 시드 3개 평균으로 좋은 뷰 .067, 나쁜 뷰 .039였습니다. 우연 수준은 .01입니다. 앞의 24.3%처럼 캡션을 맞힌 비율과는 다른 지표입니다.
효과는 대부분 텍스트 쪽에서 나왔습니다. 텍스트 쪽만 좋은 뷰를 쓰면 .059, 이미지 쪽만 쓰면 .043입니다. 저자들도 이미지 쪽 효과가 작다고 적었습니다. 이미지 쪽을 좋은 뷰로 바꾸는 효과는 다른 지표인 R@5에서는 오히려 반대였습니다. 텍스트 쪽이 좋은 뷰일 때 .099 대 .105, 나쁜 뷰일 때 .063 대 .072로, 이미지 쪽도 좋은 뷰로 만든 설정의 점수가 낮았습니다.
어디까지 말할 수 있을까요
다음 한계는 저자들도 직접 적었습니다. 정리들은 이상화된 세계를 다룹니다. 실험은 명제 1에서 해를 분석한 제곱 오차·화이트닝 조합 대신 LeJEPA를 씁니다. 비교 기준인 DINOv2 역시 논문의 분류로는 나쁜 뷰를 쓰는 인코더입니다. MSR-VTT를 뺀 저자들의 이미지 인코더도 마찬가지입니다. 좋은 뷰를 쓰려면 어떤 텍스트들이 같은 장면을 설명하는지 누군가 알고 있어야 합니다. 캡션 데이터셋에는 이 정보가 있습니다. 다만 저희가 보기에 언제나 공짜로 얻을 수 있는 것은 아닙니다.
저희 쪽 한계는 시드 하나, 데이터셋 하나이고, 비교도 텍스트 세 조건과 고정된 DINOv2 사이로 한정된다는 점입니다. 데모도 그림 여섯 장입니다. 논문의 이미지 JEPA와 캡션 쌍 조건은 돌리지 않았고, 캡셔너, 쌍 없는 ImageNet-100 결과, 스케일링 법칙도 시험하지 않았습니다.
저희가 재현한 것은 Flickr30k에서 텍스트 모델에 어떤 입력들을 가깝게 만들도록 가르치느냐의 효과입니다. 한 캡션의 조각 대신 같은 사진의 여러 캡션에서 입력을 뽑자 R@1이 .140에서 .243으로 올랐습니다. 논문의 .133, .246과 가까운 결과입니다.
직접 돌려 보려면 저장소를 받아 stable-pretraining을 버전 ab836bf로 설치하고, Flickr30k(약 8GB)를 받은 뒤 아래 명령을 실행합니다.
python train.py --modality text --caption-views        # good views
python train.py --modality text                        # bad views
python train.py --modality text --objective ntp        # next-token
python evaluate.py embed dinov2 runs/ref/flickr_dinov2
python evaluate.py align runs/ref/flickr_dinov2 <text run> --last
저장소 테스트는 CPU에서 돌고 데이터셋이 필요 없습니다. 다만 토크나이저를 내려받는 테스트가 있습니다. 저희 환경에서 pytest -m "not slow"는 129개 통과, 6개 실패, 2개 건너뜀이었습니다. 실패 중 다섯은 그림 테스트로, 저희 장비에 LaTeX 패키지 cm-super가 없어서 멈췄습니다. 나머지 하나는 unbiased CKA 테스트이고 pytest.approx 안에서 TypeError: iteration over a 0-d tensor로 멈춥니다. 고치지는 않았고, 저희 점수는 CKA가 아니라 mutual 10-NN과 R@1입니다. tests/test_theory.py만 돌리면 37개가 모두 통과하고, test_thm1_two_modalities_with_the_same_positives_agree_up_to_rotation도 여기 들어 있습니다. GPU 시간을 쓰기 전에 정리 1이 성립하는 모습부터 보고 싶다면 여기서 시작하시면 됩니다.
그림은 FLUX.1-schnell로 만들었습니다. 데모의 캡션은 MS COCO(CC BY 4.0)에서 가져왔습니다. Flickr30k 사진은 다시 싣지 않습니다. 코드는 MIT 라이선스인 prh-proof 저장소의 버전 a2b9949와 stable-pretraining에서 인용했습니다.