불확실성 점수의 얼마가 답의 길이였을까: U-Space를 Qwen3.5-4B로 재 봤습니다
새 논문은 답의 길이 하나만으로도 언어 모델의 오답을 여러 불확실성 점수만큼 가려낸다고 보고했습니다. 원저자 코드와 문항으로 Qwen3.5-4B를 돌려 보니, 길이만으로 낸 AUROC가 세 벤치 평균 65.3이었고 TriviaQA 75.2에서 SuperGPQA 48.6까지 벌어졌습니다. U-Lens는 길이 통제 전 비교에서 길이만 쓴 점수보다 4.4 높았고, 길이를 통제한 비교에서 MSP보다 8.4 높았지만, 평균 로그 손실과의 차이(1.1)는 판정할 수 없었습니다. 주 비교에 쓴 세 벤치에서는 답의 최대 3분의 1이, 비교에서 뺀 Omni-MATH에서는 92.5%가 16,384토큰 상한에서 잘려 채점에서 빠졌습니다.
불확실성 점수의 얼마가 답의 길이였을까: U-Space를 Qwen3.5-4B로 재 봤습니다
언어 모델이 어려운 질문에 답할 때, 그 답이 틀렸을 가능성을 숫자 하나로 알 수 있으면 편합니다. 의심스러운 답만 사람에게 넘기면 되기 때문입니다. 모델이 토큰마다 낸 확률로 이런 숫자를 만드는 방법은 여러 가지가 있습니다. 10월 6일에 나온 논문 U-Space(Braun 외)는 이 숫자들에 곤란한 질문을 던집니다. 그 숫자 가운데 얼마가 그냥 답의 길이였느냐는 것입니다.
생각하며 답하는 모델은 막힐수록 길게 쓰고, 긴 답은 더 자주 틀립니다. 그래서 길이에 따라 커지는 점수라면, 다른 정보가 하나도 없어도 오답을 잘 잡는 것처럼 보일 수 있습니다. 논문은 이것을 직접 쟀습니다. 27-31B 모델 세 개, 벤치마크 네 개, 시드 세 개 평균으로, 답의 길이 하나만으로 맞은 답과 틀린 답을 가르는 AUROC가 68.6이었습니다. 대부분의 불확실성 방법과 비슷한 수준입니다. 길이가 비슷한 답끼리만 비교하면 이 값은 16.2 떨어져 우연 수준에 가까워졌습니다. 원저자가 제안한 U-Lens는 모델 내부 상태에서 불확실성을 읽는 방법인데, 68.6보다 높은 71.1이었고 같은 통제에서 1.8만 떨어졌습니다.
논문의 모델은 모두 큽니다. 사람들이 실제로 집에서 돌리는 크기의 모델에서도 같은 그림이 나오는지 궁금해서, 원저자 코드를 Qwen3.5-4B로 돌렸습니다.
측정 방법
- 코드와 문항: 원저자 저장소(s2labres/U-Space, 커밋
cce4d26)를 고치지 않고 썼습니다. 벤치마크도 논문과 같은 네 개(MMLU-Pro, Omni-MATH, SuperGPQA, TriviaQA)이고 문항도 각 1,000개로 같습니다. 코드가 문항 목록을 논문의 해시와 대조하는데, 네 벤치 모두 일치했습니다. - 모델: Qwen3.5-4B입니다. 설정은 저장소에 원저자가 넣어 둔 작은 모델용 설정을 그대로 썼습니다. 생각 모드를 켜고, temperature 1.0, 생성 상한 16,384토큰, 공개된 4B용 lens를 씁니다. 시드는 42 하나만 썼습니다(논문은 세 개). 4B를 고른 이유는, 이 코드에 필요한 종류의 lens가 9B 지시형 모델용으로는 공개돼 있지 않기 때문입니다.
- 점수: 저장소에 있는 방법 전부입니다. U-Lens, 그 구성 요소인 A_cone, 생성 길이만 쓴 점수, MSP, 최대 엔트로피, 평균 NLL(생성한 토큰들의 평균 로그 손실), Self-Certainty, DeepConf, 예측 엔트로피입니다. 여기서 AUROC는 점수가 틀린 답을 맞은 답보다 위로 줄 세우는 정도이고, 50이면 우연, 100이면 완벽입니다. 길이 통제 AUROC는 원저자 방식 그대로입니다. 답을 길이로 10구간으로 나눠 구간 안에서 AUROC를 재고, 구간 크기로 가중평균합니다.
- 규칙(실행 전에 정함): 주 비교는 세 개이고, 벤치 평균 AUROC 차이를 문항 단위 짝 부트스트랩 구간으로 판정합니다. 비교가 셋이라 98.33% 구간을 쓰고, 구간이 0을 포함하지 않을 때만 차이로 봅니다.
계획과 달라진 점이 하나 있고, 아래 모든 결과를 읽을 때 중요합니다. Qwen3.5-4B는 생각을 길게 해서, 많은 답이 16,384토큰 상한에 걸렸습니다. 원저자 코드는 이런 답을 채점에서 뺍니다. 잘린 답에는 채점할 최종 답이 없으니 당연한 처리입니다.
| 벤치 | 채점된 답(1,000개 중) | 상한에서 잘림 | </think>가 여러 번 | 채점된 답의 정확도 |
|---|---|---|---|---|
| TriviaQA | 819 | 180 | 1 | 68.6% |
| MMLU-Pro | 951 | 31 | 18 | 82.2% |
| SuperGPQA | 664 | 307 | 29 | 57.2% |
| Omni-MATH | 75 | 925 | 0 | 92.0% |
원저자 코드는 생각 끝 표시(</think>)가 여러 번 나온 답도 채점에서 뺍니다. 행마다 더하면 1,000개입니다.
Omni-MATH는 75개만 끝까지 답했고, 이 75개는 모델이 끝낼 만큼 쉬웠던 문항입니다. 75개로는 원저자의 길이 통제 AUROC도 계산할 수 없습니다(길이 10구간마다 20개씩 필요합니다). 그래서 AUROC를 하나도 계산하기 전에, Omni-MATH를 주 비교에서 빼고 따로 보고하기로 정했습니다. 나머지 세 벤치도 채점된 답은 상한 안에 끝난 답뿐입니다. 그러니 아래 결과는 "모든 질문"이 아니라 "4B 모델이 끝까지 답한 질문"에 대한 것입니다. 참고로 논문은 27B Qwen에 65,536토큰 상한을 줬습니다.
길이만으로도 강한 신호, 단 벤치에 따라
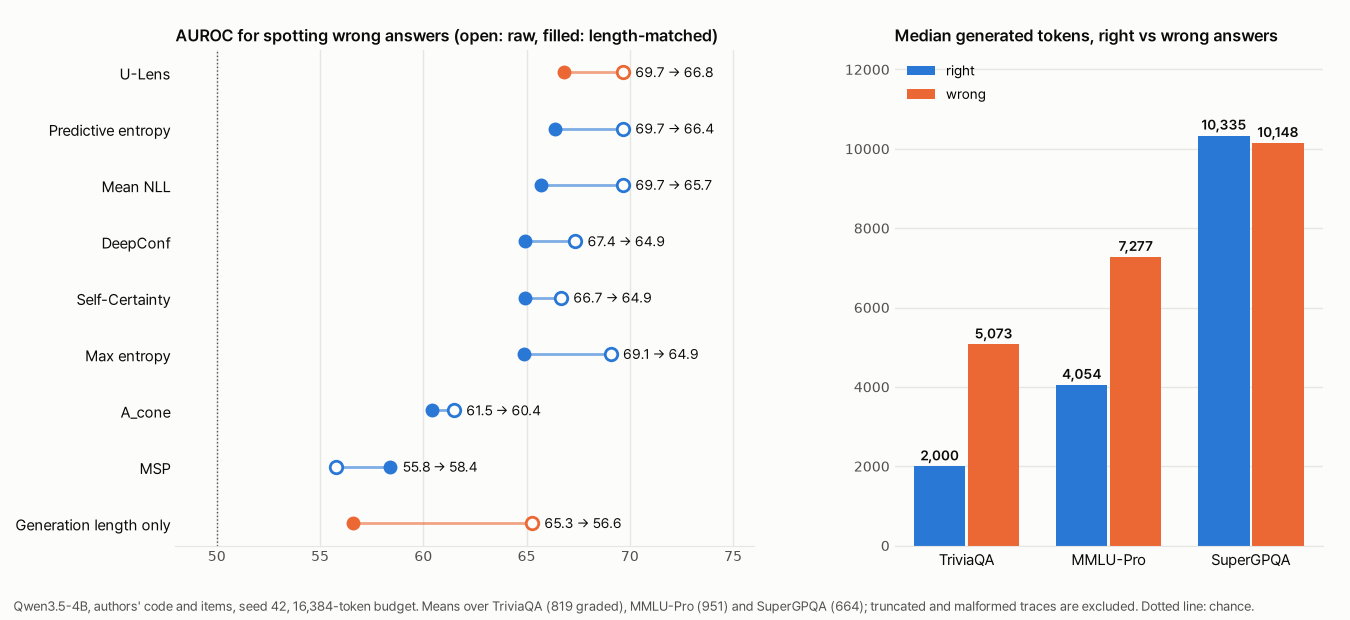
세 벤치 평균으로 길이만 쓴 AUROC는 65.3이었습니다. 논문의 큰 모델 평균은 68.6이지만, 모델과 시드가 달라 같다 다르다를 따지지는 않습니다. 이 평균 안에는 성격이 전혀 다른 벤치가 섞여 있습니다.
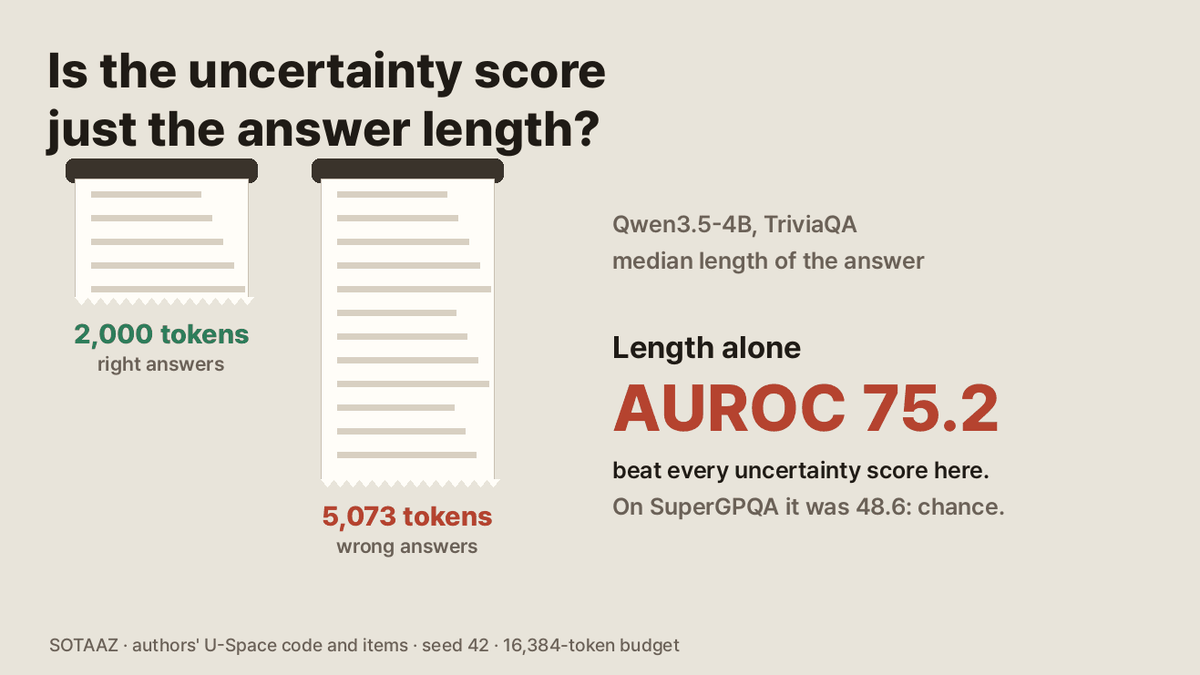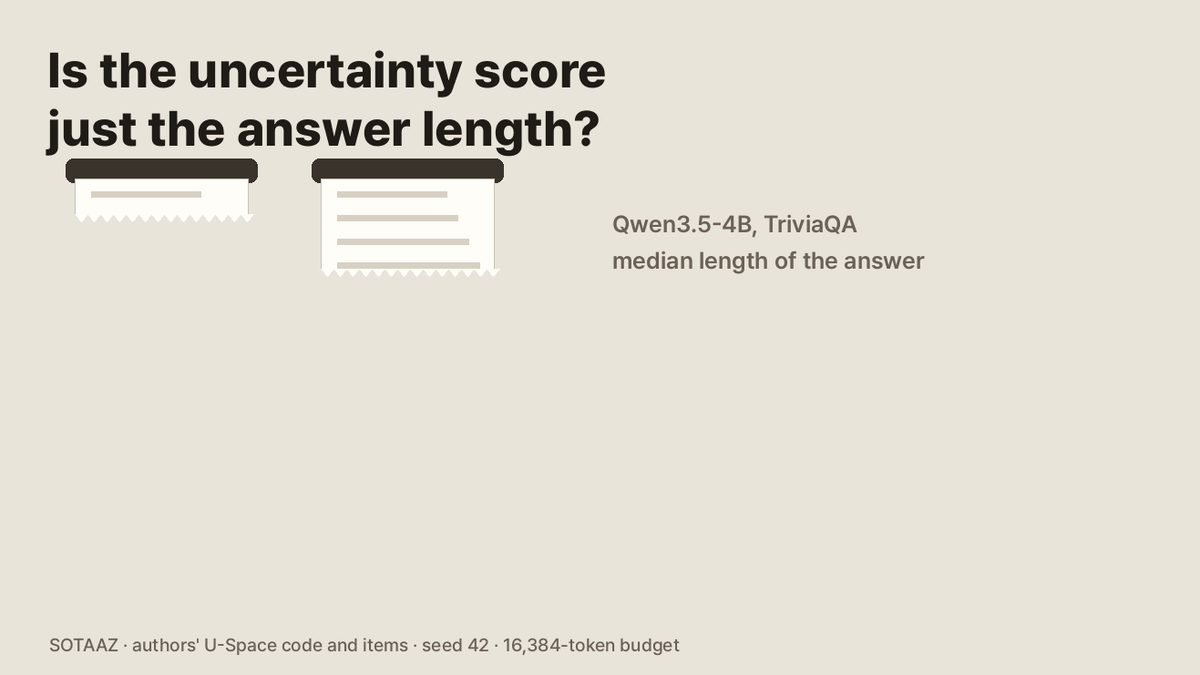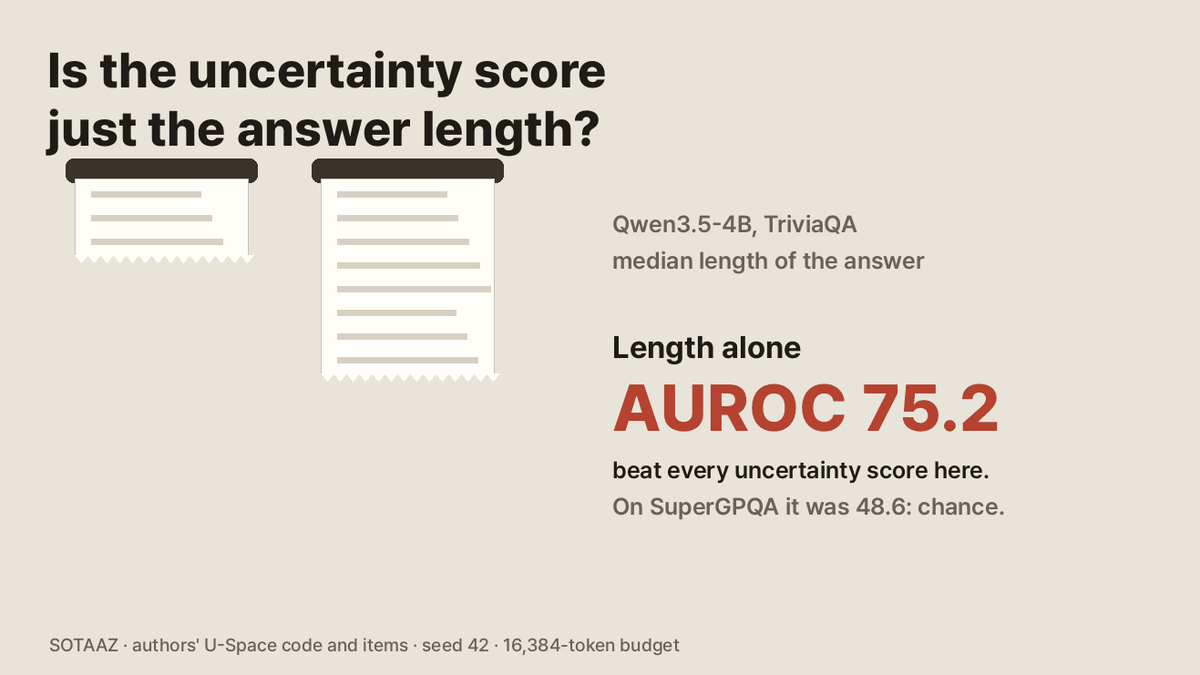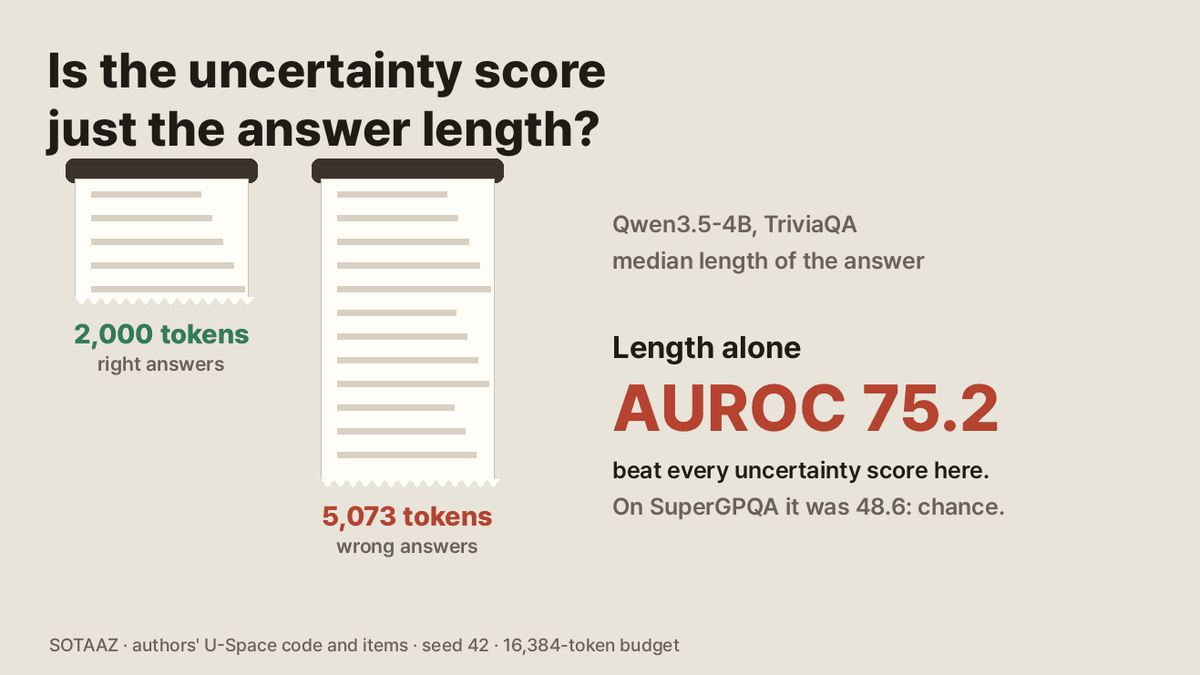
- TriviaQA 75.2: 틀린 답의 길이 중앙값이 5,073토큰, 맞은 답이 2,000토큰이었습니다. 이 벤치에서는 길이 하나가 U-Lens(71.5)를 포함한 모든 불확실성 점수보다 높았습니다.
- MMLU-Pro 72.0: 여기서도 틀린 답이 더 길었습니다(7,277 대 4,054토큰).
- SuperGPQA 48.6, 우연 수준: 맞은 답과 틀린 답의 길이가 거의 같았습니다(10,335 대 10,148토큰). 길이가 줄 정보가 없었습니다.
정리하면, "길이가 오답을 예측한다"는 말은 모델이 모르는 질문에서 장황해질 때는 맞고, 모든 질문에 길게 쓸 때는 맞지 않았습니다.
주 비교 세 개
| 비교(TriviaQA·MMLU-Pro·SuperGPQA 평균) | AUROC 차이 | 98.33% 구간 | 판정 |
|---|---|---|---|
| U-Lens − 길이만, 길이 통제 없음 | +4.4 | +1.0에서 +7.8 | U-Lens가 오답을 더 잘 갈랐다 |
| U-Lens − MSP, 길이 통제 | +8.4 | +3.8에서 +12.4 | U-Lens가 오답을 더 잘 갈랐다 |
| U-Lens − 평균 NLL, 길이 통제 | +1.1 | −0.5에서 +2.6 | 이 문항 수로는 차이를 말할 수 없다 |
이 판정은 세 벤치 평균 기준입니다. 앞에서 본 대로 TriviaQA 하나만 보면 길이(75.2)가 U-Lens(71.5)보다 높았습니다.
4B에서도 U-Lens는 길이만 쓴 점수와 MSP보다 오답을 더 잘 갈랐습니다. 논문과 같은 방향입니다. 달라진 것은 세 번째 비교입니다. 길이를 통제하자 U-Lens와 평균 NLL(모델이 낸 확률로 만드는 가장 단순한 점수)의 차이가 1점 남짓이었고, 구간이 0을 포함했습니다. 논문의 길이 통제 표에서는 세 모델 모두 U-Lens가 평균 NLL보다 높았고, 27B Qwen에서는 2.6 높았습니다. 4B에서는 그 차이를 확인하지 못했습니다. 시드 하나, 벤치 세 개, 그리고 위에서 말한 잘림까지 고려하면, 이것은 "여기서는 확인되지 않았다"이지 "틀렸다"가 아닙니다.
길이를 통제하자 MSP를 뺀 모든 점수가 떨어졌습니다. MSP는 처음부터 우연 수준에 가까웠습니다. 전체 표를 논문 평균과 나란히 싣습니다. 비교용이 아니라 참고용입니다.
| 방법 | 4B 원래 | 4B 길이 통제 | 변화 | 논문 원래(27-31B) | 논문 변화 |
|---|---|---|---|---|---|
| U-Lens | 69.7 | 66.8 | −2.9 | 71.1 | −1.8 |
| 예측 엔트로피 | 69.7 | 66.4 | −3.3 | 67.3 | −1.5 |
| 평균 NLL | 69.7 | 65.7 | −4.0 | 66.9 | −1.6 |
| 최대 엔트로피 | 69.1 | 64.9 | −4.2 | 67.7 | −5.0 |
| DeepConf | 67.4 | 64.9 | −2.4 | 67.8 | −1.8 |
| Self-Certainty | 66.7 | 64.9 | −1.7 | 66.9 | −4.4 |
| A_cone | 61.5 | 60.4 | −1.1 | Table 1에 없음 | |
| MSP | 55.8 | 58.4 | +2.6 | 53.3 | −0.8 |
| 길이만 | 65.3 | 56.6 | −8.7 | 68.6 | −16.2 |
(4B는 시드 하나, 벤치 세 개, 잘린 답 제외입니다. 논문은 모델 세 개, 벤치 네 개, 시드 세 개입니다. A_cone은 논문 Table 2에 모델별 길이 통제 값만 있습니다. 논문 표의 TokUR, Semantic Entropy, Feature-Gaps는 공개 코드에 없어서 돌리지 않았습니다.)
길이만 쓴 점수는 길이를 통제해도 50이 아니라 56.6이었습니다. 10개로 나눈 길이 구간 안에서도 긴 답이 조금 더 자주 틀렸다는 뜻입니다.
결정 모델에는 어떤 의미인가
저희가 최근 글에서 잰 AUROC는 Microsoft-Decision-1 같은 결정 모델의 것이었습니다. 결정 모델은 선택지 하나와 그 확률로 답하고, 답이 한 토큰이라 길이가 새어 들어갈 자리가 없습니다. 그래서 이번 글의 길이 문제는 그 숫자들에는 해당하지 않습니다. 모델이 글을 쓸 때, 특히 답하기 전에 생각을 길게 늘어놓을 때의 문제입니다.
이 결과가 말하는 것과 말하지 않는 것
- 말하는 것: 원저자 코드와 문항으로 Qwen3.5-4B를 돌리면, 답의 길이 하나가 TriviaQA와 MMLU-Pro에서는 오답을 잘 가려냈고 SuperGPQA에서는 전혀 가려내지 못했습니다. 세 벤치를 합치면 U-Lens는 길이만 쓴 점수와 MSP보다 오답을 더 잘 갈랐습니다.
- 말하지 않는 것: 4B에서 U-Lens가 평균 NLL보다 낫다는 것도, 낫지 않다는 것도 아닙니다. 여기서는 차이가 너무 작아 판정할 수 없었습니다.
- 끝까지 답하지 못한 질문은 다루지 않습니다. SuperGPQA에서는 답의 31%, Omni-MATH에서는 92.5%가 상한에 걸려 빠졌습니다. 답이 잘렸다는 사실 자체가 강한 경고 신호인데, 여기서 잰 점수들은 그것을 가려내도록 요구받지 않았습니다.
한계
- 모델 하나(Qwen3.5-4B), 시드 하나, 주 비교는 벤치 세 개입니다.
- 생성 상한 16,384토큰은 저장소의 작은 모델용 설정이고, 논문은 32,768-65,536토큰이었습니다. 상한을 늘리면 어려운 질문이 더 많이 채점되고 모든 숫자가 바뀔 수 있습니다.
- 논문의 ± 값은 모델 사이의 차이이고, 저희 숫자는 한 번 돌린 결과입니다.
- 코드는 고치지 않았습니다. 저장소의 의존성 목록에
accelerate가 빠져 있어 그것만 따로 설치했습니다.
계획서, 변경 기록, 저희 설정 파일과 비교 스크립트, 모든 점수 파일과 로그는 아래 재현 패키지에 있습니다. 모델이 쓴 생각 기록 전체(약 30MB)는 싣지 않았고, 코드로 다시 만들 수 있습니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
uncertainty-length-4b-repro.zip · 655 KB