EmbeddingGemma 2는 한국어 검색에서 1세대보다 나을까: 저희 글 177편으로 재 봤습니다
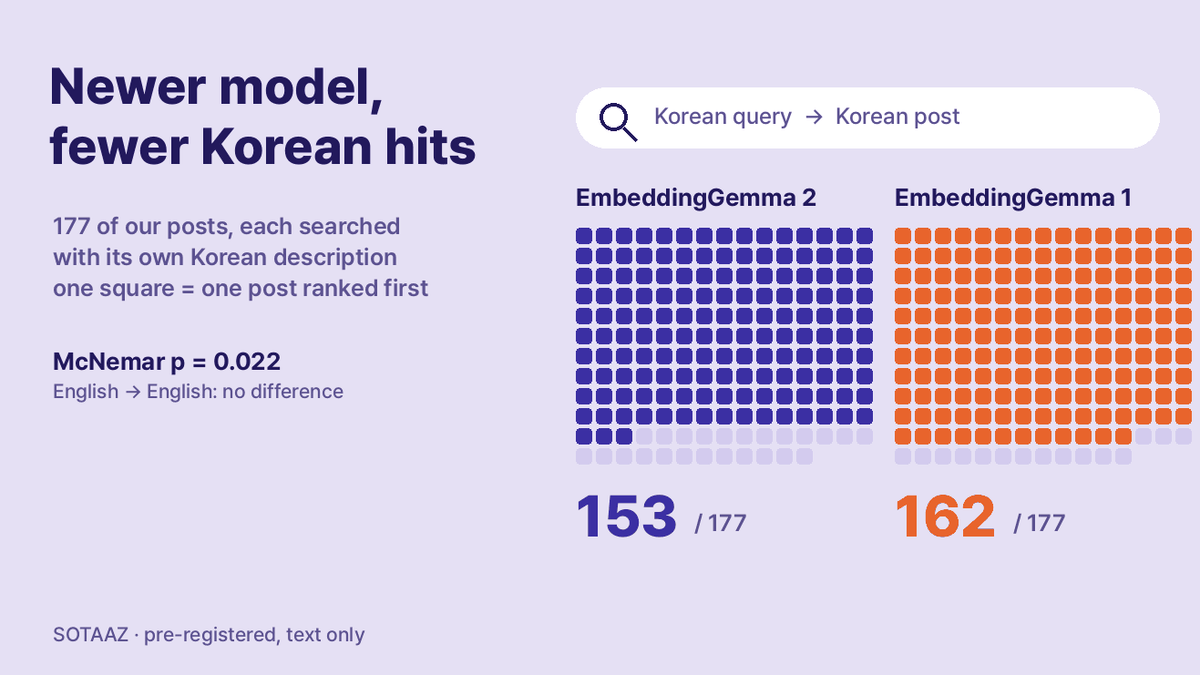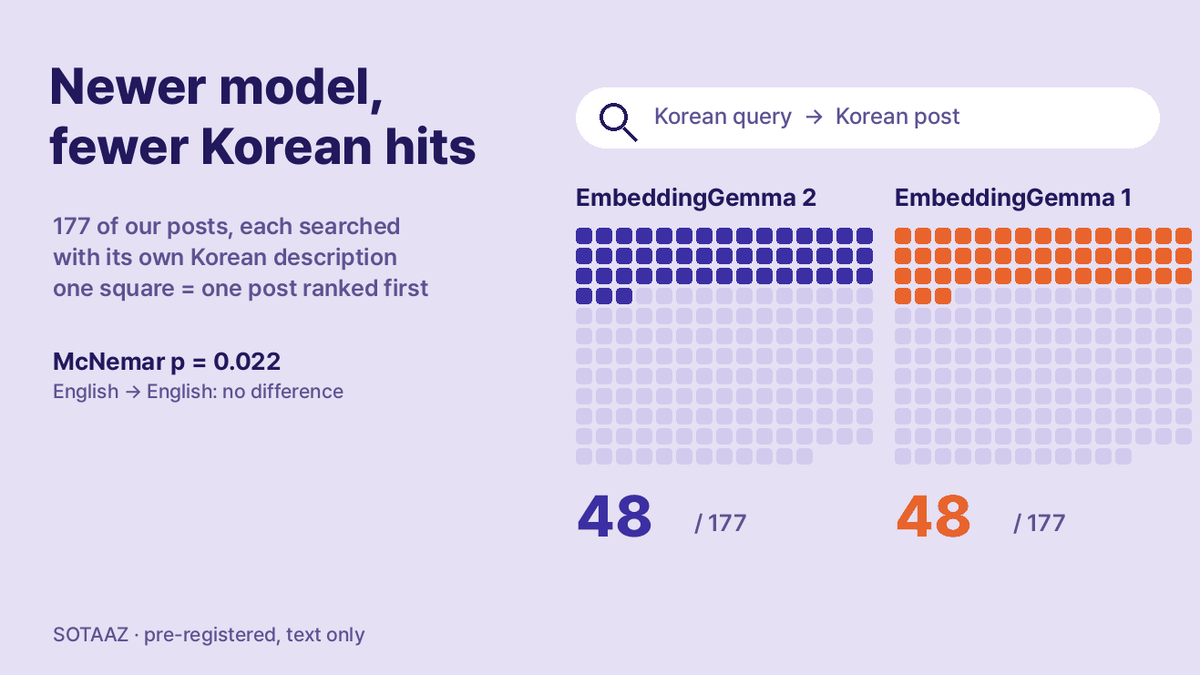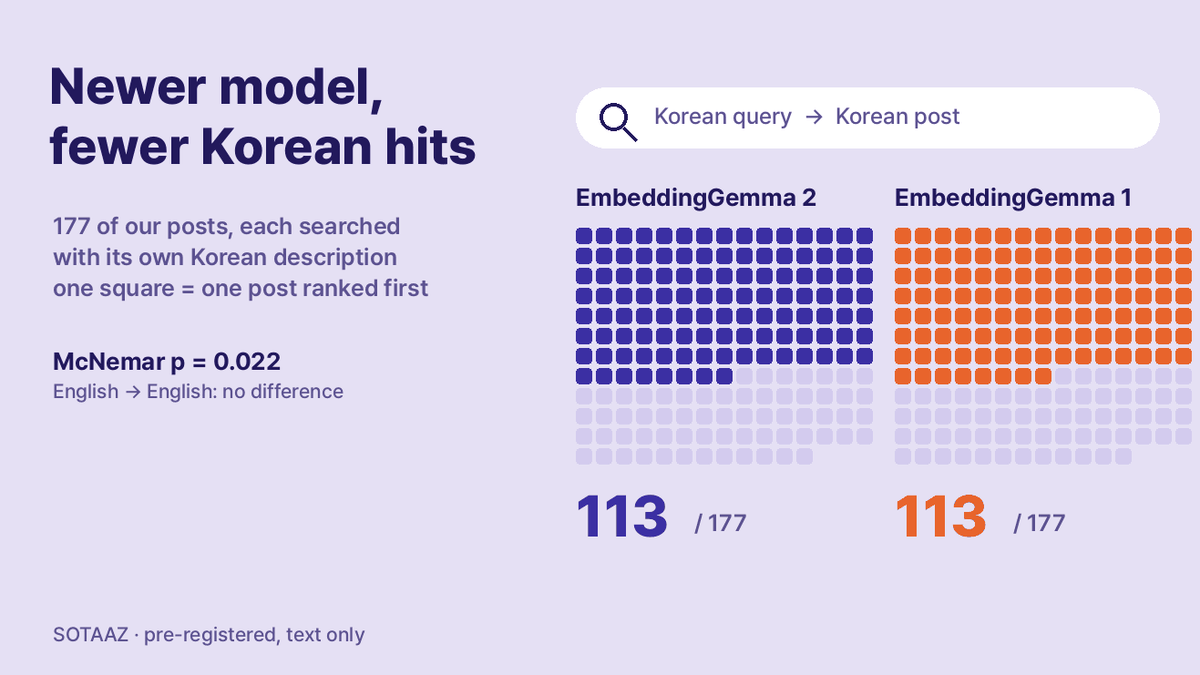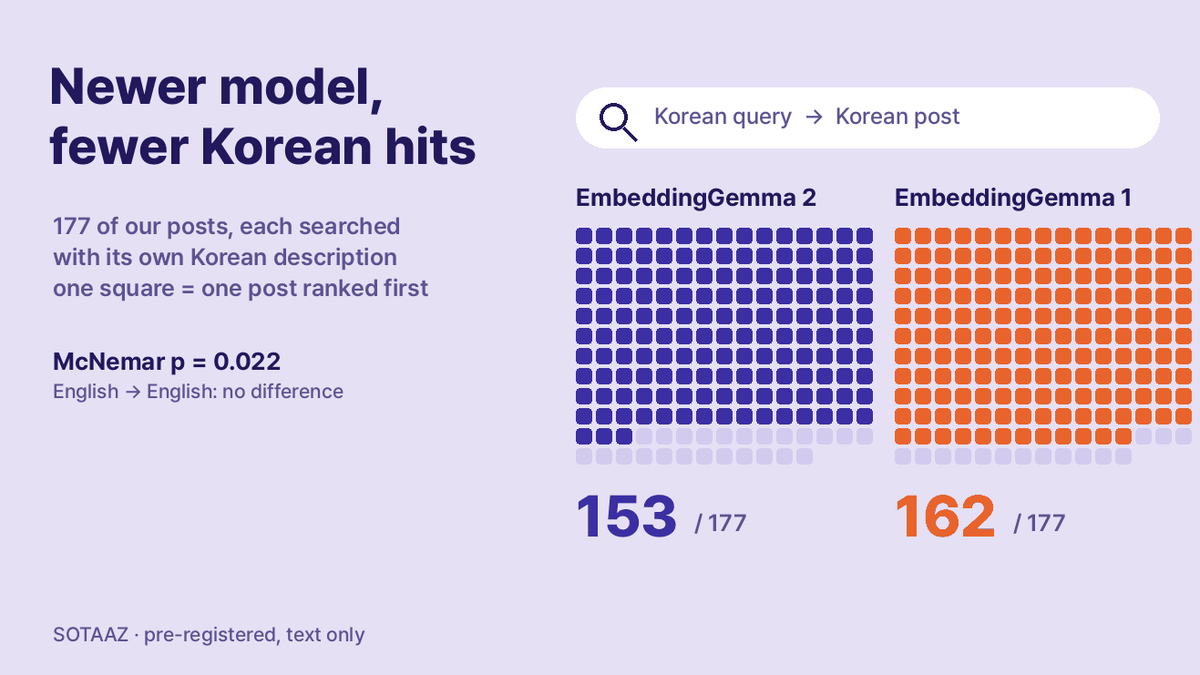
한/영으로 발행된 저희 블로그 글 177쌍에서 각 글의 설명문으로 검색해, 그 글을 1순위로 찾는지 쟀습니다. 한국어 질의에서는 EmbeddingGemma 1이 2보다 더 많이 맞혔습니다. 한국어 글을 찾을 때 162편 대 153편(p = 0.022), 영어판을 찾을 때 164편 대 155편(p = 0.035)입니다. 영어 질의로 영어 글을 찾을 때는 차이를 말할 수 없었습니다. 측정 전에 판정 기준을 커밋했고, 텍스트만 쟀습니다.
EmbeddingGemma 2는 한국어 검색에서 1세대보다 나을까: 저희 글 177편으로 재 봤습니다
구글 딥마인드가 10월에 EmbeddingGemma 2를 공개했습니다. 파라미터 740M에 Apache 2.0인 오픈 임베딩 모델입니다. 중심은 270M짜리 텍스트 모델이고, 비전과 오디오 인코더는 필요할 때만 따로 불러옵니다. 모델 카드에는 1세대와 비교한 텍스트 성적이 있습니다. 다국어 MTEB는 61.36 대 61.15, 코드 검색은 78.68 대 68.76입니다. 한국어만 따로 잰 숫자는 없습니다.
저희 블로그는 모든 글을 한국어와 영어로 냅니다. 그래서 한국어 검색을 재 볼 재료가 이미 있습니다. 글마다 검색 결과에 보이는 설명문이 하나씩 있으니, 그 설명문으로 검색했을 때 모델이 그 글을 1순위로 찾는지 보면 됩니다. 모델을 돌리기 전에 질문, 판정 기준, 결과별로 쓸 문장을 먼저 커밋했습니다.
어떻게 쟀나
- 말뭉치: 이 사이트에 한국어판과 영어판이 모두 발행된 글 177쌍입니다. 본문과 설명문은 CMS의 발행본에서 가져왔고, 제목 블록은 뺐습니다. 어떤 모델도 제목을 보지 않았습니다.
- 질의: 각 글의 설명문입니다. 정답은 그 설명문이 소개하는 글입니다.
- 과제 셋: 한국어 질의로 한국어 글 찾기(KK), 한국어 질의로 영어 글 찾기(KE), 참고용으로 영어 질의로 영어 글 찾기(EE). 과제마다 해당 언어의 글 177편 전체에서 찾습니다.
- 청크: 문단을 이어 붙여 1,000자 안쪽으로 자르고, 모든 모델에서 512토큰까지만 넣습니다. 글 점수는 그 글 청크 중 가장 높은 점수입니다.
- 모델: EmbeddingGemma 2(텍스트만), EmbeddingGemma 1(
embeddinggemma-300m), Qwen3-Embedding-0.6B, jina-embeddings-v5-omni-nano입니다. 질의와 문서 프롬프트는 각 모델 카드가 권하는 것을 그대로 썼습니다. 키워드 검색 BM25도 같이 돌렸습니다(한국어는 두 글자 단위, 영어는 단어 단위). 모든 모델을 float32로, 같은 환경(transformers 5.19.0, sentence-transformers 6.1.0)에서 돌렸습니다. - 판정: 주 비교는 EmbeddingGemma 2 대 1이고, KK와 KE에서 각각 봅니다. 정답 글을 1순위로 찾은 수(Recall@1)를 같은 질의끼리 짝지어 McNemar 정확 검정으로 비교했고, p < 0.05면 차이가 있다고 씁니다. MRR@10과 부트스트랩 10,000회 구간도 같이 적습니다.
설명문은 실제 사용자 질문보다 쉬운 질의입니다. 자기 글을 요약한 문장이라 본문과 단어가 많이 겹치기 때문입니다. 키워드 검색에 유리한 조건이고, 이 이점은 모든 모델에 똑같이 주어집니다.
결과: 한국어에서는 1세대가 더 많이 찾았습니다
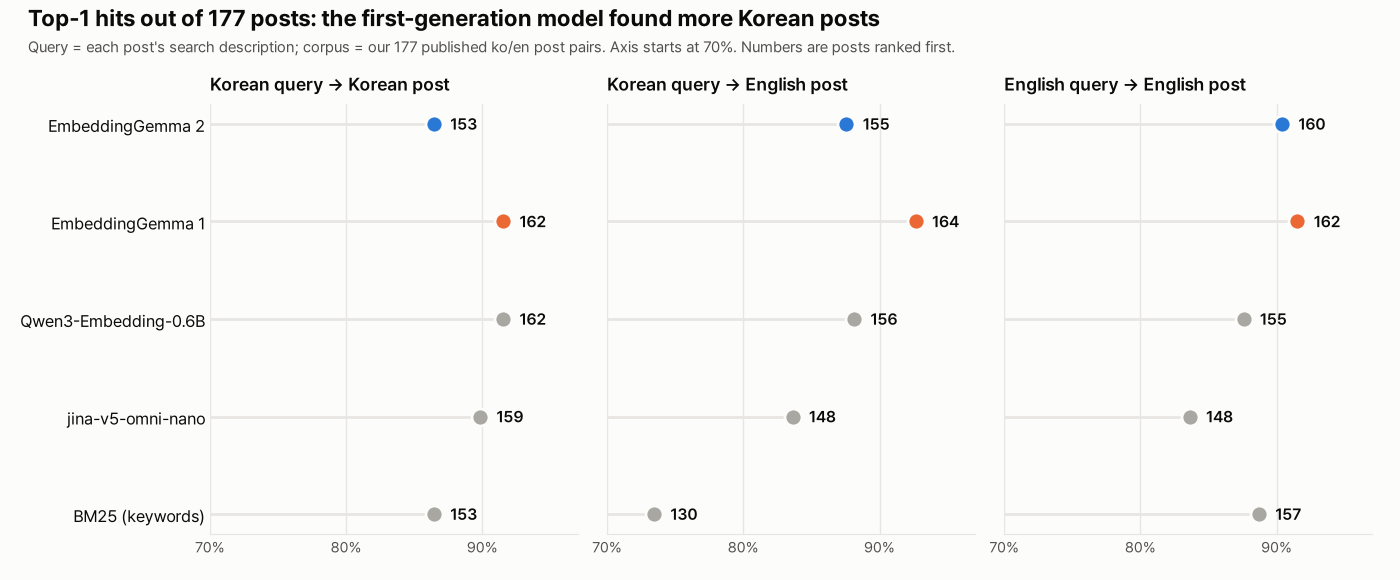
| 과제 | EmbeddingGemma 2 | EmbeddingGemma 1 | 2만 맞힘 | 1만 맞힘 | p |
|---|---|---|---|---|---|
| 한국어 → 한국어 | 153 / 177 | 162 / 177 | 2 | 11 | 0.022 |
| 한국어 → 영어 | 155 / 177 | 164 / 177 | 3 | 12 | 0.035 |
| 영어 → 영어 | 160 / 177 | 162 / 177 | 4 | 6 | 0.75 |
한국어 두 과제 모두에서 EmbeddingGemma 1이 정답 글을 1순위로 더 자주 찾았고, 두 차이 모두 검정을 통과했습니다. MRR@10도 같은 방향입니다. 2세대가 KK에서 0.027(구간 -0.049에서 -0.008), KE에서 0.028(-0.051에서 -0.006) 낮았습니다. 영어에서는 두 세대의 차이를 말할 수 없었습니다. 차이는 1순위 자리에서 납니다. 상위 5개 안에 정답 글이 들어간 수는 두 세대가 거의 같았습니다(한국어 → 한국어 175편 대 176편, 한국어 → 영어 둘 다 175편). 검색 결과 몇 개를 모델에 함께 넘기는 구조라면, 1순위 숫자만큼 차이가 크게 느껴지지는 않을 것입니다.
모델 카드는 한국어를 따로 주장하지 않았으니, 이 결과가 카드와 어긋나는 것은 아닙니다. 카드 숫자를 보면 2세대의 이득은 대부분 코드(68.76에서 78.68)에 있고, 다국어 텍스트는 거의 그대로(61.15에서 61.36)입니다. 저희 한국어 검색에서는 이전 모델이 앞섰습니다.
이 결과를 믿기 전에 세 가지를 확인했습니다.
- 프롬프트: EmbeddingGemma 2에는 카드에 적힌 그대로
task: search result | query:와title: none | text:가 들어갔습니다. - 텍스트 전용 로딩: 표본 45개(질의 5개, 청크 40개)에서 텍스트 인코더만 불러온 모델과 전체 모델의 임베딩이 완전히 같았습니다(최대 차이 0.0).
- 잘림: 두 세대는 토큰을 똑같이 나눕니다. 그래서 문서 프롬프트를 붙인 실제 입력 기준으로 한국어 청크 1,763개 중 같은 259개가 512토큰에서 잘렸습니다. 잘림 때문에 생긴 차이는 아닙니다.
다른 모델들
EmbeddingGemma 2와 비교해 검정을 통과한 차이는 셋뿐입니다.
- Qwen3-Embedding-0.6B는 한국어 → 한국어에서 더 높았습니다(162 대 153, p = 0.049). 판정 기준 0.05를 간신히 통과한 값이고, 같은 비교의 MRR@10 구간은 0을 포함합니다(-0.050에서 0.001). 한국어 청크가 Gemma보다 많이 잘렸는데도(1,763개 중 471개) 더 높았습니다.
- jina-v5-omni-nano는 영어 → 영어에서 더 낮았습니다(148 대 160, p = 0.012).
- BM25는 한국어 → 영어에서 더 낮았습니다(130 대 155, p = 0.0005). 한국어 질의와 영어 글은 겹치는 글자가 거의 없으니 예상한 결과입니다.
BM25는 한국어 → 한국어에서 EmbeddingGemma 2와 같았고(둘 다 153), 영어에서도 3편 차이였습니다. 임베딩이 약해서라기보다 저희 질의의 성격 때문입니다. 설명문이 본문 단어를 그대로 쓰니 키워드 검색이 거저 얻는 것이 많습니다. "임베딩은 쓸모없다"는 근거로 읽지 않으셨으면 합니다.
벡터를 줄이면
두 세대 모두 768개 숫자 중 앞의 512, 256, 128개만 남겨 쓸 수 있게 학습됐습니다. 측정 전에 허용폭을 정해 두었습니다. MRR@10이 떨어진 정도의 부트스트랩 구간이 0.03 아래에 있으면 "0.03 안쪽"이라고 씁니다.
| 768차원 대비 MRR@10 하락 | 한국어 → 한국어 | 한국어 → 영어 |
|---|---|---|
| EmbeddingGemma 2, 512 | 0.03 안쪽 | 0.03 안쪽 |
| EmbeddingGemma 2, 256 | 0.03 안쪽 | 말할 수 없음(0.012, -0.011에서 0.035) |
| EmbeddingGemma 2, 128 | 말할 수 없음(0.019, -0.007에서 0.045) | 0.03 넘게 하락(0.077, 0.043에서 0.112) |
| EmbeddingGemma 1, 512 | 0.03 안쪽 | 0.03 안쪽 |
| EmbeddingGemma 1, 256 | 말할 수 없음(0.017, -0.002에서 0.039) | 말할 수 없음(0.014, -0.003에서 0.033) |
| EmbeddingGemma 1, 128 | 말할 수 없음(0.027, 0.002에서 0.053) | 말할 수 없음(0.019, -0.006에서 0.044) |
모델 카드의 표에서도 128차원은 떨어집니다. 다국어 MTEB가 768차원 61.36에서 128차원 57.89가 됩니다. 저희 한국어 → 영어에서 EmbeddingGemma 2가 128차원에서 떨어진 것도 같은 방향이고, 이 과제에서는 그 폭이 허용폭을 넘었습니다. 같은 과제에서 EmbeddingGemma 1의 128차원 하락폭은 0.019로, EmbeddingGemma 2의 0.077보다 작았습니다. 128차원으로 줄여도 한국어 질의 159개에서 영어판을 1순위로 찾아, 768차원 EmbeddingGemma 2(155개)보다 많았습니다. 다만 이 두 비교는 사전 등록하지도 검정하지도 않았으니 관찰로만 읽어 주세요.
그래서 무엇을 고를까
이미 한국어 텍스트 검색에 EmbeddingGemma 1을 쓰고 있다면, 이 실험에서는 한국어 때문에 바꿀 이유를 찾지 못했습니다. 2세대로 옮길 이유는 이미지, 오디오, 영상, 코드 쪽에 있고, 저희는 그쪽을 재지 않았습니다. 작은 한국어 임베딩 모델을 처음 고른다면 과제별로 나눠 보셔야 합니다. 한국어 → 한국어에서는 EmbeddingGemma 1과 Qwen3-Embedding-0.6B가 162편으로 가장 많이 찾았습니다. 한국어 → 영어에서는 EmbeddingGemma 1만 앞섰고(164편), Qwen3-Embedding-0.6B(156편)는 EmbeddingGemma 2(155편)와 차이가 없었습니다(p = 1.0). EmbeddingGemma 1과 Qwen을 직접 검정하지는 않았습니다.
가장 싸게 해 볼 수 있는 방법은 저희가 한 그대로입니다. 이미 가진 문서로, 항목마다 정답을 아는 평가 세트를 만드는 것입니다. 채점 방법은 RAG 평가 글에서 더 자세히 다룹니다.
측정 범위와 한계
- 한/영 글 177쌍과 설명문 질의 한 종류입니다. 대부분 AI 모델과 도구를 다루고, 12쌍은 SQL과 데이터 분석 글입니다. 실제 질문은 더 짧고, 정답 문서와 겹치는 단어도 더 적습니다.
- 한국어가 영어보다 512토큰 잘림의 손해를 더 봤습니다. 문서 프롬프트를 붙인 기준으로 두 Gemma 모델에서 한국어 청크 1,763개 중 259개가 잘렸고, 영어 청크는 2,425개 중 11개였습니다. Qwen3-Embedding-0.6B는 한국어 청크 471개가 잘렸습니다.
- 질의 177개로는 작은 차이를 잡지 못합니다. 주 비교 밖의 비교는 대부분 "말할 수 없다"로 나왔습니다.
- 공개된 글이라 어느 모델이든 학습 중에 봤을 수 있습니다. 그게 특정 모델에만 유리하다고 볼 근거는 없습니다.
- 텍스트만 쟀습니다. EmbeddingGemma 2가 새로 더한 이미지, 오디오, 영상에 대해서는 이 실험이 아무것도 말하지 않습니다.
- jina-v5-omni-nano는 CC-BY-NC-4.0입니다. 측정만 했고 배포하지 않았습니다. 이 모델의 로더는
http로 시작하는 문자열을 미디어 링크로 보기 때문에, 실행 스크립트에서 모든 문자열을 텍스트로 처리하게 고정했습니다. 보통 텍스트 청크 40개 표본에서는 임베딩이 원래와 완전히 같았습니다(최대 차이 0.0).
자료는 모두 drafts/ko-embed-bench/에 있습니다. 모델을 돌리기 전에 커밋한 사전 등록 문서, 실행 스크립트, 질의별 점수, 집계 스크립트가 있습니다. 위 세 가지 확인을 다시 돌리는 verify_checks.py와 그 출력 checks.json, 실행 경위를 적은 RUNS.md도 있습니다. 사전 등록 문서의 변경 기록에는 세 가지를 남겼고, 모두 해당 실행 전에 고친 것입니다. 둘은 말뭉치를 만드는 방식으로 모델을 돌리기 전에, 하나는 실행 스크립트로 jina 모델을 돌리기 전에 고쳤습니다. 다음 측정 글은 뉴스레터로 먼저 알려 드립니다.