2비트 모델은 맞히는 법은 기억하고 확신하는 법은 잊는다
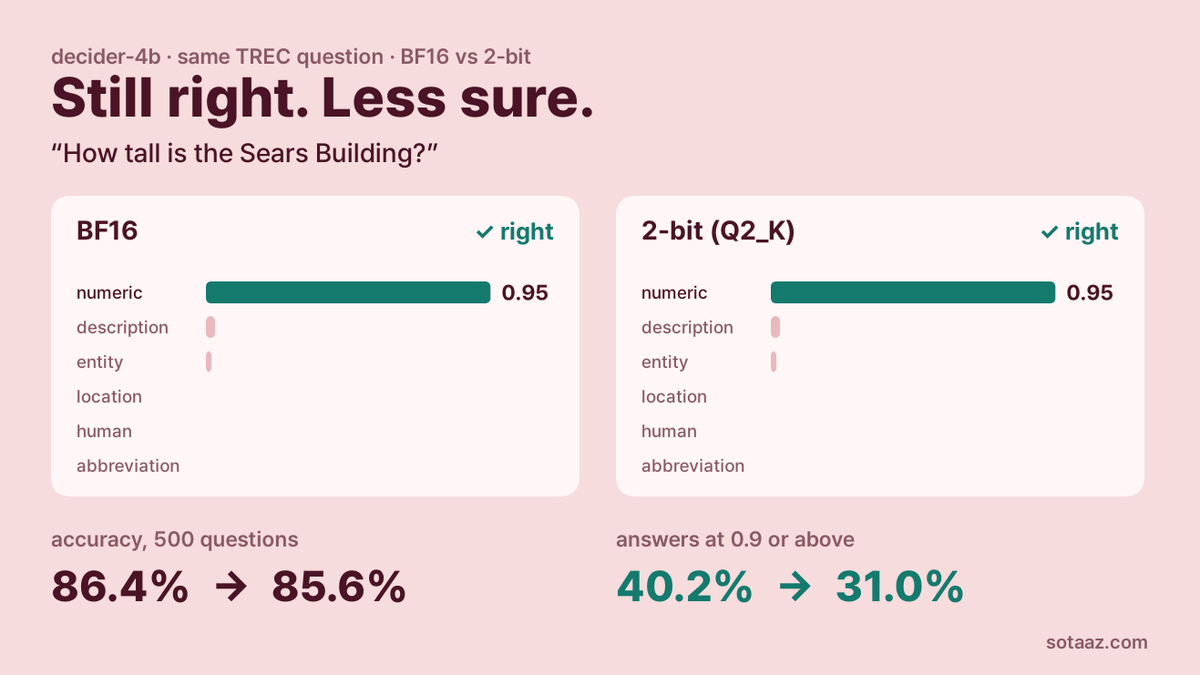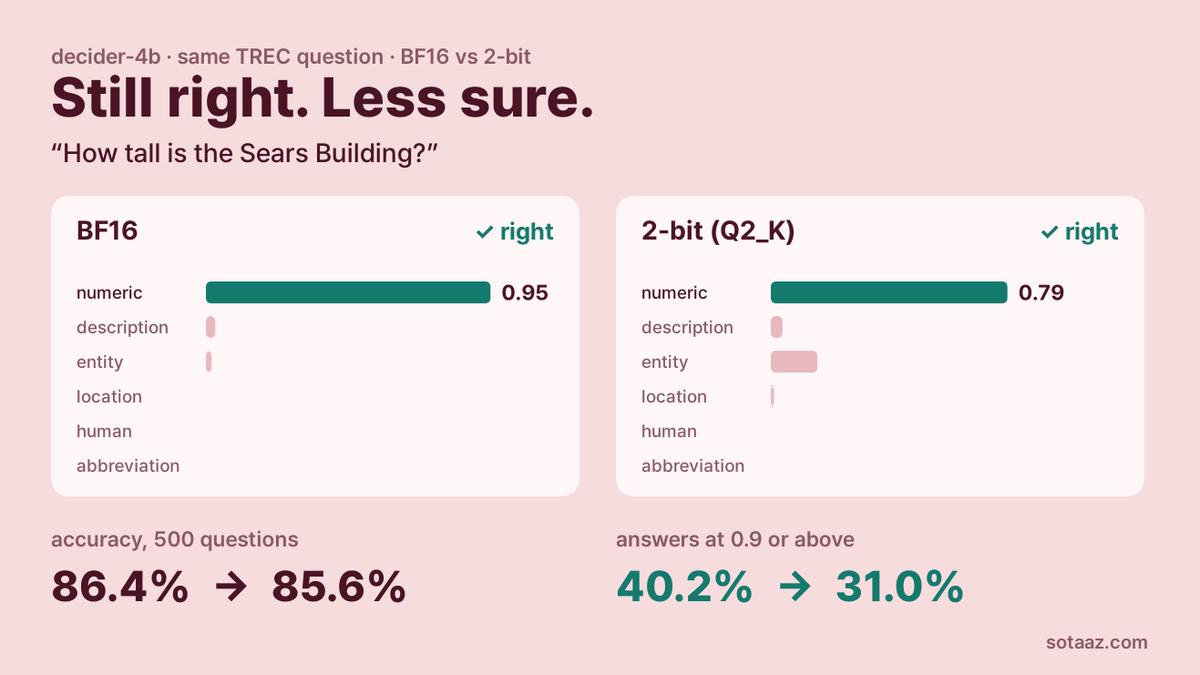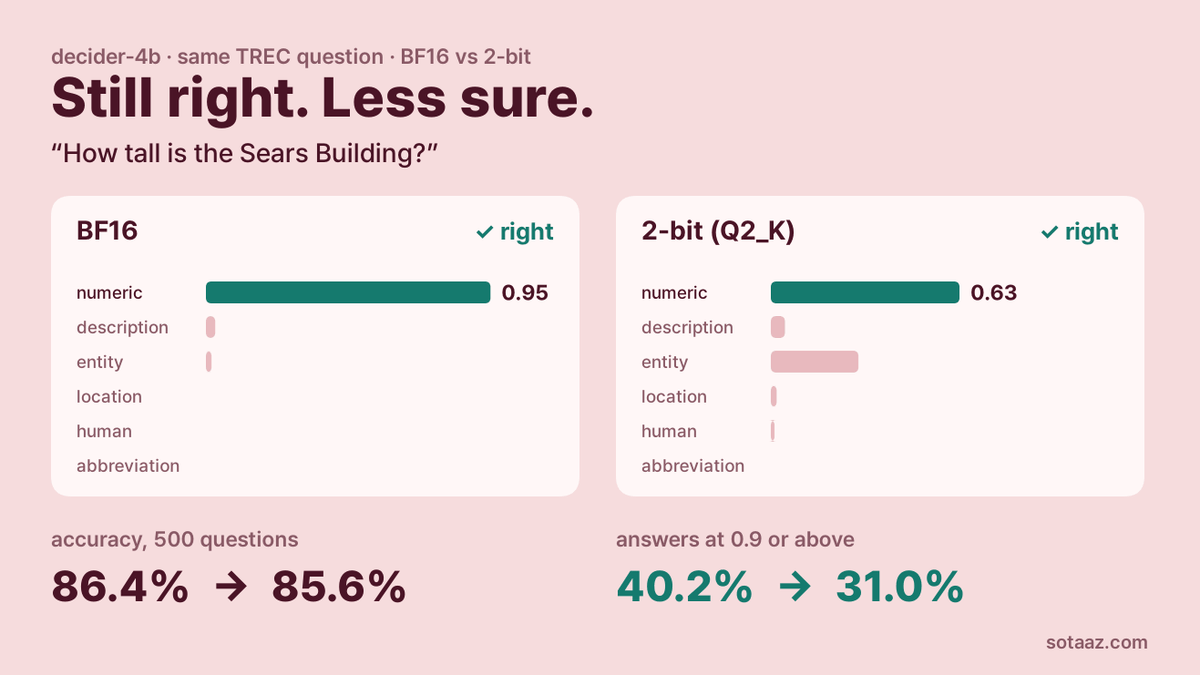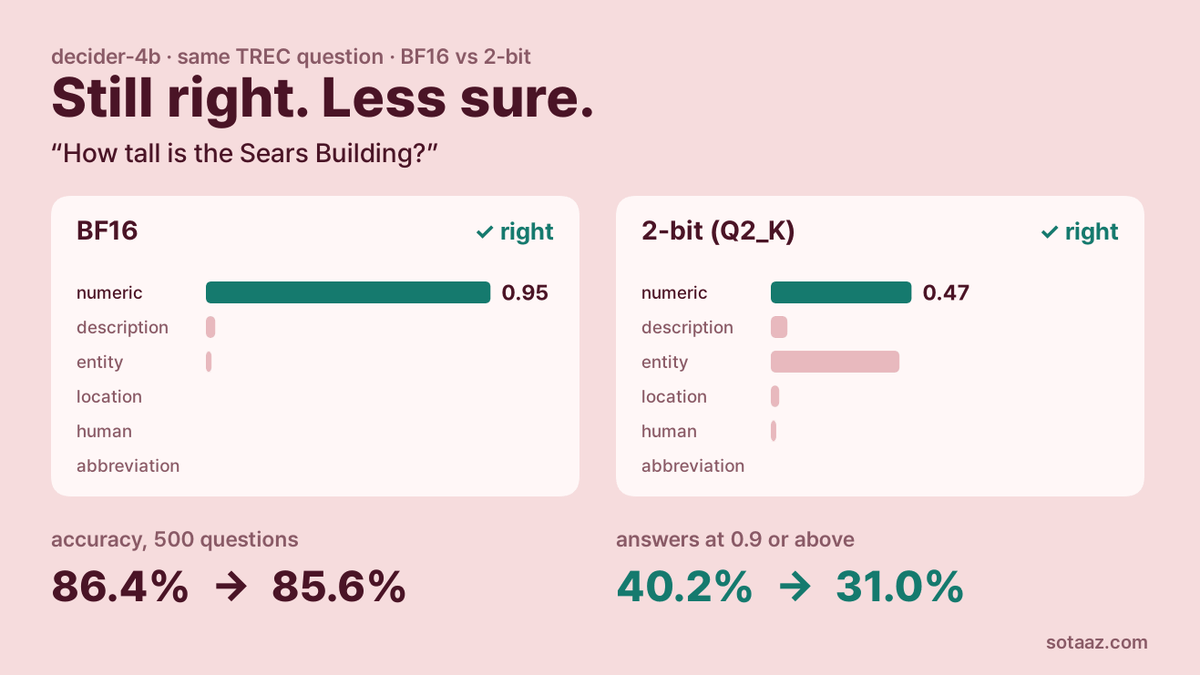
decider-4b를 2-3비트로 깎으니 정확도는 지켰지만(86.4%에서 85.6%) 단호함을 잃었고, 그 오차는 미세조정 전 기반 모델 쪽을 향했습니다(Q2_K 파일 코사인 0.29, 무작위 방향은 약 0.02). 같은 크기의 무작위 잡음도 다섯 시드 모두 단호함을 같거나 더 크게 깎았지만, 그런 방향은 없었고(−0.04에서 0.07) 정확도는 81.6-89.6%로 흩어졌습니다. 잡음은 모델을 정확도 13-32%까지 망가뜨릴 만큼 커야 비로소 그만큼 기울었습니다. temperature 하나를 다시 맞추면 확률은 대부분 돌아옵니다.
2비트 모델은 맞히는 법은 기억하고 확신하는 법은 잊는다
이 글은 저희가 거꾸로 짚은 예측에서 시작합니다.
저희는 결정 모델의 확률을 숫자 하나, temperature로 정직하게 만들 수 있는지 보고 있었습니다. decider-4b 같은 결정 모델은 글을 쓰지 않고, 주어진 선택지마다 확률을 돌려줍니다. temperature가 1보다 작으면 확률이 뾰족해지고, 1보다 크면 평평해집니다. 계산 전에 저희는 이렇게 적었습니다. 비트를 덜 남길수록 모델은 과신합니다.
TREC 질문 500개, 정상 라벨에서 가장 잘 맞는 temperature는 반대로 갔습니다. 비트를 깎을 때마다 내려갔습니다. BF16과 Q8_0이 0.80, Q4_K_M이 0.77, Q3_K_M이 0.69, Q2_K가 0.68입니다. 1보다 작다는 것은 모델의 confidence가 실제 정답률보다 낮았다는 뜻입니다. 정확도는 거의 그대로였습니다(BF16 86.4%, Q2_K 85.6%). 단서는 저희 앞 글에 이미 있었습니다. 0.9 이상으로 답한 비율이 Q3_K_M에서 40.2%에서 23.2%로 줄었습니다. 그 숫자를 갖고 있으면서도 "반올림 오차가 쌓이면 모델이 대담해진다"는 직관으로 예측을 적었습니다.
그래서 이유를 찾기로 했고, 측정할 때마다 맞음·틀림 기준을 붙인 예측을 먼저 적었습니다. 찾은 것부터 말씀드리고, 거기까지 간 과정을 뒤에 적겠습니다.
찾은 것
decider-4b는 Qwen3.5-4B-Base에 미세조정을 더한 모델입니다. 이 500문항에서 미세조정은 정확도를 82.0%에서 86.4%로 올렸고, 모델을 더 단호하게 만들었습니다. 1등 선택지가 2등보다 얼마나 앞서는지(두 선택지의 원점수 차이)의 중앙값이 2.21에서 2.47로 커졌습니다.
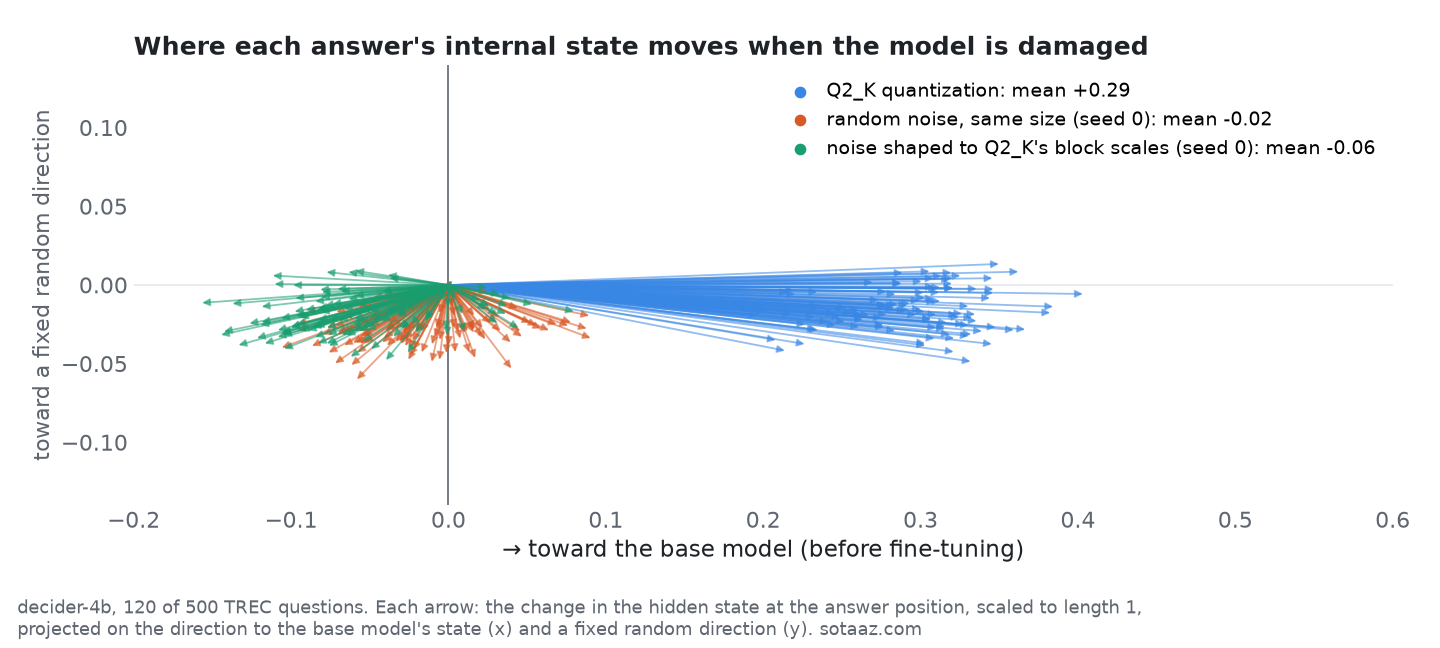
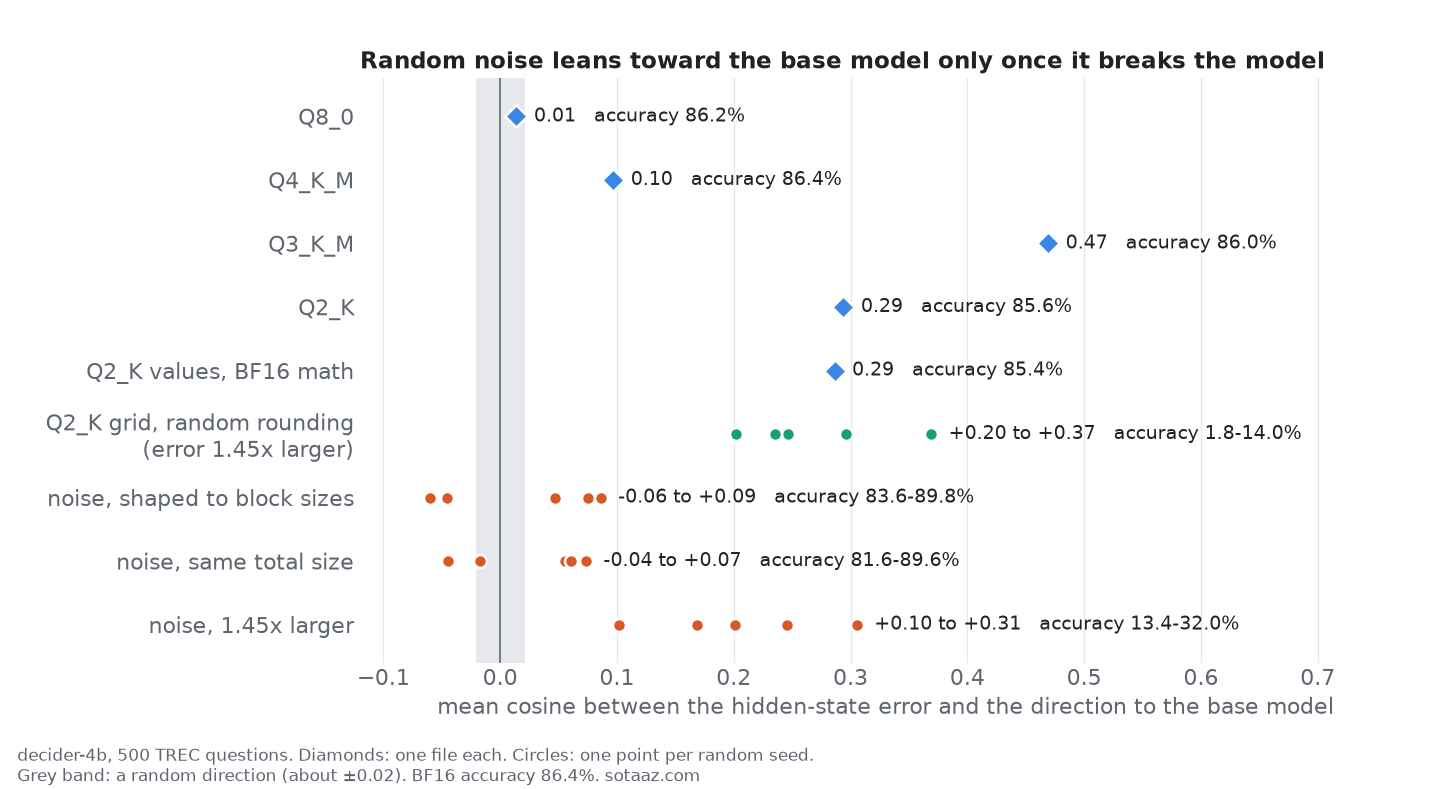
2비트 decider-4b는 정확도는 대부분 지켰고(85.6%), 단호함은 잃었습니다(1등 우위 중앙값 2.21). 이 값이 기반 모델과 딱 맞은 것은 우연일 가능성이 큽니다. Q3_K_M은 기반 모델보다 더 내려갔고(2.11), 무작위 잡음은 그보다도 더 내려갔기 때문입니다. 단단한 근거는 수준이 아니라 방향입니다. 질문마다 답 자리의 모델 내부 상태를 저장해 BF16과 비교했습니다. 2비트 몸통이 만든 오차는 기반 모델의 내부 상태가 있을 자리 쪽을 향했습니다. 코사인 평균이 0.29이고, 무작위 방향은 약 0.02입니다. Q3_K_M에서는 0.47이었습니다. 다만 이 기울기는 오차의 일부입니다. Q2_K 오차 크기의 약 30%가 기반 쪽 성분이고, 나머지 대부분은 정해진 방향이 없는 흔들림입니다.
답에서도 같은 쏠림이 보입니다.
| "설명"으로 답한 수 | "개체"로 답한 수 | |
|---|---|---|
| 실제 정답 | 138 | 94 |
| BF16 decider-4b | 114 | 134 |
| 2비트 decider-4b(Q2_K) | 165 | 96 |
| 기반 모델(미세조정 전) | 212 | 58 |
2비트 decider-4b는 BF16과 기반 모델 사이로 움직였습니다. Q8_0, Q4_K_M, Q3_K_M은 BF16과 몇 개 차이였습니다. 2비트에서 BF16과 답이 달라진 문항은 66개이고, 그중 44개는 기반 모델의 답과 같아졌습니다. 정확도가 거의 그대로인 이유도 여기서 보입니다. 바뀐 66개 중 맞던 답이 틀리게 된 것이 32개, 틀리던 답이 맞게 된 것이 28개였습니다. 가장 큰 이동인 "개체"에서 "설명"으로 바뀐 41개만 봐도, 21개는 정답이 "설명"이라 맞게 옮겼고 15개는 정답이 "개체"라 틀리게 옮겼습니다. 정답 쪽이 아니라 기반 모델 쪽으로 옮겨 갔기 때문에, 맞히고 틀리는 것이 서로 상쇄됐습니다.
한 문장으로 줄이면 이렇습니다. 2비트 양자화는 맞히는 법은 남기고 단호함을 깎는데, 그 깎이는 방향이 미세조정 전 모델 쪽입니다.
왜 하필 미세조정 쪽일까
여기에 이상한 점이 있습니다. 모델은 어떤 가중치가 사전학습에서 왔고 어떤 것이 미세조정에서 왔는지 모릅니다. 미세조정은 이미 있는 숫자들을 조금씩 바꿨을 뿐이고, 양자화가 보는 것도 그 결과인 숫자뿐입니다. 그런데 양자화는 마치 나중에 배운 것부터 잊는 것처럼 보입니다. 이 글은 이 질문을 따라갑니다.
아무 잡음이나 그렇지는 않습니다
바로 떠오르는 반론이 있습니다. 이 정도 크기로 망가뜨리면 무엇이든 똑같지 않을까? 그래서 BF16 모델에서 Q2_K가 양자화하는 몸통 텐서마다, 그 텐서의 Q2_K 오차와 전체 크기가 정확히 같은 가우시안 잡음을 더했습니다. 공유 임베딩 표는 BF16 그대로 두어 아래의 "몸통만 2비트" 판과 맞췄고, 시드는 다섯 개로 돌렸습니다.
| 몸통 2비트·표 BF16 판(저희가 나눈 판) | 같은 크기 무작위 잡음, 시드 5개 | |
|---|---|---|
| 가장 잘 맞는 temperature | 0.70 | 0.42-0.70 |
| 1등 우위 중앙값(BF16 2.47) | 2.19 | 1.40-1.85 |
| 정확도(BF16 86.4%) | 85.6% | 81.6-89.6% |
| 오차의 기반 모델 방향 코사인 | 0.30 | −0.04에서 0.07 |
잡음도 모델을 덜 단호하게 만들었습니다. 다섯 시드 모두 2비트와 같거나 더 크게 깎았습니다. 그러니 confidence가 낮아지는 것 자체는 양자화만의 일이 아닙니다. 하지만 잡음은 기반 모델 쪽으로 기울지 않았고, 정확도는 81.6%부터 89.6%까지 흩어졌습니다. 한 시드는 BF16보다 높았습니다. 500문항이면 정확도의 표준오차가 1.5%p 안팎이라, 이 흩어짐은 "잡음이 정확도를 예측할 수 없게 움직였다"로 읽어야 합니다. "잡음이 망가뜨렸다"나 "잡음이 도왔다"로 읽으면 안 됩니다. 2비트 파일은 시드가 없는 결정적 결과 하나라서, 그 안정성을 잡음의 분포와 견주지는 않습니다. 말할 수 있는 것은 이 정도입니다. 같은 크기에서 2비트 파일의 정확도는 BF16에서 1%p 안이었고, 잡음 다섯 시드 중 셋은 3%p 넘게 벗어났습니다(89.6%, 82.6%, 81.6%).
잡음의 모양을 양자화에 더 가깝게 맞춰 보기도 했습니다. 양자화 오차는 블록마다 크기가 다릅니다. 블록 안 가중치가 크면 오차도 큽니다. 그래서 가중치 16개 단위마다 실제 Q2_K 오차의 크기를 재고, 그 크기에 맞춘 무작위 잡음을 넣은 판을 시드 다섯 개로 만들었습니다. 결과는 같았습니다. temperature는 0.46-0.68로 낮아졌지만, 기반 모델 방향 코사인은 −0.06에서 0.09(중앙값 0.05)였습니다. 회귀 계수는 −0.027에서 0.024였습니다. 회귀 계수는 은닉 상태가 BF16에서 기반 모델 쪽으로, 두 상태 사이 거리의 몇 분의 몇만큼 갔는지를 뜻합니다(질문별 중앙값). 기반 모델의 상태는 꽤 멀리 있어서(BF16 상태 크기의 1.6배) 코사인이 0.3이어도 계수는 0.07 안팎입니다. 같은 기준으로 몸통 2비트 판은 0.077이었습니다.
양자화에는 있고 잡음에는 없는 것은 방향입니다. 크기와 그 블록 구조까지 맞춰도 방향은 생기지 않았습니다.
두 가지를 더 확인했습니다. 먼저 llama.cpp의 k-quant 행렬곱은 계산 도중 활성값도 8비트로 줄이는데, 잡음판에는 이 과정이 없습니다. 그래서 Q2_K 파일의 값을 그대로 BF16으로 풀어 쓴 판을 만들어 BF16 계산으로 돌렸습니다. 결과는 Q2_K 파일과 같았습니다(기반 방향 코사인 0.29, temperature 0.70, 정확도 85.4%). 원인은 계산 방식이 아니라 값에 있습니다. Q8_0 파일의 기반 방향 코사인은 0.01로 무작위 수준이었습니다.
다음으로 잡음을 더 크게 넣어 봤습니다. Q2_K 오차의 1.45배 크기 잡음입니다(이 크기가 나온 이유는 아래 "남은 질문"에 적었습니다). 이번에는 잡음도 기반 쪽으로 기울었습니다. 다섯 시드의 코사인이 0.10-0.31이었습니다. 다만 그때 모델은 이미 망가져 있었습니다. 정확도가 13.4-32.0%였습니다. 기반 모델 쪽은 모델이 크게 망가질 때 끌려가는 방향이기도 한 셈입니다. 그런데 2비트 양자화는 정확도를 85%로 지킨 채, 같은 크기의 잡음으로는 생기지 않는 기울기(0.29)를 냈습니다.
거기까지 간 과정
이 발견에 닿기까지 원인을 세 번 추측했습니다. 추측마다 맞음·틀림 기준을 붙인 예측을 시각과 함께 먼저 커밋하고 쟀습니다. 2차부터는 앞 결과를 본 뒤 설계했습니다.
모델에 대해 알아 둘 사실이 두 가지 있습니다. decider-4b에는 출력 헤드가 따로 없습니다. 입력에서 토큰을 벡터로 바꾸는 표(token_embd)를 출력에서도 다시 쓰고, 답 자리의 은닉 상태를 이 표의 선택지 글자 행에 곱해 답을 읽습니다. 그리고 llama.cpp의 기본 Q4_K_M, Q3_K_M, Q2_K 파일은 모두 이 표를 6비트로 남깁니다. 2-3비트로 깎이는 것은 몸통입니다. Q2_K 파일에서 텐서 176개가 Q2_K, 40개가 Q3_K, 32개가 Q4_K입니다. 앞의 잡음판들도 이 248개 텐서 전부에 넣었습니다. 모든 실행은 decider-ai 1.6.0과 llama-cpp-python, 같은 500문항, decider에 들어 있는 temperature 1.11로 했고, 비교하는 점수는 그 temperature를 적용하기 전 값입니다.
1차: 헤드인가 몸통인가. 몸통과 표를 나눠 깎은 판을 만들었습니다. 몸통만 2비트이고 표는 BF16인 판은 temperature 0.70으로 Q2_K(0.68)와 같았고, 몸통은 BF16이고 표만 6비트인 판은 0.80으로 BF16과 같았습니다. 원인은 몸통에 있습니다. 1등 우위 중앙값은 Q2_K에서 2.468에서 2.205로 10.7% 좁아졌습니다. 함께 세운 설명, 즉 양자화가 큰 가중치를 눌러 담느라 줄인다는 설명은 틀렸습니다. 크기 상위 0.1% 가중치는 원래 크기의 평균 99.0%를 지켰습니다(텐서별 95.7-100.3%). 몸통은 BF16이고 표만 2비트로 깎은 판은 오히려 1에 가까워졌습니다(T 0.91). 다만 이 표는 입력 임베딩도 겸하므로, 이 판은 읽는 방식과 답하는 방식이 함께 바뀐 판이라 무엇이 temperature를 움직였는지는 가를 수 없습니다.
2차: 신호가 묽어지는가. 층마다 생긴 작은 오차를 마지막 정규화가 일정한 크기로 다시 맞추면 원래 "정답 방향"의 몫이 줄어들 수 있습니다. 답 자리 은닉 상태를 저장했고, 이 벡터에 표의 선택지 행을 곱하면 기록된 점수가 0.11 안쪽 차이로 다시 나와 제대로 된 벡터임을 확인했습니다. 크기가 유지된다는 예측은 틀렸습니다. 오히려 커졌습니다(Q2_K 1.09배). 그래서 Q2_K 상태를 BF16 상태 방향 성분과 그에 수직인 성분으로 나눴습니다(탐색). 500문항 평균으로 BF16 1등의 2등 대비 우위는 2.518이고, BF16 방향 성분이 만든 우위는 2.561로 오히려 1.7% 컸습니다. 여기에 수직 성분이 −0.403을 더해 합이 Q2_K에서 같은 두 선택지 사이 간격의 평균 2.158과 정확히 맞습니다. 묽어진 것은 없고, 우위를 깎은 것은 수직 성분입니다. 이 성분은 무작위가 아니었습니다. 1등 점수에서 나머지 다섯 선택지 점수의 평균을 뺀 값을 0.78 낮췄고, BF16에서 우위가 컸던 질문일수록 더 많이 깎았습니다(상관 −0.35).
3차: 양자화가 미세조정을 되돌리는가. 미세조정이 바꾼 몫은 가중치 크기의 3.8%이고, Q2_K 오차는 30%입니다. 거친 격자에서는 작은 변화가 있든 없든 같은 칸으로 반올림될 테니 오차 안에 미세조정이 거꾸로 들어 있을 거라고 추론했는데, 가중치 단위로는 틀렸습니다. 오차와 "미세조정을 되돌리는 방향"의 코사인은 −0.005였고, 지워진 몫은 −5.8%로 오히려 아주 조금 더한 쪽이었습니다. 반올림 오차는 가중치가 격자 칸 안 어디에 있든 고르게 퍼지기 때문입니다. 반면 모델 전체로는 맞았습니다. 은닉 상태 오차는 기반 모델 쪽을 향했고(코사인 0.29), 기반 모델은 실제로 덜 단호했습니다(1등 우위 중앙값 2.21 대 2.47). 기반 모델은 decider의 답 형식을 학습한 적이 없으므로 이 방식으로 읽은 것은 저희가 고른 비교 방법입니다. 그래도 82.0%를 맞혔습니다. 같은 기반에서 미세조정한 지시형 Qwen3.5-4B 방향을 함께 회귀해도(두 방향은 코사인 0.82로 많이 겹칩니다) Q2_K 파일의 기반 방향 계수는 0.075로 남고(기반 방향 하나만 넣으면 0.069) 지시형 방향은 −0.007이었습니다.
마지막 확인: "기반 쪽"이 "무너지는 쪽"과 같은가. 크게 망가진 판들은 거의 한 클래스로만 답했습니다. 확률적 반올림 시드 다섯 개 중 넷이 "약어"를 70-99.6% 골랐는데, 정답 중 약어는 9문항(1.8%)뿐입니다. 큰 잡음 판들도 시드마다 다른 한 클래스로 쏠렸습니다. 그렇다면 "기반 모델 방향"이 "한 클래스로 무너지는 방향"과 겹칠 수 있습니다. 그래서 확률적 반올림 다섯 시드 오차의 평균을 붕괴 방향으로 두고, Q2_K 오차를 두 방향에 함께 회귀했습니다(유지·수정 기준은 계산 전에 정했습니다). 큰 잡음 평균은 시드마다 쏠린 클래스가 달라 서로 상쇄되므로, 넷이 같은 클래스로 무너진 확률적 반올림 쪽이 더 엄격한 검증입니다. 기반 방향 계수는 0.069에서 0.051로 줄었지만 기준(0.04)을 넘어 남았습니다. 큰 잡음 평균으로는 0.056, 시드별 붕괴 방향 다섯 개를 따로 넣으면 0.051, 열 개를 모두 넣어도 0.050이었습니다. Q3_K_M은 0.080에서 0.076으로 거의 그대로였습니다. 요지는 유지됩니다.
다만 정직하게 적어 둘 것이 있습니다. 두 방향 벡터는 크기가 달라서 계수끼리는 비교할 수 없습니다. 대신 각 성분이 오차 크기의 몇 할인지로 보면, 붕괴 방향을 함께 뺐을 때 Q2_K 오차에는 기반 쪽 성분(0.22)과 무너질 때 가는 쪽 성분(0.23)이 거의 같은 크기로 함께 들어 있습니다. 앞에서 말한 약 30%는 기반 방향 하나만 봤을 때의 값이고, 0.22는 붕괴 방향과 겹치는 몫을 뺀 뒤 기반 방향에 남는 몫입니다. 기반 쪽 성분 중 5분의 1에서 4분의 1은 무너지는 방향과 겹친 몫이었고, 나머지가 남은 것입니다. 앞에서 본 예측 분포가 이 그림과 맞습니다. 2비트 decider-4b는 무너진 판들이 쏠린 "약어"로 가지 않고(14개에서 11개), 기반 모델처럼 "설명"을 늘리고 "개체"를 줄였습니다.
예측 채점표입니다.
| 단계 | 맞음 | 틀림 |
|---|---|---|
| 1차: 헤드인가 몸통인가 | 우위가 10% 이상 좁아짐(아슬아슬), 원인은 몸통, 정확도는 3%p 안 | 큰 가중치가 눌림 |
| 2차: 희석 | 은닉 상태가 BF16에서 벗어남 | 크기가 유지됨, 우위가 코사인만큼 줄어듦 |
| 3차: 미세조정 | 은닉 상태가 기반 쪽으로 감, 기반 모델이 덜 단호함 | 가중치 오차가 미세조정을 되돌림, 미세조정 몫이 10% 이상 지워짐 |
| 같은 크기 잡음(시드 0·1로 판정) | 잡음도 confidence를 낮춤 | 잡음도 기반 쪽으로 감, 잡음에서도 정확도가 3%p 안 |
| 블록 크기를 맞춘 잡음 | confidence를 낮춤 | 기반 방향 코사인 중앙값 0.15 이상, 회귀 계수 중앙값 0.04 이상 |
| 계산 방식, 확률적 반올림 | BF16 계산에서도 같음, Q8_0은 기울지 않음 | 확률적 반올림은 기울지 않음 |
| 큰 잡음 | 크기만으로는 기울지 않음 | |
| 붕괴 방향 확인 | 붕괴 방향을 넣어도 기반 방향 계수가 0.04 이상 남음 |
22개 중 11개를 맞혔습니다.
남은 질문
질문은 이렇게 좁아졌습니다. 가중치 하나하나의 Q2_K 오차는 미세조정과 상관이 없습니다(코사인 −0.005). 같은 크기의 무작위 잡음은 크기 구조를 맞춰도 기반 쪽으로 가지 않습니다. 잡음이 기반 쪽으로 가려면 모델을 정확도 13-32%까지 망가뜨릴 만큼 커야 합니다. 그런데 Q2_K 오차는 모델을 거의 망가뜨리지 않고 그만큼 기웁니다. 양자화 오차의 무엇이 이렇게 적은 손상으로 기반 쪽에 닿게 할까요?
용의자는 둘입니다. 하나는 반올림이 가중치 값마다 결정적으로 정해진다는 점입니다. 같은 가중치는 언제나 같은 쪽으로 반올림되고, 비슷한 값은 비슷하게 반올림됩니다. 다른 하나는 격자 자체입니다. 블록마다 탐색해서 고른 눈금과, 값이 몇 개의 격자점에만 놓일 수 있다는 제약입니다.
이 둘을 가르려고 같은 Q2_K 눈금을 쓰되 위·아래 격자점을 거리에 비례한 확률로 무작위로 고르는 판(확률적 반올림)을 만들었습니다. 구현은 맞았습니다. 같은 눈금으로 가장 가까운 점을 다시 계산하면 248개 텐서 모두 파일 값과 100% 일치합니다. 그런데 확률적 반올림은 원리상 오차가 더 커서, 이 격자에서는 √2배 가까이(1.45배) 커졌고 모델이 무너졌습니다(정확도 1.8-14.0%). 그리고 같은 크기의 잡음도 무너지면서 기반 쪽으로 기울었기 때문에, 미리 정한 규칙대로 이 결과는 격자의 증거로 쓰지 않습니다. 결정성과 격자는 이번 설계로는 가르지 못했습니다.
다음 실험은 오차 크기를 맞춘 확률적 반올림입니다. 한 단계 촘촘한 격자(예를 들어 Q3_K)에서 확률적 반올림을 하면 오차가 Q2_K의 가장 가까운 점 반올림과 비슷한 크기가 되고, 그때도 기반 쪽으로 기우는지 보면 됩니다.
저희가 품었던 가설도 적어 둡니다. 사전학습은 수조 토큰으로 패턴을 깊게 새겼고, 미세조정은 그 위에 얇게(이 모델은 LoRA를 병합했으니 저랭크로) 덧칠했습니다. 양자화가 사포처럼 큰 굴곡은 남기고 미세한 결을 지운다면, 미세조정의 효과가 수많은 작은 가중치의 정밀한 맞물림에 기대고 있을 때 가중치 하나하나는 그대로 두면서도(3차의 가중치 단위 확인대로) 그 맞물림만 흐트러뜨릴 수 있습니다. 블록 크기를 맞춘 잡음이 기울지 않았으니 "거칠기"를 흉내 내는 것만으로는 부족했고, 크게 망가뜨리면 아무 잡음이나 기운다는 결과까지 더하면 이 가설은 아직 반쯤 열려 있습니다.
양자화한 결정 모델을 쓴다면
- 이 모델과 과제에서 Q2_K와 Q3_K_M은 정확도는 거의 잃지 않았지만 confidence가 눈에 띄게 낮았습니다. confidence 기준으로 답을 자동 처리한다면, 양자화한 뒤에는 기준을 넘는 답이 줄어듭니다.
- 직접 라벨을 단 질문 수백 개로 맞춘 temperature 하나가 이번에는 이를 되돌렸습니다(Q2_K에서 보정 오차 ECE 0.100에서 0.045). 양자화한 뒤에는 temperature를 다시 맞추세요. decider에 들어 있는 1.11은 BF16에 맞춘 값입니다.
- 공유 임베딩 표를 높은 정밀도로 남겨 두는 것으로는 해결되지 않습니다. llama.cpp 기본 파일은 이미 그렇게 하고 있고, confidence 하락은 몸통에서 옵니다.
한계
- 모델 하나(decider-4b v2.1), 과제 하나(TREC, 선택지 6개, 질문 500개), 파일마다 한 번 실행했습니다. 일반화를 확인하는 가장 싼 방법은 두 번째 모델(예를 들어 저희가 앞서 직접 학습한 작은 결정 모델)로 다시 재는 것인데, 아직 하지 않았습니다.
- "헤드"가 입력 임베딩과 같은 표라서, 한쪽만 깎을 수 없었습니다.
- 2차, 3차와 모든 대조군은 앞 결과를 본 뒤 설계했습니다. 각 단계의 예측은 그 단계를 재기 전에 적었습니다. 성분 분해와 지시형 모델 확인은 탐색입니다.
- Q3_K_M이 Q2_K보다 기반 쪽으로 더 기울고(0.47 대 0.29) 단호함도 더 잃었습니다. 비트 순서와 맞지 않습니다. 두 파일은 높은 정밀도로 남기는 텐서가 서로 다른데, 이를 비교하면 어느 층이 단호함을 쥐고 있는지까지 갈 수 있습니다. 아직 하지 않았습니다.
단계별 예측과 그 시각이 담긴 계획서, 나눈 판과 잡음판의 제작 방법, 모든 스크립트와 결과 파일은 아래 재현 패키지에 들어 있습니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
quantized-model-less-sure-repro.zip · 1,734 KB