A100 PCIe 한두 장에 Qwen3.8-27B 올리기: vLLM 설정만으로 한 사람 기준 28에서 211 tok/s까지
A100 80GB PCIe 한 장에서 INT4 체크포인트와 공개된 vLLM 설정만 쓰자, 코드 없이 한 사람 기준 28.4에서 211.0 tok/s, 32명 동시 사용 기준 587에서 약 1,568 tok/s가 됐습니다(temperature 0). 두 장이면 여러 명은 복제, 한 명은 분할이 빨랐습니다.
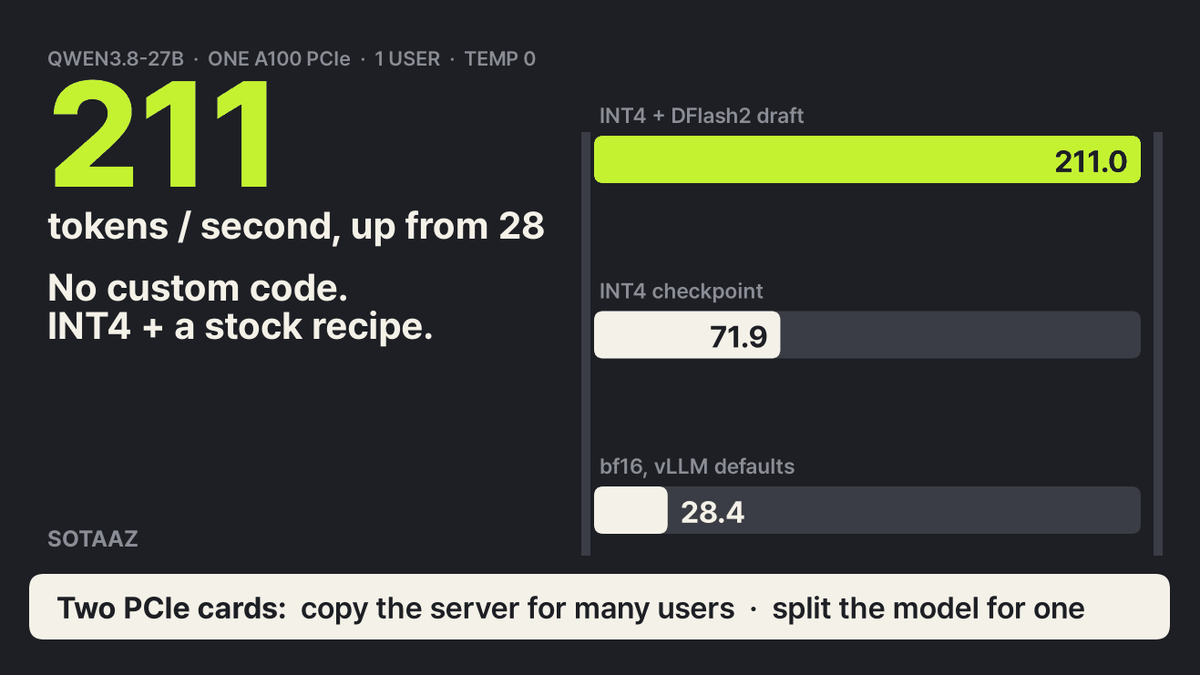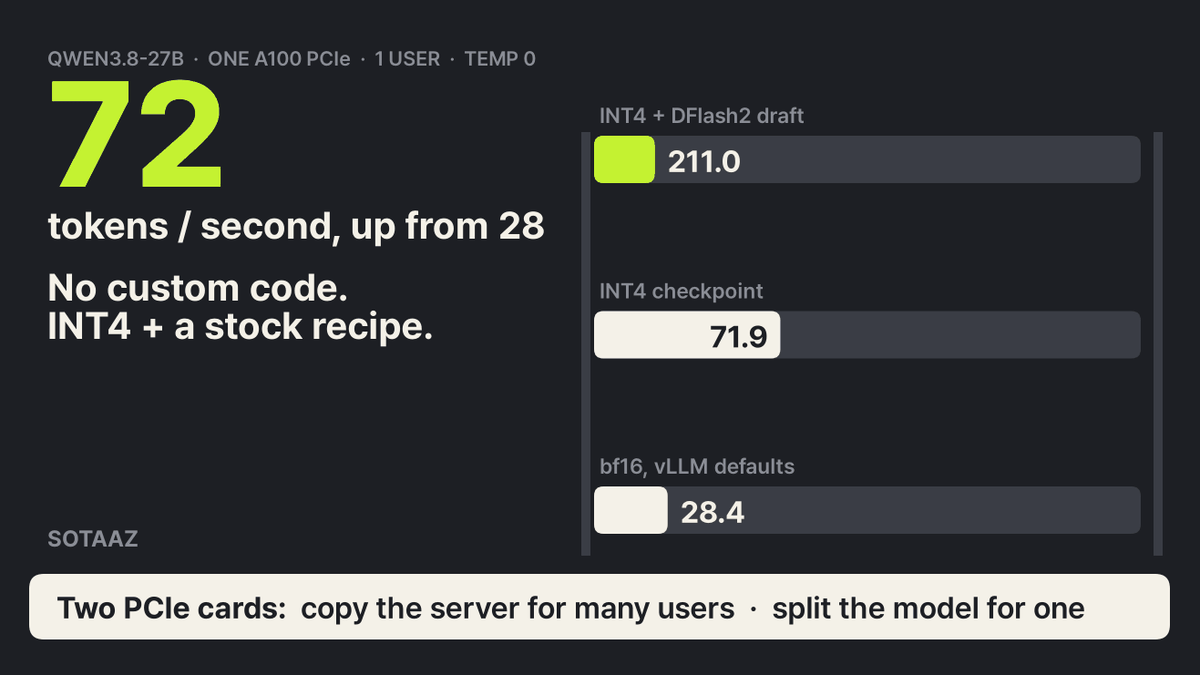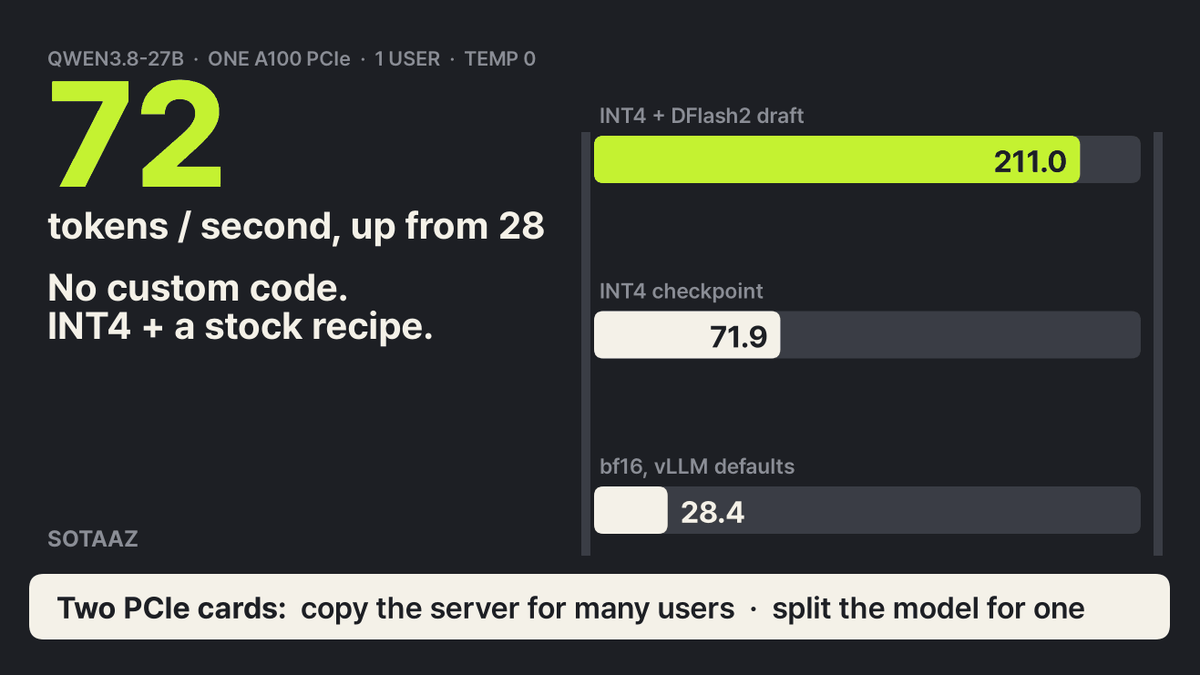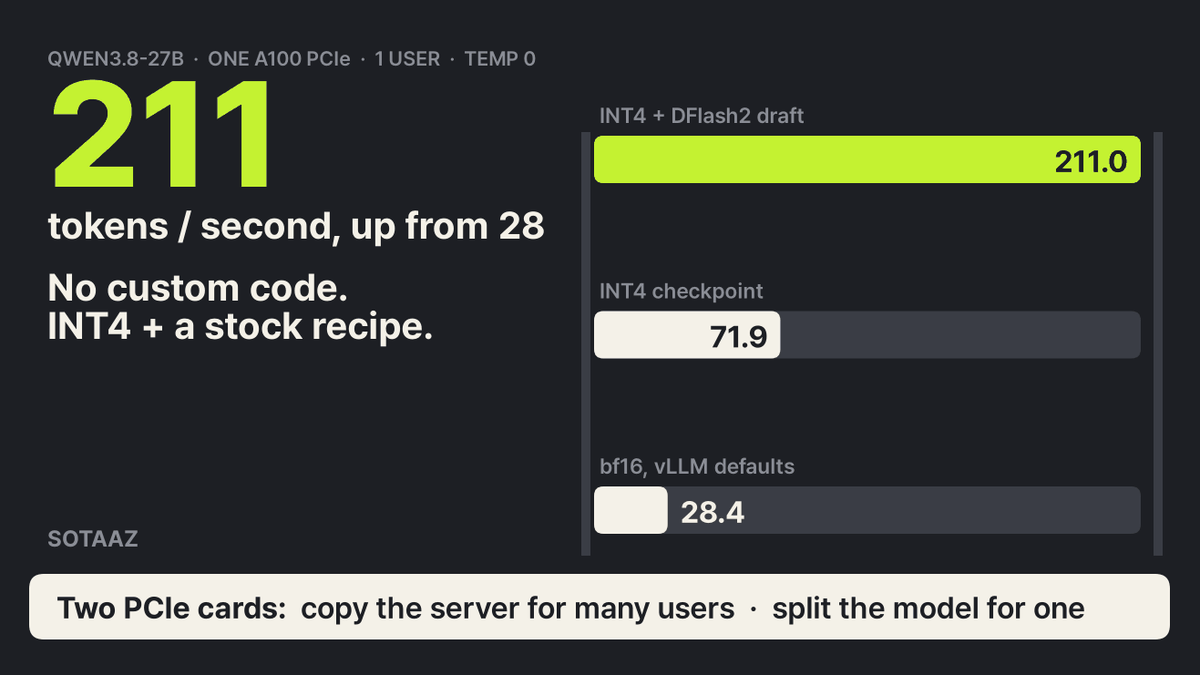
A100 한 장에 Qwen3.8-27B를 vLLM 기본값으로 띄우고 한 사람이 질문하면 초당 28.4토큰이 나옵니다. 별도 세팅은 하지 않고 디폴트 값 그대로 올려 실행한 결과입니다. 이번에는 INT4 체크포인트로 바꾸고, 공개된 vLLM 설정을 그대로 얹었습니다. 그러자 같은 질문이 초당 211.0토큰으로 나왔습니다. 7.4배입니다(temperature 0, 한 번에 한 사람). 32명이 동시에 요청을 보내는 경우에는 카드 한 장의 처리량이 초당 587토큰에서 약 1,568토큰으로 2.7배가 됐습니다.
모델 하나를 카드 두 장에 나눠 올리면, 토큰을 하나 만들 때마다 두 카드가 계산 중간 결과를 주고받아야 합니다. NVLink는 GPU끼리 직접 잇는 전용 연결이라 이 교환이 빠릅니다. NVLink가 없으면 같은 데이터가 메인보드의 PCIe를 거쳐 오갑니다. NVIDIA A100 사양표 기준으로 양방향 합계 NVLink는 초당 600GB, PCIe 4.0은 초당 64GB입니다. 따라서 NVLink 없는 PCIe 카드 두 장에 모델 하나를 나눠 올리면, 서버를 두 개 띄우는 것보다 어느 경우에나 느릴 것이라고 예상했습니다.
사용자가 많을 때는 서버 두 개 쪽이 빨랐습니다. 그런데 한 사람만 쓸 때는 나눠 올린 쪽이 초당 138.4토큰으로, 두 개 띄운 쪽의 102.9토큰보다 빨랐습니다. 사용자 한 명일 때는 카드마다 읽을 가중치가 절반으로 줄어, 가중치를 한 번 읽어 토큰을 내는 계산 한 단계가 17.8ms에서 13.2ms로 짧아졌습니다. 카드끼리 주고받는 시간은 그 단계의 10%쯤이었습니다.
이 글은 GPU 한 장과 두 장에서 토큰 속도가 어떻게 달라지는지, 그리고 그 속도를 올리는 설정을 다룹니다.
서빙 엔진은 무엇을 하나
vLLM 같은 서빙 엔진은 모델을 GPU 메모리에 올려 두고, OpenAI 형식의 HTTP 요청에 답합니다. 글을 만드는 과정은 반복입니다. 토큰 하나를 만들 때마다 GPU는 모델의 가중치를 처음부터 끝까지 한 번 읽습니다. 270억 개 파라미터 모델이면 토큰 하나에 수십 GB를 읽는 셈입니다. 그래서 한 사람만 쓸 때의 속도는 계산 능력보다 카드가 자기 메모리를 얼마나 빨리 읽느냐에 달려 있습니다. 그러니 속도를 올리려면 토큰 하나를 만들 때 읽는 양을 줄이거나, 한 번 읽을 때 만드는 토큰 수를 늘리면 됩니다.
- 가중치를 작게 만듭니다. INT4 양자화는 가중치 하나를 16비트 대신 4비트로 저장합니다. 토큰마다 읽을 양이 4분의 1로 줄어듭니다.
- 한 번 읽을 때 토큰을 여러 개 얻습니다. speculative decoding은 작은 드래프트 모델(draft model)이 다음에 몇 토큰이 올지를 미리 예상하고, 큰 모델이 그 예상 내용을 한 번에 검사하는 방식입니다. 큰 모델이 동의한 토큰은 그대로 답에 쓰므로, 가중치를 한 번 읽고 토큰을 여러 개 얻습니다. 실제 출력이 얼마나 빨라지는지 아래에서 따로 확인합니다.
여러 사람이 동시에 요청을 하면 엔진은 요청을 묶어서 처리합니다. 가중치를 한 번 읽어 여러 명의 토큰을 함께 만듭니다. 이때는 카드가 계산으로 바빠지므로, 한 사람용으로 맞춘 설정이 오히려 손해가 될 수 있습니다.
측정 환경
- 장비: A100 80GB PCIe 두 장, 카드당 300 W, 카드 사이 NVLink 없음. 서버 한 대입니다.
- 소프트웨어: vLLM 0.31.0. 플러그인도 소스 수정도 없습니다.
- 모델:
Qwen/Qwen3.8-27B(bf16),RedHatAI/Qwen3.8-27B-INT4, 드래프트 모델z-lab/Qwen3.8-27B-DFlash2. 모두 Apache-2.0이고 리비전을 고정했습니다. - 질문: 저희가 직접 만든 96개 태스크입니다. 코딩·에이전트·일반·수학이 24개씩이고 그중 40개가 한국어입니다. 생각 모드는 모델 템플릿 기본값대로 켜 두었고 답 길이는 1,024토큰까지입니다. 모든 조건에서 96개 중 58-65개가 이 한도에 닿았으므로, 조건마다 만든 글의 양은 거의 같습니다.
- 한 사람 속도는 답 하나의 생성 속도입니다. (토큰 수 - 1)을 첫 토큰부터 마지막 토큰까지 걸린 시간으로 나누고 96개를 평균했습니다. 여러 사람 처리량은 전체 토큰 수를 전체 시간으로 나눈 값이고, 첫 토큰이 나오기까지의 시간(TTFT) 중앙값과 상위 5% 지점(p95)을 같이 적었습니다.
- 실행마다 서버를 새로 띄웠습니다. 2초마다 GPU 프로세스를 기록했고, 다른 GPU 프로세스가 보이거나 load가 64를 넘은 실행 3건은 버리고 다시 쟀습니다. 그래서 글에 나오는 숫자는 모두 두 검사를 통과한 실행에서 나왔습니다. 1분 load average는 128스레드 장비에서 최대 13.0이었습니다.
R1, R3-32 같은 이름은
아래 표와 그림에 나오는 R1, R3-32, D1 같은 이름은 vLLM 옵션이 아니라 저희가 이 연재에서 붙인 이름입니다. 연재 이름인 사다리(ladder)에서 따왔습니다. R은 사다리의 단(rung)이고, 숫자가 클수록 설정을 더 얹은 단계입니다.
- R1: bf16 원본 모델, vLLM 기본값.
- R2: INT4 체크포인트, vLLM 기본값.
- R3-1, R3-32: INT4에 튜닝한 설정을 얹은 단계입니다. 뒤의 숫자는 그 설정이 겨냥한 동시 사용자 수입니다. R3-1은 한 사람용, R3-32는 32명용입니다.
- D1, D2, D3: 카드 두 장(dual)을 쓰는 방법입니다. D1은 서버 복제, D2는 모델 분할, D3은 카드마다 다른 설정을 띄우는 방법이고, 아래 두 장 절에서 설명합니다.
모든 조건을 한 번씩 돌리고, 차이가 작은 비교만 세 번씩 돌렸습니다. 32명 기준 R3-32 설정을 세 번 돌리면 초당 1,562.3, 1,567.1, 1,574.0토큰으로 폭이 0.75%였습니다. 이 폭은 32명 기준에서 잰 것인데, 한 번만 잰 한 사람 기준 값에도 같은 폭을 적용했습니다. 그러니 아래에서 한 번만 잰 숫자는 이 정도 오차를 감안해 읽어 주세요. 한 사람 속도를 세 번 잰 경우에는 세 값의 차이가 모두 초당 0.1토큰 안이었습니다.
튜닝한 두 설정은 atdev-serve 벤치마크 문서가 "가장 좋은 vLLM 설정"이라는 기준선으로 공개한 순정 vLLM 명령을 그대로 가져와 썼습니다.
두 설정은 서버 옵션 다섯 개를 똑같이 켭니다. --max-model-len 8192 --kv-cache-dtype bfloat16 --language-model-only --gpu-memory-utilization 0.90 --mamba-ssm-cache-dtype bfloat16입니다. R3-1은 여기에 speculative 설정을 더합니다. 드래프트 모델로 DFlash2를 쓰고, 한 단계에 7토큰을 짐작하고, 드래프트 모델은 fp8로 저장합니다. R3-32는 그 대신 모델에 내장된 예측기(MTP, Multi-Token Prediction)로 한 단계에 1토큰만 짐작하고, --attention-backend TRITON_ATTN, --no-enable-prefix-caching, 환경 변수 VLLM_MARLIN_INPUT_DTYPE=int8을 더합니다. 마지막 것은 INT4 행렬 곱의 입력을 int8로 바꿉니다. 그러니 기본 INT4에서 두 설정으로 넘어갈 때는 짐작만 바뀌는 것이 아니라 여러 옵션이 함께 바뀝니다. MTP가 무엇이고 과제에 따라 얼마나 잘 맞히는지는 과제별 speculative decoding 실측에서 따로 다뤘습니다.
그대로 따라 하기
vLLM 0.31.0을 Python 3.12 가상 환경에 설치합니다. 저희가 한 순서대로 vLLM을 먼저 설치하고, 함께 들어온 CUDA 컴파일러 패키지 세 개를 13.0.88로 다시 맞춥니다. 두 번째 pip 줄과 그 아래 세 줄은 바로 다음 문단에서 설명하는 설치 문제를 피하기 위한 것입니다.
python3.12 -m venv .venv && . .venv/bin/activate
pip install vllm==0.31.0
pip install nvidia-cuda-nvcc==13.0.88 nvidia-cuda-crt==13.0.88 nvidia-nvvm==13.0.88
CU13=$(python -c "import nvidia; print(list(nvidia.__path__)[0] + '/cu13')")
mkdir -p $CU13/lib64 && ln -sf ../lib/libcudart.so.13 $CU13/lib64/libcudart.so
export PATH=$CU13/bin:$PATH
설치에서 한 번 막힌 곳도 적어 둡니다. 시스템에 깔린 CUDA 12의 nvcc로는 FlashInfer JIT 빌드가 --compress-mode 옵션을 몰라 서버가 뜨지 않았습니다. pip이 가상 환경에 함께 설치한 CUDA 13 nvcc를 PATH 맨 앞에 두고, 그 버전을 헤더와 같은 13.0 계열로 맞췄습니다. 그래도 링크 단계에서 한 번 더 실패했는데, pip 패키지에는 libcudart.so.13 파일만 있기 때문입니다. 가상 환경의 nvidia/cu13/lib64/에 ../lib/libcudart.so.13을 가리키는 libcudart.so 심볼릭 링크를 만들자 vLLM을 고치지 않고 서버가 떴습니다.
이제 서버를 띄웁니다. 단계마다 명령 한 줄입니다. 저희는 카드 하나만 쓰도록 CUDA_VISIBLE_DEVICES=0을 붙였습니다. --revision은 저희가 잰 모델 버전을 고정하는 옵션이고, 드래프트 모델은 --speculative-config 안의 revision으로 고정합니다. R3 두 설정이 같이 쓰는 옵션 다섯 개는 변수 하나에 넣어 둡니다.
BF16_REV=1d4bf0f2ff6012fd82039f2fa52739d0dd7c60c0
INT4_REV=91bd022d5b49442a868bc35008f6c21e1860edfa

# R1: bf16, 기본값
CUDA_VISIBLE_DEVICES=0 vllm serve Qwen/Qwen3.8-27B --revision $BF16_REV --port 8000

# R2: INT4, 기본값
CUDA_VISIBLE_DEVICES=0 vllm serve RedHatAI/Qwen3.8-27B-INT4 --revision $INT4_REV --port 8000

# R3 두 설정이 같이 쓰는 옵션
COMMON="--max-model-len 8192 --kv-cache-dtype bfloat16 --language-model-only --gpu-memory-utilization 0.90 --mamba-ssm-cache-dtype bfloat16"

# R3-1: 한 사람용. DFlash2가 한 단계에 7토큰을 짐작
CUDA_VISIBLE_DEVICES=0 vllm serve RedHatAI/Qwen3.8-27B-INT4 --revision $INT4_REV $COMMON --port 8000 \
  --speculative-config '{"method": "dflash", "model": "z-lab/Qwen3.8-27B-DFlash2", "revision": "50307d4c4cde6860d4eee73e2547cd786fe8e8a4", "num_speculative_tokens": 7, "quantization": "fp8"}'

# R3-32: 여러 사람용. MTP가 한 단계에 1토큰을 짐작
CUDA_VISIBLE_DEVICES=0 VLLM_MARLIN_INPUT_DTYPE=int8 vllm serve RedHatAI/Qwen3.8-27B-INT4 --revision $INT4_REV $COMMON --port 8000 \
  --attention-backend TRITON_ATTN --no-enable-prefix-caching \
  --speculative-config '{"method": "mtp", "num_speculative_tokens": 1}'
서버가 뜨면 OpenAI 형식으로 질문해 봅니다. 모델 이름은 vllm serve에 준 이름 그대로입니다.
curl http://localhost:8000/v1/chat/completions -H "Content-Type: application/json" \
  -d '{"model": "RedHatAI/Qwen3.8-27B-INT4", "messages": [{"role": "user", "content": "안녕하세요"}], "max_tokens": 200}'
카드 한 장: 단계별로 켜 보기
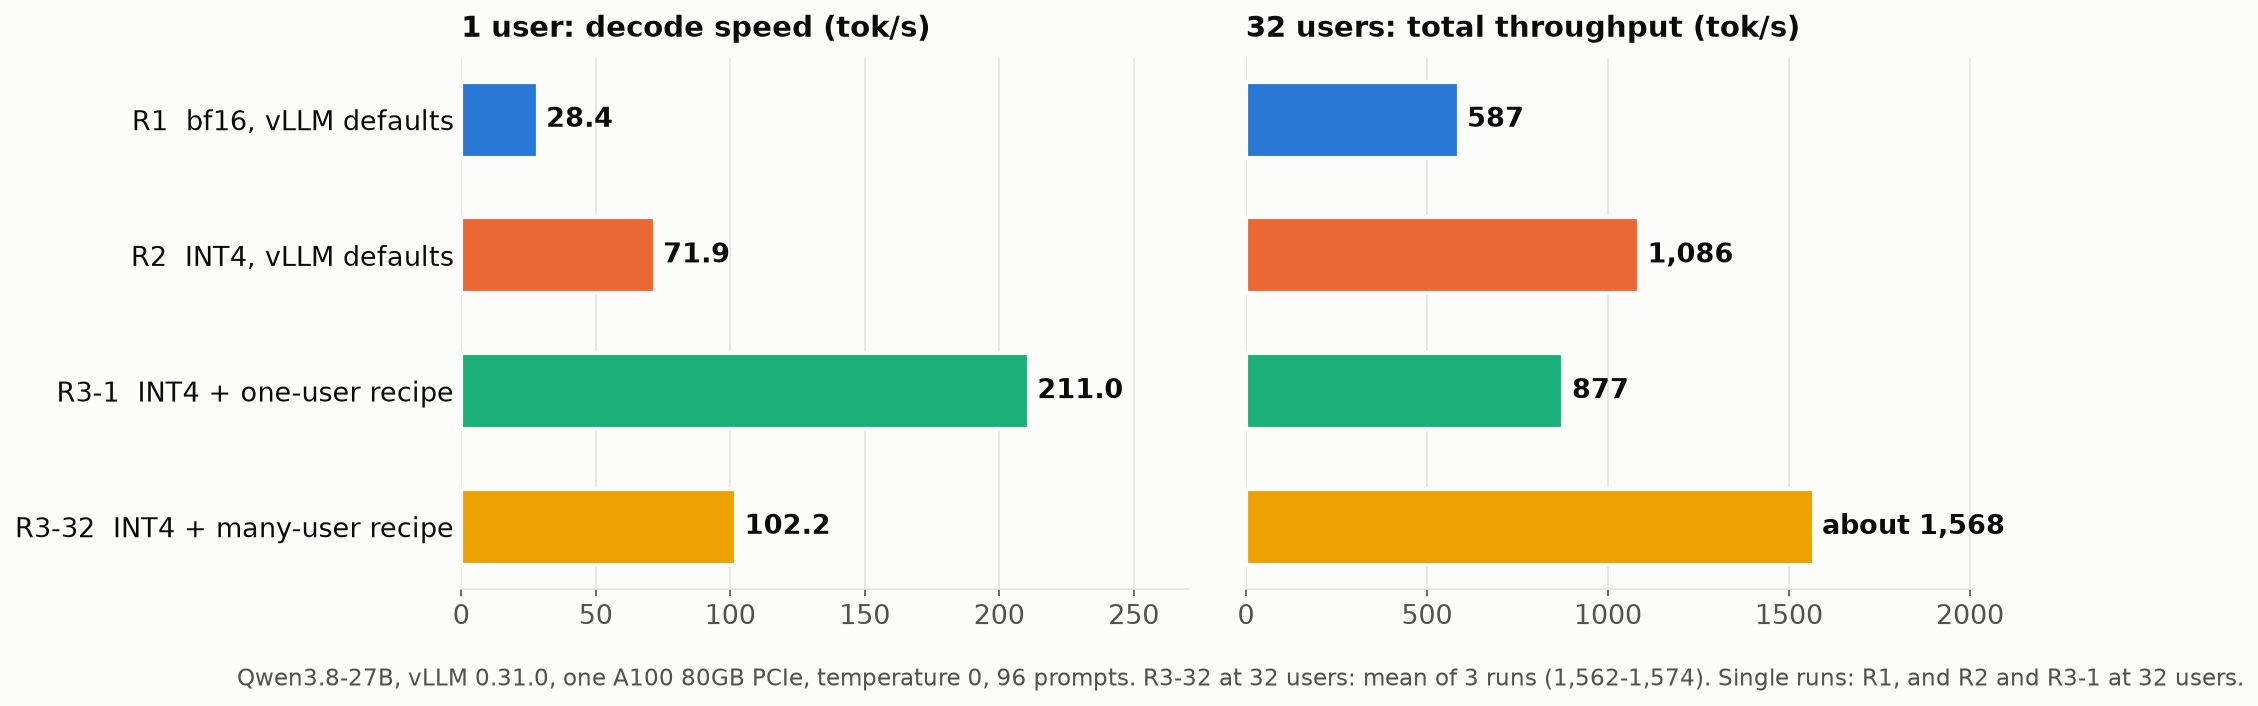
| 설정 | 1명, tok/s | 32명, tok/s | 32명, TTFT p95 |
|---|---|---|---|
| R1: bf16, vLLM 기본값 | 28.4 | 587 | 0.92초 |
| R2: INT4, vLLM 기본값 | 71.9 | 1,086 | 1.06초 |
| R3-1: INT4 + 한 사람용 설정 | 211.0 | 877 | 1.16초 |
| R3-32: INT4 + 여러 사람용 설정 | 102.2 | 약 1,568 | 0.87-0.89초 |
모두 temperature 0입니다. R1 행 전체와 R2·R3-1의 32명 칸은 한 번 잰 값이고, 나머지는 세 번 잰 값입니다.
가장 먼저 할 일은 INT4로 바꾸는 것입니다. 다른 옵션은 건드리지 않고 bf16 가중치를 INT4 체크포인트로만 바꿨더니, 한 사람 기준 28.4에서 71.9토큰(2.5배), 32명 기준 587에서 1,086토큰(1.8배)이 됐습니다. 바꾼 것은 모델 이름 하나입니다.
그다음은 몇 명이 쓰느냐에 따라 갈립니다. 두 설정의 방향이 반대입니다.
- R3-1은 DFlash2로 한 단계에 7토큰을 짐작합니다. 큰 모델은 한 단계에 평균 2.53개를 받아들였습니다. 한 사람이면 초당 211.0토큰으로 R2의 2.9배입니다. 그런데 32명이면 877토큰으로, 아무것도 붙이지 않은 INT4의 1,086토큰보다 낮습니다. 32명일 때도 단계당 2.49개를 받아들여 한 사람일 때와 거의 같았는데도 그렇습니다.
- R3-32는 한 단계에 MTP로 1토큰을 짐작하고, 평균 0.81개를 받아들였습니다. 32명이면 초당 약 1,568토큰으로 가장 많고, 기다리는 시간도 가장 짧습니다(TTFT p95 0.87-0.89초). 한 사람이면 102.2토큰으로 R3-1의 절반입니다.
그러니 카드 한 장에 대한 답은 두 개입니다. 혼자 쓰는 카드라면 R3-1, 팀이 같이 쓰는 카드라면 R3-32입니다. R3-32를 64명 기준으로 돌리면 초당 1,856토큰까지 올라갔지만 TTFT p95도 1.60초로 늘었습니다(한 번 잰 값).
참고로 atdev는 같은 세 단계의 한 사람 속도를 초당 28.9, 74.9, 196.5토큰으로 공개했습니다. 그쪽 A100 SXM 카드와 그쪽 질문 세트로 잰 값입니다. 카드와 질문이 달라서 저희 숫자와 빠르고 느림을 따지지 않고, 단계마다 빨라지는 순서가 같다는 정도로만 봅니다.
temperature 0.7에서는
실제 대화는 temperature 0보다 높은 값으로 씁니다. temperature 0.7에 시드를 고정해 다시 쟀습니다. R3-1의 한 사람 속도는 초당 186.8토큰으로 11% 낮아졌고, 받아들인 짐작도 단계당 2.53개에서 2.14개로 줄었습니다. 무작위로 고르면 큰 모델이 짐작에 동의하는 일이 줄어듭니다. 짐작 없이 INT4만 쓴 경우는 71.9에서 70.3토큰으로 훨씬 덜 줄었습니다(각각 세 번, 세 번 모두 느림). 그래서 한 사람 기준으로 짐작을 쓴 R3-1이 기본 INT4보다 빠른 배수는 temperature 0에서 2.9배, 0.7에서 2.7배로, 10% 정도 작아졌습니다.
32명 기준은 사정이 다릅니다. R3-32는 1,382토큰으로 12% 낮아졌고 TTFT p95는 0.87-0.89초에서 3.15초로 늘었습니다. 짐작을 쓰지 않는 기본 INT4도 1,086에서 936토큰으로 비슷하게(14%) 줄었고, TTFT p95는 9.41초였습니다. 32명 기준에서 느려지는 것은 짐작을 쓰는 설정에만 생기는 일이 아닙니다. temperature 0.7에서 R3-1과 32명 기준 두 설정은 한 번 잰 값입니다.
답은 그대로인가
카드 한 장 설정 네 가지를 시험 문제로 채점했습니다. GSM8K 테스트 문제 전체 1,319개, MMLU-Pro 1,400문항(분야별 100개), KMMLU 1,125문항(과목별 25개)입니다. 답을 안정적으로 뽑으려고 채점 때는 생각 모드를 끄고 답 길이를 4,096토큰까지 늘렸습니다. 속도를 잰 설정과는 다릅니다.
| 설정 | GSM8K | MMLU-Pro | KMMLU |
|---|---|---|---|
| R1 bf16 | 96.6% ± 1.0 | 78.2% ± 2.2 | 70.9% ± 2.7 |
| R2 INT4 | 96.8% ± 0.9 | 77.1% ± 2.2 | 73.0% ± 2.6 |
| R3-1 | 97.0% ± 0.9 | 76.8% ± 2.2 | 70.4% ± 2.7 |
| R3-32 | 96.2% ± 1.0 | 77.1% ± 2.2 | 70.3% ± 2.7 |
± 값은 95% 신뢰구간입니다. 세 시험 모두에서 어느 두 설정을 골라도 구간이 겹치므로, 이 문항 수로는 네 설정의 차이를 가릴 수 없었습니다. KMMLU는 원본 정답이 한쪽 보기에 몰려 있어서, 여기서는 설정끼리 비교하는 데만 쓰고 모델의 한국어 실력을 나타내는 숫자로 쓰지 않습니다. INT4 세 설정은 4,096토큰 한도를 더 자주 넘겼습니다. 한도를 넘긴 답이 MMLU-Pro에서는 bf16 86개 대 110-115개, KMMLU에서는 17개 대 38-55개였습니다. MMLU-Pro에서 한도를 넘긴 답은 거의 모두 정답을 적지 못한 채 끝나 오답으로 셌습니다.
temperature 0에서 만든 토큰도 하나하나 맞대어 봤습니다. 기본 옵션의 INT4는 같은 설정을 다시 돌려도 답이 달라졌습니다. 두 번 돌린 결과가 끝까지 같은 질문은 96개 중 5-10개였고, 갈라지는 지점은 중앙값으로 90번째 토큰 근처였습니다. 반면 R3-1과 R3-32는 세 번 모두 96개가 똑같았습니다. 기본 INT4와 맞대면 R3-1은 2-3개가 같았습니다. 기본 INT4가 자기 자신과 같은 5-10개보다도 적어서, 기본 INT4가 원래 흔들리는 정도와 구분할 수 없습니다. R3-32는 하나도 같지 않았고, 첫 토큰부터 다른 답도 있었습니다. R3-32는 int8 입력과 다른 어텐션 커널처럼 계산 경로를 여러 곳에서 바꾸는 설정입니다. 게다가 두 설정은 짐작 말고도 여러 옵션이 기본 INT4와 다르므로, 이 비교로 짐작 하나의 효과를 따로 떼어 볼 수도 없습니다. 결국 토큰 비교로는 두 설정이 같은 글을 낸다고 보여 줄 수 없고, 남는 근거는 위의 채점 결과입니다. 그리고 채점으로는 설정 사이의 차이를 가릴 수 없었습니다.
카드 두 장: 여러 명이면 복제, 한 명이면 분할
모델이 이미 한 장에 들어간다면, 두 번째 카드를 쓰는 흔한 방법은 둘입니다. 드래프트 모델만 두 번째 카드에 올리는 방법도 떠올릴 수 있지만, vLLM 0.31.0에는 드래프트 모델의 GPU를 고르는 옵션이 없습니다. draft_tensor_parallel_size도 1이나 큰 모델과 같은 값만 받습니다.
- 복제(D1): R3-32 서버를 카드마다 하나씩 두 개 띄우고, 요청을 번갈아 보냅니다.
- 분할(D2):
--tensor-parallel-size 2로 R3-32 서버 하나를 두 카드에 걸쳐 띄웁니다. 카드마다 층의 절반씩을 맡고, 토큰마다 두 카드가 PCIe로 결과를 주고받습니다.
명령은 R3-32와 같고, 카드 번호와 옵션 하나만 다릅니다(COMMON은 위에서 정의한 변수입니다).
# D1 복제: 카드마다 서버 하나, 포트를 다르게
CUDA_VISIBLE_DEVICES=0 VLLM_MARLIN_INPUT_DTYPE=int8 vllm serve RedHatAI/Qwen3.8-27B-INT4 --revision $INT4_REV $COMMON --port 8000 \
  --attention-backend TRITON_ATTN --no-enable-prefix-caching \
  --speculative-config '{"method": "mtp", "num_speculative_tokens": 1}' &
CUDA_VISIBLE_DEVICES=1 VLLM_MARLIN_INPUT_DTYPE=int8 vllm serve RedHatAI/Qwen3.8-27B-INT4 --revision $INT4_REV $COMMON --port 8001 \
  --attention-backend TRITON_ATTN --no-enable-prefix-caching \
  --speculative-config '{"method": "mtp", "num_speculative_tokens": 1}' &

# D2 분할: 서버 하나가 두 카드를 함께 씀
CUDA_VISIBLE_DEVICES=0,1 VLLM_MARLIN_INPUT_DTYPE=int8 vllm serve RedHatAI/Qwen3.8-27B-INT4 --revision $INT4_REV $COMMON --port 8000 \
  --attention-backend TRITON_ATTN --no-enable-prefix-caching \
  --speculative-config '{"method": "mtp", "num_speculative_tokens": 1}' \
  --tensor-parallel-size 2
복제에서는 저희 측정 프로그램이 두 포트에 요청을 번갈아 보냈습니다. 여러 사람이 쓰는 서비스라면 nginx 같은 프록시를 앞에 두어 같은 일을 맡기면 됩니다.
한 사람용 설정을 두 카드에 나눠 올리려면, 위 R3-1 명령에서 CUDA_VISIBLE_DEVICES=0,1로 바꾸고 --tensor-parallel-size 2를 붙입니다.
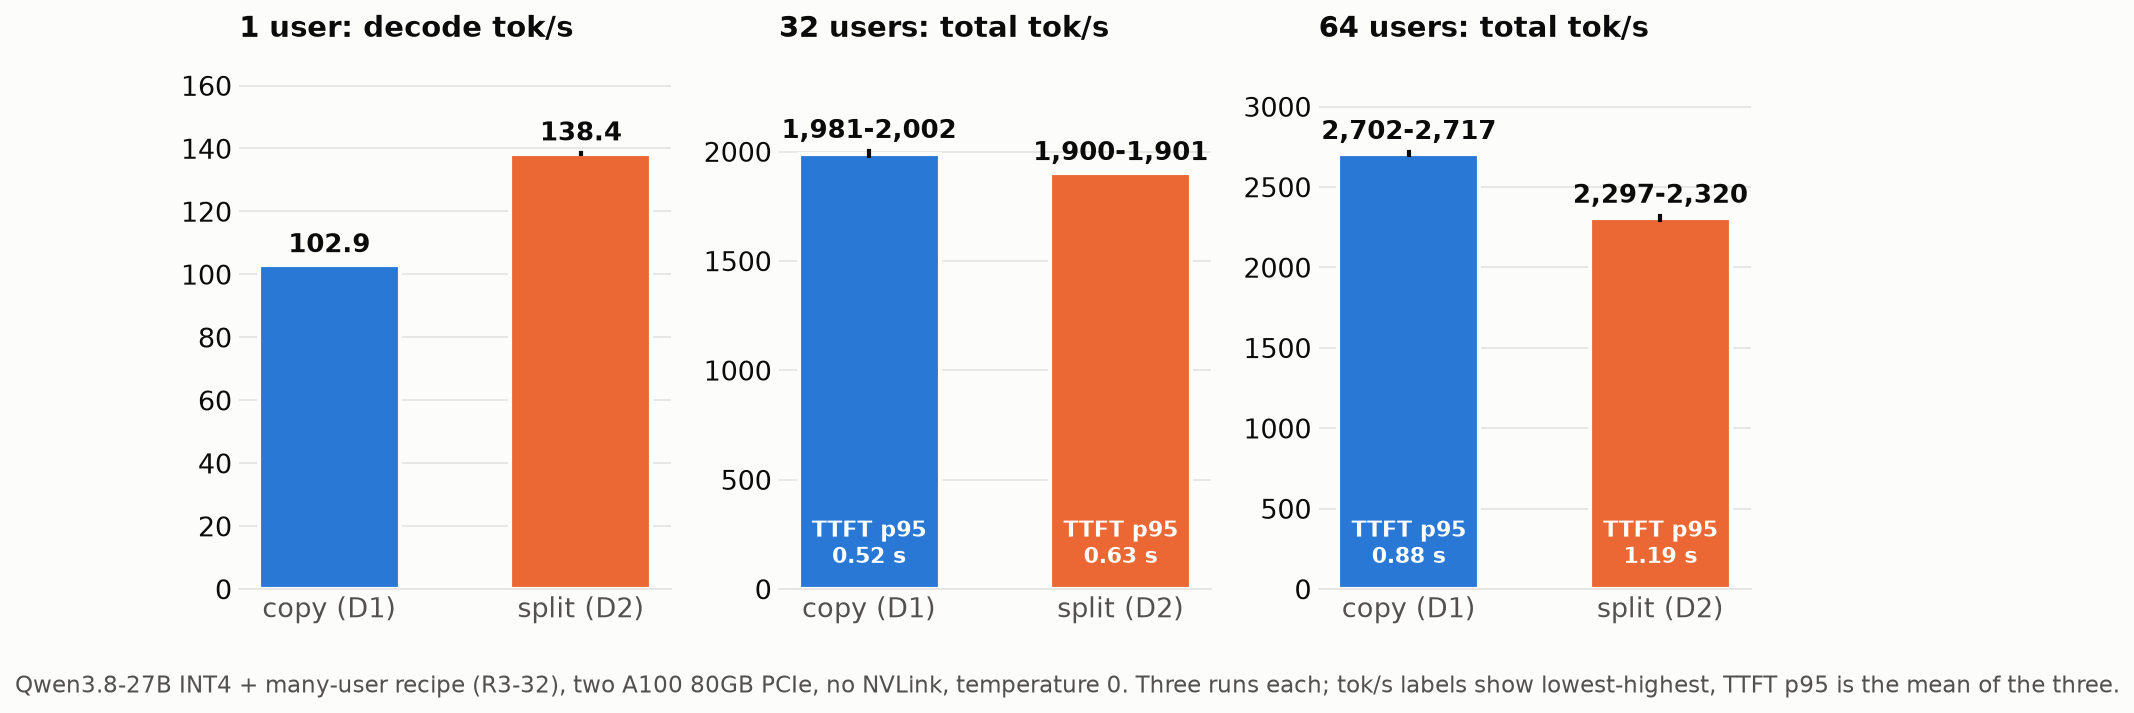
| 사용자 수 | 복제(D1) | 분할(D2) |
|---|---|---|
| 1명 | 102.9 tok/s | 138.4 tok/s |
| 32명 | 1,981-2,002, TTFT p95 0.50-0.54초 | 1,900-1,901, p95 0.63초 |
| 64명 | 2,702-2,717, p95 0.87-0.88초 | 2,297-2,320, p95 1.19-1.20초 |
각각 세 번, temperature 0입니다. 범위는 세 번 중 가장 낮은 값과 높은 값입니다.
사용자가 많으면 복제가 낫습니다. 64명 기준으로 복제는 초당 2,702-2,717토큰, 분할은 2,297-2,320토큰이었고, 가장 늦게 받는 사람의 첫 토큰도 복제 쪽이 빨랐습니다(p95 0.88초 대 1.19초). 32명에서는 차이가 작았지만 세 번 모두 복제가 처리량과 대기 시간 양쪽에서 앞섰습니다.
두 방법 모두 같은 인원의 카드 한 장보다는 낫습니다. 32명 기준으로 복제는 초당 1,981-2,002토큰이라 한 장의 1,562-1,574토큰보다 1.26-1.28배 많았고, p95도 0.50-0.54초로 한 장의 0.87-0.89초보다 짧았습니다. 분할도 1,900-1,901토큰, p95 0.63초였습니다. 64명 기준으로는 복제가 2,702-2,717토큰, 한 장이 1,856토큰(한 번 잰 값)이었고, p95는 0.87-0.88초 대 1.60초였습니다. 저희는 복제 64명이 한 장 32명의 2배 가까이 나올 것으로 봤는데, 실제로는 1.73배였습니다.
사용자가 한 명이면 분할이 낫습니다. 저희 예상과 반대입니다. 복제는 한 사람 속도를 거의 바꾸지 않습니다. 요청이 어차피 카드 한 장으로 가기 때문입니다. 세 번 모두 카드 한 장보다 근소하게 빨랐지만, 102.9토큰 대 102.2토큰으로 차이는 0.7%였습니다. 분할은 138.4토큰으로 복제의 1.35배였습니다. 한 사람용 설정(R3-1)을 두 카드에 나눠 올리는 경우도 한 번 쟀는데, 한 장의 211.0토큰보다 높은 276.7토큰이 나왔습니다.
사용자 한 명일 때 분할이 빠른 것은 한 단계가 짧아졌기 때문입니다. 여기서 한 단계는 큰 모델이 가중치를 한 번 읽고 토큰을 내놓는 계산 한 번입니다. 단계마다 나오는 토큰은 카드 한 장이 1.805개, 분할이 1.799개로 거의 같았습니다. 앞에서 본 받아들인 짐작 0.81개에 큰 모델 자신의 1개를 더한 값입니다. 달라진 것은 단계 하나에 걸린 시간이고, 17.8ms에서 13.2ms로 줄었습니다.
그 시간이 어디에 쓰이는지 보려고 torch 프로파일러를 켜고 요청 하나(256토큰)씩을 다시 돌려 GPU 커널 시간을 종류별로 나눴습니다. 요청 하나씩만 잰 것이지만, 프로파일러로 잰 GPU 커널 시간을 단계 수로 나누면 17.7ms와 13.2ms로 보통 실행의 단계 시간과 거의 같았습니다.
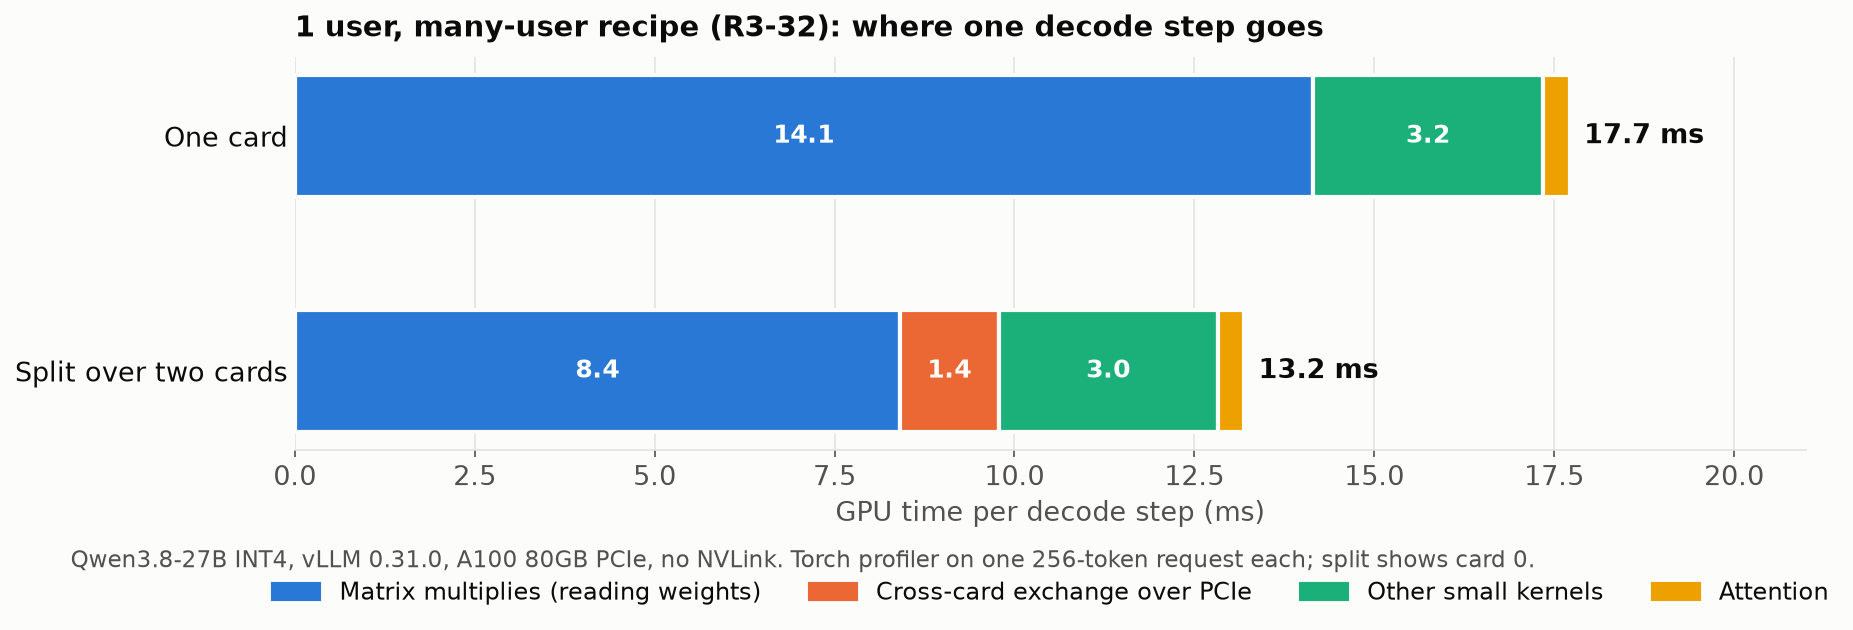
가중치를 읽어 곱하는 행렬곱이 14.1ms에서 8.4ms로 줄었습니다. 두 카드가 가중치를 절반씩 나눠 들고 있으니 카드마다 읽을 양이 줄어든 것입니다. 대신 카드끼리 중간 결과를 주고받는 시간 1.4ms가 새로 생겼습니다. 그중 1.2ms는 한 단계에 133번쯤 하는 짧은 합산으로, 한 번에 중앙값 약 8µs가 걸렸습니다. 나머지 0.15ms는 결과를 한데 모으는 교환입니다. 사용자 한 명이면 한 번에 오가는 데이터가 토큰 두어 개 분량이라 작습니다. 그 밖의 작은 커널은 3.2ms에서 3.0ms로 거의 그대로였습니다.
저희가 분할을 불리하게 본 것은 NVLink 없이 PCIe로 주고받는 통신이 클 것이라 생각했기 때문입니다. 사용자 한 명일 때 이 통신은 단계 시간의 10%쯤이었고, 행렬곱에서 아낀 5.7ms의 4분의 1 정도였습니다. 짐작을 쓰지 않는 INT4 기본 설정(R2)도 한 번 나눠 봤는데 71.9토큰이 100.5토큰이 됐습니다. 짐작이 없어도 분할만으로 한 사람의 속도가 올라간다는 뜻입니다.
다만 분할하면 출력이 달라집니다. temperature 0에서 분할 서버의 답은 카드 한 장의 답과 96개 중 하나도 같지 않았고, 한 사람용 설정으로 분할했을 때도 6개만 같았습니다. 분할 서버를 세 번 돌린 결과끼리도 적게는 79개만 같았습니다. 복제는 96개 모두 카드 한 장과 같았습니다.
두 가지를 한꺼번에 할 수도 있습니다(D3). 0번 카드에는 한 사람용 R3-1을, 1번 카드에는 32명용 R3-32를 띄우고 동시에 부하를 걸었습니다. 명령은 위 R3-1을 그대로 쓰고, R3-32는 CUDA_VISIBLE_DEVICES=1과 --port 8001로 바꾸면 됩니다. 세 번 돌린 결과 0번 카드는 초당 211.0-211.1토큰으로 혼자 돌릴 때의 211.0토큰과 같거나 조금 높았고, 1번 카드는 1,570-1,574토큰으로 혼자 돌릴 때의 1,562-1,574토큰 범위 안이었습니다. 이 장비에서는 어느 쪽도 상대 때문에 느려지지 않았습니다.
저희라면 이렇게 설정합니다
카드가 한 장이라면:
- INT4 체크포인트로 바꿉니다. 이것만으로 한 사람 기준 2.5배, 32명 기준 1.8배입니다(temperature 0).
- 혼자 쓰는 카드라면 DFlash2 드래프트 모델을 붙입니다(R3-1). temperature 0.7에서는 11% 정도 덜 나온다고 보시면 됩니다.
- 팀이 같이 쓴다면 R3-32를 씁니다. 32명을 넘기면 TTFT p95를 지켜봅니다.
PCIe 카드가 두 장이고 모델이 한 장에 들어간다면:
- 팀이 쓴다면 서버를 두 개 띄웁니다(D1).
- 한 사람이 많이 쓴다면 모델을 나눠 올리고(D2), 한 사람용 설정을 씁니다.
- 둘 다 필요하다면 카드마다 역할을 나눕니다(한 장은 R3-1, 다른 한 장은 R3-32).
세 가지 모두 NVLink 없이 PCIe로만 이어진 카드에서 나온 결과입니다.
다음 편에서는 같은 모델과 같은 질문 96개를 SGLang에서 돌립니다. 바꾸는 것은 엔진 하나입니다. 엔진이 바뀌어도 복제와 분할의 답이 그대로인지 궁금하시면, 아래 뉴스레터로 다음 편을 받아 보실 수 있습니다.