작은 로컬 모델도 codemode를 할 수 있을까: Qwen3.5-9B는 코드로 30개 중 28개, 도구 호출로 19개를 맞혔습니다
Armin Ronacher는 모델이 도구를 하나씩 부르는 대신 도구를 부르는 코드를 쓰게 하는 codemode가 아직 작은 모델에서는 안 된다고 적었습니다. 가짜 이슈 트래커 위의 과제 30개로 Qwen3.5-4B, Qwen3.5-9B, Qwen3.8-27B를 llama.cpp에서 재 보니, codemode가 세 크기 모두에서 더 많이 맞혔습니다(22 대 18, 28 대 19, 30 대 26). 미리 정한 검정을 통과한 것은 9B의 차이 하나였고(p = 0.012), 그 차이의 대부분은 도구 호출 쪽 응답이 출력 상한 2,048토큰에서 잘린 데서 왔습니다. 두 방식이 모두 맞힌 과제에서 codemode의 과제당 토큰 중앙값은 도구 호출의 28-45%였습니다.
작은 로컬 모델도 codemode를 할 수 있을까: Qwen3.5-9B는 코드로 30개 중 28개, 도구 호출로 19개를 맞혔습니다
코딩 에이전트는 대개 모델에게 도구 여러 개를 주고 하나씩 부르게 합니다. 이슈 목록을 부르고, 결과를 읽고, 다음 도구를 부르고, 또 결과를 읽는 식입니다. Armin Ronacher의 "What is Codemode"(10월 6일)는 다른 방식을 설명합니다. 이름은 Cloudflare가 붙였다고 그가 밝혔습니다. 모델에게 코드를 실행하는 도구 하나만 주고, 그 코드 안에서 나머지 도구를 평범한 함수처럼 쓰게 합니다. 여러 쪽을 넘기는 반복, 결과 잇기, 걸러 내기를 모두 코드에서 하고, 코드가 출력한 것만 대화로 돌아옵니다.
글 끝에서 그는 아직 풀지 못한 문제로 "이 방식이 작은 모델에서는 되지 않는다(the inability of this pattern to work with smaller models)"를 꼽았습니다. 이 문장을 뒷받침하는 측정은 글에 없습니다. 로컬에서 돌리는 모델은 대부분 작은 모델이라(어떤 모델이 어떤 그래픽카드에 들어가는지는 Qwen 로컬 실행 가이드에 있습니다), 직접 재 봤습니다.
어떻게 쟀나
- 환경: 고정한 시드로 만든 가짜 이슈 트래커입니다. 이슈 240개와 팀 다섯 개에 나뉜 사용자 30명이 있습니다. 도구는 다섯 개입니다. 이슈 목록(한 쪽 20개, 상태와 라벨로 거르기), 이슈 하나 보기, 사용자의 이름과 팀 보기, 라벨 목록, 검색입니다.
- 과제: 정답이 정해진 질문 30개를 종류별로 10개씩 뒀습니다.
- 집계: 여러 쪽을 넘겨 세거나 더해야 합니다. 예: "bug 라벨이 붙은 열린 이슈 중 댓글이 5개 넘는 것은 몇 개인가"
- 연결: 이슈를 사용자의 팀과 이어야 합니다. 예: "platform 팀 사람이 연 열린 이슈는 몇 개인가"
- 단건: 한두 번 조회로 끝납니다. 예: "이슈 #42를 연 사람은 어느 팀인가"
- 두 방식:
- 도구 호출: 다섯 도구를 함수로 주고, 결과는 모두 대화에 넣습니다. 모델 호출은 40번까지입니다.
- codemode: run_python 도구 하나만 줍니다. 다섯 도구는 별도 파이썬 프로세스에 미리 정의된 함수로 들어 있고, 네트워크와 파일 쓰기는 막고 10초 제한을 뒀습니다. 출력된 것의 앞 4,000자만 돌아오며, 모델 호출은 10번까지입니다. Ronacher의 구현은 WASM 안의 자바스크립트이지만, 저희는 작은 모델이 더 익숙한 파이썬을 썼습니다.
- 두 시스템 프롬프트는 같은 도구 설명을 씁니다. codemode 쪽에는 "세기, 거르기, 잇기는 코드로 하라"는 지시가 더 있습니다. 그것이 이 방식의 핵심이기 때문이고, 도구 호출 쪽에는 이에 해당하는 지시가 없습니다.
- 모델: Unsloth의 Qwen3.5-4B Q4_K_M, Qwen3.5-9B Q4_K_M, Qwen3.8-27B UD-Q4_K_M GGUF입니다. llama.cpp
4da6337에서 temperature 0, 추론(생각 모드) 끔, 컨텍스트 32K, 응답 하나당 출력 최대 2,048토큰으로 돌렸습니다. - 채점: 모델은 마지막에
ANSWER: <값>으로 답하고, 대소문자·공백·쉼표를 맞춘 뒤 정답과 비교합니다. 이 줄이 없으면 틀린 것으로 셉니다. - 판정 규칙: 모델마다 두 방식을 과제별로 짝지어 McNemar 정확 검정을 하고, p < 0.05일 때만 차이가 있다고 봅니다.
환경, 과제, 프롬프트, 실행 코드, 규칙은 모델을 돌리기 전에 고정했습니다. 본 측정 전에 바꾼 것이 하나 있습니다. 과제 두 개로 한 스모크 테스트에서 9B가 codemode로 comments를 댓글 목록으로 짐작했는데, 실제로는 댓글 수라서 0으로 답했습니다. 도구 호출은 결과 JSON을 직접 보니 이런 실수를 할 수 없지만, codemode는 함수 설명만 봅니다. 그래서 두 방식이 같이 쓰는 함수 설명에 반환 구조를 더했습니다. Ronacher도 MCP에 대해 같은 이야기를 합니다. "MCP의 outputSchema가 그 용도로 아주 좋다(The outputSchema system in MCP is great for that)."
결과
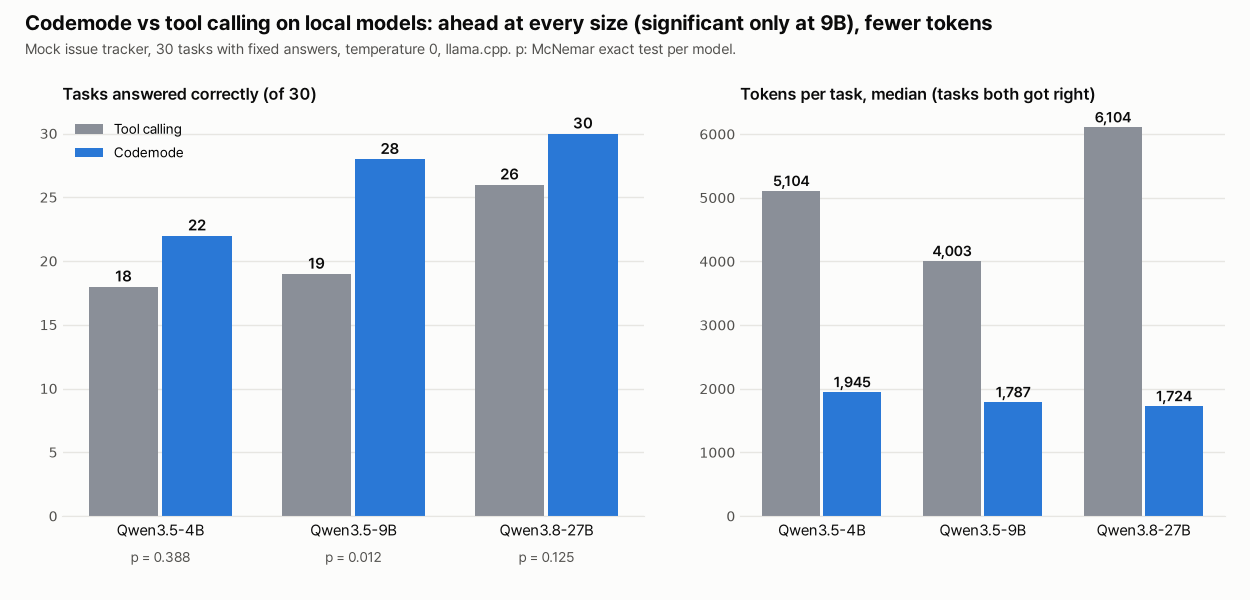
| 모델 | 도구 호출 | codemode | 도구 호출만 맞힘 | codemode만 맞힘 | p |
|---|---|---|---|---|---|
| Qwen3.5-4B | 18 | 22 | 4 | 8 | 0.388 |
| Qwen3.5-9B | 19 | 28 | 1 | 10 | 0.012 |
| Qwen3.8-27B | 26 | 30 | 0 | 4 | 0.125 |
이 과제들에서 작은 모델은 codemode에 실패하지 않았습니다. 세 크기 모두에서 codemode가 더 많이 맞혔습니다. 검정을 통과한 것은 9B의 차이였고, 4B와 27B는 과제 30개로는 두 방식을 가를 수 없었습니다. "작은 모델에서는 안 된다"가 맞다면 codemode가 유의하게 낮게 나와야 하는데, 그런 모델은 없었습니다.
모델이 작을수록 차이가 커지는지도 보려고 했지만, 그런 단순한 모양은 아니었습니다. codemode가 앞선 정도는 4B에서 4개, 9B에서 9개, 27B에서 4개였습니다.
과제 종류별로 나누면 이렇습니다.
| 모델 | 집계 | 연결 | 단건 |
|---|---|---|---|
| 4B, 도구 / 코드 | 6 / 8 | 2 / 7 | 10 / 7 |
| 9B, 도구 / 코드 | 7 / 9 | 2 / 10 | 10 / 9 |
| 27B, 도구 / 코드 | 8 / 10 | 8 / 10 | 10 / 10 |
차이는 연결 과제에서 났습니다. 도구 호출은 4B와 9B 모두 10개 중 2개를 맞혔고, codemode는 7개와 10개를 맞혔습니다.
도구 호출이 실패한 이유: 손으로 세다가 자리가 모자랐습니다
틀린 실행을 모두 나누면 이렇습니다.
| 모델, 방식 | 답이 틀림 | 응답 상한 2,048토큰에서 잘림 | 끝까지 썼지만 답 줄 없음 | 호출 한도 |
|---|---|---|---|---|
| 4B, 도구 | 4 | 8 | 0 | 0 |
| 4B, 코드 | 5 | 0 | 3 | 0 |
| 9B, 도구 | 3 | 8 | 0 | 0 |
| 9B, 코드 | 1 | 0 | 0 | 1 |
| 27B, 도구 | 4 | 0 | 0 | 0 |
| 27B, 코드 | 0 | 0 | 0 | 0 |
4B와 9B의 도구 호출 실패는 대부분 추론이 틀려서가 아니었습니다. 추론을 끈 상태에서 모델은 도구 호출로 데이터를 모은 뒤, 응답 본문에서 이슈를 하나씩 세어 나갔고, 목록 중간에 응답 상한 2,048토큰에 걸려 잘렸습니다. 9B에서 codemode만 맞힌 과제 10개 중 8개가 이렇게 잘린 도구 호출이었습니다. 그러니 9B의 결과는 이 상한에 크게 기대고 있습니다. 상한이 더 컸다면 일부는 끝까지 셌을 수 있는데, 그건 재지 않았습니다.
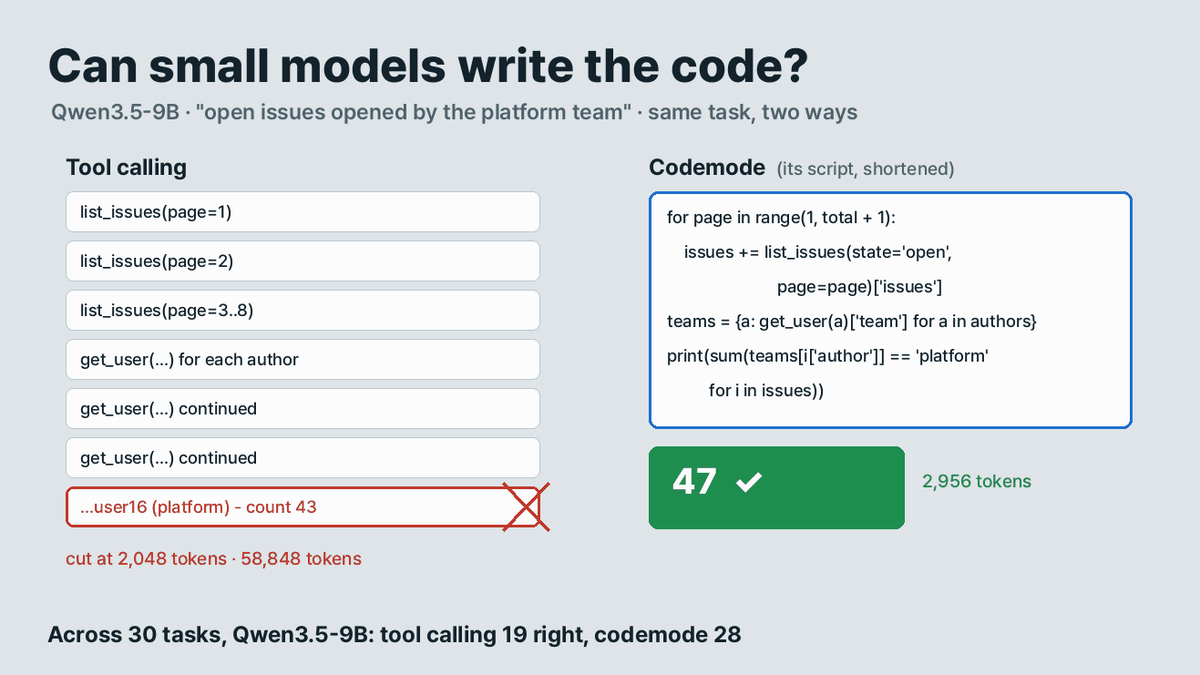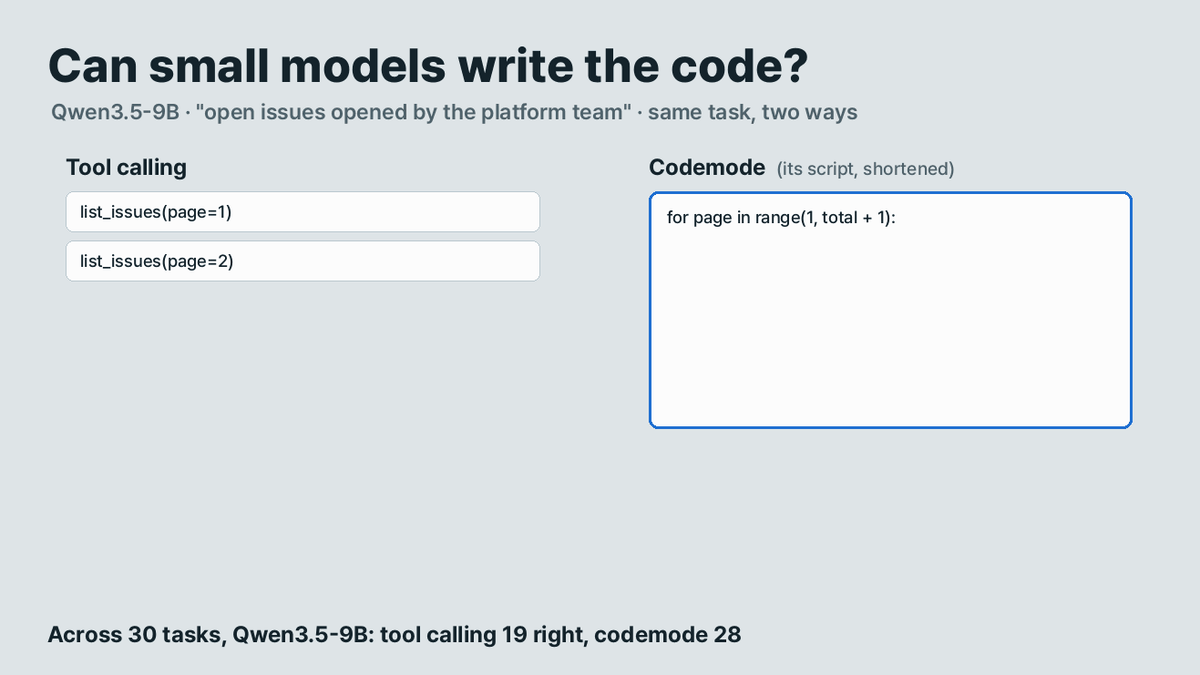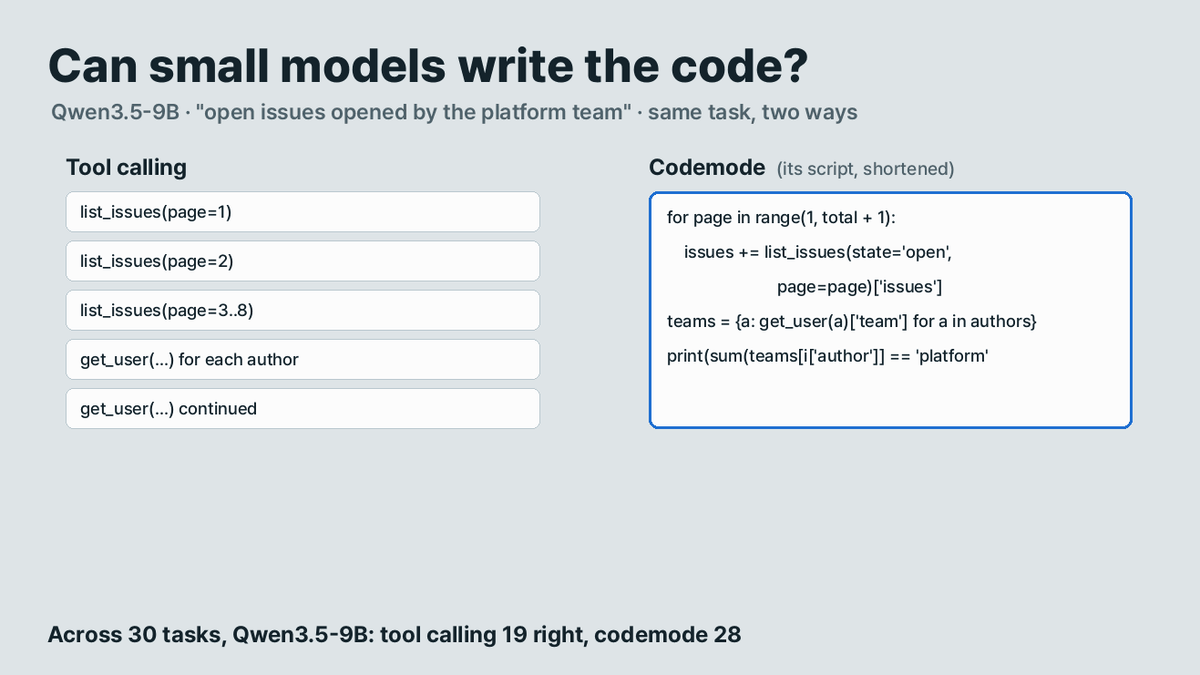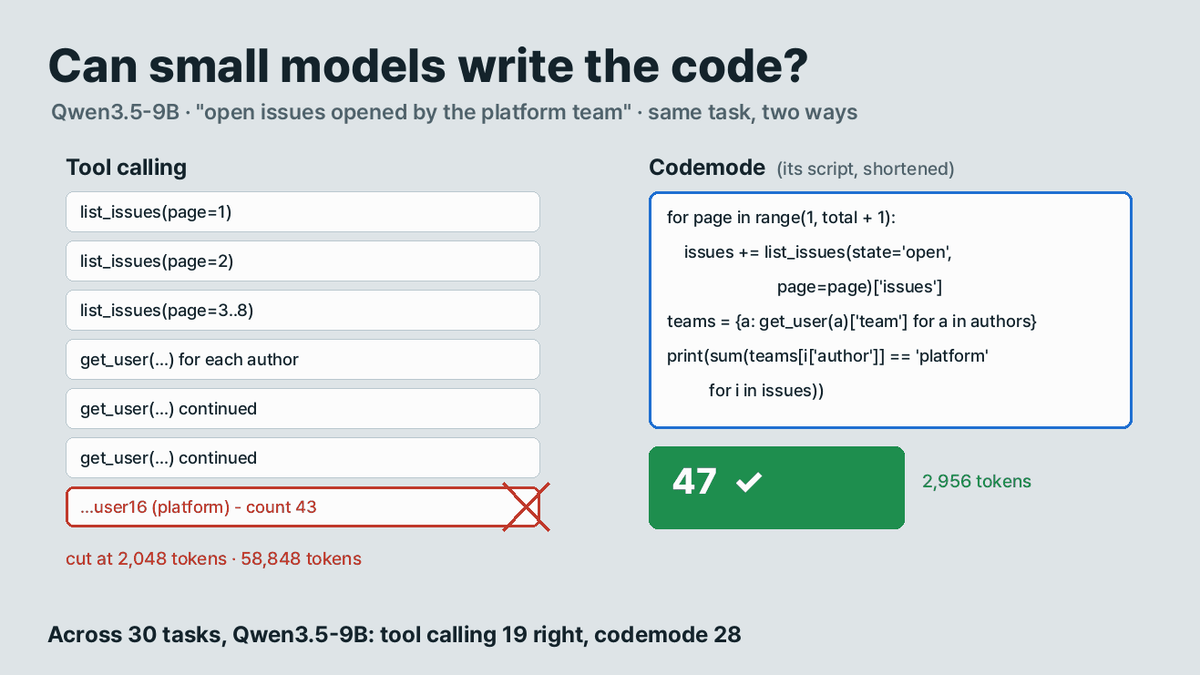
"platform 팀 사람이 연 열린 이슈는 몇 개인가"를 예로 들겠습니다. 열린 이슈는 8쪽에 걸쳐 150개이고, 사용자는 30명입니다. 도구 호출로 푼 9B는 8쪽을 다 가져오고 작성자마다 get_user를 부른 뒤, 응답 본문에서 이슈를 하나씩 짚어 나갔습니다. "user16 (platform) - count 43"까지 쓰고 끝에 닿기 전에 잘렸습니다. 모델 호출 7번에 걸쳐 쓴 토큰은 모두 58,848개였습니다.
codemode로 푼 같은 모델은 스크립트 하나를 썼습니다. 모든 쪽을 가져오고, 작성자를 모으고, 작성자마다 팀을 찾고, 맞는 이슈를 세서 숫자를 출력하는 코드입니다. 모델 호출 2번에 2,956토큰을 썼고, 정답 47을 냈습니다.
이 과제들에서 두 방식을 가른 것은 이 지점입니다. codemode에서는 세는 일을 코드가 하므로, 모델이 150개를 일일이 적을 필요가 없습니다.
codemode가 진 자리
단건 조회에서 4B는 도구 호출로 10개를 모두 맞혔지만 codemode로는 7개였습니다. 틀린 셋은 모두 답은 맞고 형식이 틀렸습니다. "The author of issue #42 is on the infra team."처럼 쓰고 ANSWER: 줄을 빠뜨렸습니다. 미리 정한 채점대로 이것은 틀린 것으로 셉니다. 9B와 27B는 codemode에서 이런 실패가 없었습니다.
결과를 본 뒤 추가한 느슨한 기준으로, 끝까지 쓴 응답이 ANSWER: 줄 없이 정답을 말한 경우를 맞은 것으로 세면 4B codemode가 22에서 25가 되고 나머지는 그대로입니다. 상한에서 잘린 응답은 답까지 가지 못했으니 여기서도 세지 않습니다.
토큰
두 방식이 모두 맞힌 과제의 중앙값으로 보면, codemode의 과제당 토큰은 도구 호출의 28-45%였습니다. 4B 1,945 대 5,104, 9B 1,787 대 4,003, 27B 1,724 대 6,104입니다. 모델마다 두 중앙값을 나눈 비율이라, 과제 하나하나의 비율은 이보다 넓게 퍼집니다. 이 값은 API가 청구하는 방식처럼 호출마다 입력과 출력을 모두 더한 것입니다. 도구 호출은 쪽마다 받은 결과를 대화에 넣고, 그 뒤 호출 때마다 다시 보냅니다. codemode는 쪽들을 코드 안에 두고 몇 줄만 돌려줍니다. 로컬에서 이것이 대기 시간으로 얼마나 이어지는지는 서버에 달려 있습니다. llama.cpp는 대화에서 바뀌지 않은 앞부분의 캐시를 다시 쓰고, 저희는 속도를 재지 않았습니다. 에이전트 대화가 작은 그래픽카드의 컨텍스트를 얼마나 빨리 채우는지는 8GB 컨텍스트 예산 글에 있습니다.
이 결과가 말하는 것과 말하지 않는 것
- 말하는 것: 답을 내려면 여러 쪽을 넘기고 결과를 이어야 하는 구조화된 조회에서는, 작은 로컬 모델도 코드를 쓰는 방식이 도구를 하나씩 부르는 방식보다 못하지 않았고 토큰도 훨씬 적게 썼습니다.
- 말하지 않는 것: codemode가 언제나 도구 호출보다 낫다는 뜻은 아닙니다. 저희 과제는 코드에 유리합니다. 정답이 딱 떨어지고, 데이터가 여러 쪽으로 나뉘어 있고, 잇는 일이 기계적입니다. 9B 차이의 상당 부분은 도구 호출 쪽이 손으로 세다가 출력 상한에 걸린 데서 왔습니다. Ronacher가 든 예에는 이미지 생성이나 출력이 들쭉날쭉한 MCP 서버도 있는데, 그런 경우는 재지 않았습니다.
- 4B는 codemode 단건 과제 세 개에서 답은 맞히고 형식을 놓쳤습니다. 9B와 27B에서는 없었습니다.
- 반환 타입도 인터페이스의 일부입니다. 반환 구조가 없을 때 9B는 codemode에서 필드의 타입을 잘못 짐작했습니다. 모델에게 코드로 도구를 쓰게 한다면 타입도 같이 주세요.
다루지 못한 것
- 가짜 환경 하나, 과제 30개, temperature 0으로 한 번씩입니다. 과제 30개로는 서너 개 차이를 가를 수 없습니다.
- 응답 하나당 출력 상한이 2,048토큰입니다. 4B와 9B의 도구 호출 실패 대부분이 이 상한에서 잘린 것이라, 상한을 키우거나 추론을 켜면 결과가 달라질 수 있습니다.
- Ronacher가 설명한 자바스크립트 샌드박스 대신 파이썬을 썼고, codemode 프롬프트에는 세는 일을 코드로 하라는 지시가 있습니다.
- Qwen 모델만, 추론을 끄고 쟀습니다.
- 반환 구조 추가는 스모크 테스트 뒤, 본 측정 전에 했습니다. 느슨한 집계는 결과를 본 뒤 추가했습니다.
계획, 환경, 과제, 프롬프트, 실행 코드와 모든 대화 기록은 아래 재현 패키지에 있습니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
codemode-small-models-repro.zip · 582 KB