OpenRouter로 Microsoft-Decision-1 쓰기: 첫날 직접 부딪힌 여섯 가지
Microsoft-Decision-1을 OpenRouter로 처음 붙이면서 겪은 것을 정리했습니다. 채팅 API가 아니라 System One 엔드포인트로 부르고, 선택지는 배열이 아니라 객체로 보내야 하며, confidence는 최고 확률과 다른 값입니다. 모델 ID에 날짜가 붙고, 요청 속도 제한이 걸리며, 같은 질문이 Jev에서는 3.5-4.8배 비쌌습니다. 바로 쓸 수 있는 파이썬 코드도 함께 실었습니다.
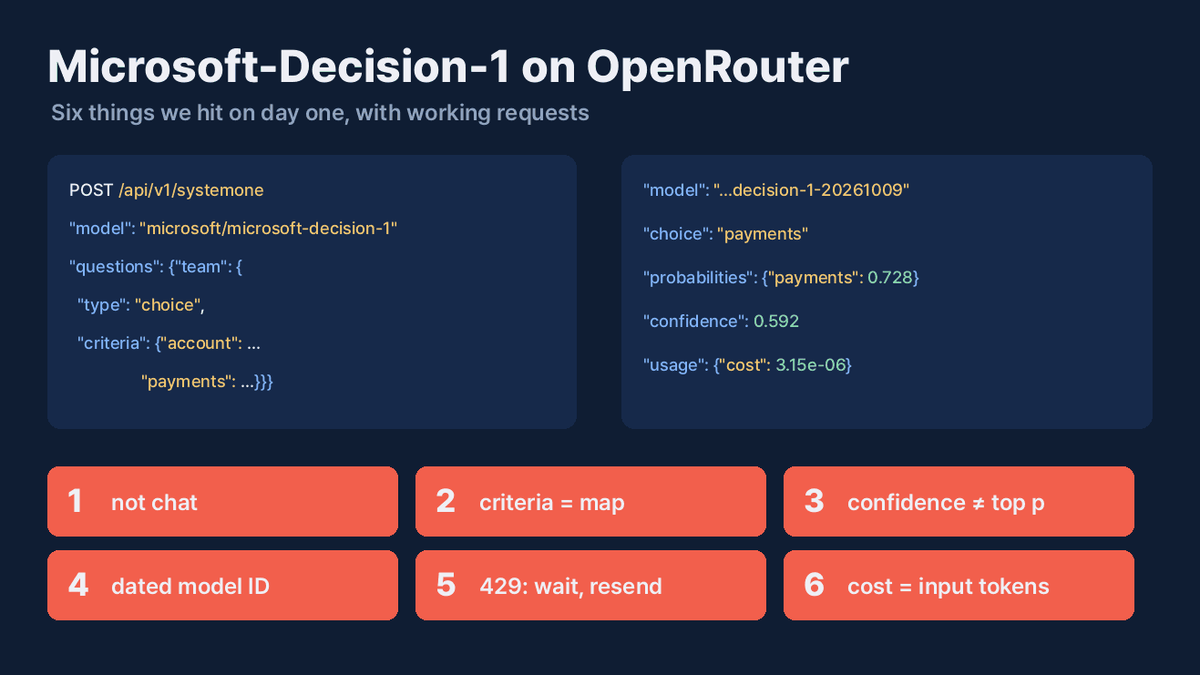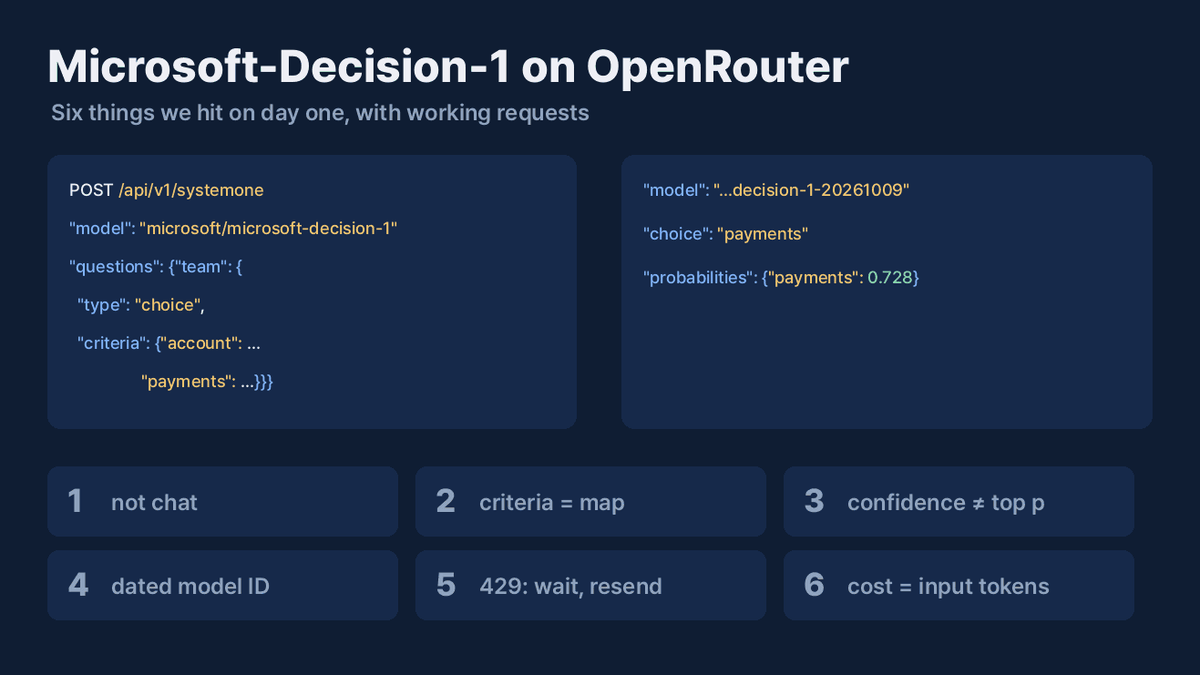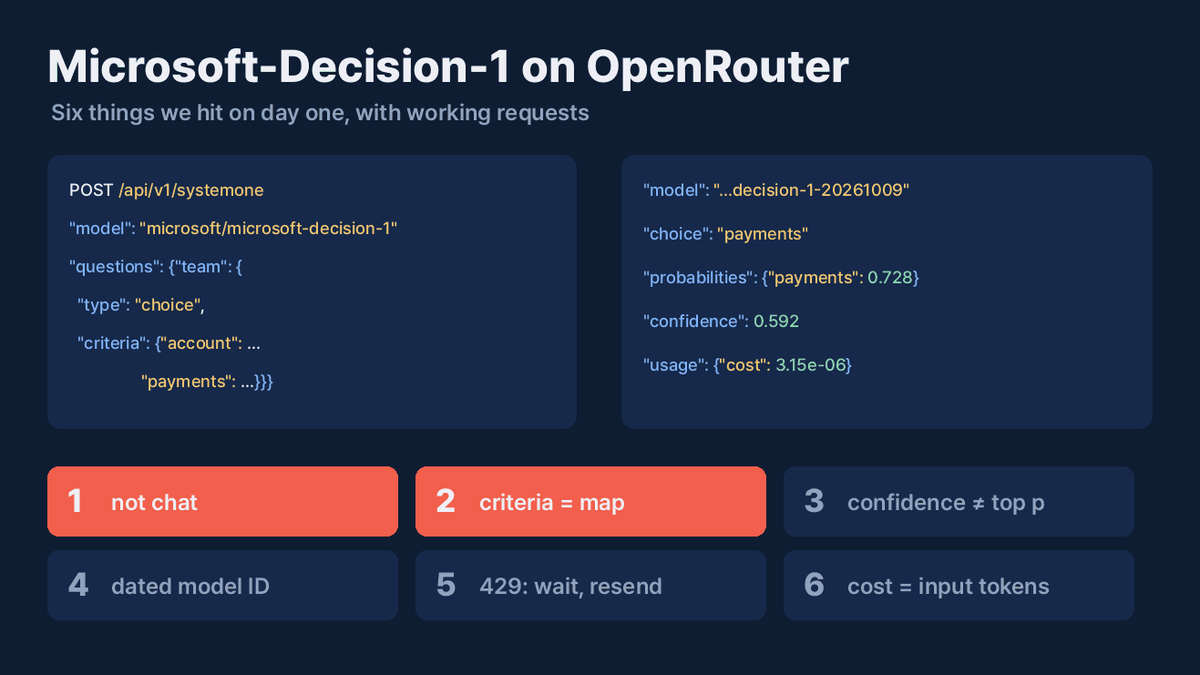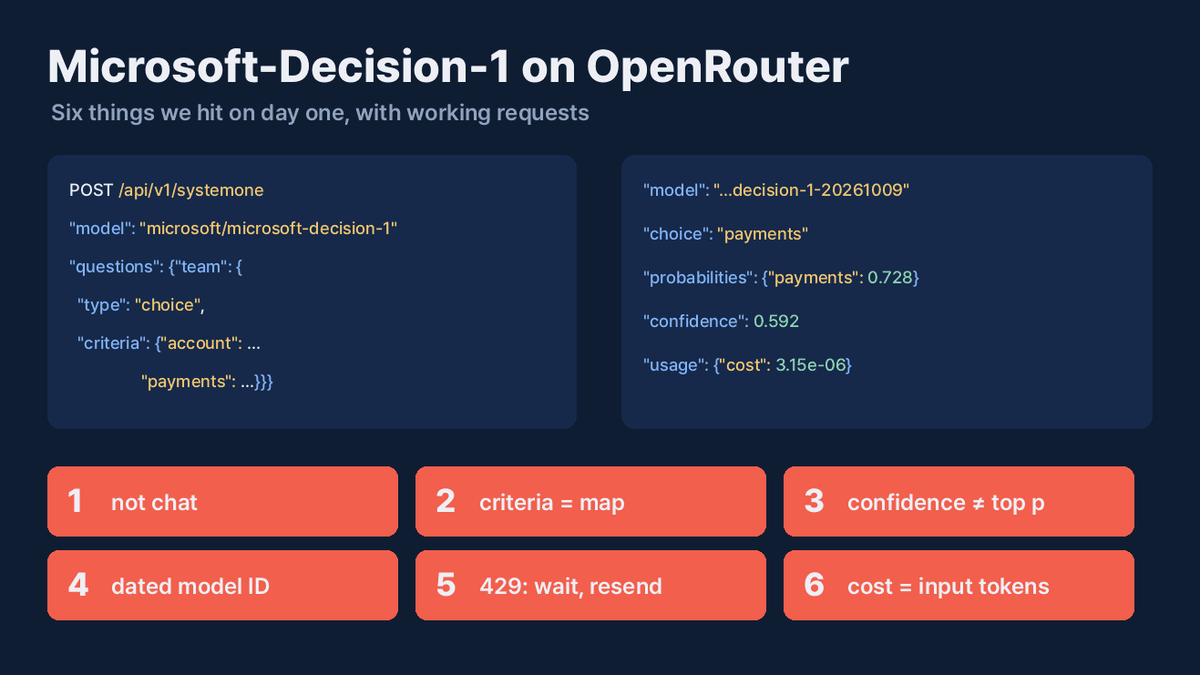
OpenRouter로 Microsoft-Decision-1 쓰기: 첫날 직접 부딪힌 여섯 가지
Microsoft가 10월 9일 Microsoft-Decision-1을 공개했습니다. 이 모델은 글을 쓰지 않습니다. 판단할 내용과 질문을 주고 질문마다 고를 수 있는 답을 정해 주면, 답마다 확률을 돌려줍니다. OpenRouter 모델 페이지는 이 값을 "보정된(calibrated) 확률"이라고 부르고, 이 확률로 애플리케이션이 바로 처리할지, 미룰지, 사람에게 검토를 맡길지 정할 수 있다고 설명합니다.
Microsoft Foundry와 OpenRouter 두 곳에서 쓸 수 있습니다. 저희는 이 모델을 측정하던 중이었고, Jev와 같은 키 하나로 부르고 싶어서 OpenRouter를 골랐습니다. 이 글은 첫날 실제로 보낸 요청과 받은 응답을 그대로 옮겨, 붙이는 과정에서 걸린 것들을 정리한 것입니다. 확률을 얼마나 믿어도 되는지 잰 결과는 따로 정리한 글에 있습니다.
1. 채팅 모델이 아니므로 System One 엔드포인트로 부릅니다
OpenRouter 모델 페이지에는 이 모델이 "OpenAI 호환 채팅 엔드포인트가 아니라 OpenRouter Decisions API에서 동작한다"고 적혀 있습니다. messages를 /chat/completions로 보내는 기존 코드로는 부를 수 없습니다. 저희는 OpenRouter의 System One 엔드포인트를 썼습니다. TypeSafe의 Jev API와 요청 형식이 같습니다.
curl https://openrouter.ai/api/v1/systemone \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "microsoft/microsoft-decision-1",
    "state": "My checkout page shows a blank screen after I click Pay. I have tried two browsers.",
    "questions": {
      "team": {
        "type": "choice",
        "instructions": "Which team should own this ticket?",
        "criteria": {
          "account": "Login, permissions, or profile issues.",
          "frontend": "Rendering, layout, or browser compatibility issues.",
          "payments": "Checkout, billing, or payment processing issues."
        }
      }
    }
  }'
돌아온 응답입니다.
{
  "model": "microsoft/microsoft-decision-1-20261009",
  "answers": {
    "team": {
      "type": "choice",
      "choice": "payments",
      "probabilities": {"account": 0.0038, "frontend": 0.2679, "payments": 0.7283},
      "confidence": 0.5924
    }
  },
  "usage": {"input_tokens": 75, "output_tokens": 1, "cost": 3.15e-06},
  "provider": "Azure"
}
여기서는 확률을 소수 넷째 자리까지만 옮겼습니다. 실제 응답은 자릿수를 자르지 않은 값입니다.
state에는 판단할 내용을 넣습니다. 문자열도 되고 JSON 객체도 됩니다. questions는 객체라서 요청 한 번에 질문을 여러 개 넣을 수 있습니다. 저희가 써 본 질문 형식은 세 가지입니다.
choice: 이름 붙인 선택지 중 하나를 고릅니다. 답에는choice,probabilities,confidence가 옵니다.noul: 예/아니오 질문입니다. 답은 "예"일 확률 숫자 하나입니다({"type": "noul", "noul": 0.9933}).instructions만 보내고criteria는 비워도 동작했습니다.score: 순서가 있는 단계를 고릅니다.criteria에 단계 설명을 배열로 넣습니다. 답에는 기댓값score(이 예에서는 0-2 단계 중 1.99), 단계별probabilities,legend,confidence가 옵니다.
OpenRouter 문서에는 TypeSafe의 파이썬·자바스크립트 SDK도 base URL만 https://openrouter.ai/api로 바꾸면 이 엔드포인트에 붙는다고 나옵니다. 저희는 SDK는 시험하지 않았고, 이 글의 예시는 모두 HTTP 요청을 직접 보낸 것입니다.
2. 선택지는 설명이 없어도 객체로 보냅니다
라벨만 있을 때는 "criteria": ["account", "frontend", "payments"]처럼 배열로 보내고 싶어집니다. OpenRouter는 이 요청을 HTTP 400으로 거절했습니다.
"expected": "record", "code": "invalid_type", "path": ["questions", "team", "criteria"],
"message": "Invalid input: expected record, received array"
설명을 비운 객체로 보내면 됩니다({"account": null, "frontend": null, "payments": null}). 저희 측정에서 이 형식으로 Decision-1에 700건을 보냈고 거절된 요청은 없었습니다. 배열은 단계 순서 자체가 의미인 score에서만 씁니다.
설명은 쓸 수 있으면 쓰는 편이 좋습니다. 선택지 이름과 설명이 함께 모델 입력에 들어갑니다. 비슷한 공개 모델로 저희가 시험했을 때는 이름이 설명과 어긋나면 설명보다 이름이 답을 훨씬 크게 흔들었습니다.
3. `confidence`는 최고 확률과 다른 값입니다
위 응답에서 고른 답의 확률은 0.728인데 confidence는 0.592였습니다. 질문 세 개를 한 번에 보낸 요청에서도 payments 확률은 0.795, confidence는 0.693이었습니다. score 질문에서는 가장 높은 단계의 확률이 0.993, confidence가 0.990이었습니다.
Microsoft 글과 OpenRouter 페이지 어디에도 confidence를 어떻게 계산하는지는 나와 있지 않습니다. 요청 형식이 같은 공개 모델 decider-4b를 서빙하는 decider-ai 패키지(1.6.0, decider/systemone.py)를 보면, confidence는 TypeSafe 방식의 신뢰도이고 가장 큰 확률은 x_p_max로 따로 돌려줍니다. Decision-1이 같은 식을 쓰는지는 알 수 없습니다. 계산식이 무엇이든 실무에서 챙길 것은 같습니다. "0.9가 넘으면 바로 처리한다" 같은 규칙을 쓴다면, 두 숫자 중 어느 쪽을 기준으로 삼는지 정하고 로그에 남겨야 합니다. 한쪽에 맞춘 임계값은 다른 쪽에 그대로 옮겨 쓸 수 없습니다. 저희 측정에서는 최고 확률을 썼습니다.
4. 모델 ID에 날짜가 붙고, 가중치는 바뀝니다
요청에는 microsoft/microsoft-decision-1을 넣었는데 응답에는 microsoft/microsoft-decision-1-20261009가 옵니다. OpenRouter 페이지에 이유가 있습니다. "Weights are updated continually while the API shape stays the same." 가중치는 계속 갱신되고, API 모양만 그대로 유지된다는 뜻입니다.
Jev도 마찬가지입니다. typesafe/jev-1.13으로 보내면 typesafe/jev-1.13-20260917이 돌아옵니다.
그래서 저희 쪽에서 아무것도 바꾸지 않아도, 다음 달에는 같은 요청에 다른 확률이 나올 수 있습니다. 버전이 같아도 흔들렸습니다. 같은 요청 500개를 두 번 보냈더니 Decision-1의 확률이 439개에서 달랐습니다. 차이의 중앙값은 0.0004, 가장 큰 차이는 0.060이었고, 답이 하나 바뀌었습니다. 저희는 응답의 model 값을 행마다 저장하고, 이 값이 같은 결과끼리만 비교했습니다. 이 모델로 임계값을 맞췄다면 어느 날짜 버전으로 맞췄는지도 함께 적어 두는 편이 안전합니다.
5. 요청 속도 제한이 걸리니, 기다렸다가 다시 보냅니다
측정 중에 일부 요청이 OpenRouter 뒤의 Azure 배포에서 HTTP 429로 돌아왔습니다. 메시지는 "Your requests to Microsoft-Decision-1 ... have exceeded request rate limit."였습니다. 측정 전체에서 Decision-1로 보낸 요청 4,236건 중 36건이 429를 받았고, 같이 보낸 Jev는 한 건도 받지 않았습니다. 36건 모두 다시 보내 통과했고, 가장 오래 걸린 요청은 네 번 다시 보낸 끝에 통과했습니다. 처음 시험할 때는 곧바로 다시 보낸 두 번이 모두 같은 제한에 걸렸고, 몇 초 기다렸다 보내니 통과했습니다.
파이썬 표준 라이브러리만 쓰는 최소 예제입니다. 429만 처리합니다. 응답에 Retry-After가 초 단위로 오면 그대로 따르고, 없으면 지수 백오프에 무작위 지연을 섞어 기다립니다. (저희 429 응답에 Retry-After가 있었는지는 기록하지 않았습니다. 측정 실행기는 2, 4, 8, 16, 32, 60초를 기다렸습니다.) 다른 오류, 시간 초과, 연결 실패는 직접 처리해야 합니다.
import json, os, random, time, urllib.request, urllib.error

URL = "https://openrouter.ai/api/v1/systemone"
KEY = os.environ["OPENROUTER_API_KEY"]

def decide(state, questions, model="microsoft/microsoft-decision-1", max_tries=6):
    """최소 예제: HTTP 429만 다시 보내고, 다른 오류는 그대로 올립니다."""
    body = json.dumps({"model": model, "state": state, "questions": questions}).encode()
    for attempt in range(max_tries):
        req = urllib.request.Request(URL, data=body, headers={
            "Authorization": "Bearer " + KEY, "Content-Type": "application/json"})
        try:
            with urllib.request.urlopen(req, timeout=60) as r:
                return json.loads(r.read())  # res["model"]에 답한 버전(날짜)이 있으니 함께 저장
        except urllib.error.HTTPError as e:
            if e.code != 429:
                raise  # 400은 요청 형식 문제라 다시 보내도 같음
            after = e.headers.get("Retry-After", "")
            if after.isdigit():
                wait = int(after)  # 서버가 알려 준 대기 시간
            else:
                wait = min(60, 2 ** (attempt + 1)) * random.uniform(0.5, 1.0)  # 지수 백오프 + 무작위 지연
            time.sleep(wait)
    raise RuntimeError("여러 번 기다려도 속도 제한이 풀리지 않음")

res = decide("I was charged twice for my subscription.",
             {"refund": {"type": "noul", "instructions": "Is the customer asking for money back?"}})
print(res["model"], res["answers"]["refund"]["noul"])
같은 모델로 보내는 요청 사이에는 1초 간격도 두었습니다. 그래도 429는 없어지지 않았고, 간격이 429를 줄였는지는 따로 시험하지 않았습니다. 이렇게 하나씩 보내니 측정 실행의 8,400건(두 모델 합계)이 1시간 50분쯤 걸렸습니다. 시간당 4,600건 안팎입니다. 병렬로 보낸다고 제한이 풀리지는 않습니다. 더 많이 처리해야 한다면 계정과 제공자의 제한을 먼저 확인하고, 같은 백오프를 둔 채 동시 요청 수를 작게 제한해서 늘리시기 바랍니다.
6. 비용은 입력 토큰으로만 매기고, 같은 질문도 Jev에서는 더 비쌉니다
10월 10일 기준 OpenRouter의 Decision-1 가격은 입력 100만 토큰당 0.042달러, 출력은 0달러입니다. 응답마다 usage.cost가 함께 오는데, 저희가 받은 성공 응답 8,419건(두 모델 합계로, 측정 실행 8,400건에 실행기 시험과 이 가이드 예시 19건을 더한 수) 모두에서 "입력 토큰 × 100만 토큰당 0.042달러"와 정확히 같았습니다. 위 티켓 질문은 입력 75토큰에 0.00000315달러였습니다.
이 단가라면 입력 125토큰쯤 되는 요청 한 건이 0.00000525달러이고, 10만 건이면 약 0.53달러입니다(125 × 100,000 × 0.042달러 ÷ 1,000,000).
Jev 1.13도 같은 엔드포인트에서 같은 가격으로 부를 수 있습니다. model만 typesafe/jev-1.13으로 바꾸면 됩니다. 그런데 같은 요청인데도 Jev 쪽 입력 토큰이 더 많이 잡혔습니다. 티켓 질문은 입력 360토큰에 0.0000151달러로 Decision-1의 4.8배쯤이었고(Jev의 usage에는 출력 토큰도 38개처럼 잡히지만 Decision-1은 1개, 출력 단가가 0이라 비용에는 영향이 없습니다), 저희 분류 요청에서는 434토큰 대 125토큰으로 3.5배쯤이었습니다. 같은 텍스트인데 Jev가 왜 토큰을 더 많이 세는지는 응답에 나오지 않아 알 수 없습니다. 두 모델을 비용으로 비교한다면 가격표가 아니라 응답의 usage.cost로 비교해야 합니다.
같은 응답에서 차이가 하나 더 보였습니다. Jev는 확률을 소수 둘째 자리로 반올림해 돌려주고("frontend": 0.15, "account": 0), Decision-1은 자르지 않은 값을 돌려줍니다. 로그 손실처럼 작은 확률이 필요한 계산을 한다면, 반올림돼 0으로 온 값에 하한을 정해야 합니다.
확률대로 바로 처리하기 전에
여기까지는 응답을 제대로 받는 방법입니다. 그 확률을 믿고 애플리케이션이 사람 없이 처리하게 해도 되는지는 다른 문제입니다. 라벨을 어떻게 붙였는지, 어떤 데이터인지, 두 숫자 중 무엇을 기준으로 삼는지에 따라 답이 달라집니다. 정답이 있는 질문 700개로 이를 잰 결과는, 선택지 이름과 설명이 서로 어긋나는 경우까지 포함해 함께 쓴 측정 글에 정리했습니다.