llama.cpp 새 FP8 KV 캐시, q8_0에서 바꿔야 할까: Qwen3-8B·Llama 3.1 8B 실측
f8_e4m3는 q8_0보다 캐시가 6% 작지만, 출력이 f16에서 멀어지는 정도는 q8_0의 8-10배였고 A100에서 32K 깊이 생성 속도는 12-13% 느렸습니다. GGUF에 KV 배율이 없으면 q8_0을 유지하세요.
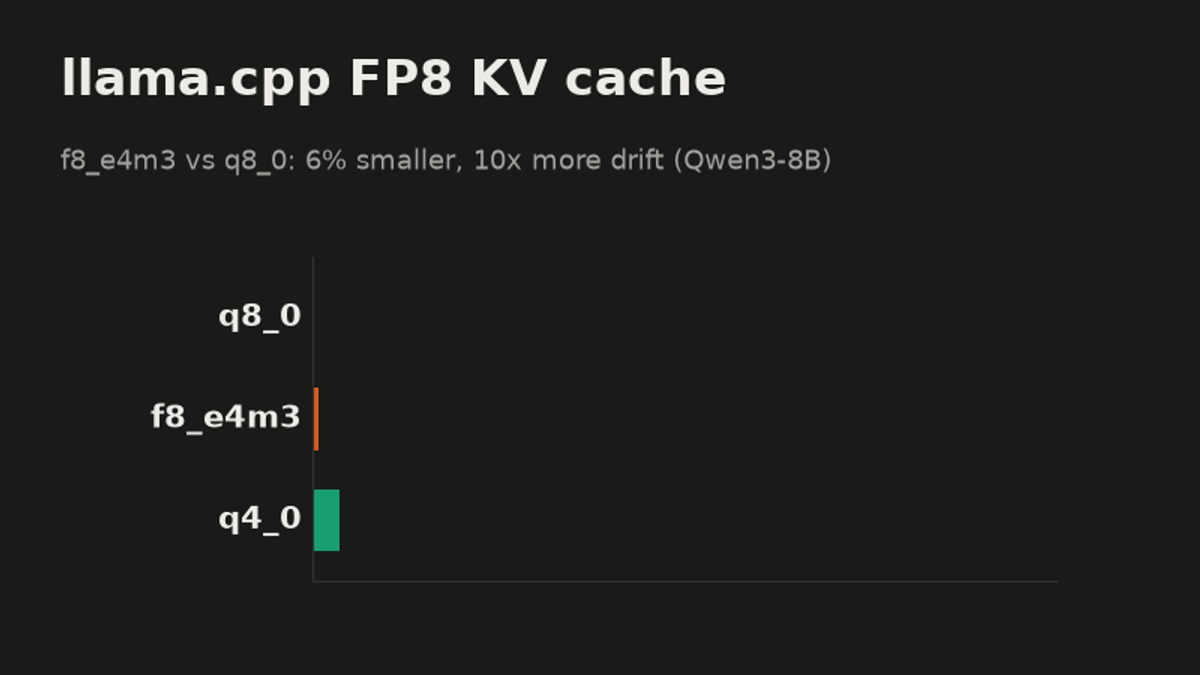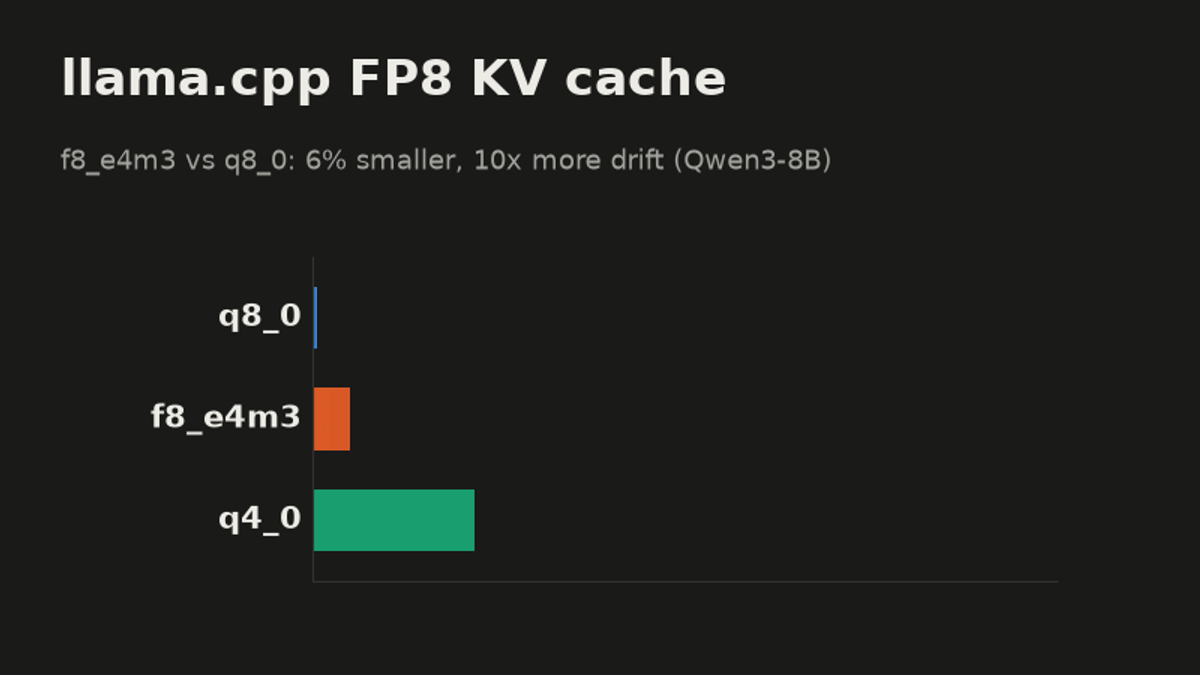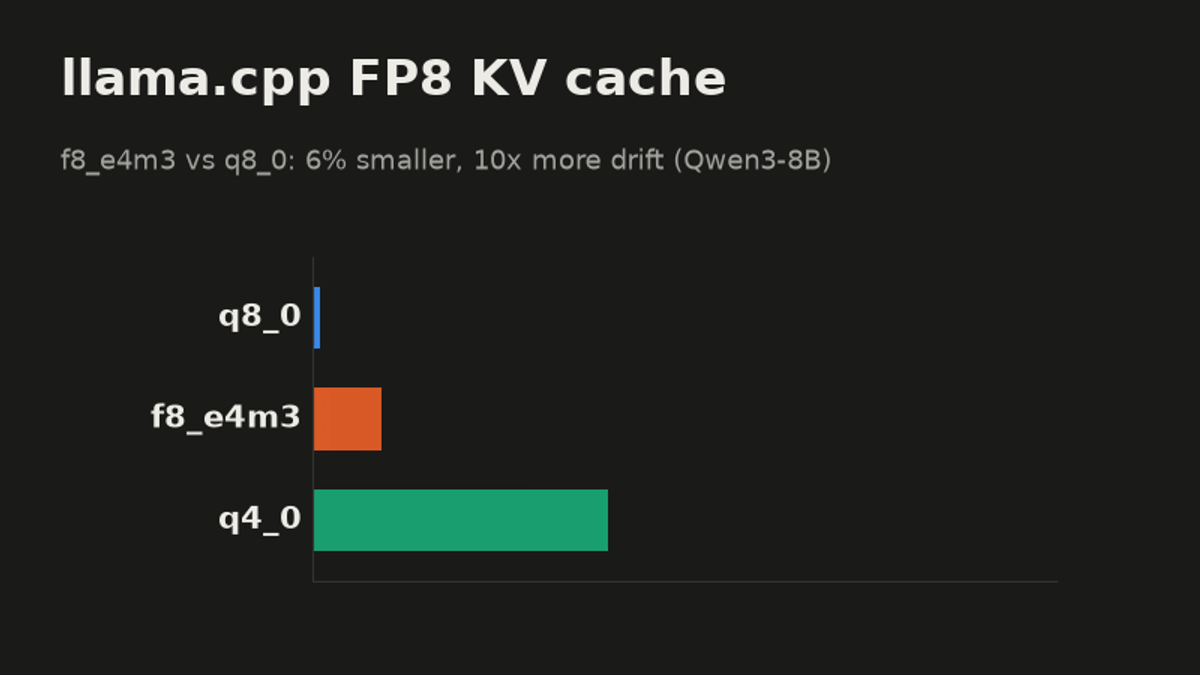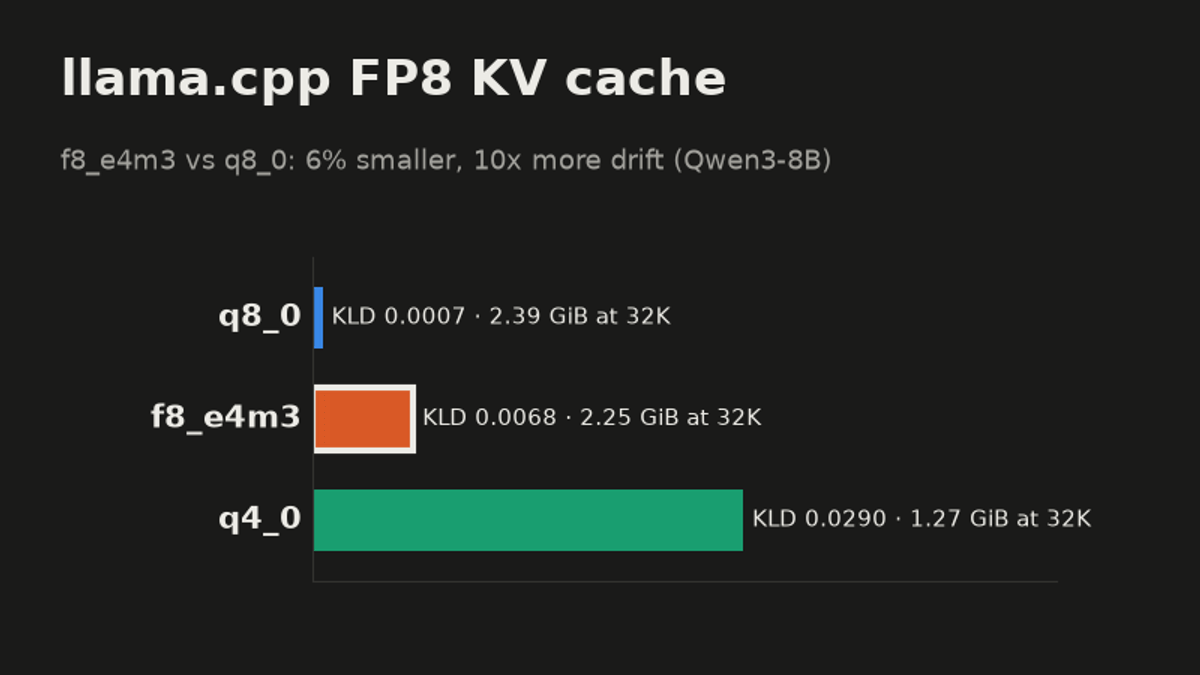
결론부터 말씀드리면, 지금 -ctk q8_0 -ctv q8_0을 쓰고 계신다면 그대로 두시는 편이 낫습니다. 8B 모델 두 개로 재 보니 새 캐시 타입 f8_e4m3가 q8_0보다 줄여 준 메모리는 6%였습니다. Qwen3-8B에서 32K 토큰 기준 144MiB입니다. 그 대신 모델의 다음 토큰 예측은 f16 캐시에서 8-10배 더 멀어졌고, 캐시에 32K 토큰이 차 있을 때 A100에서 생성 속도가 12-13% 느렸습니다. 품질은 q8_0과 q4_0 사이, 크기는 q8_0과 거의 같은 자리입니다.
FP8 캐시가 "메모리를 절반으로 줄인다"는 이야기는 f16과 비교한 숫자입니다. q8_0과 비교하면 이야기가 완전히 달라지는데, 왜 그런지부터 보겠습니다.
같은 8비트인데 왜 다를까
llama.cpp는 빌드 b12274(풀 리퀘스트 #28392)부터 KV 캐시 타입으로 f8_e4m3를 받습니다. 저희는 b12307로 시험했습니다.
KV 캐시는 이미 읽은 토큰마다 키(key)와 값(value) 벡터를 저장해 두는 곳입니다. 다음 토큰을 만들 때 어텐션이 이 캐시를 처음부터 끝까지 다시 읽습니다. 문맥이 길어질수록 커지기 때문에 다들 줄이려고 합니다. q8_0과 f8_e4m3는 둘 다 숫자 하나에 1바이트를 쓰지만, 그 1바이트를 쓰는 방식이 다릅니다. KV 캐시 양자화가 처음이시라면 llama.cpp KV 캐시 양자화 가이드에서 기본부터 보실 수 있습니다.
이름에 형식이 그대로 적혀 있습니다. q8_0의 q는 양자화(quantization), 8은 숫자당 비트 수이고, _0은 묶음마다 배율 하나만 두는 llama.cpp의 묶음 방식이라는 뜻입니다(_1이 붙은 타입은 최솟값도 함께 둡니다). f8_e4m3의 f8은 8비트 부동소수점, e4m3는 지수(exponent) 4비트와 가수(mantissa) 3비트라는 뜻입니다.
q8_0은 숫자를 32개씩 묶습니다. 묶음마다 가장 큰 값에 맞춘 16비트 배율(scale)을 하나 두고, 각 숫자는 -127부터 127까지의 정수로 바꿔 그 배율을 곱해 씁니다. 반올림 오차는 많아야 한 칸의 절반, 즉 묶음 최댓값의 약 0.4%입니다. 대신 배율 몫이 붙어서 숫자 32개에 34바이트, 숫자 하나에 8.5비트가 듭니다.
f8_e4m3는 숫자 하나하나를 아주 작은 부동소수점으로 씁니다. 부호 1비트, 지수 4비트, 가수 3비트입니다. 가수가 3비트뿐이라 이웃한 두 값의 간격이 상대적으로 12.5%이고, 반올림하면 원래 값의 6% 가까이 어긋날 수 있습니다. 담을 수 있는 가장 큰 값은 448입니다. 묶음 배율이 없으니 숫자 하나에 정확히 8비트입니다.
정리하면 f8_e4m3는 배율을 빼서 숫자당 0.5비트를 아끼고, 그 대가로 숫자마다 더 거칠게 반올림합니다.
이걸 보완하는 장치는 있습니다. GGUF 파일에 층마다 k_scale, v_scale 텐서가 들어 있으면 llama.cpp가 이를 읽어 값을 FP8 범위에 맞게 늘려 담습니다. 다만 선택 사항이고, 지금 흔히 받는 GGUF에는 없습니다. 이번에 쓴 두 모델 파일에도 없었습니다. 배율이 없으면 키와 값이 그대로 FP8에 들어갑니다.
켜는 방법
# q8_0과 같은 두 플래그, K와 V는 같은 타입으로
llama-server -m model.gguf -ngl 99 -fa on -ctk f8_e4m3 -ctv f8_e4m3 -c 32768
켜기 전에 알아 둘 점이 세 가지 있습니다.
- 기본 CUDA 빌드에서는 K와 V를 둘 다
f8_e4m3로 맞춰야 합니다. 기본GGML_CUDA_FA_QUANTS목록에는f8_e4m3끼리의 flash attention 커널만 있고, FP8이 섞인 조합은 들어 있지 않습니다. - 일부 구조는 불러올 때 거부합니다. MLA 어텐션을 쓰는 모델과 DeepSeek·GLM 계열 일부 구조는 코드에서 FP8 캐시를 막습니다. 소스 코드에 그렇게 들어 있습니다.
- 최신 빌드가 필요합니다. b12274보다 오래된 빌드는 이 타입을 모릅니다.
실험 조건
- llama.cpp b12307(
4180722ee), sm80용 CUDA 빌드, A100 80GB 한 장. A100에는 FP8 텐서 코어가 없어서 FP8 값을 소프트웨어로 변환합니다. - Qwen3-8B Q4_K_M(36층)과 Meta-Llama-3.1-8B-Instruct Q4_K_M(32층). 둘 다 KV 헤드 8개, 헤드 크기 128입니다.
- K와 V는 항상 같은 타입,
-fa on -ngl 99. - 품질은 wikitext-2 테스트 세트에
llama-perplexity를 4,096토큰 창 40개로 돌렸습니다.f16캐시의 출력을 먼저 저장하고, 나머지 타입을 모두 그것과 비교했습니다. - 속도는
llama-bench -p 4096 -n 128 -d 0,8192,32768 -r 2입니다.
아래 숫자는 모두 카드 한 장, 모델 두 개에서 나온 값입니다. 속도 순위는 카드마다 다를 수 있습니다. 메모리는 비트 수로 정해지는 값이라 어느 카드에서나 같습니다.
메모리: q8_0보다 6% 작습니다
-c 32768, 슬롯 하나로 llama-server를 띄웠을 때 로그에 찍힌 KV 버퍼 크기입니다.
| 캐시 타입 | Qwen3-8B | Llama 3.1 8B | f16 대비 |
|---|---|---|---|
| f16 | 4,608MiB | 4,096MiB | 100% |
| q8_0 | 2,448MiB | 2,176MiB | 53% |
| f8_e4m3 | 2,304MiB | 2,048MiB | 50% |
숫자당 16비트, 8.5비트, 8비트라는 계산과 정확히 맞습니다. Qwen3-8B에서 q8_0을 f8_e4m3로 바꾸면 32K 기준 144MiB가 빕니다.
그중 일부는 다른 곳에서 다시 씁니다. llama-server가 캐시 옆에 잡아 두는 계산 버퍼가 두 모델 모두 q8_0에서 200MiB, f8_e4m3에서 208MiB였습니다(f16은 136MiB와 148MiB). Qwen3-8B에서 실제로 남는 것은 136MiB입니다.
품질: perplexity만 보면 차이가 가려집니다
보통은 perplexity로 품질을 봅니다. 그런데 Qwen3-8B에서는 이 지표가 거꾸로 말했습니다. f8_e4m3 캐시의 perplexity는 f16보다 오히려 0.20% 낮았고, q8_0은 0.01% 높았습니다. 이것만 보면 FP8이 압축하지 않은 캐시보다도 낫다는 말이 됩니다. Llama 3.1 8B에서는 perplexity도 순서를 제대로 보여 줬습니다(+0.32%와 +0.02%). 늘 틀리는 지표는 아니지만, 어느 쪽 경우인지 미리 알 수 없다는 것이 문제입니다.
perplexity는 정답 단어에 준 확률을 평균한 값입니다. 어떤 예측은 올라가고 어떤 예측은 내려가면 평균에서 서로 상쇄될 수 있습니다. KL 발산(KLD)은 상쇄를 허용하지 않습니다. 위치마다 다음 토큰 확률 분포 전체가 f16 캐시의 분포에서 얼마나 멀어졌는지를 재고, 그 값을 평균합니다. "첫 번째 후보 일치율"은 더 단순합니다. 모델이 가장 높게 친 토큰이 f16과 같은 위치의 비율입니다.
비교 기준으로 q4_0도 함께 쟀습니다. q4_0 캐시는 숫자당 4.5비트라 Qwen3-8B 32K에서 1.27GiB로 계산됩니다.
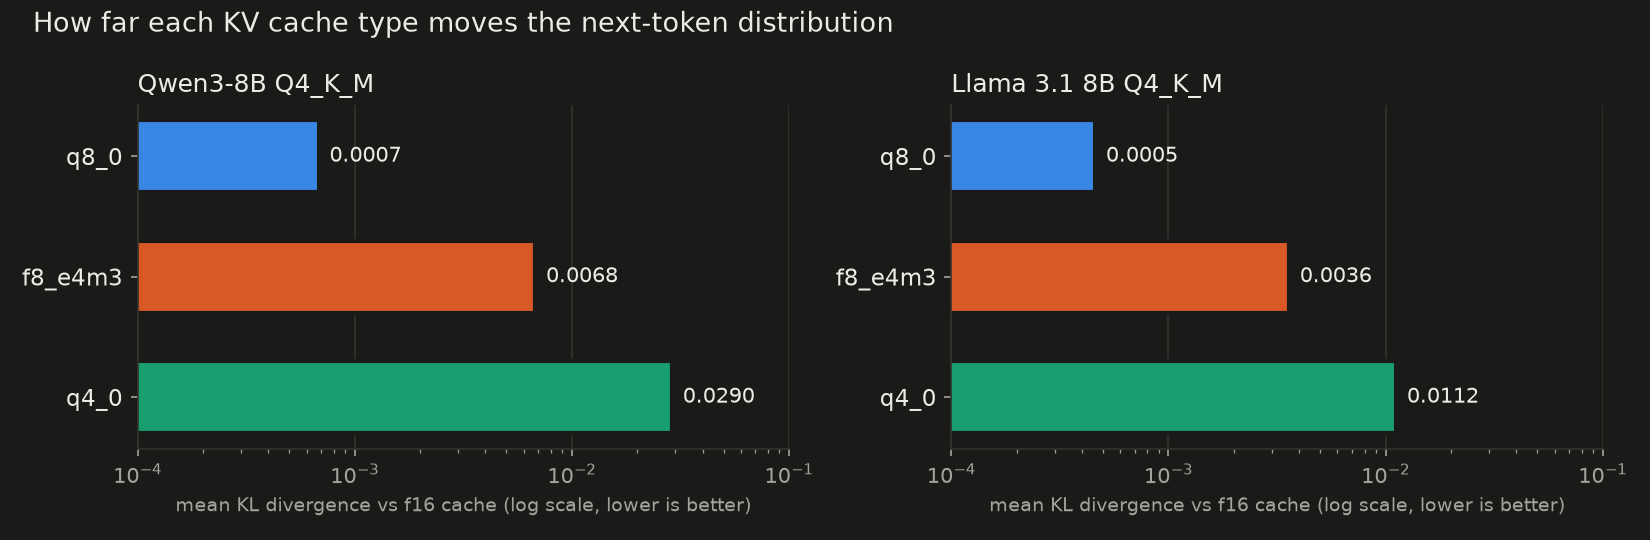
| 평균 KLD | 상위 1% KLD | 첫 후보 일치율 | f16 대비 perplexity | |
|---|---|---|---|---|
| Qwen3-8B | ||||
| q8_0 | 0.00068 | 0.0056 | 98.87% | +0.01% |
| f8_e4m3 | 0.00679 | 0.0562 | 96.66% | -0.20% |
| q4_0 | 0.02895 | 0.2684 | 93.45% | +0.55% |
| Llama 3.1 8B | ||||
| q8_0 | 0.00046 | 0.0032 | 98.92% | +0.02% |
| f8_e4m3 | 0.00359 | 0.0263 | 97.21% | +0.32% |
| q4_0 | 0.01119 | 0.0862 | 95.18% | +1.14% |
FP8 캐시는 Qwen3-8B에서 q8_0의 약 10배, Llama 3.1 8B에서 약 8배만큼 출력을 움직였습니다. 두 모델 모두 q8_0과 q4_0 사이입니다. 평균 KLD로 보면 q4_0보다 3.1-4.3배 f16에 가깝고, 메모리는 q4_0의 약 1.8배를 씁니다.
첫 후보 일치율이 가장 와닿는 숫자입니다. q8_0은 약 90개 위치 중 하나에서 첫 후보가 f16과 달라집니다. FP8은 Qwen3-8B에서 약 30개 중 하나, Llama 3.1 8B에서 약 36개 중 하나입니다.
저희는 Llama 3.1이 더 크게 흔들릴 거라고 봤습니다. Qwen3는 쿼리와 키에 정규화를 한 번 더 거는데 Llama 3.1은 그렇지 않아서, 키 값이 더 커질 수 있다고 생각했기 때문입니다. 결과는 반대였습니다. 평균 KLD로도, 첫 후보 일치율로도 Llama 3.1 쪽이 덜 흔들렸습니다.
속도: 프롬프트 처리는 FP8이 조금 빠르고, 캐시가 찰수록 생성이 느립니다
A100 80GB, 초당 토큰 수입니다.
| f16 | q8_0 | f8_e4m3 | q8_0 대비 f8 | |
|---|---|---|---|---|
| Qwen3-8B, 프롬프트 4096 처리 | ||||
| 빈 캐시 | 4,672 | 4,555 | 4,629 | +1.6% |
| 캐시 32K | 2,358 | 2,261 | 2,316 | +2.5% |
| Qwen3-8B, 생성 | ||||
| 빈 캐시 | 149.6 | 146.1 | 144.1 | -1.4% |
| 캐시 8K | 132.6 | 111.8 | 104.8 | -6.3% |
| 캐시 32K | 103.5 | 67.7 | 59.2 | -12.5% |
| Llama 3.1 8B, 생성 | ||||
| 빈 캐시 | 157.7 | 153.9 | 152.1 | -1.1% |
| 캐시 8K | 141.1 | 119.2 | 111.9 | -6.1% |
| 캐시 32K | 111.1 | 73.8 | 64.4 | -12.7% |
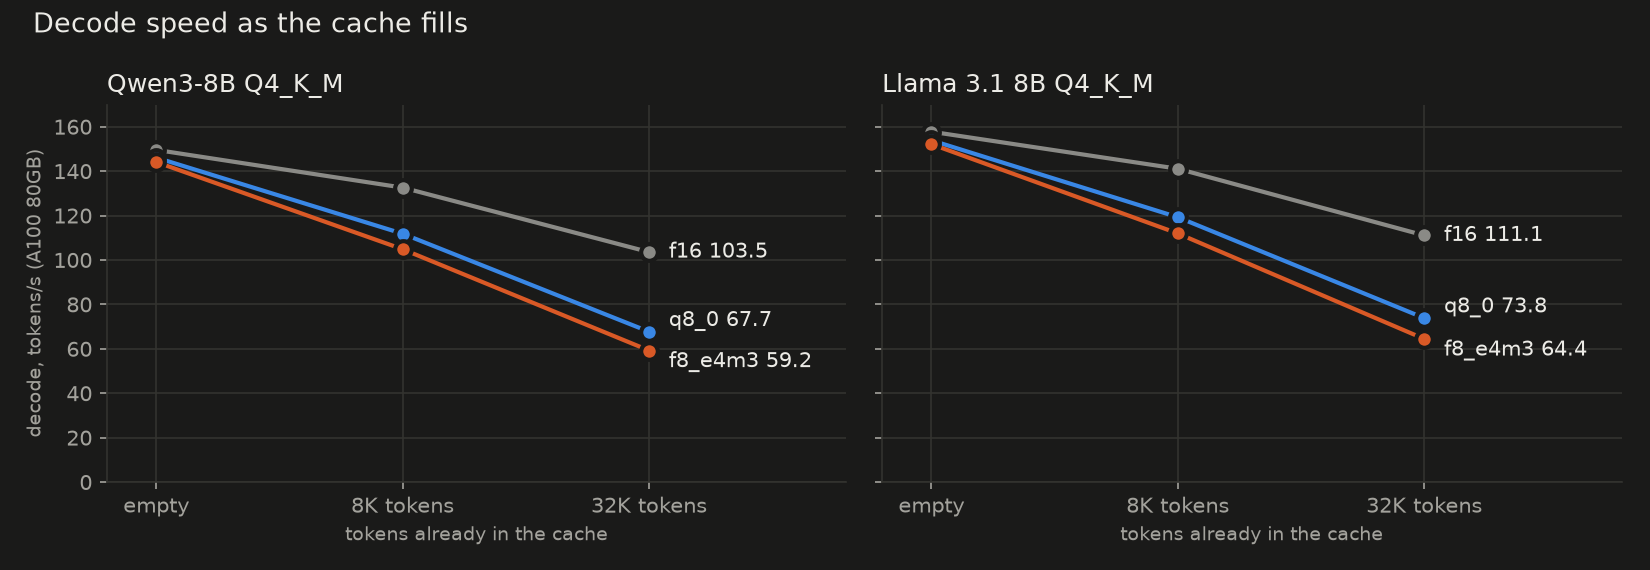
프롬프트 처리는 두 모델, 모든 깊이에서 FP8이 q8_0보다 1.3-2.5% 빨랐습니다. 중요한 것은 생성 속도인데, 캐시가 찰수록 차이가 벌어졌습니다. 빈 캐시에서 약 1%, 8K에서 약 6%, 32K에서 12-13% 느렸습니다. 새 토큰 하나를 만들 때마다 캐시 전체를 읽으니, 저장된 숫자 하나에 드는 비용이 캐시 크기만큼 불어납니다.
원인은 변환 비용으로 보입니다. A100에는 FP8 하드웨어가 없어서 어텐션이 쓰기 전에 FP8 값을 소프트웨어로 더 넓은 숫자로 바꿔야 합니다. FP8을 지원하는 카드(Ada, Hopper, Blackwell)에서는 이 비용이 더 작을 수 있습니다.
FP8이 맞는 경우
- GGUF에
k_scale,v_scale이 들어 있을 때. 위의 반올림 문제는 배율이 없는 경우의 이야기입니다. 배율이 있으면 값이 FP8 범위를 넓게 쓰도록 늘어나므로 이 글의 품질 숫자가 그대로 들어맞지 않습니다. - 모델을 올리기에 120-140MiB 정도가 모자랄 때. 이번 두 8B 모델의 32K에서 FP8은 커진 계산 버퍼까지 빼고
q8_0보다 그만큼을 비워 줬습니다. 그것으로 모델이 올라가느냐 마느냐가 갈린다면,q4_0으로 내려가는 것보다 품질 손해가 적습니다.q4_0은 같은 계산으로q8_0보다 약 1.0-1.1GiB를 더 비우지만 출력이 FP8보다 3.1-4.3배 더 멀어집니다. - 다른 엔진의 FP8 체크포인트와 형식을 끝까지 맞추고 싶을 때. 이건 호환성 이유이지 품질이나 속도 이유는 아닙니다.
그 밖의 경우라면 저희 카드 같은 환경에서 q8_0이 더 정확하고, 긴 문맥에서 더 빠르고, 크기는 6%만 큽니다.
내 모델에서 직접 확인하기
위의 품질 숫자는 명령 두 개로 나옵니다. 첫 번째는 f16 캐시로 모델의 예측을 저장하고, 두 번째는 FP8로 다시 돌려 그것과 비교합니다. 저희 카드에서는 한 번에 1.5-2분 걸렸습니다.
llama-perplexity -m model.gguf -f wiki.test.raw -c 4096 -b 2048 --chunks 40 -ngl 99 -fa on \
  -ctk f16 -ctv f16 --kl-divergence-base base.kld
llama-perplexity -m model.gguf -c 4096 -b 2048 --chunks 40 -ngl 99 -fa on \
  -ctk f8_e4m3 -ctv f8_e4m3 --kl-divergence-base base.kld --kl-divergence
두 번째 실행이 끝나면 "Mean KLD"와 "Same top p"를 보면 됩니다. 쓰시는 모델에서 FP8이 q8_0에 가깝게 나오거나, FP8 하드웨어가 있는 카드에서 생성이 더 빠르다면 바꿔도 됩니다. 그렇지 않다면 q8_0을 그대로 쓰세요.
다른 캐시 타입과 64K에서의 동작은 llama.cpp KV 캐시 양자화 가이드에 정리해 두었습니다. 다음 실측을 받아 보시려면 아래 뉴스레터를 구독해 주세요.