LLM 추론 최적화 Part 1 — Attention 메커니즘 해부
Self-Attention을 밑바닥부터 구현. MHA → GQA → MQA 진화를 코드로 비교. KV Cache 동작 원리와 Prefill vs Decode 분석.
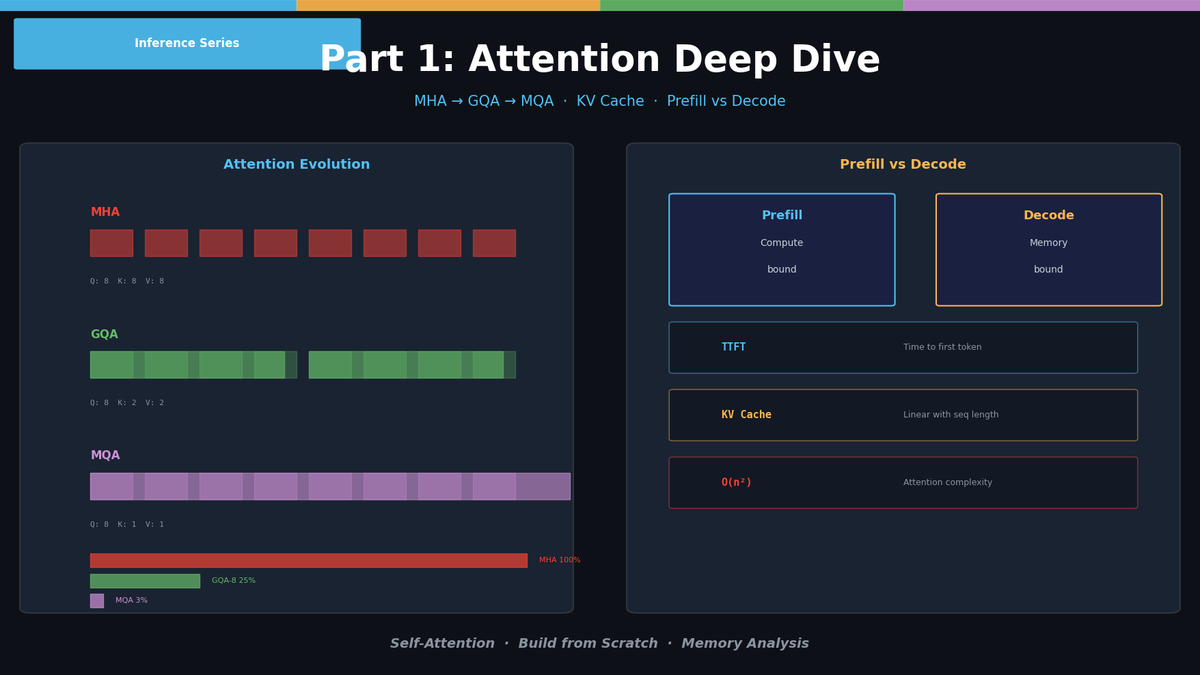
LLM을 실제 서비스에 배포하면 가장 먼저 부딪히는 벽은 추론 속도와 메모리입니다. 모델이 아무리 좋아도 느리고 비싸면 쓸 수 없습니다. 이 시리즈에서는 LLM 추론의 핵심 병목을 하나씩 해부하고, 실전 최적화 기법을 코드와 함께 다룹니다.
Part 1에서는 모든 최적화의 출발점인 Attention 메커니즘을 밑바닥부터 구현하고, MHA → GQA → MQA의 진화를 코드로 직접 비교합니다.
Self-Attention — 처음부터 구현
기본 구조
여기부터는 유료 연재입니다
- ✓ 「LLM 추론 최적화」 연재 전체: 한국어 3편, 영어 3편
- ✓ Jupyter 노트북 3개
- ✓ 한 번 결제, 기한 없음. 결제한 이메일로 로그인하면 열립니다.
연재 단품은 로그인 없이 결제됩니다. 구독은 무료 계정이 필요합니다.