LLM 추론 최적�� Part 3 — Sparse Attention 실전
Sliding Window, Sink Attention, DeepSeek DSA, IndexCache, Nvidia DMS. 동적 토큰 선별부터 Needle-in-Haystack 평가까지.
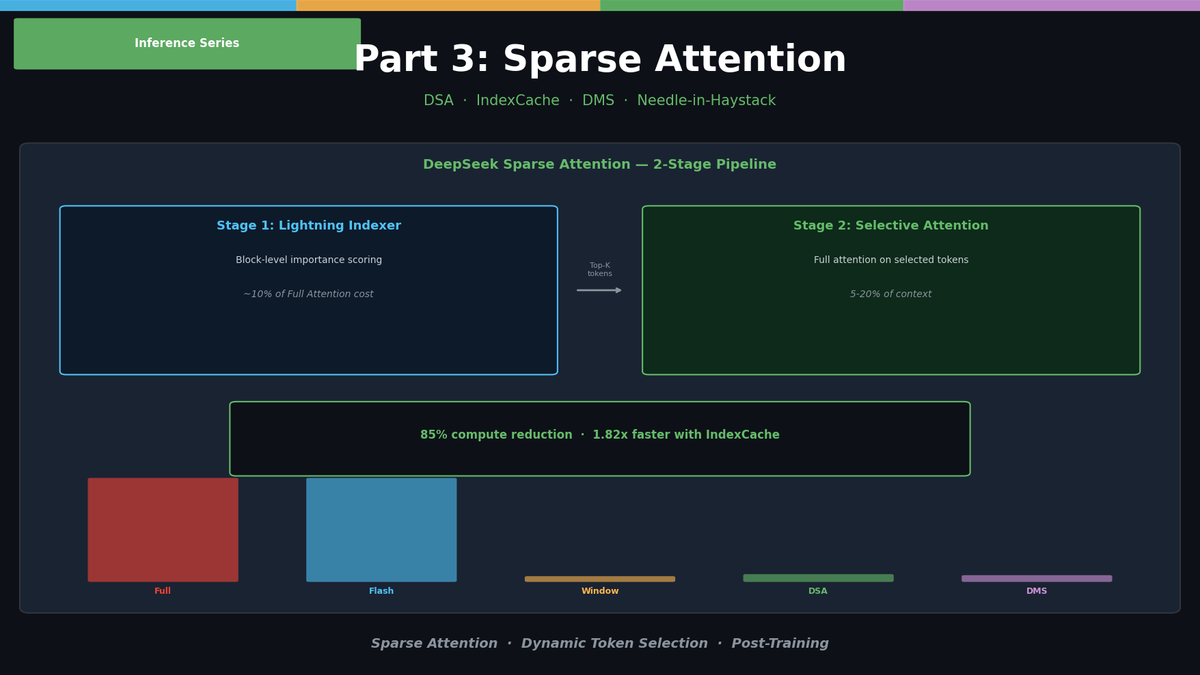
Part 2에서 KV Cache 양자화, 압축, PagedAttention을 다뤘습니다. 이 기법들은 저장된 데이터를 줄이는 접근입니다. Part 3에서는 방향을 바꿔서 계산 자체를 줄이는 Sparse Attention을 다룹니다.
핵심 질문: "모든 토큰이 정말 필요한가?"
대부분의 경우, 답은 "아니오"입니다. 128K 컨텍스트에서 현재 토큰이 실제로 참조해야 하는 토큰은 전체의 5~20%에 불과합니다.
Full Attention의 문제
여기부터는 유료 연재입니다
- ✓ 「LLM 추론 최적화」 연재 전체: 한국어 3편, 영어 3편
- ✓ Jupyter 노트북 3개
- ✓ 한 번 결제, 기한 없음. 결제한 이메일로 로그인하면 열립니다.
연재 단품은 로그인 없이 결제됩니다. 구독은 무료 계정이 필요합니다.