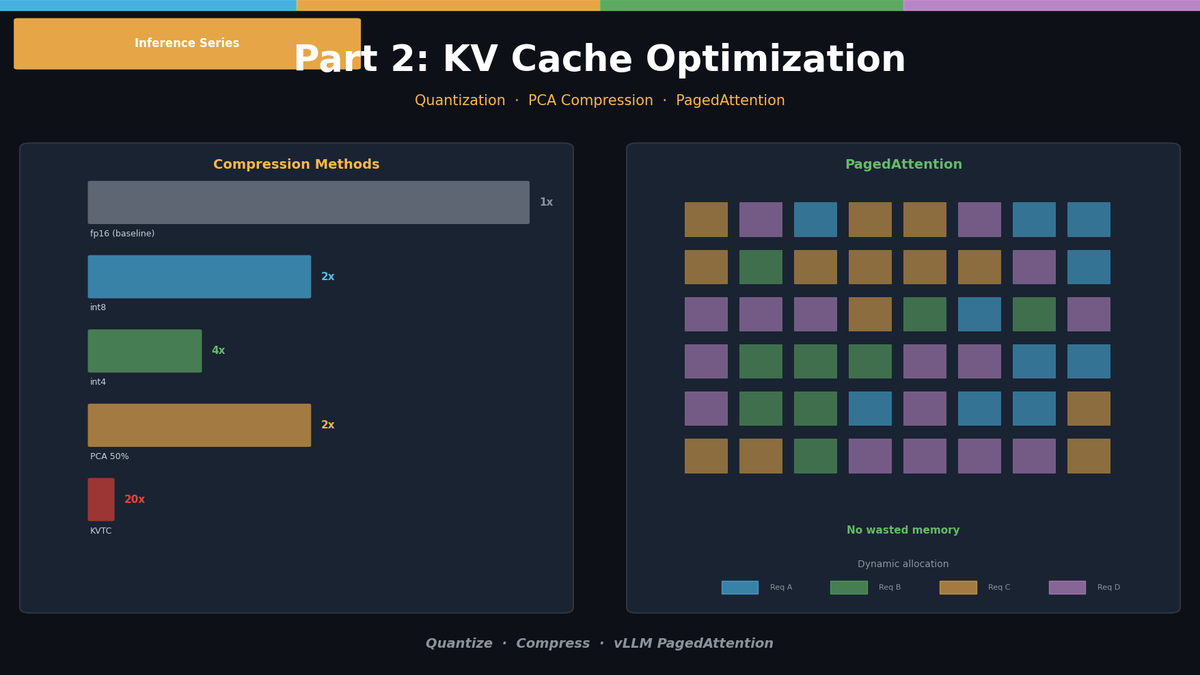
KV Cache의 각 원소를 fp16(2바이트)에서 int8(1바이트) 또는 int4(0.5바이트)로 변환합니다. 가장 직관적인 압축 방법입니다.
$$\text{quantized} = \text{round}\left(\frac{x - \text{zero\_point}}{\text{scale}}\right)$$
import torch

def quantize_kv_cache_int8(key: torch.Tensor, value: torch.Tensor):
    """KV Cache를 int8로 양자화 (per-channel)"""
    def quantize_tensor(t):
        # Channel별 min/max 기반 양자화
        t_flat = t.reshape(-1, t.shape[-1])  # (tokens, head_dim)
        t_min = t_flat.min(dim=0).values
        t_max = t_flat.max(dim=0).values

        scale = (t_max - t_min) / 255.0
        zero_point = t_min

        quantized = ((t - zero_point) / scale).round().clamp(0, 255).to(torch.uint8)
        return quantized, scale, zero_point

    k_quant, k_scale, k_zp = quantize_tensor(key)
    v_quant, v_scale, v_zp = quantize_tensor(value)

    return (k_quant, k_scale, k_zp), (v_quant, v_scale, v_zp)


def dequantize_kv_cache(quantized, scale, zero_point, dtype=torch.float16):
    """양자화된 KV Cache를 복원"""
    return quantized.to(dtype) * scale + zero_point


# 사용 예시
batch, kv_heads, seq_len, head_dim = 1, 8, 4096, 128
key = torch.randn(batch, kv_heads, seq_len, head_dim, dtype=torch.float16)
value = torch.randn(batch, kv_heads, seq_len, head_dim, dtype=torch.float16)

# 양자화
(k_q, k_s, k_z), (v_q, v_s, v_z) = quantize_kv_cache_int8(key, value)

# 메모리 비교
original_mb = (key.nelement() + value.nelement()) * 2 / 1024**2  # fp16
quantized_mb = (k_q.nelement() + v_q.nelement()) * 1 / 1024**2   # int8

print(f"Original (fp16): {original_mb:.1f} MB")
print(f"Quantized (int8): {quantized_mb:.1f} MB")
print(f"Compression: {original_mb / quantized_mb:.1f}x")

# 복원 품질 확인
key_restored = dequantize_kv_cache(k_q, k_s, k_z)
mse = ((key.float() - key_restored.float()) ** 2).mean()
print(f"MSE: {mse:.6f}")