OpenAI 음성 합성 코드를 로컬 llama-server로 돌리기: 고쳐야 할 두 줄
OpenAI 문서의 TTS 예제는 음성 이름과 저장 파일 이름 두 곳만 고치자 llama-server의 /v1/audio/speech에서 돌았습니다. 스트리밍을 켜면 A100에서 0.05초 만에 소리가 나왔습니다. 한국어는 숫자와 영문이 섞이기 전까지 정확했습니다.
OpenAI 문서에 있는 음성 합성(TTS) 예제를 그대로 가져와 주소만 저희 서버의 llama-server로 바꿔 돌려 봤습니다. 두 곳을 고치자 제대로 돌아갔습니다. 음성 이름, 그리고 저장하는 파일 이름입니다. 옵션 하나를 더 넣으니 요청 후 0.05초 만에 첫 소리가 왔고, 6.6초 분량의 문장 전체가 A100에서 0.8초 만에 만들어졌습니다.
두 줄을 고쳐도 남는 함정이 하나 있습니다. 한국어 문장은 한 글자도 틀리지 않고 읽혔는데, 시각과 포트 번호, "GPU 8GB"를 한 문장에 넣자 그 단어들 대부분이 알아들을 수 없게 나왔습니다. 소리 나는 대로 풀어 쓰니 대부분 해결됐습니다. 이 이야기는 뒤에서 자세히 다룹니다.
llama-server에 무엇이 생겼나
OpenAI의 음성 API는 HTTP 호출 하나입니다. 글과 모델 이름, 음성 이름을 /v1/audio/speech로 보내면 소리가 돌아옵니다. 공식 SDK가 이 호출을 감싸 주기 때문에 실제로 쓰이는 코드도 대부분 모양이 같습니다.
llama.cpp에 들어 있는 HTTP 서버인 llama-server가 이제 같은 경로에 응답합니다. 불러온 모델이 말을 할 줄 알면 SDK 호출이 그대로 모델까지 갑니다. 남는 질문은 OpenAI 요청의 어디까지를 알아듣느냐입니다. 저희는 빌드 b12307로 시험했습니다.
모델은 LiquidAI의 LFM3-Audio-2B GGUF, Q8_0입니다. 모델 파일이 1.85GB, 오디오 프로젝터 파일이 0.30GB입니다. 내장 음성은 female과 male 두 개뿐이고 목소리 복제 기능이 없어서, 따로 준비할 음성 샘플은 없습니다.
서버 띄우기
llama-server -m LFM3-Audio-2B-Q8_0.gguf -mm mmproj-LFM3-Audio-2B-Q8_0.gguf \
-ngl 99 -np 1 -c 4096 --port 8080-mm이 오디오 프로젝터를 불러옵니다. 이게 없으면 모델이 소리를 내지 못합니다. 저희는 18932번 포트로 돌렸고, 이 글의 예시는 llama-server 기본값인 8080을 씁니다.
A100에서 -np 1 -c 4096으로 띄우고 음성 요청을 한 번 보낸 뒤 nvidia-smi로 보니 카드에서 3,094MiB가 쓰이고 있었습니다. 기본 설정(슬롯 4개, 모델의 최대 문맥)으로는 4,680MiB였습니다.
0단계: 주소만 바꾼 OpenAI 예제
from pathlib import Path
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8080/v1", api_key="sk-no-key-required")

with client.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",
    voice="alloy",
    input="Today is a wonderful day to build something people love!",
    instructions="Speak in a cheerful and positive tone.",
) as response:
    response.stream_to_file(Path("speech.mp3"))
OpenAI 안내 문서의 예제 모양에서 base_url과 api_key만 바꿨습니다(openai-python 2.33.0). llama-server를 --api-key 없이 띄우면 키 문자열은 아무거나 받습니다.
첫 호출에서 바로 실패했습니다.
openai.BadRequestError: Error code: 400 - {'error': {'code': 400,
  'message': 'unknown voice "alloy", see "voices" in GET /props', ...}}
llama-server는 OpenAI의 음성 이름을 모델의 음성으로 바꿔 주지 않습니다. alloy, nova 같은 이름을 LFM3-Audio는 모릅니다. 다행히 오류 메시지에 수정할 부분을 명시해줍니다. GET /props에 불러온 모델이 가진 음성 목록을 볼 수 있습니다.
1단계: 음성을 바꾸니 돌아가지만, MP3가 아닙니다
voice="alloy"를 voice="female"로 바꾸자 호출이 성공하고 speech.mp3가 저장됐습니다. 그런데 파일 첫머리가 RIFF입니다. 16비트, 24kHz, 모노, 3.68초짜리 WAV 파일입니다.
SDK는 response_format을 직접 정했을 때만 보냅니다. OpenAI 서버의 기본값은 MP3이고 llama-server의 기본값은 WAV입니다. 그래서 이름만 MP3인 WAV가 생깁니다. 대부분의 플레이어는 확장자가 아니라 파일 머리를 보고 열기 때문에 재생은 됩니다. 하지만 MP3 디코더에 넘기거나 MP3 형식으로 업로드하는 코드에서는 문제가 됩니다. 가장 작은 수정은 파일 이름을 실제 형식에 맞추는 것입니다.
with client.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",                                # llama-server는 무시합니다
    voice="female",                                          # 수정 1: 모델이 가진 음성
    input="Today is a wonderful day to build something people love!",
    instructions="Speak in a cheerful and positive tone.",  # 받지만 무시합니다
) as response:
    response.stream_to_file(Path("speech.wav"))              # 수정 2: 실제로는 WAV
기본적인 경우라면 옮기는 작업은 이 두 줄이 전부입니다. 서버 기본값에 기대고 싶지 않다면 response_format="wav"도 함께 보내세요. 서버가 받아 줍니다.
서버가 받는 옵션과 거절하는 옵션
OpenAI의 옵션을 하나씩 따로 보내 응답을 기록했습니다.
| 옵션 | 결과 |
|---|---|
response_format="mp3" 또는 "opus" | 400: "Only 'wav' and 'pcm' response_format are supported for speech" |
response_format="pcm" | 200, 16비트 원시 샘플, 콘텐츠 타입 audio/pcm;rate=24000;encoding=signed-int;bits=16 |
speed=1.25 | 400: "'speed' is not supported for speech" |
speed=1.0 | 받음 |
stream_format="sse" | 400: "Only 'audio' stream_format is supported for speech" |
stream_format="audio" | 200, 만들어지는 대로 소리를 보냄 |
model="tts-1", instructions="..." | 받지만 무시함 |
주의할 것은 마지막 줄입니다. 요청이 성공하니 "밝은 목소리로" 같은 지시가 아무 효과가 없다는 걸 알려 주는 곳이 없습니다. 소리는 모델 고유의 샘플링 레이트로 옵니다. 이 모델은 24kHz이고, 서버 README에 따르면 llama-server가 변환해 주지 않습니다. 같은 seed로 보내면 바이트까지 똑같은 파일이 나왔고, seed를 바꾸면 다른 파일이 나왔습니다.
스트리밍: 전체 시간은 같고, 소리는 0.75초 먼저 나옵니다
stream_format 없이 보내면 서버는 소리를 끝까지 다 만든 뒤에야 보내기 시작합니다. 넣으면 모델이 만드는 대로 바로 내보냅니다. OpenAI SDK에서는 extra_body로 넘깁니다.
with client.audio.speech.with_streaming_response.create(
    model="tts", voice="female", input=text, response_format="wav",
    extra_body={"stream_format": "audio"},
) as response:
    for chunk in response.iter_bytes():
        player.write(chunk)   # 소리를 내보낼 곳
20단어짜리 영어 문장으로 시간을 쟀습니다. 만들어진 소리는 6.64초 분량입니다. A100 80GB에서 예열 한 번 뒤 다섯 번 돌린 중앙값입니다.
| 첫 소리 도착 | 요청 완료 | |
|---|---|---|
stream_format 없음 | 0.79초 | 0.79초 |
stream_format="audio" | 0.05초 | 0.79초 |
요청 완료 시각은 SDK로 다섯 번 돌린 중앙값입니다. 스트리밍의 첫 소리 시각은 WAV 머리 다음에 오는 첫 오디오 바이트를 재려고 따로 다섯 번 돌린 값이고, 이때 요청은 0.80-0.81초에 끝났습니다.
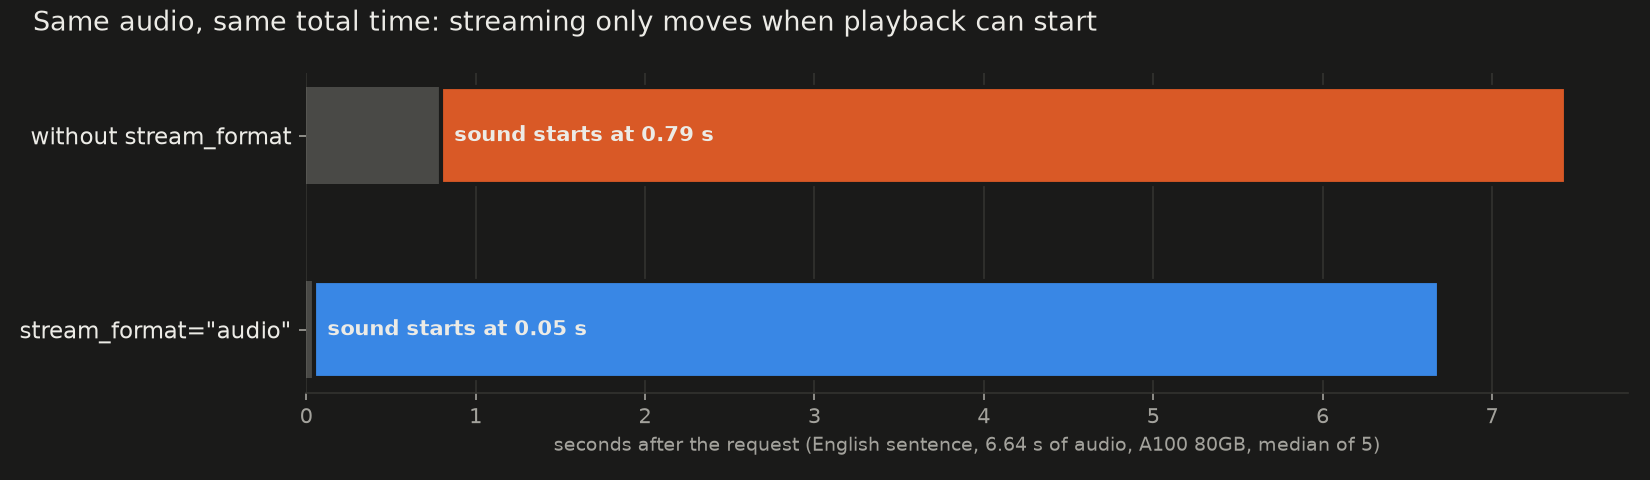
전체 시간도, 소리 자체도 그대로입니다. 두 파일은 WAV 머리에서 길이를 적는 8바이트만 다른데, 스트림은 길이를 미리 알 수 없기 때문입니다. 스트리밍이 바꾸는 것은 재생을 언제 시작할 수 있느냐뿐입니다.
첫 조각에 이미 소리가 들어 있었습니다. 머리만 먼저 온 것이 아닙니다. 스트림은 모두 84개 조각으로 왔고 조각 하나가 약 80ms 분량이었습니다. 모든 실행의 모든 시점에서 받아 둔 소리가 지난 시간보다 앞서 있었으니, 스트림을 바로 플레이어에 넣어도 끊기지 않았을 것입니다. 이 문장을 이 카드에서 만들 때 속도는 실제 재생 시간의 약 8.4배였습니다.
한국어 문장도 같았습니다. 전체 0.80초, 첫 소리 0.04-0.05초였습니다.
한국어: 숫자와 영문이 나오기 전까지는 정확했습니다
LFM3-Audio는 lang 필드를 받습니다. 이것도 extra_body로 넘깁니다.
extra_body={"lang": "ko"}알아들을 수 있는지는 귀가 아니라 기계로 확인했습니다. Whisper large-v3로 모든 소리를 받아 적게 하고, 보낸 글과 비교했습니다.
평범한 한국어 문장("오늘은 사람들이 좋아할 무언가를 만들기 좋은 날입니다…")은 목소리 두 개, 시드 다섯 개로 만든 10개 모두 글자 오류율(CER)이 0이었습니다. 영어 문장도 마찬가지였습니다.
다음으로 개발자가 실제로 보낼 법한 문장을 넣었습니다. "오후 3시 15분에 GPU 8GB 카드에서 llama.cpp 서버를 8080번 포트로 띄웠습니다." 글자 오류율이 0.40-0.76으로 뛰었습니다. 10개 중 "3시 15분"을 맞게 받아 적은 것이 1개, "GPU"가 1개, "8GB"와 "8080"은 하나도 없었습니다. 전형적인 받아쓰기 결과는 "오후 3시 10분에 지프 업계 피카드에서 여마 서포키 서버를 하진 끝 호트로 띄웠습니다"였습니다.
Whisper가 못 알아들은 것일 수도 있습니다. 둘을 가르려고 같은 문장을 소리 나는 대로 바꿔 썼습니다. "오후 세 시 십오 분에 지피유 팔 기가 카드에서 라마 쩜 씨쁠쁠 서버를 팔공팔공 번 포트로 띄웠습니다." 목소리와 시드, Whisper를 모두 그대로 두었습니다. 이번에는 시각과 "GPU"가 10개 중 10개, "8GB"와 "8080"이 10개 중 9개 맞았습니다.
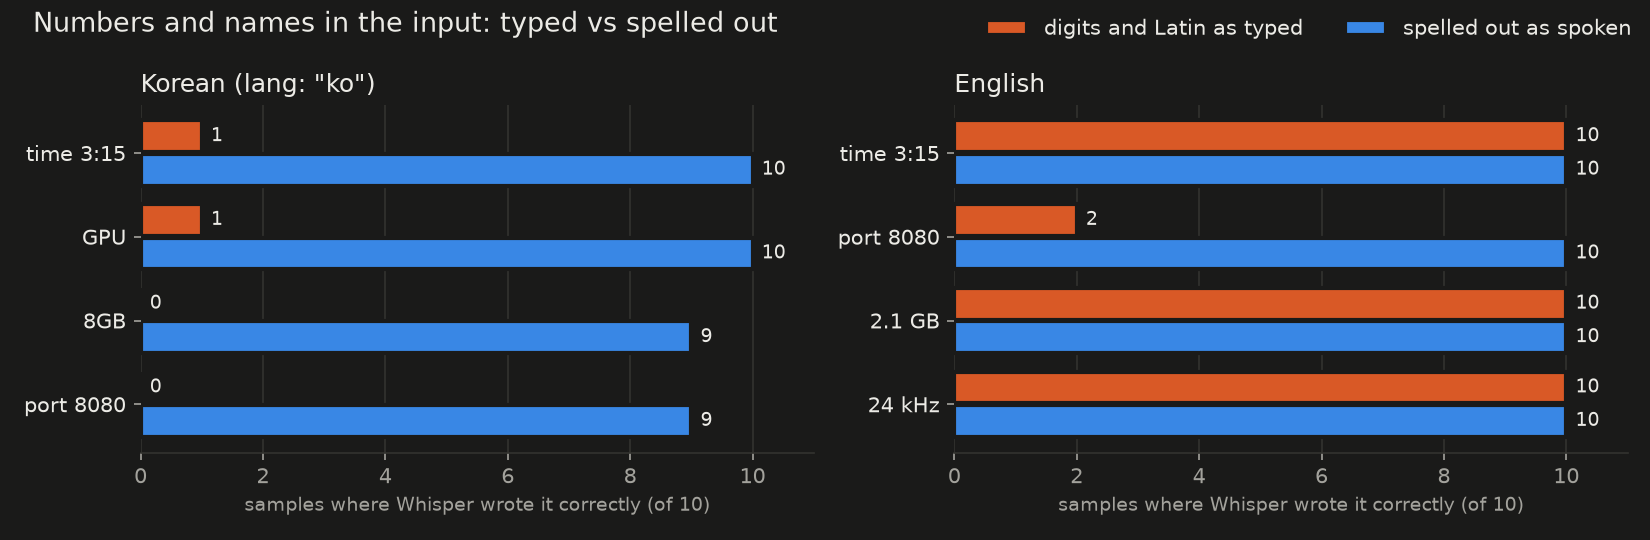
문제는 모델이 한국어 문장 안의 숫자와 영문을 읽는 방식에 있고, 호출 전에 풀어 쓰면 대부분 해결됩니다. 다만 "llama.cpp"는 그대로 쓴 판과 풀어 쓴 판 모두 10개 중 하나도 맞게 받아 적히지 않아서("라마출시++", "라마쯔 10++" 등) 그래프에서 뺐습니다. 영어에서도 작게 같은 일이 있었습니다. "3:15 PM", "2.1 GB", "24 kHz"는 괜찮았지만 "port 8080"은 10개 중 2개만 맞았습니다. "eighty eighty"로 쓰니 10개 모두 맞았습니다.
앱이 직접 쓰지 않은 글(채팅 답변, 알림, 파일 이름)을 읽어 준다면, 음성 호출 앞에 숫자와 단위를 읽는 말로 바꿔 주는 단계를 하나 두세요. 제품 이름은 그것만으로 부족할 수 있습니다. 저희가 시험한 이름 하나는 풀어 써도 끝내 맞게 받아 적히지 않았으니, 앱에서 실제로 읽게 될 이름은 직접 들어 보고 확인하세요.
라이선스
LFM3-Audio-2B는 LiquidAI의 LFM Open License v1.0으로 공개돼 있습니다. 연 매출 1,000만 달러 미만인 조직은 상업적으로 쓸 수 있고, 그 이상이면 상업적 사용이 허락되지 않습니다. 이 모델로 무언가를 만들기 전에 모델과 함께 배포되는 라이선스 파일을 직접 읽어 보세요.
옮기기 전에 확인할 것
GET /props에서 음성 이름을 읽고, 쓰던 OpenAI 음성을 그중 하나에 대응시킵니다.- 파일을
.wav로 저장하거나response_format="wav"를 보내고, MP3를 기대하는 코드가 있는지 봅니다. - 첫 소리를 기다리는 곳이 있다면
extra_body로stream_format="audio"를 넘깁니다. - 한국어 문장에 들어가는 숫자, 단위, 영문 약어는 음성 호출 전에 읽는 말로 바꿉니다.
- 앱이 읽게 될 제품 이름은 한 번씩 직접 들어 봅니다.
다음 로컬 모델 실측을 받아 보시려면 아래 뉴스레터를 구독해 주세요.