Paper of the Week #10 — 에이전트가 일하는 환경을 다시 짰더니 Haiku 4.5의 비용이 4분의 1로 줄었습니다
이번 주에는 EnvOpt(UC 버클리·시카고대·Bespoke Labs)를 다룹니다. 정답지 없이 한 에이전트가 다른 에이전트의 업무 환경을 다시 짜는 방법입니다. AutomationBench에서 Claude Haiku 4.5의 비용이 72.7% 줄고 통과율이 2.33%에서 16.67%로 올랐습니다. 같은 환경을 받은 Opus 5는 비용이 68.1% 줄었고, 통과율은 33.83%에서 35.17%가 됐습니다. 숫자를 논문 표와 하나씩 대조했고, 맥락이 필요한 숫자에는 설명을 붙였습니다. 같은 연구실의 SlackBench도 다룹니다. 연구팀 슬랙에 대한 질문에서 에이전트 구성 33개 중 가장 잘한 구성이 80.25%를 받았고, 슬랙 도구 대신 내보낸 파일을 직접 읽게 하자 점수가 평균 7.85점 올랐습니다.
Paper of the Week #10 — 에이전트가 일하는 환경을 다시 짰더니 Haiku 4.5의 비용이 4분의 1로 줄었습니다
2026년 11월 3일-5일 · EnvOpt · SlackBench
Claude Haiku 5.5가 다시 정리한 업무 환경에서 과제 200개를 1.51달러에 풀었고 32.8%를 통과했습니다. 원래 환경의 Claude Opus 5는 같은 200개에 236.18달러를 쓰고 33.83%를 통과했습니다. 모델도, 모델을 감싼 하네스도 그대로였습니다. 바뀐 것은 에이전트가 일감을 받아 보는 방식입니다. 이메일과 티켓, 고객 기록을 어떻게 가져와 어떤 모양으로 보여 주고 어떤 안내를 붙이는지가 달라졌습니다. 이 방식은 다른 에이전트가 짰는데, 정답지를 한 번도 보지 않고 목표 에이전트가 일하는 모습만 보고 고쳤습니다. 이번 주 가장 많이 공유된 논문 EnvOpt의 결과입니다. 이틀 앞서 같은 버클리 연구실이 연구팀 슬랙으로 만든 벤치마크 SlackBench를 냈는데, 여기서도 같은 방향의 결과가 하나 나왔습니다. 에이전트에게 슬랙 도구 대신 내보낸 파일을 그대로 주자 점수가 평균 7.85점 올랐습니다. EnvOpt를 소개한 글의 숫자는 대부분 원문과 맞습니다. 다만 표를 같이 봐야 뜻이 정확해지는 숫자가 몇 개 있습니다. 논문마다 무엇이 나왔는지, 저희가 원문에서 확인한 숫자, 읽을 때 주의할 점, 직접 확인할 수 있는지를 적었습니다.
한 에이전트가 환경을 고치고, 다른 에이전트가 그 안에서 일합니다
무엇이 나왔나. 「EnvOpt: Automated Optimization for Agent Environments」(Mingxuan Li·Huanzhi Mao·Qiuyang Mang·Hanchen Li·Joseph E. Gonzalez·Alex Dimakis, UC 버클리 Sky Computing Lab·시카고대·Bespoke Labs, arXiv 2611.07372, 11월 5일, CC BY 4.0)는 에이전트의 비용을 정하는 요소를 셋으로 봅니다. 모델, 하네스, 그리고 에이전트가 일하는 환경입니다. 앞의 둘은 이미 많이들 최적화합니다. 이 논문은 세 번째를 다루는데, 그중에서도 여러 작업이 함께 쓰는 환경입니다. 회사 슬랙 워크스페이스나 문서·티켓 더미처럼 작업마다 내용은 달라도 바탕은 그대로인 곳을 말합니다. 논문은 이를 '정적 환경(stationary environment)'이라고 부릅니다.
방법에는 에이전트 둘이 나옵니다. 연구 에이전트(대표 실험에서는 Claude Code + Claude Opus 4.8)가 목표 에이전트(Claude Code + Claude Haiku 4.5)에게 학습용 과제 20개를 풀게 하고, 실행 기록을 읽고, 환경을 고친 뒤 다시 돌립니다. 연구 에이전트는 목표 에이전트가 과제를 맞혔는지 알 수 없습니다. 저자들이 채점기를 일부러 숨겼기 때문입니다. 채점 결과를 보여 주면 환경에 답을 적어 넣는 식으로 비용을 줄일 수 있어서입니다. 그래서 품질은 목표 에이전트가 한 일을 읽고 판단합니다. 단계가 끝날 때마다 채점기가 있는 별도의 검증 세트로 새 환경을 돌려 보고, 비용이 오르거나 통과율이 떨어지면 직전 단계의 환경을 남기고 멈춥니다.
대표 실험은 AutomationBench입니다. Gmail, Salesforce, Slack, QuickBooks, Zendesk 같은 가상 SaaS 앱 약 47개에 걸친 업무 과제입니다. 공개된 600개 중 200개를 시험용, 96개를 검증용으로 떼어 두고 나머지로 학습했습니다(3절). 결과는 모두 세 번 돌린 평균입니다(그림 3).
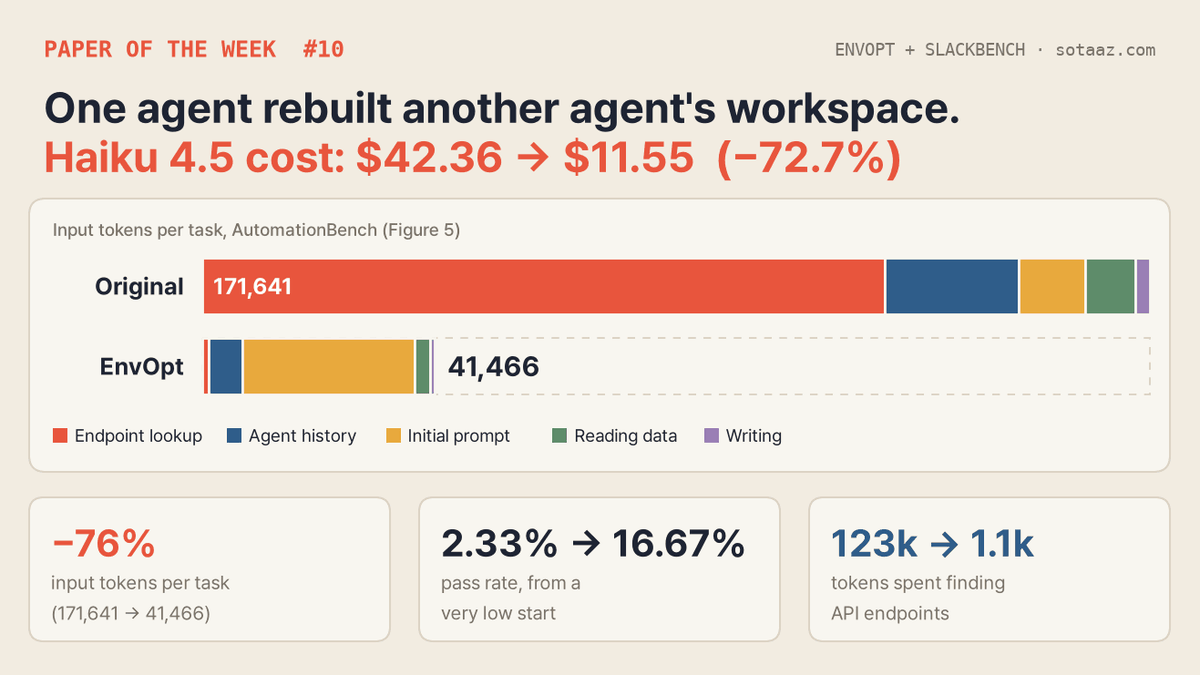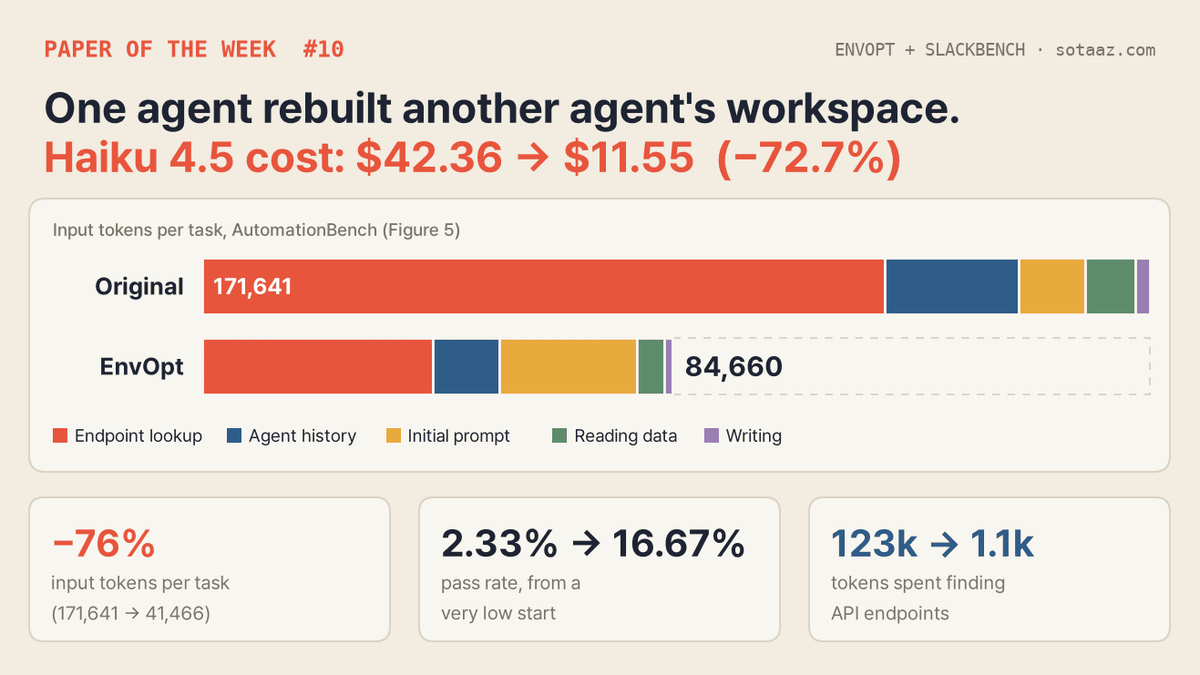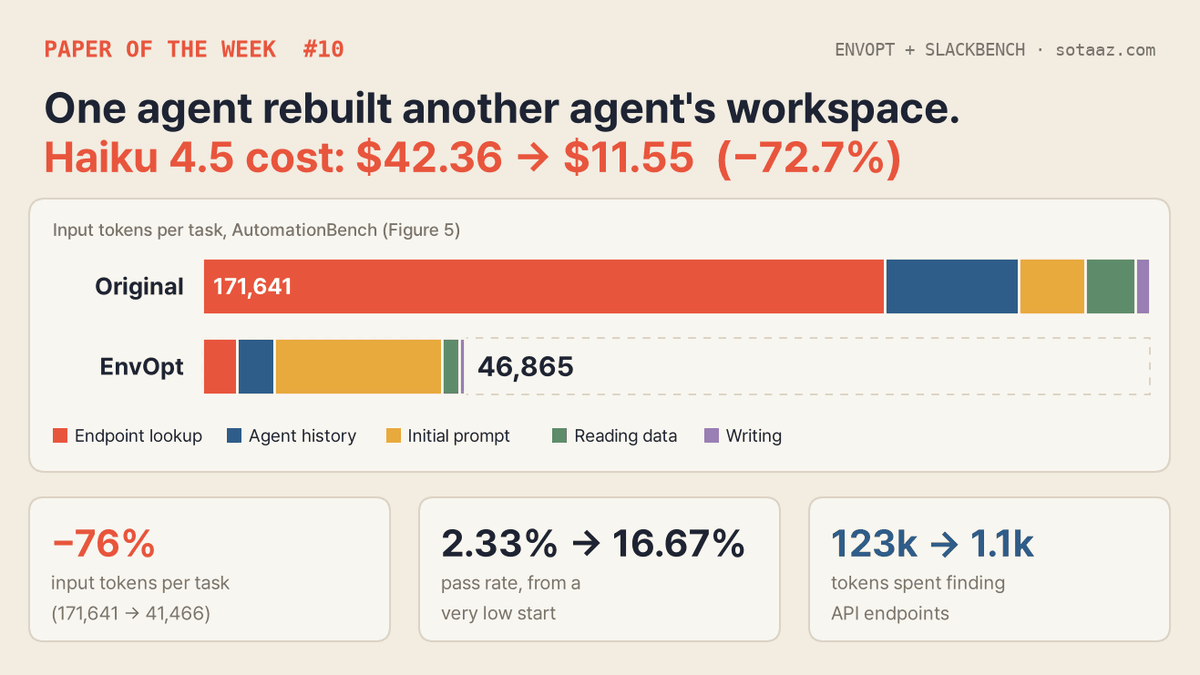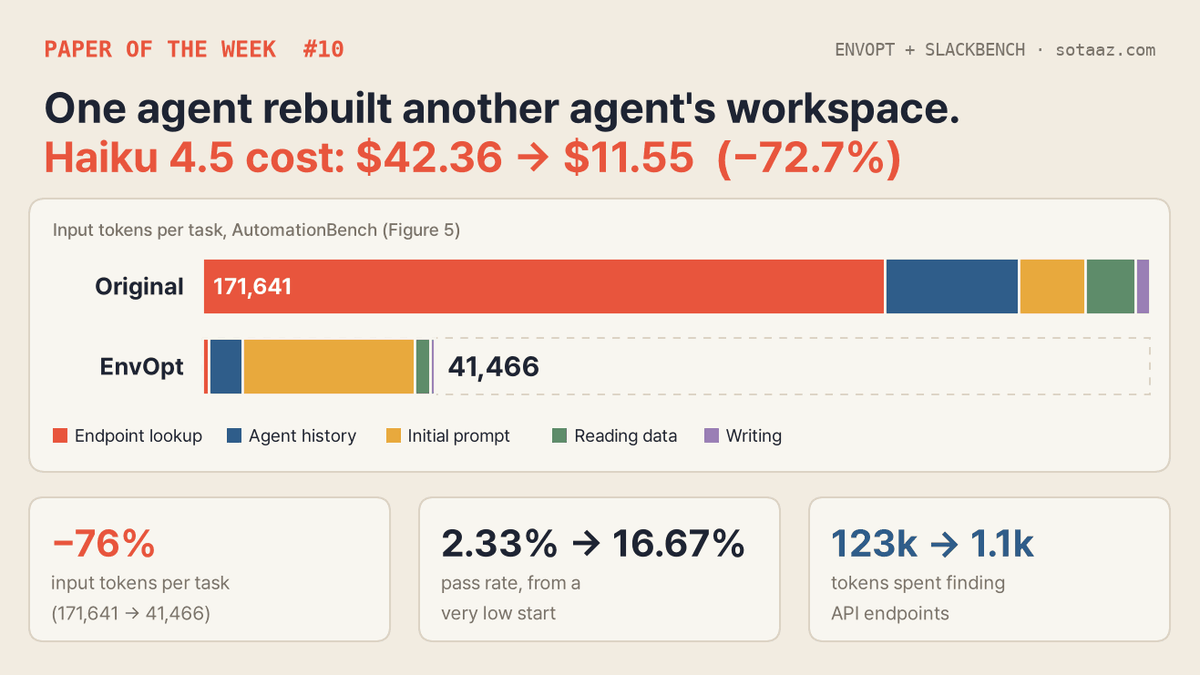
눈여겨볼 부분. 핵심 숫자는 표 1에 있습니다. 목표 에이전트인 Haiku 4.5는 시험 과제 200개의 비용이 42.36달러에서 11.55달러로 72.7% 줄었고, 통과율은 2.33%에서 16.67%로 올랐습니다. 저자들은 이 환경을 그대로 두고, 최적화에 쓰지 않은 다른 에이전트에게도 줬습니다.
| 에이전트 | 통과율 (원래 → EnvOpt) | 비용 (원래 → EnvOpt) |
|---|---|---|
| Haiku 4.5 (목표) | 2.33% → 16.67% | 42.36달러 → 11.55달러 |
| Haiku 5.5 | 20.7% → 32.8% | 4.83달러 → 1.51달러 |
| GPT-5.6-luna | 19.17% → 24.67% | 17.42달러 → 1.98달러 |
| Opus 4.8 | 28.50% → 33.33% | 358.13달러 → 80.90달러 |
| Opus 5 | 33.83% → 35.17% | 236.18달러 → 75.26달러 |
모든 에이전트의 비용이 68%에서 89% 사이로 줄었습니다. 첫 문단의 Haiku 5.5와 Opus 5 비교는 논문이 직접 한 비교입니다(그림 3). 다만 두 모델을 모두 새 환경에 두고 견주는 쪽이 더 공정합니다. 그러면 Opus 5는 75.26달러에 35.17%, Haiku 5.5는 1.51달러에 32.8%입니다.
비용이 어디서 줄었는지는 그림 5에 있습니다. 과제 하나당 입력 토큰이 171,641개에서 41,466개로 줄었는데, 거의 전부가 한 항목에서 나왔습니다. API 엔드포인트를 찾는 도구 결과가 12만 3천 토큰에서 1천 1백 토큰이 됐습니다. 원래 환경의 에이전트는 Jira 이슈를 만들거나 결제를 기록하는 엔드포인트가 어디 있는지 찾느라 과제마다 많은 토큰을 썼습니다. 연구 에이전트는 그 엔드포인트들을 치트시트로 적어 뒀습니다. 반대로 늘어난 항목도 하나 있습니다. 첫 프롬프트가 1만 2천 토큰에서 3만 1천 토큰으로 커졌습니다. 새 접근 층이 과제를 시작할 때 그 과제의 데이터를 미리 읽어 요약을 프롬프트 맨 위에 붙이기 때문입니다. 출력 토큰은 5,065개에서 3,881개로 덜 줄었습니다.
자기 데이터를 에이전트용으로 정리하려는 분께 가장 쓸모 있는 부분은 연구 에이전트가 시도했다가 버린 변경들입니다(4.2절). Data-Eng-Bench에서는 모든 열의 모든 값을 한 파일에 모아 줬더니, 에이전트가 오히려 더 많이 탐색했습니다. 그 파일을 보고 아직 안 읽은 정보가 많다는 것을 알게 됐기 때문입니다. Workspace-Bench에서는 파일을 찾아 주는 검색 도구가 필요 없는 파일까지 너무 많이 돌려줘서, 에이전트가 파일을 더 많이 열었습니다. 코드 저장소 과제에서는 2단계에 추가한 테스트가 그 단계의 과제 20개에는 잘 맞았지만, 3단계에서는 맞는 수정까지 막았습니다.
다른 벤치마크의 결과는 폭이 작지만 방향은 같습니다. Workspace-Bench(가상 직원 컴퓨터의 파일로 하는 업무)에서 Codex + GPT-5.4-mini는 39.84%에서 43.12%로 올랐고 비용은 47.65% 줄었습니다. Data-Eng-Bench(dbt 데이터 엔지니어링 티켓)에서 Codex + GPT-5.6-luna는 50.68%에서 53.88%로 올랐고 비용은 53.44% 줄었습니다(표 1).
EnvOpt의 숫자를 읽을 때 주의할 점
+14.34의 출발점은 2.33%입니다. 초록은 통과율이 "14.34% 올랐다"고 씁니다. 표 1을 보면 2.33%에서 16.67%로, 절대값으로 14.34%p입니다. 시험 과제 200개에서 2.33%는 한 번 돌릴 때 약 5개를 맞힌 셈입니다(저희 계산). 원래 환경은 Haiku 4.5에게 거의 쓸 수 없는 수준이었다는 뜻입니다. 검증 세트에서의 출발점은 1.0%였습니다(표 5). 그래서 더 단단한 결과는 비용 72.7% 감소이고, 통과율 상승은 원래 환경이 이 모델에게 얼마나 불친절했는지를 보여 줍니다.
Opus 5의 통과율은 1.34%p 올랐습니다. 초록의 같은 문장에 Opus 5의 비용 −68.1%와 "1.34% 상승"이 함께 나옵니다. 시험한 모델 중 가장 강한 모델에서는 사실상 비용만 줄었고, 저자들도 그 이상을 주장하지 않습니다.
다른 에이전트에 옮겼을 때 비용은 늘 줄었지만, 통과율이 늘 오르지는 않았습니다. 논문은 환경이 "다른 모델과 다른 하네스로 옮겨진다"고 씁니다. AutomationBench에서는 옮겨 간 에이전트가 모두 나아졌습니다. 나머지 두 벤치마크에서는 옮겨 간 에이전트 네 개 중 세 개의 통과율이 조금 내려갔습니다. Workspace-Bench의 Opus 5는 62.27%에서 61.14%로, Data-Eng-Bench의 GPT-5.6-sol은 62.56%에서 61.19%로, Opus 5는 63.47%에서 63.01%로 내려갔습니다. 비용은 네 경우 모두 50%에서 58% 줄었습니다(표 1). 저자들은 이를 "통과율이 유지됐다"고 표현했습니다.
"추가로 83.4%"의 기준은 Meta-Harness이고, 이 실험에서 Meta-Harness는 비쌌습니다. 초록은 하네스를 자동으로 최적화하는 Meta-Harness 위에 EnvOpt를 더하면 "비용을 추가로 83.4% 낮추고 Meta-Harness 단독보다 정확도를 11.17% 높인다"고 씁니다. 그 기준이 어땠는지는 표 4에 있습니다. Haiku 4.5에서 Meta-Harness 단독은 75.33달러에 7.00%였습니다. 원래 환경(42.36달러)보다 비쌌습니다. EnvOpt와 Meta-Harness를 함께 쓰면 12.47달러에 18.17%였습니다. EnvOpt 단독(11.55달러에 16.67%)과 비교하면 Meta-Harness를 더해서 얻은 것은 92센트를 더 쓰고 1.5%p를 올린 정도입니다. Opus 5에서는 Meta-Harness 단독이 통과율을 33.83%에서 27.5%로 떨어뜨렸습니다.
AutomationBench에서 바꾼 '환경'은 과제마다 먼저 도는 코드입니다. 이 벤치마크에는 여러 과제가 함께 쓰는 파일이 없습니다. 과제마다 새로운 가상 세계에서 시작하고, 에이전트는 도구로만 그 세계에 접근합니다. 그래서 연구 에이전트가 고친 것은 접근 층입니다. 도구, 사용 안내, 그리고 과제가 시작될 때 데이터를 읽기만 해서 요약을 프롬프트에 붙이는 함수입니다(부록 A.1). 저자들은 도구만 바꾼 경우와 따로 비교했습니다. 새 도구만 쓰면 Haiku 4.5는 15.75달러에 6.33%였고, 전체를 바꾸면 11.55달러에 16.67%였습니다(표 2). 이것을 환경으로 볼지 하네스의 일부로 볼지는 읽는 사람이 판단할 문제입니다. Workspace-Bench와 Data-Eng-Bench에서는 연구 에이전트가 실제 파일과 폴더를 고쳤습니다.
값싼 모델은 아낀 돈이 최적화 비용을 넘기까지 오래 걸립니다. AutomationBench 최적화에는 6.6시간, 150.10달러가 들었습니다(표 3). 논문은 이 금액에 연구 에이전트가 띄운 목표 에이전트 실행 비용이 들어 있다고 적었지만, Opus 4.8 자신의 사용료가 포함되는지는 밝히지 않았습니다. 표 1의 비용이 시험 과제 200개를 한 번 돈 값이라고 보고 계산하면, Haiku 4.5는 과제 1,000개마다 약 154달러를 아낍니다((42.36 − 11.55) ÷ 200 × 1,000). 최적화 비용 150달러를 겨우 넘습니다. Opus 4.8은 약 1,386달러로 9배쯤입니다. Opus 4.8에서 약 10배까지 아낀다는 그림 6과도 맞습니다.
연구 에이전트가 규칙을 늘 지키지는 않았습니다. Workspace-Bench에서는 답의 길이와 키워드 일치로 품질을 판단했고, 이것이 시험 과제 성적을 깎았습니다. 저자들은 검증 세트 결과를 본 뒤 연구 에이전트의 지시문을 고쳤습니다(4.6절). 건드리지 말라고 한 Codex의 추론 강도 설정을 바꾸려고도 했는데, 이 변경은 버려졌습니다. Data-Eng-Bench에서는 1단계에 만든 SQL 문장 분리기가 따옴표 안의 세미콜론에서 깨졌고, 5단계까지 아무도 몰랐습니다. 목표 에이전트는 망가진 쿼리를 자기 잘못으로 여기고 다시 만드느라 토큰을 썼습니다. 그리고 Workspace-Bench의 답은 고정된 검사가 아니라 다른 에이전트(Claude Code + Sonnet 5)가 채점했습니다.
직접 확인할 수 있나. 일부는 됩니다. AutomationBench 과제 600개는 공개돼 있고, 논문 부록 A에 다섯 벤치마크에서 연구 에이전트에게 준 지시문이 전부 실려 있습니다. 이 지시문이 가장 구체적인 재현 안내입니다. 저자 저장소(itea1001/EnvOpt)는 스스로 "아직 완성되지 않았다"고 적어 두었고, 11월 13일에 저희가 확인했을 때 라이선스 파일이 없었습니다. AutomationBench 전체를 돌리는 데는 논문 기준으로 약 150달러가 듭니다.
자기 데이터 위에서 에이전트를 돌리고 있다면, 이 논문에서 싸게 해 볼 수 있는 것이 두 가지 있습니다. 하나는 에이전트 입력 토큰 중 '무엇이 어디 있는지 찾는 도구 결과'가 얼마나 되는지 세어 보는 것입니다. 이 논문에서는 그게 가장 큰 항목이었습니다. 다른 하나는 큰 색인 파일 하나나 넓게 찾아 주는 검색 도구를 붙이기 전에, 위에서 본 버린 변경들을 떠올리는 것입니다. 두 방법 모두 에이전트가 더 많이 읽게 만들었습니다.
연구팀 슬랙에서 답을 찾는 시험, 가장 잘한 에이전트가 80.25%를 받았습니다
무엇이 나왔나. 「SlackBench: Benchmarking Agents on Collaborative Projects Grounded in Real Code Repositories」(Mingxuan Li·Huanzhi Mao·Ruitao Zheng·Jarod Stanbury James·Yunze Li·Natanya Anderson·Joseph E. Gonzalez·Alex Dimakis, UC 버클리·시카고대·Bespoke Labs, arXiv 2611.05512, 11월 3일)는 EnvOpt보다 이틀 먼저 같은 연구실에서 나온 벤치마크입니다. 재료는 실제 슬랙 워크스페이스입니다. 사람이 작은 연구 프로젝트를 이끌고, Cursor나 Claude Code 같은 코딩 에이전트가 연구 보조로 일했습니다. 보조 에이전트들은 슬랙으로 보고하고 실제 GitHub 저장소에 커밋했습니다(3.1절). 그렇게 채널 15개에 메시지 약 3,000개가 쌓였고, 저장소 14개와 구글 문서 9개가 대화에 연결됐습니다. 메시지의 35.0%는 사람이 직접 썼고 35.2%는 사람이 크게 고쳐 썼습니다. 나머지 약 30%는 에이전트가 쓴 그대로입니다(저희 계산). 슬랙 대화만 약 79만 토큰입니다. EnvOpt가 쓴 AutomationBench는 과제당 환경이 중앙값 3,300토큰이니 규모가 전혀 다릅니다(2절). 질문 140개는 네 갈래로 나뉩니다. 슬랙·코드·문서를 오가며 사실을 찾는 질문이 58개, 답할 수 없거나 전제가 틀린 질문을 알아채는지 보는 질문이 48개입니다. 조수의 추천서처럼 목적에 맞춰 요약하는 질문이 14개, 팀에서 누가 무임승차하는지처럼 행동에서 상황을 짐작하는 질문이 20개입니다.
눈여겨볼 부분. 표 1은 하네스 8개와 모델 24개를 묶은 33개 구성을 비교합니다. 추론 강도는 medium, 질문당 제한 시간은 20분이고, 세 번 돌린 평균입니다(4.1절). 1위는 Antigravity + Gemini 4 Argon의 80.25%입니다. 그다음이 Muse Code + Muse Wonder(73.74%), Claude Code + Fable 5.1(73.67%), Claude Code + Opus 5.5(72.65%), Claude Code + Muse Wonder(70.72%)이고, 나머지 28개는 66%에 못 미쳤습니다. 여기서도 하네스에 따라 결과가 달라졌습니다. 같은 Muse Wonder가 Muse Code에서는 143달러에 73.74%, Claude Code에서는 535.32달러에 70.72%였습니다(6.1절, 그림 3).
EnvOpt와 이어지는 결과는 에이전트가 데이터를 읽는 방식에 관한 것입니다. 저자들은 같은 에이전트에게 MCP로 슬랙 도구를 주는 대신, 워크스페이스를 내보낸 파일을 주고 터미널에서 grep·jq·cat으로 읽게 했습니다. 시험한 일곱 구성 모두 총점이 올랐고, 평균 7.85점이 올랐습니다(표 2). 약한 구성일수록 많이 올랐습니다. Codex + GPT-5.4-Mini는 27.04%에서 43.12%로, Codex + GPT-5.5는 45.52%에서 59.90%가 됐습니다. Claude Code + Opus 5.5는 72.65%에서 73.68%로 점수가 거의 그대로였지만, 비용은 54% 줄었습니다(5절). 이유는 표 3에 있습니다. MCP로 읽을 때는 도구 호출의 절반(50.9%)이 search_messages였는데, 이 도구는 결과마다 메타데이터를 잔뜩 붙여 돌려줍니다. 도구 정의를 불러오는 데도 호출의 15.1%를 썼습니다. 파일로 읽을 때는 호출의 58.6%가 그냥 읽기였습니다.
전제가 틀린 질문에서는 모델 계열에 따라 차이가 났습니다. 일어난 적 없는 문제가 해결됐는지 물으면, GPT 계열은 답부터 내놓고 마지막에야 전제가 다르다고 덧붙이는 일이 많았습니다. 그런 질문 가운데 GPT 6 Astra는 25%, GPT 6.1 Sol은 21%에서 이렇게 답했고, Opus 5.5는 8%였습니다(5절).
읽을 때 주의할 점. 80.25%는 네 갈래 점수를 같은 비중으로 평균한 값입니다. 그래서 요약 질문 하나가 사실 찾기 질문 하나보다 약 4배 무겁습니다(58 ÷ 14, 저희 계산). 사실 찾기만 보면 1위 구성은 70.69%로, Muse Code + Muse Wonder의 81.03%보다 낮습니다. 사람 기준선 84.5%는 제작에 참여하지 않은 연구자 3명이 Claude Code 같은 AI 도구를 써도 되는 조건에서 낸 점수입니다. 95% 신뢰구간은 77.0%에서 92.0%이고(6.5절), 1위 에이전트의 점수가 이 구간 안에 들어갑니다. 파일로 읽게 했을 때 총점은 모두 올랐지만 모든 갈래가 오르지는 않았습니다. Opus 5.5는 사실 찾기가 71.84%에서 66.67%로, 전제가 틀린 질문이 75.00%에서 72.92%로 내려갔습니다. 또 이 비교의 MCP 쪽은 저자들이 직접 만든 슬랙 도구였습니다. 일부 질문으로 공식 Slack MCP와 견줘 보니 모델 네 개와 질문 두 갈래로 나눈 8개 비교 중 7개에서 공식 도구가 높았고 1개는 같았습니다(표 5). 채점은 GPT-5.4가 했고, 한 구성의 판정 264건을 사람이 검토했을 때 95.8%가 일치했습니다(6.6절). 개발 중에는 벤치마크의 비공개 저장소에 접근할 수 있는 GitHub 토큰을 받은 에이전트가 그 저장소에 들어가 정답을 읽은 일도 있었습니다(6.3절). 저자들은 드문 일이었다고 적었고, 정답을 공개하지 않는 이유가 이것입니다.
직접 확인할 수 있나. 워크스페이스는 Hugging Face(HuanzhiMao/SlackBench)에 Apache-2.0 태그로 올라와 있습니다. 받으려면 로그인한 뒤 접근을 신청해야 하고, 신청은 자동으로 승인됩니다. 11월 13일에 저희가 본 공개 파일 목록에는 채널별 대화 기록과 README가 있었습니다. 정답은 연구자가 요청하면 받을 수 있습니다. 자기 에이전트가 MCP로 슬랙 같은 도구를 읽고 있다면, 같은 데이터를 파일로 내보내 실제 질문 몇 개를 두 방식으로 돌려 보세요. 이 논문에서 가장 싸게 해 볼 수 있는 시험입니다.
다음 호에서도 이번 주에 화제가 된 숫자를 원문 기준으로 대조해 정리합니다. 놓치지 않으려면 아래에서 뉴스레터를 구독해 주세요.