Paper of the Week #6 — 검사는 통과했는데, 무엇을 검사했을까
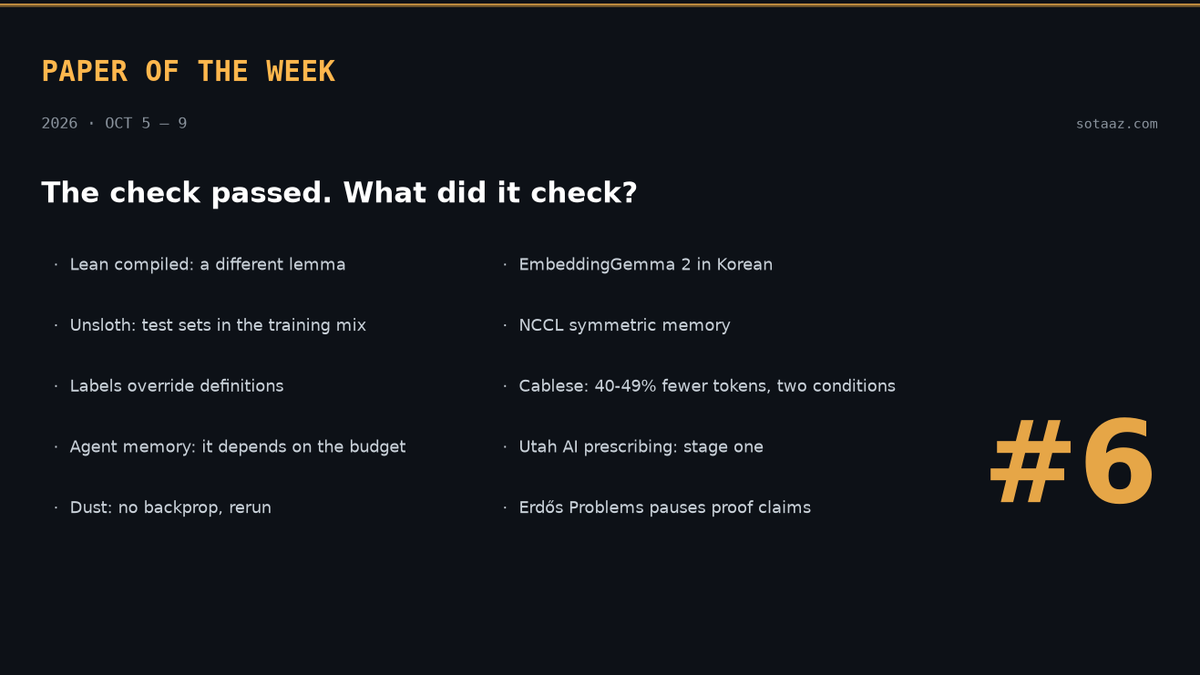
이번 주 화제를 묶었습니다. 형식화한 Lean 증명이 논문의 보조정리와 다른 것을 증명했고, 결정 모델 학습 가이드의 시험 데이터셋은 학습 데이터에도 들어 있었습니다. 에이전트 메모리는 모델이 몇 개를 읽느냐에 따라 결론이 달라졌고, NCCL symmetric memory의 이득은 B200에서 메시지 크기에 따라 154%부터 -2%까지 갈렸습니다. 출력 토큰을 40-49% 줄였다는 전보체 실험은 소문자와 추론 끄기가 조건이었고, AI 처방 파일럿의 1단계는 의사 두 명이 모든 처방을 먼저 승인합니다.
Paper of the Week #6 — 검사는 통과했는데, 무엇을 검사했을까
2026년 10월 5일-9일 · Lean과 나비에-스토크스 · Unsloth 결정 모델 · 라벨과 정의 · 에이전트 메모리 · Dust · EmbeddingGemma 2 · NCCL symmetric memory · 전보체 · 유타 AI 처방 · Erdős Problems
이번 주에는 열 가지를 골랐습니다. 대부분 같은 질문으로 묶입니다. 검사를 통과했다는데, 그 검사가 실제로 확인한 것은 무엇이었을까요. Lean 증명은 컴파일되지만 논문과 조금 다른 보조정리를 증명했고, 시험 데이터는 "오염 제거"를 거쳤지만 같은 데이터셋이 학습에 들어 있었고, "AI가 처방한다"는 처방도 파일럿 1단계에서는 의사 두 명이 먼저 승인합니다. 항목마다 무엇이 나왔는지, 저희가 출처에서 확인한 숫자, 읽을 때 주의할 점, 직접 확인할 수 있는지를 적었습니다. 이 중 네 가지는 이번 주에 저희가 직접 재 봤고, 자세한 글로 이어집니다.
Lean은 통과했는데, 논문의 보조정리를 증명한 걸까
무엇이 나왔나. 「Navier-Stokes lost in translation」(킹스칼리지 런던의 Alexander Bastounis, 케임브리지대의 Fabian Circelli·Anders C. Hansen, arXiv 2610.08144, 10월 6일)는 OpenAI가 나비에-스토크스 방정식의 유한 시간 폭발을 증명했다며 자연어 논문과 함께 공개한 Lean 코드를 살펴봤습니다. 초록에는 "형식화한 Lean 증명이 자연어 증명과 대응하지 않는다"고 적혀 있습니다.
눈여겨볼 부분. 예시 3.1입니다. OpenAI 논문의 보조정리 8.6은 어떤 연산자의 크기를 입력의 도함수 m + 4개로 묶는데, 대응하는 Lean 정리들은 모두 m + 5개를 씁니다. 도함수를 하나 더 요구하니 더 약한 명제입니다. 저희도 논문이 가리킨 버전의 Lean 저장소를 열어 봤습니다. NavierStokes/SmoothFamilyTorusInverse.lean의 norm_derivativeWord_inverse_le는 w.length + 5개의 도함수에 대한 조건을 가정하고, 지금 main에서도 그대로입니다. 논문은 압력 흐름 부등식에서도 어긋남을 하나 더 짚었습니다.
읽을 때 주의할 점. 저자들은 "OpenAI의 자연어 증명이 맞는지에 대해서는 주장하지 않으며, Lean으로 옮기는 과정의 오역만 다룬다"고 분명히 적었습니다. 그러니 이 논문을 "증명이 틀렸다"로 읽으면 안 되고, "Lean 검사를 통과했다고 자연어 논증까지 보증되지는 않는다"로 읽어야 합니다. OpenAI나 형식화한 쪽의 답은 아직 찾지 못했습니다. 저장소에 올라온 변경은 논문보다 앞선 두 번뿐이고, 이슈 탭은 닫혀 있습니다. 논문의 그림 네 개는 모두 ChatGPT-6와 나눈 대화 화면이고, 그림 3과 4에서는 챗봇이 Navier–Stokes 불일치 두 건에 대해 저자들과 같은 의견을 냅니다. 코드를 직접 대조한 것보다는 약한 근거입니다.
직접 확인할 수 있나. 일부만 됩니다. 식 (8.19)와 Lean 파일 1063번째 줄을 맞대 보는 데는 10분이면 됩니다. 다만 m + 5가 그 뒤 논증을 무너뜨리는지는 편미분방정식 전문가가 판단할 일입니다.
"오염 제거"를 했는데도 같은 데이터셋
무엇이 나왔나. Unsloth가 Jev 같은 결정 모델을 직접 학습하는 가이드를 냈습니다. 학습 코드는 10월 7일 Unsloth에 들어갔습니다. Unsloth가 직접 잰 표에 따르면 Qwen3.5-0.8B가 약 4GB 메모리로 BANKING77에서 7%에서 74%로, CLINC150에서 19%에서 76%로 올라갑니다. 시험 데이터는 학습 데이터 기준으로 "오염 제거"를 했다고 적었습니다.
저희가 재 본 것. Unsloth의 학습 스크립트를 기본값 그대로 써서 조건마다 시드 세 개로 학습했고, 판정 기준은 학습 전에 정해 두었습니다. BANKING77과 CLINC150은 표와 거의 같게 나왔습니다(75.4%, 75.0%). 그런데 두 데이터셋 모두 학습 데이터에 들어 있습니다. 가이드가 말한 오염 제거는 시험 문장과 13단어 연속으로 겹치는 학습 행을 버리는 처리인데, 이 두 데이터셋은 문장이 짧아서 실제로 빠진 것은 BANKING77 3행, CLINC150 0행이었습니다. 두 데이터셋을 학습에서 빼고 같은 500행으로 재면 56.5%와 55.9%로, 19%p 안팎 낮았습니다. typed-decisions는 표의 73%보다 낮은 61.2%였는데, 같은 13단어 검사가 이 데이터셋의 학습 사례 1,200건 중 850건을 버린다는 것도 확인했습니다. 결과를 본 뒤 따로 돌린 사후 실행에서 이 사례를 학습에 그대로 두자, typed-decisions는 74.3%로 표와 1.3%p 차이까지 올라왔습니다.
읽을 때 주의할 점. 가이드에 틀린 말은 없습니다. 같은 데이터셋 안에서 잰 정확도를 보고한 것입니다. 다만 직접 다루는 과제가 학습에 없던 의도를 분류하는 일이라면 56% 쪽이 더 가까운 예상치입니다.
직접 확인할 수 있나. 됩니다. GPU 한 장이면 되고, 저희 실행에서 최대 메모리는 4.15GB, 다른 학습과 GPU를 나눠 쓴 상태에서 한 번에 20분 안팎이었습니다. 자세한 내용은 결정 모델 직접 학습기에 있습니다.
결정 모델은 정의보다 라벨을 읽는다
무엇이 나왔나. 「Labels Override Definitions in Jev-Style Typed Decision Models」(Azizi, Baghaei Potraghloo, Pedram, arXiv 2610.02586)는 공개 결정 모델이 선택지마다 적어 준 정의를 따르는지, 선택지 이름을 따르는지 따져 봤습니다. 정의를 모두 지워도 laya-td의 정확도는 그대로였습니다(0.8559 대 0.8487). 논문이 지목한 원인은 모델 가중치가 아니라 프롬프트를 만드는 코드 한 줄이었고, 정의만 넣게 고치면 laya 체크포인트 세 개가 라벨과 무관하게 같은 답을 냈습니다.
읽을 때 주의할 점. 선택지 이름을 A, B로 바꾸면 0.1511 오른다는 결과는 규칙이 정의에만 들어 있게 만든 합성 데이터에서 나왔습니다. 논문의 분류 과제 11개에서는 라벨을 글자로 바꿔 정의만 남기면 laya-td가 0.7971로, 라벨과 정의를 함께 줄 때의 0.8559보다 낮았습니다. 호스팅 Jev는 재지 않았습니다.
직접 확인할 수 있나. 됩니다. 저희가 논문의 laya 체크포인트 세 개 중 두 개(laya 0.3.7)로 다시 돌려 보니 코드 한 줄 수정으로 두 체크포인트 모두 라벨과 무관한 결과가 그대로 나왔고, 정의와 어긋나는 라벨을 붙이자 TREC 정확도가 88.6%에서 22.2%로 떨어졌습니다. 자세한 내용은 재측정 글에 있습니다.
에이전트 메모리, 모델이 몇 개를 읽느냐에 따라 답이 바뀐다
무엇이 나왔나. 언뜻 결론이 엇갈려 보이는 논문 두 편입니다. 「When Does Selection Replace Extraction?」(독립 연구자 Rishabh Sharma·Rishika Lall, arXiv 2609.34227, 사전 등록, 코드 MIT)은 대화를 그대로 저장해 두고 Jev로 필요한 턴을 고르는 방식과, 저장할 때 사실을 뽑아 두는 메모리 시스템을 비교했습니다. 개발에 쓰지 않은 LoCoMo 778문항에서 gpt-4o-mini가 답할 때, Jev로 고른 원래 대화는 77.0%, 저자들이 만든 추출형 시스템은 77.5%였습니다. 미리 정한 기준(하한 -3.0, 허용 폭 -5)으로 뒤지지 않는다고 판정했고, 저장 비용은 3,061배 쌌습니다. 한편 VibeMemBench(arXiv 2609.23570, 중국과학원 선전선진기술연구원·선전과학기술대·알리바바)는 코딩 에이전트와 메모리 시스템 조합 12개 중 11개가 메모리를 끈 같은 에이전트를 넘지 못했다고 보고합니다.
눈여겨볼 부분. 답변 모델이 읽는 항목 수입니다. 첫 논문에서 후보 30개를 다시 순위 매기면, 3개만 읽을 때는 이득이 크지만(LoCoMo +17.4점, LongMemEval +9.1점) 20개를 읽을 때는 거의 없고(+1.5, +1.1점) 오히려 추출형 시스템이 더 정확합니다. 같은 논문은 재순위화가 "모르면 모른다고 답하기"를 줄인다는 결과도 냈습니다. 3개만 읽을 때 함정 질문에 모른다고 답한 비율이 63.6%에서 54.1%로 떨어졌습니다. 그러니 "메모리가 쓸모 있나"는 "모델이 몇 개를 읽나"를 정하지 않으면 답이 없는 질문입니다.
읽을 때 주의할 점. VibeMemBench는 기준 설정에서 과거 기록을 넣었을 때 결과가 좋아진 과제만 남겼다고 초록에 밝혔습니다. 메모리에 유리하게 고른 과제에서도 12개 중 11개가 못 넘었다는 뜻이라 결과는 오히려 강하지만, 코딩 과제 전체를 대표하는 표본은 아닙니다. 첫 논문의 블라인드 사람 재채점은 1저자가 했고, 채점 모델(gpt-4o-mini 하나)이 두 시스템 중 한쪽만 맞았다고 본 141문항만 다시 봤습니다.
직접 확인할 수 있나. 첫 논문의 make reproduce-v3는 저장소에 올려 둔 결과 파일에서 논문의 모든 숫자를 다시 만들고, API는 부르지 않습니다. 실험 자체를 다시 돌리려면 OpenAI와 Jev 유료 호출이 필요합니다.
Dust, 역전파 없이 사전학습
무엇이 나왔나. Q Labs의 Dust(Dahal, Mandal, Gülbahar, Vegesna, 논문, 코드 MIT)는 역전파 없이 트랜스포머 언어 모델을 학습합니다. 중간 활성값을 살짝 흔들어 loss가 어떻게 바뀌는지 보고, 그 변화로 가중치를 고칩니다. 1M 토큰에서 업데이트마다 천 번쯤 흔들면 역전파보다 loss가 낮게 끝난다고 보고했고, 역전파를 대체할 만큼 계산 효율을 높이려는 것은 아니라고 밝혔습니다.
저희가 재 본 것. 저자 코드로 1M 토큰에서 다시 돌리니 1,024번 흔든 Dust는 5.938, SGD 역전파는 시드 20개 평균 5.941이었습니다. 차이는 어느 쪽으로든 0.02 안쪽이었고, 논문의 0.025 차이는 나오지 않았습니다. 역전파에 논문이 쓴 Adam 설정을 주면 같은 한 바퀴에서 5.384, 논문의 SGD 설정 그대로 같은 데이터를 16번 보게 하면 5.209였고, 이때 계산량은 Dust의 4.6%였습니다. 자세한 내용은 Dust 재측정 글에 있습니다.
읽을 때 주의할 점. 1,024번 흔드는 Dust는 한 스텝에 역전파의 약 347배 계산을 씁니다. 더 흥미로운 주장은 10M, 20M 토큰에 있는데 저희는 그 규모를 돌리지 않았습니다.
EmbeddingGemma 2와 한국어 검색
무엇이 나왔나. Google DeepMind가 EmbeddingGemma 2를 공개했습니다. 270M 텍스트 모델을 중심에 둔 740M 공개 임베딩 모델(Apache 2.0)입니다. 모델 카드에는 다국어 MTEB 61.36(1세대 61.15)이 있고, 한국어만 따로 잰 값은 없습니다.
저희가 재 본 것. 저희 블로그의 한국어·영어 글 177쌍에서 글마다 써 둔 설명을 검색어로 넣어 보니, 한국어 글을 1순위로 찾은 수는 1세대가 더 많았습니다. 162개 대 153개(p = 0.022)였고, 한국어로 검색해 영어 글을 찾을 때도 164개 대 155개(p = 0.035)였습니다. 영어끼리는 차이가 없었습니다. 자세한 내용은 EmbeddingGemma 2 한국어 검색 글에 있습니다.
읽을 때 주의할 점. 글 설명은 본문과 단어가 많이 겹쳐서 실제 사용자 질문보다 쉬운 검색어입니다. 한국어끼리 검색에서는 단순한 키워드 검색(BM25)도 EmbeddingGemma 2와 같은 점수를 냈습니다.
NCCL symmetric memory, 작은 all-reduce에서는 2.5배, B200의 8GiB에서는 조금 느림
무엇이 나왔나. Stas Bekman이 10월 5일 ml-engineering에 NCCL symmetric memory 측정을 올렸습니다. 8×B200 노드와 8×H200 노드에서 symmetric 버퍼를 쓸 때와 안 쓸 때의 all-reduce 버스 대역폭을 비교했습니다(torch 2.14.0+cu130, NCCL 2.30.7, 두 번 잰 평균). B200에서는 32KiB에서 154%, 1MiB에서 83%, 64MiB에서 76%, 1GiB에서 12% 빨랐고, 8GiB와 16GiB에서는 2% 느렸습니다. H200에서는 이득이 32KiB 133%에서 1GiB 3%까지 줄지만 손해로 바뀌지는 않았습니다.
읽을 때 주의할 점. 모든 GPU가 NVLink로 직접 연결돼 있어야 하고, 버퍼를 symmetric으로 등록한 메모리 풀에서 할당해야 합니다(register_mem_pool(pool, symm=True), torch 2.9 이상). 평범한 텐서로 all-reduce하는 코드는 이 이득을 전혀 얻지 못합니다. 또 이 숫자는 GPU가 바쁜 동안 호출이 줄줄이 쌓이는 상황을 전제로 합니다. 호출마다 끝나기를 기다리는 방식으로 재면 32KiB 이득이 154%가 아니라 37%입니다. 버스 대역폭이 곧 학습 속도도 아닙니다.
직접 확인할 수 있나. NVLink가 있어야 합니다. 저희 A100 PCIe 서버는 NVLink가 없어서 재 볼 수 없습니다.
전보체로 쓰면 토큰 40-49% 절감, 조건은 둘
무엇이 나왔나. Travis(GitHub Travis42)의 「The Telegraph Test」(저장소, 코드 Apache-2.0, 데이터 CC BY 4.0)는 모델에게 글을 19세기 전보처럼 관사와 군말을 뺀 문체로 기록하게 하고, 다른 모델이 그 기록만 보고 질문에 답하게 했습니다. 소문자로 쓰라는 지시를 붙이고 추론을 끄면, 지문 50개에서 실제 과금된 출력 토큰이 GLM-5.3-Flash 48.4%, Qwen3.8-27B 48.9%, Gemma 4 31B 40.4% 줄었습니다. 727문항에서 읽는 모델의 정답률은 일반 기록을 볼 때의 1.01-1.09배였습니다.
읽을 때 주의할 점. 조건 두 가지가 다 중요합니다. 소문자 지시가 없으면 기록이 대문자로 나오고 절감 폭은 25-34%에 그칩니다. GPT-5-mini는 전보체를 쓰라고 하자 추론을 세 배쯤 더 해서 쓰기 비용이 오히려 두 배가 됐습니다. 채점은 정해진 코드로 하고, 이전에 LLM 채점을 썼다가 모델이 자기 답을 후하게 채점하는 것을 발견하고 그 숫자를 전부 지웠다고 적었습니다. 채팅 답변이 아니라 다른 모델이 읽을 기록이라는 설정이고, 지문 묶음도 하나뿐입니다.
직접 확인할 수 있나. 됩니다. verify_headlines.py는 고정해 둔 실행 결과에서 README 숫자를 API 호출 없이 다시 계산합니다. 저희가 돌려 보니 31개 검사가 모두 통과했습니다. 로컬 Qwen으로 다시 재는 것이 다음 단계이고, GPU 시간 말고는 비용이 들지 않습니다.
"사람의 직접 감독 없이 처방"인데 1단계는 의사 두 명
무엇이 나왔나. 유타주 AI 정책국이 Nolla Health의 파일럿을 승인했습니다. AI가 처방 갱신뿐 아니라 첫 처방까지 내리는데, 대상은 유타에 사는 성인 경증-중등도 여드름이고 정해 둔 바르는 약 몇 가지로 한정됩니다(먹는 약과 이소트레티노인 제외는 SiliconANGLE 보도 기준). 일부 헤드라인은 "사람의 직접 감독 없이 처방한다"고 썼습니다.
읽을 때 주의할 점. Nolla의 발표에 따르면 1단계는 첫 환자 100명을 대상으로 최소 4주 운영하고, 이 단계에서는 "면허가 있는 의사 두 명이 각자 모든 AI 처방을 환자에게 가기 전에 검토하고 승인"합니다. 의사가 사후에만 검토하는 2단계로 가려면 "의사와 95% 일치, 심각한 부작용 0건, 주 정부의 서면 승인"이 필요합니다. 일부 보도는 100명이라는 조건만 남기고 나머지 두 조건을 빼서, 큰 문제만 없으면 저절로 넘어가는 것처럼 썼습니다. 주 정부 협약서 원본은 열리지 않아(403), 단계 조건은 Nolla 발표와 Healthcare Dive 보도를 기준으로 적었습니다. 1월에 시작한 유타의 다른 파일럿(Doctronic)은 처방 갱신만 다루니 섞지 않아야 합니다.
직접 확인할 수 있나. 아니고, 의료 판단은 하지 않습니다. 여기서 얻을 것은 읽기 교훈 하나입니다. 단계마다 붙은 조건은 헤드라인에서 가장 먼저 사라집니다.
Erdős Problems, 증명 제출을 멈췄다
무엇이 나왔나. erdosproblems.com을 운영하는 Thomas Bloom이 10월 6일 공지를 올렸습니다. 변화는 네 가지입니다. 문제별 댓글과 증명 주장 받기를 잠정 중단하고(hiatus), 어떤 문제가 풀렸는지 표시하지 않으며, 앞으로의 결과에는 사람이든 AI든 누구의 공로인지 적는 표현을 쓰지 않고, 잘 쓴 풀이 해설을 앞세우겠다는 내용입니다. 이유로는 사이트에 오는 댓글 대부분이 AI로 만든 증명을 알리는 글이고, 설명 없이 "점점 의미가 없어지는 선점 기록"을 남기려는 용도라고 적었습니다. 그는 이 변화를 "다소 실험적"이라고 했고, 기존 댓글은 기록으로 남습니다.
읽을 때 주의할 점. Bloom은 그 덕분에 "전에 몰랐던 많은 질문의 답을 알게 됐다"고도 적었고, 최근 진전의 상당 부분은 사람들의 노력이 되살아난 덕분이라고 덧붙였습니다. 댓글에서 Sam Korsky는 뒤의 두 변화(공로 표현, 해설 강조)는 괜찮다고 했지만 앞의 두 변화(잠정 중단, 풀림 표시 숨기기)에는 반대하면서, 그 "유일한 효과"는 수학의 진전을 덜 보이게 만드는 것이라고 했습니다. 풀림 표시는 숨겨질 뿐이고, 풀린 문제가 다시 미해결로 바뀌는 것은 아닙니다.
직접 확인할 수 있나. 잴 것은 없습니다. 공지와 댓글이 짧으니 전체를 읽어 볼 만합니다.
정산
5호는 남은 과제를 측정 글로 넘겼습니다. Suffix Cache Reuse, 저희 BANKING77·CLINC150 문장에서 Clef-flash 재기, A100 PCIe에서 MSMF 다시 재기입니다. 이번 주에는 셋 다 돌리지 못했습니다. GPU가 GPT-2 연재와 위의 측정 글 네 편에 쓰였기 때문입니다. A100은 10월 9일 이후 비고, 한 장으로 30분이면 되는 MSMF가 첫 순서입니다. 그 전부터 남아 있던 MoE 결과의 DeepSeek-V2-Lite 대조군과 토큰 고정, HoH 10회 실행도 아직 열려 있습니다.