Paper of the Week #9 — 물리학자가 낸 연구 과제 56개, 가장 잘한 에이전트도 168번 중 46번만 통과했습니다
이번 주 화제를 묶었습니다. 물리학자 42명이 자기 연구로 만든 과제 56개에서 가장 잘한 에이전트 구성도 168번 시도 중 46번(27.4%)만 통과했고, 실패의 주된 원인은 물리 지식이 아니라 엄밀하지 못한 추론이었다는 FrontierPhysics, 에이전트가 쓴 연구 제안서가 실제로 나온 연구와 겹치는 정도가 사람 논문끼리 겹치는 정도의 약 18%라는 IdeaTaste를 다룹니다. 질문마다 모델을 완벽하게 고르면 5.12점이 오르지만 학습한 라우터는 0.30점에 그친 Route Anything, 다른 모델의 미세조정을 다섯 라운드 돌린 하네스 CoworkOS, 7B 추론 모델의 수학 답을 약 44% 줄인 LoCo도 함께 정리했습니다.
Paper of the Week #9 — 물리학자가 낸 연구 과제 56개, 가장 잘한 에이전트도 168번 중 46번만 통과했습니다
2026년 11월 2일-6일 · FrontierPhysics · IdeaTaste · Route Anything · CoworkOS · LoCo
물리학자 42명이 자기 연구에서 문제를 골라 과제 56개를 만들고, AI 에이전트에게 한 번에 최대 10시간씩 맡겼습니다. 가장 잘한 구성인 Claude Code의 Claude Opus 5.5도 168번 시도 가운데 46번만 통과했습니다. 물리학자들이 다른 에이전트의 실패 기록을 직접 읽어 보니, 가장 흔한 문제는 물리 지식이 모자란 것이 아니었습니다. 틀린 가정 위에서 그 가정에 기대는 방법으로 답을 검산하는 식의, 엄밀하지 못한 추론이었습니다. 같은 주에 나온 다른 논문은 비슷한 모습을 반대편에서 보여 줍니다. 내년 연구를 제안하라고 하자 에이전트는 연구자들이 실제로 다룬 문제는 곧잘 골랐지만, 연구자들이 택한 접근까지 맞힌 경우는 드물었습니다. 지난 #8에서는 점수가 결과만 보는지, 결과에 이르는 과정도 보는지를 물었습니다. 이번 호의 앞 두 항목은 연구를 맡은 에이전트가 정확히 어디에서 막히는지를 봅니다. 나머지 셋은 실무 쪽입니다. 요청마다 모델을 고르는 문제, 다른 모델의 미세조정을 맡은 하네스, 추론을 짧게 줄이는 방법입니다. 항목마다 무엇이 나왔는지, 저희가 원문에서 확인한 숫자, 읽을 때 주의할 점, 직접 확인할 수 있는지를 적었습니다.
물리학자가 자기 연구로 만든 과제 56개, 가장 잘한 에이전트의 통과율은 27.4%였습니다
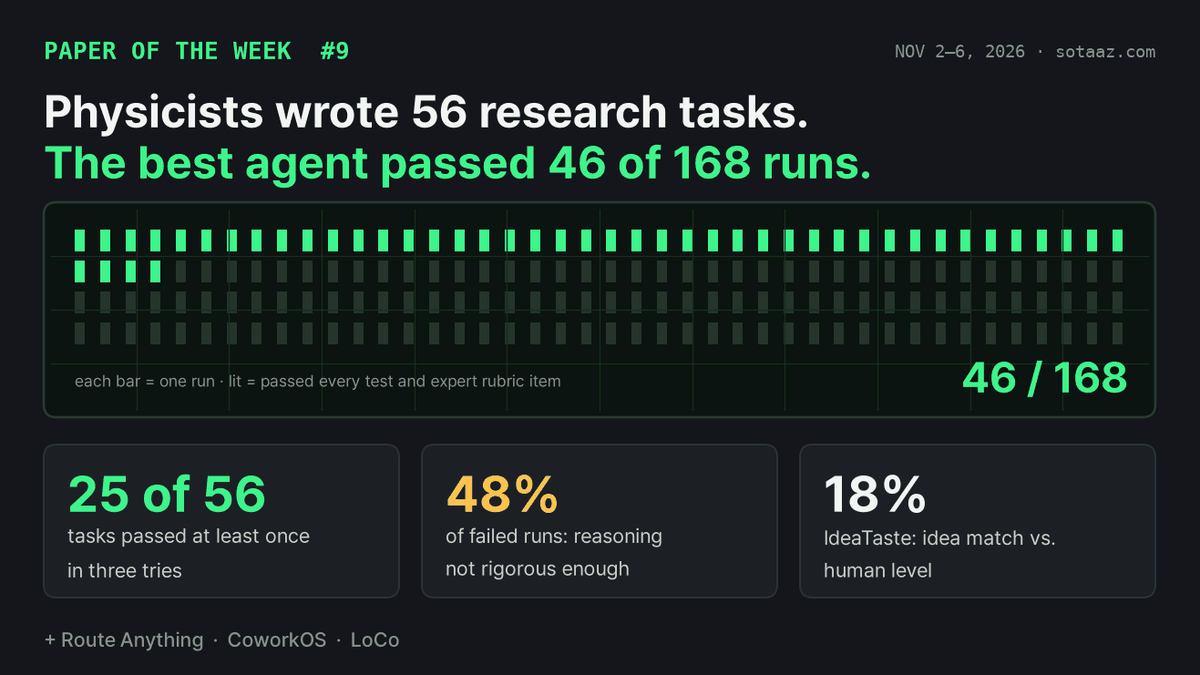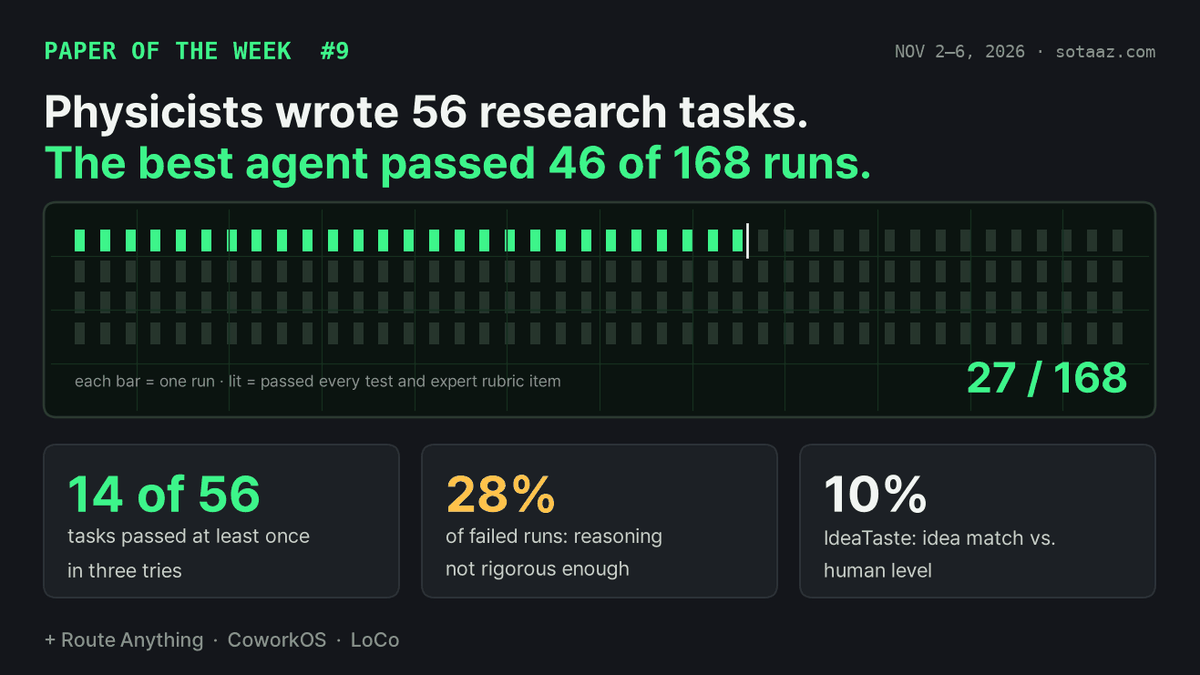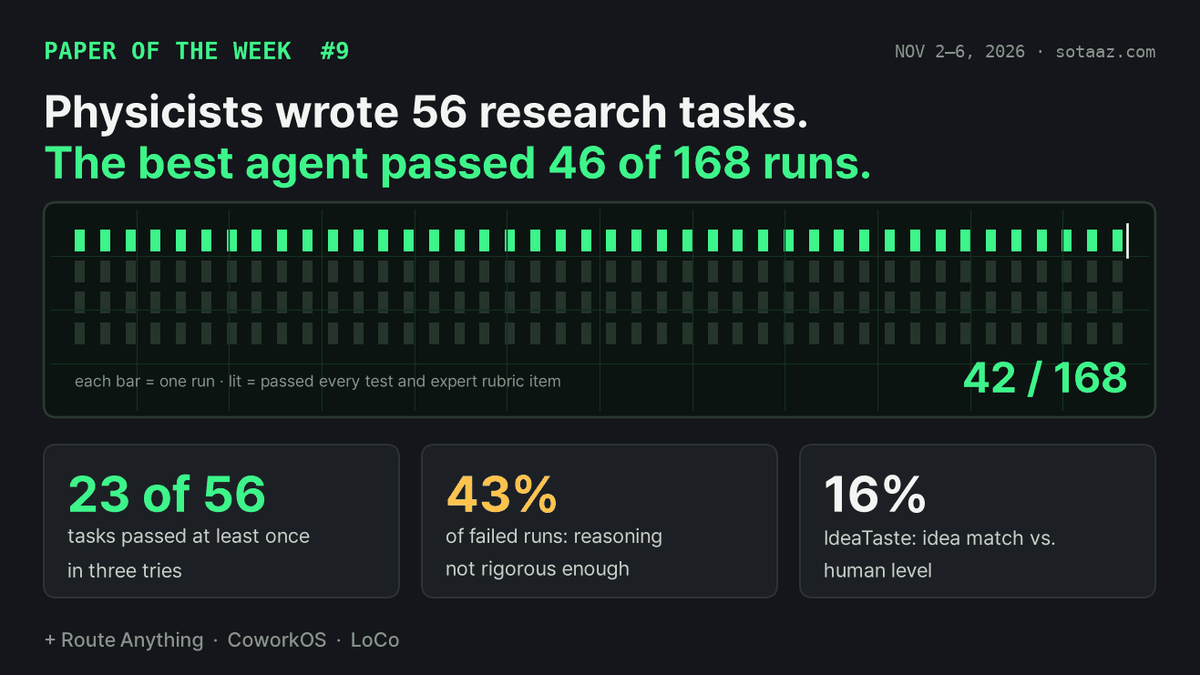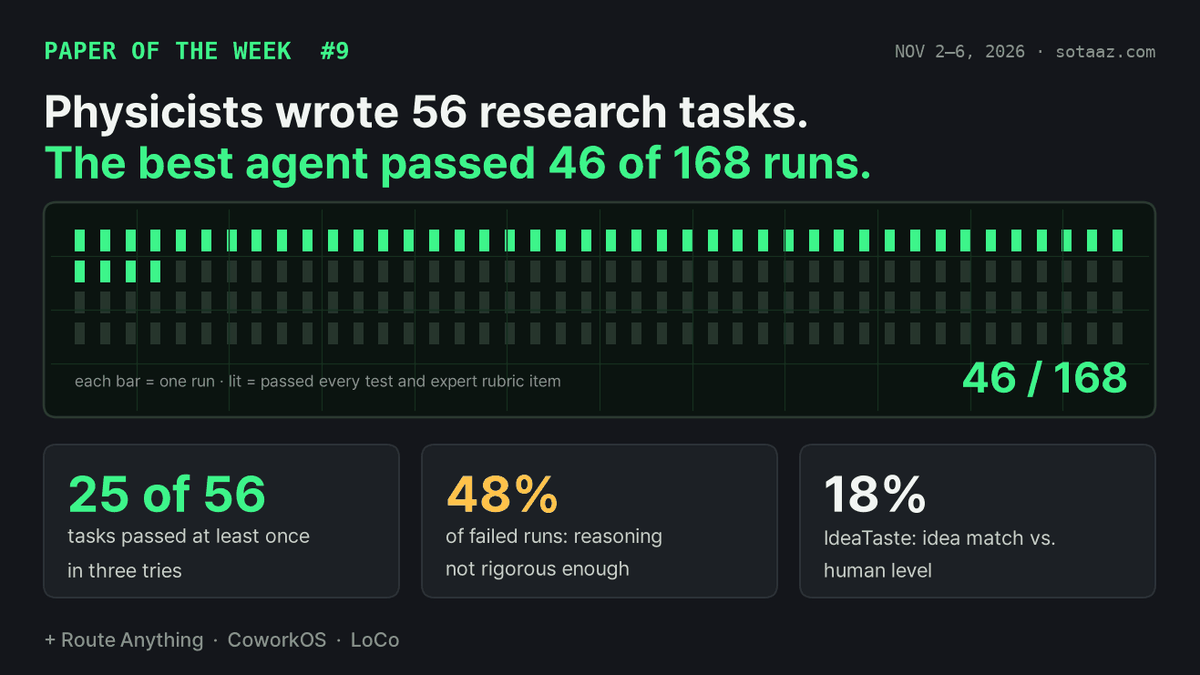
무엇이 나왔나. 「FrontierPhysics: Evaluating Agents for End-to-End Physics Research」(You 외 72명, BenchFlow·UC 버클리 주도에 Caltech·하버드·스탠퍼드 등 공동, arXiv 2611.06910, 11월 4일, CC BY 4.0)는 물리학자 42명이 이론·계산·실험 물리 9개 분야에서 과제 56개를 만든 시험대입니다. 에이전트는 연구실 책임자가 학생에게 일을 넘기듯 짧은 지시문과 연구 제안서, 입력 파일을 받고, 수치 결과와 논문 한 편을 내야 합니다. 결정적 검사를 모두 통과하고 전문가 채점표의 '필수' 항목도 하나도 빠짐없이 채워야 통과입니다(2.3절). 모델 22개를 26개 구성으로 돌렸고, 과제마다 세 번씩 시도해서 구성 하나당 168번(56 × 3)입니다. 가장 잘한 Claude Code의 Claude Opus 5.5가 168번 중 46번, 27.4%를 통과했습니다(부트스트랩 95% 구간 17.9-36.9, 표 8). 세 번 중 한 번이라도 통과한 과제로 세면 44.6%입니다. 다음은 GPT-6 Astra(max)의 23.2%였는데, 논문은 이 차이를 통계적으로 구분되지 않는다고 표시했습니다.
눈여겨볼 부분. 과제를 낸 물리학자들이 자기 과제에서 GPT-6 Astra(xhigh)가 실패한 세 번의 기록을 읽고 보고서를 썼고, 운영진이 이를 14개 범주로 묶었습니다(3.3절). 실패 143건 가운데 '추론이 엄밀하지 않음'이 68건(48%), '전문가의 직관 부족'이 48건(34%), 문헌 문제가 39건(27%)이었습니다. 물리를 틀린 경우는 23건(16%), 실행 오류는 6건(4%)이었습니다. 한 건에 여러 범주가 붙을 수 있습니다. 리드베리 원자 실험의 오차 원인을 분석하는 과제에서는 에이전트들이 리드베리 상태의 붕괴를 아예 고려하지 않았습니다. 저자들은 원자·분자·광학 물리학자라면 당연히 따져 볼 요소라고 적었습니다(표 4). 저자들이 짚은 또 하나의 패턴은 순환 검산입니다. "에이전트의 검증 방법 자체가 틀린 가정에 기대고 있어서, 실수를 끝내 찾지 못한다"는 것입니다(3.4절). 같은 회사 모델끼리는 비용과 성적이 반대로 움직였습니다. Claude 모델의 통과율은 Opus 5.5, Fable 5.1, Opus 5 순이었는데, 시도당 비용은 그 반대 순서였습니다(3.2절). Opus 5.5의 시도당 평균 비용은 26.95달러입니다(표 10).
읽을 때 주의할 점. 모든 시도를 GPT-5.6 Sol(xhigh) 한 채점 에이전트가 채점했고, 같은 구성이 순위표에도 올라 있습니다. 저자들은 1차 시도를 Claude Opus 5.5에게도 다시 채점시켰습니다(표 6). GPT-6 Astra의 시도에서는 두 채점자가 거의 같았습니다(통과 25건과 26건). Opus 5.5의 시도에서는 기본 채점자가 37건을, Opus 채점자가 44건을 통과시켰습니다. 저자들은 Opus 채점자가 같은 계열 모델의 시도에 더 너그러웠다고 적었습니다. 위의 27.4%는 기본 채점자 기준입니다. 실패 범주는 GPT-6 Astra 하나의 기록에서 나왔고, 저자들도 다른 모델은 다르게 실패할 수 있다고 밝혔습니다. 채점자가 GPT-6 Astra의 시도 168건 중 9건을 잘못 떨어뜨린 것도 확인됐는데, 이 보정은 GPT-6 Astra에만 했고 다른 모델의 숫자는 같은 방식으로 고치지 않았습니다(3.4절). 기준 자체도 사람에게 쉽지 않습니다. 저자들이 직접 만든 참고 자료도 같은 채점표에서 평균 96.2%였습니다(표 11).
직접 확인할 수 있나. 쉽지 않습니다. 논문은 실행 도구인 BenchFlow(benchflow-ai/benchflow)를 인용하지만, 과제 자체나 모았다고 밝힌 실행 기록의 공개 링크는 찾지 못했습니다. 한 번 시도에 최대 10시간이 걸리고, GPU 머신이 필요한 과제도 있습니다.
문제는 맞게 골랐지만, 연구자가 택한 접근까지 맞힌 경우는 드물었습니다
무엇이 나왔나. 「IdeaTaste: Do LLMs Share the Research Taste of Human Researchers?」(Zhong·Xu·Ning·Kumar·Xiong, 카네기멜런대, Liu, MBZUAI, arXiv 2611.03424, 11월 2일, CC BY 4.0)는 에이전트에게 2025년까지의 문헌을 주고 연구 제안서를 쓰게 한 다음, 같은 연구 분야에서 2026년 1월부터 8월까지 실제로 나온 논문과 비교합니다. 모델 6개, 연구 분야 4개, 제안서 9만 편 이상입니다. 점수는 두 가지입니다. 인용 일치는 제안서의 참고문헌이 실제 논문의 참고문헌과 얼마나 겹치는지를 봅니다. 아이디어 일치는 초록을 문제·동기·접근 같은 부분으로 나누고, 채점 모델(GPT-5.6 Luna)이 부분마다 가장 가까운 실제 논문과 대조합니다(3.2절). 초록의 결론은 에이전트가 인용 일치에서 사람 수준의 약 26%, 아이디어 일치에서 18%에 그쳤다는 것입니다.
눈여겨볼 부분. '사람 수준'이 무엇인지부터 짚어야 합니다. 2026년 논문들이 서로 얼마나 겹치는지를 기준으로 삼았고, 이때 각 논문은 다른 사람 논문과만 비교합니다(3.2절). 이 기준값부터 높지 않습니다. 인용은 16.38-20.84, 아이디어는 10.53-13.87입니다(표 2). 그래서 18%는 제안서의 품질이 사람의 18%라는 뜻이 아닙니다. 실제 논문끼리 겹치는 정도에 비해 에이전트 제안서가 실제 연구와 겹치는 정도가 약 18%라는 뜻입니다. 그림 4의 사례가 이 차이를 잘 보여 줍니다. 문제는 캐시에 없는 MoE 전문가 가중치를 불러올 때 생기는 I/O 비용입니다. 2026년에 나온 실제 논문 ReMoE는 최근에 쓴 전문가를 고르도록 라우터를 미세조정했습니다. Qwen3.8-27B가 쓴 제안서 하나는 같은 문제를 잡았지만, 모델은 그대로 두고 필요한 전문가를 예측해 미리 불러오는 방법을 제안해서 일치로 세지 않았습니다. 같은 모델이 쓴 다른 제안서는 라우터만 학습하는 방법이었고, 이쪽은 일치로 셌습니다. 논문의 정리는 "문제가 같다고 접근까지 같지는 않다"입니다. 블라인드 평가에서는 심사자 11명이 제안서 96편과 실제 논문 96편을 읽었습니다. 성공 가능성 점수는 실제 논문 70.70, 제안서 50.39였고, 심사자들은 제안서의 86.46%를 AI가 쓴 것으로 판단했습니다(표 3). 제안서를 훨씬 많이 쓰게 해도 차이는 줄지 않았습니다. 곡선은 사람 수준에 한참 못 미치는 곳에서 평평해졌습니다(5절).
읽을 때 주의할 점. 저자들도 일치도가 높다고 해서 그 자체로 연구 품질이 높다는 뜻은 아니라고 적었습니다(부록 A.5). 실제로 아이디어 일치가 가장 높은 Llama 4 Scout가 심사 점수는 가장 낮았습니다(4절). 아이디어 채점 모델은 한 분야(자동화 연구)의 40쌍으로만 검증했고, 주석자 세 명과의 일치율은 동기 70.00%에서 문제 87.50% 사이였습니다(부록 B.4). 모델별 심사 점수는 모델당 16편에 기대고 있습니다. 파이프라인 일부 단계에 DeepSeek-V4-Flash를 썼는데, 이 모델은 평가 대상 여섯 개 중 하나이기도 합니다(표 17).
직접 확인할 수 있나. 일부만 됩니다. 리더보드는 공개돼 있고 계속 갱신한다고 합니다. 논문에서 코드나 데이터 저장소 링크는 찾지 못했습니다.
질문마다 모델을 완벽하게 고르면 5.12점, 학습한 라우터는 0.30점이었습니다
무엇이 나왔나. 「Route Anything: A Study of Model and Policy Routing for General-Purpose AI Systems」(Zhou 외, NUS HPC-AI Lab 주도에 Cardinal AI Lab·UC 버클리·HKUST 공동, arXiv 2611.05275, 11월 3일, CC BY-NC-SA 4.0)는 늘 같은 모델을 쓰는 대신 요청마다 모델·도구·실행 계획을 골라 쓰면 얼마나 이득인지를 잽니다. 후보에는 LLM, 이미지 생성 모델, 로봇 정책, 그리고 '싼 모델로 먼저 해 보고, 검증에서 걸리면 비싼 모델로 넘긴다' 같은 계획까지 들어갑니다. 후보 구성 452개를 벤치마크 25개에서 돌려 채점한 실행이 37만 4,401회입니다. 그중 24개 벤치마크(시험 입력 1만 9,814개)에서, 벤치마크마다 가장 좋은 후보 하나를 계속 쓰면 82.60점이었습니다. 결과를 다 본 뒤 입력마다 가장 좋은 후보를 고르는 이상적 선택(오라클)은 87.98점으로, 5.38점 높았습니다(표 1).
눈여겨볼 부분. 저자들이 학습시킨 라우터는 이 차이를 거의 가져가지 못했습니다. 라우터를 학습한 16개 벤치마크에서 가장 좋은 라우터가 79.98점, 고정 최고 후보가 79.68점, 오라클이 84.80점이었습니다(4.1절). 오라클은 5.12점 앞서고, 라우터는 0.30점 앞섭니다. 초록의 5.4점과 0.3점은 서로 다른 벤치마크 묶음에서 나온 숫자라서, 같은 묶음끼리 비교하면 5.12점 대 0.30점이 맞습니다. 다른 설계도 마찬가지였습니다. 입력마다 '이긴 후보'를 라벨로 붙여 배우는 방법 12가지 중 가장 좋은 것이 78.87점으로, 고정 후보의 79.44점보다 낮았습니다. 이미지 생성에서는 라우터 설계 31개 중 어느 것도 고정 생성 모델보다 확실히 낫지 않았습니다(4.1절). 저자들은 이유를 세 가지로 듭니다. 입력마다 생기는 차이의 일부는 어떤 라우터도 예측할 수 없는 노이즈입니다. 한 벤치마크 안에서는 대개 후보 하나가 거의 모든 유형의 입력에서 이깁니다. 그리고 '이긴 후보' 라벨의 94%가 응답 시간으로 갈렸습니다(4.3절). 라우터가 주로 배운 것은 어느 후보가 가장 빠른지였던 셈입니다.
읽을 때 주의할 점. 초록에는 라우팅으로 효율이 8.82배 오르고 품질 손실은 0.5점 미만이라고도 적혀 있습니다. 이 숫자는 기준 모델 대비 비용당 품질을 네 시험대에서 단순 평균한 값입니다. 코드 25.5배, 텍스트 질의응답 7.1배, 이미지 생성 1.35배, 로봇 1.33배입니다(표 5). 품질을 똑같이 유지한 채 얻은 효율은 아닙니다. 이미지 생성에서는 품질이 0.47점 떨어졌고, 구간이 −0.87에서 −0.06이라 0을 포함하지 않습니다. 비용은 달러 기준이고, 로봇만 정책 실행 시간(초) 기준입니다. 오라클은 모든 입력에서 모든 후보의 결과를 보고 고르는 것이라 실제로 배포할 수 있는 방법이 아니라 상한선입니다.
직접 확인할 수 있나. 아직은 어렵습니다. 논문에서 코드나 37만 4,401회 실행 데이터의 링크를 찾지 못했습니다. 로컬 모델과 호스팅 모델 사이에서 요청을 나눠 보내고 있다면, 이 논문이 알려 주는 가장 싼 확인법이 있습니다. 라우터를 만들기 전에 가장 나은 모델 하나를 계속 쓸 때의 성적부터 재 보는 것입니다.
하네스가 다른 모델의 미세조정을 다섯 라운드 돌렸습니다
무엇이 나왔나. 「CoworkOS: Scaling Agent Coworkers for Real-world Automation」(Jin 외 39명, 중국 인민대 주도에 푸단대·베이징대, 상하이교통대·NUS·화둥사범대 공동, arXiv 2611.03178, 11월 2일)는 긴 작업용 하네스입니다. 전략은 모델이 정하고 실행 관리는 런타임이 맡습니다. 에이전트는 직접 일하거나 하위 에이전트에게 나눠 맡기고, 작업 공간과 기억을 남겨 이어서 할 수 있으며, 사람과 에이전트가 문서·슬라이드·CAD 모델·Blender 장면을 함께 고칠 수 있습니다. 저자들은 다른 하네스 세 개(OpenHands, Codex, DeepSeek Harness)와 모두 GLM-5.3으로 4개 분야 12개 벤치마크에서 비교했습니다(표 1). 화제가 된 것은 4.3절의 사례입니다. GLM-5.3이 지휘하는 CoworkOS가 Qwen3.6-35B-A3B를 다섯 라운드 동안 미세조정했고, 벤치마크 8개 평균이 33.19에서 42.95로 올랐습니다.
눈여겨볼 부분. 하네스 비교의 차이는 작습니다. CoworkOS는 분야 평균 네 개 중 두 개에서 앞섰고(생산성 57.54 대 56.13, ML 코딩 56.26 대 56.14), 두 개에서는 뒤졌습니다(도구 사용 55.22 대 55.31, 검색 82.14 대 82.22). 미세조정 사례에서 에이전트는 라운드마다 모델을 평가하고, 약점을 진단하고, 데이터 파이프라인을 고치고, 데이터를 만들어 거른 뒤 지도 미세조정을 돌리고 다시 평가했습니다. 라운드별 평균은 33.19, 36.94, 35.90, 39.22, 40.71, 42.95였습니다(표 2). 2라운드에서 점수가 떨어진 뒤 검토해 보니 궤적 42개가 지도 학습 토큰의 84.2%를 차지하고 있었습니다. 긴 예시 몇 개가 학습을 좌우한 것입니다. 가장 많이 오른 것은 AutomationBench로 11.00에서 44.15가 됐습니다. JobBench는 22.66에서 20.53으로 오히려 내려갔습니다.
읽을 때 주의할 점. 출발점 33.19는 손대지 않은 원래 모델의 점수가 아닙니다. 에이전트가 맡기 전에 준비한 궤적 1,345개로 원래 모델을 한 번 미세조정한 결과이고(부록 A.3), 원래 모델의 점수는 논문에 없습니다. 에이전트는 점수를 매기는 바로 그 벤치마크 8개로 약점을 진단했으므로, 오른 폭은 그 벤치마크에 맞춰 얼마나 잘 조정했는지를 보여 줍니다. 비슷한 데이터가 학습에 섞이는 것을 막은 장치는 BM25 유사도 0.8 기준 필터 하나입니다. 실행은 한 번뿐이고, 사람이 짠 미세조정 방법과의 비교나 쓴 계산량도 없습니다. 저자들도 라운드마다의 변화는 여러 개입이 동시에 일어난 결과라서, 하나하나의 인과 효과로 읽으면 안 된다고 적었습니다.
직접 확인할 수 있나. 코드는 MIT로 GitHub에 있습니다. 미세조정 사례를 다시 하려면 GLM-5.3급 지휘 모델과 35B 모델을 학습할 GPU가 필요해서 저희는 시도하지 않았습니다.
7B 추론 모델이 수학 문제에서 약 44% 일찍 멈추게 됐습니다
무엇이 나왔나. 「Think Less, Locally: Local Preference Learning for Reasoning Compression」(Yuan 외, 시안교통대·Tencent WeChat AI, arXiv 2611.04814, 11월 3일)는 답을 이미 구한 뒤에도 생각을 이어 가는 추론 모델의 답을 줄이는 방법 LoCo를 제안합니다. 모델이 자기 추론을 단계별로 다시 읽으면서 확신도가 낮고 크게 흔들리는 단계를 표시합니다. 다른 모델(Qwen3-30B)이 그중 실제로 생각이 지나친 단계를 가려냅니다. 그 지점부터 모델이 이어 쓰기를 여덟 번 하고, 정답에 닿는 것 가운데 가장 짧은 것을 원래의 긴 추론보다 나은 예시로 삼습니다. 이렇게 만든 쌍으로 DPO 학습을 하는데, 데이터는 모델이 스스로 푼 수학 문제뿐입니다. 학습한 모델은 DeepSeek-R1-Distill-Qwen-7B 하나입니다. 답 길이가 AMC23에서 41.7%, AIME24에서 45.4% 줄었고, 나머지 수학 벤치마크 세 개는 그 사이였습니다(표 1).
눈여겨볼 부분. 정확도는 수학 벤치마크 다섯 개 중 네 개에서 유지되거나 올랐습니다. AIME24는 50.83에서 54.17, AIME25는 37.92에서 40.42가 됐습니다. MATH-500은 91.88에서 91.80으로 조금 내려갔습니다. 수학으로만 학습했는데 코드 문제에서도 답이 짧아졌습니다. MBPP는 정확도가 84.05로 같은 채 36.3%, LiveCodeBench v5는 24.7%, CodeContests는 23.4% 줄었고, 뒤의 두 개는 정확도도 조금 올랐습니다(표 2). 공개 가중치로 평가한 기존 방법 두 개와 비교하면, DAST는 답을 2.0-7.4% 줄였고, TokenSqueeze는 22.5-39.2% 줄였지만 수학 벤치마크 전부에서 정확도가 내려갔습니다(표 1). 어디서 끊는지도 중요했습니다. 끊는 지점을 무작위로 고르면 답은 비슷하게 줄었지만 AIME24 정확도가 떨어졌습니다. LoCo가 고른 지점은 추론의 뒤쪽, 평균 57% 지점에 몰려 있었습니다(표 3, 부록 A.3).
읽을 때 주의할 점. 모델이 7B 하나뿐입니다. 문제마다 temperature 0.6으로 여덟 번씩 생성했고, 표의 ± 값이 무엇인지는 적혀 있지 않습니다. AIME는 한 해 30문제이고 AIME 쪽 ±가 약 4점이라, +3.34점과 +2.50점은 그 범위 안에 있습니다. 한계를 다루는 절이 없고, 학습에 쓴 선호 쌍의 개수와 GPU 사용 시간도 적혀 있지 않습니다. 학습은 H20 네 장에서 LoRA로 했습니다.
직접 확인할 수 있나. 됩니다. 코드와 병합된 7B 체크포인트가 MIT로 공개돼 있고, 저장소에는 선호 쌍을 만드는 코드와 원본 수학 문제, 수학 시험 세트 다섯 개가 들어 있지만, 완성된 선호 쌍은 올라와 있지 않습니다. 공개된 평가 스크립트는 수학용뿐입니다. 7B는 GPU 한 장에 들어가므로, 로컬에서 추론 모델을 돌리는 분이라면 AIME에서 원래 모델과 답 길이를 비교해 볼 수 있습니다.
다음 호에서도 이번 주에 화제가 된 숫자를 원문 기준으로 대조해 정리합니다. 놓치지 않으려면 아래에서 뉴스레터를 구독해 주세요.