vLLM을 SGLang으로 바꿨더니: 카드 두 장 결론은 그대로, 한 장에서는 32명 중 5명이 줄을 섰습니다
Qwen3.8-27B와 A100 PCIe 두 장에서 서빙 엔진만 SGLang 0.5.23으로 바꿨습니다. 카드 두 장 결론(1명은 분할, 64명은 복제)은 그대로였지만, 카드 한 장에 32명을 붙이자 동시 처리 한도가 27로 묶여 5명이 대기했고 TTFT p95가 14.4초까지 뛰었습니다.

1편과 모든 조건을 똑같이 두고 서빙 엔진만 vLLM에서 SGLang으로 바꿨습니다. 모델은 Qwen3.8-27B, 장비는 NVLink 없는 A100 80GB PCIe 두 장, 질문은 같은 96개입니다. 카드 두 장에서는 1편과 결론이 같았습니다. 한 사람만 쓸 때는 모델 하나를 두 카드에 나눠 올린 쪽이 초당 174.9토큰으로, 카드마다 서버를 하나씩 띄운 쪽의 125.5토큰보다 빨랐습니다. 64명이 동시에 쓸 때는 반대로 서버 두 개가 1,640토큰, 나눠 올린 쪽이 1,455토큰이었습니다.
예상하지 못한 결과는 카드 한 장에서 나왔습니다. 각 엔진의 여러 명용 설정으로 띄운 서버에 32명을 붙였습니다. vLLM은 요청 32개를 한꺼번에 돌렸습니다. 반면 SGLang은 27개만 돌리고, 나머지 5개는 돌고 있는 답이 끝날 때까지 세워 두었습니다. 그래서 가장 늦은 첫 토큰(TTFT p95)이 0.88초가 아니라 14.4초 뒤에 나왔습니다. 전체 처리량도 초당 881토큰으로 vLLM의 약 1,568토큰에 못 미쳤습니다. 줄 서서 기다린 탓도 있지만, 이미 돌고 있던 27개 자체가 vLLM보다 느렸기 때문입니다(요청당 초당 37.0 대 57.9토큰). 에러는 하나도 없었습니다. 유일한 단서는 SGLang이 시작할 때 서버 로그에 남긴 한 줄뿐이었습니다.
먼저 이 한도가 어디서 생기는지 살펴본 뒤, 카드 두 장 비교와 한 사람 기준 설정별 결과를 차례로 봅니다. 실행 명령과 한도 확인·조정 방법은 글 끝에 정리했습니다.
1편에서 바꾼 것
엔진 하나만 바꿨습니다. vLLM 0.31.0 자리에 SGLang 0.5.23을 넣었습니다. 장비, 모델 체크포인트와 리비전, 96개 질문(코딩·에이전트·일반·수학 24개씩, 그중 40개가 한국어), 최대 출력 1,024토큰, 속도 측정 방식은 1편과 같습니다. 한 사람 속도는 답 하나의 생성 속도를 96개 질문에 대해 평균한 값입니다. 여러 사람 처리량은 전체 토큰 수를 전체 시간으로 나눈 값이고, 옆에 TTFT p95를 같이 적었습니다. 실행마다 서버를 새로 띄웠고, 다른 GPU 프로세스와 장비 부하 검사도 1편과 같이 거쳤습니다. 이번에는 제외된 실행 없이 모든 결과를 그대로 썼습니다.
측정하는 날 1편의 vLLM 설정 두 가지를 다시 돌려 장비 상태를 확인했습니다. R3-32에 32명을 붙이자 초당 1,572.5토큰이 나와 1편의 범위(1,562-1,574) 안에 들었습니다. 한 사람용 R1도 두 엔진 모두 세 번씩 측정하려고 두 번 더 돌렸는데, 역시 28.4가 나왔습니다. 그래서 아래 vLLM 숫자는 1편 값을 그대로 씁니다.
이름은 1편을 따르고, SGLang 쪽에는 S를 붙였습니다.
- S1: bf16 모델, SGLang 기본값
- S2: INT4 체크포인트, SGLang 기본값
- S3-1, S3-32: INT4에 SGLang이 공개한 한 사람용·여러 명용 설정을 얹은 것
- SD1, SD2: 카드 두 장. SD1은 카드마다 S3-32 서버를 하나씩 띄운 복제, SD2는 S3-32 서버 하나를 두 카드에 나눠 올린 분할
S3 설정은 SGLang의 Qwen3.8-27B 쿡북 페이지에서 가져왔습니다. 이 페이지에 A100 항목은 없어서, H200 bf16 명령을 썼습니다. 그 명령에는 Low-Latency와 High-Throughput 두 가지 서빙 방식이 있습니다. 문서 명령을 그대로 쓰되 옵션 세 개만 뺐습니다. 141GB짜리 H200에 맞춰 메모리를 잡는 옵션(--mem-fraction-static 0.85, --chunked-prefill-size 32768, --max-prefill-tokens 32768)인데, 80GB 카드에서는 메모리가 모자라 서버가 뜨지 않았습니다. 그래서 S1, S2와 마찬가지로 메모리 크기는 SGLang이 알아서 정하게 두었습니다.
- S3-1(Low-Latency): DFlash. vLLM의 R3-1과 같은 z-lab DFlash2 드래프트 모델을 쓰고, 한 단계에 7토큰을 미리 예상합니다. vLLM R3-1과 같은 개수입니다(SGLang의
--speculative-num-draft-tokens 8은 현재 토큰까지 센 값입니다). - S3-32(High-Throughput): 모델에 들어 있는 예측 모듈(MTP)을 SGLang의 EAGLE 방식으로 돌립니다. 한 단계에 한 줄로 3토큰을 미리 예상합니다.
두 설정은 쿡북의 공통 옵션도 같이 씁니다. fp8 KV 캐시, FlashInfer 어텐션 백엔드, Qwen3용 추론·도구 호출 파서, 그리고 모델의 선형 어텐션 층 상태를 float32로 두는 옵션입니다. --mamba-full-memory-ratio에는 쿡북 계산기가 기본 요청 길이 5,120토큰 기준으로 제시한 값(S3-1은 11.93, S3-32는 7.34)을 넣었습니다.
1편의 vLLM 설정은 다른 팀이 튜닝한 값입니다. 따라서 표에서 설정을 적용한 행은 순수 엔진 대결이라기보다 두 팀이 공개한 레시피의 비교로 봐야 합니다. 예를 들어 vLLM 여러 명용 설정은 한 단계에 1토큰을, SGLang은 3토큰을 미리 예상합니다.
카드 한 장에 32명: 다섯 명이 줄을 섰습니다
32명이 동시에 접속하자 SGLang 설정 네 가지 모두 같은 조건의 vLLM보다 처리량이 낮았습니다. 차이가 가장 큰 것은 동시 처리 한도가 5로 가장 작은 bf16 설정이었습니다.
--max-running-requests를 따로 지정하지 않으면 SGLang은 시작할 때 동시에 처리할 요청 수를 정하고, 그 값을 서버 로그에 남깁니다. 이 모델에서는 선형 어텐션 층의 상태를 담으려고 따로 잡아 두는 공간이 이 값을 정합니다. 실제 S3-32 서버 로그에도 아래 한 줄이 찍혔습니다.
max_running_requests is capped to 27 by the mamba state cache (max_mamba_cache_size=111, 4 state slots per request). To raise it: increase --mamba-full-memory-ratio or --max-mamba-cache-size, or halve the state size with --mamba-ssm-dtype bfloat16.vLLM은 A100에서 기본 한도가 256이라 저희 요청 32개가 한꺼번에 돌았습니다. SGLang은 bf16에서 5, INT4와 여러 명용 설정에서 27, 한 사람용 설정에서 18을 골랐습니다. 한도를 넘은 요청은 돌고 있는 요청 하나가 끝나야 시작합니다. 쿡북 명령에서 H200 메모리 옵션 세 개만 빼고 80GB 카드에 띄우면 기본으로 잡히는 값이라, 별도로 손대지 않고 그대로 측정했습니다.
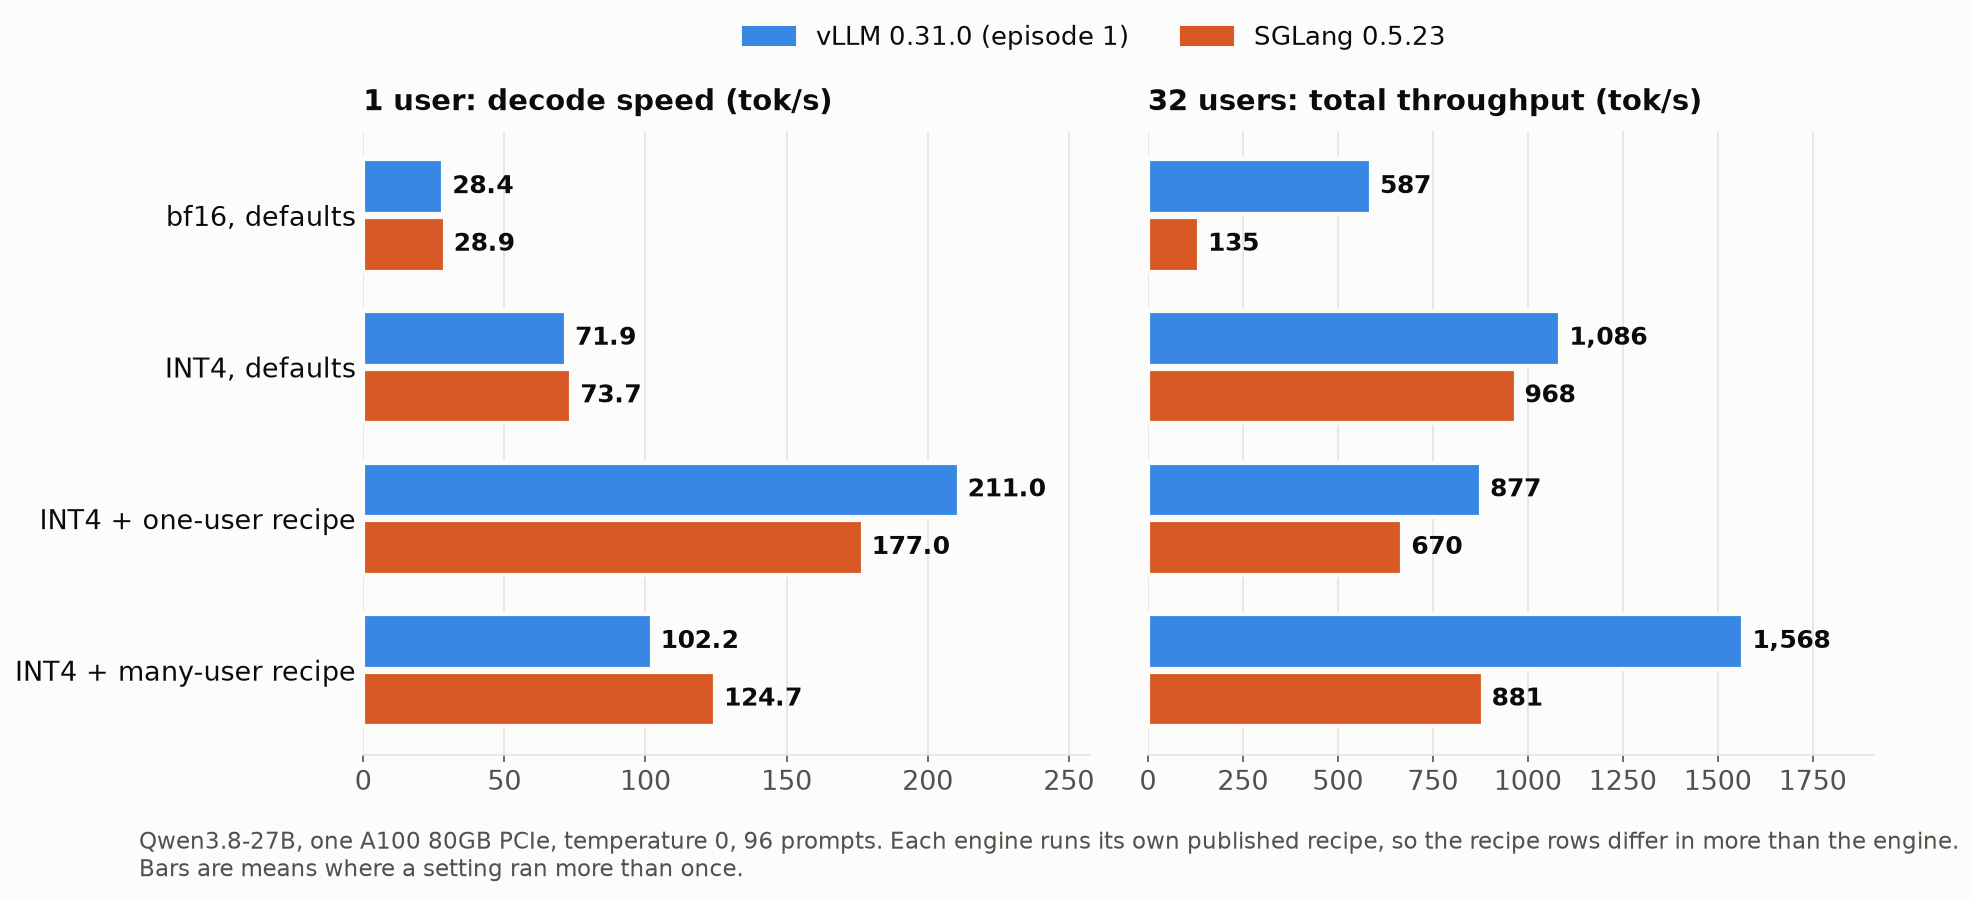
| 설정 | 1명, vLLM | 1명, SGLang | 32명, vLLM | 32명, SGLang | SGLang 동시 처리 한도 |
|---|---|---|---|---|---|
| bf16, 기본값 | 28.4 | 28.9 | 587 (p95 0.92초) | 134.7 (p95 189.4초) | 5 |
| INT4, 기본값 | 71.9 | 73.7 | 1,086 (p95 1.06초) | 966-970 (p95 15.5-16.0초) | 27 |
| INT4 + 한 사람용 설정 | 211.0 | 177.0 | 877 (p95 1.16초) | 669.9 (p95 27.2초) | 18 |
| INT4 + 여러 명용 설정 | 102.2 | 124.7 | 약 1,568 (p95 0.87-0.89초) | 870.7-891.0 (p95 13.7-15.3초) | 27 |
단위는 모두 초당 토큰이고 temperature 0입니다. SGLang은 bf16과 INT4 한 사람, 그리고 여러 명용 설정 32명을 세 번씩, INT4 32명을 두 번, 나머지를 한 번씩 돌렸습니다. 여러 명용 설정 32명의 세 번 측정치는 평균 대비 2.31% 폭 안에서 움직였고, vLLM은 0.75%였습니다.
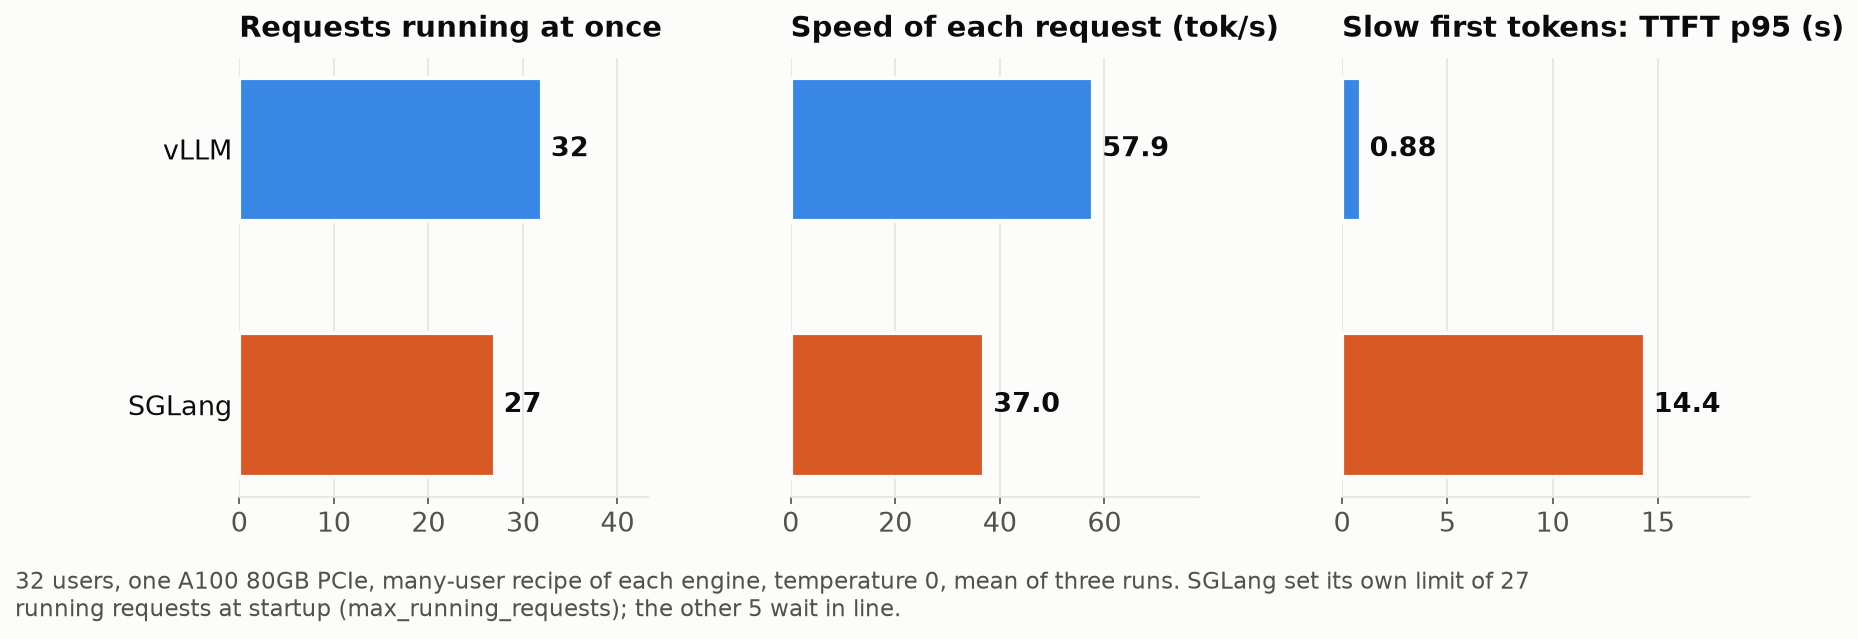
여러 명용 설정에서는 두 가지 원인이 겹쳤습니다.
- 다섯 요청이 기다립니다. 27개가 돌고 5개가 줄을 서자, 가장 늦은 첫 토큰은 0.87-0.89초가 아니라 13.7-15.3초 뒤에 나왔습니다. 줄 선 다섯 요청은 최대 1,024토큰짜리 답 하나가 끝나야 시작합니다.
- 돌고 있는 요청도 느립니다. 요청 하나의 생성 속도는 평균 초당 37.0토큰으로, 32개를 함께 돌린 vLLM의 57.9토큰보다 낮았습니다. 이 값은 요청마다 첫 토큰이 나온 뒤부터 잰 속도이므로, 줄 서서 기다린 시간은 포함되지 않습니다.
사람을 더 붙여도 전체 처리량은 늘지 않았습니다. 64명에서 초당 882.8토큰(한 번 실행)으로 32명과 같았고, TTFT p95만 44.8초로 길어졌습니다. vLLM 여러 명용 설정은 64명에서 1,856토큰, TTFT p95 1.60초였습니다.
한도가 가장 극단적으로 드러난 것은 bf16 행입니다. 동시에 5개만 돌다 보니 32명이 받은 처리량은 합쳐서 초당 134.7토큰이었고, 가장 늦은 첫 토큰은 189.4초 뒤에 나왔습니다. 같은 가중치로 vLLM은 초당 587토큰, TTFT p95 0.92초였습니다.
이어지는 카드 두 장 결과에서는 32명일 때 대기열이 사라집니다. 한도에 걸리지 않을 때 두 엔진의 차이가 어떻게 달라지는지 바로 확인할 수 있습니다.
카드 두 장: 1편의 결론이 그대로 맞았습니다
복제는 카드마다 S3-32 서버를 하나씩 띄우고, 분할은 S3-32 서버 하나를 --tp-size 2(SGLang에서 텐서 병렬을 켜는 옵션)로 두 카드에 나눠 올립니다. 1편과 마찬가지로 저희 클라이언트가 요청을 두 서버에 번갈아 보냈습니다. 여럿이 함께 쓰는 서비스라면 앞단 프록시가 같은 일을 합니다.
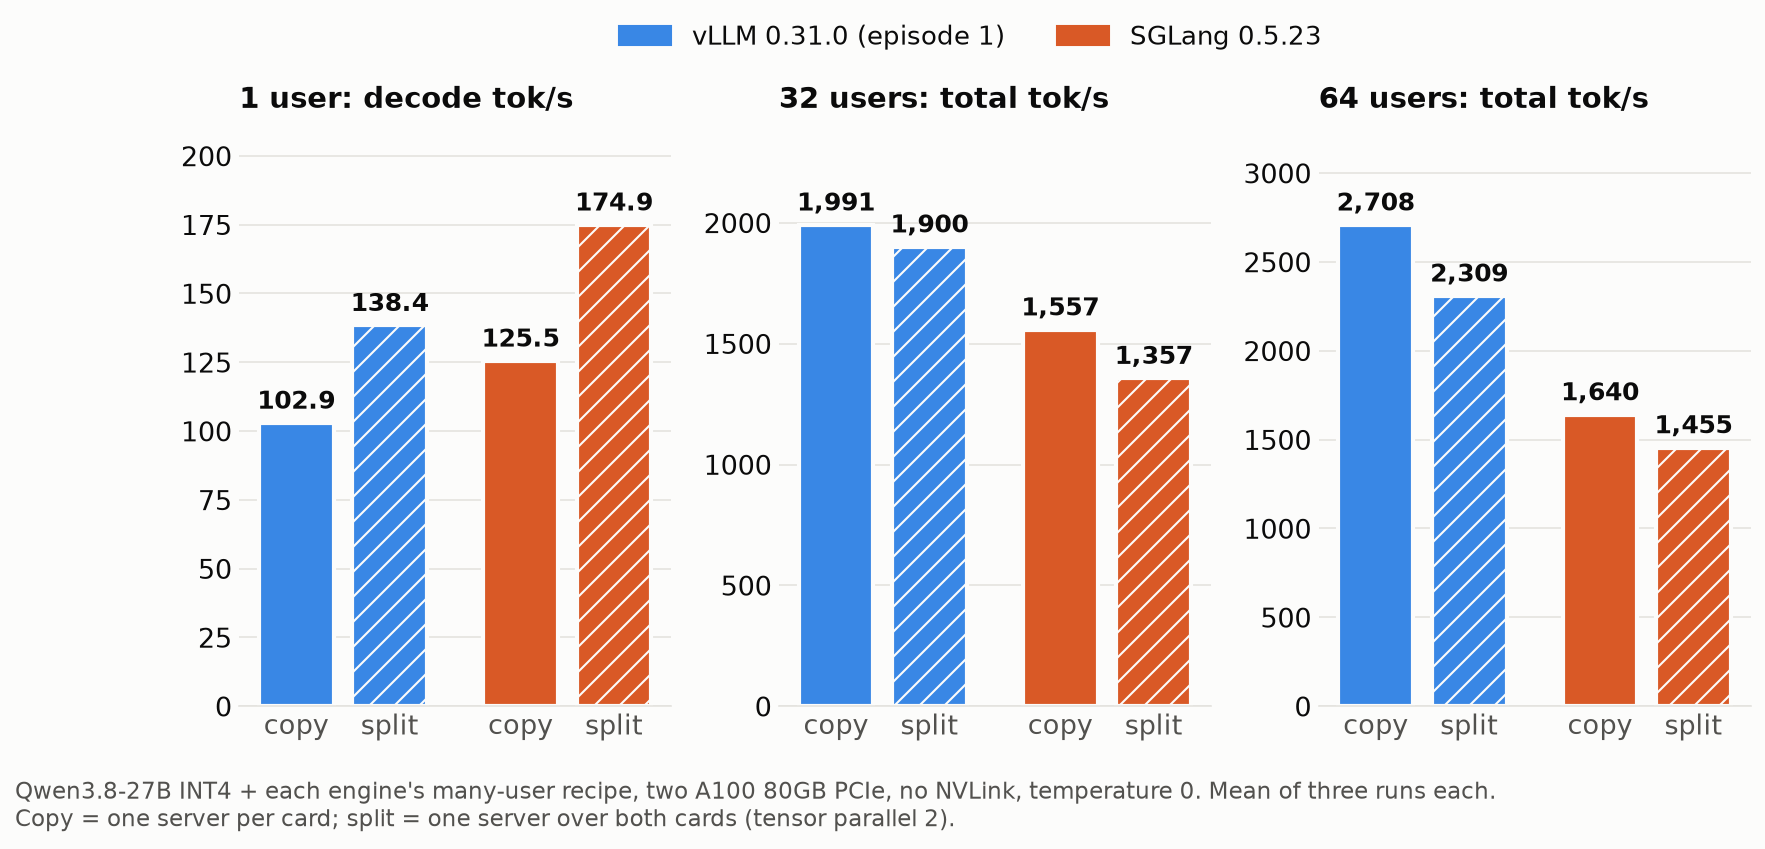
| 사용자 | vLLM 복제 | vLLM 분할 | SGLang 복제 | SGLang 분할 |
|---|---|---|---|---|
| 1명 | 102.9 | 138.4 | 125.3-125.7 | 174.7-175.0 |
| 32명 | 1,981-2,002, p95 0.50-0.54초 | 1,900-1,901, p95 0.63초 | 1,515-1,582, p95 0.55-0.62초 | 1,341-1,369, p95 0.76-1.13초 |
| 64명 | 2,702-2,717, p95 0.87-0.88초 | 2,297-2,320, p95 1.19-1.20초 | 1,631-1,652, p95 17.9-18.7초 | 1,449-1,465, p95 27.2-27.9초 |
초당 토큰, 조건마다 세 번씩, temperature 0이고, 범위는 가장 낮은 실행과 가장 높은 실행입니다.
한 사람이면 SGLang에서도 분할이 빨랐습니다. 복제 구성에서는 요청 하나하나가 카드 한 장에서만 돌기 때문에, 한 사람이 받은 속도는 초당 125.5토큰으로 카드 한 장일 때의 124.7과 거의 같았습니다. 분할은 174.9로 복제의 1.39배였고, vLLM에서는 같은 비율이 1.35배였습니다. 세 번의 측정 모두 분할이 복제를 앞섰습니다.
한 사람 기준으로 SGLang 분할은 vLLM이 여러 명용 설정으로 나눠 올린 서버(138.4)보다도 빨랐습니다. vLLM도 한 사람용 설정으로 나눠 올리면 1편에서 276.7이 나왔습니다.
여러 명이면 SGLang에서도 복제가 빨랐습니다. 32명에서 복제는 초당 1,515-1,582토큰, 분할은 1,341-1,369토큰이었고, 64명에서는 1,631-1,652 대 1,449-1,465였습니다. 32명과 64명 모두 세 번의 측정 전부에서 복제가 분할보다 빨랐습니다.
여기서도 동시 처리 한도가 보입니다. 복제한 서버 하나는 최대 27개를 돌리므로, 32명을 두 서버에 나누면 대략 절반씩, 많을 때도 한 카드에 21개가 돌아 아무도 기다리지 않았습니다. 이때 가장 늦은 첫 토큰은 0.55-0.62초로, vLLM 복제의 0.50-0.54초와 비슷했습니다. 64명이면 두 서버가 합쳐 54개를 돌리고 10개가 기다려, TTFT p95가 17.9-18.7초로 뛰었습니다. 분할 서버는 한도를 48로 정해서 32명에서는 줄이 없었고(p95 0.76-1.13초), 64명에서는 16개가 기다렸습니다(p95 27.2-27.9초). 대기열이 없을 때는 SGLang의 TTFT p95도 vLLM과 0.5초 이내로 좁혀졌습니다.
다만 대기열이 없어도 전체 처리량은 vLLM에 못 미쳤습니다. SGLang 복제 두 서버에 32명을 붙이면 평균 초당 1,557토큰으로, vLLM 카드 한 장(1,562-1,574)과 비슷한 수준이었습니다. 요청 하나의 생성 속도는 평균 초당 58.1토큰으로 vLLM 복제의 74.2토큰보다 낮았습니다.
카드 한 장에 한 사람
앞의 카드 한 장 표에서 1명 결과만 따로 보면 32명일 때와는 양상이 다릅니다.
한 사람 기준으로 앞의 두 단계는 두 엔진에서 거의 같은 비율로 빨라졌습니다. bf16을 INT4로 바꾸자 SGLang은 초당 28.9토큰에서 73.7토큰으로 2.55배가 됐고, vLLM은 28.4에서 71.9로 2.53배였습니다. 기본값끼리 비교하면 SGLang이 bf16에서 1.7%, INT4에서 2.6% 빨랐고, 세 번씩 돌린 모든 실행에서 그랬습니다.
한 사람용 설정은 SGLang이 느렸고, 여러 명용 설정은 SGLang이 빨랐습니다. SGLang의 DFlash 설정은 177.0으로 vLLM의 211.0보다 낮았습니다. 그렇다고 예상이 덜 맞은 것은 아닙니다. 큰 모델이 자기 토큰까지 포함해 한 단계에 받아들인 토큰은 SGLang 3.48개, vLLM 3.53개로 거의 같았습니다. 단계당 토큰 수를 생성 속도로 나누면 한 단계에 걸린 시간은 SGLang 약 19.6ms, vLLM 16.7ms입니다. 차이는 예상 토큰이 몇 개나 맞느냐가 아니라, 한 단계를 처리하는 데 걸리는 시간에서 났습니다. 다만 두 설정은 예상하는 토큰 수는 7개로 같아도 다른 옵션이 서로 달라서, 이 결과를 엔진만의 차이로 볼 수는 없습니다.
여러 명용 설정에서는 순서가 뒤집혀, SGLang이 124.7로 vLLM의 102.2보다 22% 빨랐습니다.
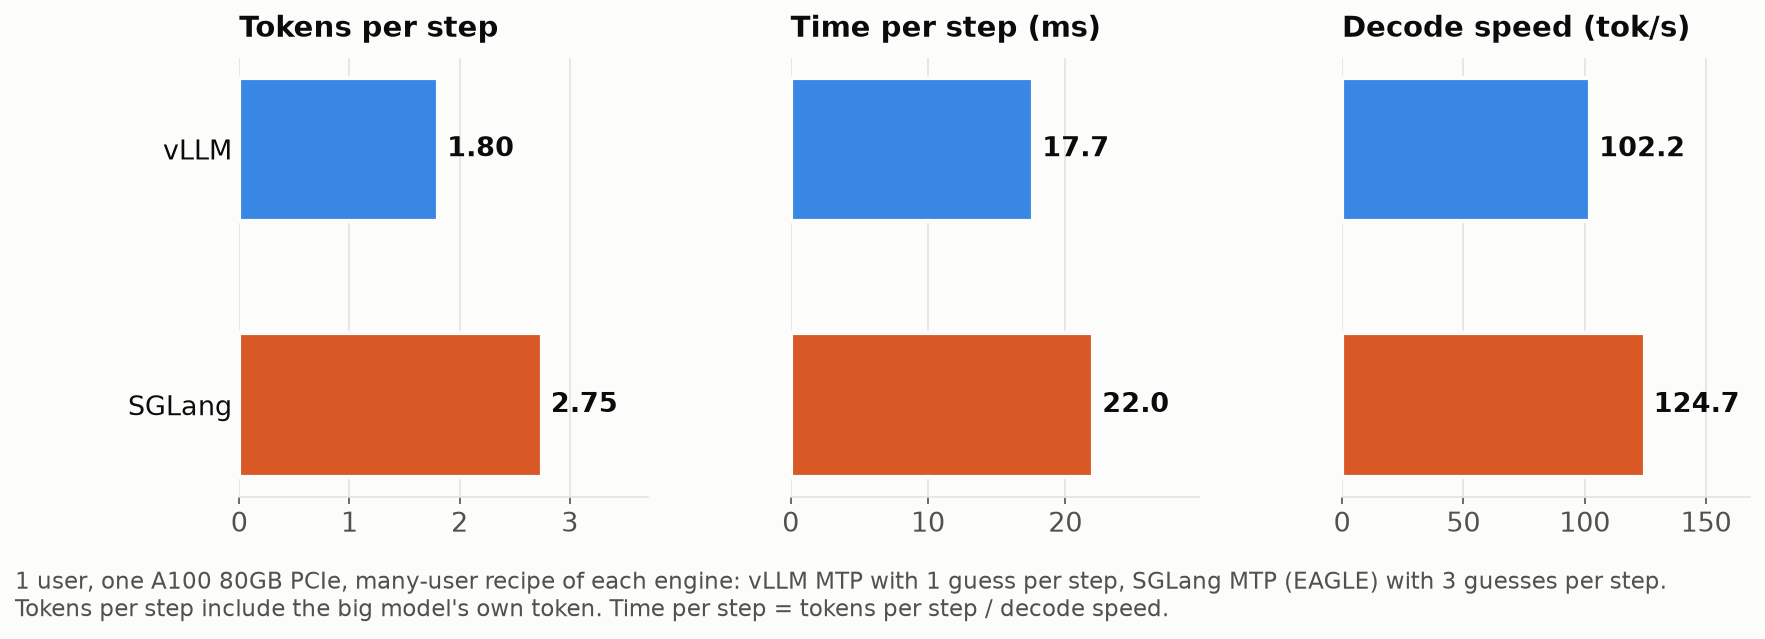
SGLang 설정은 한 단계에 1토큰이 아니라 3토큰을 미리 예상하고, 큰 모델이 받아들인 토큰도 단계당 2.75개로 vLLM의 1.80개보다 많았습니다. 한 단계는 22.0ms로 vLLM의 17.7ms보다 길었지만(단계당 토큰을 생성 속도로 나눈 값입니다. 1편에서 같은 vLLM 설정을 프로파일러로 잰 값은 17.8ms였습니다), 단계당 시간은 늘어도 한 번에 얻는 토큰이 훨씬 많아 결과가 뒤집혔습니다. 물론 한 사람만 쓴다면 어느 엔진에서든 여러 명용 설정은 한 사람용 설정보다 한참 느립니다(SGLang에서 124.7 대 177.0).
temperature 0.7에 시드를 고정하면 한 사람용 설정은 SGLang 쪽이 덜 느려졌습니다. 초당 171.5토큰으로 temperature 0의 177.0보다 3% 낮았고, 단계당 받아들인 토큰은 3.47개로 3.48개와 거의 같았습니다. 같은 조건에서 vLLM은 11% 떨어졌고(211.0에서 186.8), 단계당 토큰도 3.53개에서 3.14개로 줄었습니다. 여러 명용 설정 32명은 881에서 814.3으로 8% 낮아졌고 단계당 토큰은 2.74개에서 2.57개가 됐습니다. vLLM은 12% 줄었습니다. temperature 0.7 결과는 모두 한 번씩 돌린 값입니다.
답은 그대로일까
SGLang INT4 설정 세 가지를 1편과 같은 방법으로 채점했습니다. GSM8K 테스트 1,319문제 전부, MMLU-Pro 1,400문제, KMMLU 1,125문제를 생각 모드를 끄고 4,096토큰까지 허용해 풀게 했습니다.
| 설정 | GSM8K | MMLU-Pro | KMMLU |
|---|---|---|---|
| S2 INT4, SGLang | 97.0% ± 0.9 | 77.8% ± 2.2 | 72.3% ± 2.6 |
| S3-1, SGLang | 97.0% ± 0.9 | 77.9% ± 2.2 | 71.7% ± 2.6 |
| S3-32, SGLang | 96.8% ± 0.9 | 77.1% ± 2.2 | 71.9% ± 2.6 |
| R2 INT4, vLLM | 96.8% ± 0.9 | 77.1% ± 2.2 | 73.0% ± 2.6 |
| R3-1, vLLM | 97.0% ± 0.9 | 76.8% ± 2.2 | 70.4% ± 2.7 |
| R3-32, vLLM | 96.2% ± 1.0 | 77.1% ± 2.2 | 70.3% ± 2.7 |
±는 95% 신뢰구간입니다. 모든 벤치마크에서 어느 두 설정을 비교해도 신뢰구간이 겹쳐, 이 문제 수로는 여섯 설정 사이에 유의미한 정답률 차이를 찾을 수 없었습니다. 1편과 마찬가지로 KMMLU는 설정끼리 비교하는 데만 썼고, 모델의 한국어 실력을 재는 지표로 쓰지 않았습니다.
temperature 0에서 토큰 단위로 비교하면, SGLang 기본 INT4 서버에 한 사람만 붙였을 때 세 번 실행의 답이 96개 질문 모두에서 똑같았습니다. vLLM은 같은 비교에서 5-10개만 일치했습니다. 32명을 붙이면 SGLang 두 번 실행이 96개 중 7개에서 일치했습니다. 같은 INT4 가중치라도 SGLang과 vLLM의 출력을 비교하면 어느 vLLM 실행과 대조하느냐에 따라 96개 중 2-5개만 일치했습니다. 가중치와 질문이 똑같아도 엔진이 달라지면 출력 문장이 달라졌습니다.
직접 돌려 보려면
Python 3.12로 SGLang 0.5.23을 설치합니다. SGLang이 flash-attn-4의 사전 배포판을 함께 받기 때문에 --prerelease=allow가 필요하고, 쿡북도 같은 방식으로 설치합니다. 1편처럼 FlashInfer의 JIT 빌드가 CUDA 13.0 헤더와 맞지 않는 컴파일러 때문에 실패해서, 컴파일러 패키지 세 개를 13.0.88로 고정하고 libcudart.so 링크를 같은 방법으로 만들었습니다.
uv venv --python 3.12 .venv-sglang && . .venv-sglang/bin/activate
uv pip install --prerelease=allow "sglang[all]==0.5.23"
uv pip install nvidia-cuda-nvcc==13.0.88 nvidia-cuda-crt==13.0.88 nvidia-nvvm==13.0.88
CU13=$(python -c "import nvidia; print(list(nvidia.__path__)[0] + '/cu13')")
mkdir -p $CU13/lib64 && ln -sf ../lib/libcudart.so.13 $CU13/lib64/libcudart.so
export PATH=$CU13/bin:$PATH CUDA_HOME=$CU13
설정마다 서버를 하나씩 띄웁니다. 저희 장비에서 S3-1은 처음 띄울 때 7-9분이 걸렸습니다.
BF16_REV=1d4bf0f2ff6012fd82039f2fa52739d0dd7c60c0
INT4_REV=91bd022d5b49442a868bc35008f6c21e1860edfa
DRAFT_REV=50307d4c4cde6860d4eee73e2547cd786fe8e8a4

# S1: bf16, 기본값
CUDA_VISIBLE_DEVICES=0 python -m sglang.launch_server --model-path Qwen/Qwen3.8-27B --revision $BF16_REV --port 8000

# S2: INT4, 기본값
CUDA_VISIBLE_DEVICES=0 python -m sglang.launch_server --model-path RedHatAI/Qwen3.8-27B-INT4 --revision $INT4_REV --port 8000

# S3 두 설정의 공통 옵션 (쿡북에서 H200 메모리 옵션 세 개를 뺀 것)
DOC="--trust-remote-code --kv-cache-dtype fp8_e4m3 --attention-backend flashinfer --reasoning-parser qwen3 --tool-call-parser qwen3_coder --mamba-ssm-dtype float32"

# S3-1: 한 사람용 (Low-Latency). DFlash2 드래프트, 단계당 7토큰 예상
CUDA_VISIBLE_DEVICES=0 python -m sglang.launch_server --model-path RedHatAI/Qwen3.8-27B-INT4 --revision $INT4_REV $DOC --port 8000 \
  --speculative-algorithm DFLASH --speculative-draft-model-path z-lab/Qwen3.8-27B-DFlash2 --speculative-draft-model-revision $DRAFT_REV \
  --speculative-num-draft-tokens 8 --mamba-radix-cache-strategy extra_buffer --mamba-full-memory-ratio 11.93

# S3-32: 여러 명용 (High-Throughput). 내장 MTP, 단계당 3토큰 예상
CUDA_VISIBLE_DEVICES=0 python -m sglang.launch_server --model-path RedHatAI/Qwen3.8-27B-INT4 --revision $INT4_REV $DOC --port 8000 \
  --speculative-algorithm EAGLE --speculative-num-steps 3 --speculative-eagle-topk 1 --speculative-num-draft-tokens 4 \
  --mamba-radix-cache-strategy extra_buffer_lazy --mamba-full-memory-ratio 7.34
서버는 vLLM과 같은 /v1/chat/completions 경로에서 OpenAI 형식으로 답하므로, 1편의 요청 코드를 그대로 쓸 수 있습니다.
카드 두 장 구성은 S3-32 명령을 카드마다 하나씩 띄우거나(복제), --tp-size 2를 붙여 두 카드에 한 번 띄웁니다(분할).
# SD1 복제: 카드마다 서버 하나, 포트를 다르게
CUDA_VISIBLE_DEVICES=0 python -m sglang.launch_server --model-path RedHatAI/Qwen3.8-27B-INT4 --revision $INT4_REV $DOC --port 8000 \
  --speculative-algorithm EAGLE --speculative-num-steps 3 --speculative-eagle-topk 1 --speculative-num-draft-tokens 4 \
  --mamba-radix-cache-strategy extra_buffer_lazy --mamba-full-memory-ratio 7.34 &
CUDA_VISIBLE_DEVICES=1 python -m sglang.launch_server --model-path RedHatAI/Qwen3.8-27B-INT4 --revision $INT4_REV $DOC --port 8001 \
  --speculative-algorithm EAGLE --speculative-num-steps 3 --speculative-eagle-topk 1 --speculative-num-draft-tokens 4 \
  --mamba-radix-cache-strategy extra_buffer_lazy --mamba-full-memory-ratio 7.34 &

# SD2 분할: 서버 하나를 두 카드에
CUDA_VISIBLE_DEVICES=0,1 python -m sglang.launch_server --model-path RedHatAI/Qwen3.8-27B-INT4 --revision $INT4_REV $DOC --port 8000 \
  --speculative-algorithm EAGLE --speculative-num-steps 3 --speculative-eagle-topk 1 --speculative-num-draft-tokens 4 \
  --mamba-radix-cache-strategy extra_buffer_lazy --mamba-full-memory-ratio 7.34 --tp-size 2
SGLang으로 띄운다면 이렇게 하겠습니다
카드 한 장:
- 먼저 INT4 체크포인트로 바꿉니다. 한 사람 기준으로 vLLM과 마찬가지로 SGLang에서도 약 2.5배 빨랐습니다.
- 한 사람이 쓴다면 쿡북의 Low-Latency 설정(S3-1)이 SGLang에서 가장 빨랐습니다(초당 177.0토큰).
- 팀이 함께 쓴다면 서버를 띄울 때 로그의
max_running_requests줄을 확인합니다. 저희 80GB 카드에서 High-Throughput 설정은 27이었으므로, 28번째 사람은 답 하나가 끝날 때까지 기다립니다. 같은 로그 줄에 무엇이 한도를 정했는지(선형 어텐션 상태 캐시)와 한도를 올리는 옵션(--mamba-full-memory-ratio등)이 나옵니다.--max-running-requests만으로는 이 한도를 넘지 못합니다. 실제 트래픽이 이 한도를 넘는다면 옵션을 조정하기 전에 실제 서비스용 프롬프트로 먼저 측정해 보시기 바랍니다.
PCIe 카드 두 장, 모델이 한 장에 들어갈 때:
- 팀이 쓴다면 서버를 두 개 띄웁니다. 서버마다 동시 처리 한도 아래에서는 아무도 기다리지 않습니다.
- 한 사람이 많이 쓴다면
--tp-size 2로 모델을 나눠 올립니다.
이 연재의 다음 편이 나오면 아래 뉴스레터로 보내 드립니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
serve-ladder-sglang-repro.zip · 15,772 KB