트랜스포머 블록 15가지 변화: 2017년 원조부터 Mamba 하이브리드까지, 13가지는 코드로 실제 층과 맞춰 봤습니다
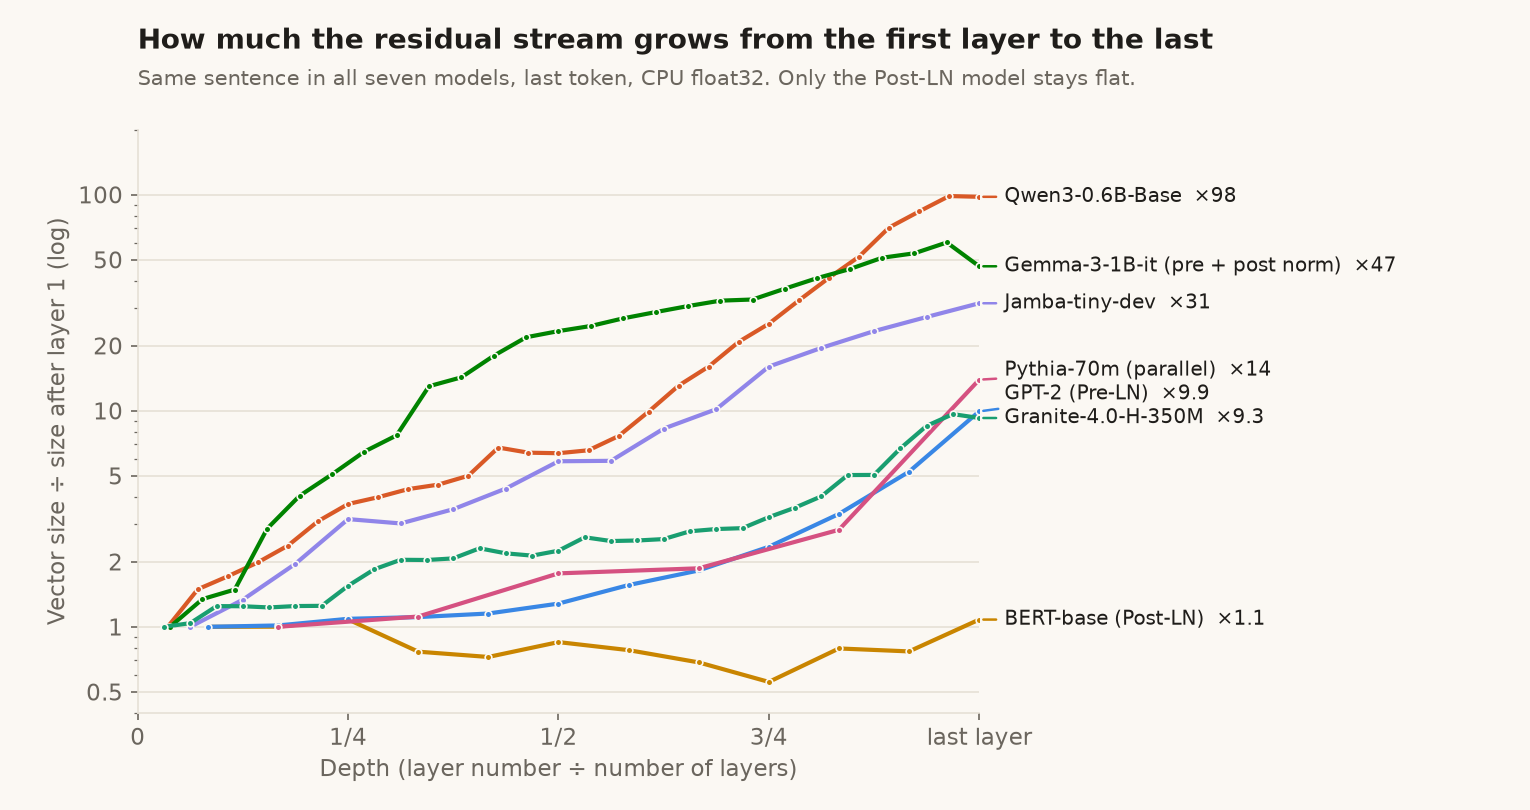
Post-LN에서 Mamba 하이브리드까지 트랜스포머 블록의 15가지 변화를 그림 하나씩으로 정리하고, 논문이 보고한 이득과 대가를 붙였습니다. 실제 모델 일곱 개의 층을 짧은 PyTorch 함수로 다시 짜서 Hugging Face 출력과 맞춰 봤고, 일곱 개 모두 반올림 오차 안에서 같았습니다. 같은 문장을 넣으면 층마다 더해지며 올라가는 본 흐름(잔차 스트림)이 첫 층 대비 Qwen3-0.6B에서는 98배, BERT에서는 1.1배가 됩니다.
BERT, GPT-2, Pythia, Qwen3, Gemma 3, Jamba, Granite-4.0-H 일곱 모델에 같은 문장을 넣고, 층을 하나 지날 때마다 마지막 토큰의 벡터가 얼마나 커지는지 쟀습니다. Qwen3-0.6B-Base에서는 마지막 층을 지난 벡터가 첫 층을 지난 벡터의 98배였습니다. BERT에서는 1.1배로 거의 그대로였습니다. 두 모델은 어텐션, 피드포워드 망, 정규화라는 같은 부품으로 만들어졌지만, 그 밖에도 다른 점이 많습니다. 그중 이 그래프에 바로 드러나는 차이가 하나 있습니다. 층을 지나며 칸의 출력이 계속 더해지는 벡터를 이 글에서는 본 흐름이라고 부르겠습니다(흔히 잔차 스트림이라고 합니다). BERT는 더하기가 끝날 때마다 본 흐름 자체를 다시 정규화하고, 나머지 여섯 모델은 본 흐름을 한 번도 정규화하지 않습니다. 그래서 BERT 선만 평평합니다. 정규화를 어디에 두느냐는 이 글에서 살펴볼 15가지 변화 중 하나입니다.
앞 글에서는 토큰 하나가 GPT-2, Qwen3, Granite를 지나가는 길을 따라갔습니다. 층마다 하는 일은 같았습니다. 정규화하고, 토큰끼리 정보를 섞고, 그 결과를 원래 벡터에 더합니다. 다시 정규화하고, 토큰마다 피드포워드 망(FFN)으로 변환하고, 또 더합니다. 이번 글은 2017년 이후 이 칸들을 무엇으로 채우고, 어떻게 잇고, 어떻게 쌓아 왔는지를 다룹니다. 변화마다 움직이는 그림 하나, 논문이 보고한 결과, 그 대가를 붙였습니다. 어텐션 계산 자체(헤드, KV 캐시, 그룹 쿼리, 희소·선형 어텐션)는 어텐션 정리 글에서 다뤘으니, 여기서는 어텐션을 칸 하나로만 봅니다.
코드를 어떻게 확인했는가
이 글의 블록마다 짧은 PyTorch 함수가 붙어 있습니다. 이 함수가 저희가 논문을 읽고 짐작한 블록이 아니라 실제 모델의 블록이라는 것을 보이려고, 실제 모델과 직접 비교했습니다. 순서는 이렇습니다.
- Hugging Face에서 모델을 불러와 "In the morning, Alice gave Bob a book. Later, Bob gave the book back to"라는 문장을 넣습니다.
- 모델이 도는 동안 층마다 들어간 값과 나온 값을 기록합니다. PyTorch에서는 이런 기록 장치를 forward hook이라고 부릅니다.
- 층 하나의 가중치를 꺼내 저희 함수에 같은 입력을 넣고, 그 출력을 실제 층이 낸 출력과 비교합니다.
io = {}
def hook(i):
    def f(mod, args, kwargs, out):
        x = args[0] if args else kwargs["hidden_states"]   # i번 층에 들어간 값
        y = out[0] if isinstance(out, tuple) else out       # 나온 값
        io[i] = (x[0].clone(), y[0].clone())
    return f
hs = [l.register_forward_hook(hook(i), with_kwargs=True) for i, l in enumerate(layers)]
model(ids)

x, y = io[5]                                     # 5번 층
ours = pre_ln_block(x, weights_of_layer_5, n_heads, eps)
print((ours - y).abs().max())                    # 모든 숫자 중 가장 큰 차이
CPU에서 float32로, 일곱 모델의 층 22개를 이렇게 비교했습니다(전체 스크립트는 글 끝의 재현 묶음에 있습니다). 가장 큰 차이를 실제 출력의 가장 큰 값으로 나눈 상대 차이는 Pythia 마지막 층의 3.9e-5가 최대였고, 나머지는 모두 2.2e-7 이하였습니다. Pythia 마지막 층만 눈에 띄게 커서, Pythia 세 층을 float64로 다시 비교했습니다. 그 층의 차이는 5.4e-13으로, 나머지 두 층은 2.3e-15 이하로 줄었습니다. 계산 정밀도를 올리자 차이가 함께 줄었으니 계산이 달라서 생긴 차이가 아니라 반올림 차이입니다. 즉 함수가 모델과 같은 계산을 합니다.
| 모델 | 확인하는 것 | 비교한 층 | 가장 큰 상대 차이 |
|---|---|---|---|
| BERT-base | Post-LN | 0, 5, 11 | 2.2e-7 |
| GPT-2 | Pre-LN | 0, 5, 11 | 1.8e-7 |
| Pythia-70m | 병렬 블록, 일부 차원만 RoPE | 0, 2, 5 | 3.9e-5 |
| Qwen3-0.6B-Base | RMSNorm, QK 정규화, RoPE, SwiGLU | 0, 14, 27 | 1.4e-7 |
| Gemma-3-1B-it | 칸 앞뒤 정규화 | 2, 5, 25 | 4.5e-8 |
| Jamba-tiny-dev | Mamba, MoE, 위치 없는 어텐션 | 3, 4, 5, 12 | 9.4e-8 |
| Granite-4.0-H-350M | Mamba-2, 위치 없는 어텐션 | 0, 10, 31 | 1.6e-7 |
아래에 나오는 코드가 이 비교를 통과한 코드입니다. 인코더·디코더 원조와 Hymba 두 항목은 그림과 논문 수치로 설명합니다.
출발점
1. 원조 블록 (2017)
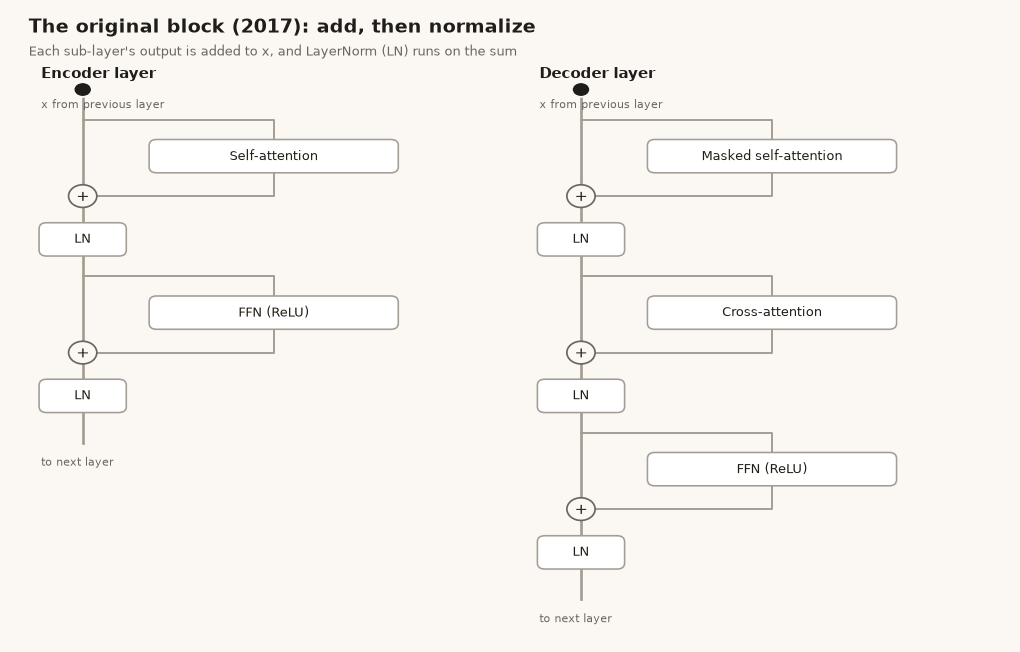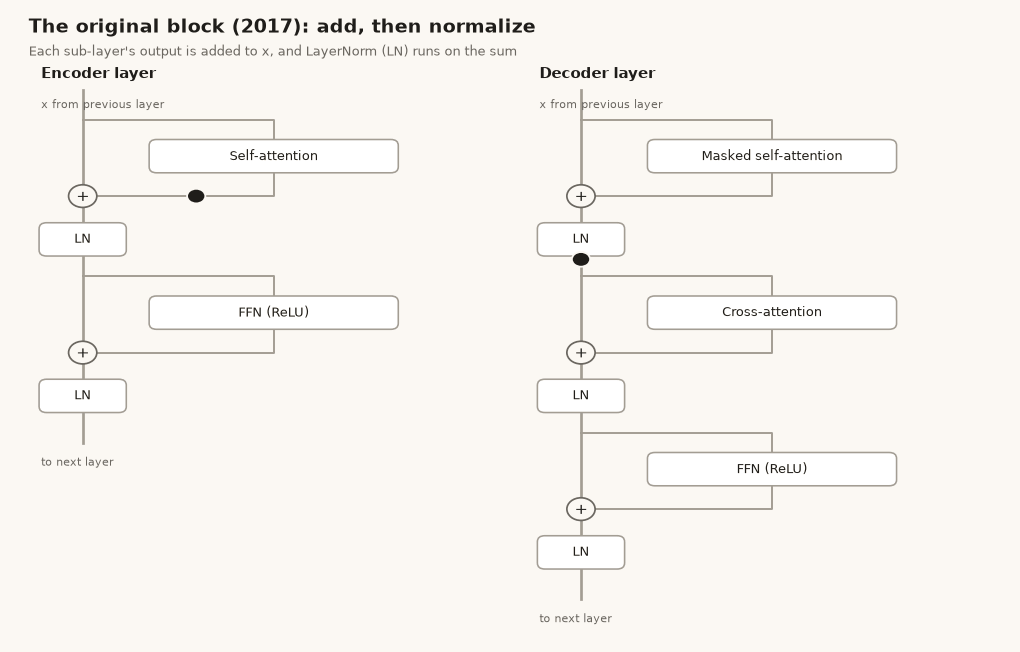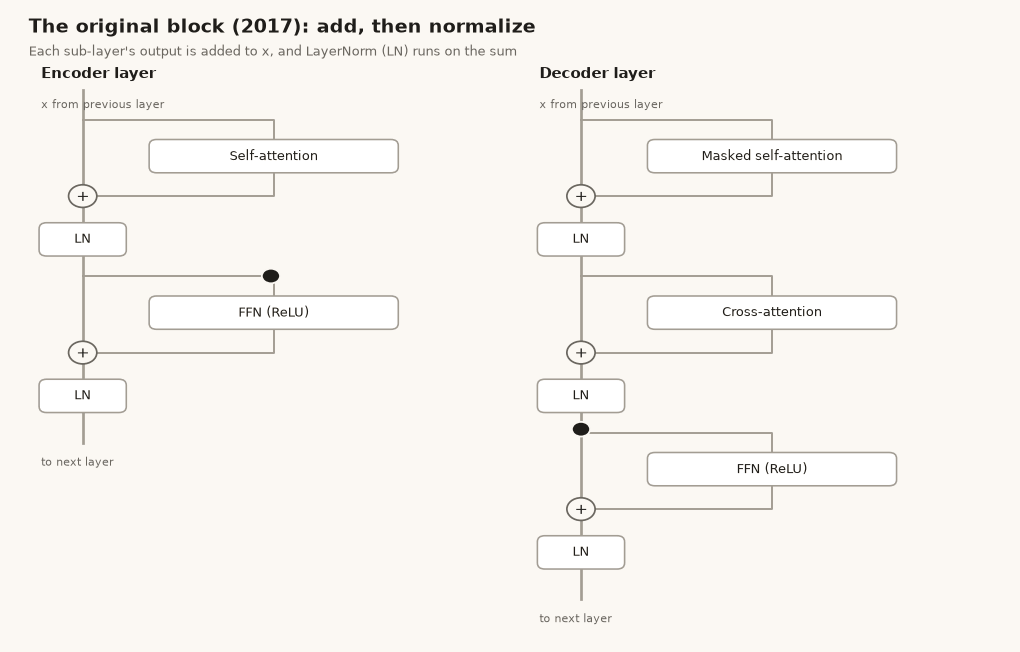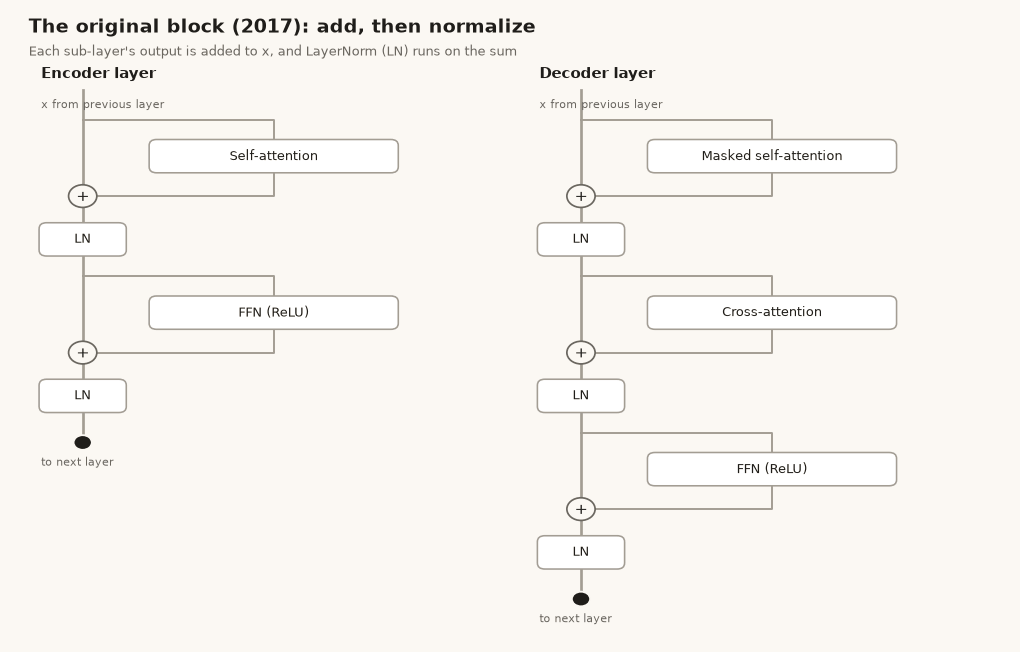
"Attention Is All You Need"(Vaswani et al., 2017)는 번역 모델을 인코더와 디코더 각 6층으로 만들었습니다. 각 칸은 LayerNorm(x + Sublayer(x)) 형태로 감쌉니다. 칸을 계산해 x에 더한 다음, 그 합을 정규화합니다. 더하기 뒤에 정규화가 오므로 Post-LN이라고 부릅니다. FFN은 행렬 두 개 사이에 ReLU를 둔 구조로, 바깥 폭이 512, 안쪽 폭이 2,048입니다. 위치는 고정된 사인파를 입력에 더해 넣었습니다. 학습하는 위치 벡터도 시험했는데, 두 방식 모두 BLEU 25.7로 같았다고 보고합니다(Table 3, E행).
BERT는 인코더에 이 블록을 그대로 썼고(FFN만 GELU), 그래서 Post-LN 예시로 BERT-base를 씁니다.
def post_ln_block(x, sd, H, eps):
    q = heads(x @ sd["attention.self.query.weight"].T + sd["attention.self.query.bias"], H)
    k = heads(x @ sd["attention.self.key.weight"].T + sd["attention.self.key.bias"], H)
    v = heads(x @ sd["attention.self.value.weight"].T + sd["attention.self.value.bias"], H)
    a = merge(attend(q, k, v, 1 / math.sqrt(q.shape[-1]), causal=False))
    a = a @ sd["attention.output.dense.weight"].T + sd["attention.output.dense.bias"]
    x = layer_norm(x + a, sd["attention.output.LayerNorm.weight"], sd["attention.output.LayerNorm.bias"], eps)
    f = F.gelu(x @ sd["intermediate.dense.weight"].T + sd["intermediate.dense.bias"])
    f = f @ sd["output.dense.weight"].T + sd["output.dense.bias"]
    return layer_norm(x + f, sd["output.LayerNorm.weight"], sd["output.LayerNorm.bias"], eps)
여기서 x가 처음에 말한 본 흐름입니다. layer_norm(x + ...) 두 줄을 보면 본 흐름 자체를 층마다 두 번 다시 정규화합니다. 첫 그래프에서 BERT 선이 평평한 이유가 이것입니다.
2. 디코더만 남기기
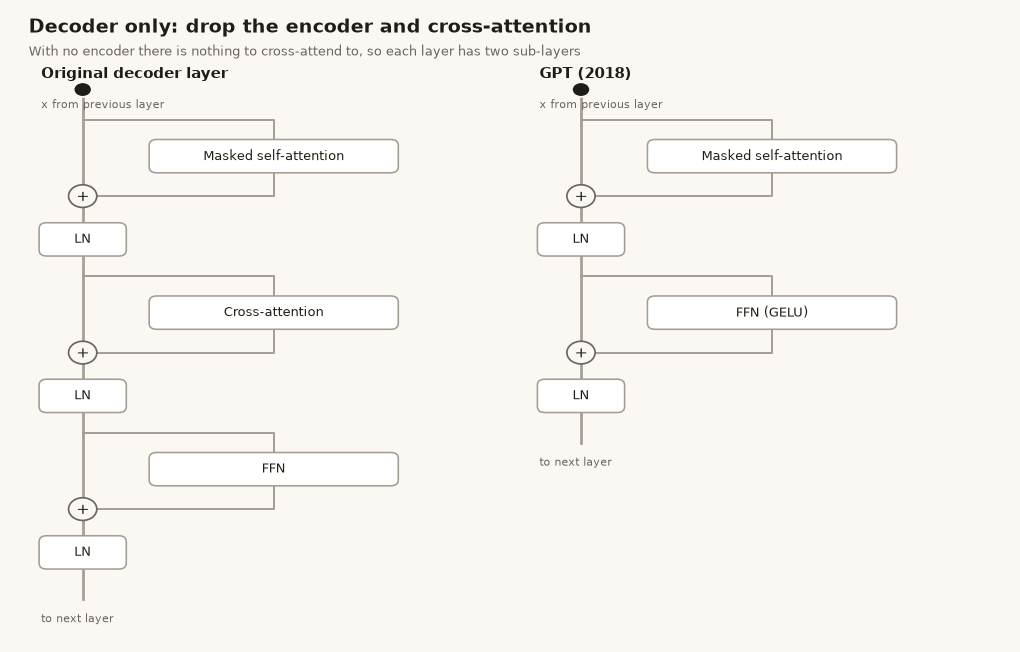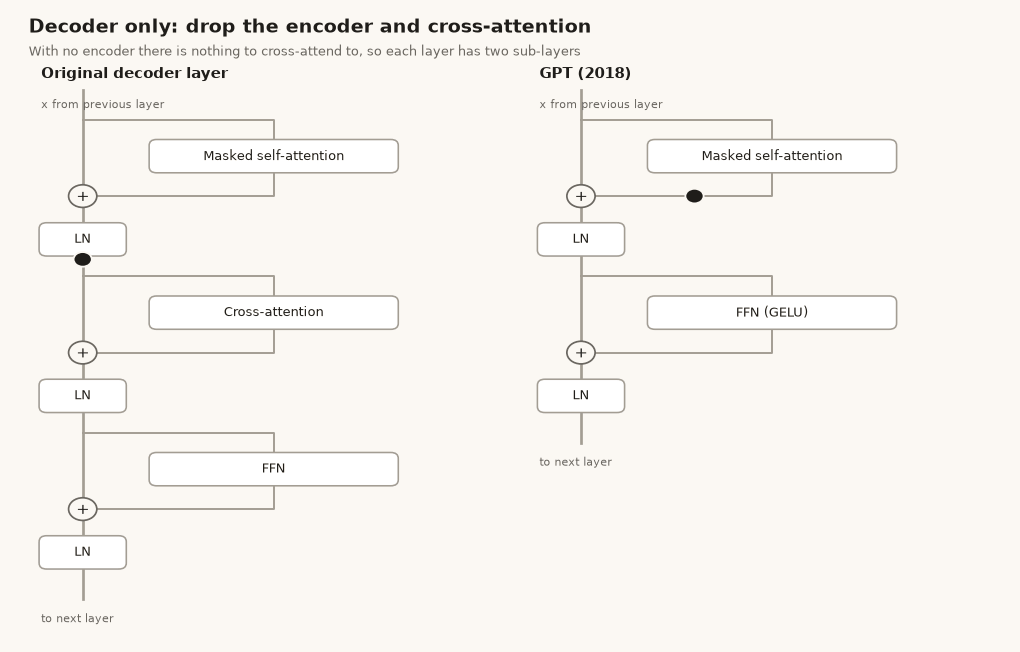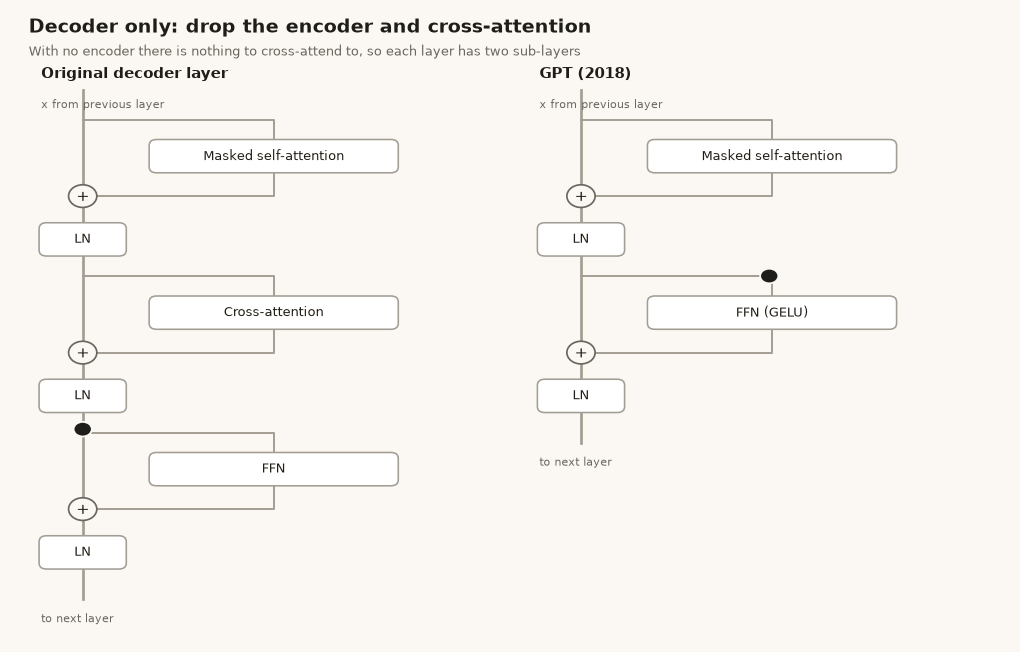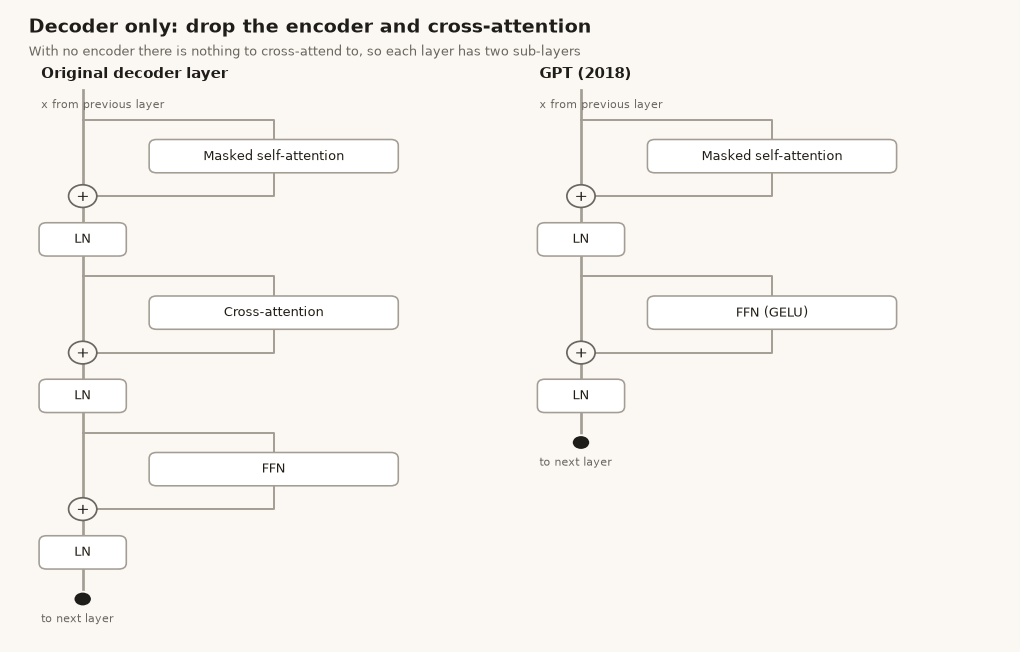
글을 이어 쓰기만 하는 언어 모델에는 읽어 올 원문이 없습니다. 그러니 인코더도, 인코더를 읽는 크로스 어텐션도 필요 없습니다. GPT(Radford et al., 2018)는 마스크 셀프 어텐션과 FFN으로 된 디코더 층을 12개 쌓았습니다. 폭은 768, FFN 안쪽은 3,072입니다. FFN 활성화 함수를 GELU로 바꾸고 사인파 대신 학습하는 위치 벡터를 쓴 것도 이 논문입니다. 아래에 나오는 모델은 거의 모두 이렇게 디코더 층만 쌓은 구조에서 칸만 바꾼 것입니다.
정규화 칸
3. Pre-LN: 본 흐름 대신 복사본을 정규화합니다
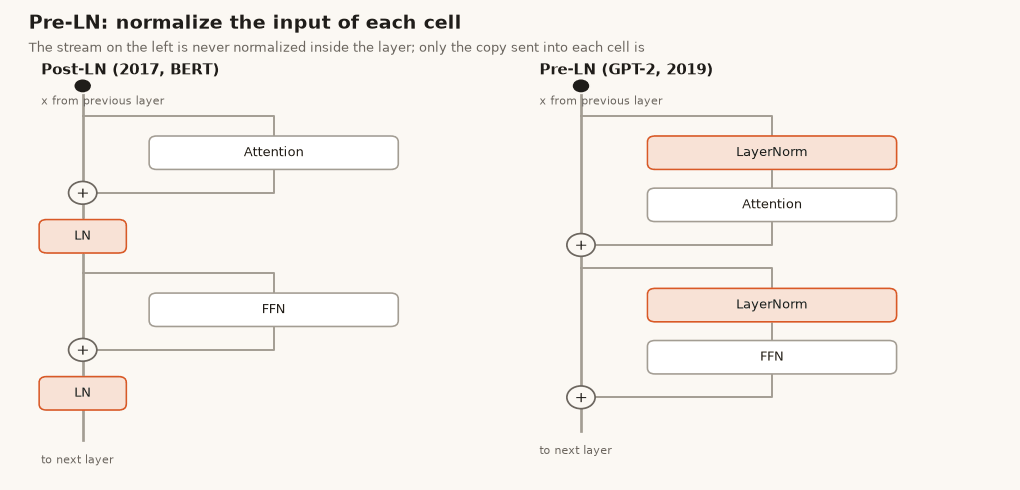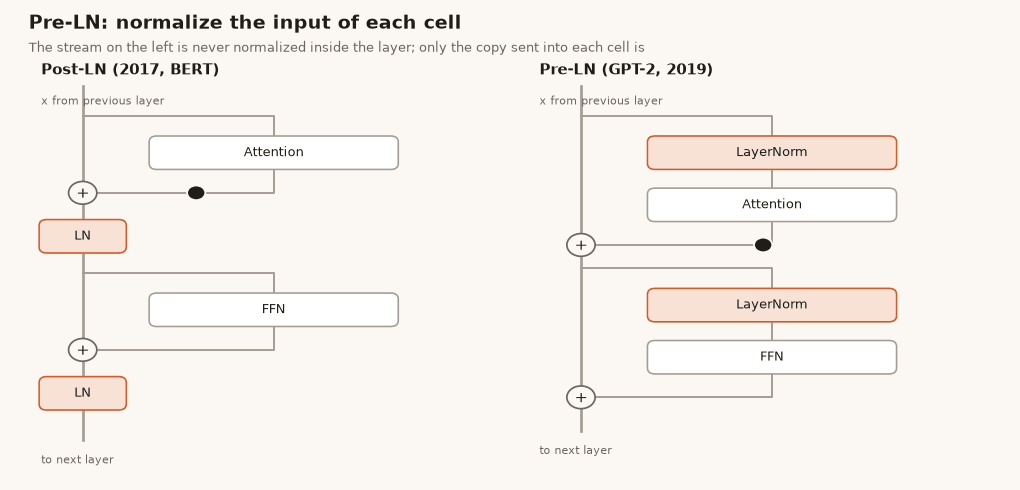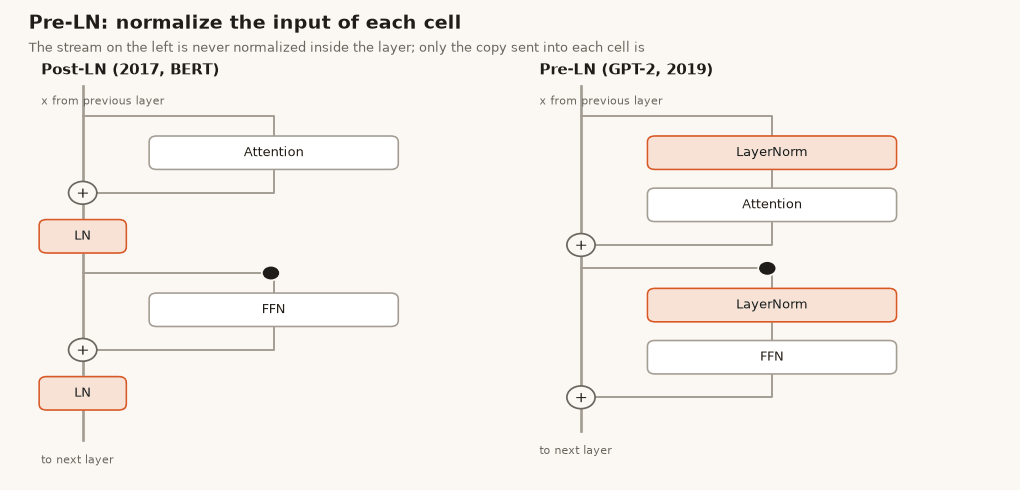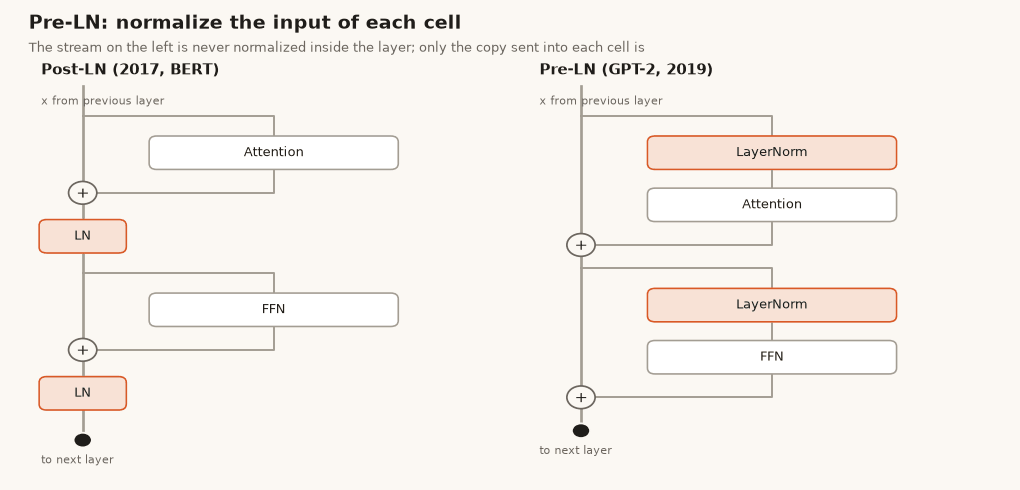
GPT-2(Radford et al., 2019)가 GPT에서 바꿨다고 밝힌 것은 셋입니다. LayerNorm을 각 칸의 입력 쪽으로 옮겼고, 마지막 층 뒤에 LayerNorm을 하나 더 넣었고, 초기화 때 잔차 가중치를 1/√N로 줄였습니다. 코드로 보면 BERT와 다른 점은 정규화 호출 위치뿐입니다.
def pre_ln_block(x, sd, H, eps):
    D = x.shape[-1]
    h = layer_norm(x, sd["ln_1.weight"], sd["ln_1.bias"], eps)      # 복사본을 정규화
    q, k, v = (heads(t, H) for t in (h @ sd["attn.c_attn.weight"] + sd["attn.c_attn.bias"]).split(D, -1))
    a = merge(attend(q, k, v, 1 / math.sqrt(D // H)))
    x = x + a @ sd["attn.c_proj.weight"] + sd["attn.c_proj.bias"]   # 정규화하지 않은 본 흐름에 더함
    h = layer_norm(x, sd["ln_2.weight"], sd["ln_2.bias"], eps)
    f = F.gelu(h @ sd["mlp.c_fc.weight"] + sd["mlp.c_fc.bias"], approximate="tanh")
    return x + f @ sd["mlp.c_proj.weight"] + sd["mlp.c_proj.bias"]
왜 나아졌는가. Xiong et al. (2020)은 Post-LN 모델이 초기화 직후 출력 가까운 층에서 기울기가 크기 때문에, 학습률을 처음에 천천히 올리는 웜업 없이는 학습이 잘 안 된다는 것을 보였습니다. IWSLT14 독일어-영어 번역에서 웜업 없는 Post-LN은 BLEU 8.45에 그쳤고, 웜업을 넣으면 약 34였습니다. Pre-LN은 기울기가 안정적이라 웜업을 뺄 수 있습니다. BERT 사전 학습에서는 Pre-LN이 검증 손실 약 1.69에 50만 스텝 무렵 닿았고 Post-LN은 70만 스텝 무렵 닿았습니다(Figure 5a). 논문은 이를 40% 빨라졌다고 적습니다.
대가는 무엇인가. 층을 지나는 동안 본 흐름을 한 번도 정규화하지 않으니, 층마다 더한 값이 계속 쌓입니다. 첫 그래프에서 커지는 선들이 그 모습입니다. GPT-2에서 마지막 토큰 벡터의 크기는 1번 층 뒤 51.6에서 12번 층 뒤 512.1이 됩니다. 크기는 출력 직전의 마지막 정규화(GPT-2가 추가한 그 LayerNorm)에서 정리합니다.
4. RMSNorm: 평균 빼기를 생략합니다
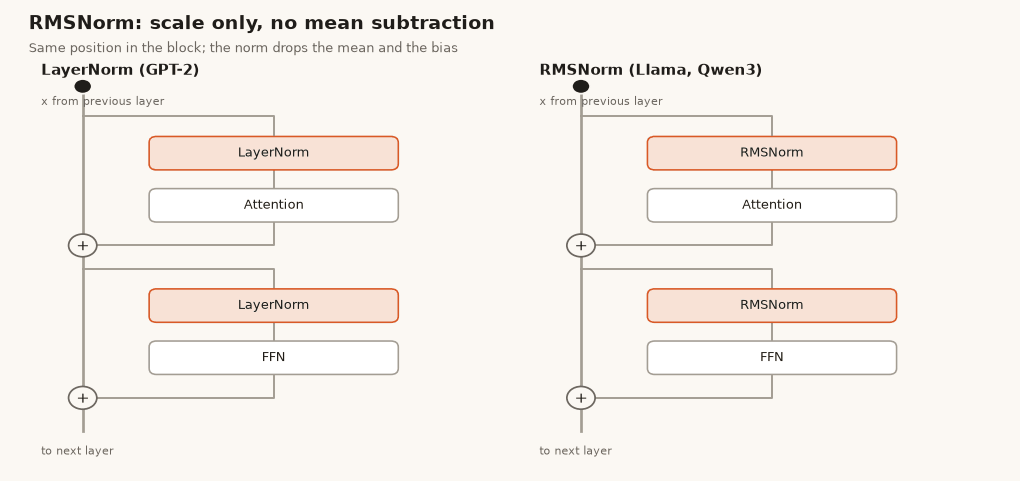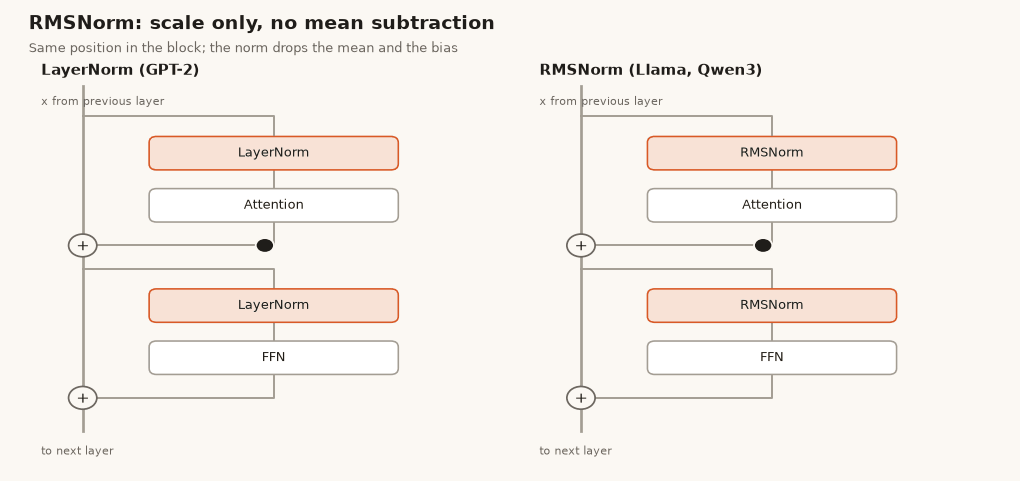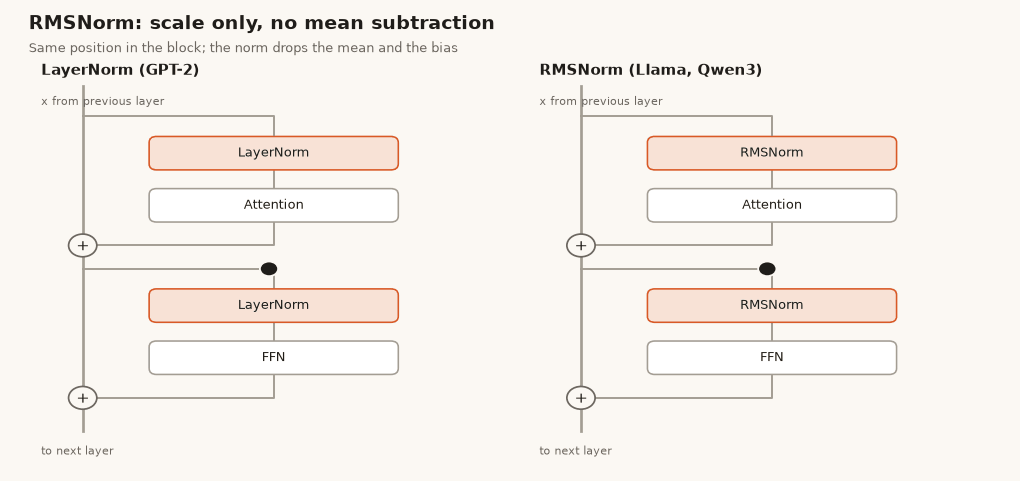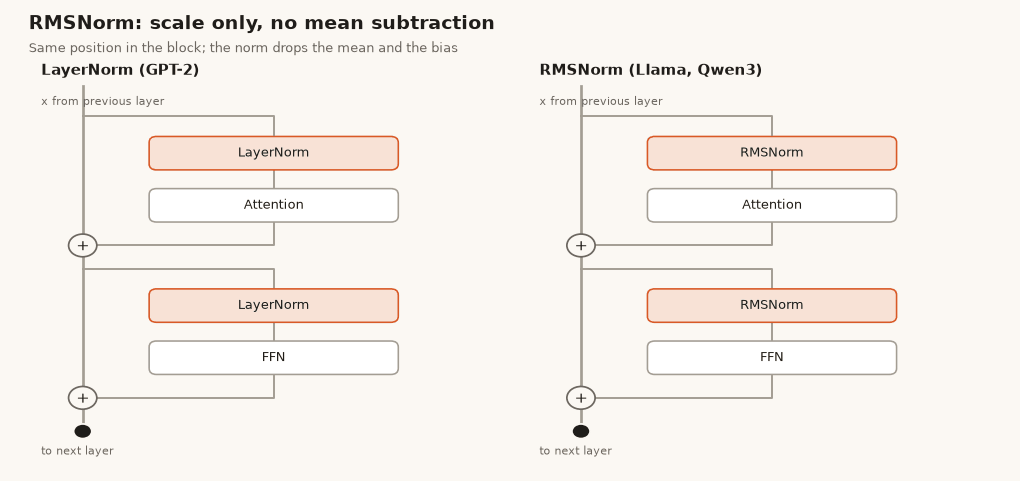
LayerNorm은 벡터에서 평균을 빼고 표준편차로 나눈 뒤, 가중치를 곱하고 편향을 더합니다. RMSNorm(Zhang and Sennrich, 2019)은 크기 맞추기만 남깁니다. 제곱평균제곱근으로 나누고 가중치를 곱하는 것이 전부입니다.
def rms_norm(x, w, eps, plus_one=False):
    y = x * torch.rsqrt(x.pow(2).mean(-1, keepdim=True) + eps)
    return y * (1 + w) if plus_one else y * w           # Gemma는 (1 + w)를 곱합니다
논문이 보고한 것. Transformer-base 번역 모델에서 학습 1,000스텝에 걸리는 시간이 248초에서 231초로 6.9% 줄었고(Table 4), newstest2014 BLEU는 26.6과 26.8이었습니다. 초록의 "7%에서 64%"라는 범위에는 RNN 모델이 들어 있고, 트랜스포머에서는 RMSNorm이 6.9%, 일부 차원만 쓰는 변형인 pRMSNorm이 9% 빨랐습니다. 대가: 평균을 맞추는 기능이 빠진다는 것 말고는 따로 적힌 것이 없고, 저자들은 그 기능이 필요 없다고 주장합니다.
5. 칸 앞뒤에 정규화 (Gemma 2, 3)
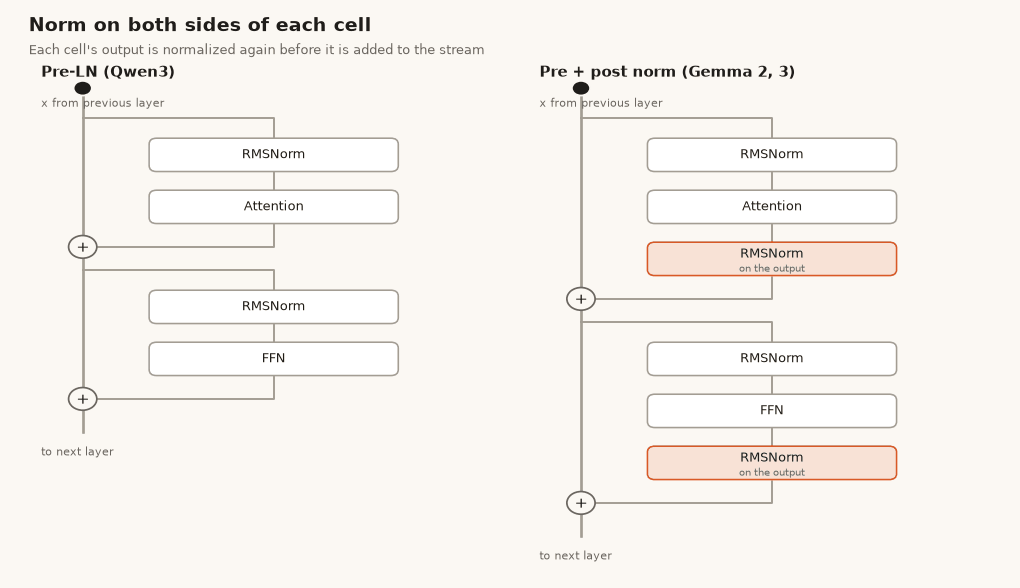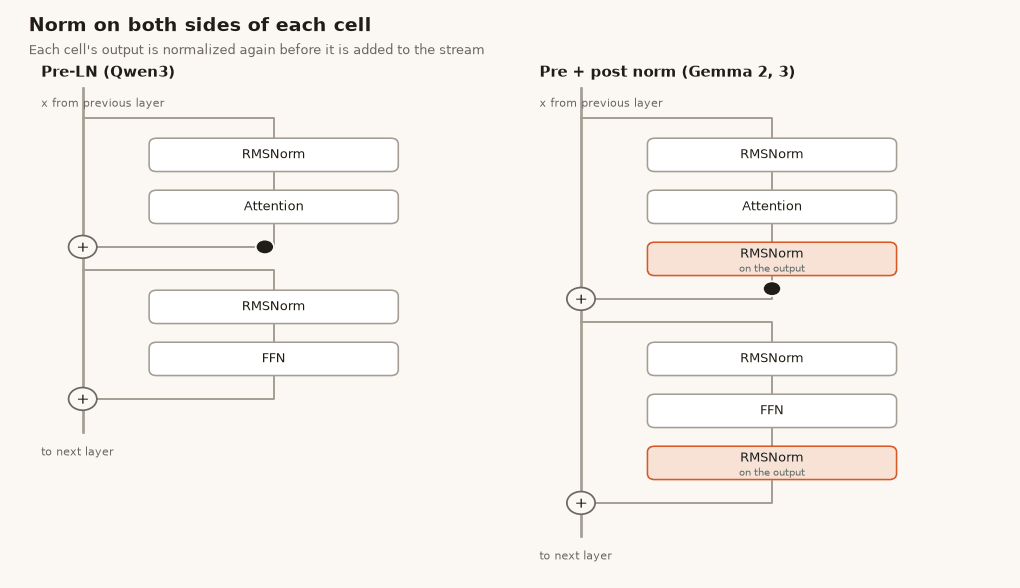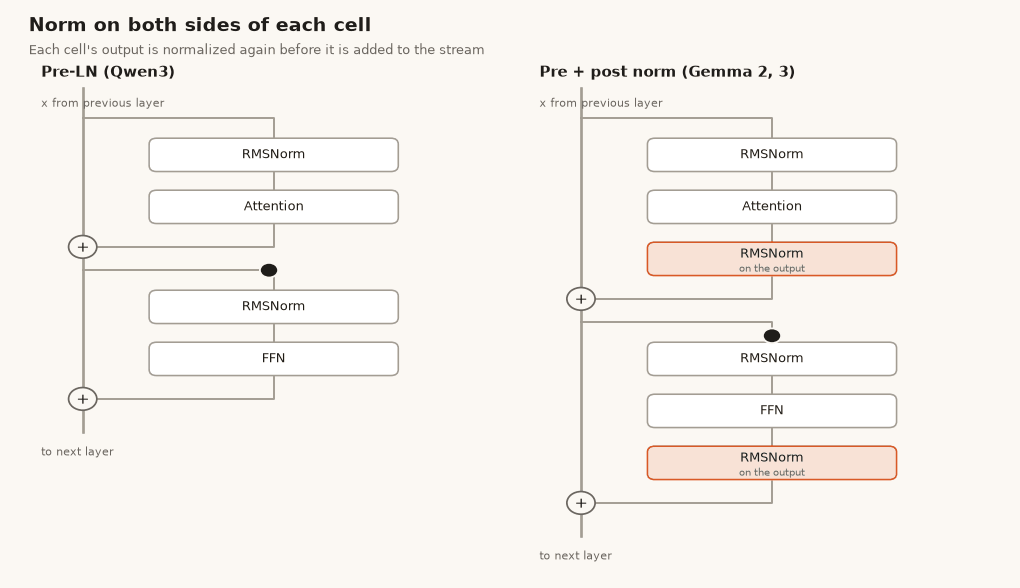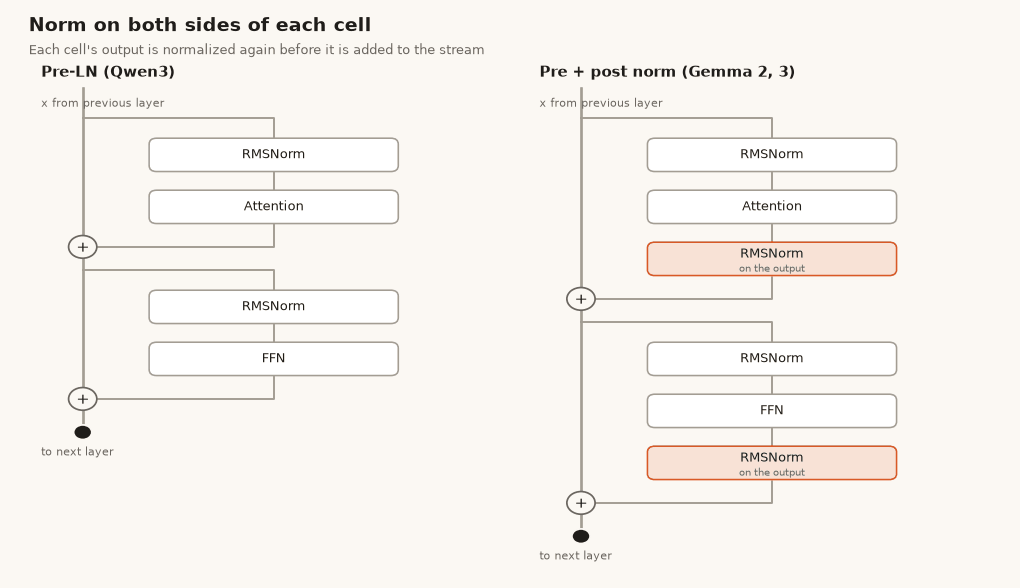
Gemma 2(Gemma Team, 2024)는 "각 트랜스포머 칸의 입력과 출력"을 정규화하고, Gemma 3(Gemma Team, 2025)도 이를 유지합니다. 그래서 Gemma 3 층 하나에는 정규화가 네 개 있습니다. input_layernorm, post_attention_layernorm, pre_feedforward_layernorm, post_feedforward_layernorm입니다.
def sandwich_block(x, sd, Hq, Hkv, d, eps, theta, scale):
    pos = torch.arange(x.shape[0])
    n = lambda t, name: rms_norm(t, sd[name], eps, plus_one=True)
    h = n(x, "input_layernorm.weight")
    q = n(heads(h @ sd["self_attn.q_proj.weight"].T, Hq), "self_attn.q_norm.weight")
    k = n(heads(h @ sd["self_attn.k_proj.weight"].T, Hkv), "self_attn.k_norm.weight")
    v = heads(h @ sd["self_attn.v_proj.weight"].T, Hkv)
    q, k = rope(q, pos, theta), rope(k, pos, theta)
    a = merge(attend(q, k, v, scale)) @ sd["self_attn.o_proj.weight"].T
    x = x + n(a, "post_attention_layernorm.weight")                  # 출력을 정규화한 뒤 더함
    h = n(x, "pre_feedforward_layernorm.weight")
    g, u = h @ sd["mlp.gate_proj.weight"].T, h @ sd["mlp.up_proj.weight"].T
    f = (F.gelu(g, approximate="tanh") * u) @ sd["mlp.down_proj.weight"].T
    return x + n(f, "post_feedforward_layernorm.weight")
가중치 이름을 읽을 때 헷갈리기 쉬운 곳이 있습니다. Llama와 Qwen3의 post_attention_layernorm은 FFN 앞의 정규화입니다. Gemma에서는 이름대로 어텐션 출력에 적용됩니다.
출력 쪽 정규화는 각 칸이 더하는 양을 제한하지만, 본 흐름 자체는 여전히 정규화하지 않습니다. 그래서 Gemma의 본 흐름도 커지고, 첫 그래프에서는 47배였습니다. GPT-2의 9.9배보다 크지만, 두 모델은 크기와 학습도 다르므로 이 그래프로 출력 쪽 정규화의 효과만 떼어 볼 수는 없습니다. 논문이 보고한 것: 이유는 "학습을 안정시키기 위해"라고만 적혀 있고, 두 보고서 모두 이 변화에 대한 수치는 없습니다. 대가: 층마다 정규화 호출이 두 번 늘어납니다.
6. QK 정규화: 쿼리와 키를 정규화합니다
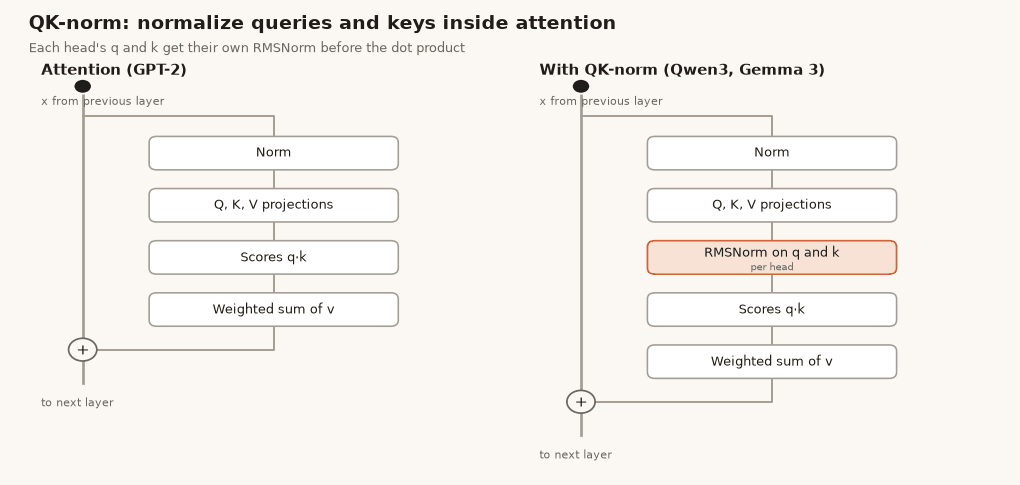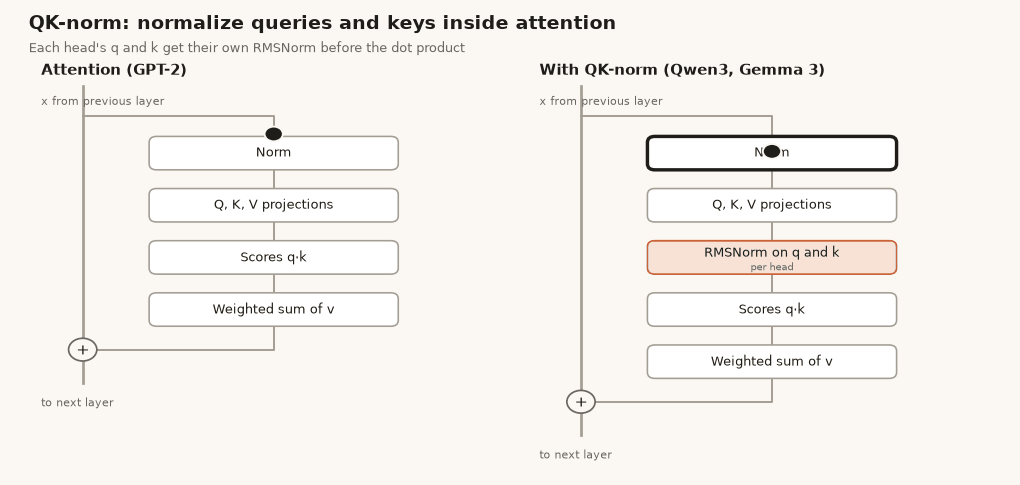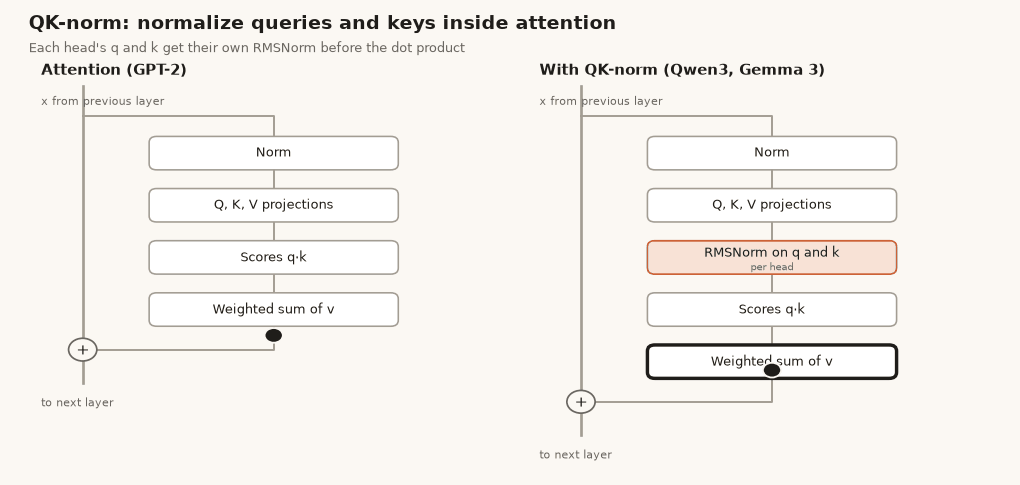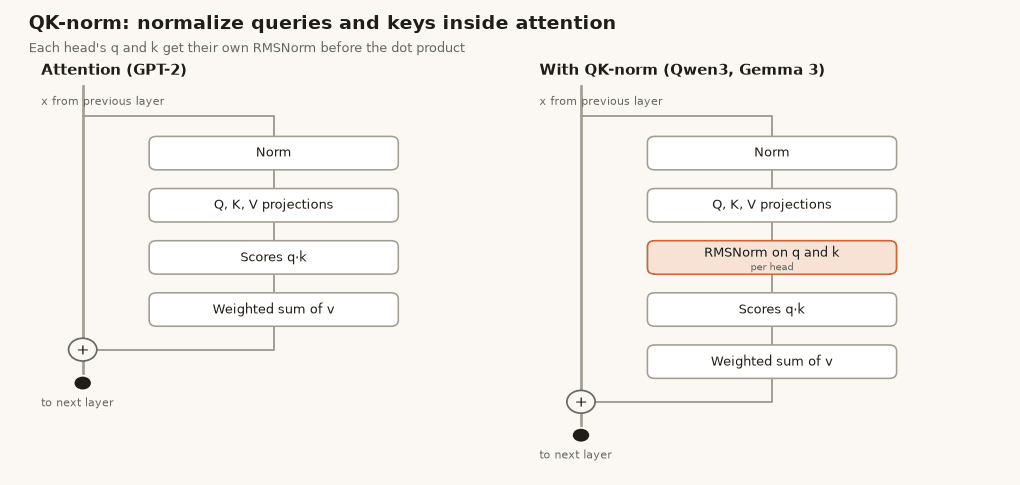
어텐션 점수는 쿼리와 키의 내적입니다. 학습 중에 두 벡터가 커지면 점수도 커지고, softmax가 가중치를 거의 한 토큰에 몰아 줍니다. ViT-22B(Dehghani et al., 2023)가 매개변수 약 80억 개 규모에서 바로 이 문제를 겪었습니다. 어텐션 로짓이 지나치게 커지면서 학습이 발산했습니다. 정규화를 넣지 않은 실험에서는 로짓의 크기가 "50000을 넘게" 커졌다고 적었습니다. 이들이 Gilmer et al. (2023)의 방법이라고 밝히며 쓴 해결책은 내적 전에 쿼리와 키에 LayerNorm을 거는 것이었습니다. 그보다 앞선 Henry et al. (2020)은 학습하는 배율을 곱한 L2 정규화를 썼고, 자원이 적은 번역 언어쌍 다섯 개에서 평균 0.928 BLEU가 올랐다고 보고합니다.
Qwen3(Yang et al., 2025)는 Qwen2의 QKV 편향을 없애고 "안정적인 학습을 위해" QK 정규화를 넣었습니다. Gemma 3는 Gemma 2의 로짓 소프트 캡을 이것으로 바꿨습니다. Qwen3에서는 q와 k에 헤드마다 RMSNorm을 하나씩 거는 두 줄이 늘어날 뿐입니다.
def qwen3_block(x, sd, Hq, Hkv, d, eps, theta):
    pos = torch.arange(x.shape[0])
    h = rms_norm(x, sd["input_layernorm.weight"], eps)
    q = rms_norm(heads(h @ sd["self_attn.q_proj.weight"].T, Hq), sd["self_attn.q_norm.weight"], eps)
    k = rms_norm(heads(h @ sd["self_attn.k_proj.weight"].T, Hkv), sd["self_attn.k_norm.weight"], eps)
    v = heads(h @ sd["self_attn.v_proj.weight"].T, Hkv)
    q, k = rope(q, pos, theta), rope(k, pos, theta)
    x = x + merge(attend(q, k, v, 1 / math.sqrt(d))) @ sd["self_attn.o_proj.weight"].T
    return x + swiglu(rms_norm(x, sd["post_attention_layernorm.weight"], eps), sd)
이 함수 하나에 4번, 7번, 10번 항목도 같이 들어 있습니다. 대가: 정규화마다 작은 가중치 벡터(Qwen3-0.6B에서는 각 128개)가 생기고, 층마다 정규화 호출이 두 번 늘어납니다.
위치 칸
7. RoPE: 어텐션 안에서 위치만큼 회전합니다
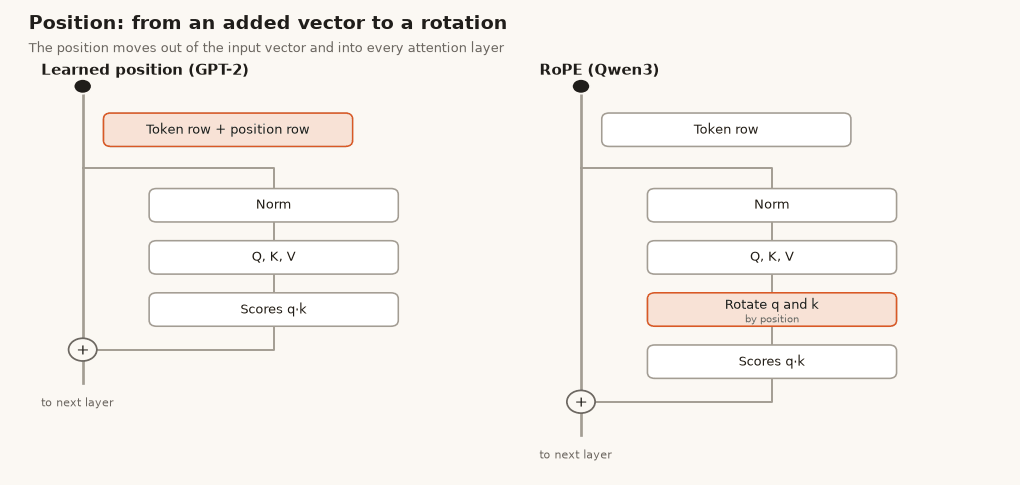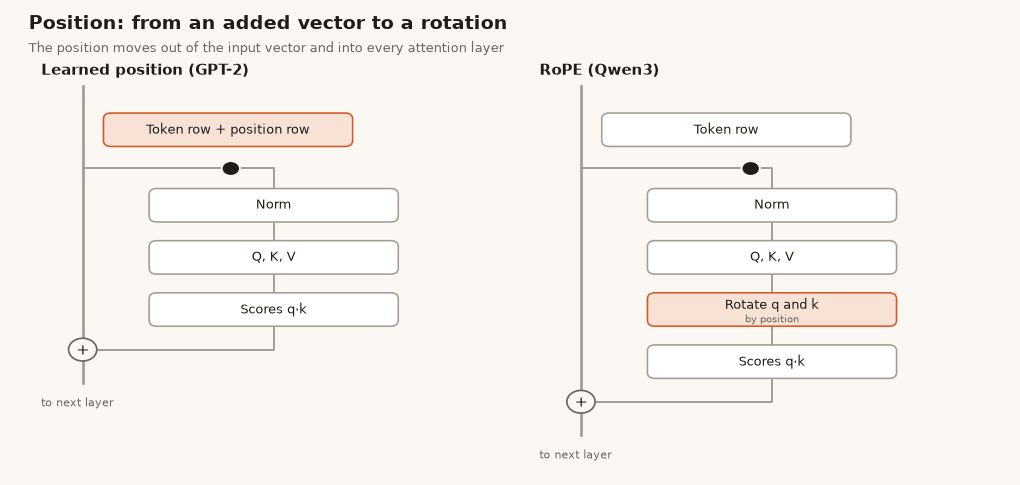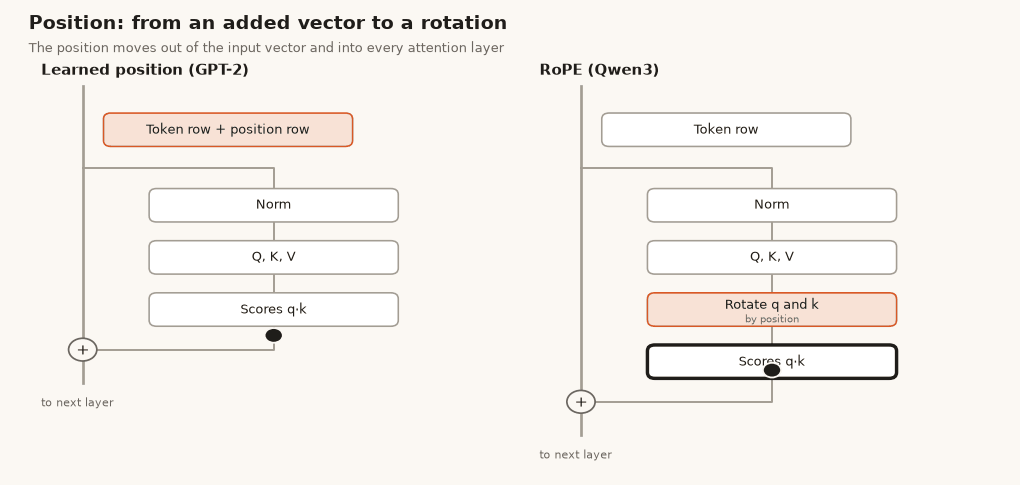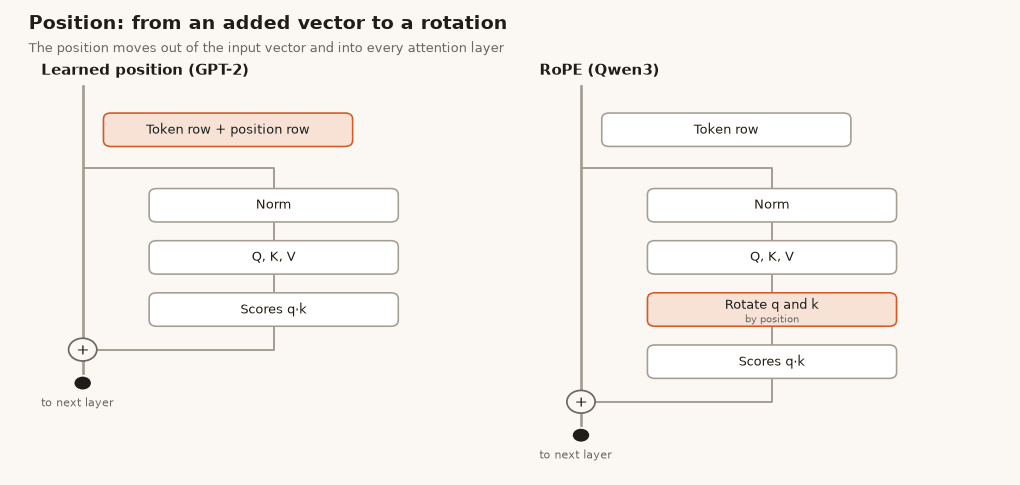
GPT-1과 GPT-2는 맨 아래에서 토큰 벡터마다 학습한 위치 벡터를 한 번 더합니다. GPT-2의 위치 행은 1,024개라 그보다 긴 입력은 받지 못합니다. RoPE(Su et al., 2021)는 그 대신 어텐션 층마다 q와 k의 숫자를 두 개씩 짝지어 위치에 비례하는 각도로 회전합니다. 그러면 회전한 두 벡터의 내적이 두 토큰 사이의 거리에 따라 정해집니다. rope 함수와 이 성질을 확인한 과정은 앞 글에 있습니다.
논문이 보고한 것: WMT14 영어-독일어에서 Transformer base의 27.3 대비 27.5 BLEU였고, 중국어 법률 문서 짝 맞추기 과제에서는 BERT 기준선 67.77% 대비 512토큰에서 68.29%, 1,024토큰에서 69.79%였습니다. 저자들이 밝힌 한계: 왜 기준 모델보다 빨리 수렴하는지 "충분한 설명이 없다"고 적었습니다. Pythia는 각 헤드의 앞 4분의 1에만 RoPE를 겁니다(아래 parallel_block의 rot_frac = 0.25). Qwen3-Next의 어텐션 층도 같은 방식입니다.
8. NoPE: 위치 신호를 아예 넣지 않습니다
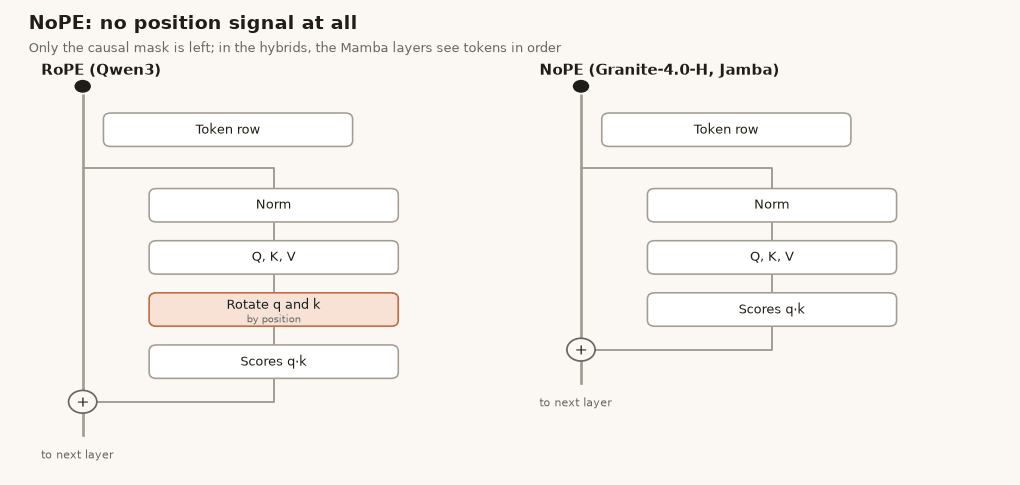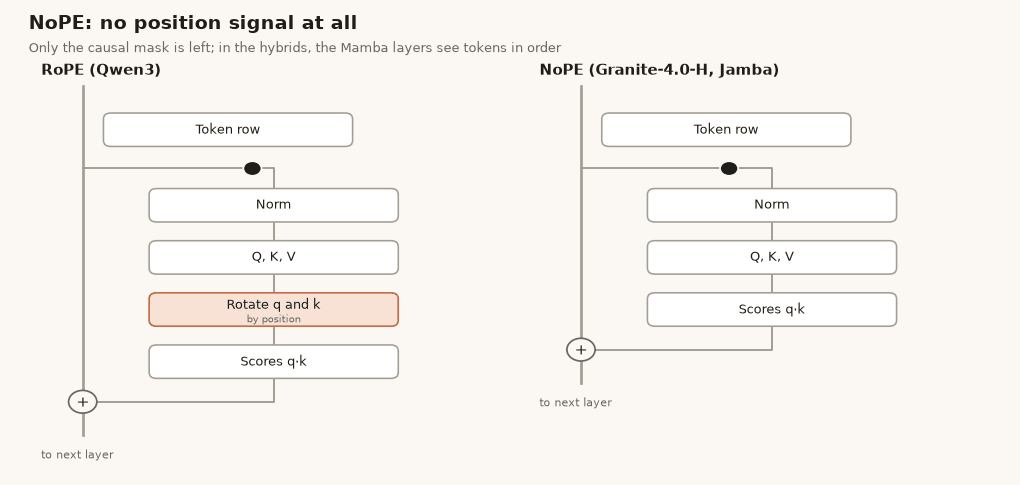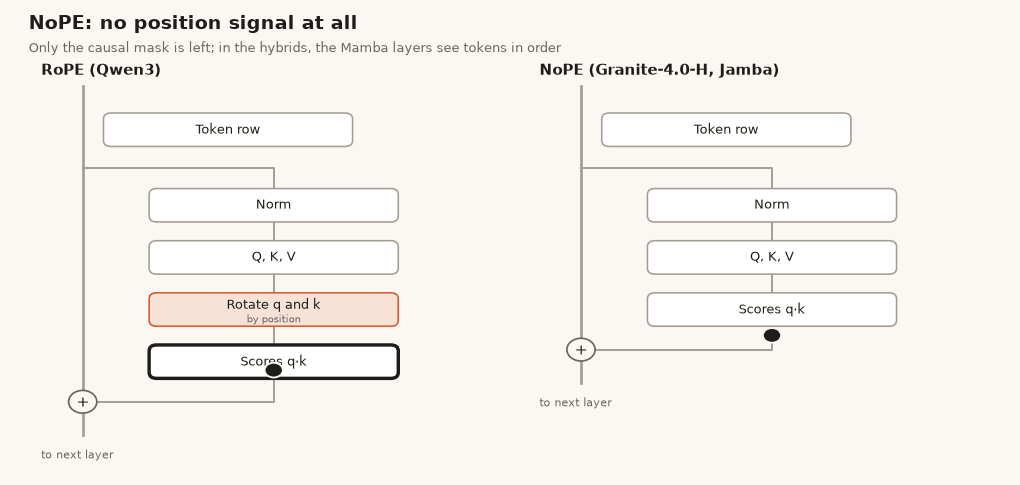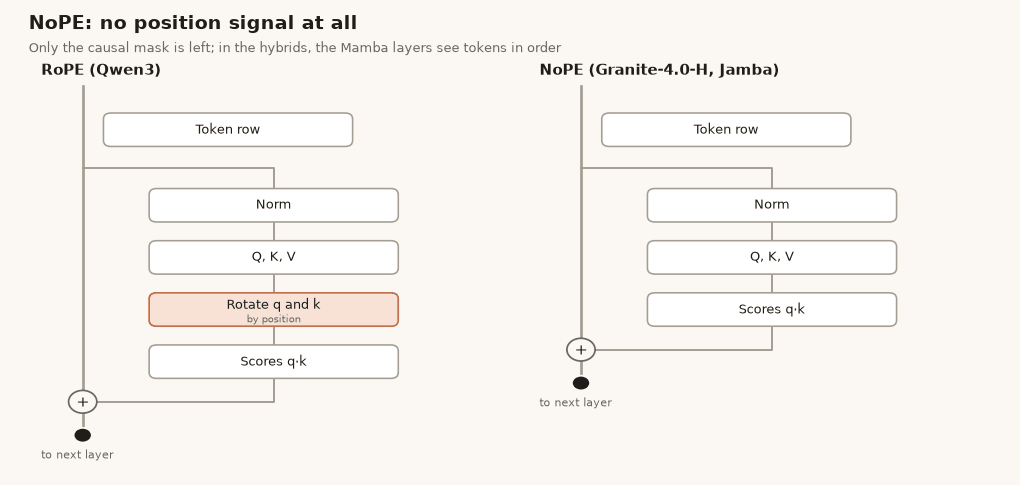
디코더는 위치 인코딩이 없어도 위치 정보를 어느 정도 가집니다. 인과 마스크 때문에 10번 토큰은 앞 토큰 10개를 보고, 3번 토큰은 3개만 봅니다. Kazemnejad et al. (2023)은 매개변수 약 1억 700만 개의 작은 디코더 모델을 합성 추론 과제로 학습시켰고, 위치 인코딩을 아예 넣지 않은 모델이 학습 때보다 긴 입력에서 함께 시험한 다른 방식들보다 잘 버텼습니다. 밝힌 한계: 대규모 사전 학습은 시험하지 못했고, 10억 개 규모 실험에서는 가장 긴 길이에서 ALiBi가 NoPE보다 안정적이었습니다.
하이브리드 모델이 NoPE를 쓰는 이유는 따로 있습니다. Jamba 논문(Lieber et al., 2024)은 "Mamba 층이 있으면 위치 임베딩이나 RoPE 같은 장치가 필요 없다"고 적습니다. Granite-4.0-H-350M의 설정 파일에도 "position_embedding_type": "nope"가 있습니다. Mamba 층은 토큰을 순서대로 읽으니 순서가 이미 상태에 들어 있습니다. 저희가 짠 Jamba와 Granite 어텐션 코드에는 rope 호출이 없고, 두 모델 모두 실제 층과 맞았습니다.
잇는 방식
9. 병렬 블록: 어텐션과 FFN이 같은 입력을 읽습니다
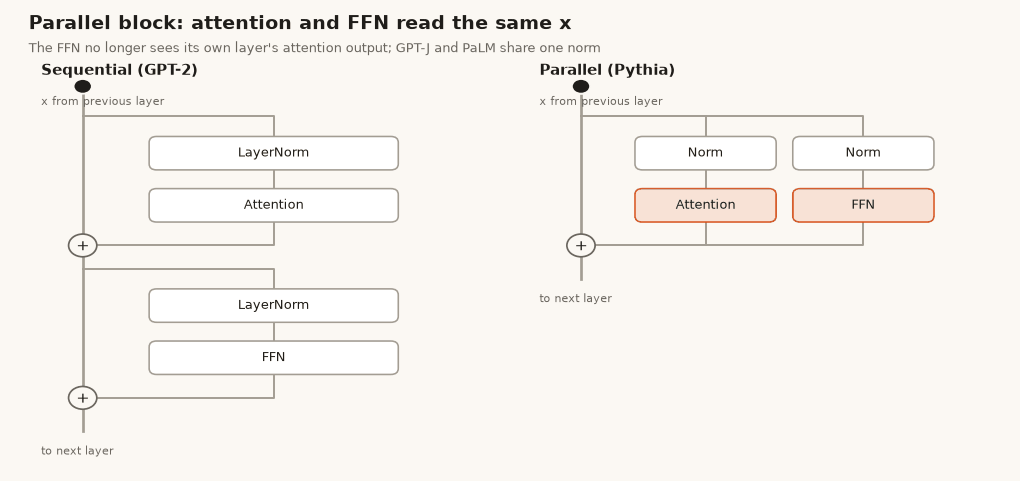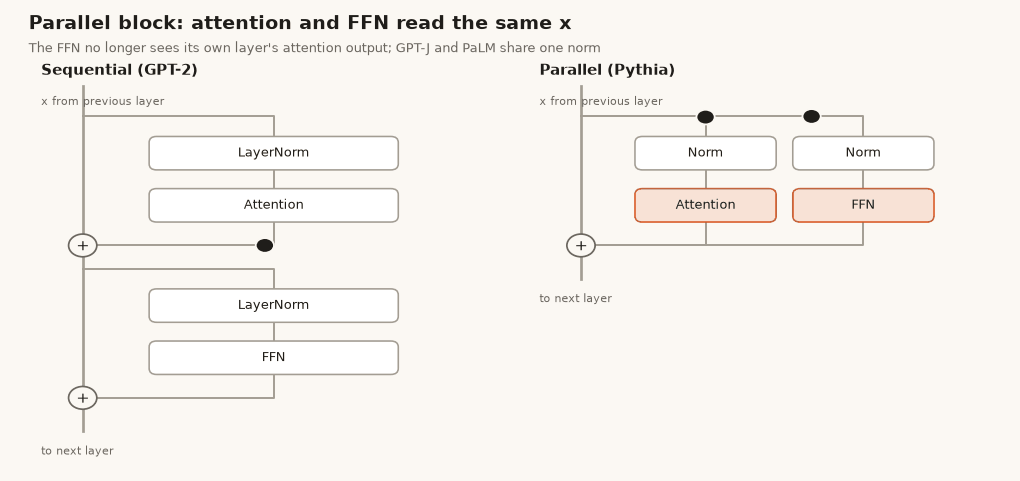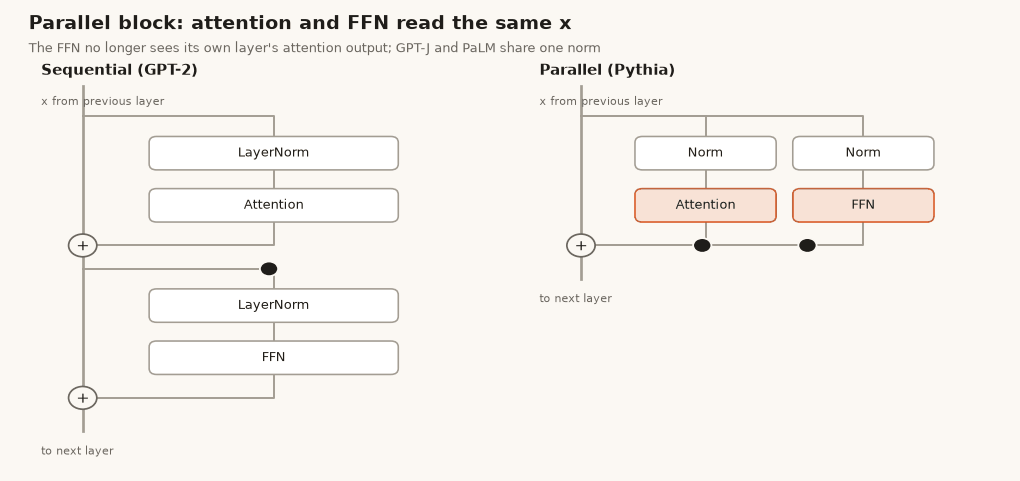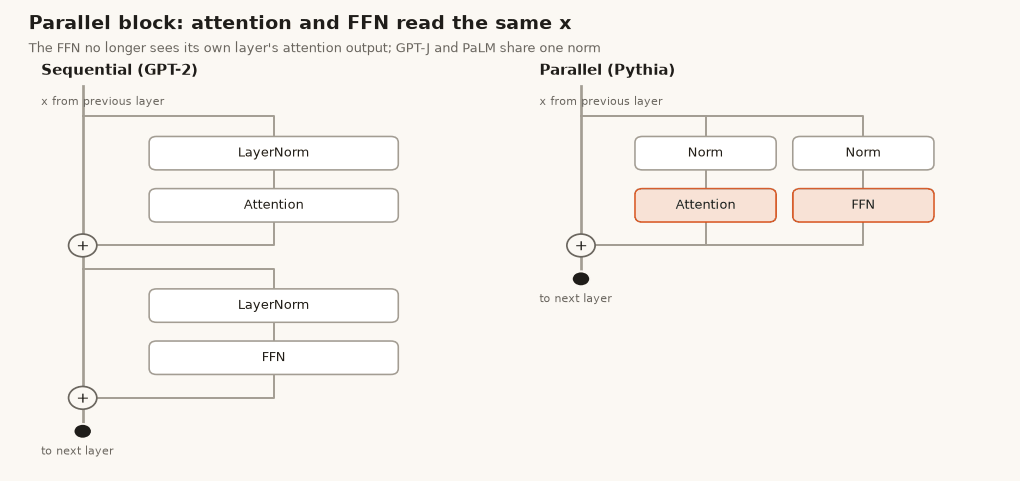
보통 블록에서는 어텐션 결과가 더해진 x를 FFN이 받습니다. GPT-J(Wang and Komatsuzaki, 2021)는 둘을 같은 x에서 계산해 함께 더했습니다. PaLM(Chowdhery et al., 2022)은 이를 받아들이고 "MLP와 어텐션의 입력 행렬 곱을 합칠 수 있어 큰 규모에서 학습이 약 15% 빨라졌다"고 보고했습니다. 동시에 "80억 규모에서는 품질이 조금 떨어졌고 620억 규모에서는 떨어지지 않았다"고 적었으며, 5,400억 규모에서 영향이 없으리라는 것은 이 결과에서 미루어 본 것입니다. GPT-NeoX와 Pythia도 이 방식을 씁니다.
def parallel_block(x, sd, H, eps, theta, rot_frac):
    T, D = x.shape
    pos = torch.arange(T)
    h = layer_norm(x, sd["input_layernorm.weight"], sd["input_layernorm.bias"], eps)
    qkv = (h @ sd["attention.query_key_value.weight"].T + sd["attention.query_key_value.bias"])
    qkv = qkv.view(T, H, 3 * (D // H)).transpose(0, 1)              # 헤드마다 [q|k|v]
    q, k, v = qkv.chunk(3, -1)
    rd = int((D // H) * rot_frac)                                   # Pythia는 헤드 차원의 1/4만 돌립니다
    q, k = rope(q, pos, theta, rd), rope(k, pos, theta, rd)
    a = merge(attend(q, k, v, 1 / math.sqrt(D // H)))
    a = a @ sd["attention.dense.weight"].T + sd["attention.dense.bias"]
    h2 = layer_norm(x, sd["post_attention_layernorm.weight"], sd["post_attention_layernorm.bias"], eps)
    f = F.gelu(h2 @ sd["mlp.dense_h_to_4h.weight"].T + sd["mlp.dense_h_to_4h.bias"])
    f = f @ sd["mlp.dense_4h_to_h.weight"].T + sd["mlp.dense_4h_to_h.bias"]
    return x + a + f                                                # 한 번에 더하기
Pythia는 정규화를 하나로 공유하지 않고 두 개(h와 h2)를 따로 둡니다. GPT-NeoX 논문(Black et al., 2022)은 이것이 의도한 설계가 아니었고, 작은 규모 실험에서는 차이가 없었다고 밝힙니다. 대가: 한 층 안에서 FFN이 방금 어텐션이 찾은 정보를 쓸 수 없습니다.
FFN 칸
10. SwiGLU: 문(gate)이 달린 FFN
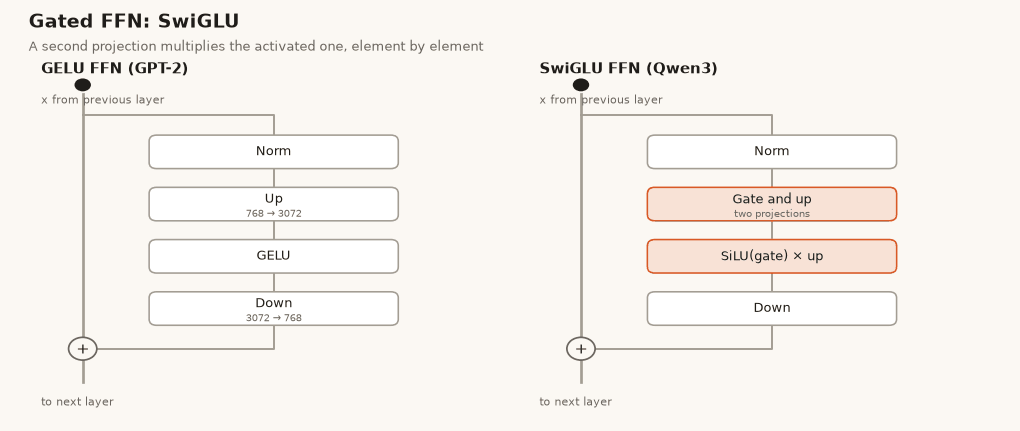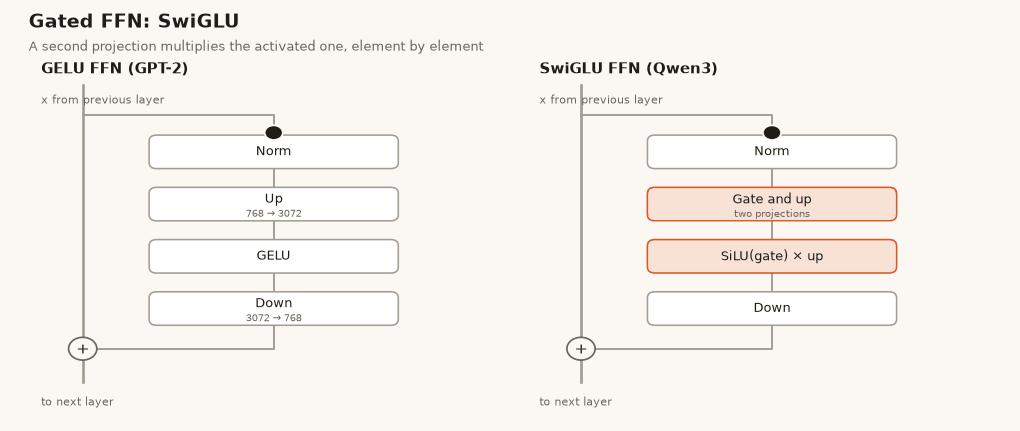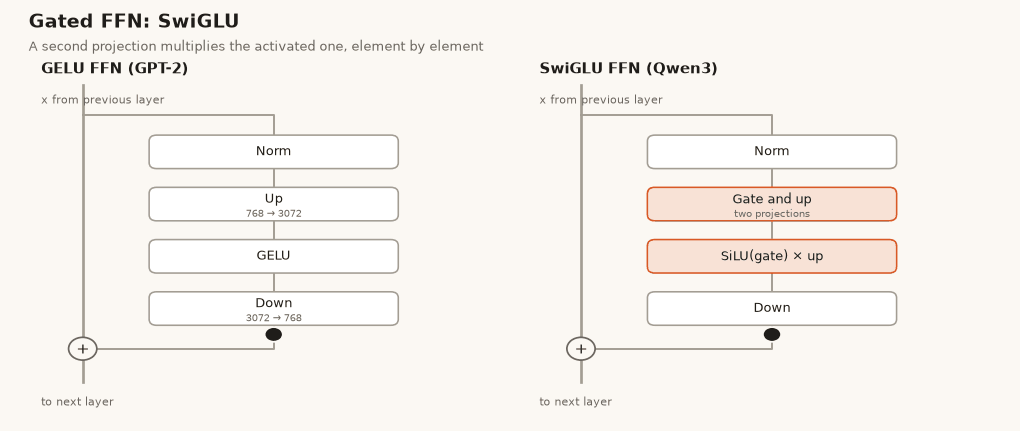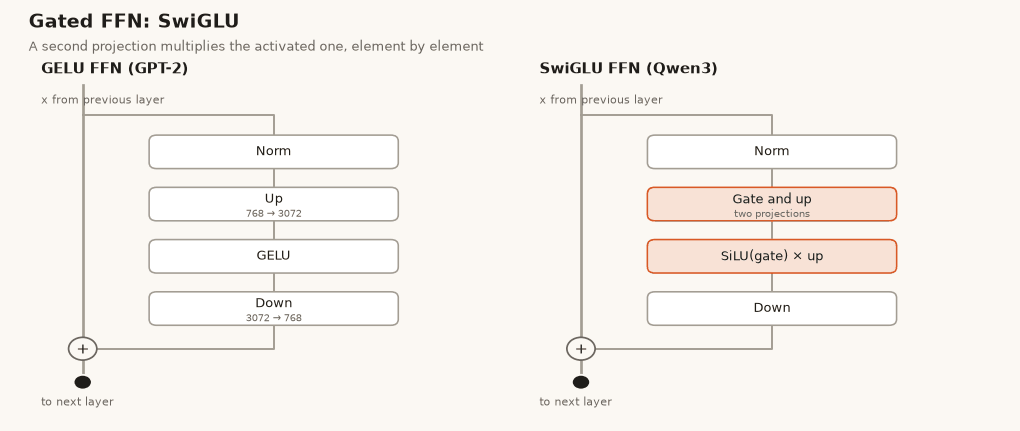
GPT-2의 FFN은 올리기, GELU, 내리기 세 단계입니다. 문이 달린 FFN(Shazeer, 2020)은 올리는 투영을 하나 더 만들고, 활성화를 거친 첫 투영과 원소별로 곱합니다.
def swiglu(h, sd, pre="mlp."):
    return (F.silu(h @ sd[pre + "gate_proj.weight"].T) * (h @ sd[pre + "up_proj.weight"].T)) @ sd[pre + "down_proj.weight"].T
논문이 보고한 것. 행렬이 하나 늘어난 만큼 안쪽 폭을 3,072에서 2,048로, 3분의 2로 줄여 매개변수와 계산량을 맞췄습니다. 그 조건에서 T5 방식 빈칸 채우기를 524,288스텝 학습한 뒤의 검증 로그 퍼플렉서티는 ReLU 1.677, GELU 1.679, SwiGLU 1.636, GEGLU 1.633이었습니다(낮을수록 좋습니다). 이유에 대한 저자의 설명은 이 두 문장이 전부입니다. "왜 이런 구조가 잘 되는지는 설명을 내놓지 못합니다. 다른 모든 것과 마찬가지로, 그 성공은 신의 은총 덕분으로 돌립니다." Qwen3는 SwiGLU를, Gemma는 GELU판인 GeGLU(위 sandwich_block)를 씁니다.
11. 전문가 혼합: 라우터가 FFN 몇 개를 고릅니다
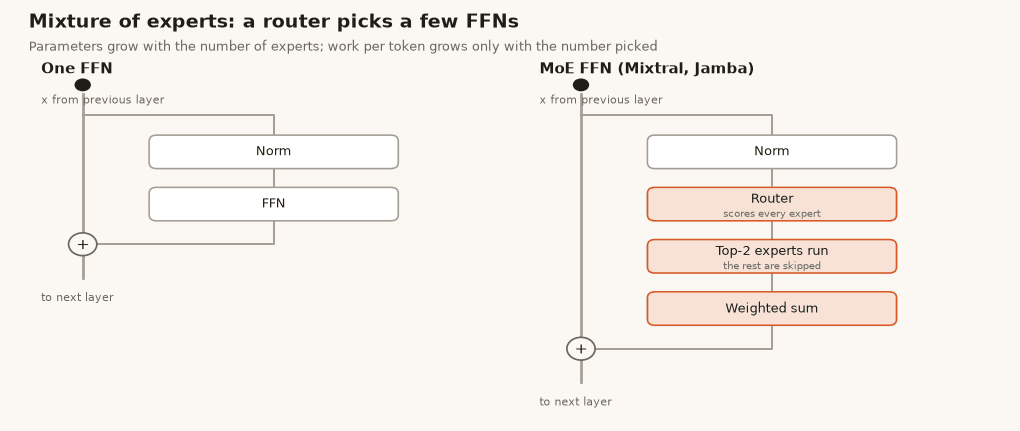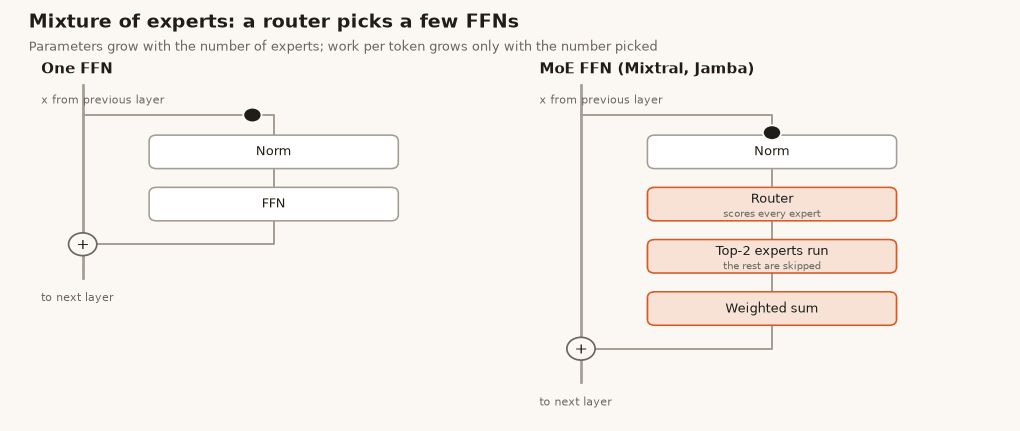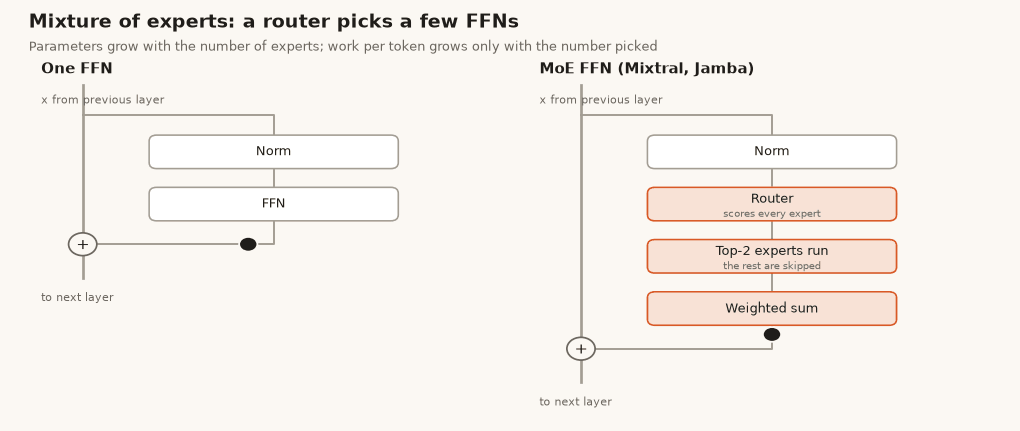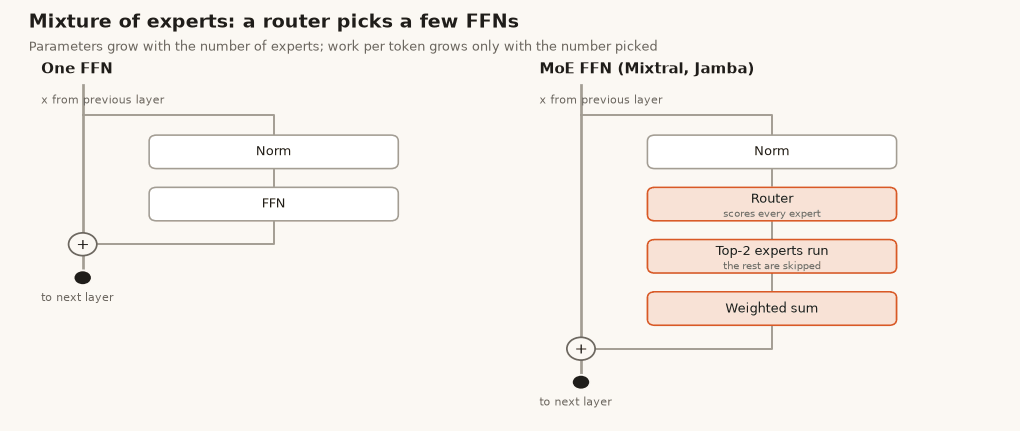
전문가 혼합(MoE) 층은 FFN 하나를 여러 FFN(전문가)과 작은 라우터로 바꿉니다. 라우터가 토큰마다 전문가 몇 개를 고릅니다. Shazeer et al. (2017)은 LSTM 층 사이에 이를 넣었고, Switch Transformers(Fedus et al., 2021)는 트랜스포머 FFN 자리에 넣어 토큰마다 전문가 하나만 쓰게 했습니다. 이 논문은 "같은 계산 자원으로 사전 학습이 최대 7배 빨라졌다"고 보고합니다. Mixtral(Jiang et al., 2024)은 전문가 8개 중 2개를 고르며, 전체 매개변수 470억 개 중 토큰마다 130억 개를 씁니다.
def moe_ffn(h, sd, top_k):
    p = (h @ sd["feed_forward.router.weight"].T).softmax(-1)        # (토큰, 전문가)
    w, idx = p.topk(top_k, -1)                                       # Jamba는 고른 가중치를 다시 나누지 않습니다
    out = torch.zeros_like(h)
    gu, down = sd["feed_forward.experts.gate_up_proj"], sd["feed_forward.experts.down_proj"]
    for t in range(h.shape[0]):
        for j in range(top_k):
            e = idx[t, j]
            g, u = (h[t] @ gu[e].T).chunk(2, -1)
            out[t] += w[t, j] * ((F.silu(g) * u) @ down[e].T)
    return out, idx
이 함수는 어떤 전문가를 골랐는지도 돌려주니, 라우팅을 직접 볼 수 있습니다. 전문가 8개 중 2개를 고르는 Jamba-tiny-dev의 3번 층은 토큰 19개 중 10개를 0번 전문가에 보내고, 4번 전문가에는 1개만 보냅니다. 5번 층은 같은 토큰들을 다르게 나누며, 가장 많이 받은 전문가는 9개를 받은 3번입니다.
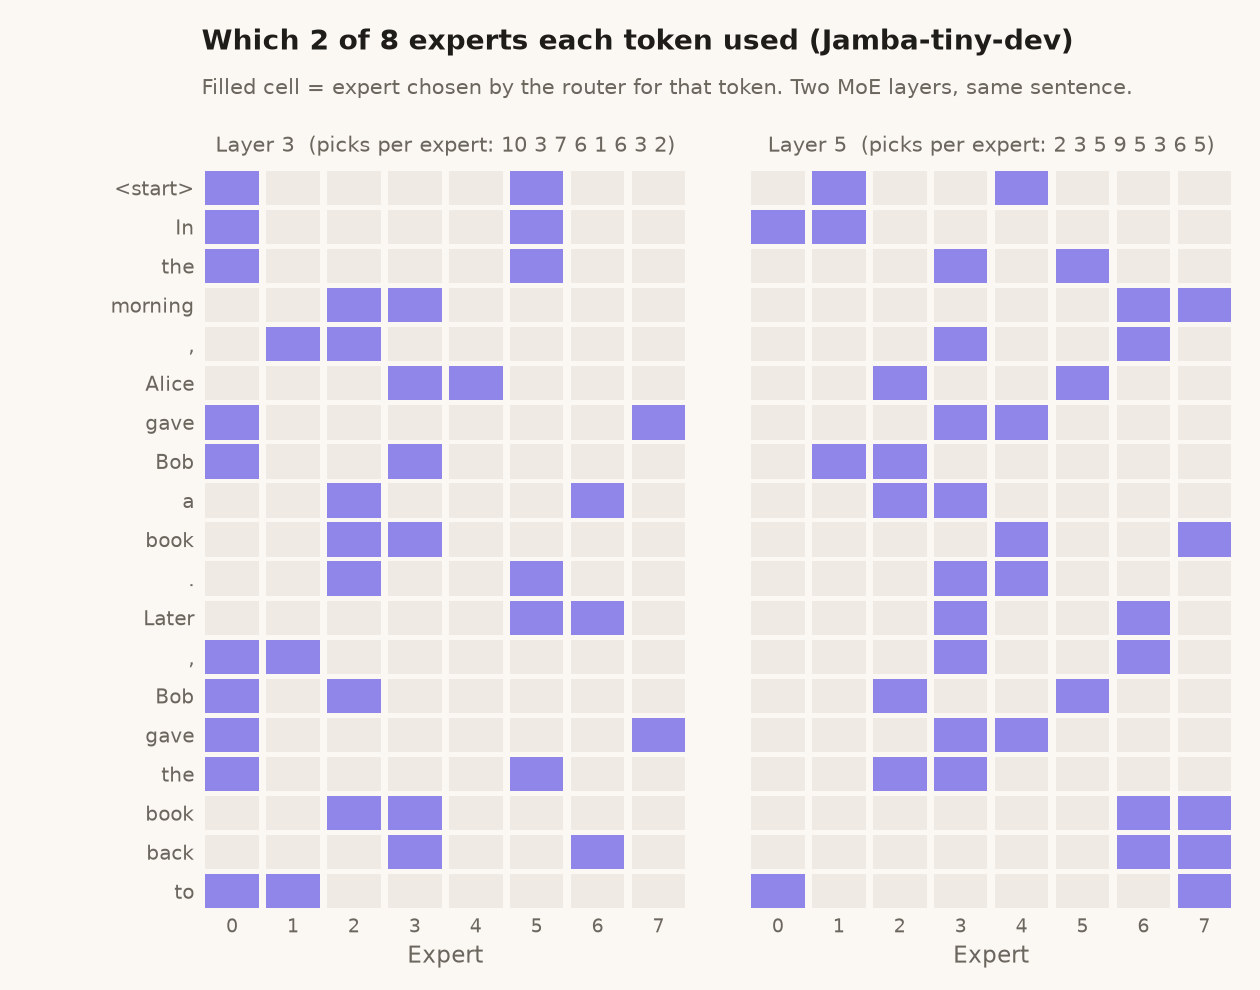
작은 개발용 모델에 문장 하나를 넣은 결과이니, 라우팅이 어떻게 생겼는지를 보여 줄 뿐 어느 전문가가 무엇을 맡는지는 말해 주지 않습니다. Mixtral이 밝힌 대가: 메모리는 쓰는 매개변수(130억)가 아니라 전체 매개변수(470억)만큼 필요하고, 라우팅에 따른 부담도 생깁니다. 그래서 MoE는 "여러 요청을 묶어 처리하는 작업에 더 알맞다"고 적습니다. Switch 논문은 "복잡도, 통신 비용, 학습 불안정"을 꼽습니다.
섞기 칸을 바꾸기
12. Mamba: 어텐션과 FFN 대신 칸 하나
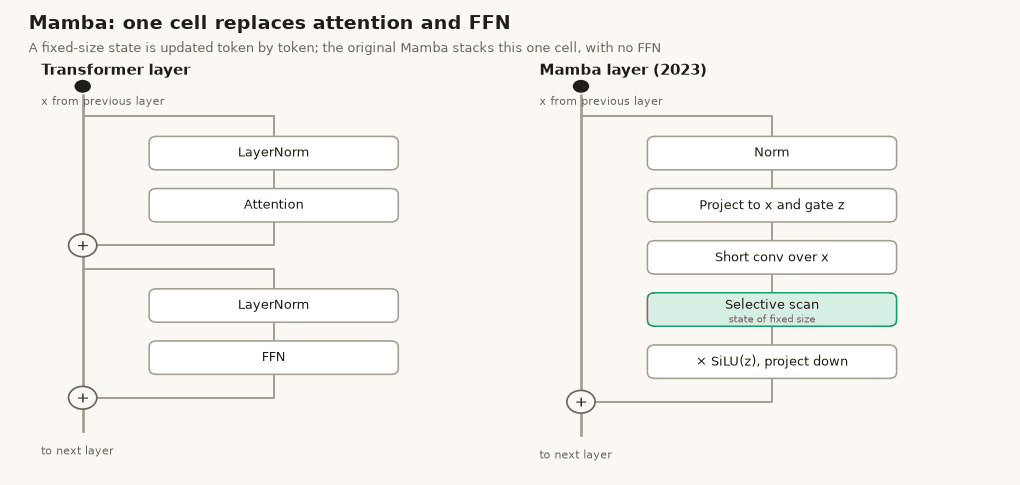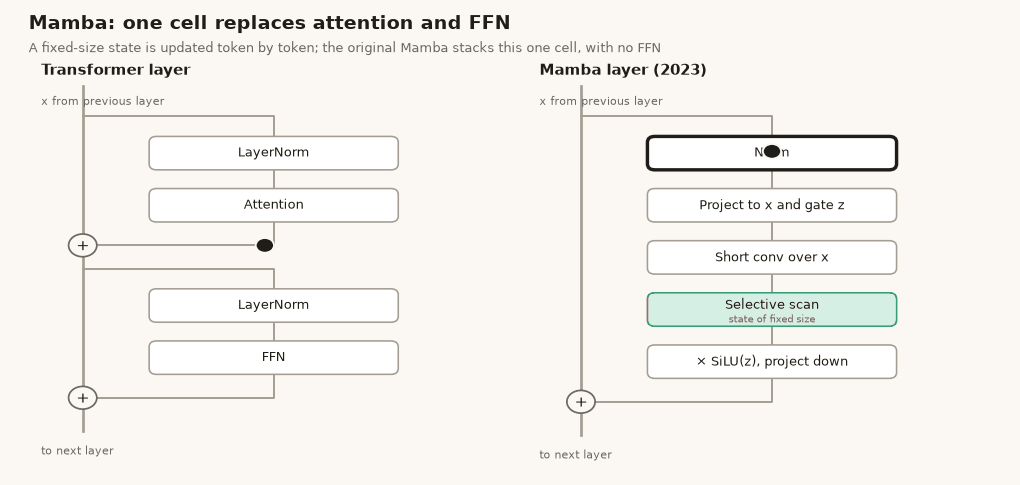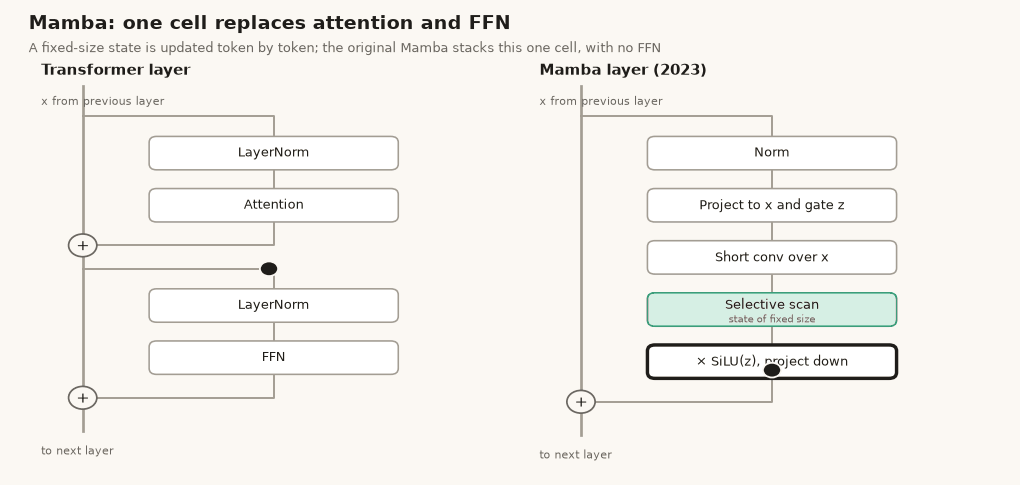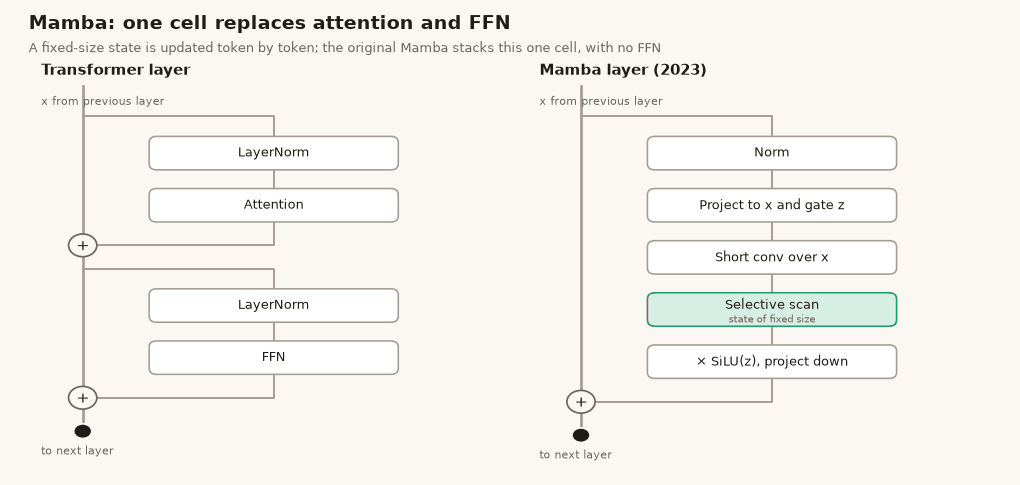
어텐션은 앞의 모든 토큰을 다시 보니 입력이 길어질수록 캐시가 커집니다. Mamba(Gu and Dao, 2023)는 그 대신 크기가 고정된 상태를 두고 토큰마다 한 번씩 갱신합니다. 갱신 방식이 토큰에 따라 달라지는 것이 "선택적"이라는 말의 뜻입니다. 걸음 크기 dt와 벡터 B, C를 입력에서 계산하므로, 모델이 토큰마다 무엇을 얼마나 남기고 무엇을 새로 쓸지 정할 수 있습니다. 원래 Mamba는 FFN도 없앴습니다. 저자들은 두 칸을 블록 하나로 합쳐 "같은 블록을 반복해 쌓았다"고 설명합니다.
아래는 Jamba의 Mamba 층을 순서대로 도는 스캔으로 쓴 것입니다.
def mamba1(h, sd, eps):
    T = h.shape[0]
    p = "mamba."
    xs, z = (h @ sd[p + "in_proj.weight"].T).chunk(2, -1)
    w = sd[p + "conv1d.weight"]
    xs = F.conv1d(xs.T[None], w, sd[p + "conv1d.bias"], padding=w.shape[-1] - 1, groups=w.shape[0])[0, :, :T].T
    xs = F.silu(xs)
    N, R = sd[p + "A_log"].shape[1], sd[p + "dt_proj.weight"].shape[1]
    dt, B, C = (xs @ sd[p + "x_proj.weight"].T).split([R, N, N], -1)
    dt, B, C = rms_norm(dt, sd[p + "dt_layernorm.weight"], eps), rms_norm(B, sd[p + "b_layernorm.weight"], eps), rms_norm(C, sd[p + "c_layernorm.weight"], eps)
    dt = F.softplus(dt @ sd[p + "dt_proj.weight"].T + sd[p + "dt_proj.bias"])   # 토큰마다 걸음 크기
    A = -torch.exp(sd[p + "A_log"])                                  # (채널, N)
    state = torch.zeros_like(A)
    ys = []
    for t in range(T):
        state = torch.exp(dt[t][:, None] * A) * state + (dt[t] * xs[t])[:, None] * B[t][None]
        ys.append(state @ C[t] + sd[p + "D"] * xs[t])
    return (torch.stack(ys) * F.silu(z)) @ sd[p + "out_proj.weight"].T
반복문 안의 한 줄에 핵심이 다 들어 있습니다. 이전 상태를 exp(dt * A)만큼 줄이고, 새 입력을 B로 써 넣고, C로 읽어 냅니다. dt, B, C에 거는 rms_norm 세 개는 Jamba가 더한 것이고 원래 Mamba에는 없습니다. Jamba는 Mamba 칸 뒤에 FFN이나 MoE 칸도 붙이므로(재현 묶음의 jamba_block), Jamba의 층은 Mamba 논문처럼 FFN이 없는 블록이 아닙니다.
논문이 보고한 것: 비슷한 크기의 트랜스포머보다 추론 처리량이 4-5배 높았고, 그 이유를 "KV 캐시가 없어 훨씬 큰 배치를 쓸 수 있기 때문"이라고 설명합니다. Mamba-3B는 두 배 크기의 트랜스포머와 성능이 비슷했습니다. 밝힌 한계: 평가가 작은 모델에 한정되어 있습니다. Jamba 논문은 한계를 하나 더 보탭니다. 순수 Mamba 모델은 예시 몇 개를 주는 프롬프트에서 "올바른 형식을 따르지 않는 경우가 많았고", 저자들은 이를 문맥 안 학습이 약하다는 신호로 봅니다.
13. Mamba-2: 같은 스캔을 더 단순하게, 헤드 단위로
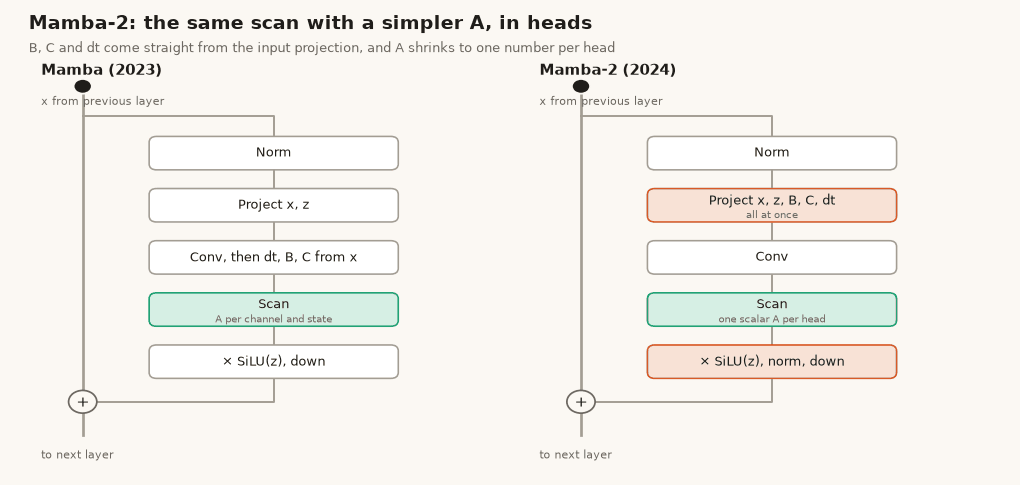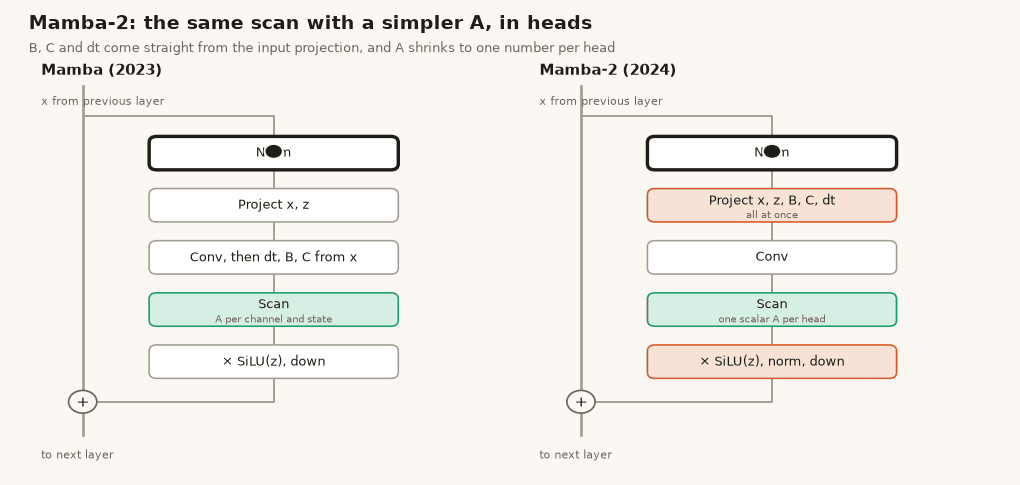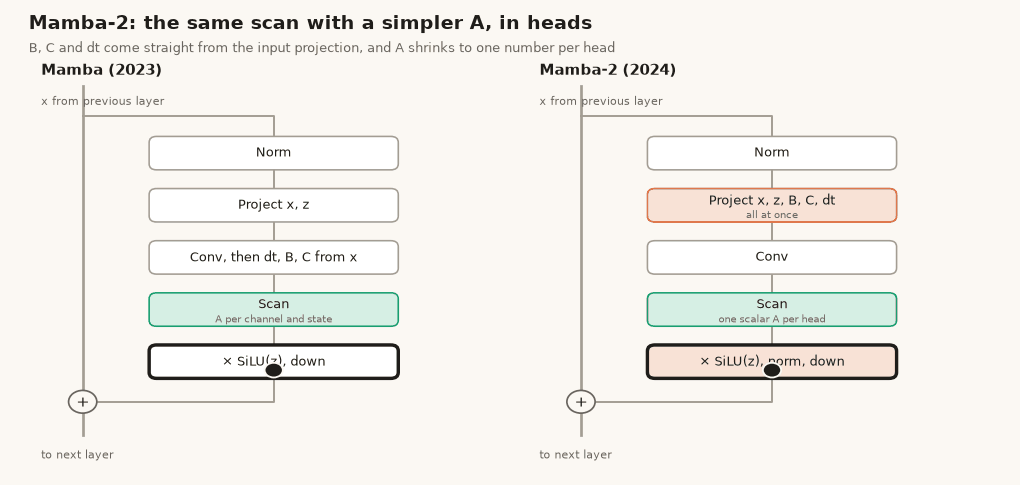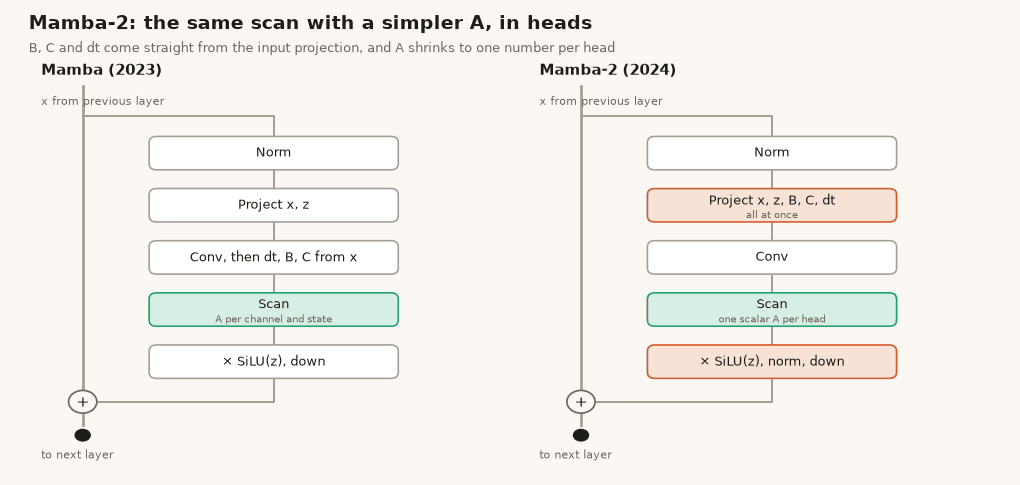
Mamba-2(Dao and Gu, 2024)는 블록을 세 군데 바꿉니다. B, C, dt를 합성곱 뒤의 x에서 계산하지 않고 입력 투영에서 바로 만듭니다. A를 채널마다 행렬로 두지 않고 헤드마다 숫자 하나로 두어, 스캔을 행렬 곱으로 계산할 수 있게 합니다. 그리고 "큰 모델에서 불안정이 생기기 쉬웠기 때문에" 출력 앞에 정규화를 넣습니다. 논문은 새 스캔이 Mamba의 스캔보다 2-8배 빠르고, 상태를 여덟 배 이상 키워도 느려지는 정도가 작다고 보고합니다.
Granite-4.0-H가 Mamba-2를 씁니다. 순수 Mamba와 달리 섞기 칸 뒤에 FFN이 있고, 두 번의 더하기 모두 0.246을 곱해 줄입니다. Granite는 앞 글에서 설명한 Mamba-2 함수로 확인했습니다.
h = rms_norm(x, sd[p + "input_layernorm.weight"], eps)
mix, _ = mamba2(sd, p, cfg, h)       # 어텐션 층 4개에서는 rope 호출 없는 어텐션
x2 = x + mix * cfg.residual_multiplier                                # 0.246
h2 = rms_norm(x2, sd[p + "post_attention_layernorm.weight"], eps)
g, u = (h2 @ sd[p + "shared_mlp.input_linear.weight"].T).chunk(2, -1)
out = x2 + (F.silu(g) * u) @ sd[p + "shared_mlp.output_linear.weight"].T * cfg.residual_multiplier
쌓는 방식
14. 하이브리드: 대부분 Mamba, 어텐션은 몇 층만
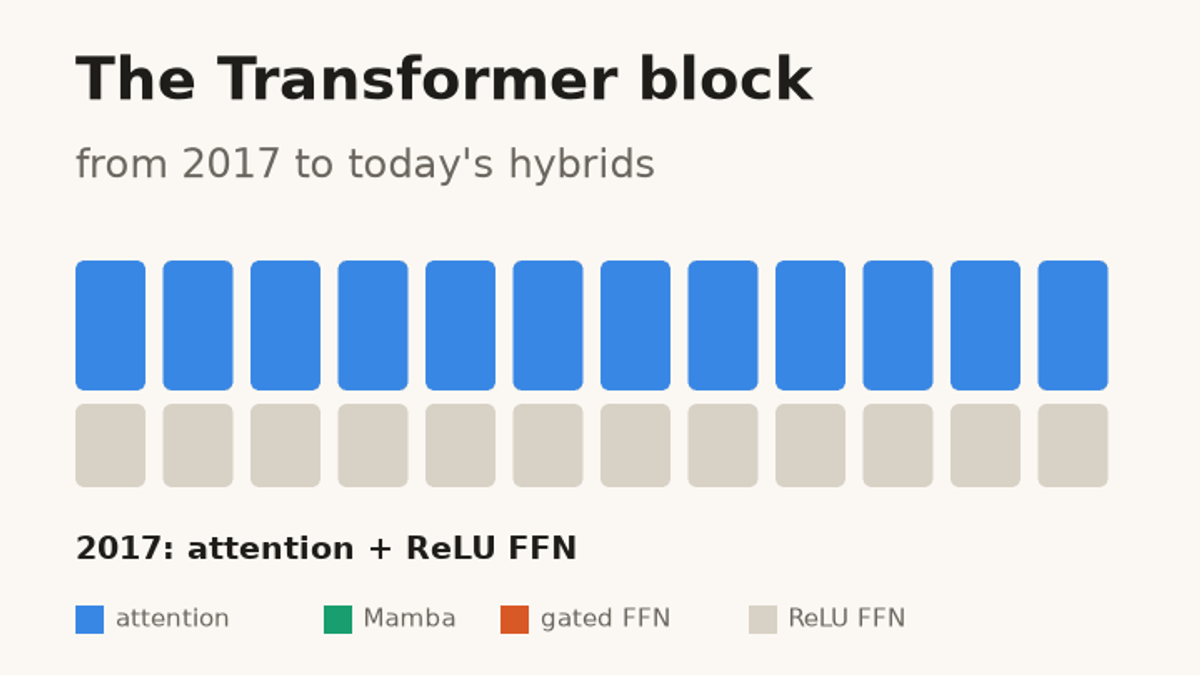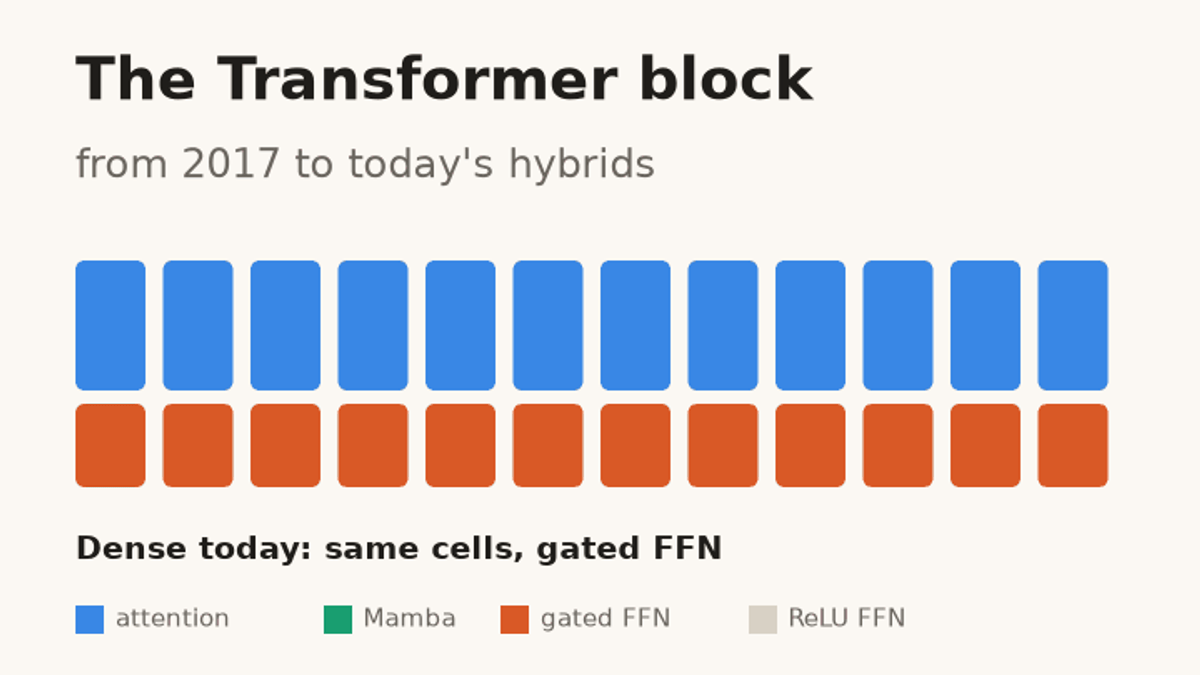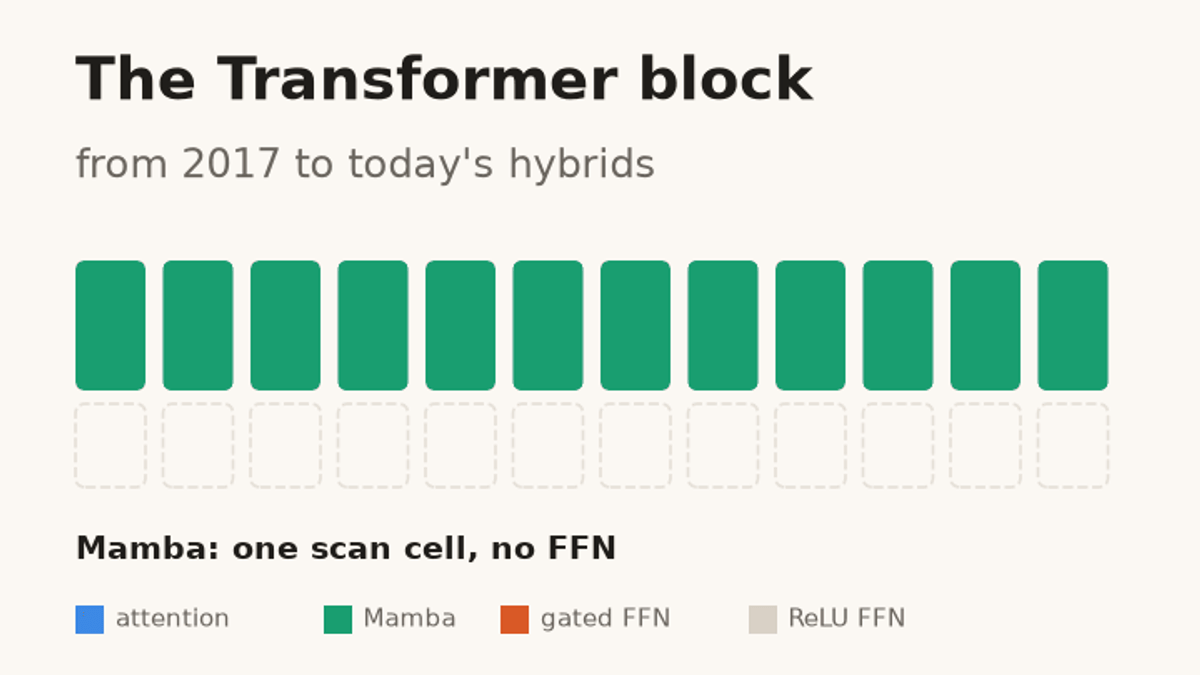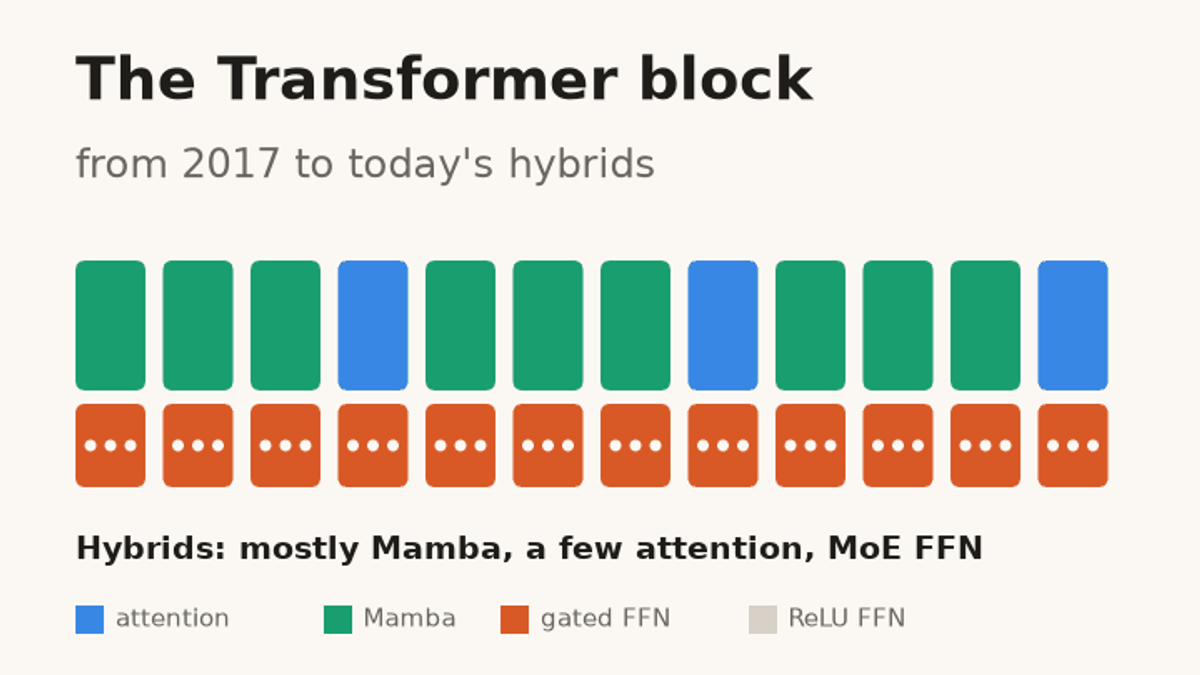
Mamba-2 논문이 직접 섞어 봤습니다. 매개변수 3억 5천만 개, 48층 모델에서 Pile 퍼플렉서티는 어텐션 층이 없을 때 8.60, 6개일 때 8.26, 트랜스포머는 8.68이었습니다(Table 2, 낮을수록 좋습니다). 저자들은 "전체 층의 약 10%를 어텐션으로 둘 때 가장 좋았다"고 적습니다. Jamba는 네 층에 하나와 여덟 층에 하나를 비교해 "성능 차이가 사실상 없다"는 결과를 얻었고, 여덟 층에 하나를 골랐습니다.
어느 층이 어떤 종류인지는 모델마다 설정 파일에 적혀 있어서, 설정 파일에서 바로 그렸습니다.
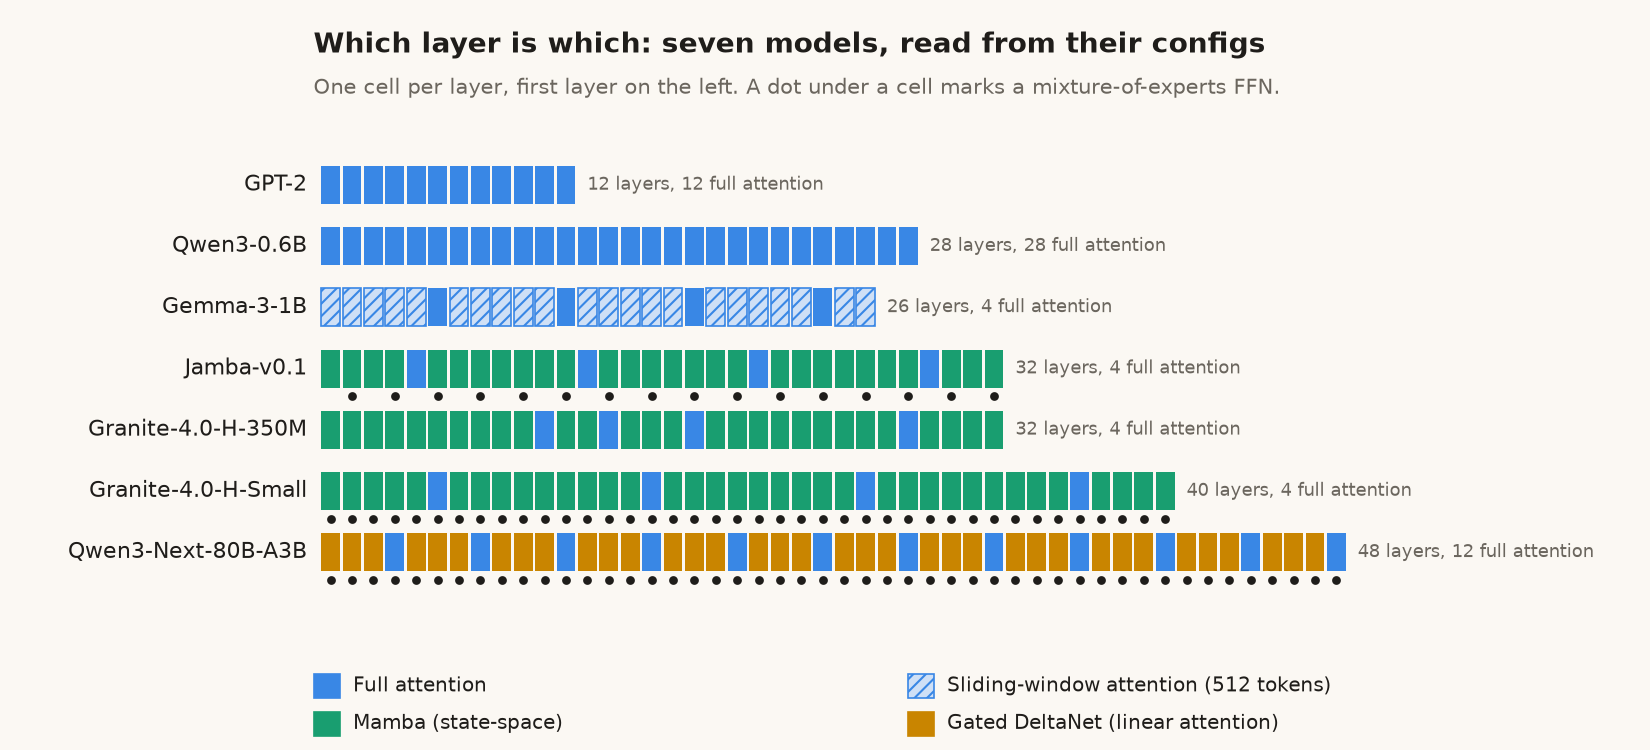
"하이브리드"라는 이름은 같아도 배치는 꽤 다릅니다. Jamba는 여덟 층마다 어텐션 하나를 규칙적으로 넣습니다. IBM은 Granite-4.0-H의 Micro, Tiny, Small을 Mamba-2와 어텐션을 "9:1 비율로" 섞었다고 설명합니다. 그런데 저희가 돌린 작은 350M 모델은 Mamba-2 28층에 어텐션 4층이고, 어텐션 층 간격도 고르지 않습니다. Qwen3-Next(모델 카드)는 Mamba를 아예 쓰지 않습니다. 네 층 중 세 층이 선형 어텐션의 한 형태인 Gated DeltaNet이고, 네 번째 층이 전체 어텐션입니다. 층마다 전문가가 512개 있고, 토큰마다 10개를 씁니다. Gemma 3는 이런 의미의 하이브리드는 아니지만 어텐션 안에서 같은 생각을 씁니다. 최근 512토큰만 보는 슬라이딩 윈도 층 다섯 개마다 전체 어텐션 층을 하나 둡니다.
얻는 것. 입력이 길어질 때 캐시가 커지는 층은 전체 어텐션 층뿐입니다. 저희는 설정 파일만 가지고 16비트 기준 시퀀스 하나의 캐시를 계산했습니다. 전체 어텐션 층마다 토큰당 2 × KV 헤드 수 × 헤드 크기 × 2바이트를 더하고, 슬라이딩 층은 512토큰까지만 같은 식으로 더하고, Mamba나 DeltaNet 층마다 고정 크기 상태를 더했습니다.
| 모델 | 입력에 따라 커지는 층 | 토큰당 | 고정분 | 4K 토큰 | 128K 토큰 |
|---|---|---|---|---|---|
| Qwen3-0.6B-Base | 28층 중 28층 | 112 KiB | 0 | 448 MiB | 14,336 MiB |
| Gemma-3-1B | 26층 중 4층(22층은 512토큰까지) | 4 KiB | 0 | 27 MiB | 523 MiB |
| Granite-4.0-H-350M | 32층 중 4층 | 4 KiB | 10.8 MiB | 27 MiB | 523 MiB |
| Jamba-v0.1 | 32층 중 4층 | 16 KiB | 8.3 MiB | 72 MiB | 2,056 MiB |
| Qwen3-Next-80B-A3B | 48층 중 12층 | 24 KiB | 37.7 MiB | 134 MiB | 3,110 MiB |
각 모델의 설정 파일에서 16비트 기준으로 계산한 값입니다. 모델 크기도 제각각이라 행끼리 비교하기보다 각 행을 그 모델의 어텐션 층 수와 같이 보시면 됩니다. 계산이 맞는지 확인할 수 있는 숫자가 하나 있습니다. 저희가 구한 Jamba-v0.1의 256K 토큰 캐시는 4,104 MiB이고, Jamba 논문 Table 1의 값은 4GB입니다.
치르는 것. 어텐션 층 몇 개는 남겨야 하고, 그 층들의 캐시는 여전히 커집니다. 앞 글에서 Granite의 어텐션 층 네 개를 꺼 봤습니다. 18토큰짜리 문장에서는(Alice가 13토큰 앞) 여전히 Alice라고 답했습니다(0.988). 같은 질문 사이에 상관없는 문단을 넣어 1,410토큰으로 늘리자 Alice의 확률이 0.002로 떨어졌고, 어텐션을 켠 원래 모델은 0.990을 유지했습니다. 저희 해석으로는 고정 크기 상태가 놓치는 정보를 몇 안 되는 어텐션 층이 맡습니다. 어텐션 층을 몇 개 남기고 어디에 둘지가 이 모델들이 서로 다르게 답하는 설계 문제입니다.
15. 한 층 안에서 섞기: Hymba
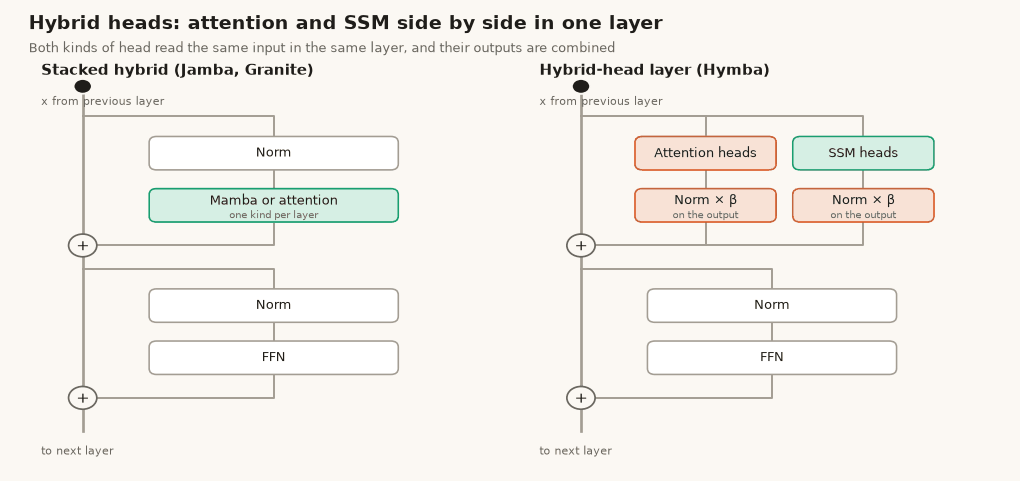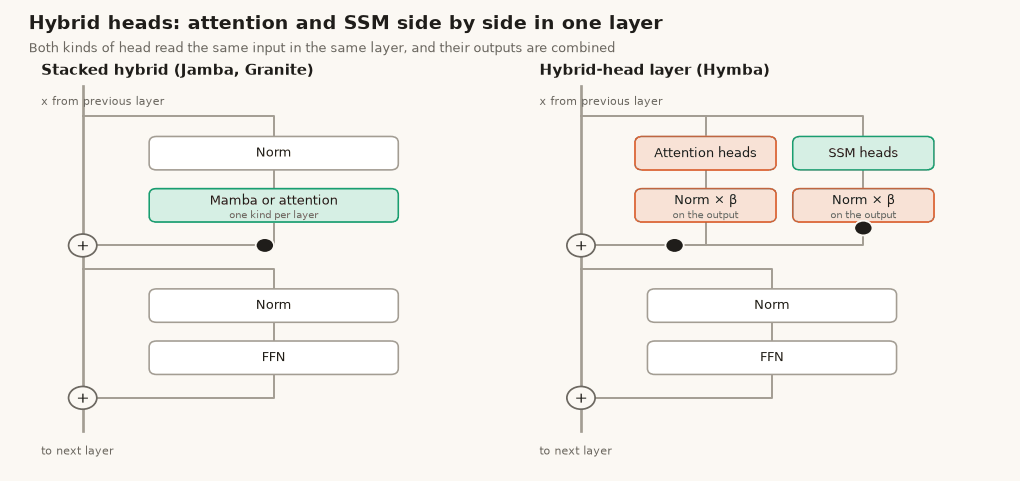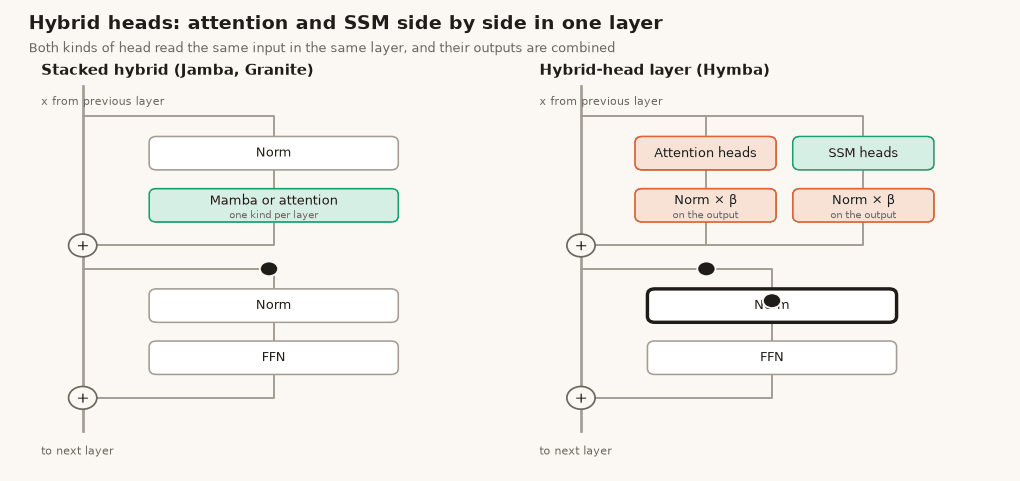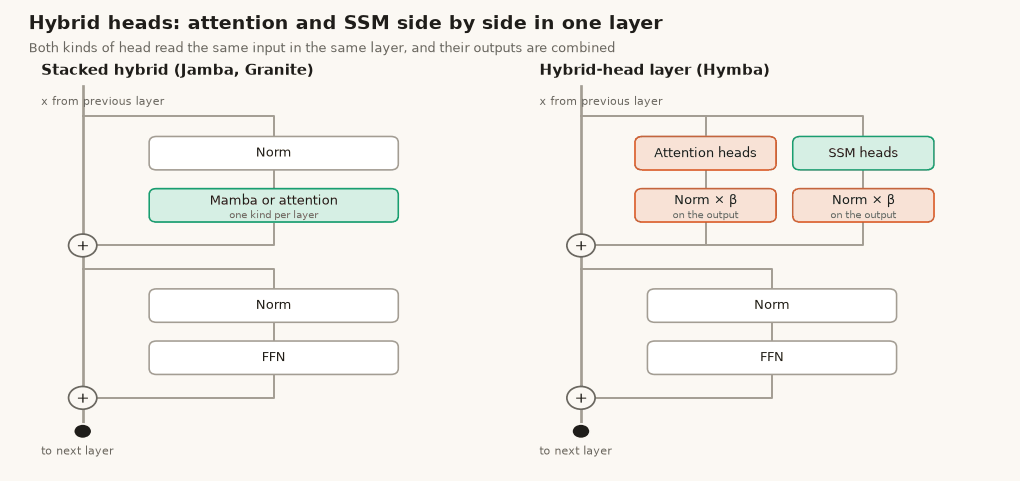
NVIDIA의 Hymba(Dong et al., 2024)는 어텐션 헤드와 상태 공간(SSM) 헤드를 한 층 안에 나란히 두고 같은 입력을 읽게 합니다. SSM 출력이 "어텐션 헤드 출력보다 늘 컸기" 때문에, 두 출력을 각각 정규화하고 배율을 맞춘 뒤 합칩니다. 매개변수 3억 개를 1,000억 토큰으로 학습한 비교(Table 1)에서, 같은 부품을 층마다 번갈아 쌓은 구조 대비 이 병렬 구조의 상식 추론 정확도는 44.07%에서 45.19%로, 기억 회상은 45.16%에서 49.90%로 올랐습니다. Hymba는 대부분의 층에 슬라이딩 윈도 어텐션을 쓰고 전체 어텐션은 세 층에만 둡니다.
15가지 변화 한눈에 보기
| # | 변화 | 무엇을 바꿨나 | 보고된 이득 | 대가·한계 |
|---|---|---|---|---|
| 1 | Post-LN 블록 | (2017년 원조) | 영어-독일어 BLEU 28.4 | 웜업이 필요함(Xiong 2020) |
| 2 | 디코더만 | 인코더 + 디코더 | 글 생성에 필요한 층만 남김(저희 요약) | 크로스 어텐션으로 읽을 원문 없음(저희 요약) |
| 3 | Pre-LN | Post-LN | 웜업 불필요, BERT 사전 학습 40% 단축 | 밝힌 것 없음. 깊어질수록 본 흐름이 커짐(저희 측정) |
| 4 | RMSNorm | LayerNorm | 스텝당 6.9% 빠름 | 따로 밝힌 것 없음 |
| 5 | 칸 앞뒤 정규화 | Pre-LN | "학습 안정" | 수치 없음 |
| 6 | QK 정규화 | 편향, 소프트 캡 | 80억 규모 로짓 폭주 방지(ViT-22B) | 언어 모델 수치 없음 |
| 7 | RoPE | 학습한 위치 행 | BLEU 27.5 대 27.3 | 잘 되는 이유는 설명 못 함 |
| 8 | NoPE | RoPE | 1억 700만 규모에서 긴 입력 일반화 | 큰 규모 미검증 |
| 9 | 병렬 블록 | 순차 블록 | 학습 약 15% 빠름 | 80억 규모에서 품질 조금 하락 |
| 10 | SwiGLU | ReLU·GELU FFN | 로그 퍼플렉서티 1.636 대 1.677 | 따로 밝힌 것 없음 |
| 11 | MoE FFN | FFN 하나 | 사전 학습 최대 7배 빠름 | 메모리는 전문가 전체만큼 |
| 12 | Mamba | 어텐션 + FFN | 추론 처리량 4-5배 | 예시 형식 따르기가 약함 |
| 13 | Mamba-2 | Mamba 스캔 | 스캔 2-8배 빠름 | 회상은 여전히 상태 크기에 묶임 |
| 14 | 하이브리드 쌓기 | 전부 어텐션 또는 전부 Mamba | 3억 5천만 규모 퍼플렉서티 8.26 대 8.60 | 일부 층은 여전히 캐시가 커짐(저희 계산) |
| 15 | 한 층 안 하이브리드 | 층 단위 하이브리드 | 3억 규모 상식 추론 45.19 대 44.07 | 밝힌 것 없음. 층마다 부품이 늘어남(저희 해석) |
이득 칸과, "저희"라고 표시하지 않은 대가 칸은 모두 각 논문이 자기 설정에서 낸 내용입니다. 저희가 직접 돌린 것은 코드입니다. 코드는 모두 재현 묶음에 있고, 블록 함수마다 해당 모델의 층을 반올림 오차 안에서 재현합니다.
칸 하나를 직접 바꿔 보기
글 아래 재현 묶음의 verify.py는 일곱 모델을 Hugging Face에서 받아 층마다 들어간 값과 나온 값을 기록하고, blocks.py의 블록 함수와 비교합니다. CPU만으로 돌아갑니다. 블록 함수에서 한 줄을 바꿔 보는 것이 가장 쉬운 시작입니다. 예를 들어 GPT-2의 pre_ln_block에서 정규화를 더하기 뒤로 옮기면 Post-LN 블록이 되고, 실제 층 출력과의 차이가 얼마나 벌어지는지 바로 보입니다. 같은 방식으로 qwen3_block에서 RoPE를 빼 볼 수도 있습니다.
새 글이 올라올 때 받아 보시려면 아래 뉴스레터 폼에서 구독하실 수 있습니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
block-variants-repro.zip · 33 KB