この記事は、英語の原文を AI(Claude)で翻訳したものです。数値と内容は英語の原文を基準とします。 英語の原文を読む
llama.cpp の KVキャッシュ量子化: -ctk と -ctv はどれを使うべきか、最新ビルドで測定
そのまま使える -ctk/-ctv (--cache-type-k/-v) の設定、指定できる型、ビルドオプション GGML_CUDA_FA_QUANTS をまとめました。測定では、q8_0 は 64K で 4.2 GiB を節約し、デコード速度は f16 の 56% でした。
結論から言うと。KVキャッシュが VRAM に収まるなら、既定の f16 のままにしてください。収まらないなら -ctk q8_0 -ctv q8_0 を使います。2つのフラグには同じ値を指定し、メモリの節約がタダだとは考えないでください。コンテキストが 64K トークンのとき、量子化したキャッシュのデコード速度は f16 のおよそ半分です。
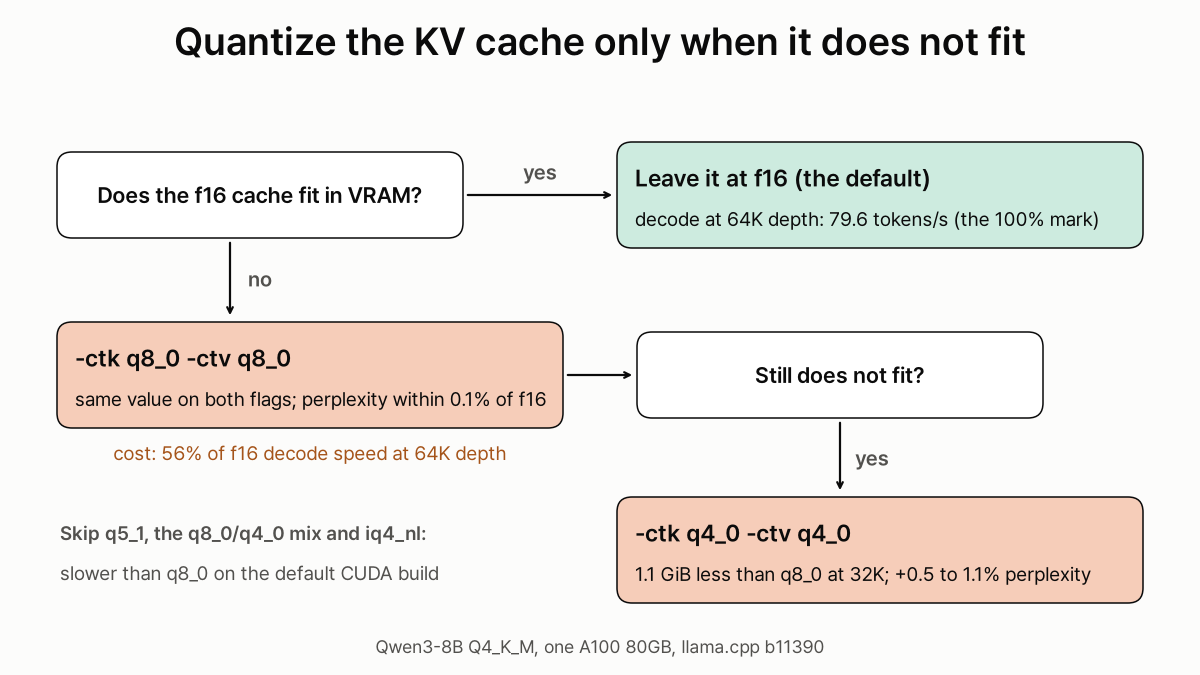
このページは、このブログの測定記事3本の要約版で、2026年10月4日の llama.cpp ビルドで測り直したものです。測り直したのには意味がありました。9月9日にマージされた変更で、あまり使われない型の挙動が変わり、9月に公開した内容の一部は現在のビルドでは当てはまらなくなっています。以下の数値のうち古いビルドによるものは、その旨を明記しています。
コマンド
# server, chat, CLI: the same two flags
llama-server -m model.gguf -ngl 99 -fa on -ctk q8_0 -ctv q8_0 -c 32768

# compare types on your own card before you commit to one, one type per run
for t in f16 q8_0 q4_0; do
  llama-bench -m model.gguf -ngl 99 -fa on -ctk $t -ctv $t -p 4096 -n 128 -d 0 -d 32768
done
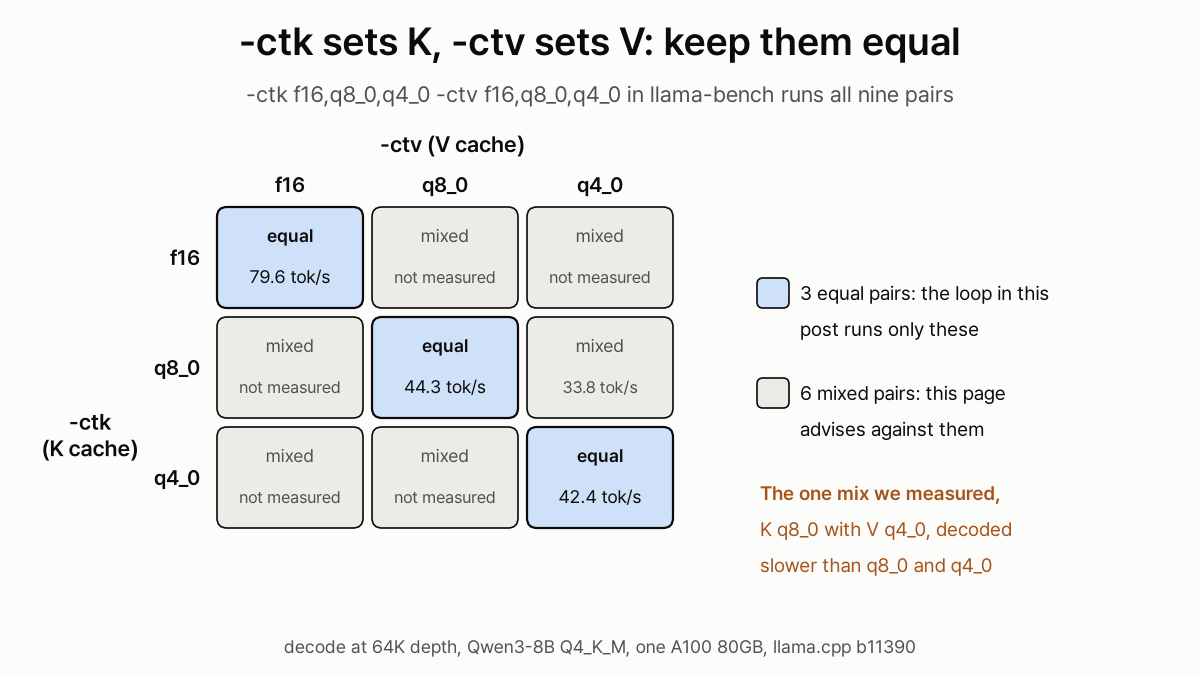
-ctk と -ctv は --cache-type-k と --cache-type-v の短縮形です。-fa on は外さないでください。llama.cpp では、量子化した V キャッシュにはフラッシュアテンションが必要です。llama-bench はカンマ区切りのリストも受け付けますが、-ctk f16,q8_0,q4_0 -ctv f16,q8_0,q4_0 は K/V の組み合わせ9通りをすべて実行し、そのうち6通りはこのページで勧めていない混在ペアです。上のループは K と V を同じ値に保ちます。
| K キャッシュ | V キャッシュ | |
|---|---|---|
| 短いフラグ | -ctk | -ctv |
| 長いフラグ | --cache-type-k | --cache-type-v |
| 環境変数 | LLAMA_ARG_CACHE_TYPE_K | LLAMA_ARG_CACHE_TYPE_V |
どちらにも指定できる値: f32、f16、bf16、q8_0、q4_0、q4_1、iq4_nl、q5_0、q5_1。既定値は f16 です。それ以外を指定すると Unsupported cache type で止まります。
既定の -fa auto では、V キャッシュが量子化されていると llama.cpp が自動でフラッシュアテンションを有効にし、enabling flash_attn since it is required for quantized V cache とログに出します。-fa off では起動を拒否します。
error: invalid argument: --ctk が出たら、短いフラグにハイフンを2つ付けています。--ctk というフラグはありません。-ctk q8_0 か、長い形の --cache-type-k q8_0 を使ってください。
ゼロから始める場合は、ハウツー連載の第1回で、空のフォルダから CUDA ビルドを作り、最初の回答を得るまでを扱っています。そのビルドでは llama というプログラムが1つできるので、ここでの llama-server と llama-bench は llama serve と llama bench になります。どちらも同じ -ctk と -ctv フラグを持っています。
設定ごとのコスト
Qwen3-8B Q4_K_M、A100 80GB 1枚。速度は 10月4日のビルド (b11390 (dd26678)、CUDA オプションは既定値) での毎秒トークン数です。メモリは 32K トークン時のキャッシュ単体の大きさで、型のビット数から計算しました。パープレキシティは 9月のビルド (b10753 (69320fe)) のものです。キャッシュの形式は型で決まるのでカーネルが変わっても動かないはずですが、測り直してはいません。
-ctk / -ctv | 32K でのキャッシュ | f16 比のパープレキシティ (4K–32K) | プリフィル 4096 | 深さ 64K でのデコード |
|---|---|---|---|---|
| f16 / f16 | 4.50 GiB | — | 4,704 | 79.6 (100%) |
| q8_0 / q8_0 | 2.39 GiB | −0.0% から +0.1% | 4,584 | 44.3 (56%) |
| q4_0 / q4_0 | 1.27 GiB | +0.5% から +1.1% | 4,599 | 42.4 (53%) |
| bf16 / bf16 | 4.50 GiB | 未測定 | 4,672 | 41.3 (52%) |
| q5_1 / q5_1 | 1.69 GiB | 未測定 | 4,583 | 27.8 (35%) |
| q8_0 / q4_0 | 1.83 GiB | 未測定 | 4,582 | 33.8 (42%) |
| iq4_nl / iq4_nl | 1.27 GiB | 未測定 | 104 | 未測定 |
たいていの構成は、この表の3つの点で決まります。
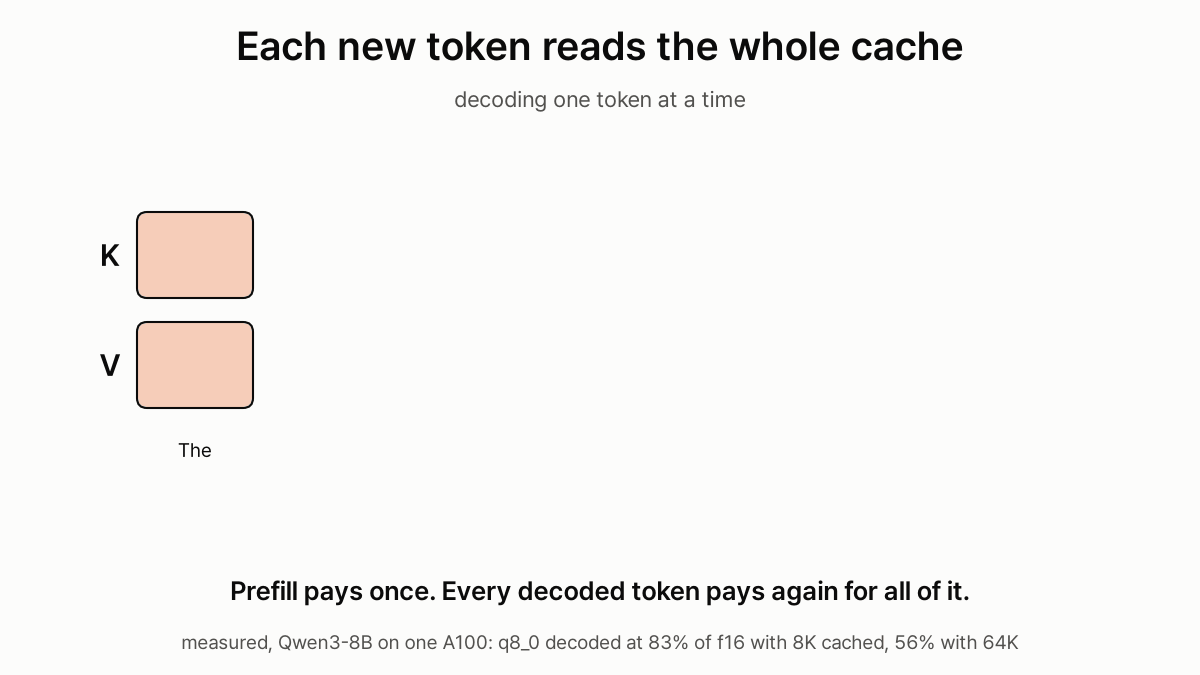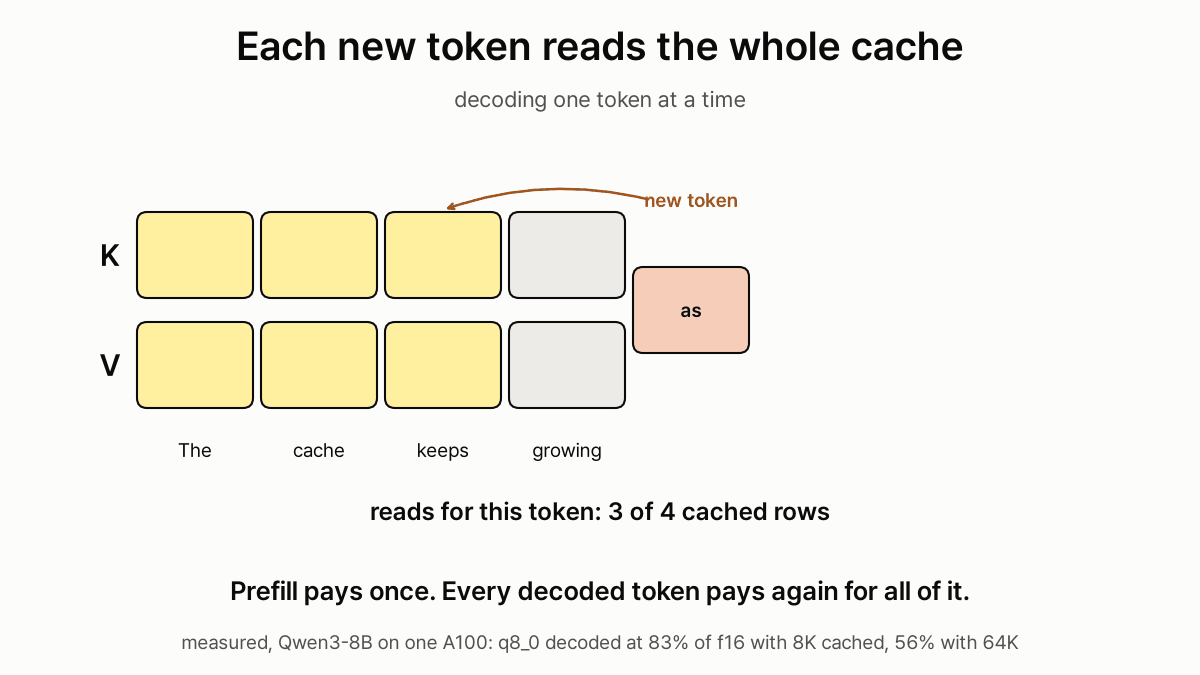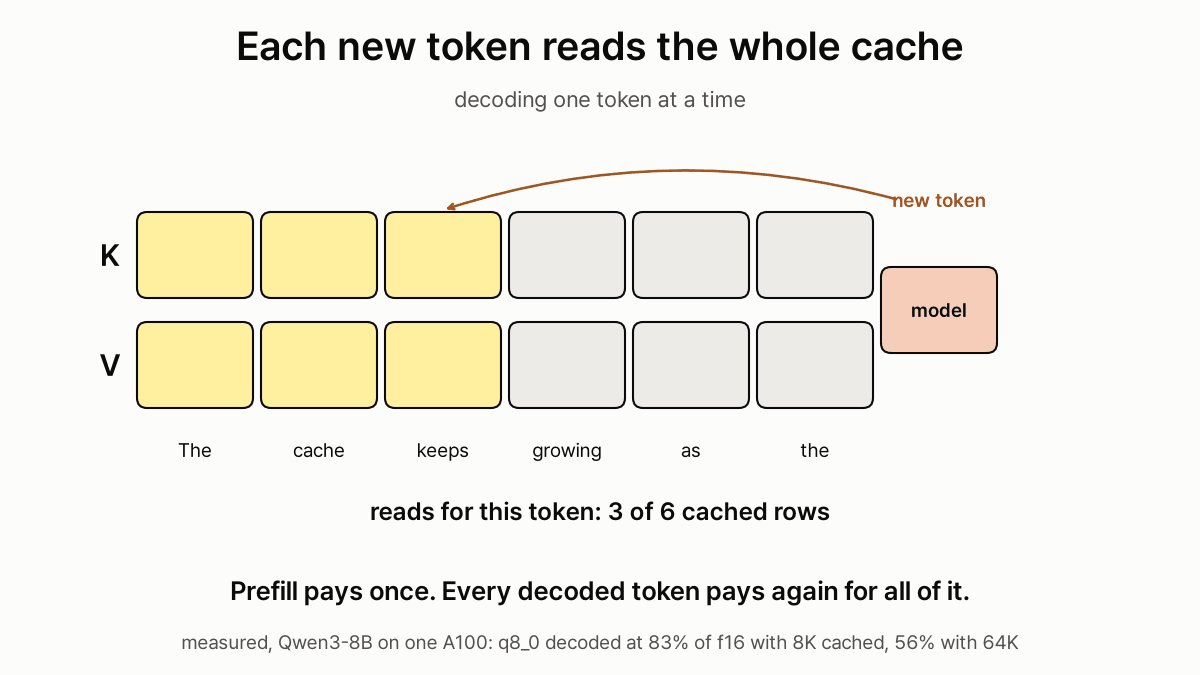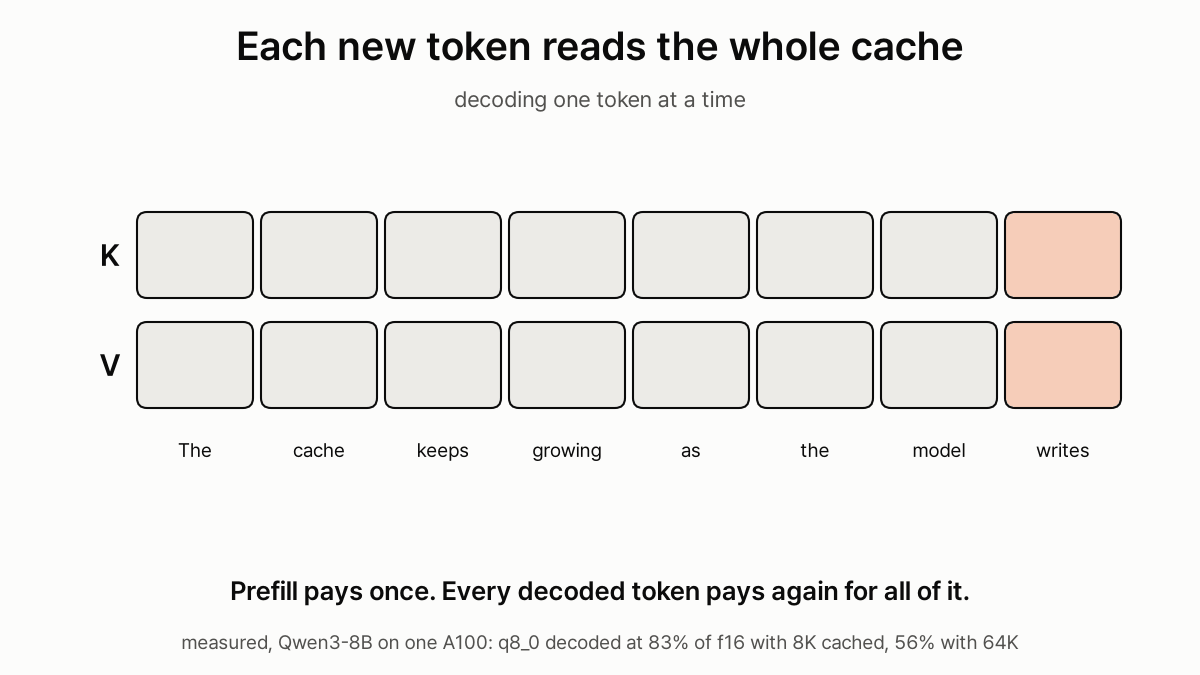
プリフィルはほとんど変わらず、深いところでのデコードが変わります。動作する型はどれも、プリフィルが f16 との差 3% 以内に収まります。コストが表れるのはキャッシュがすでに長くなっているときで、新しいトークンのたびにキャッシュ全体を読むからです。キャッシュに 8K トークンあるとき q8_0 のデコード速度は f16 の 83%、64K では 56% でした。節約したメモリは、まさにメモリが必要だったコンテキスト長で、時間として払い戻すことになります。
q8_0 と q4_0 のデコード速度はほぼ同じで、8K、32K、64K のいずれでも差は 5% 以内です。この2つの間の選択は、メモリと品質のどちらを取るかです。このモデルでは q4_0 のほうが 32K で約 1.1 GiB 少なく済み、パープレキシティが約 1% 悪くなります。q4_0 を選ぶのは、その1ギガバイトでモデルが載るかどうかが決まるときだけにしてください。
q4_0 でモデルを予算内に収めた例と、その構成にコーディングの課題を与えたときの結果は、Qwen3.8 27B を 8GB に無理やり載せた記事と動画をご覧ください。
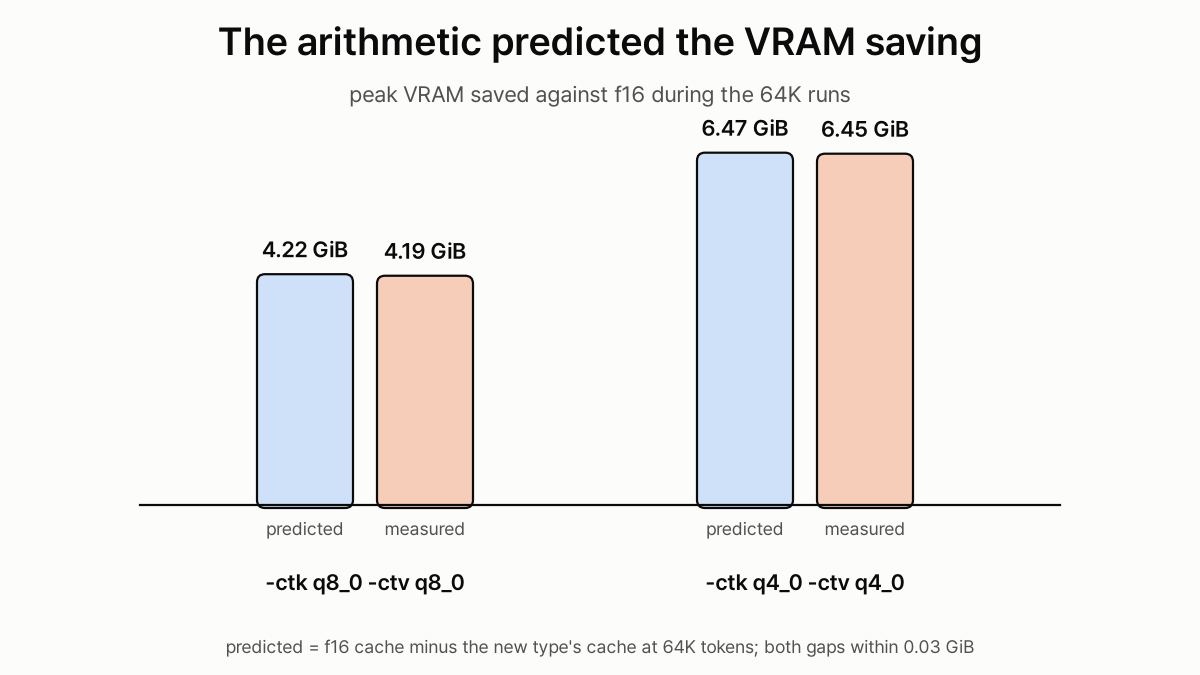
メモリの節約は本物です。64K の実行中の VRAM ピークは、q8_0 で 4.19 GiB、q4_0 で 6.45 GiB 下がりました。計算上の予測は 4.22 と 6.47 なので、実測ピークと予測の差は 0.03 GiB 以内でした。
動くけれど選ぶべきでない型
9月のビルドでは、これらの型のうち4つと、K/V を混在させたすべてのペアが、プリフィルで毎秒 83 から 284 トークンしか出ませんでした (通常は約 4,600)。既定の CUDA ビルドが、それらのフラッシュアテンション用カーネルをコンパイルしていなかったためです。当時の記事では、これを「2つのフラグには同じ値を指定し、使う型は4つだけにする」とまとめました。
現在のビルドでは、ほとんどの型でこの急な落ち込みはなくなっています。9月9日にマージされた変更 (llama.cpp #28079) は2つのことをしました。q4_1、q5_0、q5_1 をフラッシュアテンションの対応型にしたこと。そして、ある K/V ペアのデコード用カーネルがコンパイルされていない場合に、別の経路へ落ちるのではなく、K と V をその場で f16 に変換するようにしたことです。そのとき llama-server は次の1行を出力します。
ggml_cuda_flash_attn_ext_vec: no FlashAttention vector kernel compiled for K/V types q5_1-q5_1, converting K and V to f16 instead (slow). Add "q5_1-q5_1" to GGML_CUDA_FA_QUANTS to compile it.llama-bench は既定でライブラリのログを出さないので、-v を付けないとこの行は表示されません。
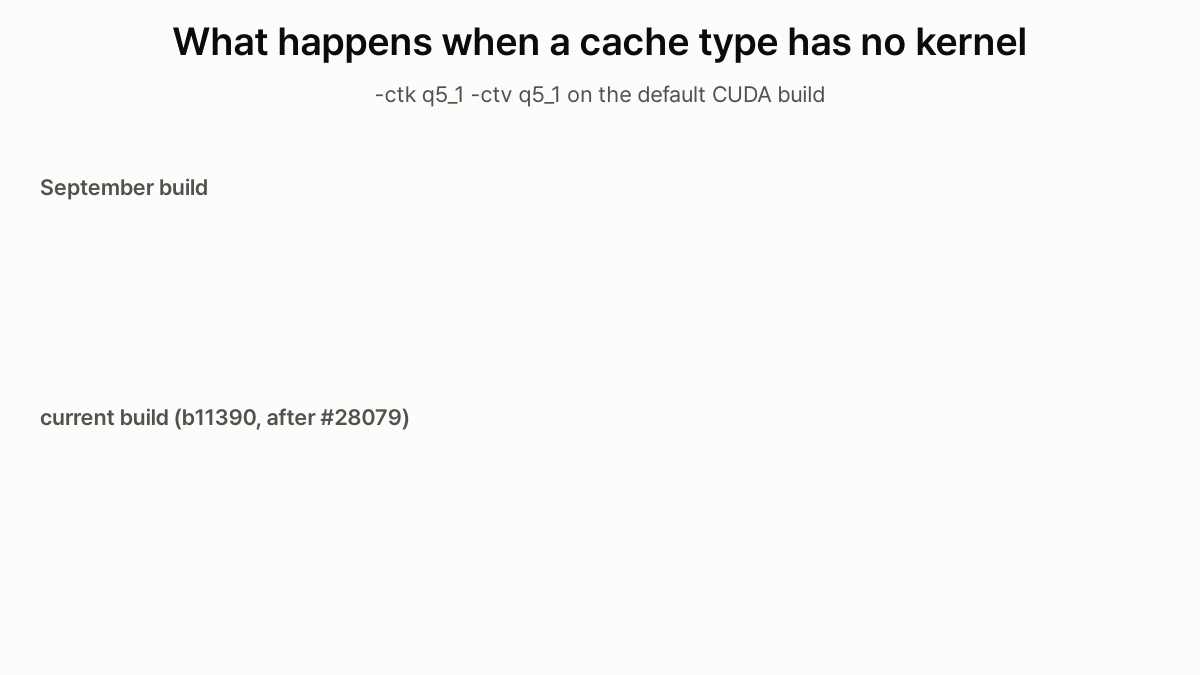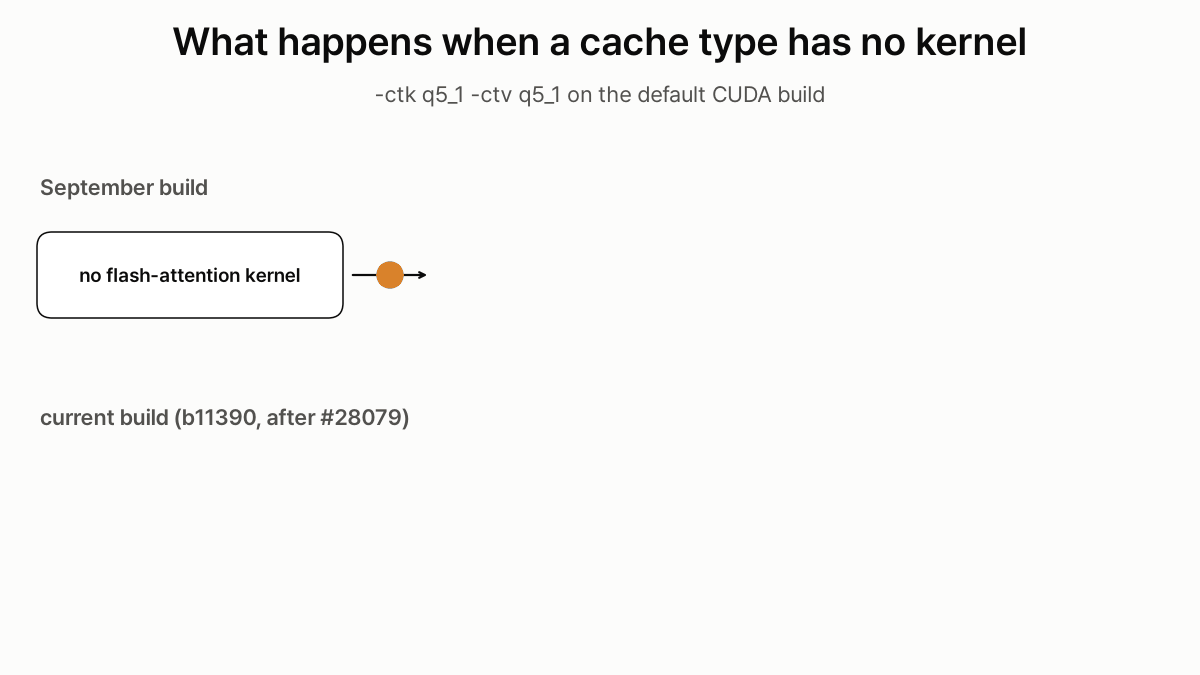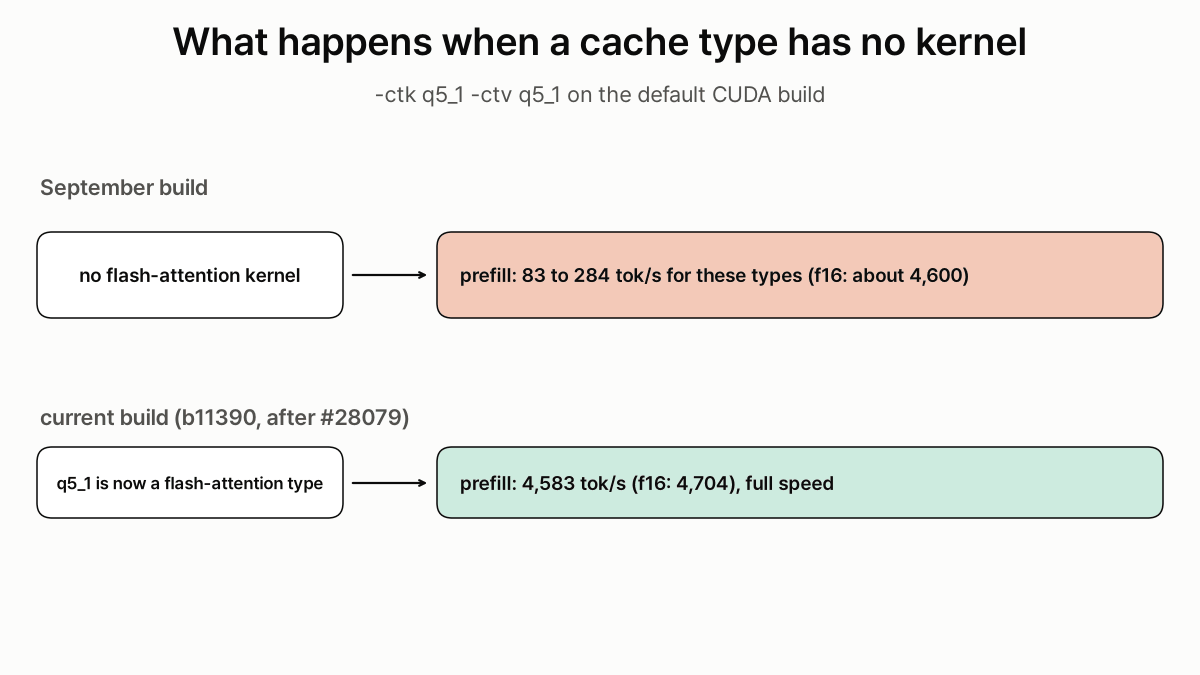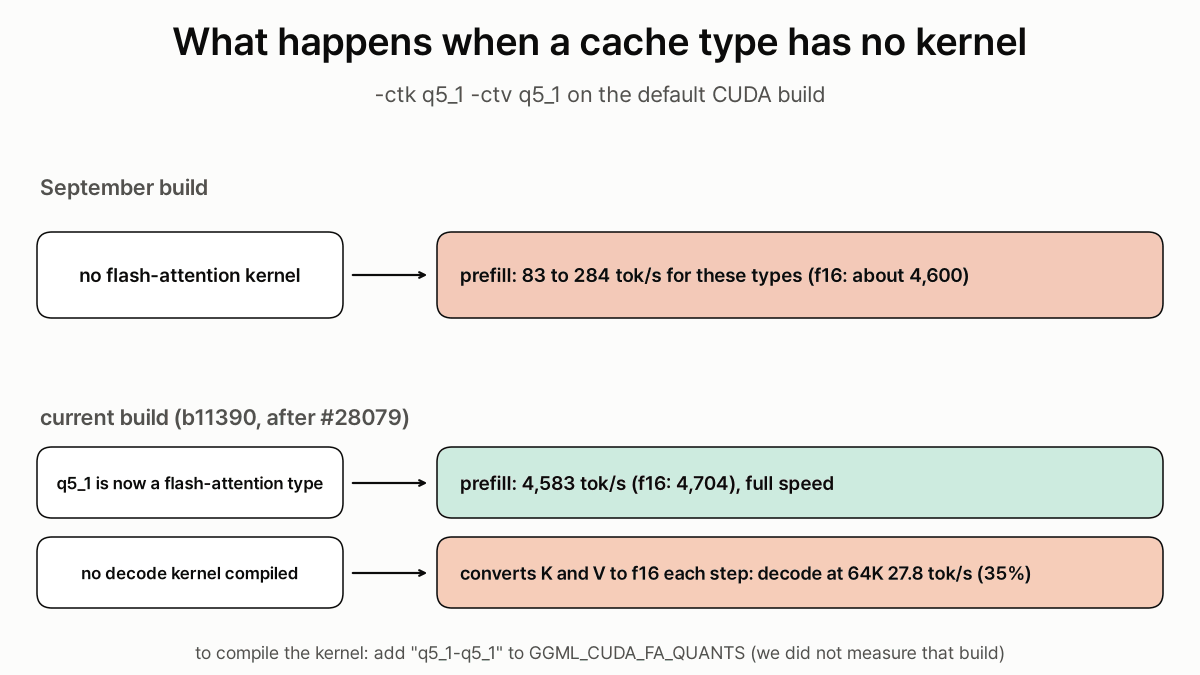
つまり q5_1 と q8_0 / q4_0 の組み合わせは、いまではフルスピードでプリフィルでき、llama-server への短いテストリクエスト1件にはどれも普通に回答しました。品質は測定していません。それでも既定のビルドでは割に合いません。q5_1 のデコード速度は 64K で f16 の 35% と q4_0 より遅く、しかもメモリは q4_0 より多く使います。組み合わせのほうは速度がその中間で、節約量は q4_0 より少なくなります。もう1つの落とし穴が bf16 です。メモリは f16 とまったく同じだけ使い、64K でのデコード速度はその 52% なので、このカードでは得るものがありません。
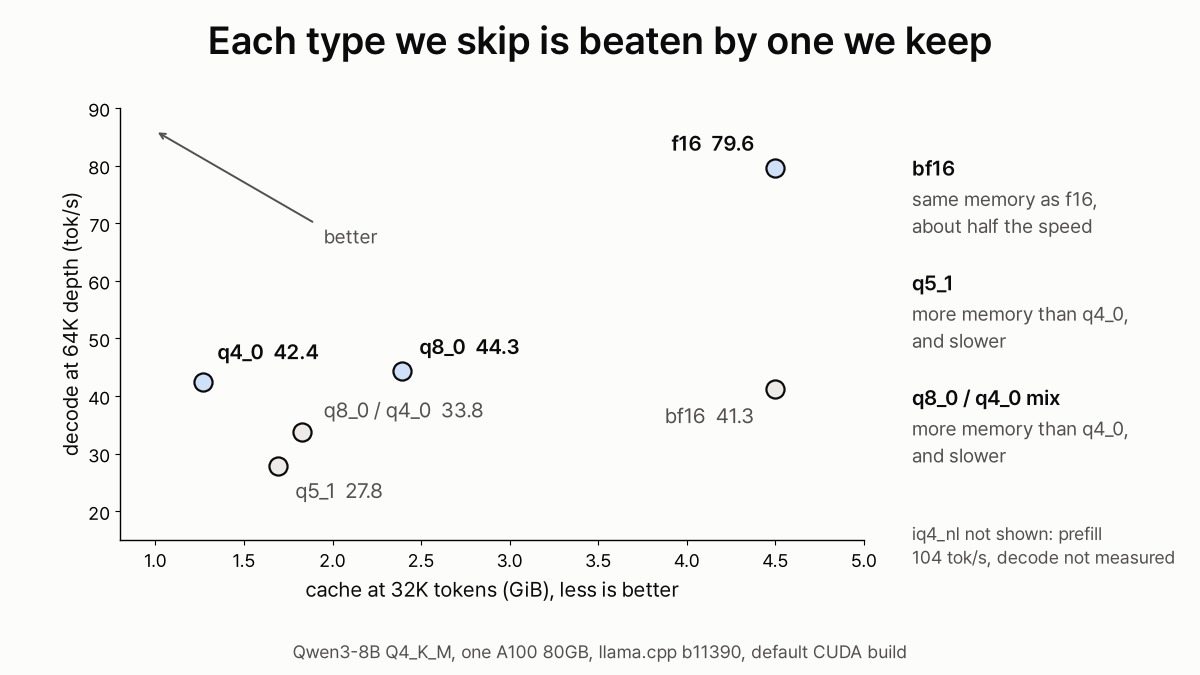
いまでも使えない型は iq4_nl だけです。-ctk と -ctv はこの型を受け付けますが、GGML_CUDA_FA_QUANTS で指定できる型ではないため、どのビルドでも CUDA のフラッシュアテンション用カーネルをコンパイルできません。プリフィルは毎秒 104 トークンでした。
その後、ビルド b12274 で新しい型 f8_e4m3 が追加されました。同じ A100 で、キャッシュは q8_0 より 6% 小さくなりましたが、出力が f16 から離れる幅は q8_0 の約 8 から 10 倍で、32K でのデコードは 12-13% 遅くなりました。結果の全体は llama.cpp の新しい FP8 KVキャッシュと q8_0 の比較にあります。
ビルドオプション: GGML_CUDA_FA_QUANTS (GGML_CUDA_FA_ALL_QUANTS の後継)
q5_1 や混在ペアを使いたい理由があるなら、そのデコード用カーネルを組み込んでビルドしてください。既定のリストに q5_1 を加えたビルドコマンドは次のとおりです。
cmake -B build -DGGML_CUDA=ON -DGGML_CUDA_FA_QUANTS="q4_0-q4_0;q8_0-q8_0;f16-f16;bf16-bf16;q5_1-q5_1"
cmake --build build --config Release -j
-DGGML_CUDA_FA_QUANTS=all ではすべてのペアをコンパイルしますが、そのぶんビルドがかなり長くなります。古いオプション GGML_CUDA_FA_ALL_QUANTS は、いまでは all の非推奨の別名です。リストに指定できる型: f16、bf16、q4_0、q4_1、q5_0、q5_1、q8_0。追加のカーネルを入れたビルドは、現在のコミットでは測定していません。
サーバーでは出力の長さがコストを決める
単一ストリームのデコードは最悪のケースです。9月のビルドで行ったllama-server の測定では、32K のプロンプトに対して、各リクエストの出力が 128 トークンのとき q8_0 はスループット全体の 9% を、1,024 トークンのときは 22% を失いました。短い回答のリクエストでは時間の大半がプリフィルで、量子化はプリフィルにほとんど影響しません。プロンプトに比べて回答が長いなら、自分の比率で測ってください。
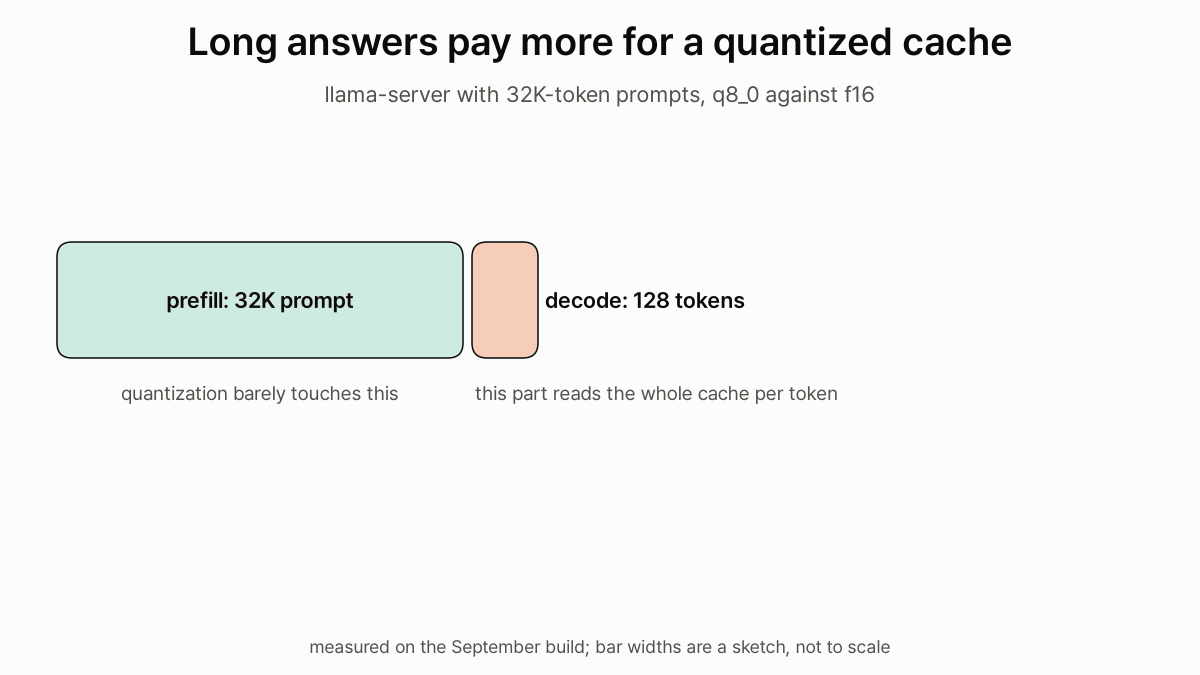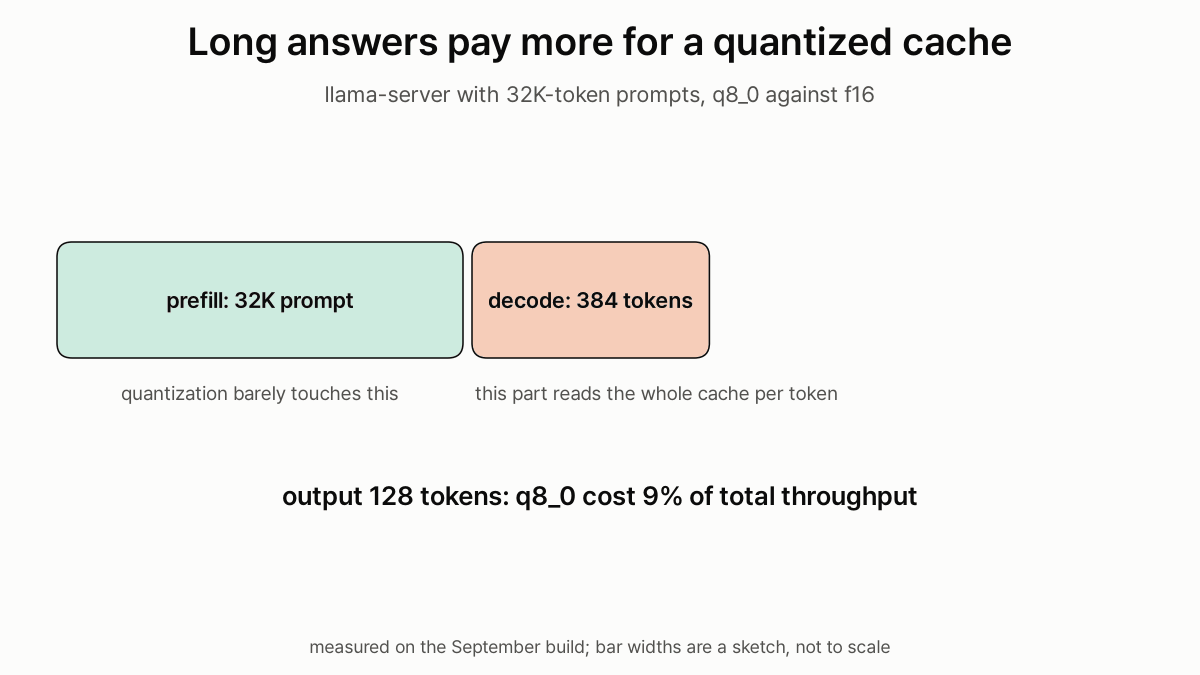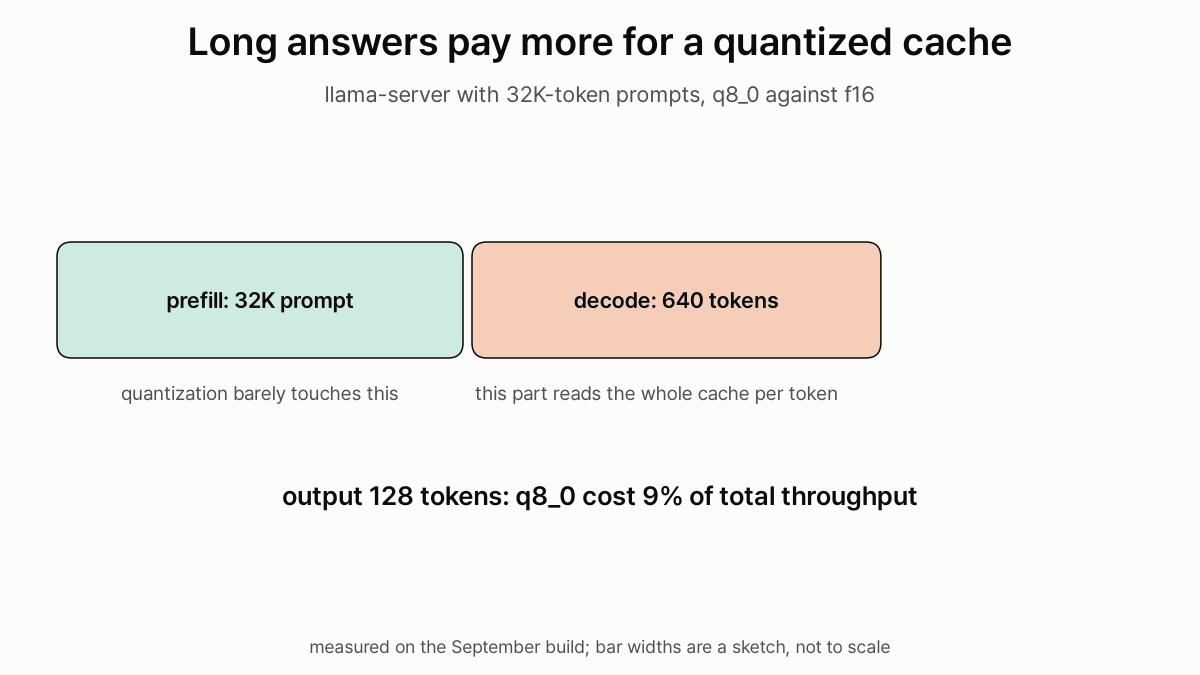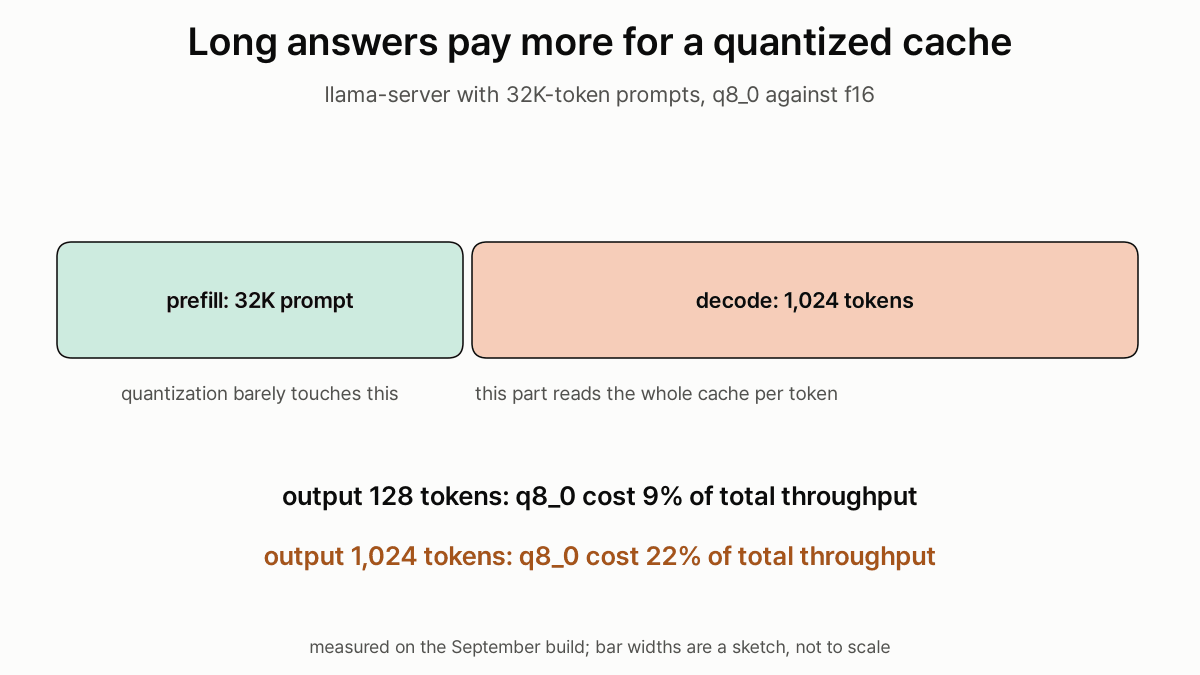
自分のカードで出た数値を信じる前に
- GPU にほかのプロセスが載っていないか確認してください。
nvidia-smi --query-compute-apps=pid,used_memory --format=csv。9月の最初の一斉測定では、止めたつもりの実行がまだカードを共有していたため、f16のプリフィルが 4,707 ではなく毎秒 1,976 トークンと出ました。 - 実際に使う深さで測ってください。キャッシュが空のときは、動作する型はどれも同じに見えます。llama-bench に
-d 32768(または実際のコンテキスト長) を加えてください。 - 速度だけでなくログも見てください。ペアがコンパイル済みのカーネルから外れたことを示すのは、
converting K and V to f16の行だけです。
自分のモデルでキャッシュはどれくらいの大きさになるか
トークン1つあたり、キャッシュが持つのは レイヤー数 × KV ヘッド数 × ヘッド次元 × 2 (K と V) × 値1つあたりのバイト数 です。Qwen3-8B は 36 レイヤーで、次元 128 の KV ヘッドが 8 個あるので、f16 ではトークンあたり 144 KiB、32K では 4.5 GiB になります。q8_0 は値1つを 8.5 ビット、q4_0 は 4.5 ビットで保存します。KV ヘッドが多いモデルほどキャッシュはそれに比例して大きくなり、深いところでの速度低下もおそらく大きくなりますが、測定したのはこの1モデルだけです。一般的な式とほかのモデル用のスクリプトはKV Cache Explainedにあります。
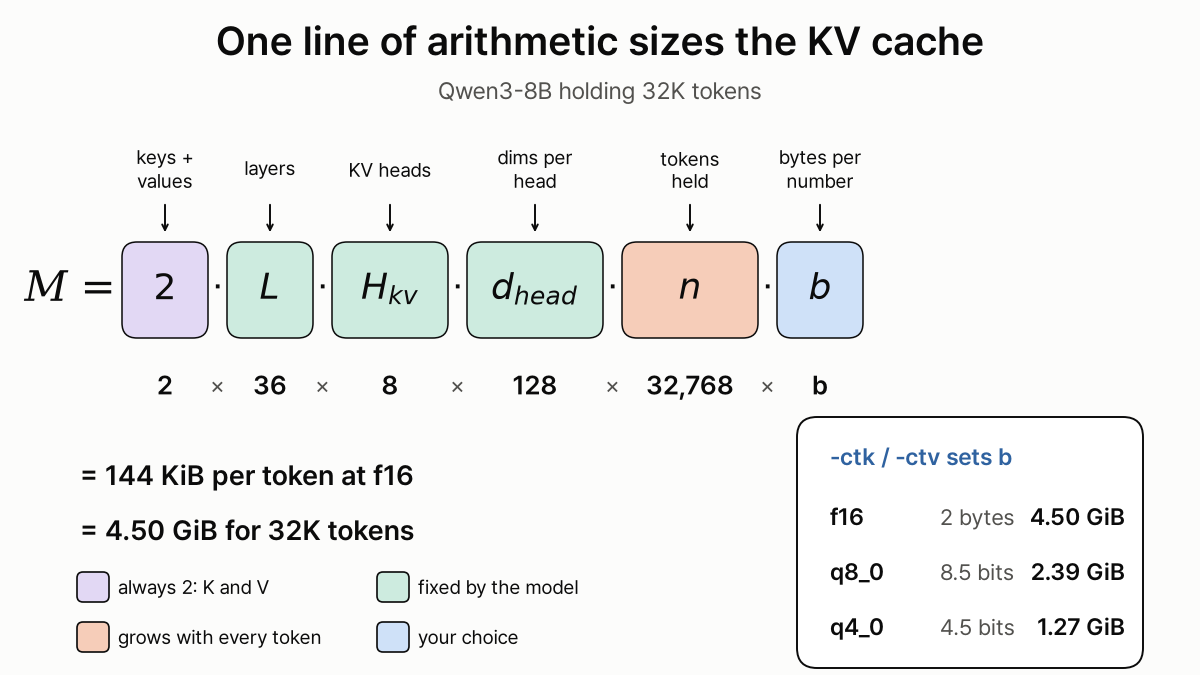
この式は、すべてのレイヤーが KV ヘッドごとに K と V を完全に持つことを前提にしています。新しいモデルはさまざまな形でこの前提を崩しており、その後そのうち6つを測定しました: Four Times the Context, Less Memory。
この結果からわからないこと
モデルは1つ、重みの量子化も1種類、A100 は1枚で、速度の表はバッチサイズ1です。パープレキシティとサーバーの数値は現在のビルドではなく 9月のビルドのものです。64K のデコードの数値はそれぞれ1回の実行です。llama.cpp は毎週変わり、9月9日の変更は、このような表が1か月で古くなりうることを示しています。いつの数値かわかるよう、日付とコミットを下の注記に記しています。
このページのもとになった3本の記事に、表の全体があります: 単一ストリームの速度・メモリ・パープレキシティ、同時負荷をかけた llama-server、9月のビルドでのすべての -ctk 値。一斉測定のスクリプトは無料のKVキャッシュ ベンチマークハーネスに入っています。
現在のビルドでの測定: llama.cpp b11390 (dd26678) (ggml-org master、2026年10月4日)、sm80 向けの CUDA ビルドで既定のオプション (GGML_CUDA_FA_QUANTS=q4_0-q4_0;q8_0-q8_0;f16-f16;bf16-bf16)、Qwen3-8B Q4_K_M、A100 80GB PCIe 1枚、-fa on -ngl 99。プリフィル: -p 4096 -n 128 -d 0 -d 8192 -r 2。深さ: -p 0 -n 128 -d 32768 -d 65536 -r 1、VRAM は nvidia-smi で 0.5 秒ごとに取得。警告行は -c 8192 を付けた llama-server と短いリクエスト1件で確認。スクリプトは scripts/bench-kv-types-master.sh と scripts/bench-kv-depth-master.sh、生の JSON とログは drafts/llamacpp-kv-guide/ にあります。パープレキシティとサーバーの数値: llama.cpp b10753 (69320fe) (2026年9月2日)、同じカードとモデルで、上でリンクした記事によるものです。