눈으로 못 가리는 가짜 주소는 결정 모델이 다 잡았습니다. 놓친 건 scotlabank.com이었습니다
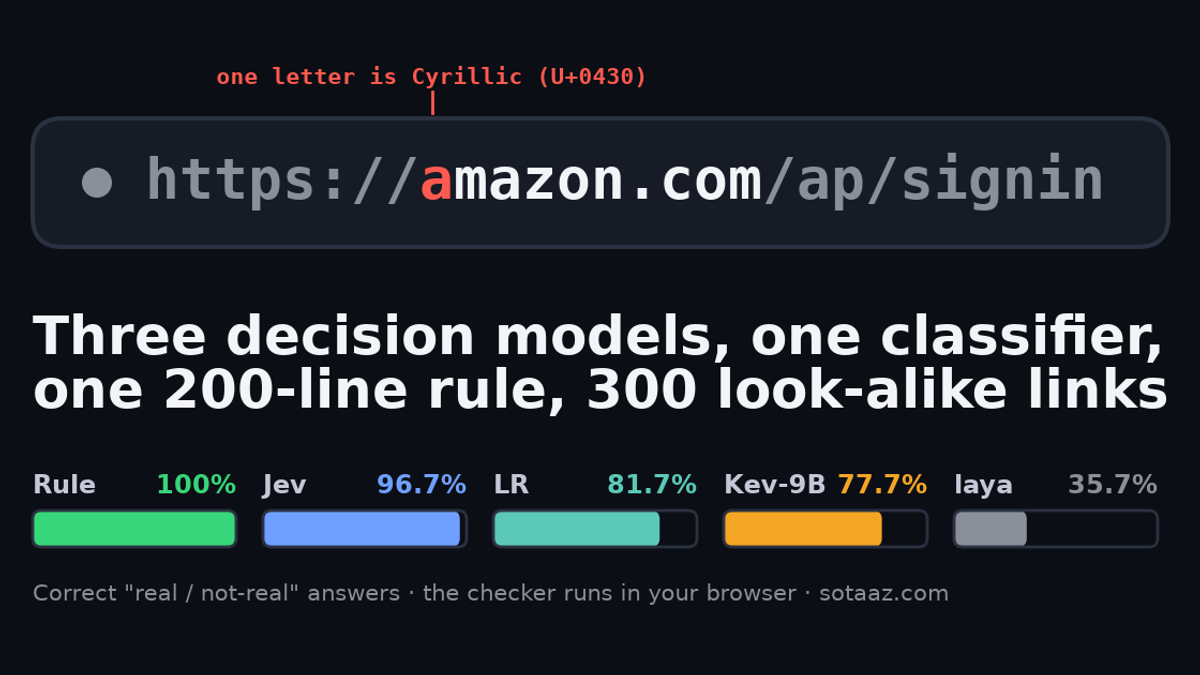
amazon.com의 a를 키릴 문자로 바꾼 주소처럼 눈으로는 가릴 수 없는 가짜 60개를 Jev는 하나도 빠짐없이 잡았습니다. 대신 scotlabank.com, d0cusign.com처럼 사람 눈에도 보이는 오타 열 개를 진짜라고 했습니다. Kev-9B는 거꾸로 그 60개 중 39개를 진짜로 봤습니다. 이 글에 넣어 둔 검사기는 모델 없이 300개를 다 가려냅니다. 그 100%를 어떻게 읽어야 하는지도 적었습니다. 붙여 넣은 링크는 브라우저 밖으로 나가지 않습니다.
눈으로 못 가리는 가짜 주소는 결정 모델이 다 잡았습니다. 놓친 건 scotlabank.com이었습니다
넷 중 가짜는 어느 것일까요? аmazon.com · scotlabank.com · amazon.com · z0om.us
답은 셋입니다. 그중 하나는 아무리 들여다봐도 진짜와 구별이 안 되는데, 결정 모델이 틀린 쪽은 그게 아니었습니다.
저희는 실험을 돌리기 전에 결과를 미리 적어 두는 편입니다. 이번에는 이렇게 적었습니다. "amazon.com의 a를 키릴 문자 а로 바꿔서 결정 모델에게 보여 주면, 절반 넘게 진짜라고 답할 것이다." 틀렸습니다. Jev API는 그런 주소 60개를 하나도 놓치지 않았습니다. 정작 놓친 건 scotlabank.com, d0cusign.com, z0om.us 같은 오타 열 개였습니다. 사람이 봐도 알 만한 것들입니다. 저희 GPU에서 돌리는 공개 모델 Kev-9B는 정반대였습니다. 키릴 문자 주소 60개 가운데 39개를 진짜라고 했습니다. 그리고 비교 기준으로 세운 규칙 검사기는 300개를 전부 맞혔습니다. 그런데 이 100%가 이 글에서 가장 믿을 게 못 되는 숫자입니다. 왜 그런지는 뒤에서 말씀드리겠습니다.
검사기는 바로 아래에 있습니다. 문자나 카톡으로 온 링크를 그대로 붙여 넣어 보세요.
링크를 붙여 넣으세요. 붙여 넣은 링크는 브라우저 밖으로 나가지 않습니다. 서버 호출도, 기록도, 저장도 없습니다.
붙여 넣은 링크는 이 페이지 밖으로 나가지 않습니다. 서버에 보내지도, 기록하지도, 저장하지도 않습니다.
가짜 주소는 네 가지로 만들어집니다
요즘 "가짜 amazon.com은 눈으로 절대 구분 못 한다"는 짧은 영상이 돌고 있습니다. 절반만 맞는 말입니다. 어떤 가짜는 정말 눈으로 못 가리고, 어떤 가짜는 보면 압니다. 검사기를 만들려면 이 차이부터 알아야 합니다. 저희는 피싱이 즐겨 흉내 내는 브랜드 133곳(은행, 택배, 결제 앱, 거래소, 쇼핑몰)의 주소로 네 종류의 가짜를 만들었습니다.
- 글자 바꿔치기. 영문자 한두 개를 다른 알파벳의 닮은꼴 글자로 바꿉니다. 키릴 문자 а, е, о, р, с, 그리스 문자 κ, 아르메니아 문자 ո, 라틴 필기체 ɡ 같은 것들입니다.
tеmu.com,dіscover.com,ɡooɡle.com. 눈으로 못 가리는 가짜가 바로 이 종류입니다. 브라우저는 이런 주소를xn--으로 시작하는 부호로 바꿔 보여 주기도 하지만, 앱마다 다르고, 메시지 본문에서는 그냥 글자로 보입니다. - 오타. 외국 글자 없이 영문자만 살짝 틀립니다.
m대신rn,o대신0,l대신1, 글자 순서 바꾸기, 하나 빼기, 겹치기, 끼워 넣기.arnazon.com,facebpook.com,v3rizon.com. 어디서 보든 적힌 그대로 보입니다. - 남의 도메인 앞에 붙인 브랜드 이름.
login.amazon.com.verify-account.shop의 주인은verify-account.shop입니다. 앞부분은 그 도메인 주인이 마음대로 짓는 하위 도메인이라,login.amazon.com이라고 써 놓아도 amazon과는 아무 상관이 없습니다.secure-paypal.net,binance.verifynotice.site도 같은 수법입니다. - @ 앞에 넣은 가짜 주소.
https://amazon.com@evil-site.net/login은evil-site.net으로 갑니다.@앞은 사용자 이름 자리라서 브라우저가 무시합니다.
종류마다 60개씩, 여기에 같은 브랜드의 진짜 주소 60개를 보태 300개를 만들었습니다. 생성 스크립트의 시드를 고정했고, 모델에 넣기 전에 파일을 먼저 공개 기록으로 묶어 두었습니다. 모든 시스템에 같은 두 줄을 줍니다. 주소 한 줄, 그 주소가 내세우는 브랜드 한 줄. 답은 real(진짜) 아니면 not-real(가짜) 둘 중 하나입니다.
검사기는 이렇게 가려냅니다
TypeScript 200줄 남짓이고 모델은 없습니다. 마지막 판정 함수는 11줄입니다. 하는 일은 세 가지입니다.
- 주소의 진짜 주인부터 찾습니다. 브라우저가 쓰는 공개 접미사 목록(public suffix list)으로 등록 도메인을 가려냅니다. 이것만으로 셋째, 넷째 종류는 끝입니다. 주인은 amazon이 아니라
verify-account.shop이고, 가는 곳은 amazon이 아니라evil-site.net입니다. - 닮은꼴 글자를 원래 글자로 되돌립니다. 유니코드가 직접 관리하는 혼동 문자 표(UTS #39, 18.0판)에서 영문자로 되돌릴 수 있는 2,122개 항목을 쓰고, 그 표가 일부러 뺀 영문자 짝 여덟 개(
rn→m,vv→w,cl→d,nn→m,0→o,1→l,5→s,8→b)를 보탰습니다. 되돌리고 나면аmazon도arnazon도amaz0n도 다amazon입니다. - 되돌린 이름을 알려진 도메인 2,060개와 맞춰 봅니다. Tranco 상위 2,000개에 브랜드 133곳을 더한 목록입니다(브랜드 73곳은 이미 상위 2,000개 안에 있어서 겹칩니다). 되돌린 이름은 같은데 원래 글자가 다르면 닮은꼴입니다. 한 글자 차이(긴 이름은 두 글자)여도 닮은꼴로 봅니다. 목록에 그대로 있으면 알려진 사이트입니다. 아무 데도 안 걸리면 "저희가 검사하는 항목에는 없음"이라고만 말합니다. "안전함"이라고는 하지 않습니다.
그 밖에 숫자만 있는 IP 주소, 보이지 않는 글자, 한 단어에 섞인 두 알파벳, 남의 도메인에 붙은 브랜드 이름도 따로 표시합니다. 판정 종류는 정해진 목록이고, 재현 패키지에 든 표 테스트가 그 목록 전부와 알려진 도메인 2,060개(헛경보가 하나라도 나면 실패), 아래 300개(하나라도 틀리면 실패)를 돌립니다. 검사기에 모델을 넣지 않은 이유가 바로 이 조건이고, 아래 측정은 이 조건을 모델이 지키지 못한다는 걸 보여 줍니다.
다섯 시스템에 같은 300개를 물었습니다
규칙 검사기는 등록 도메인이 알려진 목록에 있을 때만 real이라고 합니다. 결정 모델 셋에게는 질문 한 줄과 선택지 이름 두 개만 줬습니다. 마지막 줄은 늘 넣는 기준선입니다. 문장 임베딩(MiniLM)에 로지스틱 회귀를 얹고, 시험 집합과 겹치지 않는 생성 주소 200개로 학습시킨 것입니다.
| 시스템 | 전체 300 | 진짜 (60) | 글자 바꿔치기 (60) | 오타 (60) | 브랜드 이름 붙이기 (60) | @ 트릭 (60) | 지연 중앙값 |
|---|---|---|---|---|---|---|---|
| 규칙 검사기 | 100.0% | 60 | 60 | 60 | 60 | 60 | 1ms 미만 |
| Jev API (jev-1.13.0) | 96.7% | 60 | 60 | 50 | 60 | 60 | 203ms (한국에서) |
| Kev-9B, A100 한 장 | 77.7% | 58 | 21 | 34 | 60 | 60 | 29ms |
| MiniLM + 로지스틱 회귀, CPU | 81.7% | 9 | 60 | 57 | 59 | 60 | 9.5ms |
| laya 0.3.7, A100 한 장 | 35.7% | 60 | 3 | 14 | 14 | 16 | 24.5ms |
쌍으로 견주면 Kev-9B와 로지스틱 회귀(4점 차이, McNemar 검정 p = 0.3)만 빼고 전부 표준오차 두 배 밖입니다. Jev와 검사기의 차이는 10개인데 방향이 전부 한쪽이고 p = 0.002입니다.
미리 적어 둔 예측 넷은 이렇게 됐습니다.
- 규칙은 글자 바꿔치기와 @ 트릭을 95% 이상, 나머지 둘을 85% 이상 잡고, 진짜 주소를 가짜라고 하지 않는다. 맞았습니다. 300개 다 맞혔습니다. 다만 이 숫자를 보고 감탄하면 안 됩니다. 이유는 뒤에 있습니다.
- 결정 모델은 모두 글자 바꿔치기의 절반 넘게 진짜라고 답한다. Jev에서는 틀렸습니다. 60개 중 진짜라고 한 게 없습니다. Kev-9B(39개)와 laya(57개)는 예측대로였습니다.
- 모델은 글자 바꿔치기보다 오타를 더 잘 잡는다. Jev는 거꾸로였습니다. 놓친 열 개가 전부 오타였습니다.
scotlabank.com,d0cusign.com,z0om.us,3e.co.uk,outook.com,ternu.com,oensea.io,sigal.org,wsetpac.com.au,crypcto.com. Kev-9B와 laya는 둘 다 어려워했으니 예측대로입니다. - 로지스틱 회귀는 결정 모델과 규칙 사이에 들고, 글자 바꿔치기에서는 결정 모델보다 낫다. 반만 맞았습니다. Kev-9B와 laya는 이겼지만 Jev(96.7%)한테는 81.7%로 졌고, 글자 바꿔치기 60/60은 Jev와 같은 점수입니다. 게다가 그 60/60은 잡아낸 게 아닙니다. 같은 분류기가 진짜 주소 60개 중 51개도 가짜라고 했습니다. 문장 임베딩은 글자 하나 바뀐다고 거의 안 움직이니, 분류기는 학습 데이터의 비율(진짜 1에 가짜 4)만 익혀서 거의 다 가짜라고 찍은 겁니다. 저희가 학습 데이터를 그렇게 나눈 탓입니다.
laya는 기본 설정에서 300개 중 253개를 진짜라고 했습니다. 평균 confidence는 0.30입니다. 문서가 권하는 대로 선택지 두 개만 줬으니 앞 글에서 걸렸던 선택지 토큰 예산 문제와는 다릅니다. 이 질문으로는 주소를 제대로 읽지 못한다고 보는 게 맞고, 설정을 따로 손보지는 않았습니다.
Jev는 왜 바꿔치기한 글자는 잡고 빠진 글자는 못 잡았을까요. 짐작은 되지만 짐작일 뿐입니다. 키릴 문자 а는 영문자 a와 바이트부터 달라서, 주소 줄과 브랜드 줄이 토큰 단계에서 확연히 어긋납니다. 반면 scotlabank는 scotiabank와 토큰 하나 정도 차이라, 모델이 "같은 브랜드"로 봐 주는 범위 안에 들어갔을 수 있습니다. Jev와 같은 방식으로 요청을 받는 공개 모델 Kev-9B에서는 이런 차이가 안 보였습니다. 브랜드 줄을 빼고 주소만 주면 어떻게 되는지는 안 쟀습니다. 메시지로 링크가 올 때는 그게 실제 상황인데도요.
검사기에 모델을 넣지 않은 이유
답을 정하는 정보가 주소 문자열과 목록 안에 다 있습니다. 주소의 실제 주인은 공개 접미사 목록으로 정확히 정해집니다. 닮은꼴 글자는 유니코드 혼동 문자 표로 정확히 되돌릴 수 있고, 되돌린 이름은 알려진 도메인과 그대로 비교하면 됩니다. 셋 다 판단이 아니라 정확한 조회입니다. 모델이 할 수 있는 일은 이 조회를 어림잡는 것뿐이고, 가장 잘한 Jev도 이 조회가 다 잡는 오타 주소를 가짜 240개 중 10개 놓쳤습니다. 생성기와 검사기가 목록을 공유한 측정이라는 단서는 다음 절에 있습니다.
규칙은 증명할 수 있고 모델은 그럴 수 없습니다. 규칙은 알려진 도메인 2,060개에 헛경보 0개, 가짜 주소 240개에 놓침 0개를, 데이터 파일이 바뀔 때마다 표 테스트로 다시 확인할 수 있습니다. 모델은 같은 입력에도 버전마다 답이 바뀔 수 있고, 호스팅 모델은 예고 없이 바뀝니다. 앞에서 실제로 잰 적이 있습니다. 비밀번호를 넣기 전에 믿는 도구라면 이 차이가 결정적입니다.
실험에서 모델은 정답의 절반을 미리 받았습니다. 질문에 "이 주소가 어느 브랜드라고 주장하는지"를 함께 줬습니다. 실제 문자 메시지에는 그 줄이 없습니다. 규칙은 닮은꼴 비교로 가장 가까운 브랜드를 스스로 찾지만, 모델은 그 줄 없이는 재지 않았습니다. 그러니 위 측정은 모델에게 유리한 쪽이고, 그 조건에서도 규칙에 못 미쳤습니다.
모델이 실제로 보탤 수 있는 곳은 이 검사기 밖입니다. 이름이 평범한 피싱 도메인(secure-account-update.com)이나 페이지 내용을 판단하는 일은 문자열 비교로는 안 됩니다. 그건 다른 도구이고, 거기에 모델을 쓴다면 따로 재야 합니다.
100%를 그대로 믿으면 안 되는 이유
규칙 검사기가 300개를 다 맞힌 건 생성기와 검사기가 같은 것 둘을 쓰기 때문입니다. 브랜드 목록, 그리고 글자 바꾸는 방법입니다. 혼동 문자 표는 생성기가 하는 모든 치환을 덮고, 브랜드 목록은 생성기가 흉내 내는 브랜드를 다 담고 있습니다. 그러니 이 숫자는 "결정 모델 셋과 분류기 하나는 200줄짜리 규칙이 하는 일을 이 과제에서 못 한다"까지만 말합니다. 규칙이 피싱을 잡는다는 말이 아닙니다. 검사기는 secure-account-update.com이 피싱인지 모릅니다. 이름이 평범하니까요. 페이지 내용도 안 봅니다. 모든 검사를 통과한 링크도 비밀번호를 물을 수 있습니다. 그럴 때 검사기는 "저희가 검사하는 항목에는 없음"이라고만 하고, 그걸 "안전"으로 읽지 않도록 단어를 골랐습니다.
한계가 더 있습니다. 모델들은 주소와 브랜드, 두 줄을 받았습니다. 메시지로 오는 링크엔 브랜드 줄이 없는데, 그 조건은 안 쟀습니다. 알려진 도메인 목록은 영어권 위주라(Tranco 2,000개와 저희가 손으로 고른 브랜드) 한국 은행의 닮은꼴은 안 잡힙니다. Jev의 지연 203ms는 한국에서 잰 값이고 대부분이 왕복 시간이라는 건 앞 글에서 확인했습니다. 로컬 시스템 셋은 A100 한 장에서 한 번에 하나씩 돌렸고, 폰이 아닙니다.
이 글의 자료
재현 패키지
이 글의 하네스, 원 로그, 결과 CSV를 묶었습니다. 로그인 없이 받을 수 있고, GPU 없이 표의 숫자를 다시 계산하는 명령이 README에 있습니다.
link-check-repro.zip · 88 KB