판단 모델은 답을 어디서 읽을까: laya, DiffusionGemma, Kev, CLM, 분류기 코드 따라가기
고객 문장 하나와 의도 라벨 77개가 라벨별 확률이 되기까지를 다섯 시스템의 코드로 따라갑니다. 같은 BANKING77 154건에서 결과는 3.2%부터 90.3%까지 벌어졌습니다. laya는 라벨을 모두 세 토큰으로 자르고, 자리를 더 주면 37.0%가 46.1%로 오릅니다. 나머지 시스템은 라벨을 자르지 않은 채 선택지를 넣는 자리와 점수를 읽는 자리가 서로 다릅니다.
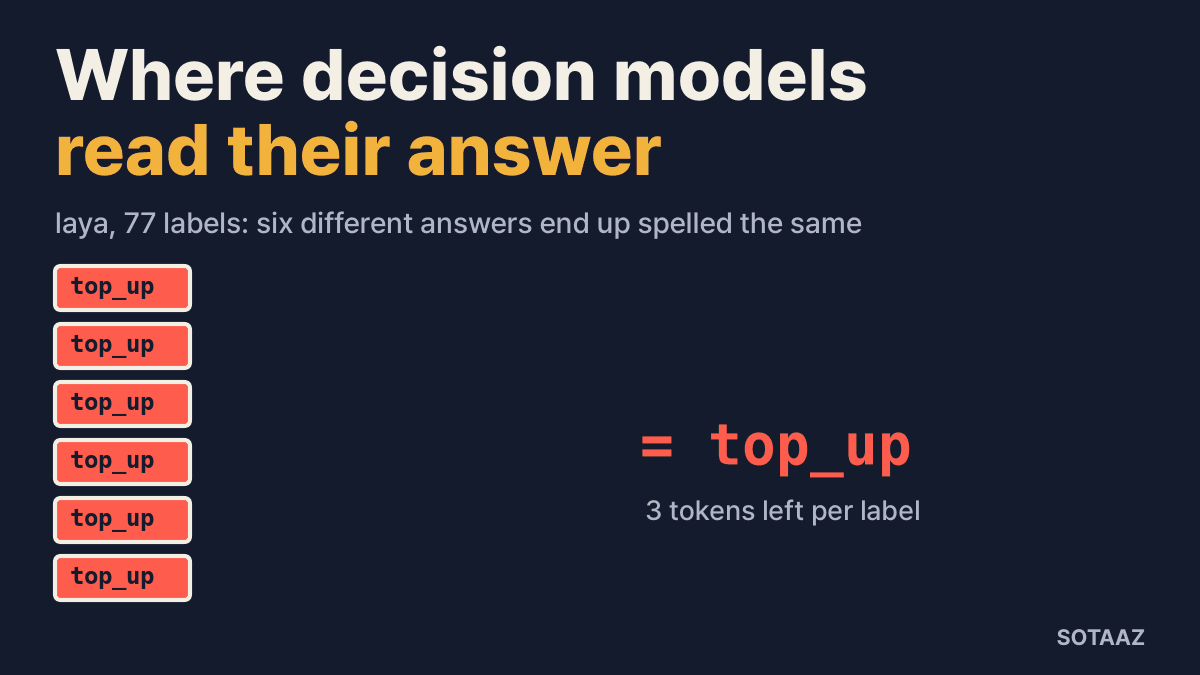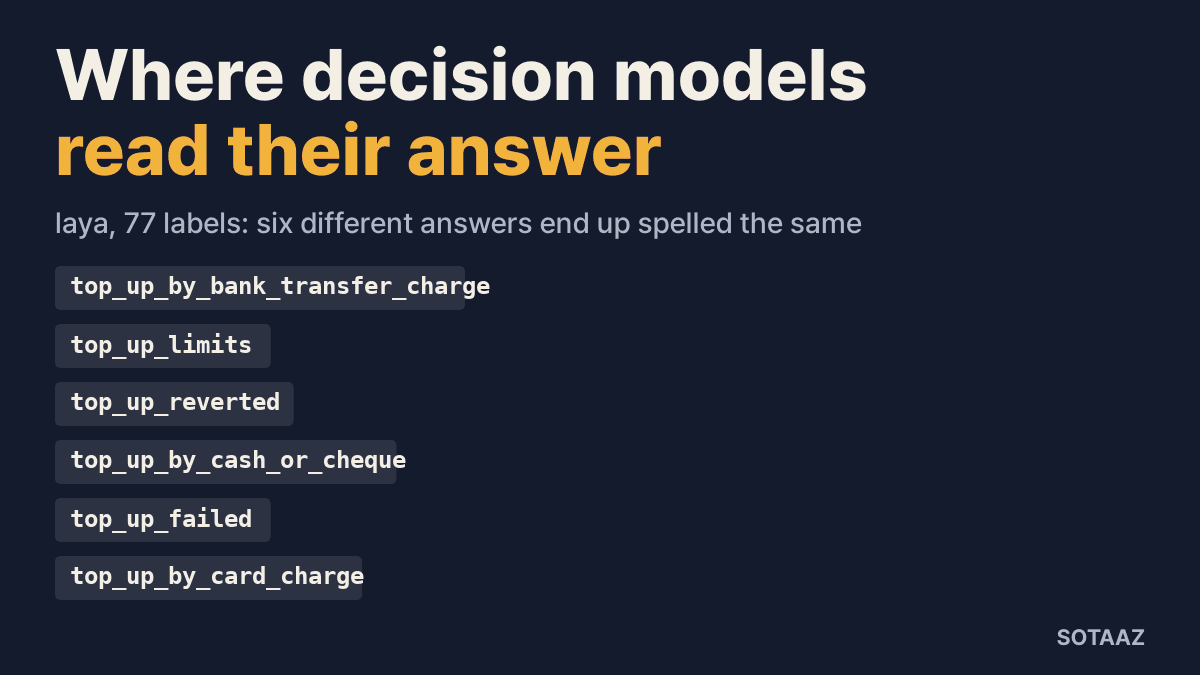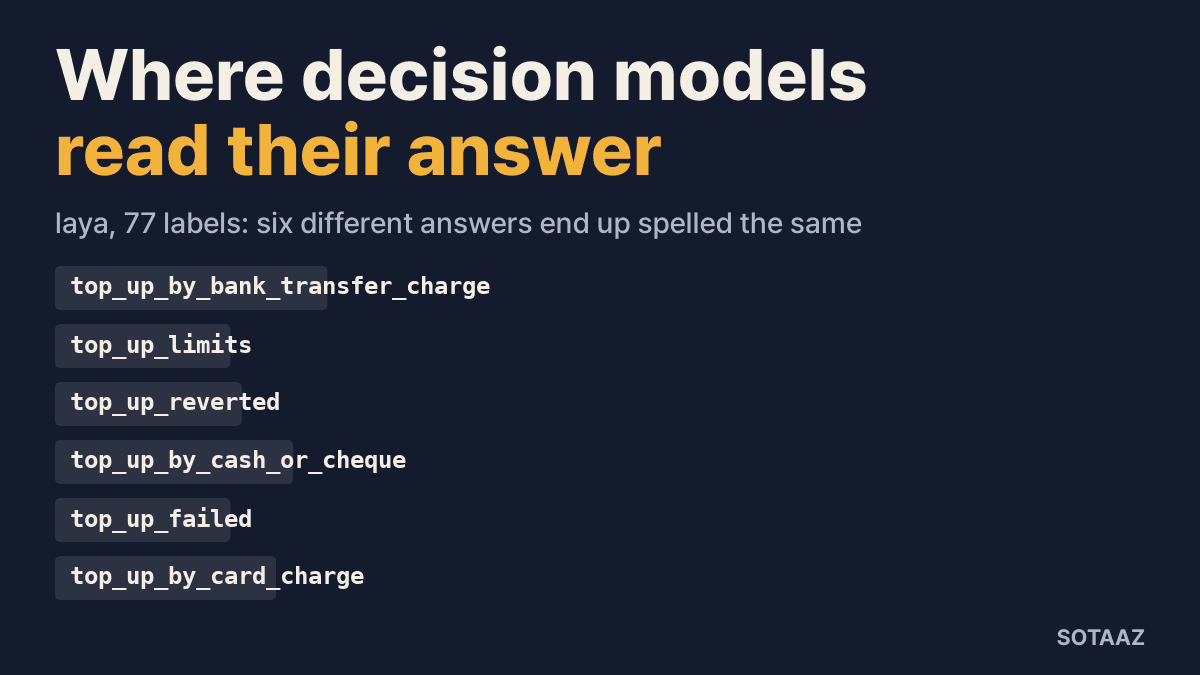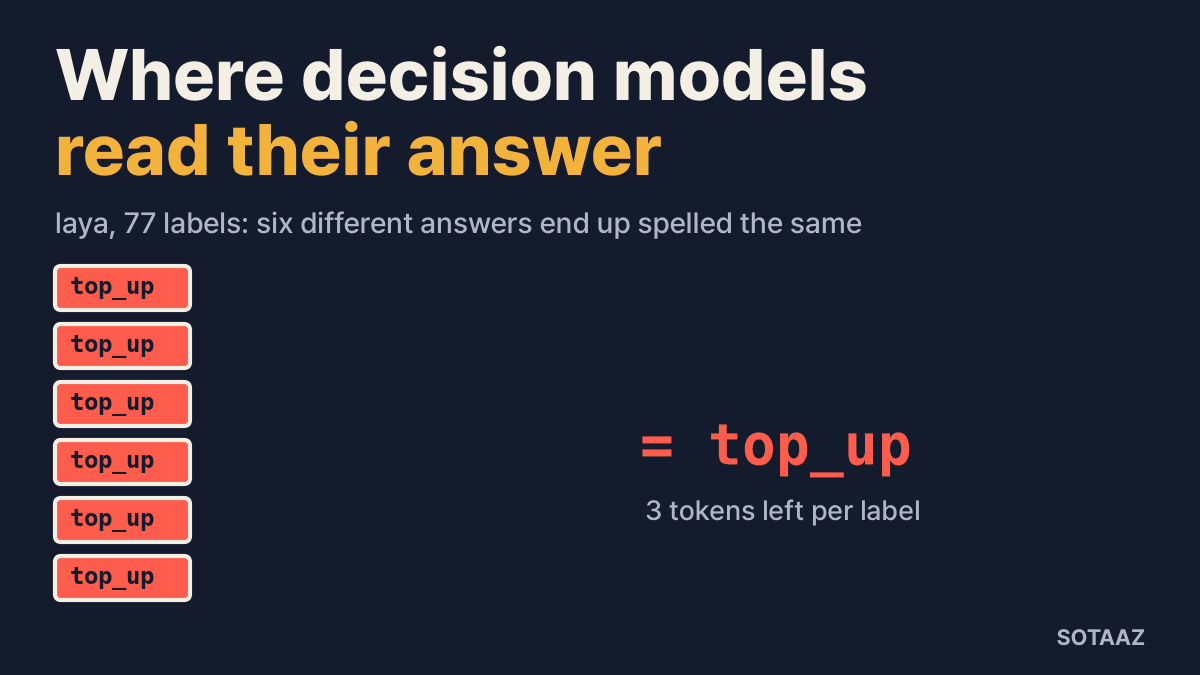
은행 고객이 "What is the top-ups limit?"라고 묻습니다. 판단 모델은 의도 77개 중 하나를 골라야 하고, 정답은 top_up_limits입니다. 421M짜리 판단 모델 laya는 top_up_by_cash_or_cheque를 골랐습니다. laya가 입력을 만드는 함수에 같은 라벨 77개를 넣고 토큰을 세어 보니, 두 라벨 모두 top_up 세 토큰만 남았습니다. 충전 관련 의도 네 개도 마찬가지였습니다. laya가 보는 입력 안에서는 서로 다른 답 여섯 개가 글자까지 똑같았습니다.
이런 차이는 문장 하나에서 끝나지 않습니다. 저희가 앞 글들에서 같은 BANKING77 154건에 라벨 이름만 주고 돌린 결과, 이 글에서 여는 다섯 시스템은 3.2%부터 90.3%까지 갈렸습니다. Jev는 참고로 함께 적습니다.
| 시스템 | 같은 154건 정확도 |
|---|---|
| laya 기본 설정 | 37.0% |
| DiffusionGemma(openjev), 한 번 읽기 | 66.9% |
| Kev-9B(BANKING77이 학습 데이터에 있음) | 82.5% |
| CLM, 라벨 이름만 | 3.2% |
| MiniLM 임베딩 + 로지스틱 회귀, 라벨 붙은 문장 10,003건으로 학습 | 90.3% |
| *참고: Jev 1.13(TypeSafe API, 내부 비공개)* | *76.0%* |
숫자는 laya·openjev·분류기 비교 글과 Kev와 Jev 비교 글, CLM이 나오는 confidence 글에서 가져왔습니다. Kev 줄은 단서와 함께 읽어야 합니다. Kev는 BANKING77로 학습했기 때문에, laya나 openjev처럼 이 과제를 처음 보는 모델과 같은 조건이 아닙니다.
이 글에서는 Jev를 뺀 네 시스템과 분류기의 공개 코드를 열고, 위 문장 하나가 확률이 될 때까지 따라갑니다. Jev는 내부 구조가 공개되지 않았습니다. 나머지는 구조 차이를 소스 코드에서 바로 읽을 수 있습니다.
판단 모델이 하는 일
판단 모델은 답을 글로 쓰지 않습니다. 상태(여기서는 고객 문장), 질문, 정해진 선택지 목록을 보내면 선택지마다 확률 하나를 돌려줍니다. 확률이 높은 답은 바로 처리하고 나머지는 더 느린 모델이나 사람에게 넘기는 식으로 씁니다. 왜 이렇게 쓰는지는 10분 설명 글에 정리해 두었습니다.
아래 다섯 시스템은 모두 같은 문제 두 개를 풉니다. 하나는 선택지를 모델에게 어떻게 보여 줄지이고, 다른 하나는 네트워크 안 어디에서 선택지마다 점수 하나를 꺼낼지입니다. 두 문제를 푸는 방식이 시스템마다 다르고, 선택지가 77개쯤 되면 첫 번째 문제가 특히 중요해집니다.
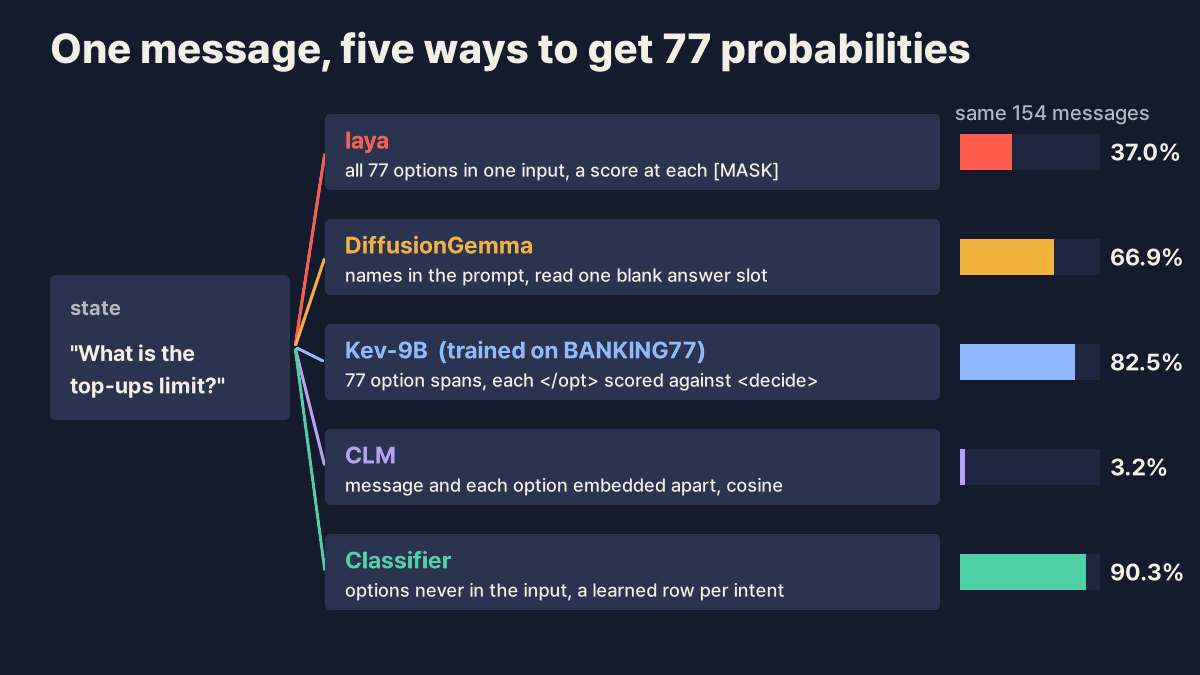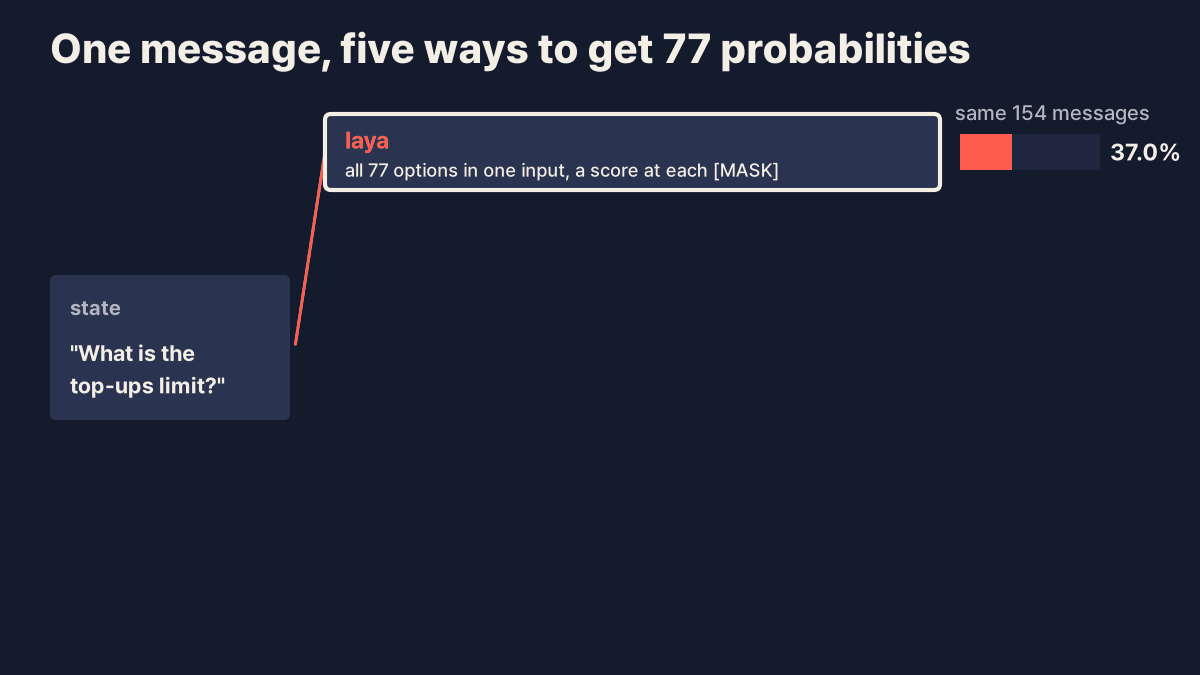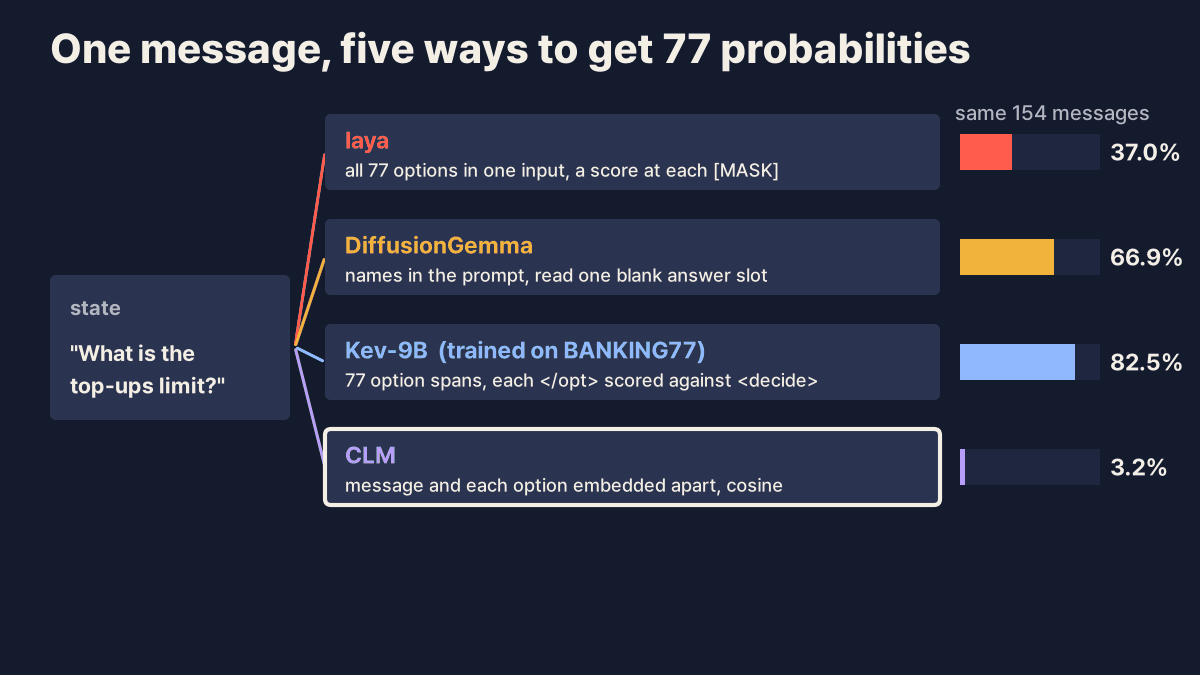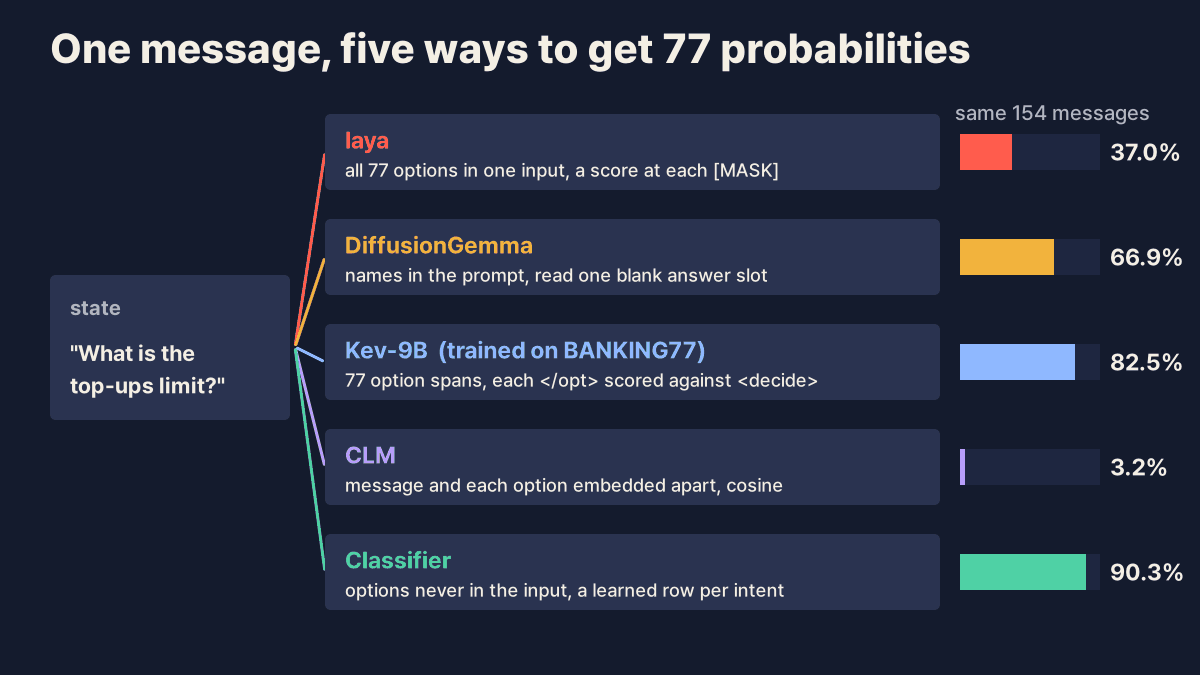
laya: 한 입력에 선택지를 모두 넣고 `[MASK]`마다 점수 하나
laya는 ModernBERT-large 인코더 위에 작은 헤드를 얹은 모델입니다. 질문 하나에 시퀀스 하나를 laya/common.py에서 이렇게 만듭니다.
[CLS] choice question: <지시문> [SEP] [MASK] 선택지0 [MASK] 선택지1 ... [SEP] <상태> [SEP]선택지마다 앞에 [MASK] 토큰이 하나씩 붙습니다. 인코더를 한 번 통과시킨 뒤, 헤드는 [MASK] 자리의 hidden 벡터만 모아 숫자 하나로 바꾸고 선택지끼리 softmax를 합니다.
idx = marker_pos.clamp(min=0)[:, :, None].expand(-1, -1, h.size(-1))
m = torch.gather(h, 1, idx)
logits = self.scorer(m).squeeze(-1).float()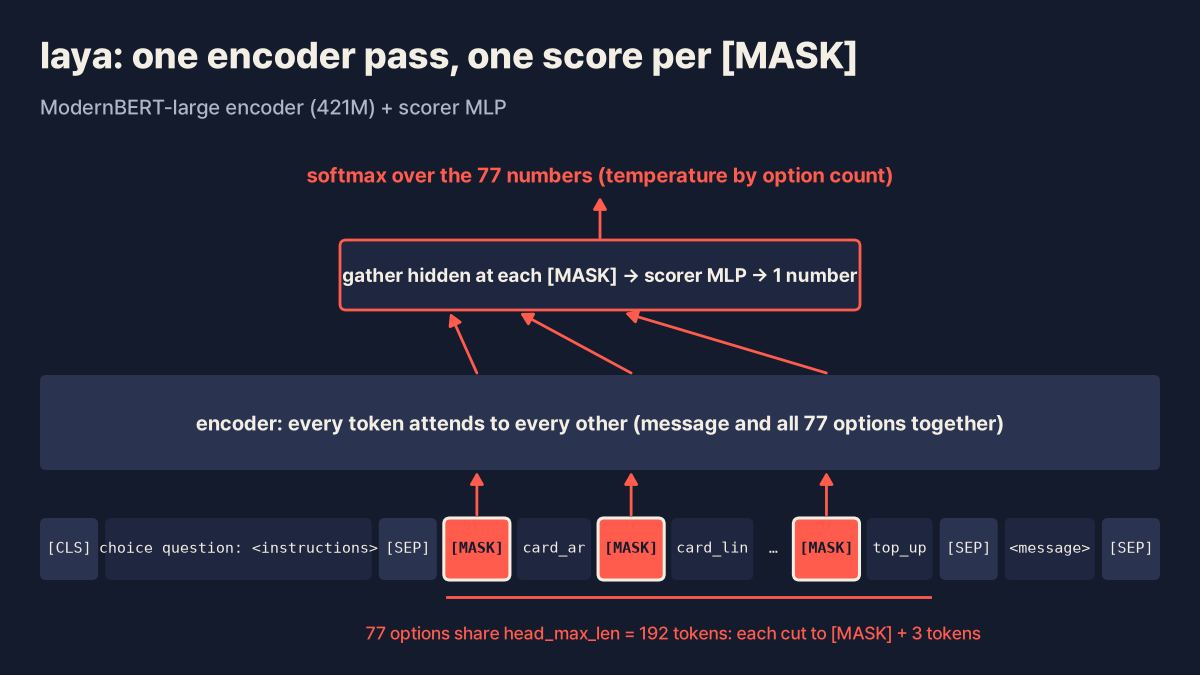
인코더라서 [MASK] 하나하나가 고객 문장과 다른 선택지를 모두 볼 수 있습니다. 이 설계의 장점입니다. 대신 선택지 전체가 지시문과 함께 정해진 크기의 앞부분에 들어가야 합니다. 그 크기가 head_max_len이고, 영어 체크포인트에서는 192토큰입니다. 선택지가 넘치면 아래 코드가 모든 선택지를 같은 길이로 자릅니다.
opt_budget = head_max_len - sum(len(o) for o in opt_ids)
if opt_budget < 16:
    per = max(4, (head_max_len - 16) // max(1, len(opt_ids)))
    opt_ids = [o[:per] for o in opt_ids]
    opt_budget = head_max_len - sum(len(o) for o in opt_ids)
head_ids = head_ids[: max(8, opt_budget)]
선택지가 77개이면 per가 하한인 4에 걸립니다. [MASK] 하나와 라벨 토큰 세 개만 남는다는 뜻입니다. 저희는 laya의 토크나이저로 이 함수를 그대로 실행해 BANKING77 라벨 77개와 위 문장을 넣어 보았습니다. 모델은 돌리지 않고 토크나이저만 썼습니다.
- 라벨 길이는 3토큰부터 17토큰까지이고, 중앙값은 5토큰, 합은 476토큰입니다. 예산은 192토큰입니다.
- 77개 중 64개가 잘립니다. 잘린 뒤 서로 다른 라벨은 67개뿐입니다. 라벨 여섯 개가
top_up이 되고, 세 개가card_payment가 됩니다. - 지시문은 8토큰만 남아 "choice question: Which intent does this banking"에서 끊깁니다.
- 하한 4가 예산보다 우선하므로, 선택지 부분은 77 곱하기 4인 308자리를 차지합니다. 192를 훌쩍 넘습니다. 고객 문장은 8토큰이라 잘리지 않습니다.
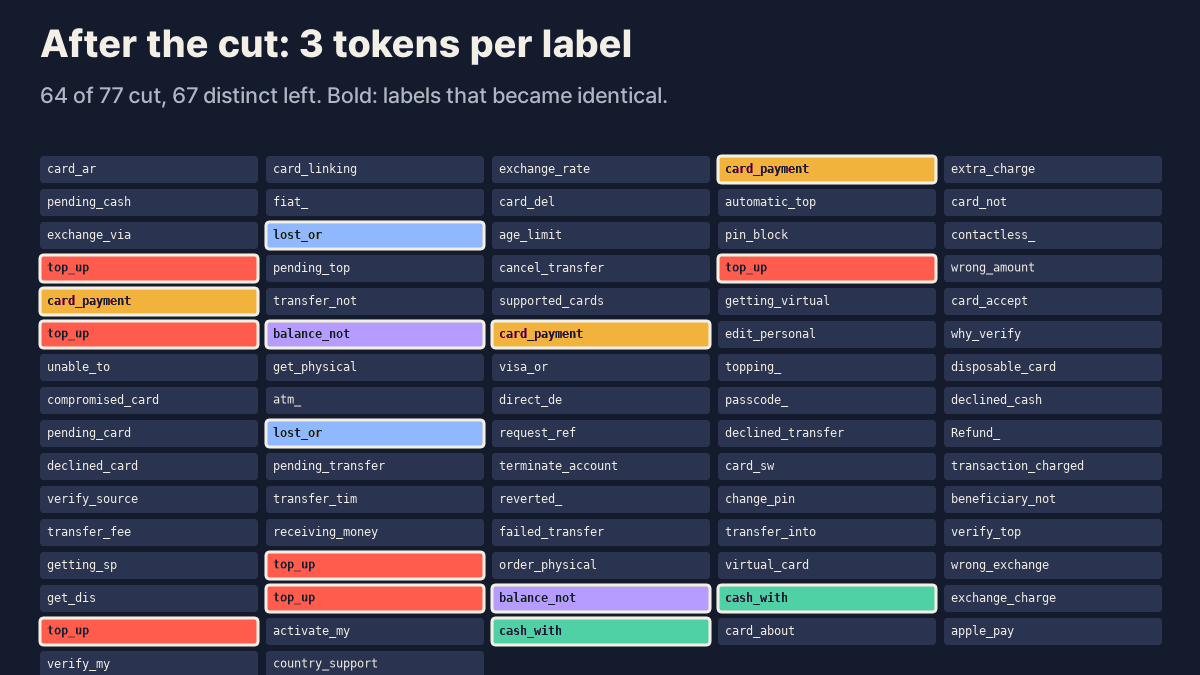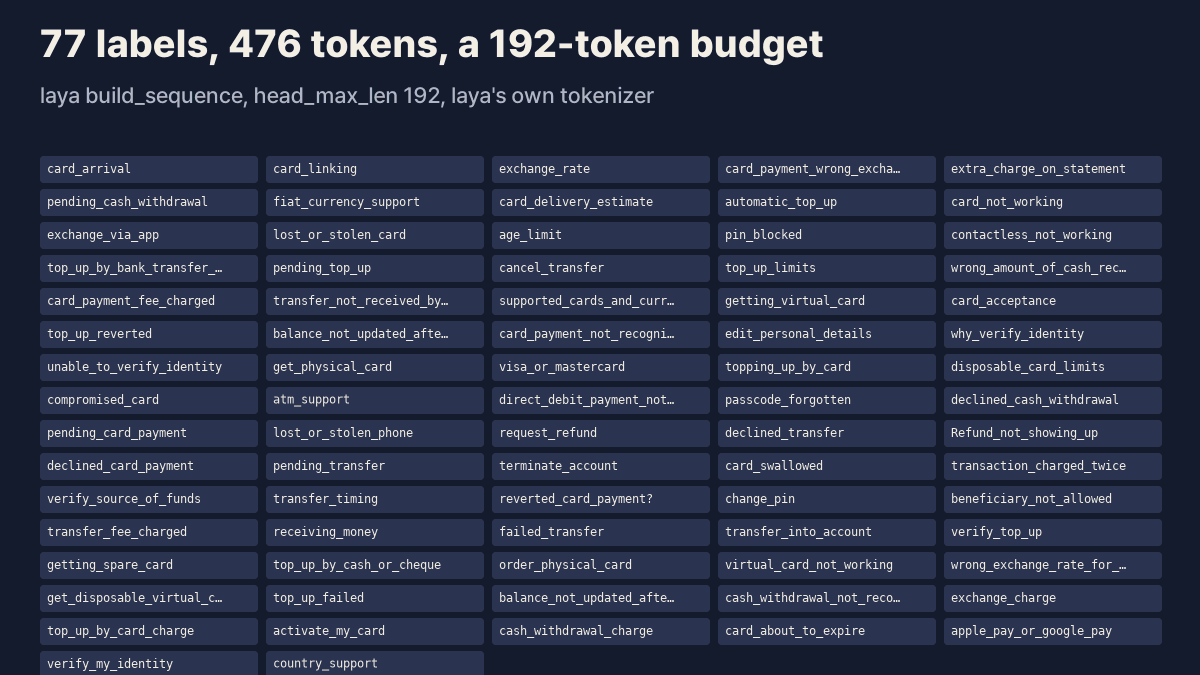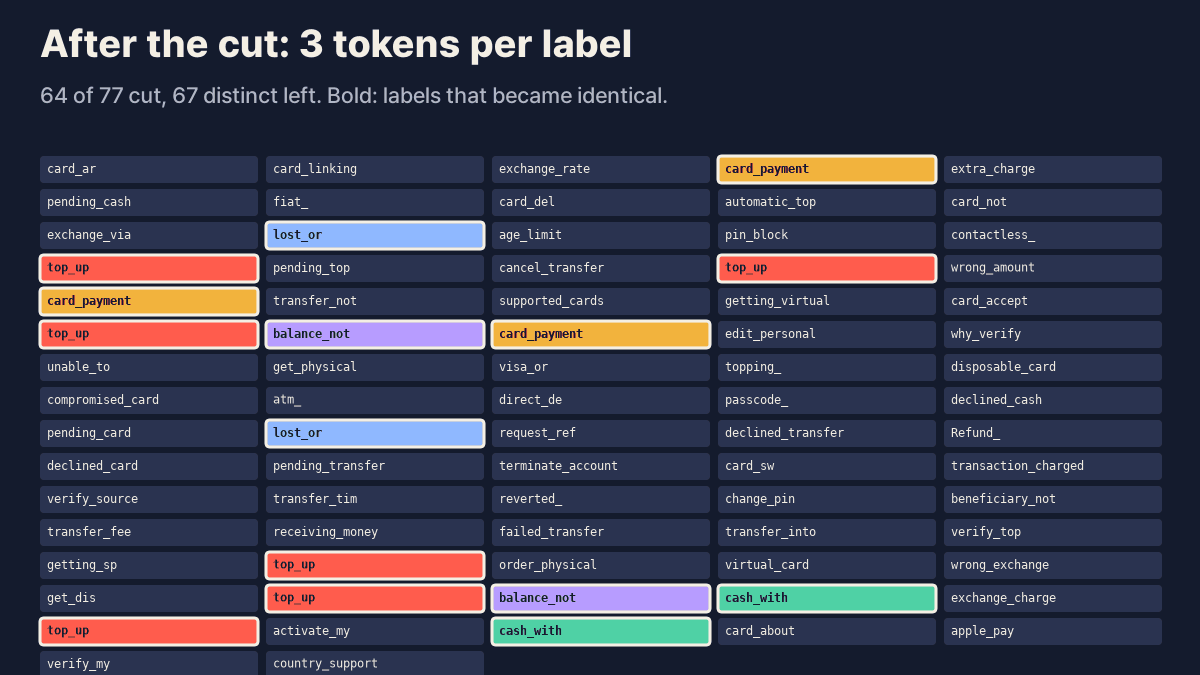
예산을 512(max_len 1024)로 올리면 지시문은 모두 남고, 잘리는 라벨은 64개에서 37개로 줄어 서로 다른 라벨이 72개가 됩니다. 저희가 돌렸을 때 이 설정은 위 문장에 top_up_limits로 맞게 답했고, 정확도는 37.0%에서 46.1%로 올랐습니다. laya README가 권하는 다른 방법은 임베딩 모델로 후보를 20개로 먼저 줄이는 것인데, 이렇게 하면 59.1%였습니다. 다만 MiniLM 혼자서도 154건 중 87건에서 정답 라벨을 골랐습니다(laya가 후보 20개 위에서 맞힌 것은 91건입니다). laya의 벤치마크 문서도 "Keep choice questions under ~20 options"라고 직접 적어 두었습니다(BENCHMARKS.md).
DiffusionGemma: 답안지에 빈칸 하나만 두고 그 칸을 읽기
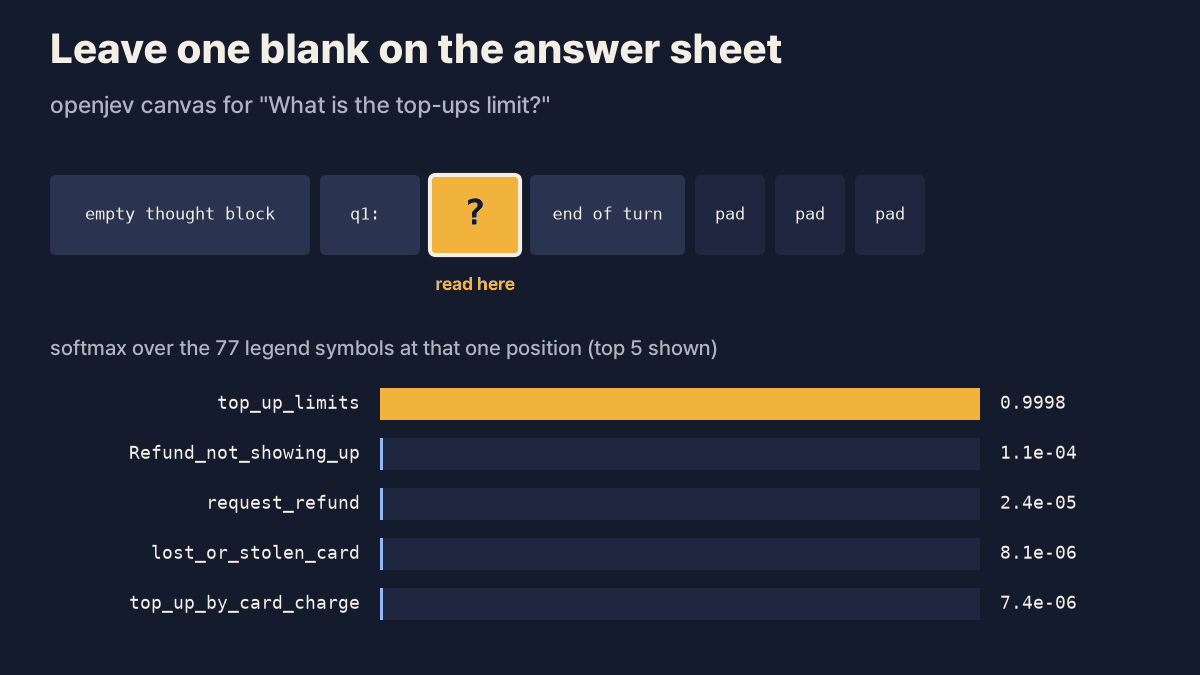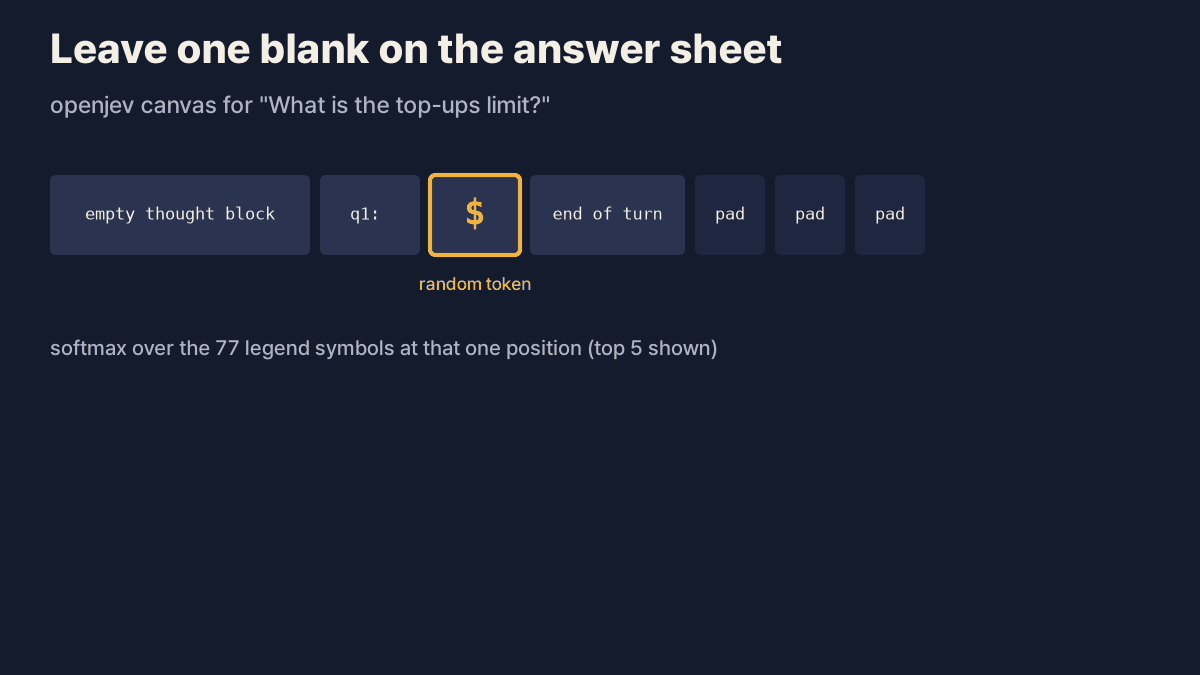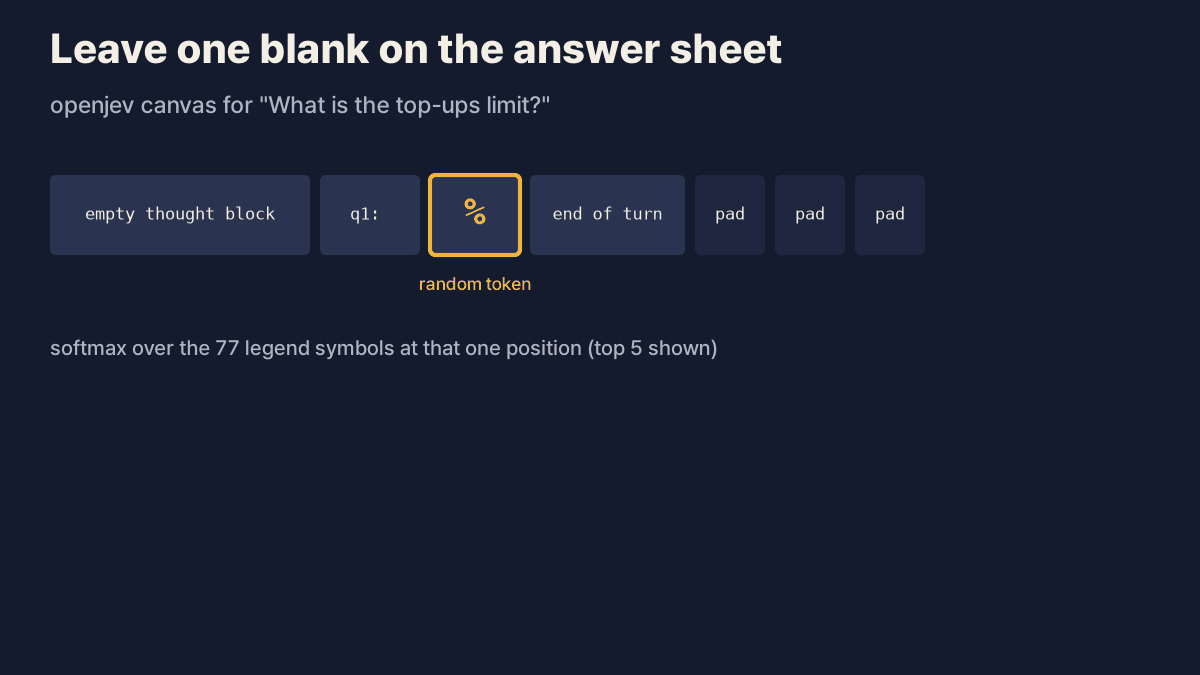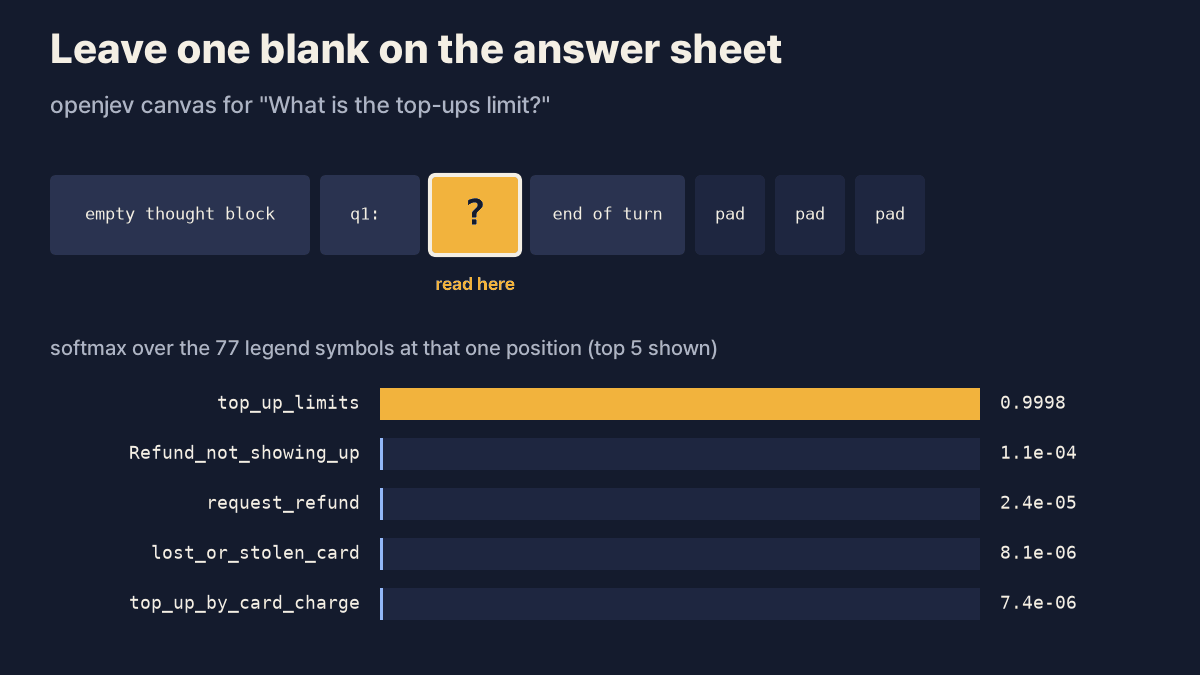
openjev는 방식이 전혀 다릅니다. DiffusionGemma-26B-A4B용으로 올라온 vLLM 풀 리퀘스트에서 가져온 방식이고, 저희가 DiffusionGemma 글에서 직접 돌려 본 방식이기도 합니다. 디퓨전 언어 모델은 토큰을 하나씩 쓰지 않고 한 덩어리를 한꺼번에 채웁니다. openjev는 그 덩어리에 답안지를 미리 써 두고, 딱 한 자리만 비워 둡니다(openjev/engine.py).
canvas = list(template) + [TURN_CLOSE]
canvas += [PAD] * (self.canvas_width(template) - len(canvas))
for s in slots:
    canvas[s["pos"]] = rng.randrange(VOCAB)
답안 형식은 q1: X입니다. 선택지 이름은 시스템 문구에 범례처럼 들어갑니다. A: card_arrival, B: card_linking 같은 식입니다. 디노이즈를 한 번 돌린 뒤 openjev는 빈칸 자리의 로짓을 읽고, 범례 기호의 토큰 id만 남겨 softmax를 합니다.
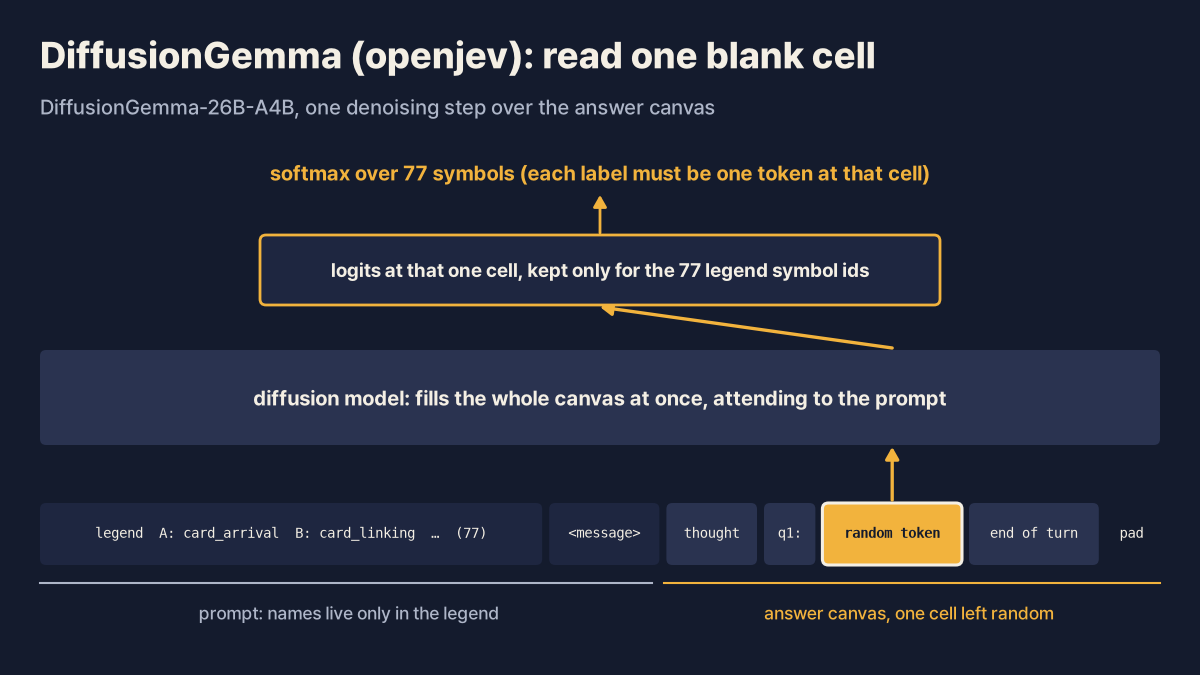
조건이 하나 붙습니다. 선택지마다 그 한 자리에 들어가는 한 토큰이어야 합니다. 그래서 답은 의도 이름이 아니라 기호입니다. openjev는 라벨을 하나씩 검사하고, 조건을 어기면 요청을 거절합니다.
if len(e) != len(base) or len(diffs) != 1 or (pos is not None and diffs[0] != pos):
    raise SchemaError(f"question {q['key']!r}: labels do not share one template slot")
선택지가 77개일 때는 이 방식에는 laya가 겪은 문제가 없습니다. 의도 이름은 공간이 넉넉한 프롬프트에 있으니 잘리지 않고, 답은 여전히 한 자리입니다. 모델이 할 일은 77줄짜리 범례를 읽고 글자 하나를 쓰는 것이 되고, openjev는 66.9%를 얻었습니다. 다만 범례도 결국 프롬프트라서 문구에 민감합니다. 그 글에서 같은 한 칸 읽기를 쓰는 vLLM 예제 서버를 돌렸을 때, 입력을 설명하는 문장 하나를 더하자 54.5%가 31.8%로 떨어졌습니다. 이 예제 서버는 선택지를 26개까지만 받습니다.
Kev: 디코더 안의 선택지 구간을 가리켜 점수 매기기
Kev는 Qwen3.5 베이스 모델(0.8B, 4B, 9B)에 LoRA 어댑터와 작은 헤드를 붙인 모델입니다. 학습한 과제에서 얼마나 맞히는지는 첫 Kev 글에서 쟀습니다. 요청을 한 시퀀스로 묶고, Qwen에서 거의 쓰지 않는 특수 토큰 다섯 개를 구분자로 다시 씁니다(kev/model.py).
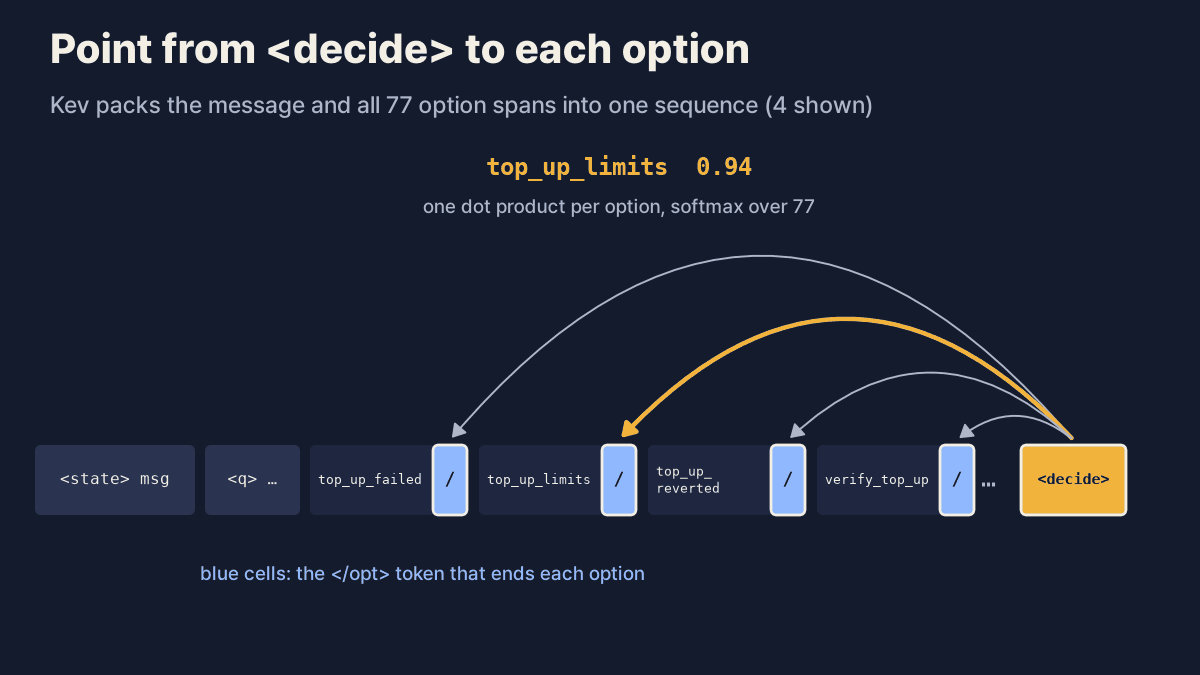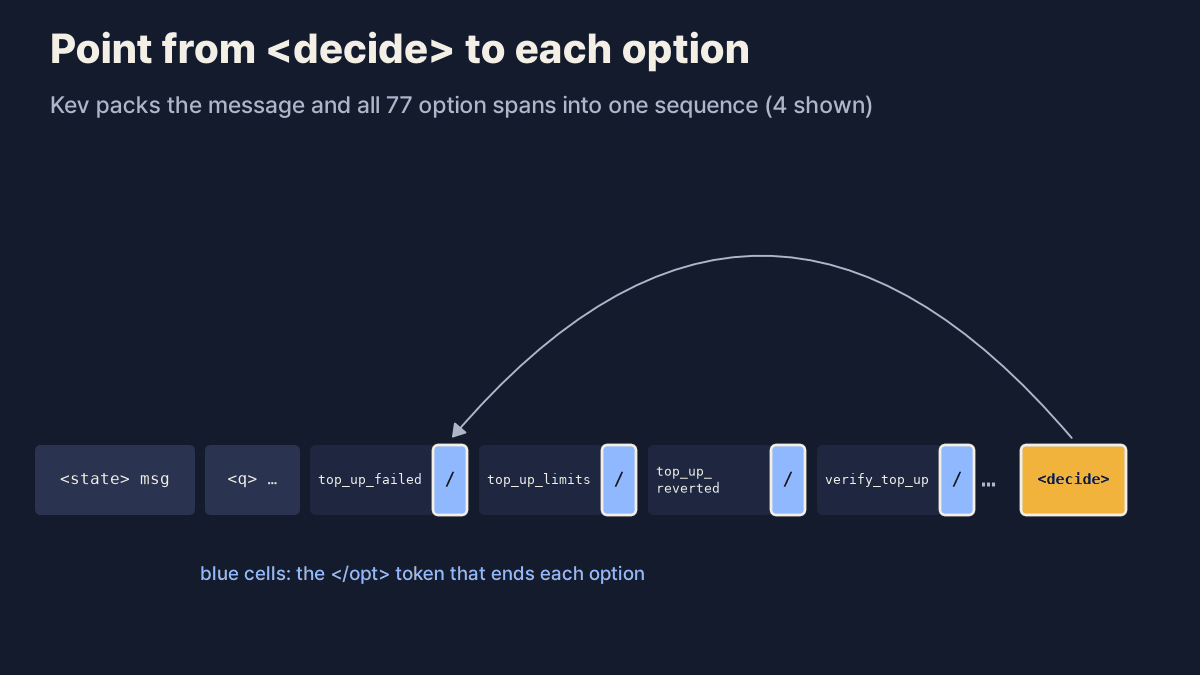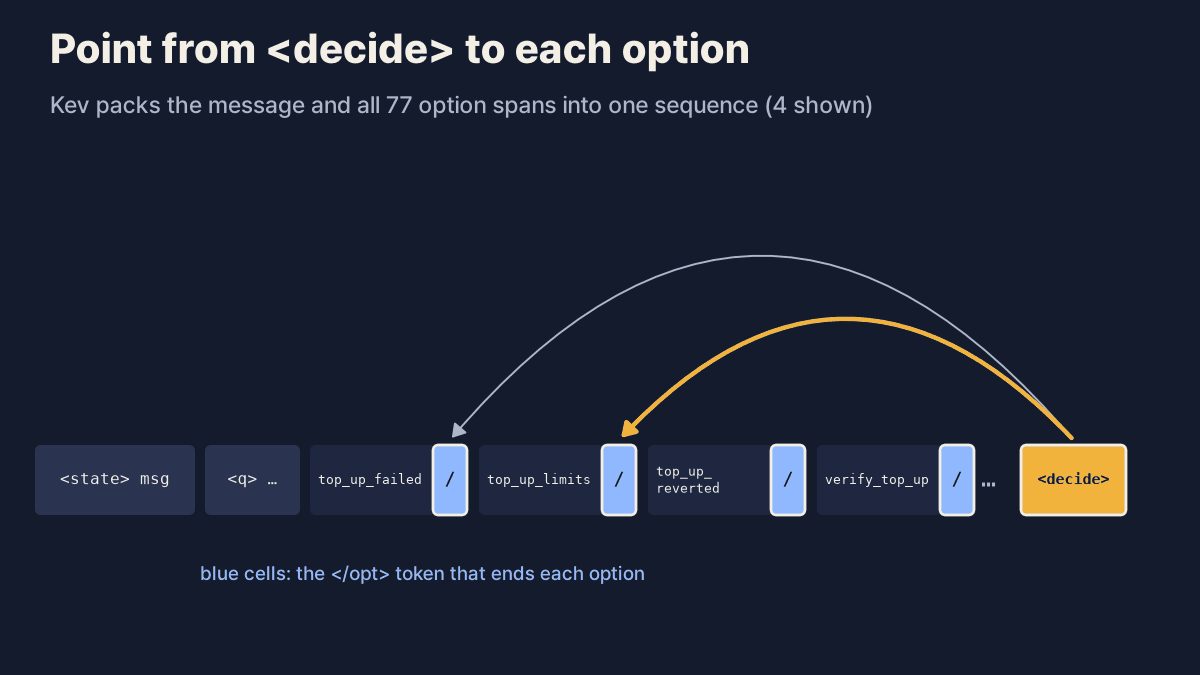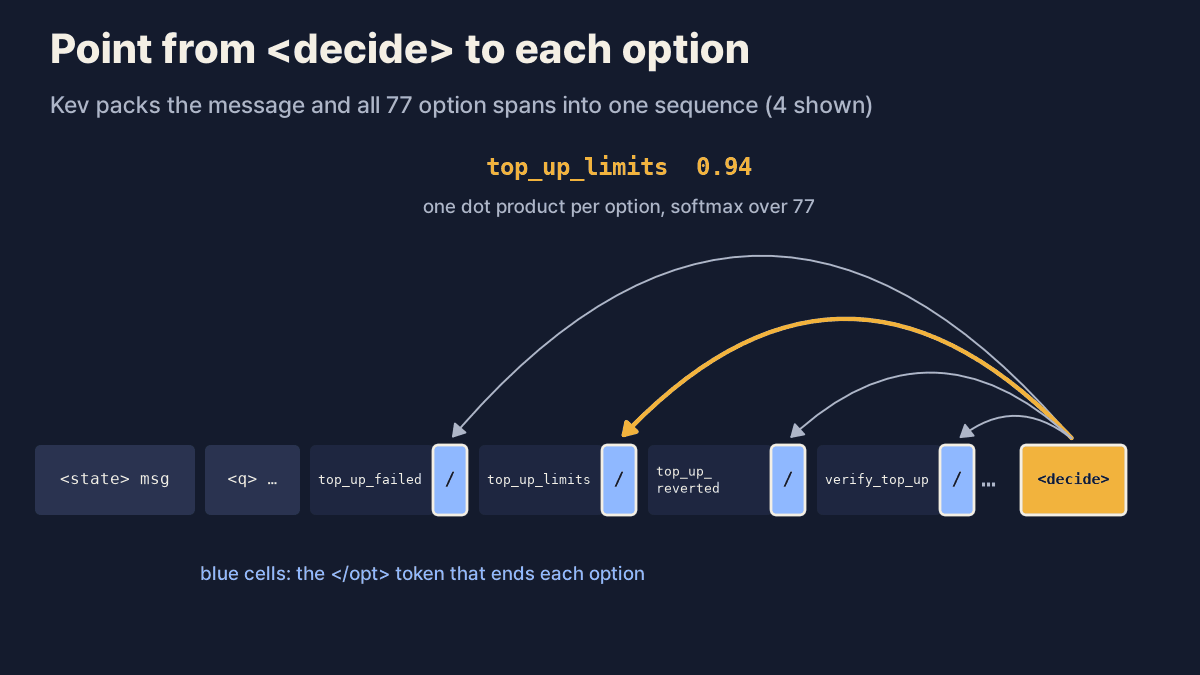
<state> 문장 <q> 지시문 <opt> card_arrival </opt> <opt> card_linking </opt> ... <decide>Kev는 라벨 토큰의 확률을 읽지 않습니다. 선택지 끝의 </opt> 토큰 hidden 벡터를 꺼내고, 이것을 <decide> 자리의 hidden 벡터와 비교합니다. <decide>는 모든 선택지 뒤에 있으므로 선택지를 전부 본 상태입니다.
def forward(self, h_decide, h_opts):  # [d], [K,d] -> logits [K]
    z = (self.k(h_opts) @ self.q(h_decide)) * self.scale
    return z if self.training or self.temperature == 1.0 else z / self.temperature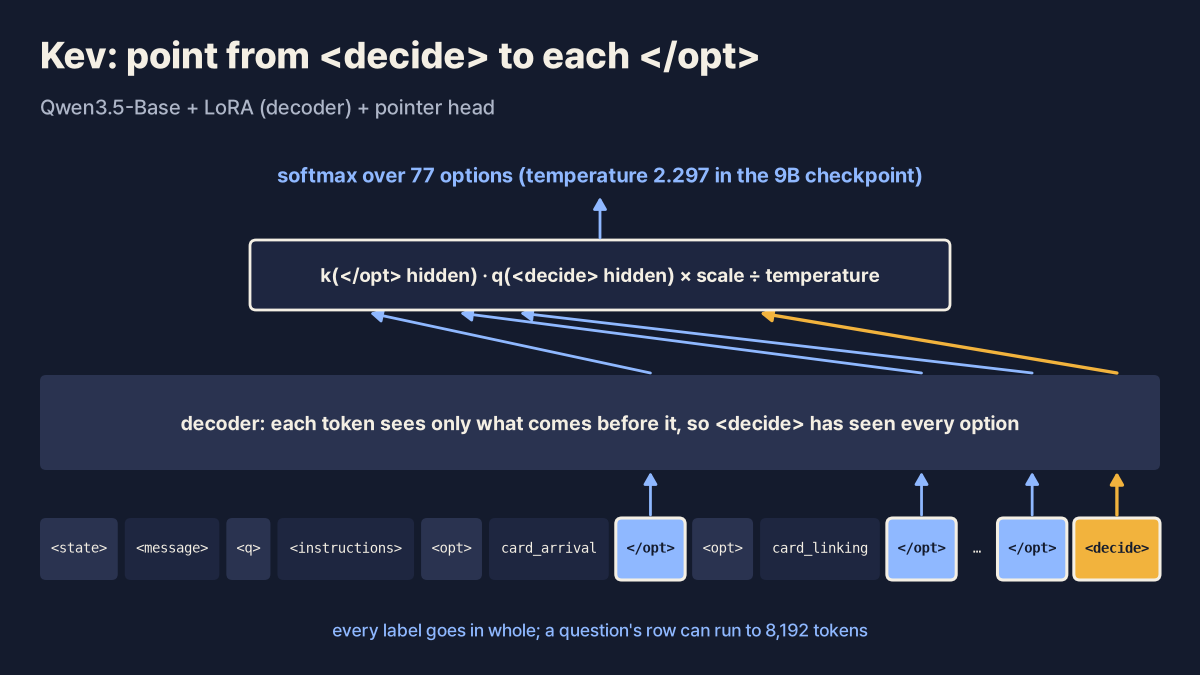
선택지마다 점수가 하나라는 점은 laya와 같습니다. 다른 점은 선택지가 입력 안의 정해진 예산을 나눠 쓰지 않는다는 것입니다. 라벨은 통째로 들어가고, 서빙할 때 질문 하나의 행은 고객 문장까지 포함해 8,192토큰까지 받습니다. BANKING77이라면 의도 이름 77개가 하나도 잘리지 않습니다. 점수를 누그러뜨리는 temperature는 체크포인트에 저장되어 있고, 저희가 잰 9B 리비전(2629c06)에서는 2.297입니다.
Kev-9B는 저희 154건에서 82.5%를 얻었습니다. Jev보다 10건을 더 맞혔지만, 이 차이는 통계적으로 뚜렷하지 않았습니다. 이 점수에는 학습 데이터 덕도 있습니다. BANKING77은 Kev가 학습한 과제 중 하나입니다. Kev가 보지 못한 데이터셋 세 개에서는 Jev가 두 개에서 앞섰습니다(Kev와 Jev 비교). 그러니 이 구조로 설명되는 것은 선택지 77개가 Kev에게 문제가 되지 않는 이유까지입니다. Kev가 다른 시스템을 이긴 이유까지 설명하지는 않습니다.
CLM: 임베딩 두 개와 코사인
CLM은 laya와 정반대 방식입니다. 고객 문장과 선택지가 한 입력에 함께 들어가지 않습니다. Qwen3-8B 인코더로 문장(질문 지시문 포함)을 임베딩하고, 선택지도 하나씩 따로 임베딩합니다. 학습된 작은 헤드가 둘을 투영하고, 점수는 둘 사이 코사인에 배율을 곱한 값입니다(src/clm/engine.py).
cos = za[k:k + len(texts)] @ zq[i]
k += len(texts)
answers[qid] = answer_from_logits(questions[qid], keys, (scale * cos / temperature).tolist())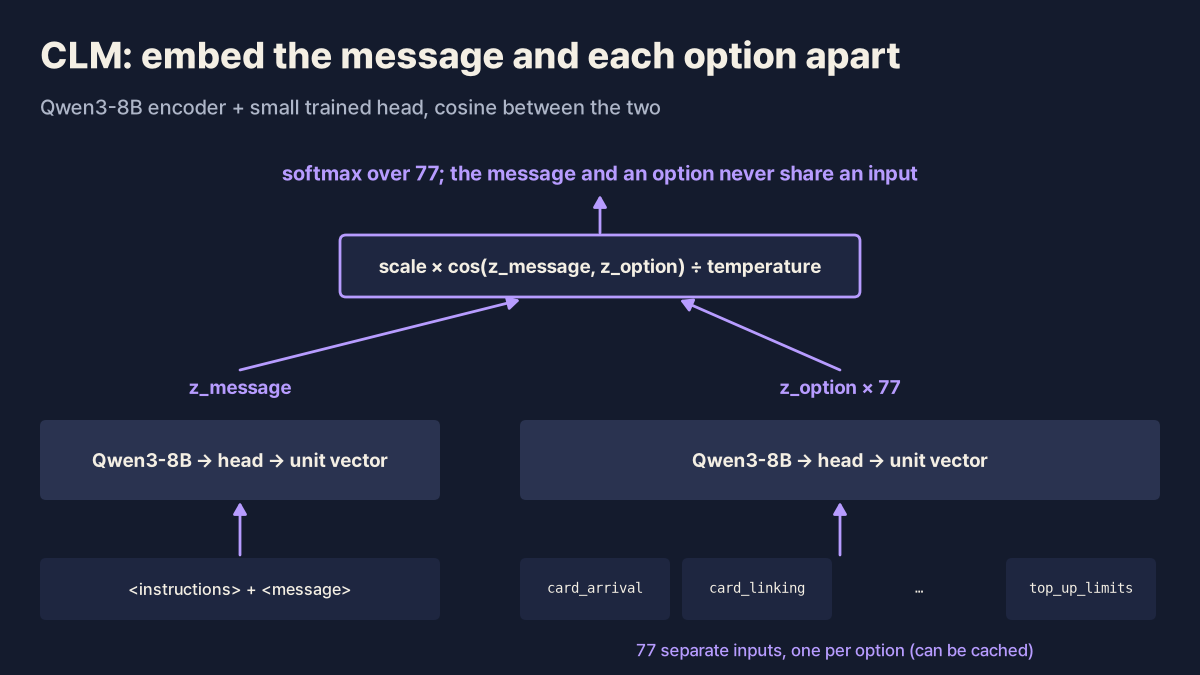
선택지 임베딩은 캐시할 수 있어 선택지를 늘려도 비용이 적고, 잘리는 것도 없습니다. 대신 선택지는 이제 자기 글자만으로 평가받습니다. top_up_limits 같은 라벨 이름은 질문과 견주기에 좋은 문장이 아닙니다. 라벨 이름만 줬을 때 CLM은 154건에서 3.2%였고, 무작위로 고르면 1.3%입니다(판단 모델과 confidence 글). 한 줄 설명이 있는 과제에서는 설명을 붙이자 나아졌습니다. CLM이 한 단어 라벨이 아니라 답 문장으로 학습되었다는 점과 맞는 결과입니다.
평범한 분류기: 선택지가 입력에 아예 없음
비교 기준으로 쓴 분류기는 모델에게 선택지를 보여 주지 않습니다. 아래 줄은 저희 벤치마크 스크립트에서 시간 재는 줄만 뺀 것입니다.
m = SentenceTransformer(a.model, device=a.device)  # all-MiniLM-L6-v2
Xtr = m.encode([r["text"] for r in train], batch_size=256, normalize_embeddings=True, show_progress_bar=False)
clf = LogisticRegression(max_iter=2000, C=10.0)
clf.fit(Xtr, [r["category"] for r in train])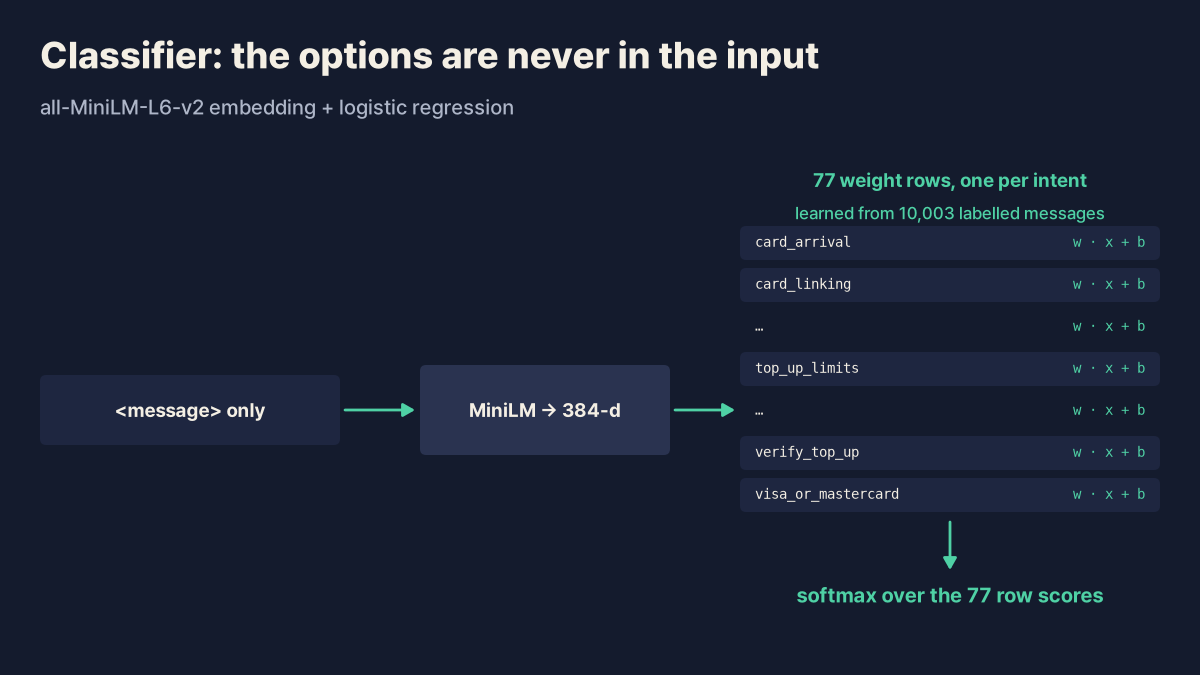
의도 77개는 각각 가중치 한 행이고, 이 가중치는 라벨이 붙은 문장 10,003건에서 배웁니다. 입력에는 고객 문장만 들어가니 선택지끼리 자리를 다툴 일이 없습니다. 그래서 선택지가 77개여도 손해가 없고, CPU에서 90.3%를 얻었습니다. 대가는 학습 데이터입니다. 라벨 붙은 예시가 없으면 이 방법은 쓸 수 없고, 판단 모델은 바로 그런 상황을 위해 나왔습니다.
다섯 시스템 나란히 보기
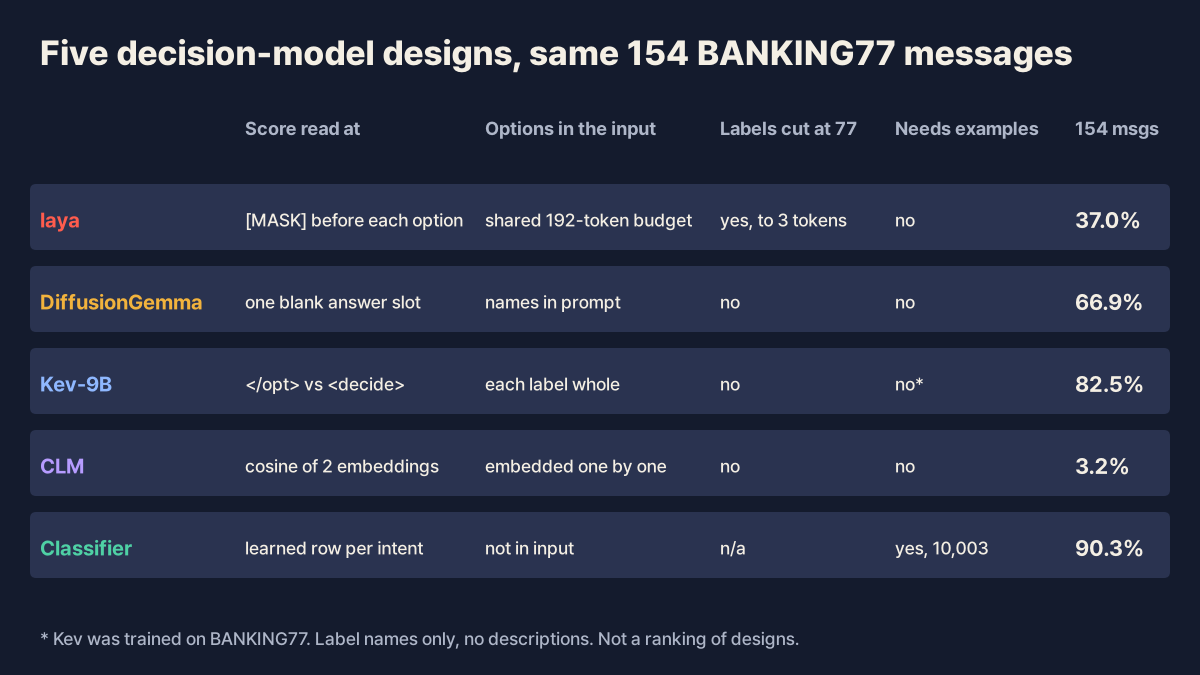
| 점수를 읽는 자리 | 선택지가 입력에 들어가는 방식 | 선택지 77개에서 긴 라벨이 잘리는가 | 라벨 붙은 예시 필요 | 154건 | |
|---|---|---|---|---|---|
| laya | 선택지 앞 [MASK] | 192토큰 예산을 나눠 씀 | 잘림, 3토큰으로 | 아니요 | 37.0% |
| DiffusionGemma(openjev) | 비워 둔 답 한 자리 | 이름은 프롬프트에, 답은 기호 하나 | 안 잘림 | 아니요 | 66.9% |
| Kev-9B | 선택지 </opt>와 <decide> | 라벨마다 통째로 | 안 잘림 | 아니요(단 BANKING77로 학습) | 82.5% |
| CLM | 임베딩 두 개의 코사인 | 선택지를 하나씩 따로 임베딩 | 안 잘림 | 아니요 | 3.2% |
| MiniLM + 로지스틱 회귀 | 의도마다 학습된 가중치 행 | 들어가지 않음 | 해당 없음 | 예, 10,003건 | 90.3% |
다섯 줄 모두 같은 154건과 설명 없는 라벨 이름을 썼습니다. 모델 크기, 학습 데이터, 하드웨어는 서로 다르므로, 이 표는 시스템마다 선택지를 어떻게 다루는지 보여 주는 것이지 구조끼리 순위를 매긴 것이 아닙니다.
Jev는 저희가 열어 볼 수 없는 유일한 시스템입니다. TypeSafe는 새 모델 구조, 병렬 샘플러, RLCD라는 학습 방법을 쓰고 요청 한 번에 모든 출력을 낸다고 밝혔습니다. 내부는 공개되지 않았으므로 비교 표에는 넣지 않았습니다.
선택지 77개를 보내기 전에
긴 선택지 목록에 판단 모델을 쓸 계획이라면, 먼저 선택지가 어디로 들어가는지 확인해 보시길 권합니다. laya처럼 입력 안의 정해진 예산을 나눠 쓰는 구조라면, 결과를 믿기 전에 토큰을 직접 세 보는 것이 좋습니다. 저희가 쓴 확인 코드입니다. laya가 설치되어 있어야 합니다.
from transformers import AutoTokenizer
from laya.common import build_sequence

tok = AutoTokenizer.from_pretrained("convaiinnovations/laya", subfolder="tokenizer")
question = {"t": "choice", "ins": instructions, "crit": {l: None for l in labels}}
# max_len, head_max_len: 쓰는 체크포인트의 설정값을 넣습니다
seq, markers = build_sequence(tok, message, question, max_len=512, head_max_len=192)
ends = markers[1:] + [seq.index(tok.sep_token_id, markers[-1])]
kept = [tok.decode(seq[m + 1:e]).strip() for m, e in zip(markers, ends)]
print(len(set(kept)), "distinct labels out of", len(kept))
이미 불러온 agent가 있다면 agent.tok, agent.cfg["max_len"], agent.cfg["head_max_len"]에 같은 값이 들어 있습니다.
출력된 숫자가 라벨 수보다 작다면, 모델 입장에서는 몇몇 답이 똑같이 생겼다는 뜻입니다. 후보를 먼저 줄이거나, 앞 토큰에서부터 서로 달라지도록 라벨을 짧게 고치거나, 라벨을 통째로 넣는 시스템을 고르시면 됩니다.
코드는 다음 커밋 기준으로 읽었습니다: laya 010bace, openjev 3e296f0, Kev 09ff745, CLM cca045f. 정확도는 본문에 링크한 글들의 결과 파일에서 가져왔고, 토큰 수는 BANKING77 라벨 77개를 laya 토크나이저로 센 값입니다.